LLM 网关:AI 应用里最被低估的一层
很多团队第一次意识到"网关"重要,是在某个普通的周三下午。一个同学为了压测写了个批量脚本,一小时内吃掉了当天大部分的 token 额度,紧接着产品线的线上问答整个下午都在返回 429。事后复盘,问题并不复杂:没人知道钱花在哪,也没人有能力在"不改代码"的前提下踩一脚刹车。
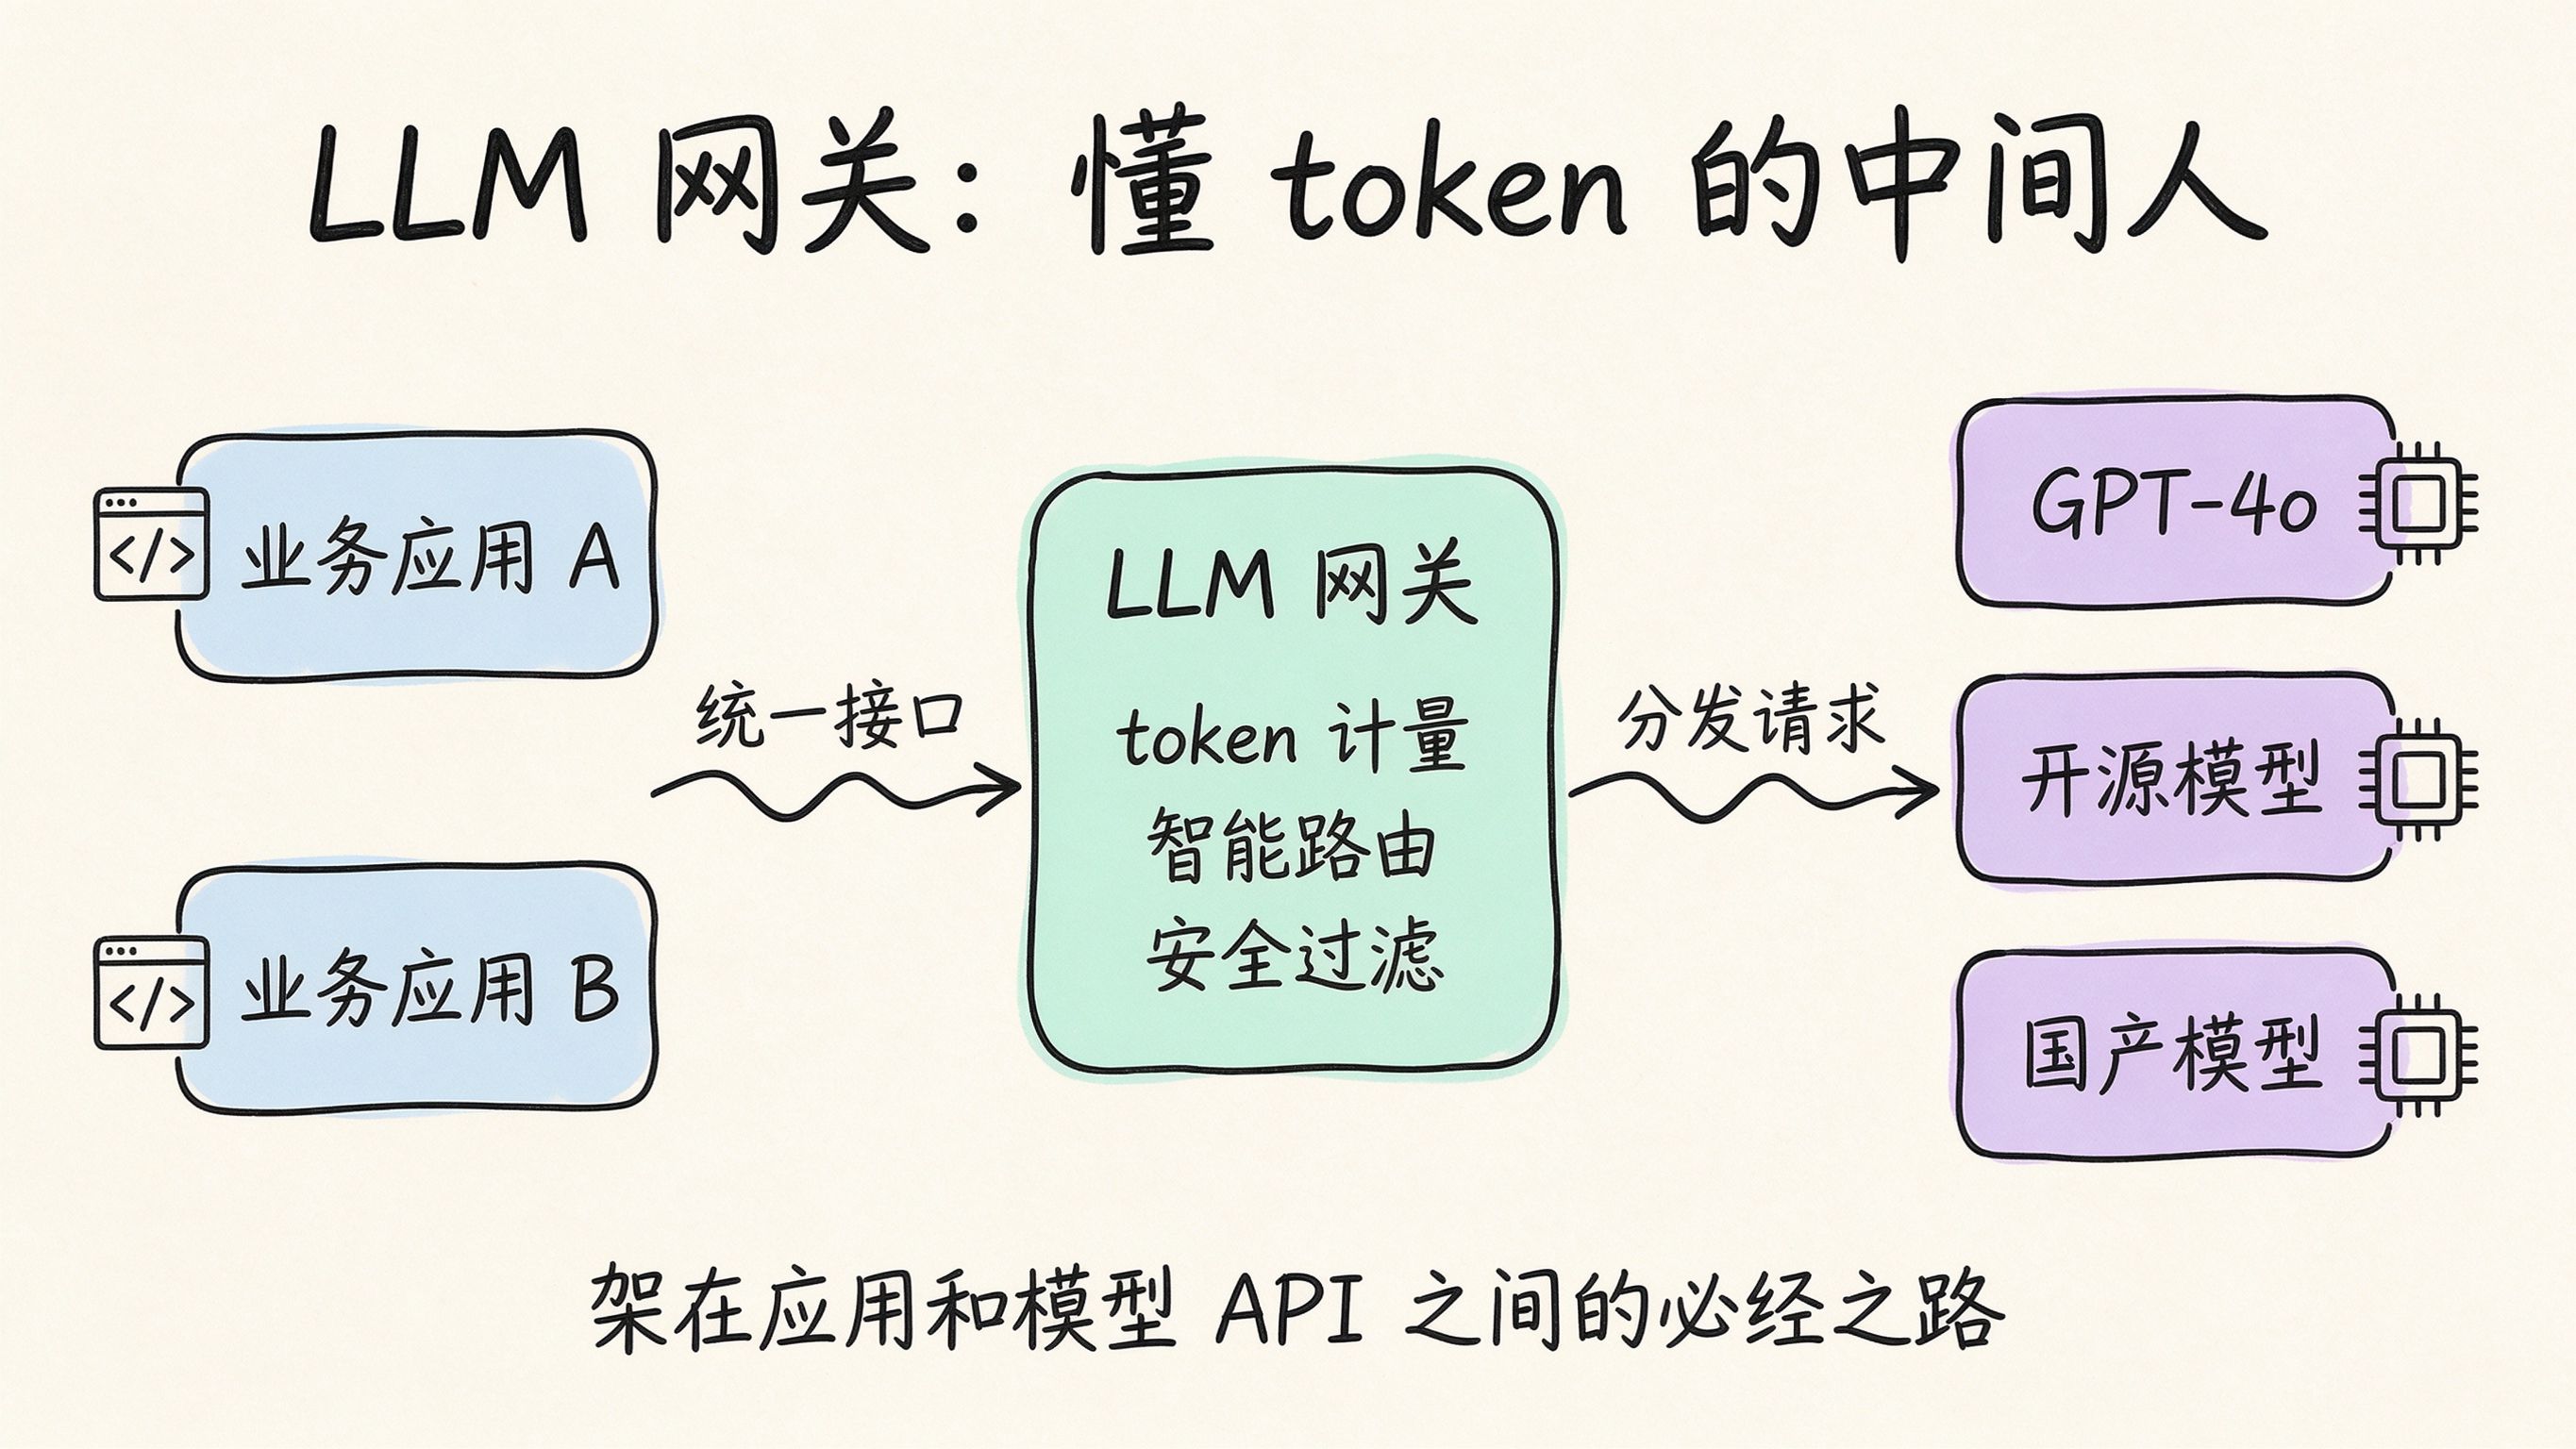
这就引出了一个常被忽略的事实——当你开始同时调用多个模型时,缺的不是一个反向代理,而是一个懂 token 的中间人。
为什么 Nginx 顶不上这个位置
有人会反问:负载均衡、健康检查、超时重试,Nginx 不都能做吗?能做,但它不知道 token 是什么,也不理解语义。普通 API 网关关心的是连接层指标:QPS、并发数、响应码;而 LLM 网关关心的是业务层语义:这次请求花了多少 token、属于哪个团队、该路由到哪个模型、prompt 里有没有夹带身份证号。
用一句话概括定位:LLM 网关是架在应用和各模型 API 之间的中间层,集中拦截和处理所有出入流量。正因为它在"必经之路"上,才可能在这个位置统一做很多事情——这是理解它全部功能的钥匙。
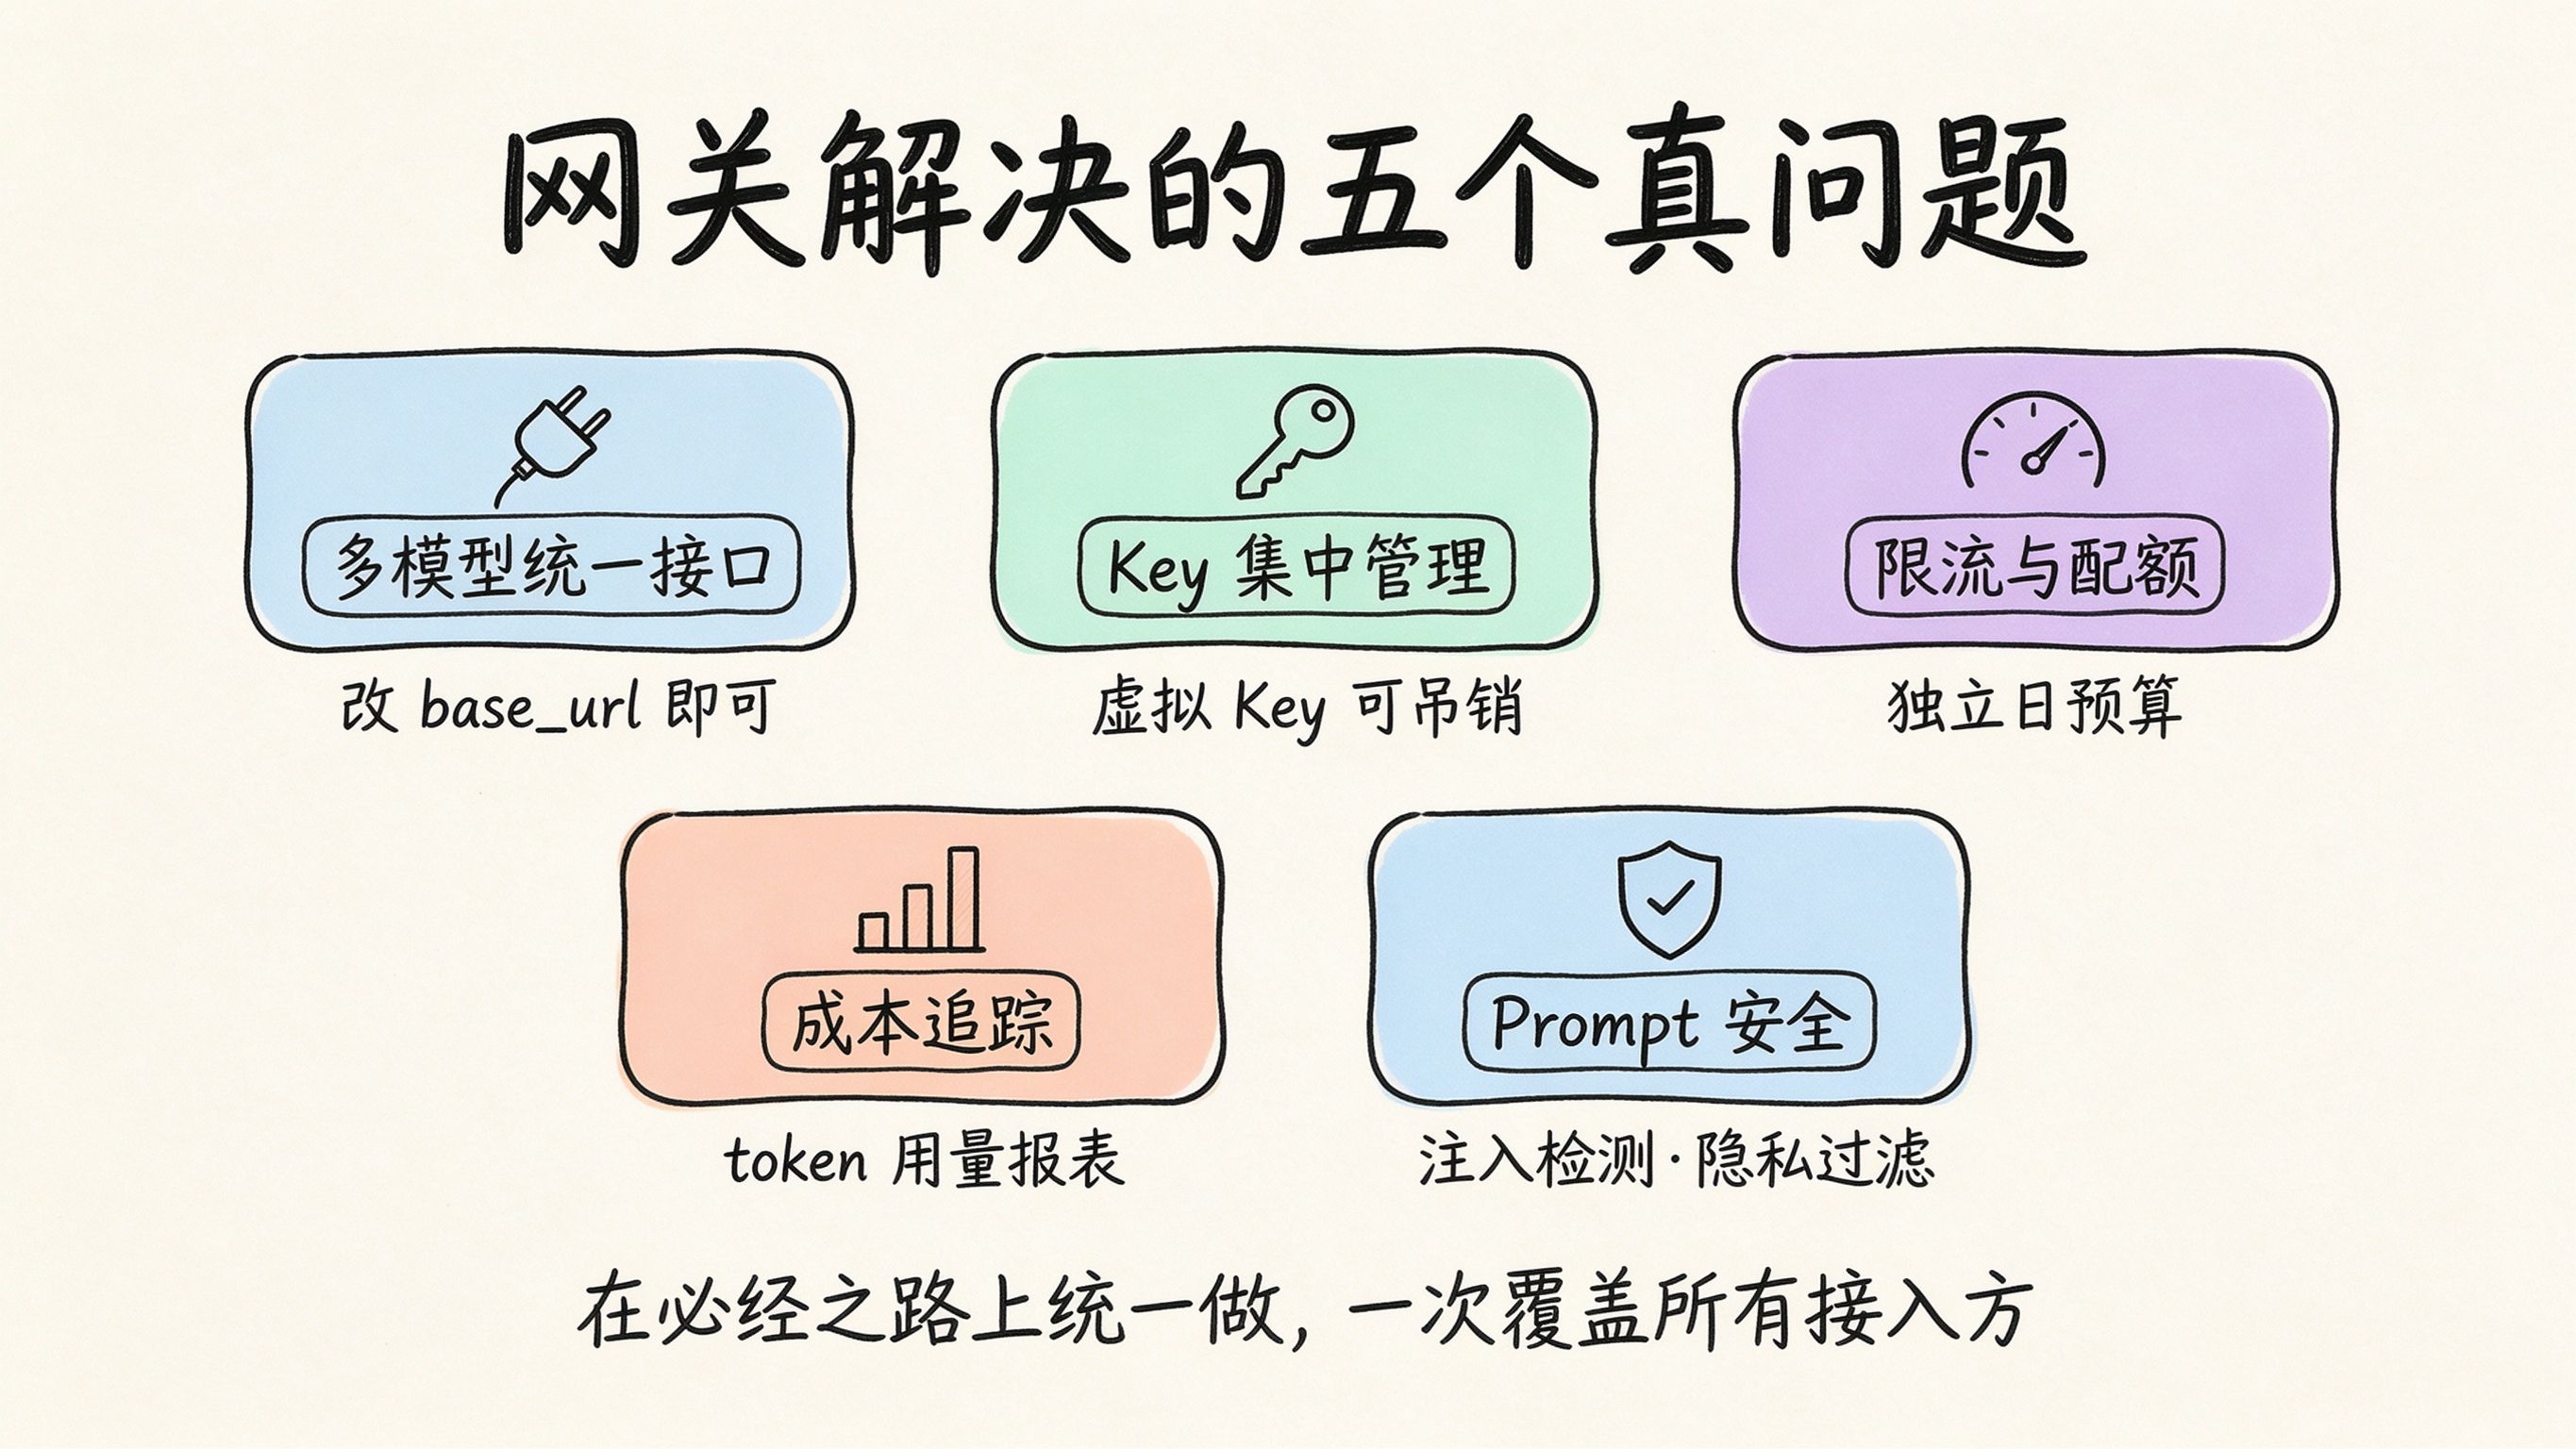
五个真问题,一次解决
多模型统一接口是最直接的收益。大多数网关对外暴露 OpenAI 兼容接口,业务代码只需要改两个地方:base_url 指向网关、api_key 换成网关签发的虚拟 Key,其余一行不动。从此"把某个任务从 GPT-4o 换成更便宜的模型"变成一次配置变更,而不是一次发版。
Key 集中管理解决的是安全账。没有网关时,API Key 散落在每个服务的配置文件里,任何一处泄露都是事故。有网关后真实密钥只存在于一个地方,业务侧拿到的是可随时吊销、可限额的虚拟 Key。
限流与配额解决的是"误伤"问题。给研发团队和产品团队各配独立日预算,前者超限只返回 429 给自己,后者的额度纹丝不动。
成本追踪让优化第一次有了依据。网关天然记录了每次调用的 token 用量、响应时间和错误率,于是"哪个接口最烧钱"“哪个团队用得最凶”"哪个模型的 P95 最慢"这类问题从拍脑袋变成了查报表。
Prompt 安全是 LLM 场景特有的一层。注入攻击检测、隐私信息过滤、内容审核,在网关实现一次就自动覆盖所有接入方,不会再出现"某个服务忘了加校验"这种漏洞。
语义缓存:网关最像"AI 原生"的能力
如果只挑一个区别于普通网关的功能,我会选语义缓存。
精确匹配的缓存对 LLM 几乎无效。“北京今天热吗”、“北京现在天气怎样”、"今天北京气温多少"是同一个需求,但字节级比对全部 miss,每次都要付一遍完整的推理费用。语义缓存的做法是先把问题转成向量,在向量库里做相似度检索,命中就跳过模型直接返回历史答案。
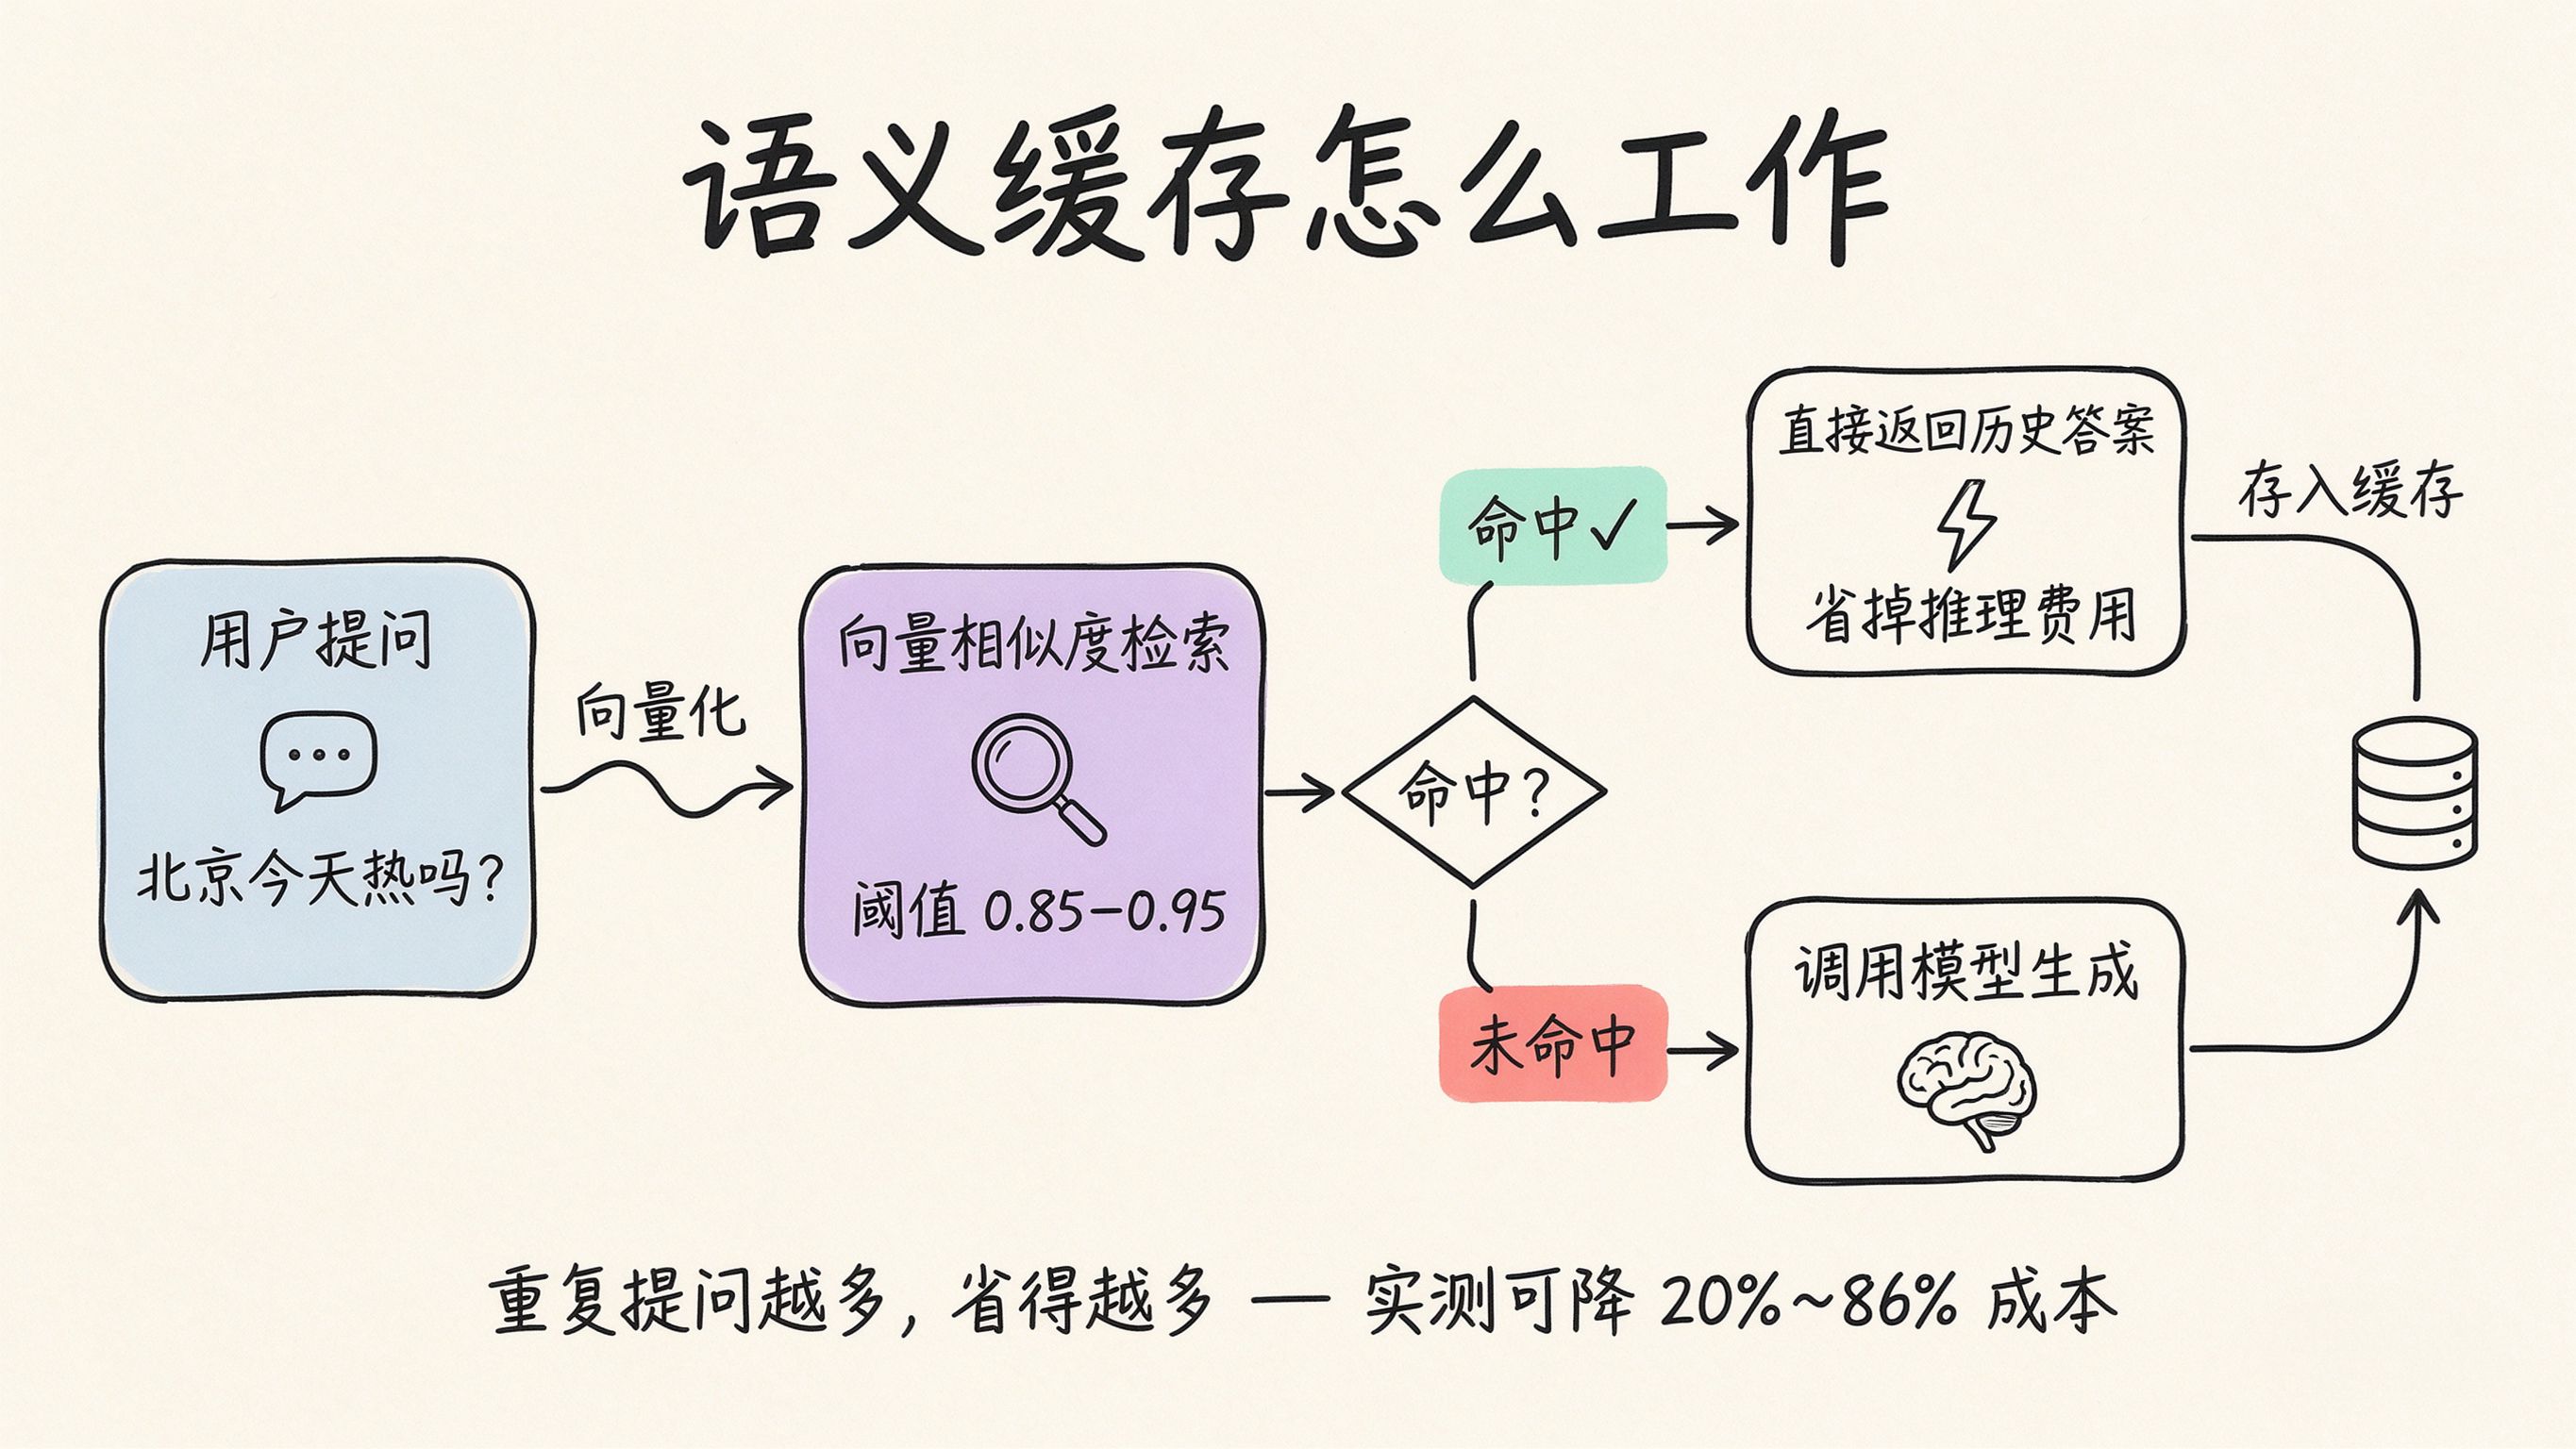
真正决定成败的是两个调参细节。相似度阈值通常落在 0.85 到 0.95 之间:设到 0.99 基本只有一字不差才命中,缓存形同虚设;设到 0.7 则可能出现"北京"命中了"上海"的答案,答非所问更尴尬。缓存有效期则要按内容类型分层——天气、股价这类实时信息缓存几分钟就够,产品 FAQ 和技术文档放几天也没问题。作为收益参考,Redis 给出的经验值是多数团队能砍掉 50% 以上的 LLM 成本,Maxim 在客服场景下的实测区间是 20%~86%,差异主要来自提问的重复度。
选型:别问哪个最好,先问你在哪一档
社区目前的格局比较清晰,但每家的强项在不同维度上,没有全能选手。
| LiteLLM | Python,开源 | 中小团队,追求模型覆盖与 Python 生态 | 细粒度权限偏企业版;生产环境建议锁版本、校验哈希 |
| One API / New API | Go,开源 | 国内团队,需可视化令牌管理与国产模型支持 | 动态路由策略相对基础,高可用需自行加固 |
| Bifrost | Rust,开源 | 对延迟和吞吐有硬要求的生产环境 | 生态较新,周边工具不如前者成熟 |
| Portkey | 商业 + 开源 | 不想自运维、看重可观测与提示词治理 | 社区版功能有限,商业版成本不低 |
| Kong AI Gateway | 商业 | 已有 Kong 技术栈的企业 | 面向企业用户,许可成本需评估 |
有一个容易被忽略的比较点:Key 管理和权限颗粒度。One API 在这块开箱体验更完整,支持多令牌、模型白名单和用量上限,全程界面操作;LiteLLM 的开源版权限模型相对粗糙,要精细化多租户往往得自己在外层再封一层鉴权。另外今年社区有过一次关于 LiteLLM 供应链安全的提醒,虽然问题已修复并发布了安全版本,但在生产环境里锁定版本、校验哈希仍然是个不亏的习惯。
一个反直觉的结论:小团队可能不该上
前面全是好处,但代价同样真实——多一个中间层就多一个单点、多一跳延迟、多一份运维负担。这个收益是随规模非线性增长的:当团队只有两三个人、只调一家模型时,环境变量加一个薄薄的封装就够了,专门维护一套网关反而是负债;等到多模型、多团队、多业务线同时出现,网关才真正从"可选项"变成"必需项"。
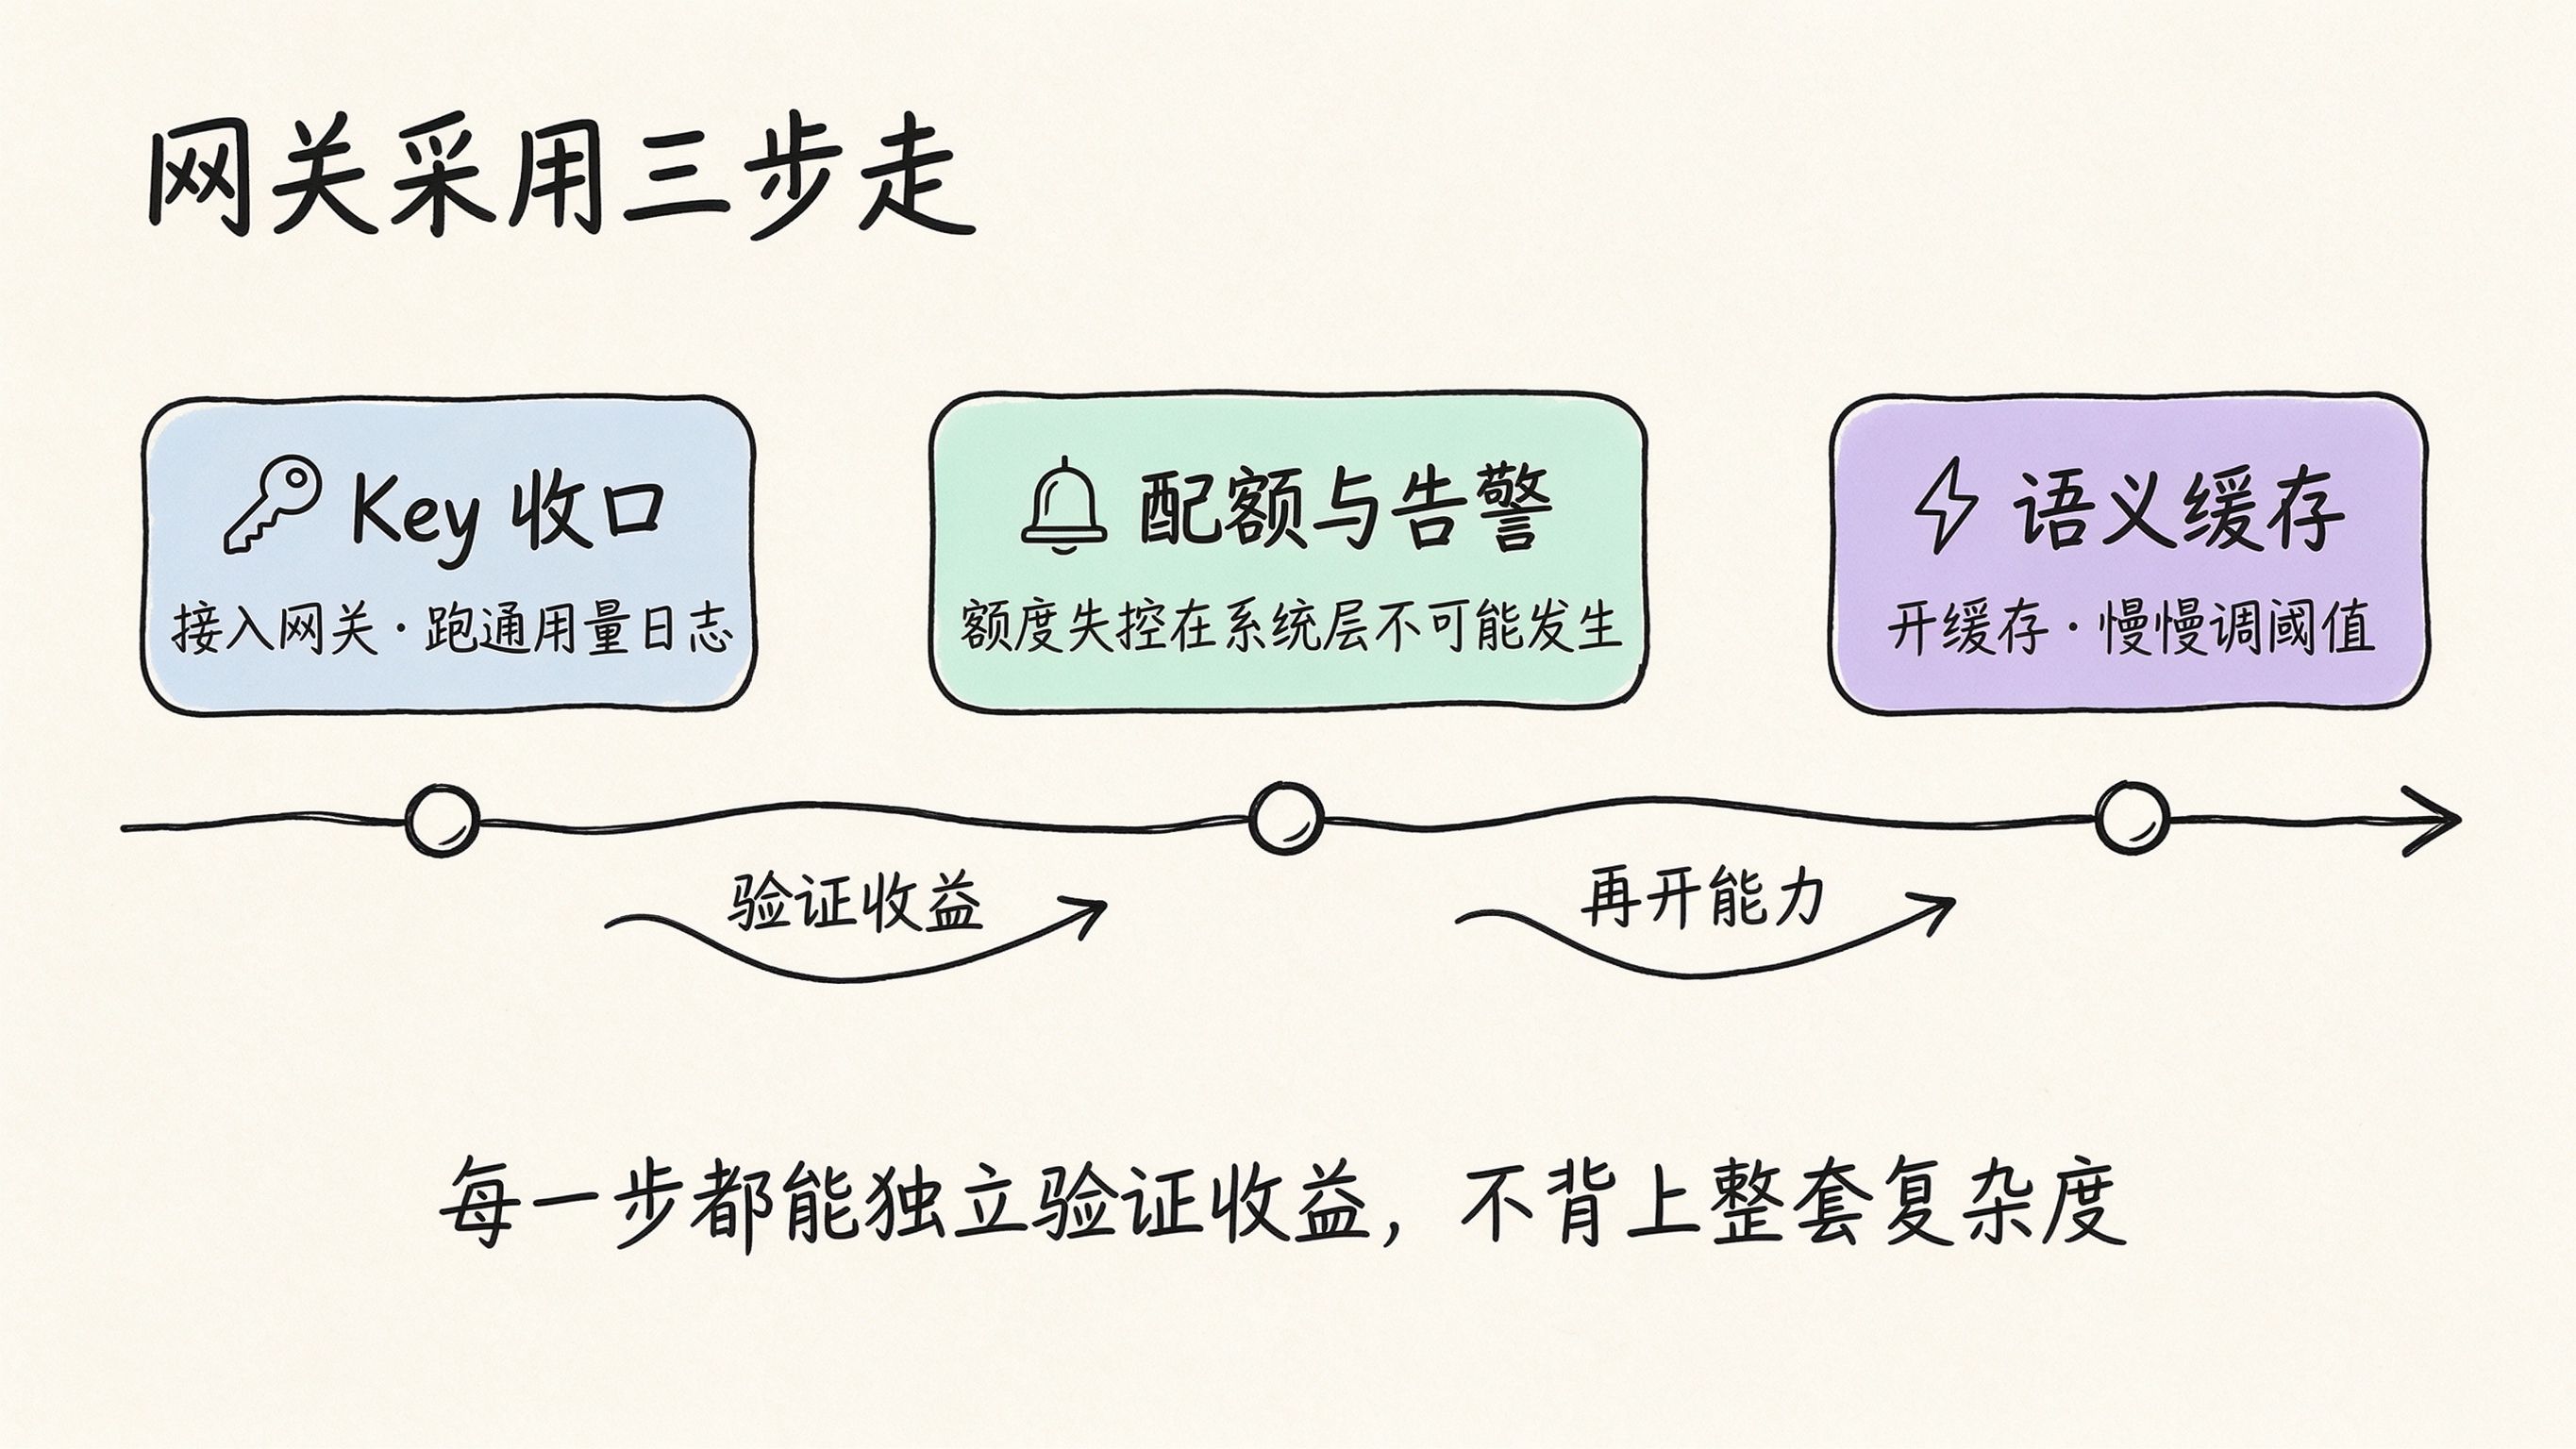
所以更务实的路径是分三步走:先接入网关把 Key 收口、把用量日志跑通;再打开配额与告警,让额度失控这件事在系统层面不可能发生;最后才是开语义缓存并慢慢调阈值。这个顺序的好处是每一步都能独立验证收益,不至于一上来就背上整套复杂度。
真正把网关用明白的团队,最后往往不再把它当"代理层",而是当成 AI 系统的控制面——路由、预算、安全、观测都在这里收口。它不生产智能,但它决定了这些智能能不能被稳定、可控、可算账地用起来。
统的控制面——路由、预算、安全、观测都在这里收口。它不生产智能,但它决定了这些智能能不能被稳定、可控、可算账地用起来。