👨⚕️ 主页: gis分享者 👨⚕️ 感谢各位大佬 点赞👍 收藏⭐ 留言📝 加关注✅! 👨⚕️ 收录于专栏:AI大模型原理和应用面试题 
文章目录
- 一、🍀回答重点
- 二、🍀扩展知识
-
- 2.1 ☘️输入审核和输出审核的侧重点
- 2.2 ☘️审核系统的工程落地
- 2.3 ☘️持续运营的最佳实践
- 2.4 ☘️国内外审核策略差异
- 三、🍀面试官追问
一、🍀回答重点
AI 应用的内容审核要解决两个方向的问题:一是用户输入的内容是否违规,二是 AI 输出的内容是否合规。
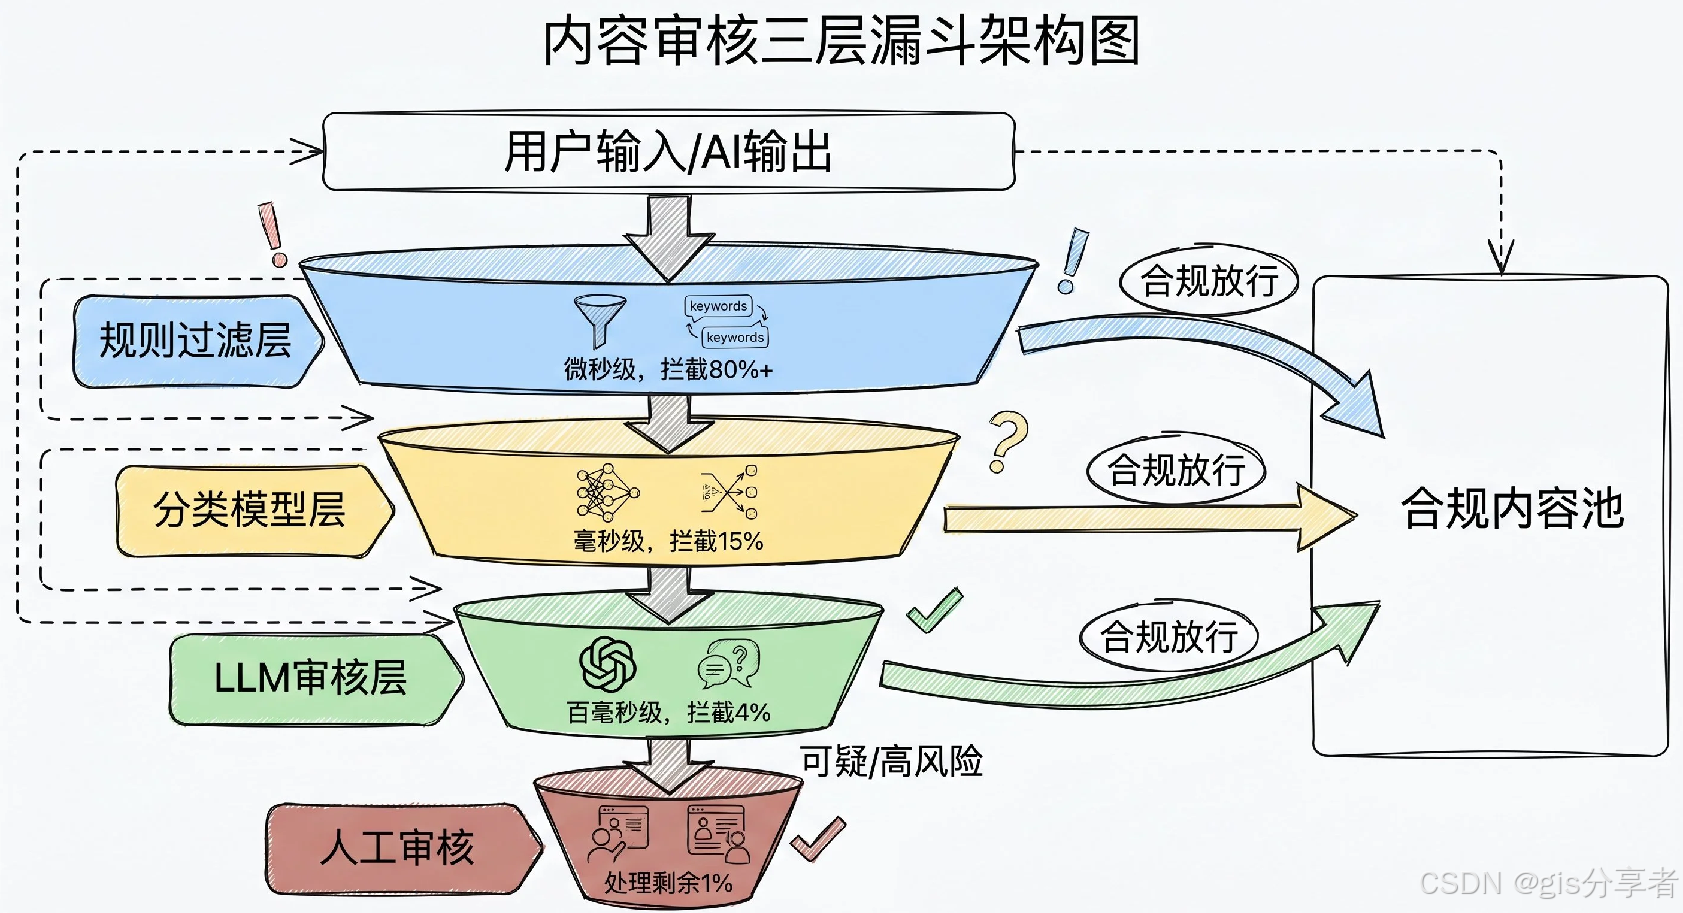
技术方案通常分三层漏斗,按成本从低到高串联:
1)规则过滤层。用关键词库和正则表达式做快速过滤,速度极快。缺点是容易被变体绕过,敏感词加个空格、用谐音、用拼音首字母都能绕开。不过这层不能省略,线上 80% 以上的低成本违规内容靠这层就能拦住
2)分类模型层。用专门训练的 NLP 模型做多标签分类,判断内容是否涉及色情、暴力、歧视、政治敏感等类别。OpenAI 的 Moderation API、Google 的 Perspective API、国内各大云厂商的内容安全服务都属于这类。准确率比关键词高一个量级,延迟在几十毫秒,能处理规则层漏掉的变体和隐晦表达
3)LLM 审核层。用大模型来判断内容是否合规,专门处理需要理解语境才能判断的复杂场景。比如\”如何制作蛋糕\”是正常的,\”如何制作炸弹形状的蛋糕\”可能也是正常的,但\”如何制作炸弹\”就不行。这种语义级别的判断只有大模型才搞得定
大部分内容在规则层就处理掉了,只有一小部分需要进入模型审核,更少的才需要人工介入。这样既保证审核质量,又把成本控制住。