做数据类需求测试,最容易掉进一个坑:以为查几张表、对几条数据、再看下页面,就算测完了。
但真到了稍微复杂一点的场景,比如:
- Excel 数据清洗后入库
- 映射表生效
- Redis 游标控制增量
- 定时任务处理
- 下游报价或报表回流
- 前台最终展示验收
这时候你会发现,问题根本不是“会不会写 SQL”,而是你测的到底是一张表,还是一条链路。
我这两年碰到这类需求,后面基本都不再按“查表思路”做了,而是固定拆成几层、几阶段去推进。这样做有两个好处:
- 出问题时能很快知道卡在哪一层
- 下次再来类似需求,不用从头再想一遍
这篇文章不讲某个具体项目复盘,直接讲我现在在做复杂数据链路测试时,比较稳定的一套方法。你拿去做团队培训、写测试手册,或者下次自己复用,都够用。
先说结论:复杂数据测试,不要按“表”测,要按“链路”测
这类需求表面上看是“导数据”,实际上经常跨了好几层:
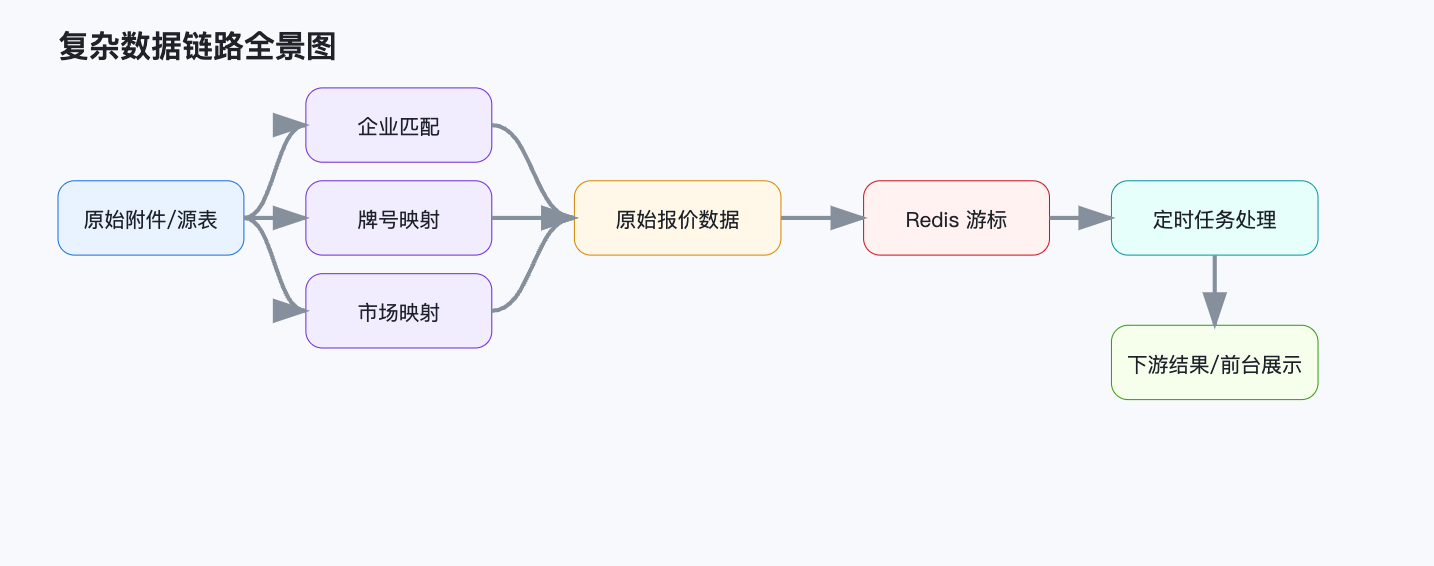
如果你的测试只停在“目标表里有数据了”,那最多只能证明配置落下去了,根本证明不了:
- 规则是不是按预期生效了
- 任务有没有真正消费到这批数据
- 下游结果有没有被正确写入
- 前台展示是不是最终正确
所以我现在会先把这类需求固定拆成 5 层。
第一部分:先拆成 5 层,不然测试范围永远是糊的
我一般会按下面这个结构拆:
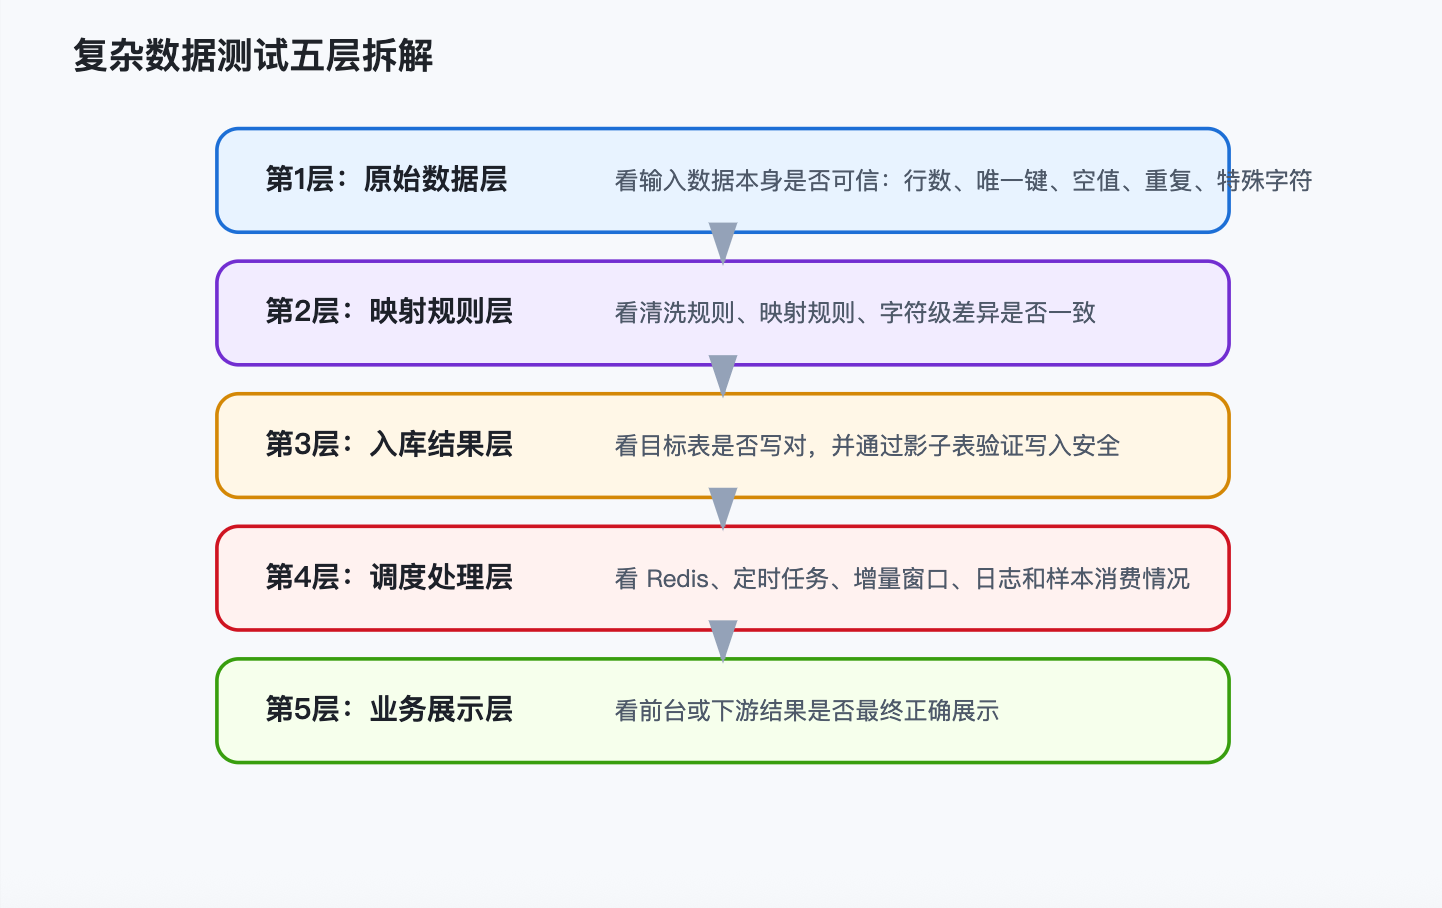
对应关系很简单:
| 原始数据层 | 输入数据本身能不能用 | 数据基线 |
| 映射规则层 | 清洗和映射到底对不对 | 差异清单 |
| 入库结果层 | 目标表到底写对了没有 | 入库核对结果 |
| 调度处理层 | Redis、任务、日志、增量是不是通的 | 链路执行证据 |
| 业务展示层 | 前台或下游结果到底对不对 | 最终验收结论 |
这个拆法的好处特别直接。
以前你可能会写一句:
“数据已入库,但页面未展示,待开发排查。”
这句话其实信息量很低。因为没人知道问题卡在哪。
但如果按 5 层拆开,你就能把结论写成:
- 原始数据层:通过
- 映射规则层:通过
- 入库结果层:通过
- 调度处理层:阻塞,Redis 游标未回退导致任务未消费
- 业务展示层:未执行
这就完全不一样了。
第二部分:执行上我一般固定成 7 个阶段
层次拆清楚以后,真正落地时我会固定走一套顺序。不是因为流程控,而是因为这类需求一旦边查边测,最后非常容易漏步骤。
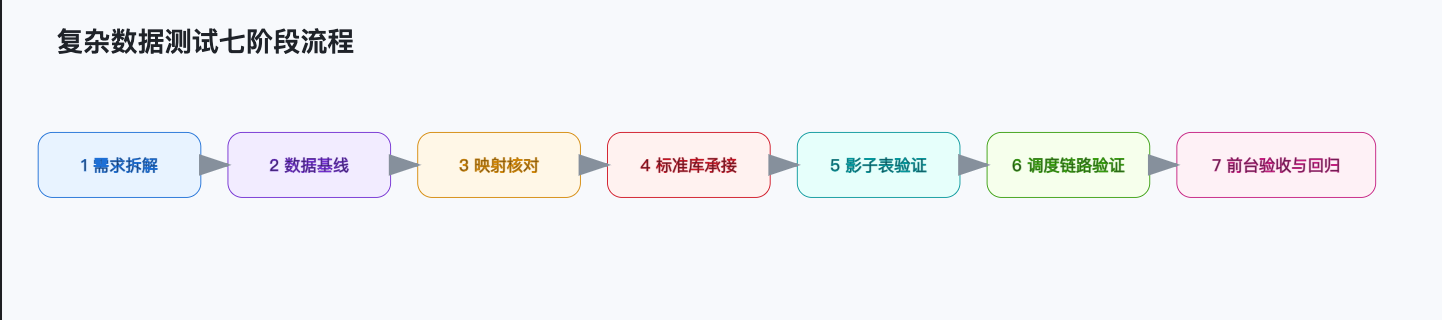
下面我按这 7 个阶段讲。