正确的代码是科学,可靠的代码是工程,优美的代码是艺术。
引子:一段“能跑就行”的代码,三个月后成了团队的噩梦
这种场景在软件开发团队里反复出现:前任开发者交付时很自豪:“全部测试通过,功能完整,性能达标。”
但当我们打开代码时,所有人都沉默了:
def parse_prd(data):
# 第一版实现,别乱改
if data:
if type(data) == str:
if len(data) > 0:
# 各种处理逻辑
for x in data.split('\\n'):
if '用户故事' in x:
# 这里以前有bug,后来修了,具体忘了怎么修的
tmp = x.split(':')[1].strip()
# 再处理一下
# …(此处省略200行)
三个月后,产品经理提出新需求:“支持从Excel导入PRD。”
我们评估的结论是:与其改这段代码,不如重写。
这不是个例。在AI辅助编程时代,代码生成速度提高了10倍,但代码的丑陋程度也同步提高了10倍。AI擅长“写出来”,但不擅长“写得好看”。而“好看”这件事,恰恰决定了软件能活多久。
这引出了软件质量的第三个维度——优美性。
一、优美性的三层内涵:结构、味道、可读
在我们团队的定义中,软件的优美性不是“好看”这种主观感受,而是三个可量化的工程维度:
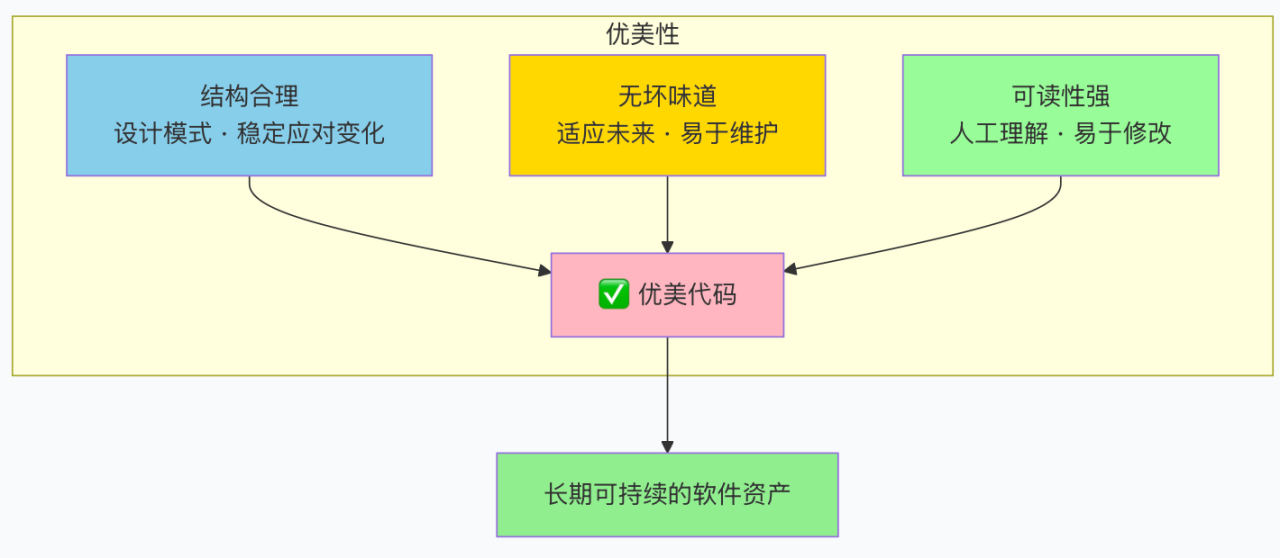
1. 结构合理:用设计模式构建“抗变化”的骨架
优美代码的第一层,是架构层面的稳定性。
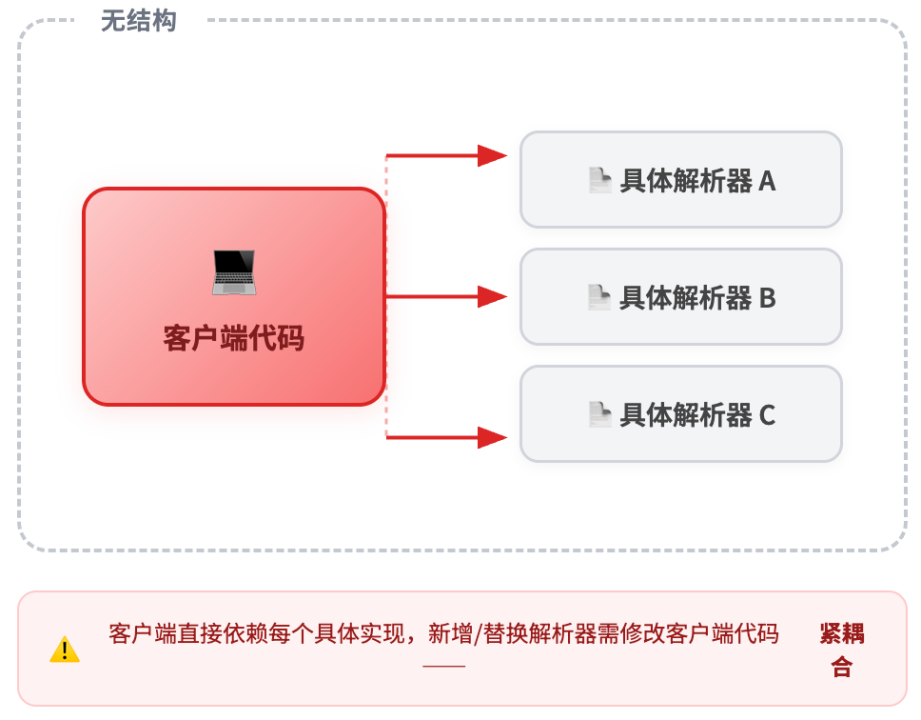
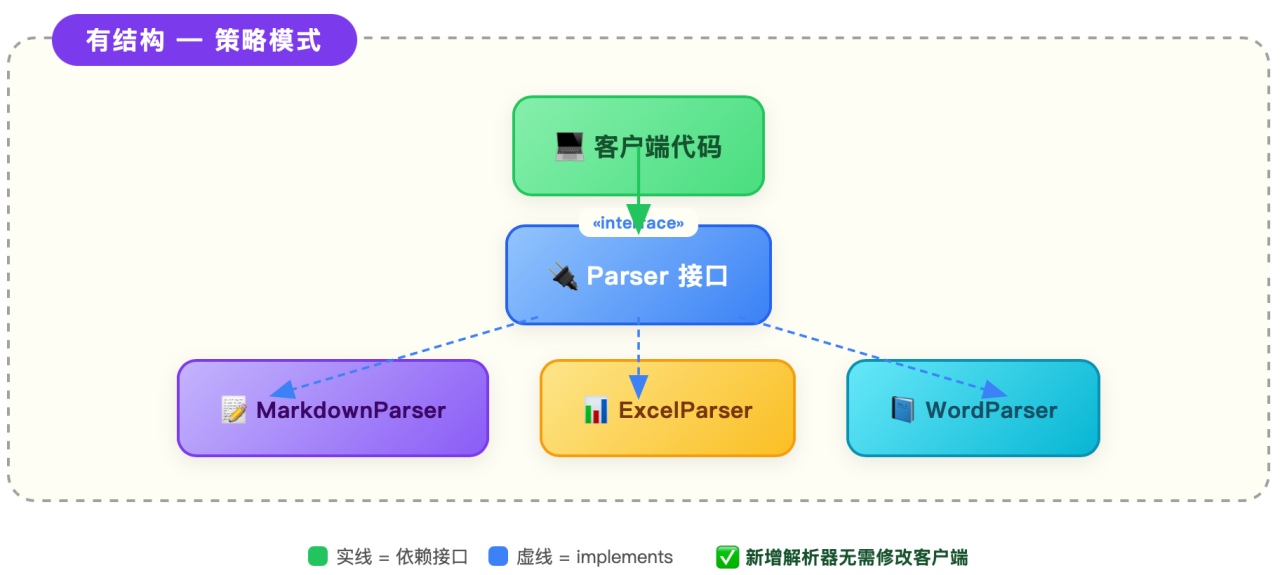
好的结构不是“今天能跑”,而是“未来能改”。它能够在需求变化时,只改动局部,而不牵一发动全身。
|
变化类型 |
无结构设计(硬编码) |
有结构设计(设计模式) |
|
新增一种PRD格式 |
修改主解析函数,新增if-else分支 |
新增一个Parser实现,无需改动现有代码 |
|
更换LLM供应商 |
全局搜索替换API调用 |
通过Adapter模式隔离,只换一个类 |
|
支持新的输出格式 |
修改所有输出点 |
新增一个Formatter,符合开闭原则 |
设计模式的本质不是“套用模板”,而是“找到稳定的抽象点,封装变化点”。
2. 没有坏味道:让代码“呼吸顺畅”
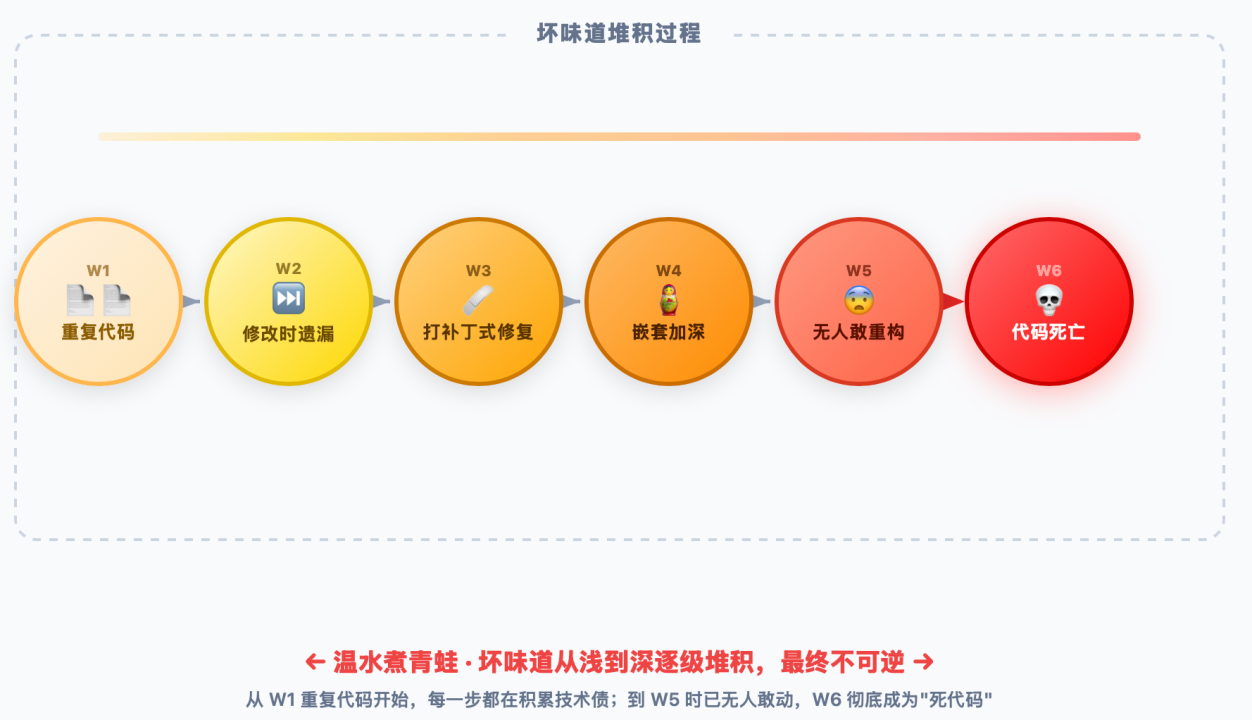
代码坏味道(Code Smell)不是Bug——Bug是“代码做错了”,坏味道是“代码虽然现在没错,但未来一定会变成麻烦”。
我们在代码审查中重点关注的坏味道清单:
|
坏味道 |
表现 |
典型示例 |
|
重复代码 |
相同逻辑出现≥3次 |
同一个解析逻辑在3个不同函数中出现 |
|
长函数 |
超过50行,做了多件事 |
一个函数既解析又校验又存储还发通知 |
|
过深的嵌套 |
if/for嵌套≥3层 |
if a: for b: if c: for d: … |
|
临时变量过多 |
一个函数中超过5个临时变量 |
tmp1, tmp2, temp_data, result_temp, final_xxx |
|
散弹式修改 |
改一个需求需要改5个文件 |
新增一个字段要改实体、DAO、Service、DTO、API |
|
过度的防御 |
所有地方都判空,掩盖设计问题 |
明明不可能为null的地方也加了if,还写了降级 |
3. 可读性强:代码是写给人看的,顺便让机器执行
优美的代码,应该像一篇清晰的散文——变量名自解释,结构有层次,注释不冗余。
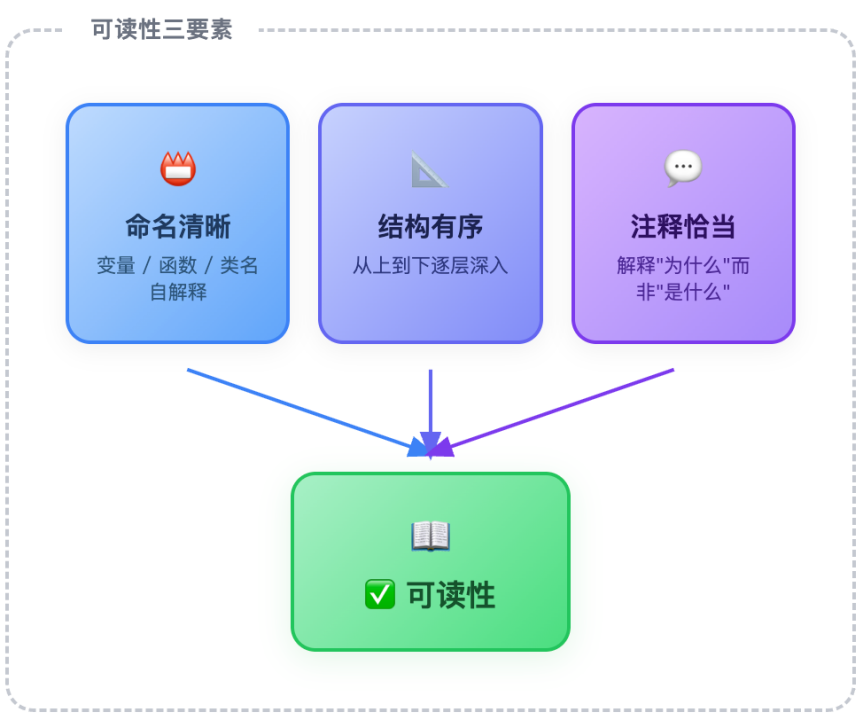
命名对照表:
|
❌ 糟糕的命名 |
✅ 优美的命名 |
说明 |
|
data |
prd_content |
具体是什么数据? |
|
process() |
parse_markdown_to_stories() |
处理什么、输出什么? |
|
flag |
is_valid_format |
布尔值以is/has开头 |
|
tmp |
raw_section |
临时变量也有意义 |
|
do_stuff() |
extract_acceptance_criteria() |
在做什么事? |
二、优美性与正确性、可靠性的关系
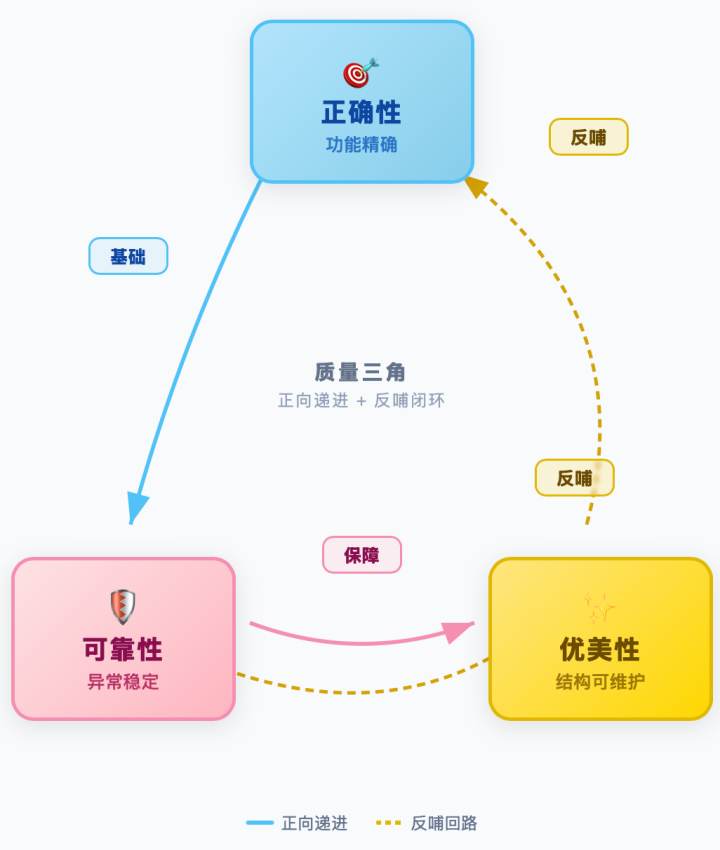
三个维度不是并列的,而是层层递进、互相支撑的:
|
维度 |
核心问题 |
失败后果 |
|
正确性 |
“做对了吗?” |
功能错,用户投诉 |
|
可靠性 |
“在意外下还能对吗?” |
系统崩,线上事故 |
|
优美性 |
“下次改的时候还能对吗?” |
改不动,技术债务堆积 |
优美性是正确性和可靠性的“时间放大器”:
- 没有优美性,正确性会在第一次需求变更时就崩塌;
- 没有优美性,可靠性会在第一次重构时就被破坏;
- 优美性让正确性可以持续,让可靠性可以进化。
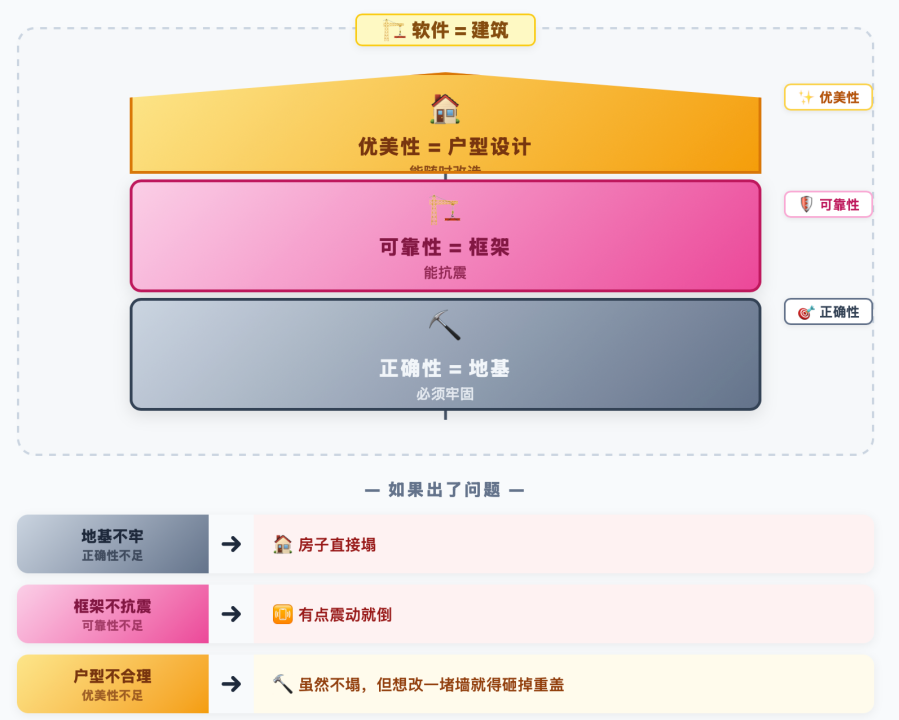
用一个比喻来理解三者的关系:
三、如何让AI写出优美的代码?四个可落地策略
AI默认生成的是“能跑”的代码,不是“好看”的代码。要让AI产出优美代码,需要在Prompt和流程中显式约束。
策略1:强制设计模式选择
在需求分析阶段,强制AI先输出设计决策,再输出代码:
## 设计决策(必须输出)
– 当前场景中,哪些是"稳定的抽象点"?
– 未来最可能变化的方面是什么?
– 选择什么设计模式来隔离变化?
示例:
"当前支持Markdown解析,未来可能支持Excel/Word,因此采用策略模式(Strategy Pattern),Parser接口作为抽象,各格式解析器作为具体实现。"
策略2:代码审查的坏味道检查清单
在AI交付代码前,自检以下清单(我们在System Prompt中强制要求):
□ 是否有重复代码块(相同逻辑出现≥2次)?
□ 是否有函数超过30行?
□ 是否有嵌套超过3层(if/for/while)?
□ 是否有超过3个临时变量(tmp1, tmp2, result_temp…)?
□ 是否有硬编码常量(如"https://api.xxx.com"直接写在代码里)?
□ 是否有类或模块承担了多个职责?
□ 所有函数名是否以动词开头,并能从命名推断其行为?
□ 所有布尔变量是否以is/has/should开头?
□ 注释是否解释"为什么"而非"是什么"?
策略3:重构优先于扩展
给AI的指令中嵌入一条原则:
"当实现新需求时,优先考虑能否通过修改现有结构来满足,而非新增逻辑。如果发现新增逻辑需要打补丁式修改,请先重构现有代码使其结构支持新需求,再实现功能。"
这个原则防止了代码走向“补丁摞补丁”的死亡螺旋。
策略4:可读性量化门禁
在交付前,AI必须输出以下可读性指标:
|
指标 |
目标值 |
检查方法 |
|
函数平均行数 |
≤30行 |
静态分析 |
|
嵌套深度 |
≤3层 |
静态分析 |
|
命名规范符合率 |
100% |
正则匹配 + 语义检查 |
|
注释密度 |
关键决策点必有注释 |
AI自检 |
|
重复代码率 |
≤5% |
代码克隆检测工具 |
四、一个实战案例:两个版本的需求工程Agent
版本1:能跑就行(无优美性设计)
def parse_prd(data):
# 开始解析
lines = data.split('\\n')
stories = []
for i in range(len(lines)):
if '用户故事' in lines[i]:
# 找到故事
story = lines[i].split(':')[1]
# 找验收条件
j = i + 1
while j < len(lines):
if '验收条件' in lines[j]:
# 找到了
condition = lines[j].split(':')[1]
stories.append({'story': story, 'condition': condition})
break
j += 1
# 这里可能有bug,但先这样吧
return stories
问题:长函数、深嵌套、硬编码、无结构、命名模糊、注释无效。
版本2:优美设计
from abc import ABC, abstractmethod
class PRDParser(ABC):
"""PRD解析器接口 – 策略模式"""
@abstractmethod
def parse(self, content: str) -> List[UserStory]:
"""解析PRD内容,返回用户故事列表"""
pass
class MarkdownPRDParser(PRDParser):
"""Markdown格式PRD解析器"""
def __init__(self, section_marker: str = "用户故事"):
self.section_marker = section_marker
def parse(self, content: str) -> List[UserStory]:
sections = self._split_by_marker(content, self.section_marker)
return [self._parse_section(s) for s in sections]
def _split_by_marker(self, content: str, marker: str) -> List[str]:
"""按标记切分文档段落"""
# 具体实现…
def _parse_section(self, section: str) -> UserStory:
"""解析单个段落为用户故事"""
# 具体实现…
class ExcelPRDParser(PRDParser):
"""Excel格式PRD解析器 – 扩展时新增,无需改现有代码"""
def parse(self, content: str) -> List[UserStory]:
# Excel解析实现…
pass
class PRDParserFactory:
"""工厂模式 – 根据文件类型创建对应的解析器"""
@staticmethod
def create(file_type: str) -> PRDParser:
parsers = {
"markdown": MarkdownPRDParser,
"excel": ExcelPRDParser,
"word": WordPRDParser,
}
return parsers.get(file_type, MarkdownPRDParser)()
优势:
- 每个函数≤30行,单一职责
- 策略模式支持新格式扩展,无需修改现有代码
- 命名自解释(parse、_split_by_marker)
- 注释解释“为什么用策略模式”而非“代码在做什么”
五、优美性的长期价值:代码是资产,不是负债
很多团队认为“优美性是锦上添花,有空再做”。但数据告诉我们不同的故事:
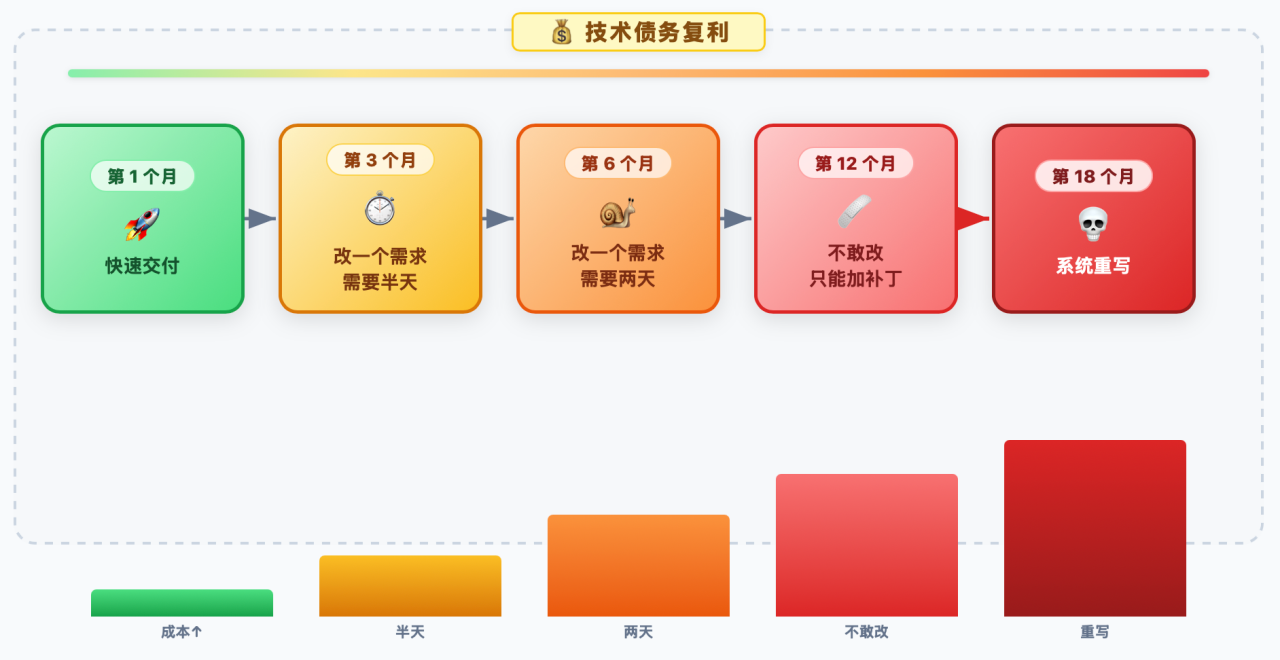
|
阶段 |
无优美性的代码 |
有优美性的代码 |
|
第1个月交付速度 |
⚡ 快 |
⚡ 较快(多花20%时间设计) |
|
第3个月新增需求 |
�� 半天 |
�� 1小时 |
|
第6个月新人上手 |
�� 2周 |
�� 2天 |
|
第12个月技术债务 |
�� 需要重写 |
�� 持续可维护 |
|
第24个月总成本 |
❌ 远高于重写 |
✅ 持续降低 |
优美的代码不是奢侈品,而是降低总拥有成本(TCO)的最有效手段。
六、我们给Agent的优美性指令(可直接复用)
在AI编程助手的System Prompt中,我们嵌入了这样一段指令:
“在交付代码之前,请完成以下三件事:
最终交付标准:代码应像一篇清晰的散文,而不是一份潦草的草稿。”
七、结语:优美性是软件生命力的保障
回到我们最初的比喻:
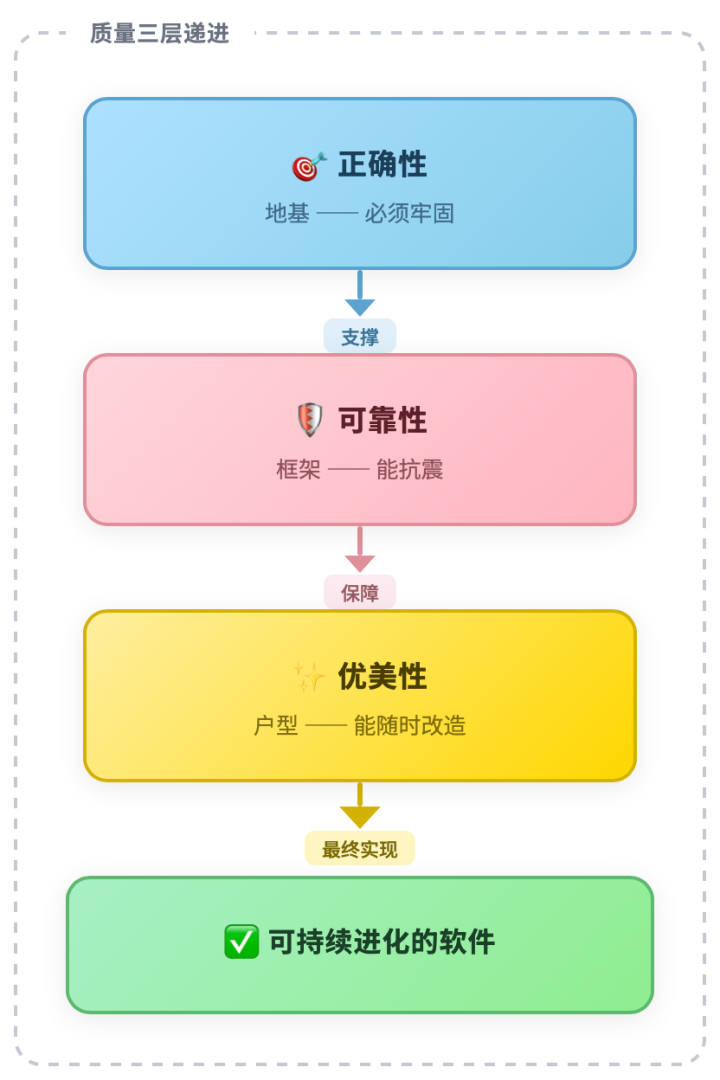
- 正确性决定了软件能不能用——这是下限
- 可靠性决定了软件敢不敢用——这是信任线
- 优美性决定了软件能活多久——这是生命力线
在AI辅助编程的时代,代码生成的速度不再是瓶颈。瓶颈变成了:我们能否让AI生成的代码,像人类中的优秀工程师写的一样清晰、优雅、可维护。
这不是审美偏好,而是工程生存问题。优美性差的代码,终将被技术债务吞噬;优美性好的代码,会成为团队最可靠的长期资产。