26年7月来自吉林大学、韩国 KAUST、Alberta大学和瑞士AI实验室的论文“Self-Improvements in Modern Agentic Systems: A Survey”。
自改进型自主智体正从研究原型走向部署系统。其主要目标是在极少甚至无需人工干预的情况下,从经验中实现可控演化或适应。本文将现代自改进型智体定义为能够将经验转化为能力提升的自适应系统。本文提供一个系统级框架,该框架将现代智体表示为一个配置,该配置将基础模型与包含提示、记忆、工具和控制逻辑的操作框架耦合在一起。在该框架下,自改进被形式化为一种自诱导更新算子,该算子获取并提交对模型参数或框架组件的更新。根据更新目标和驱动变化的信号对先前的工作进行分类,然后回顾应用并讨论评估,最后提出未解决的问题和未来的发展方向。为方便起见,在GitHub页面上跟踪技术更新。
如图1所示:现代AI智体自改进范式概述。将现有方法分为两大类。第一条路径是基础模型改进,其中模型参数从θ_t更新到θ_t+1,更新依据是内在生成性演示D_t、内在评估性反馈e_t或外在探索性经验τ_t。第二条路径是脚手架改进,其中操作脚手架(scaffolding)通过非参数变化从Σ_t更新到Σ_t+1。在脚手架的各个组件中,会实例化一个通用更新信号S_t,以驱动提示p_t、记忆m_t、工具T_t或整个脚手架Σ_t的改进。 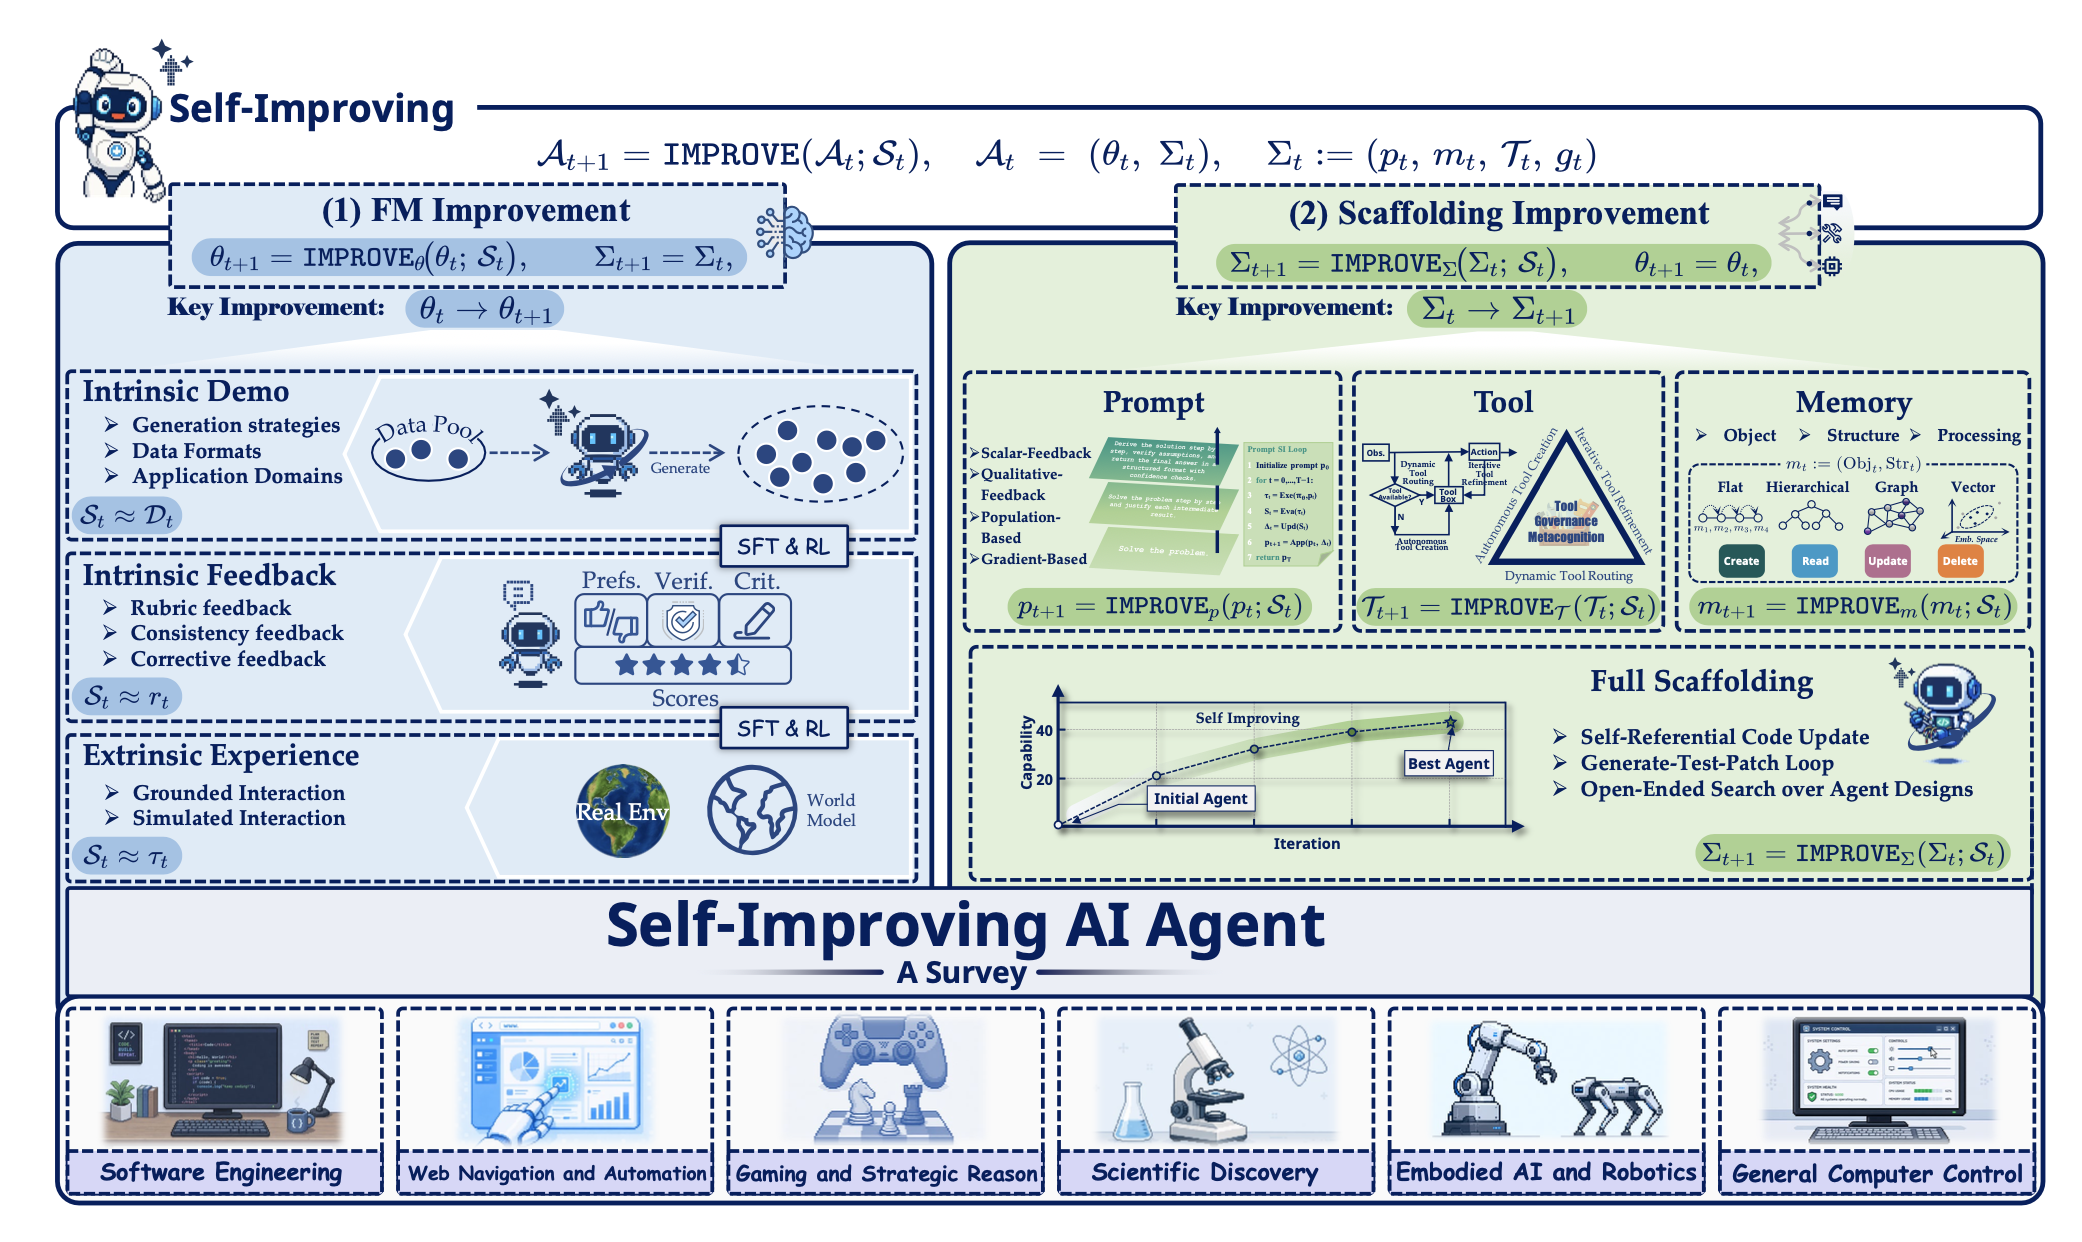
如图2 所示基于基础模型的智体自我改进的时间线和分类(2023-2026)。代表性作品按发表年份排列。左侧车道表示基础模型改进(θ),右侧车道表示脚手架改进(Σ)。AGI 标志突出该领域向日益通用的智体智能发展的长期愿景。 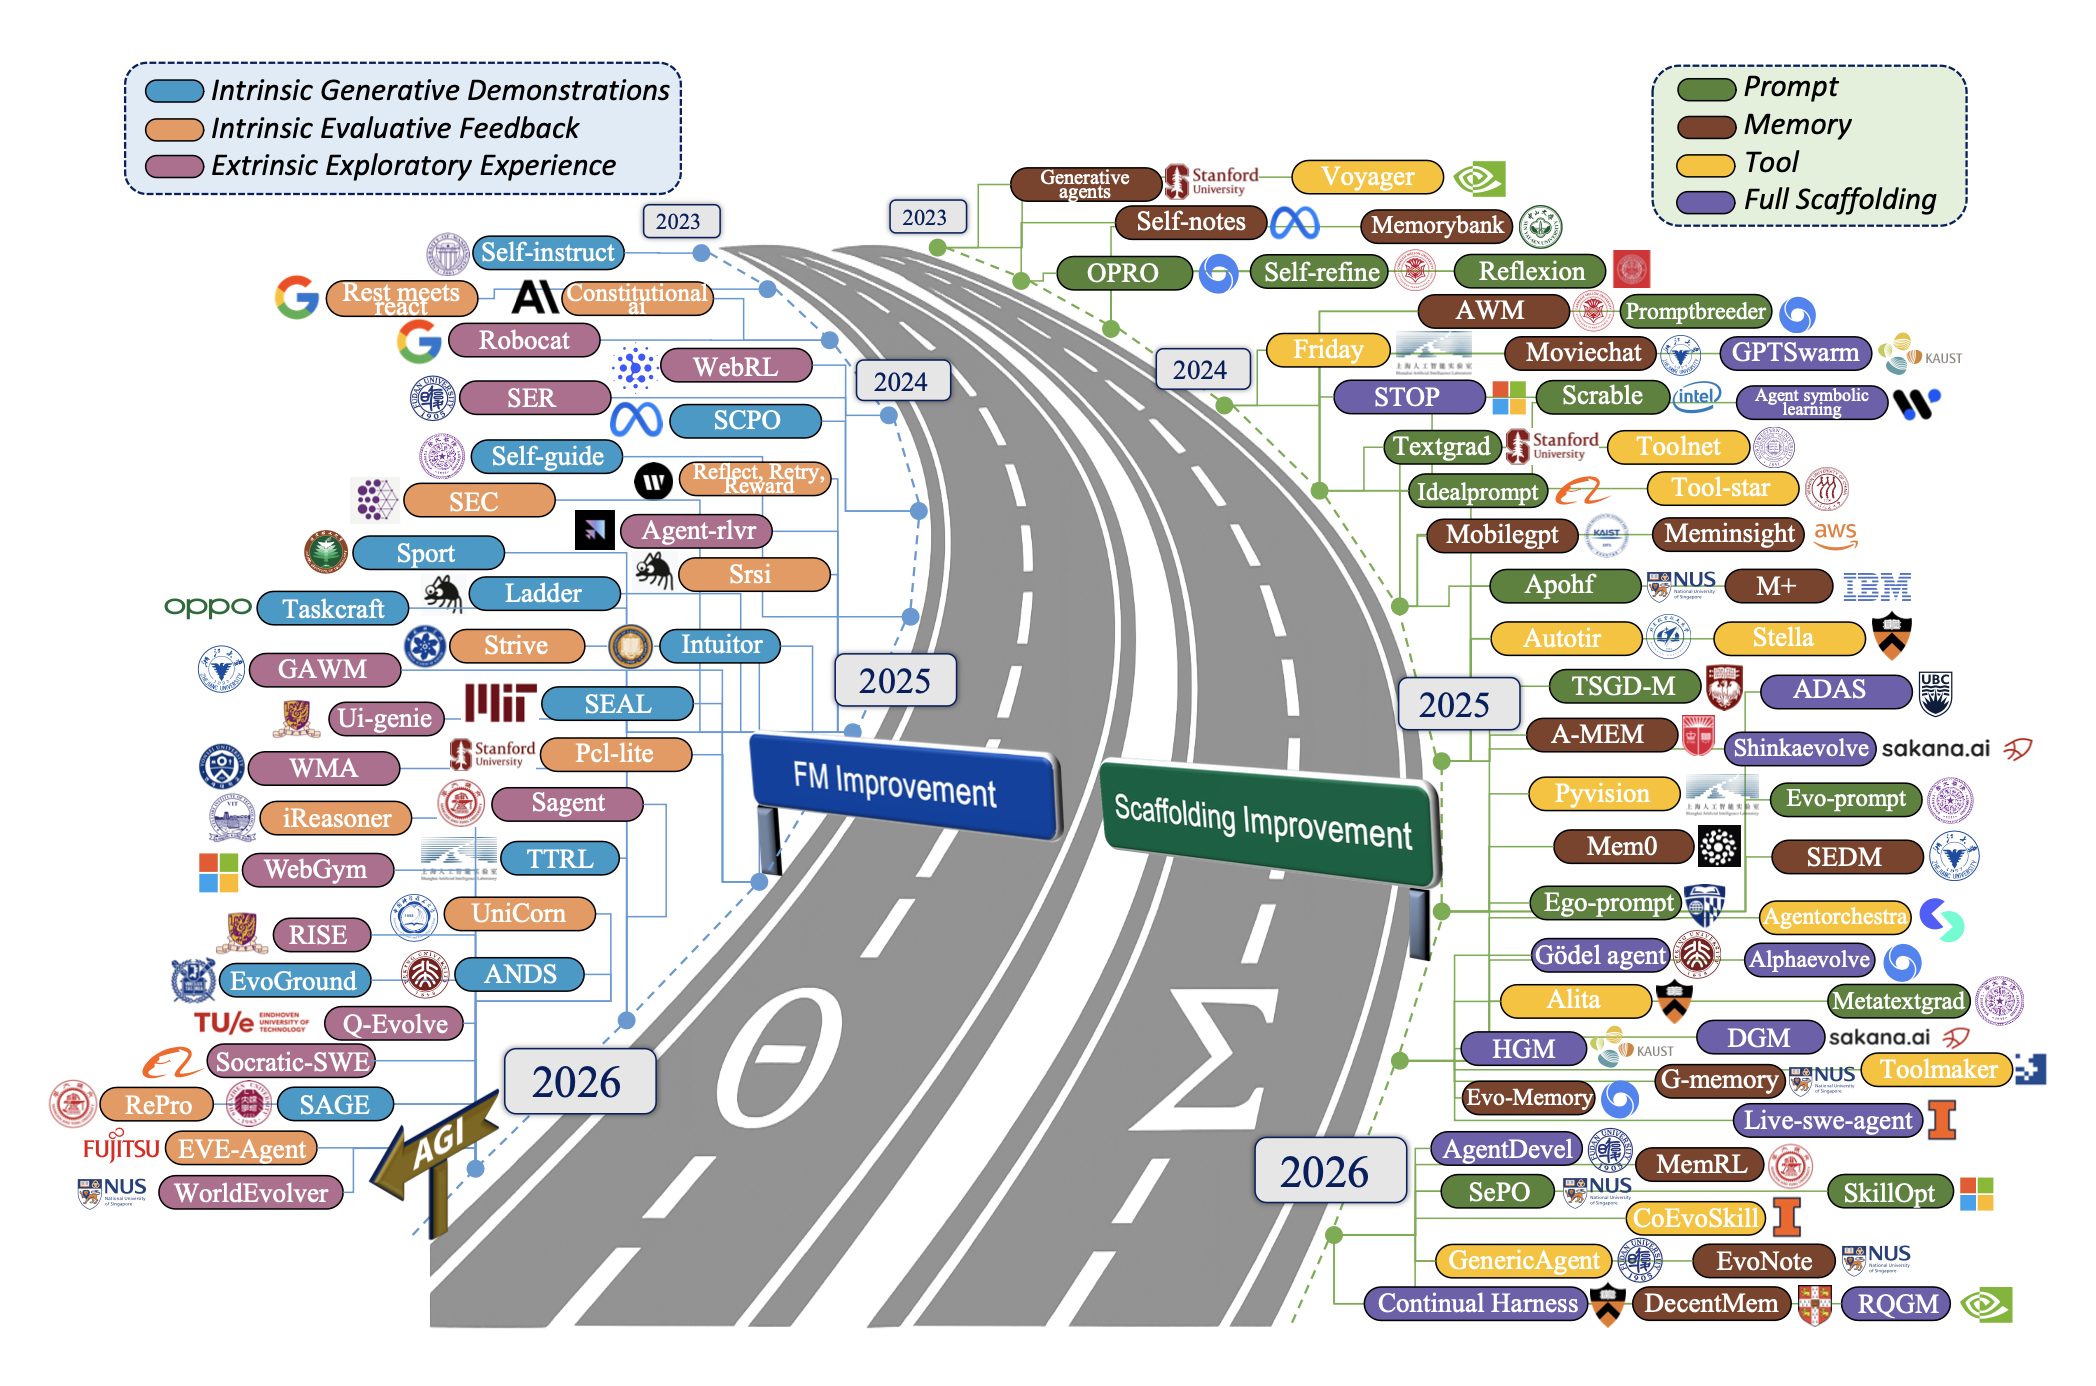
自我改进并非现代基础模型所独有,它是人工智能的根本目标之一。标准机器学习在固定架构内优化参数,而真正的自我改进则要求系统显式地检查并重写自身的运行逻辑、启发式算法或学习算法。如图 4 所示,这些机制已在多个历史范式中成功实现。通过追溯这一思想谱系,阐明早期系统如何在限定的领域内实现自我改进,以及现代基础模型如何提供一个高度表达力强、通用的底层架构,从而将这些既定原则扩展到开放的现实世界环境中。 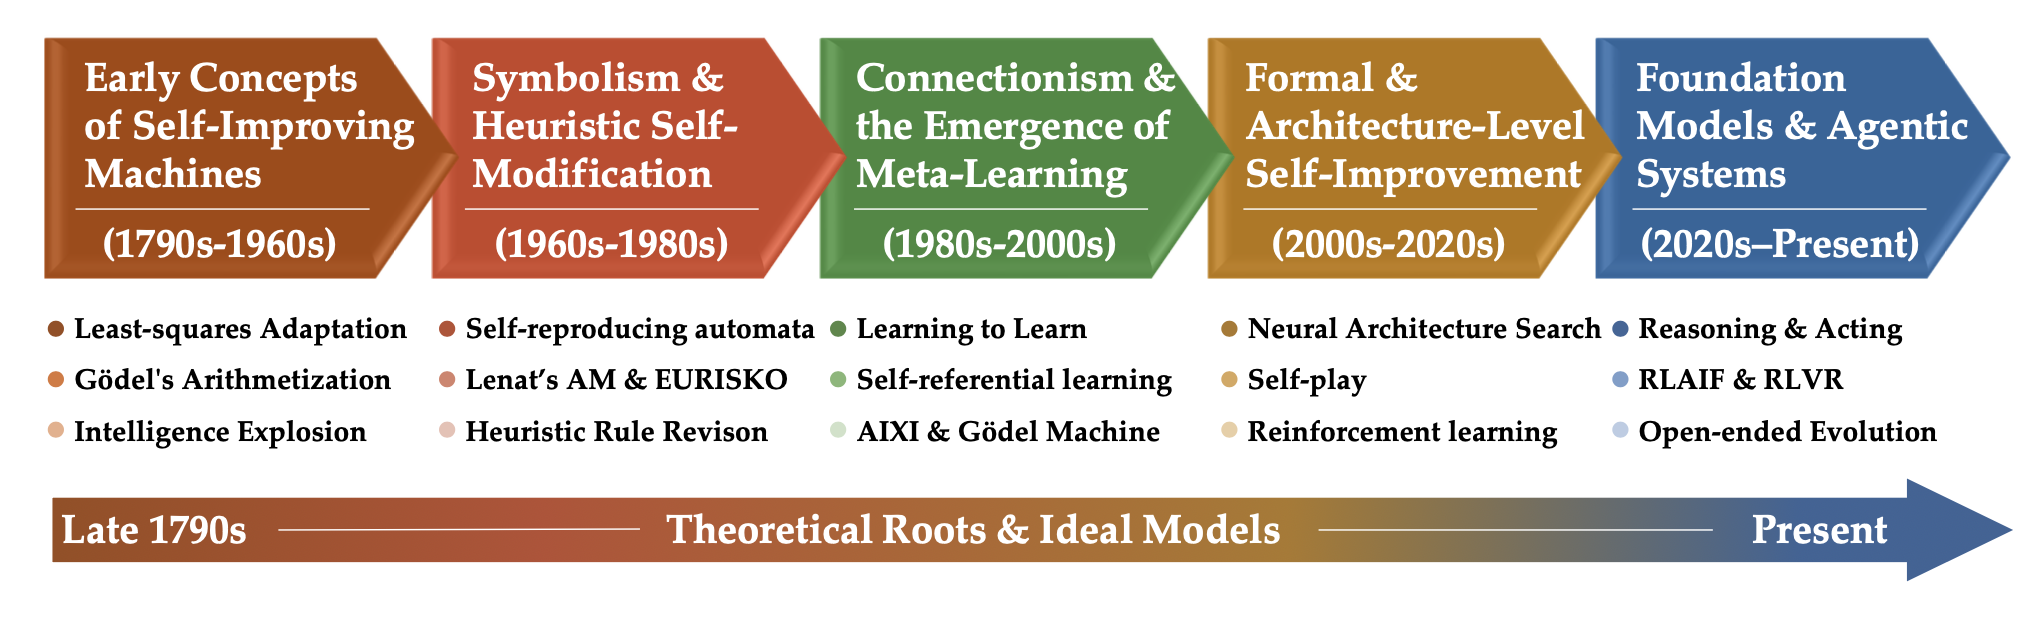
自主智体的核心在于感知环境、更新内部状态并执行动作以实现特定目标。尽管此类系统已推动人工智能研究数十年,但本综述仅聚焦于一类当代智体:基于基础模型的智体,这类智体以大型基础模型作为其核心认知引擎。至关重要的是,它们利用自然语言作为统一接口,整合感知、推理和工具操作。由于基础模型本质上是一个无状态推理引擎,因此实现自主性需要将这一认知核心与一个持久的交互式框架相结合。
脚手架 Σ_t 规定基础模型如何被设定、接地并与外部世界连接,其中 θ_t 是封装基础模型的神经参数,p_t 表示结构化提示或系统指令,m_t 表示记忆机制及其检索和更新策略,T_t 表示外部工具集及其调用接口,g_t 表示额外的控制逻辑,例如路由、调度或安全约束。图 5 展示了这些组件与模型内部参数之间的交互,该图提供该形式化框架下基于 FM 智体的示意图。θ_t 和 Σ_t 共同决定了智体如何进行推理、计划和行动。 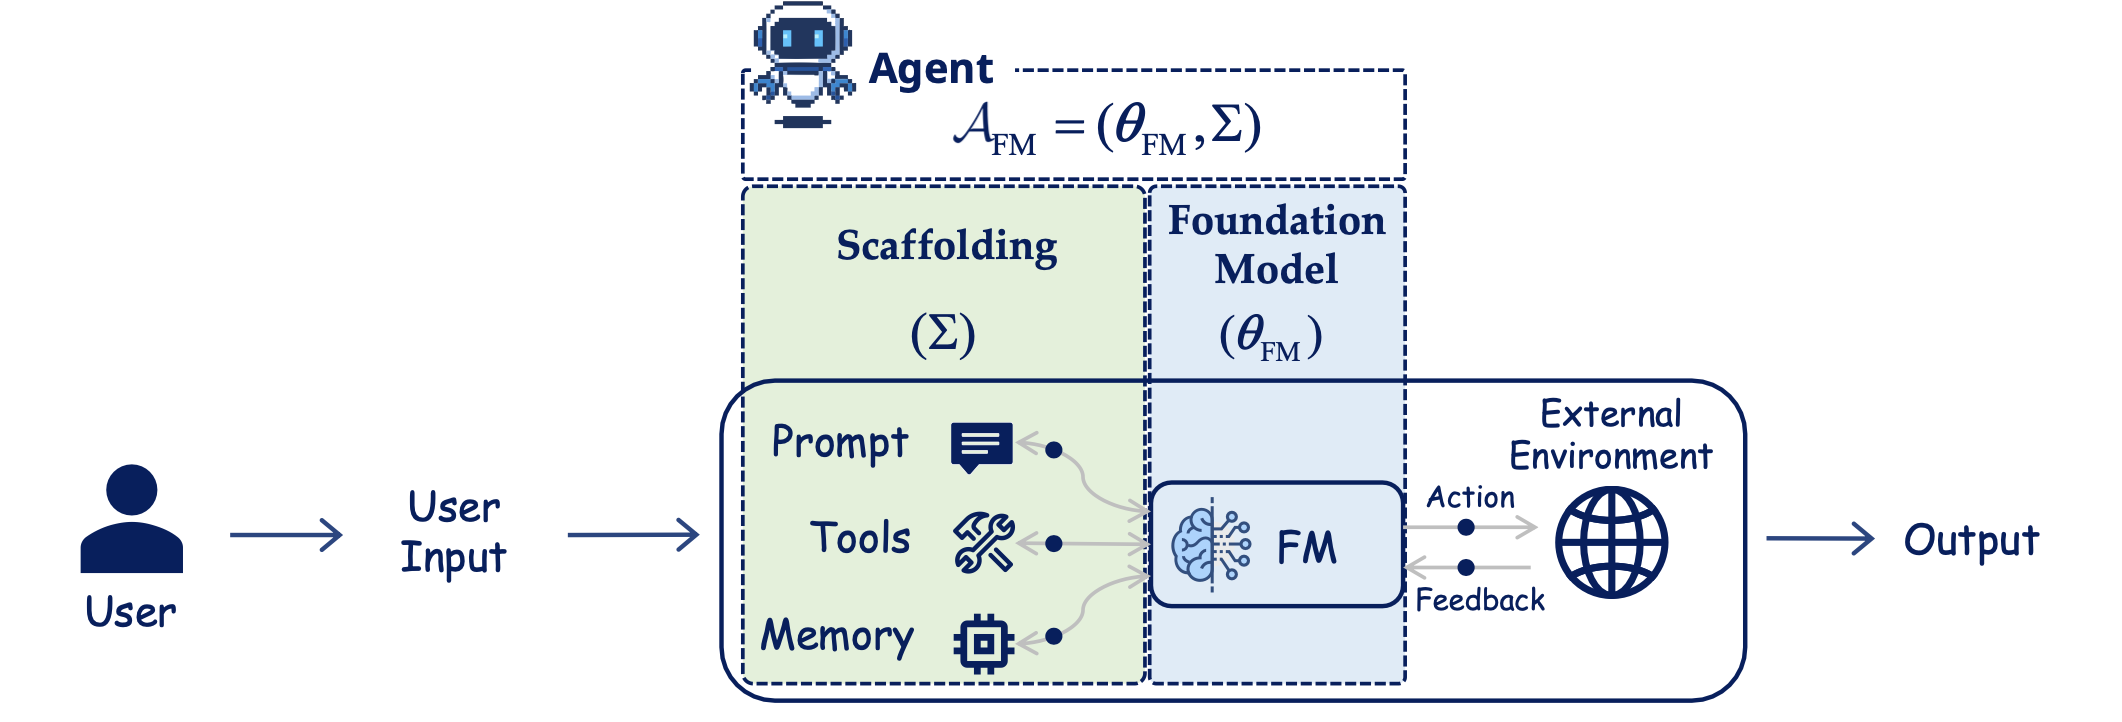
在执行过程中,为了将这种内在配置与外部环境连接起来,智体维护一个临时执行状态 X_t(例如,KV缓存、中间计划或短期工作记忆),该状态会随着智体处理交互流而演化。为了将这种结构定义与可观察的行为联系起来,有必要阐明智体的配置如何生成其动作选择机制。尽管基础模型参数θ_t实现一个通用的生成分布,但智体的实际行为是由θ_t及其操作脚手架Σ_t共同决定的。
基于形式化配置 A_t = (θ_t, Σ_t),将基于基础模型智体中的自我改进(SI-FMA)形式化为一个持续的、内生的适应过程。自我改进智体植根于显式自参照(self-referential)元学习的基本原理(Schmidhuber,1987;1993;Schmidhuber,1997),积极利用自身执行过程中产生的信号——例如交互结果、批评、验证结果或建议的修改——来持久地修改其底层计算组件。
SI-FMA 可能在多个性质不同的层面上具有自指性(self-reference)。
在第一种模式下,智体的策略通过生成经验或辅助工件(作为学习信号)来间接地促进改进。自我生成的轨迹、评估、偏好或合成标签构成学习目标,随后被更新规则(例如作用于基础模型参数 θ_t 的外部优化程序)所利用。这种模式在分布层面上实现了自我改进:智体的行为塑造了决定其未来参数的数据和监督。
在第二种模式下,智体的策略通过修改自身操作定义的组成部分来直接实现改进。智体可以通过其动作编辑提示模板、管理或重组记忆、重新配置工具界面或更改控制逻辑,从而显式地更新控制未来执行的框架 Σ_t。在这种情况下,自我改进是通过直接的、动作层面的自我修改来实现的。
这两种模式对应于截然不同但又互补的范式。基础模型改进通过在参数空间中进行自我诱导学习来实现自我改进,而脚手架式改进则通过在执行空间中进行直接自我修改来实现自我改进。它们共同揭示基于基础模型改进的智体随时间推移而自我改变的主要机制。
在基础模型改进中,自改进的目标是在保持智体层面框架不变的情况下,调整底层基础模型的参数。从诱导策略π_{θ_t ,Σ_t}出发,智体在环境中反复执行,通过自身的交互轨迹生成自诱导经验。
在脚手架改进中,自改进的目标是在保持模型参数θ不变的情况下,改进围绕基础模型的智体层结构。脚手架Σ_t控制着历史数据如何转换为基础模型的条件上下文,工具调用如何指定和执行,内存如何存储和检索,以及更一般地,如何约束token序列使其对应于有效且可执行的动作。通过这些机制,Σ_t塑造了智体的有效观察和动作语义,以及智体状态X_t在执行过程中的构建和演化。
技能作为可重复使用的更新。上述两种自参照模式要么间接地通过更新规则合并到参数θ中的自生成信号来实现自我改进,要么直接通过编辑脚手架Σ的动作来实现自我改进;一项技能跨越了这种区别。将技能建模为自诱导更新操作符 U 的可重用实例:对智体自身配置的命名更新,它保留并重用。获得一项技能会将这种更新序列化为 A_t 的基础之一:工具及其调用约定 (T )、指令或工作流程 §、内存条目 (m)、综合权重 (θ) 或控制逻辑 (g)。技能的身份是它编码的更新;基材仅命名其存储位置。技能库是这些序列化更新的结构化存储和检索策略;相同的存储和检索结构在基板上重复出现,这就是它在工具路由和内存组织中出现的原因。
可重用性有两种形式。一项技能可以被重复调用,作为跨任务多次调用的保留例程,或者以安装程序的方式应用一次:单个更新,其价值在于它留下的持久更改,但它仍然是可移植的工件,可跨智体和会话重用。无论哪种方式,技能都是一流的、序列化的操作员,这与不留下任何痕迹的临时一次性操作形成鲜明对比。
根据调用的技能的作用范围进一步区分两个范围。对象级技能作用于任务或世界状态:调用它通过执行运算符 E 运行一个(通常是多步骤)例程来执行子任务(例如,学习的收集木材例程),这是分层强化学习中时间扩展选项的智体模拟(Sutton,1999;Bacon,2017)。这里的 U 步骤在于获取,它将例程写入其底层(例如 T ),而不是调用。相反,元级技能作用于智体自己的配置:调用它会编辑 Σ_t 的组件或触发参数更新(例如,编写新工具、重构提示、将经验合并到内存中或修补自己的脚手架)。上述类似安装人员的技能本质上是元级别的。对于自我提升来说,元层面的范围是中心范围。因为元级技能既作用于 A_t,又本身序列化回 A_t,因此运算符可以成为其自身操作数的一部分。一旦这种技能依次得到改进,就会恢复自参照循环,其中改进者与其改进的系统一起进化(Schmidhuber,1987;1993;2003b)。
技能可以作为工具,也作为记忆工作流程;应用部分可说明如何跨任务调用和重用所获得的技能。
如图6 所示概述在智体诱导学习信号下基础模型改进方法。智体通过生成内在演示、产生内在评价反馈或收集外在探索经验来改进基础模型,每种方法都构成一个独立的参数更新循环。 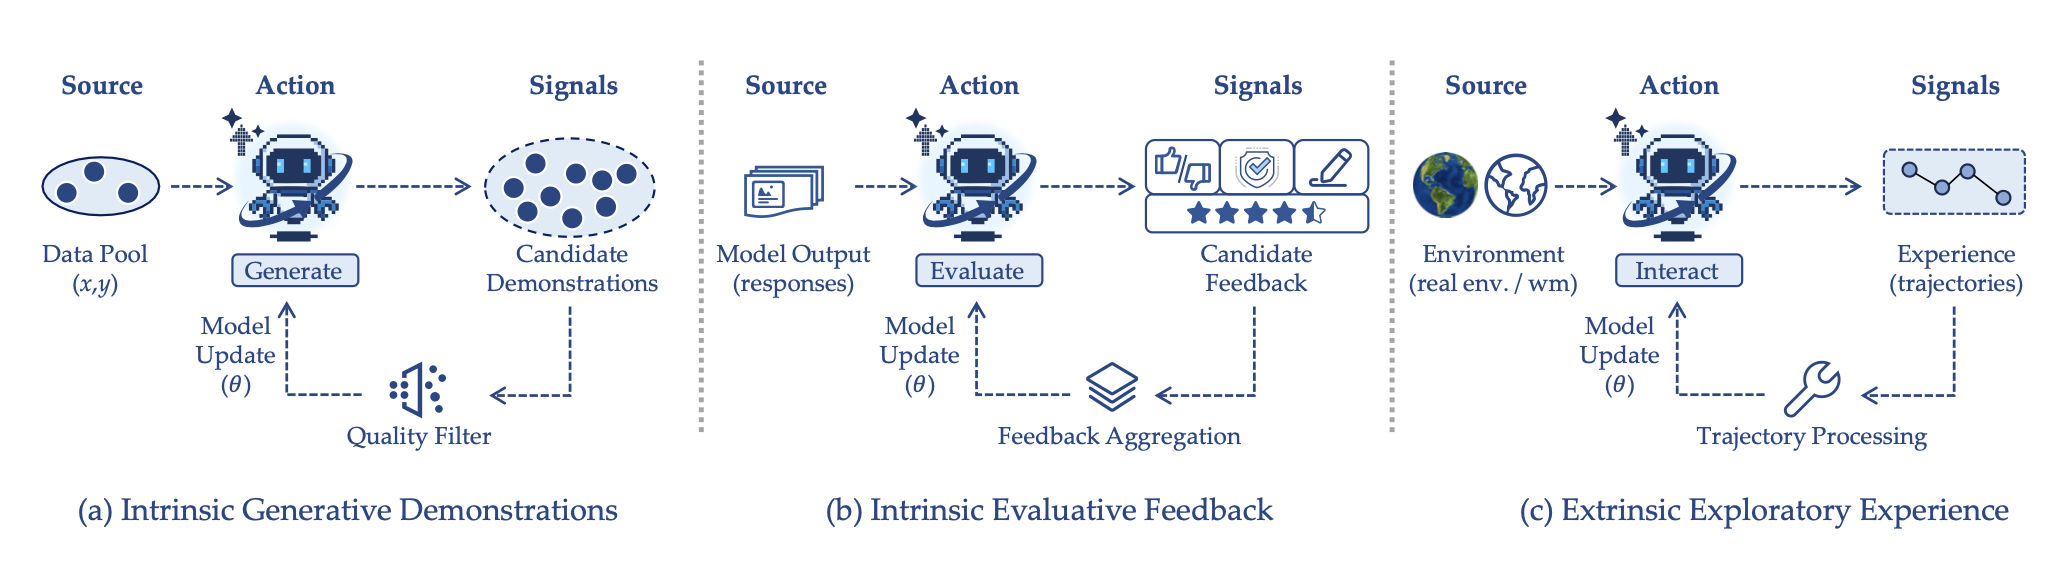
如下算法 1 总结其更新环: 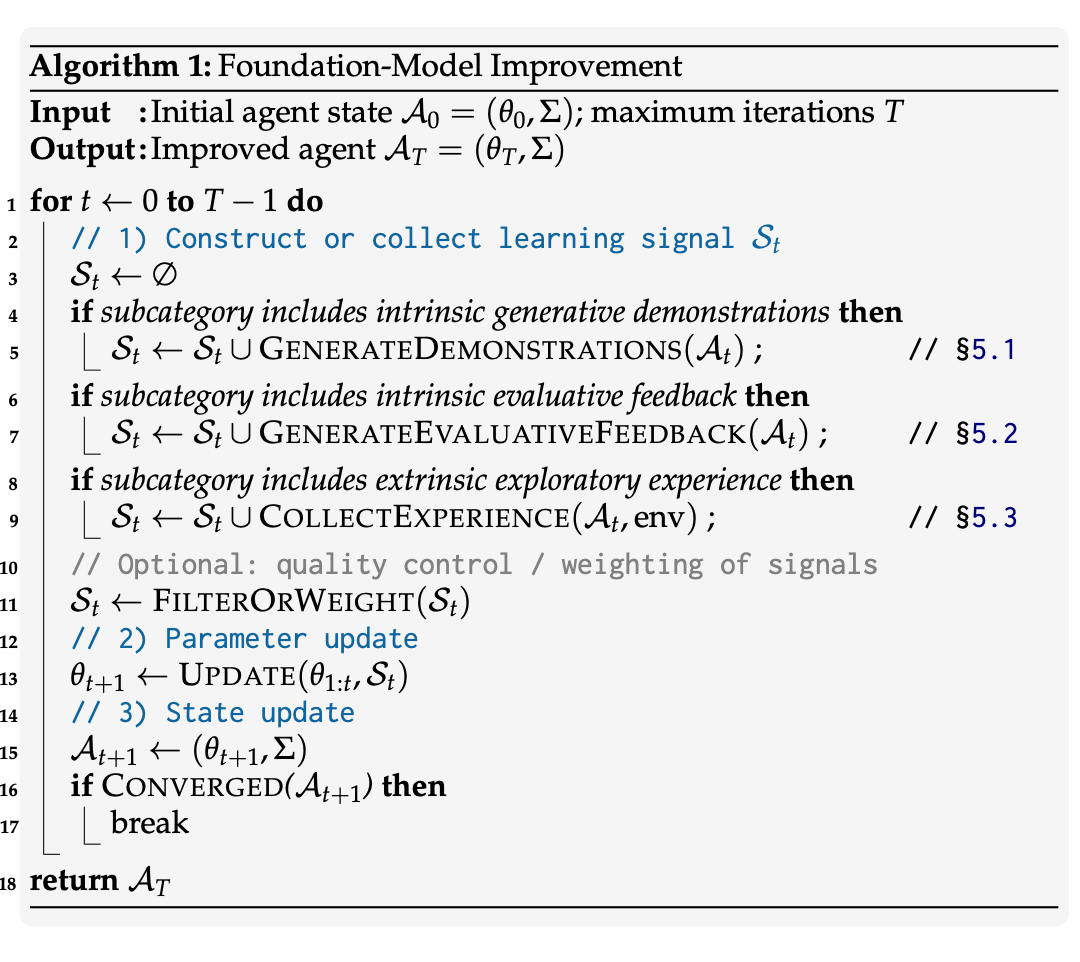
脚手架改进对应于在显式保持基础模型参数冻结 (θ_t+1 = θ_t) 的情况下修改操作脚手架的转换。由执行衍生的学习信号 S_t(例如,任务结果、评价或执行错误)驱动的更新形式化为 Σ_t+1 = IMPROVE_Σ(Σ_1:t; S_t)。通过维护版本历史记录 (Σ_1:t),系统固有地支持对所有组件进行验证和回滚,以防止有害修改。通过逐步加深架构干预来构建讨论。具体而言,将脚手架实例化为 Σ_t := (p_t, m_t, T_t, g_t),其中 p_t 表示提示模板,m_t 表示内部存储器,T_t 表示外部工具集,g_t 表示控制逻辑。算法 2 总结了跨这些组件的通用改进循环:
• 基于提示的改进针对智体的输入和指令层,形式化为 p_t+1 = IMPROVE_p(p_1:t;S_t)。提示是智体感知任务的主要语义接口,优化提示提供一种直接改进任务通信、目标和约束的方法,而无需改变基础模型的内部参数。 • 基于记忆的改进为智体配备一个不断演进的内部认知资源,通过 m_t+1 = IMPROVE_m(m_1:t;S_t) 进行更新。通过动态地存储、修剪和检索过去的经验,智体从无记忆执行转向累积学习,从而支持长时域推理和可靠的适应。 • 基于工具的改进通过更新 T_t+1 = IMPROVE_T (T_1:t; S_t) 来增强智体的执行接口。通过自主地优化和管理外部可调用模块(例如,网络搜索、代码解释器),智体将内部决策转化为精确可执行的操作,从而有效地将其能力扩展到基础模型的固有限制之外。 • 完整的脚手架改进代表最深层次的架构干预,形式化为 Σ_t+1 = IMPROVE_Σ(Σ_1:t; S_t)。通过将整个代码库和操作逻辑视为可变的底层,智体动态地重新配置其感知、推理和执行能力如何整合为一个连贯的整体。 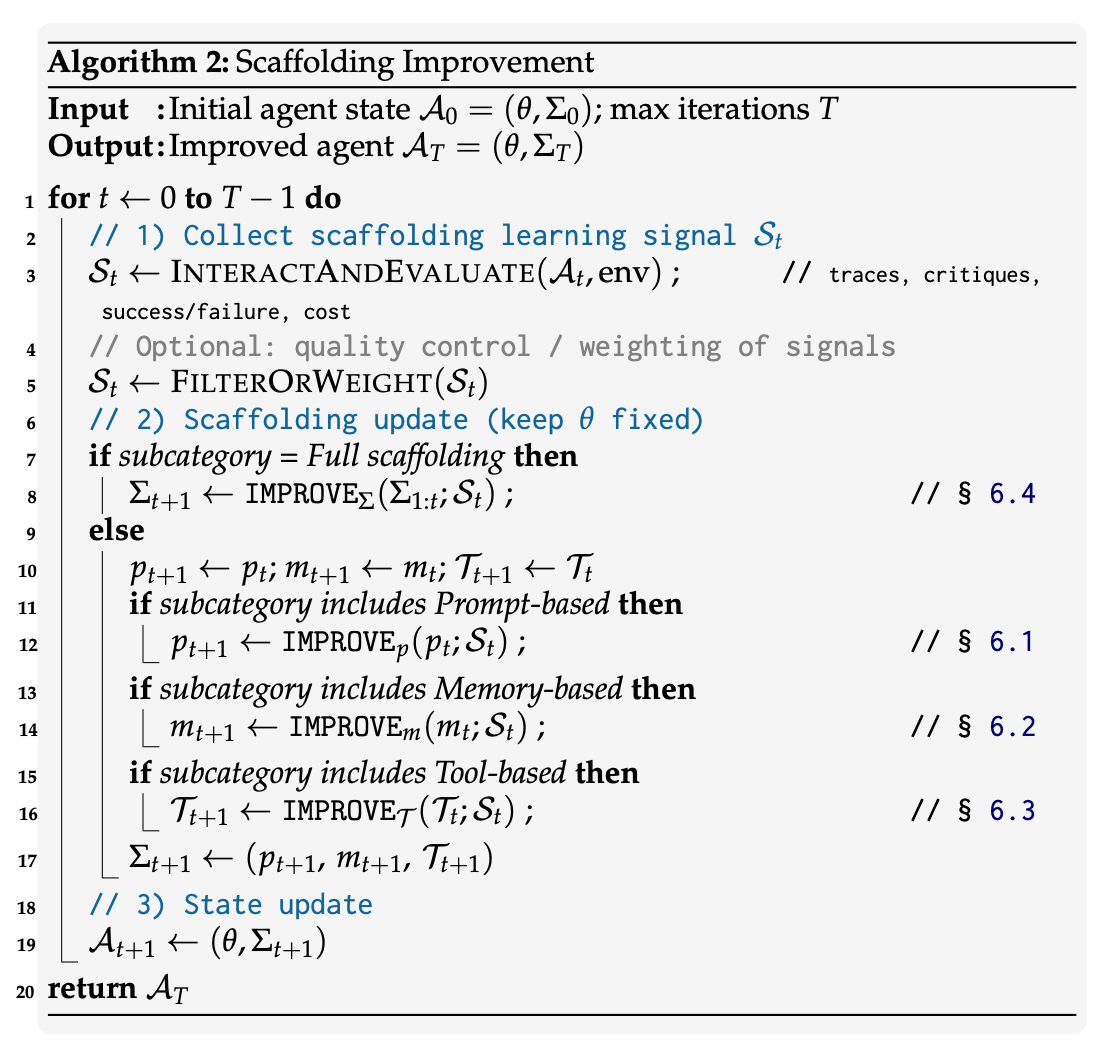
完整的脚手架式自我改进代表了架构干预的最深层次。智体程序并非仅仅调整孤立的组件(例如提示、工具或内存),而是将其整个运行逻辑和代码库视为可变的底层,从而实现根本性的结构重组。如图10 所示: 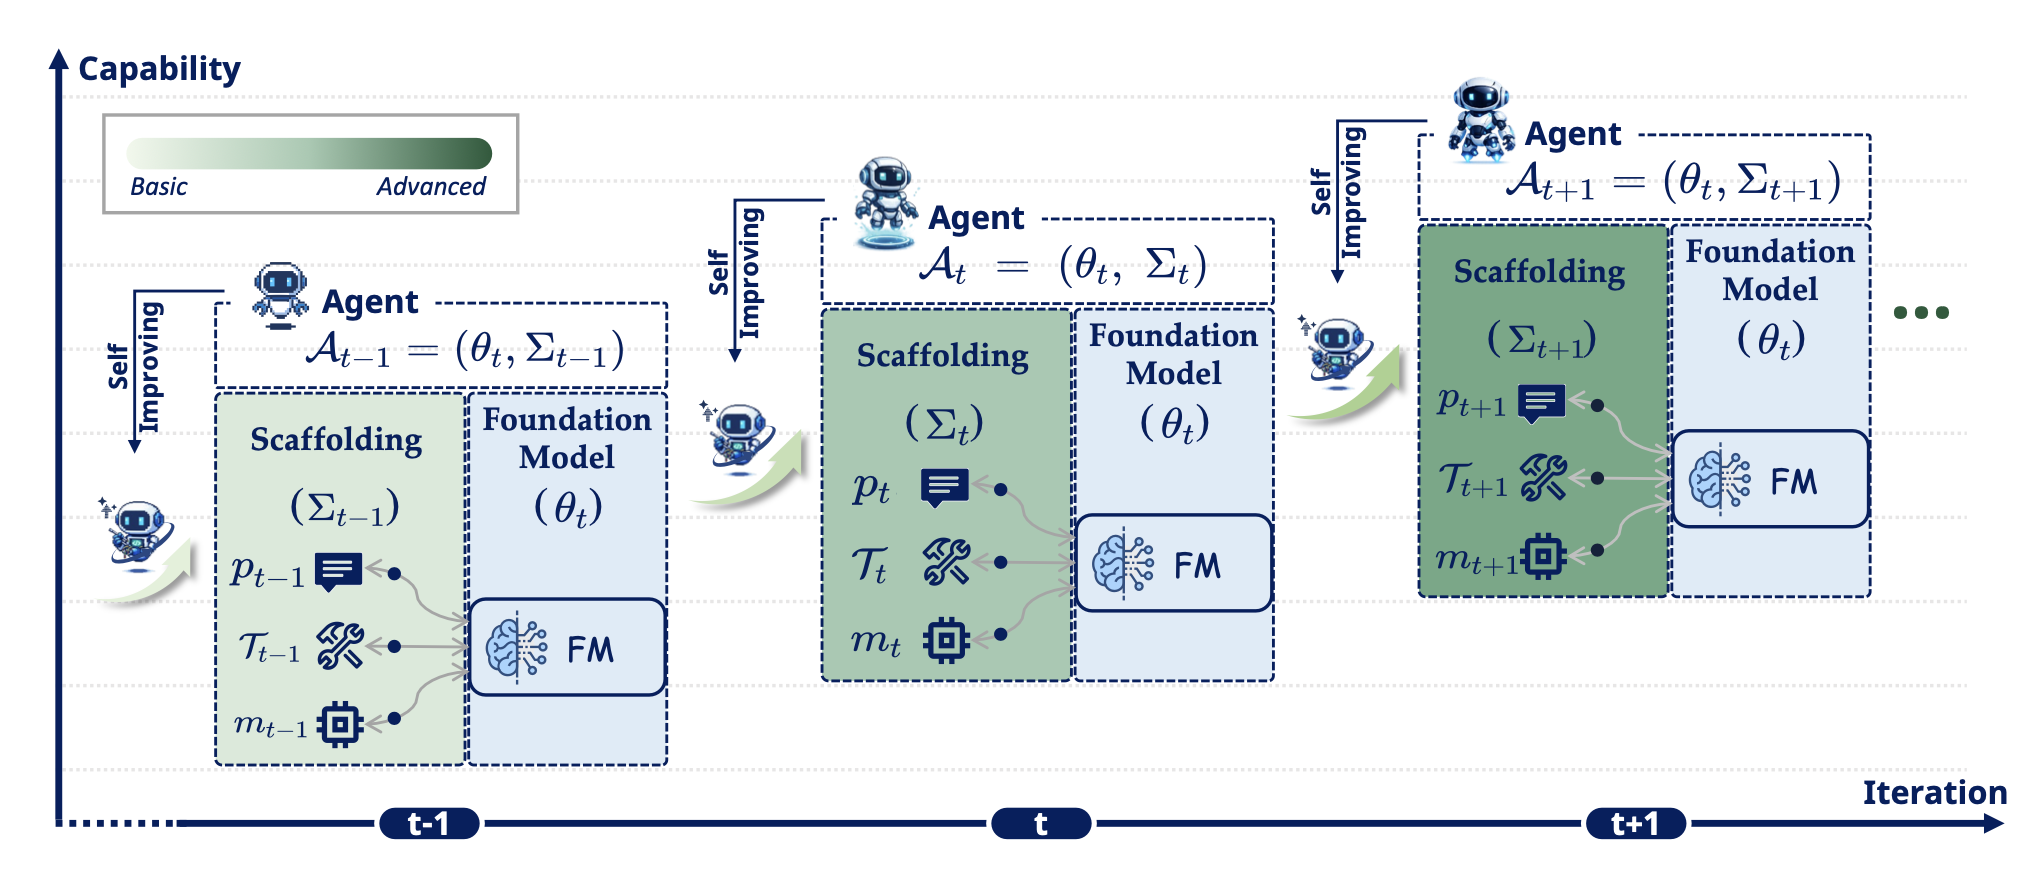
如图11所示是自进化智体的应用: 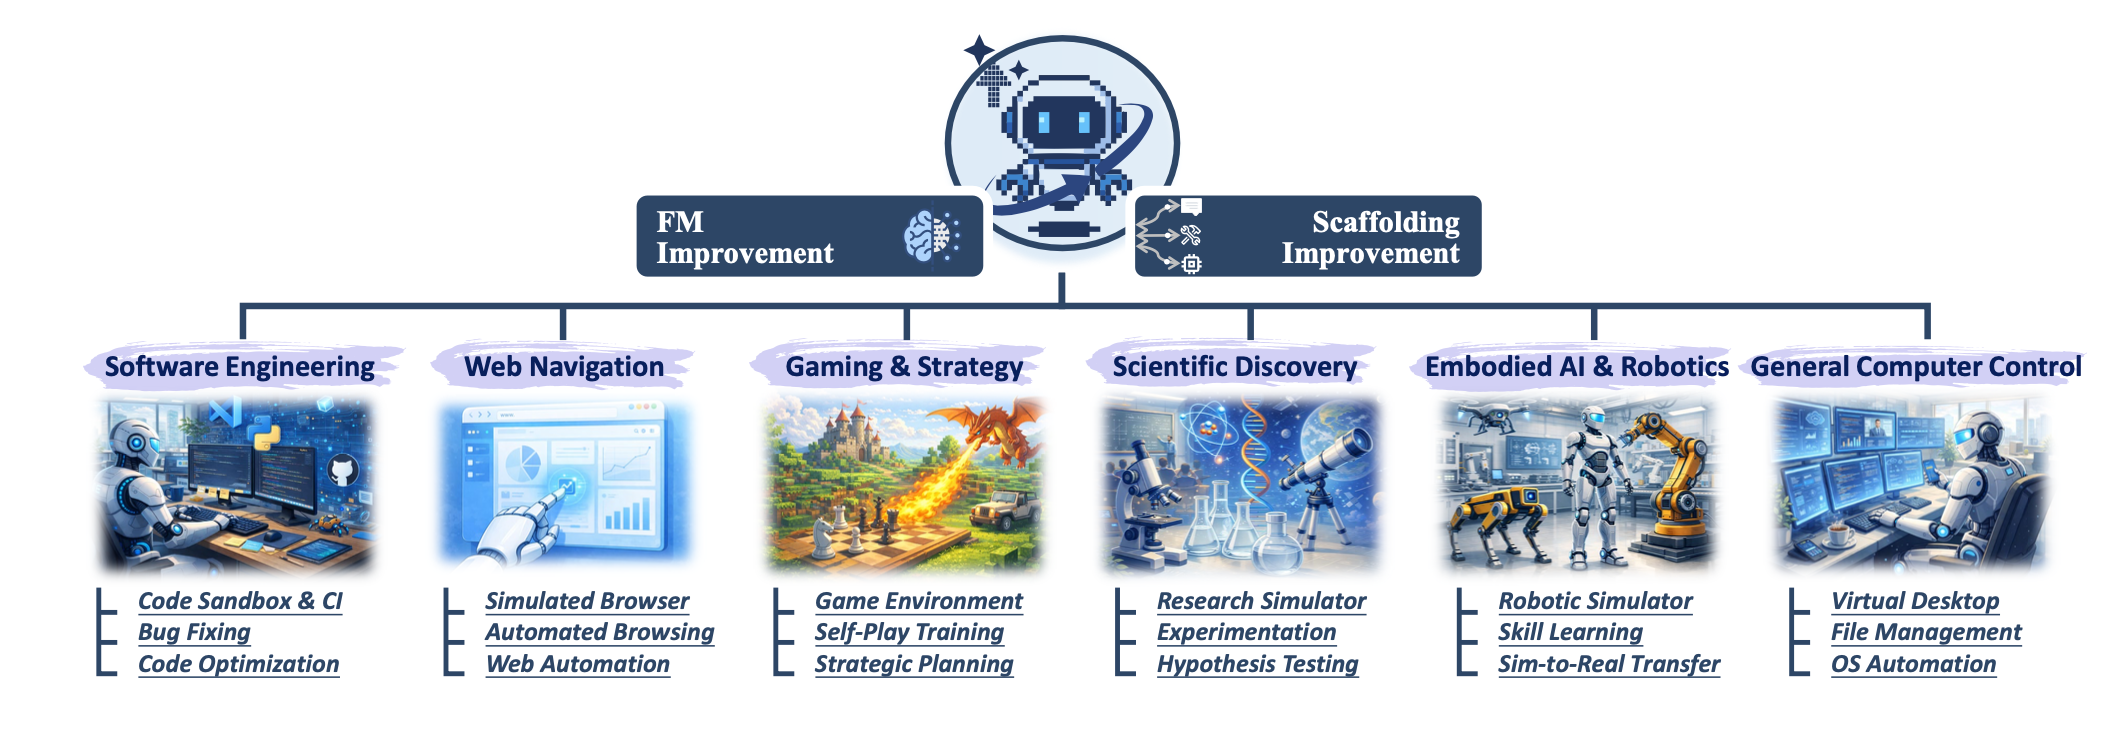
表5所示是应用域视为自我改进的循环。每个域都会产生一个独特的沙箱和学习信号,从而决定主要的瓶颈、主要的改进目标以及迭代模式。
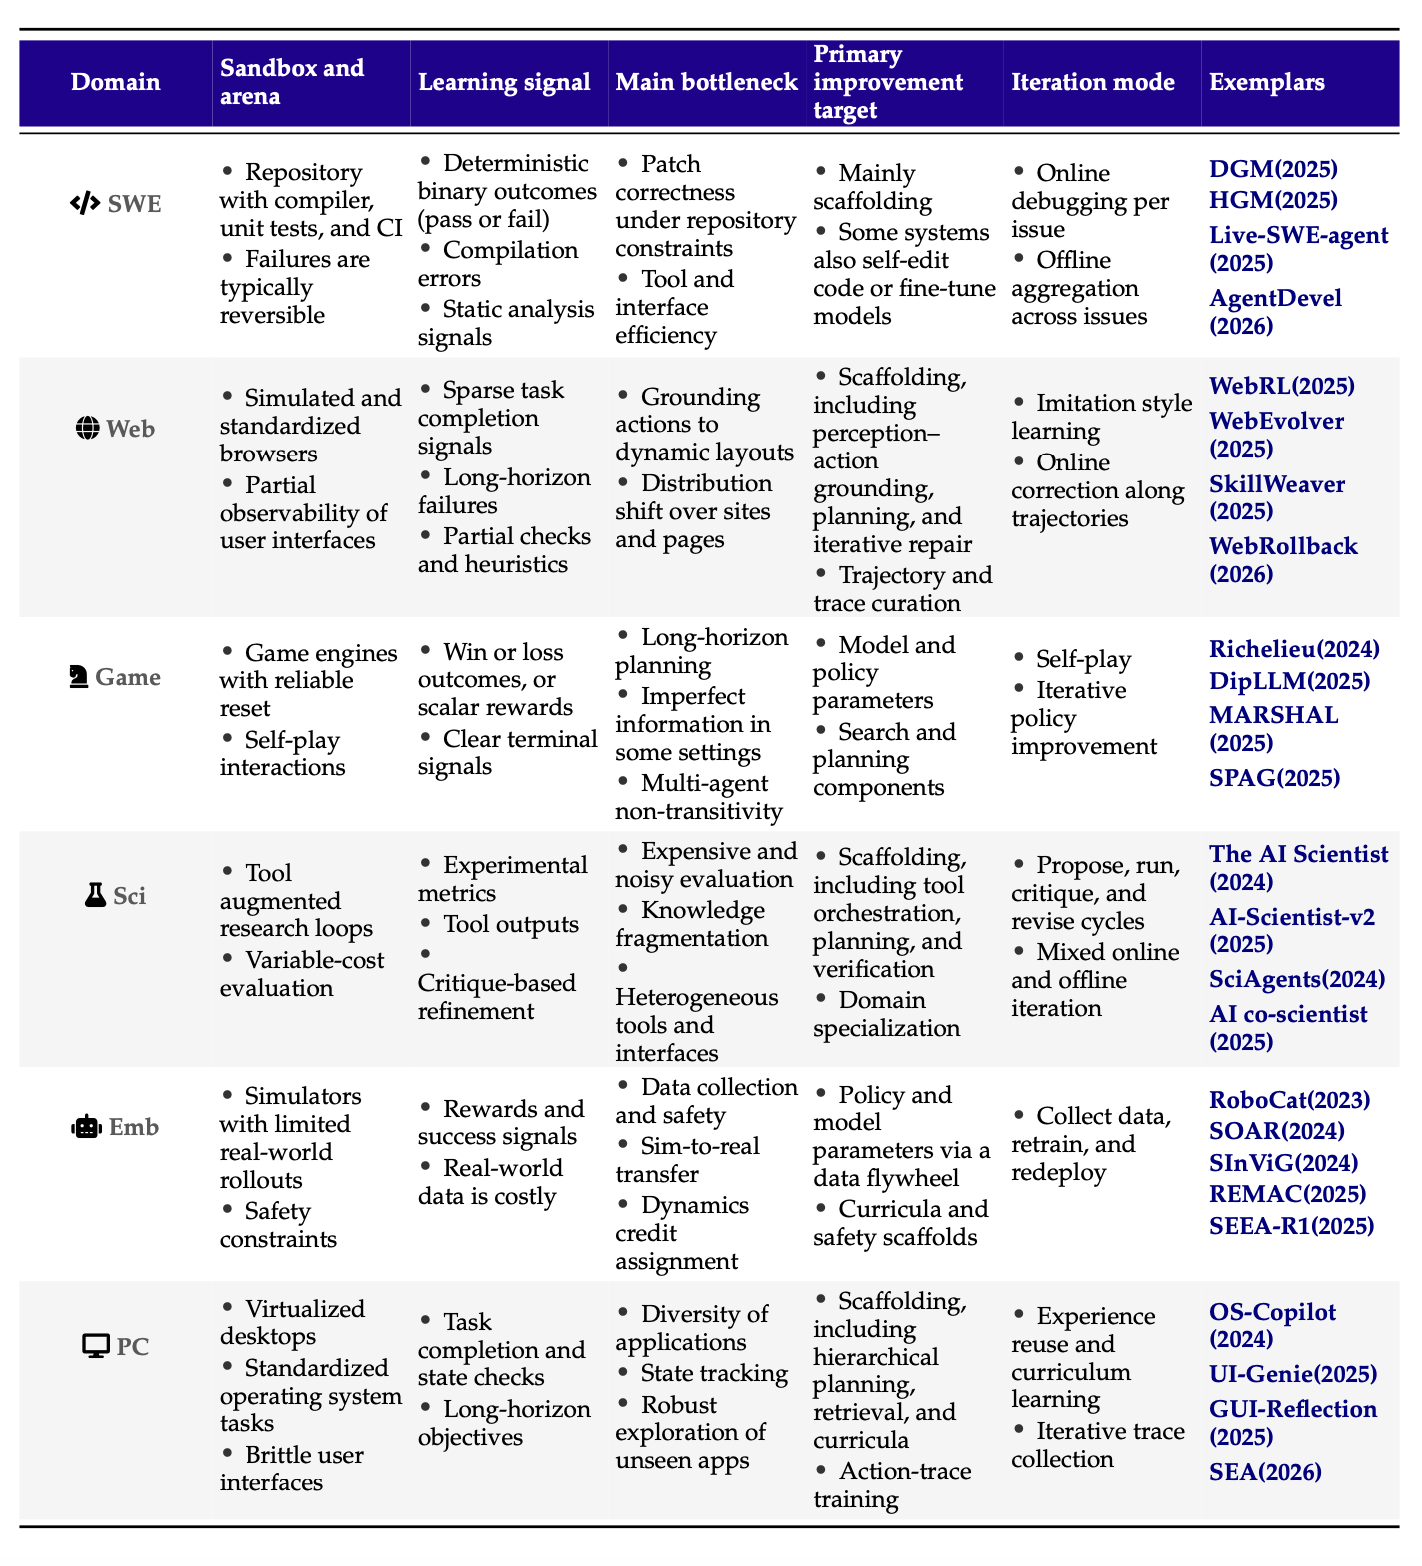
自我改进型智体可能会更新其基础模型的参数,或者改变其脚手架,例如提示、记忆、工具和编排逻辑。因此,评估应将改进视为一个随时间展开的过程。评估还应将实际能力提升与改进流程产生的产物区分开来。为了使不同研究中的改进成果具有可比性,评估协议应明确几个要素。这些要素包括:哪些内容在交互过程中保持不变;哪些反馈信号驱动更新;哪些运行预算限制了智体;以及真正能力转移的边界应该如何界定。
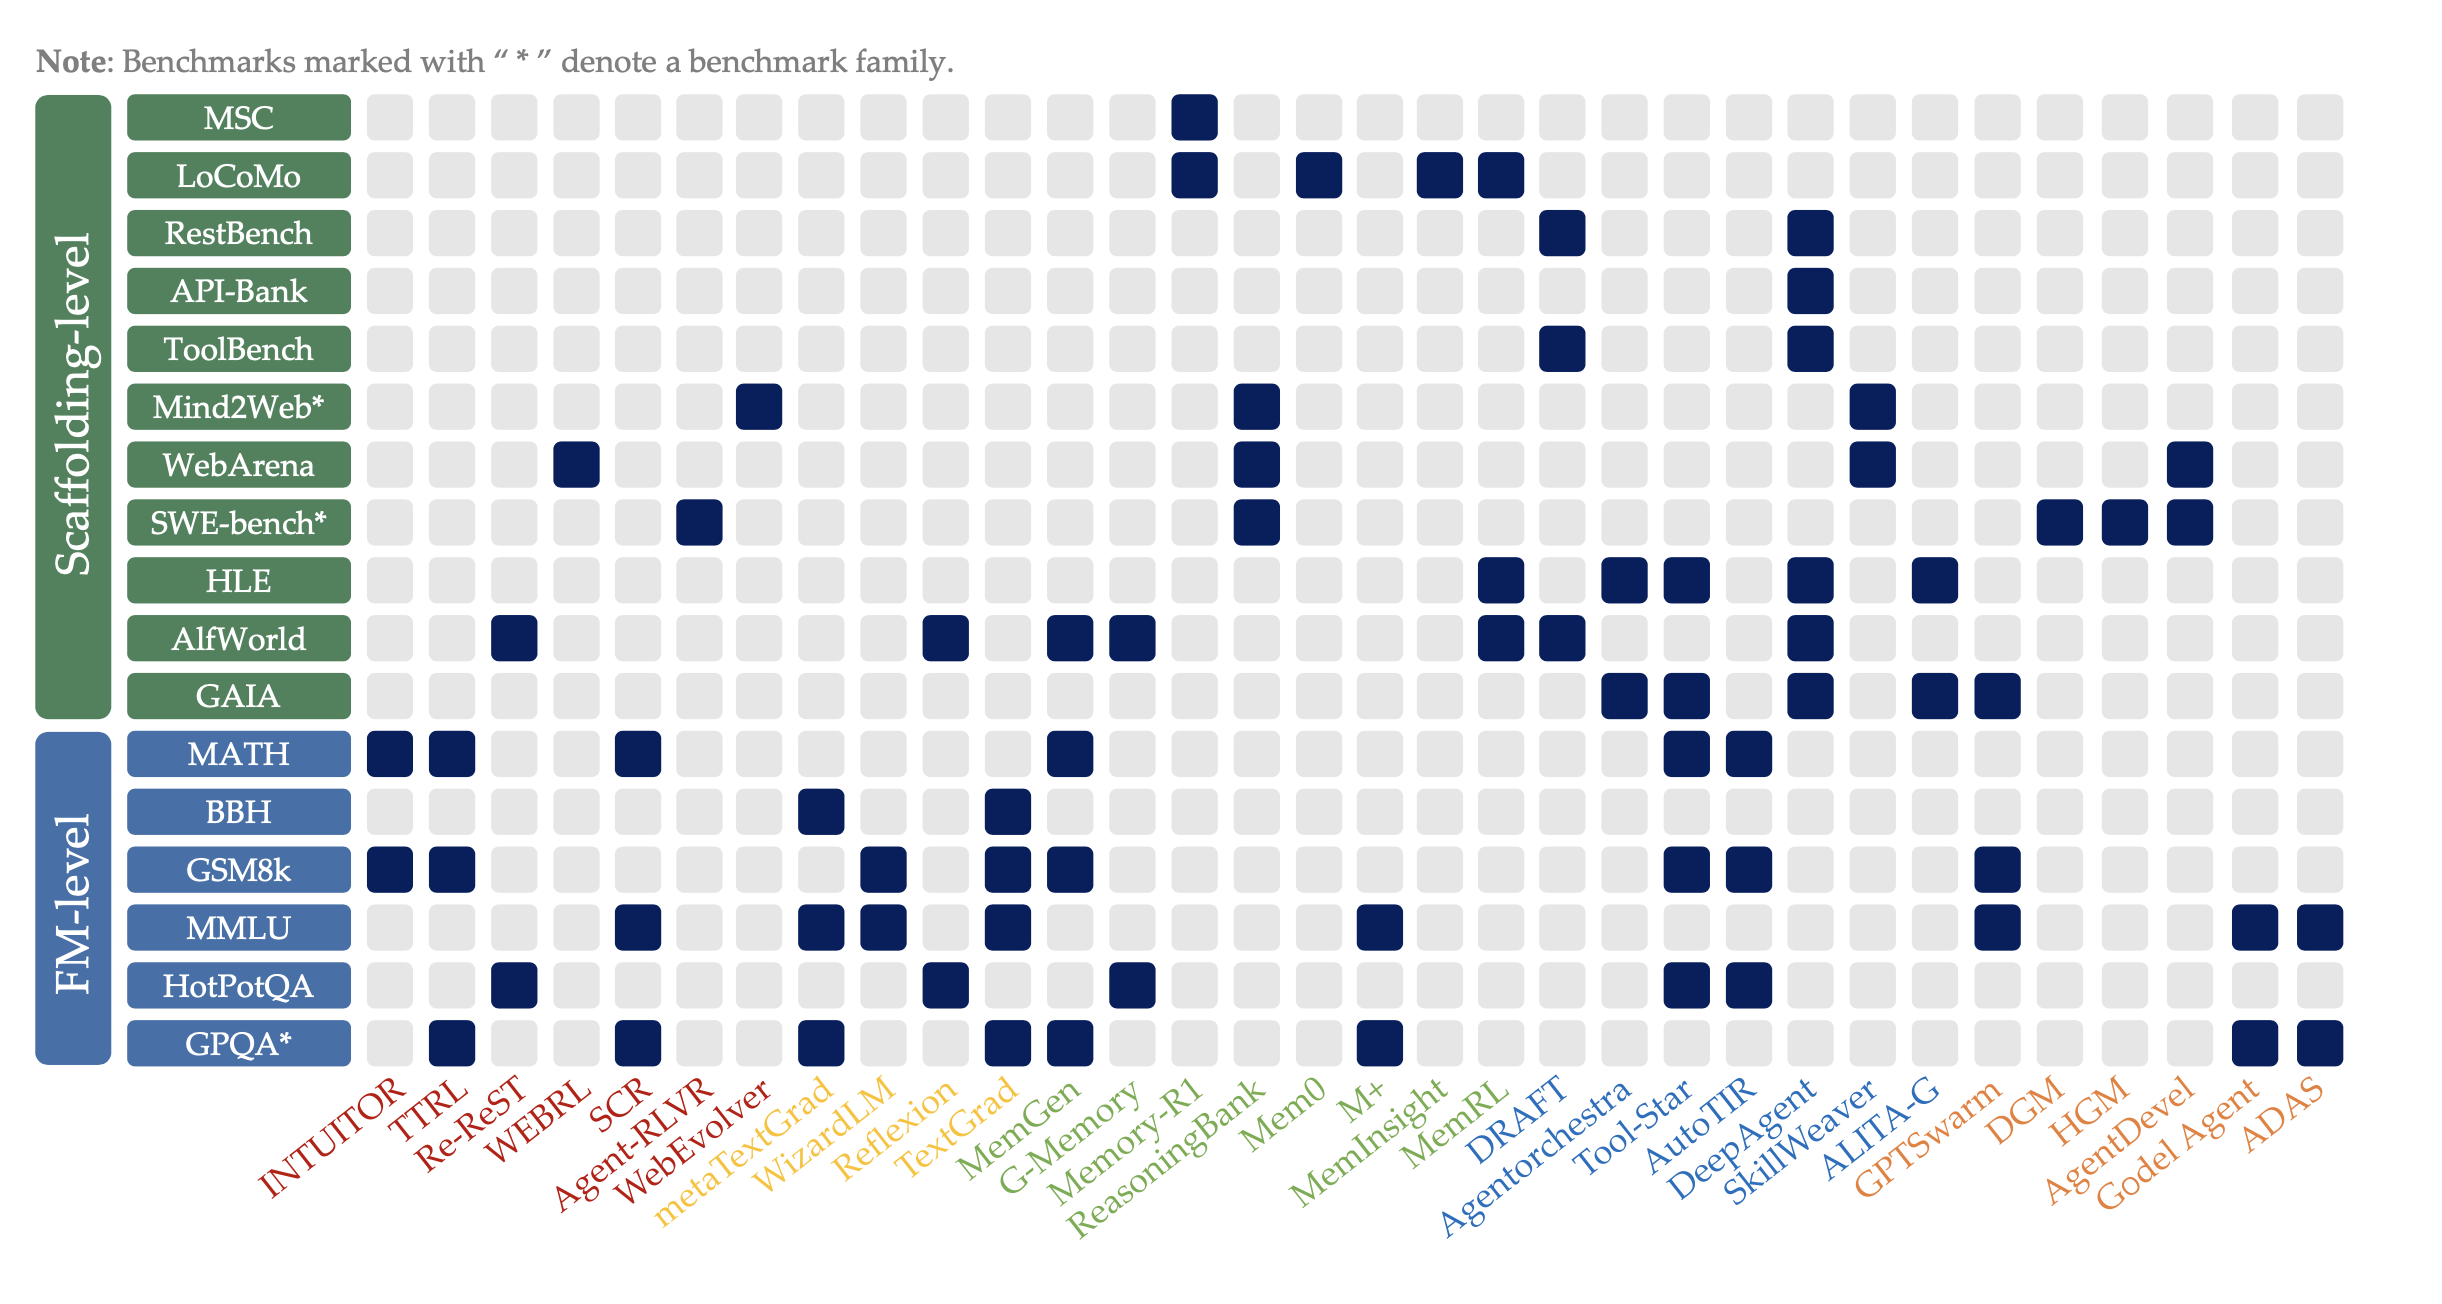
如图12 所示针对自改进智体的论文-基准关联矩阵,涵盖具有代表性的基准测试和方法。行枚举基准测试套件,并按评估接口分组:脚手架级基准测试(交互式、以智体为中心)与模型-模型级基准测试(静态、以模型为中心)。列代表具有代表性的自改进方法;列颜色表示分类法中使用的改进机制:模型-模型改进和提示/记忆/工具/完整脚手架自改进。填充的单元格表示相应的论文使用该基准测试;“*”表示一个基准测试系列。
以下略。