一、本篇要解决什么问题
通用基础大模型能聊天、能写代码,但直接拿来做企业问答,经常会「过时、不懂行、瞎编、不敢喂私有数据」。本篇只讲清楚一件事:
RAG(检索增强生成)是什么、解决什么、标准流程怎么走。
RAG(Retrieval-Augmented Generation)即检索增强生成,为大模型提供了从特定数据源检索到的信息,以此来修正和补充生成的答案。
1.1 学习目标
理解什么是 RAG
理解 RAG 解决什么问题
理解 RAG 的工作流程
1.2 一句公式
RAG = 检索技术 + LLM 提示
二、通用基础大模型存在的问题
通用的基础大模型存在一些问题。概括为「大模型应用的四大问题」,后面用 RAG 一一对应解决。
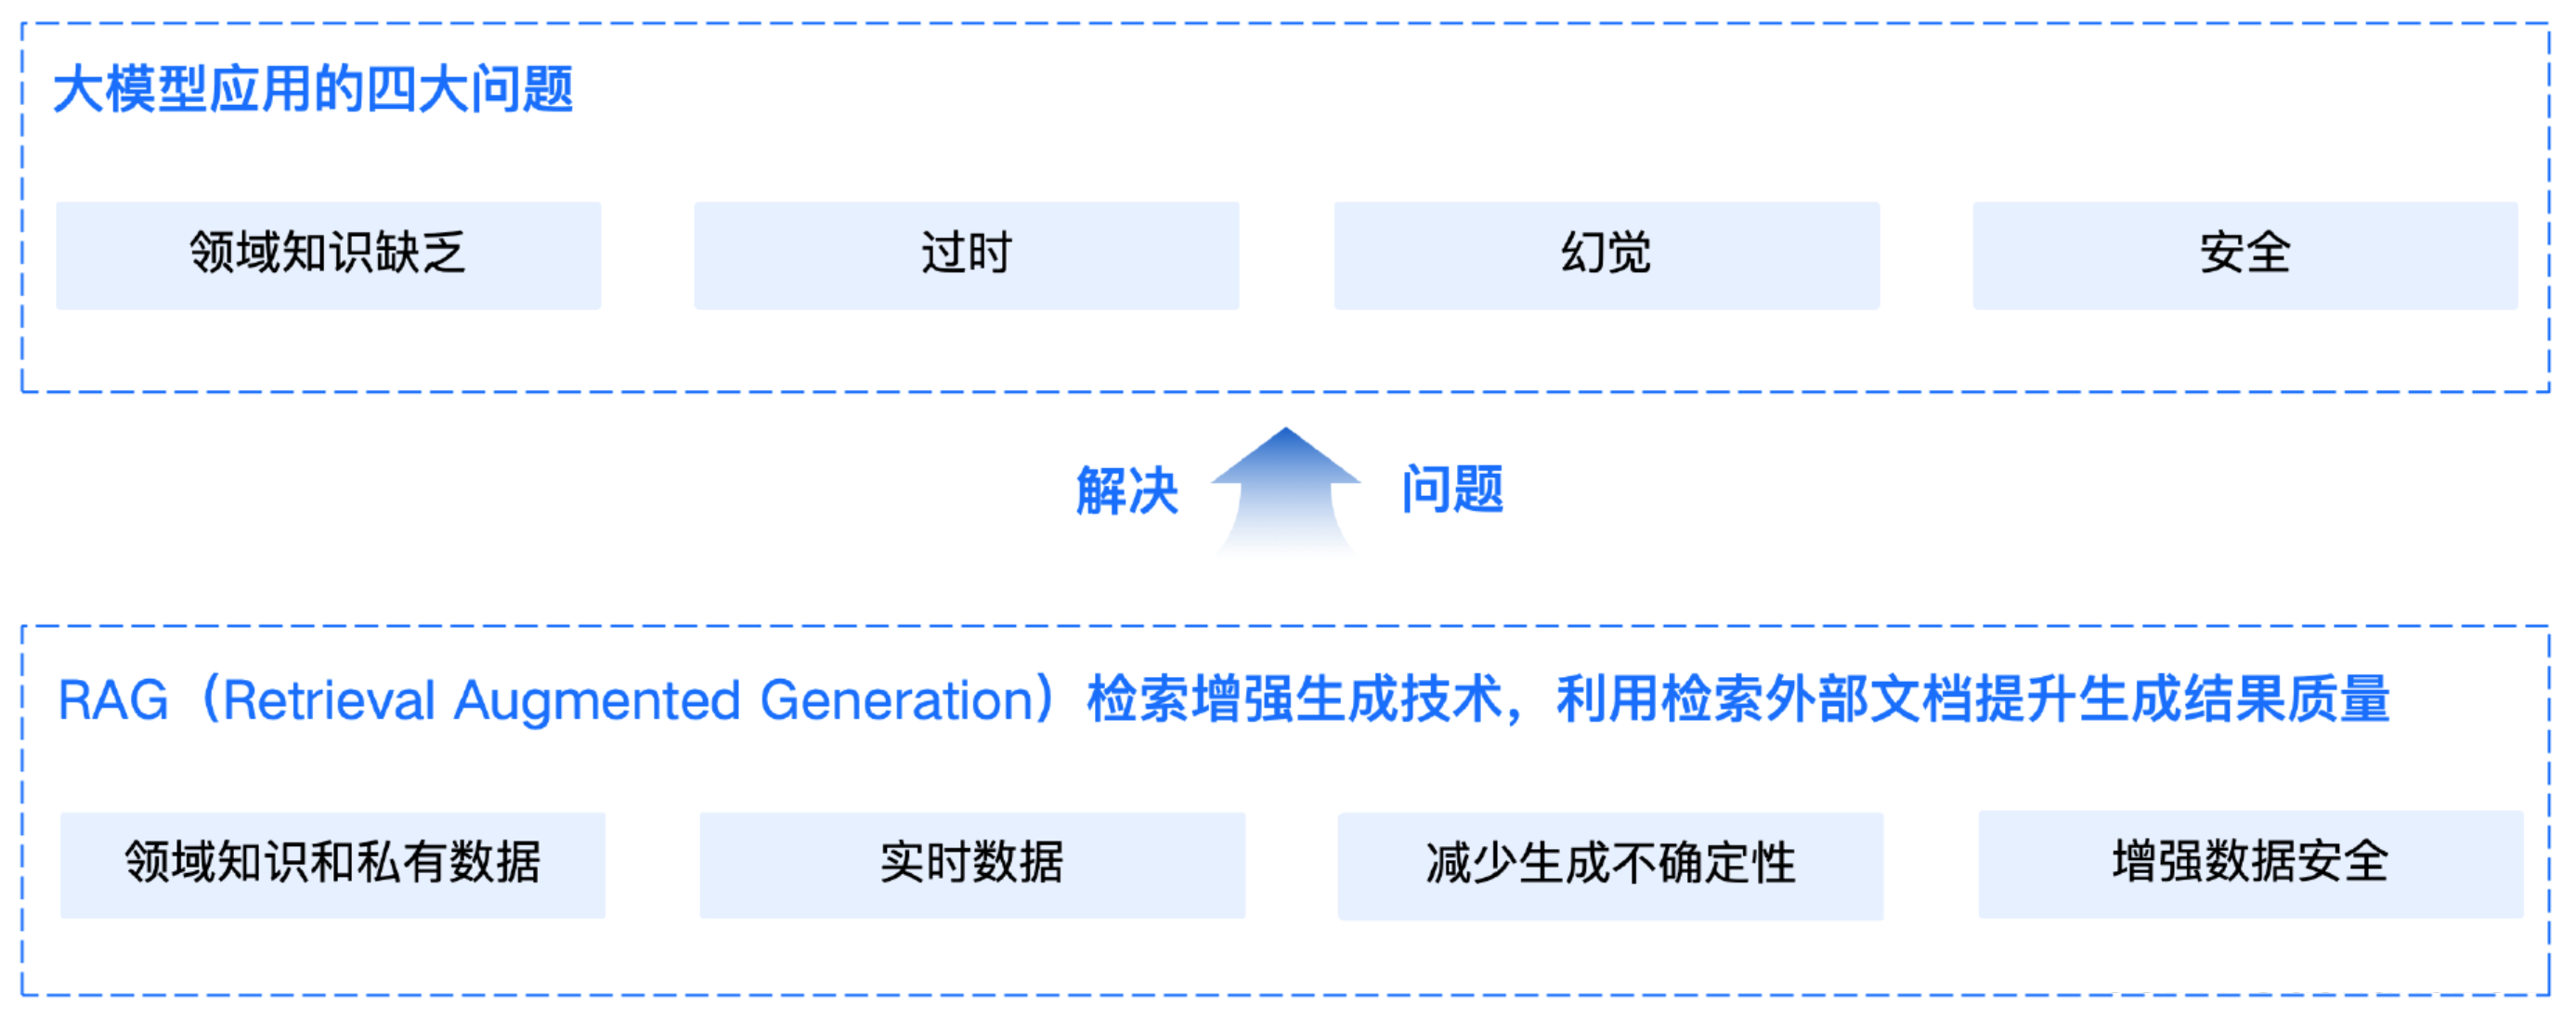
2.1 四个具体问题
2.1.1 知识不是实时的
LLM 的知识不是实时的。模型训练好后不具备自动更新知识的能力,会导致部分信息滞后。
2.1.2 领域知识缺乏
大模型的知识来源于训练数据,这些数据主要来自公开的互联网和开源数据集,无法覆盖特定领域或高度专业化的内部知识。
2.1.3 幻觉问题
LLM 有时会在回答中生成看似合理、但实际上是错误的信息。
2.1.4 数据安全性
私有数据不宜直接塞进训练,但又要能被业务问答使用。
2.2 RAG 如何一一对应
| 领域知识缺乏 | 接入领域知识和私有数据 |
| 过时 | 接入实时数据 |
| 幻觉 | 减少生成不确定性 |
| 安全 | 增强数据安全 |
三、什么是 RAG
3.1 定义
RAG(Retrieval-Augmented Generation)即检索增强生成:为大模型提供从特定数据源检索到的信息,以此来修正和补充生成的答案。
3.2 有无 RAG 的对比
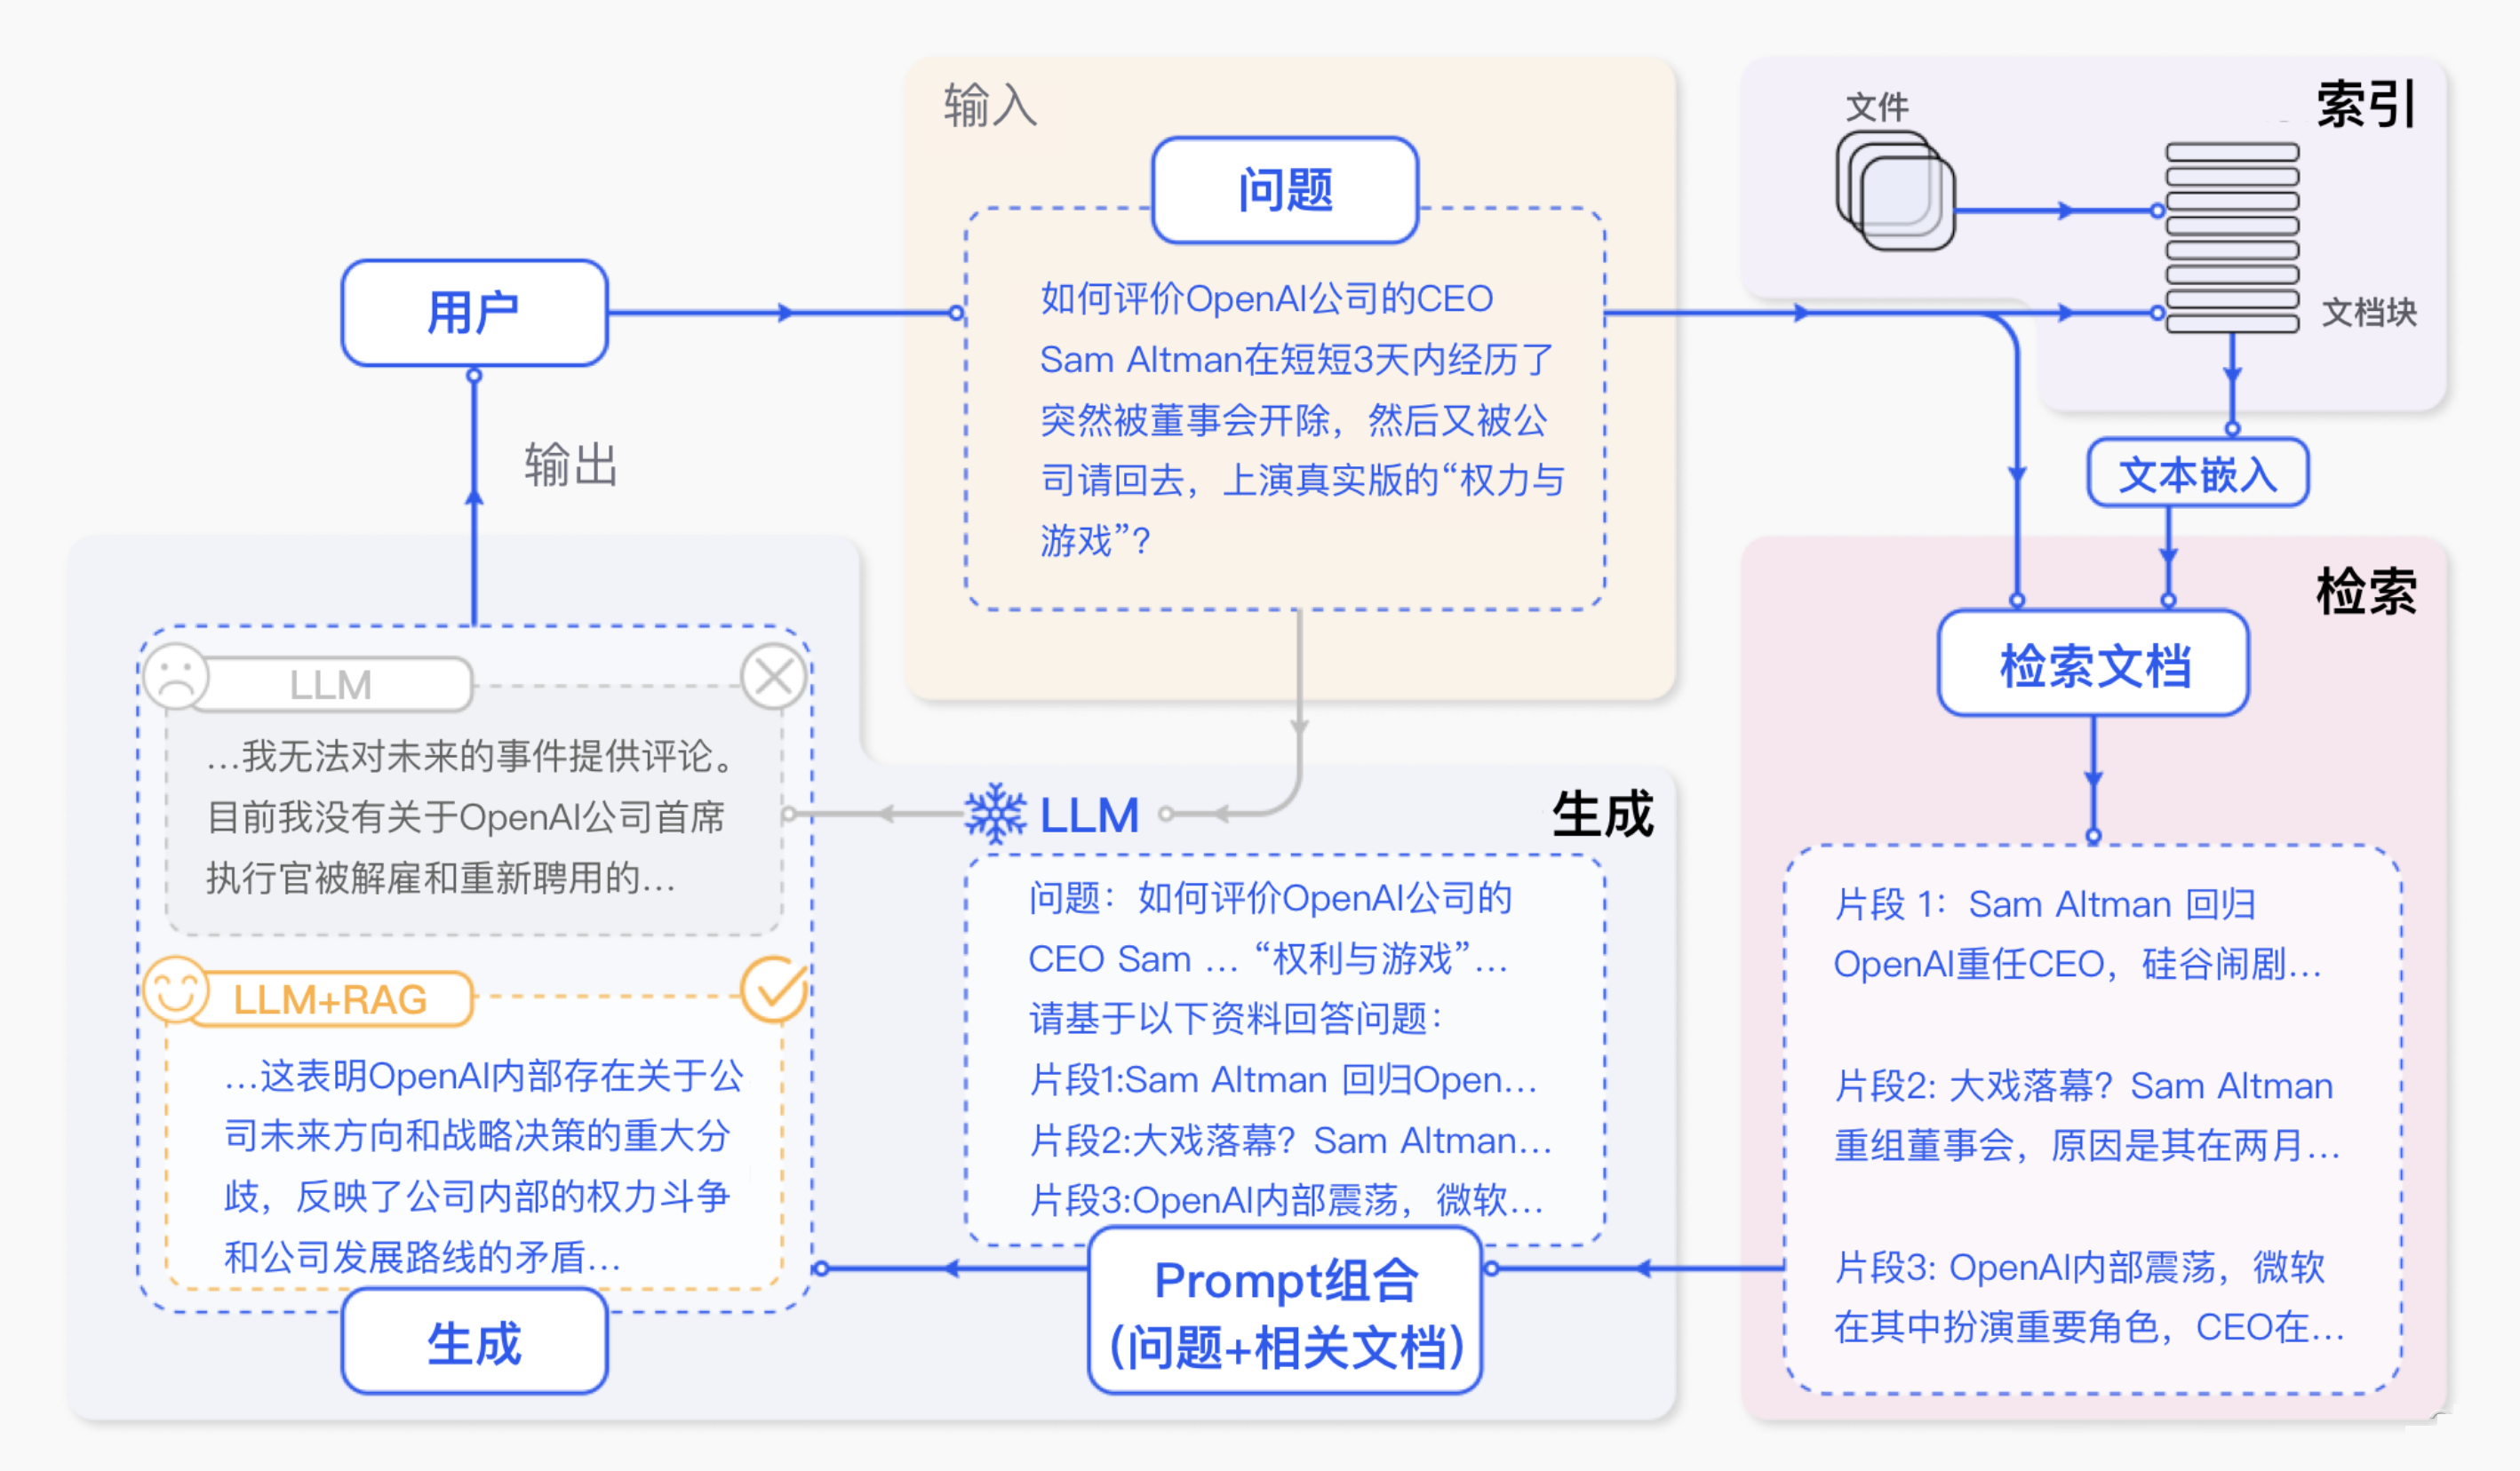
课件用一张「真实新闻问答」图对比「纯 LLM」和「LLM + RAG」:
-
用户问:如何评价 OpenAI CEO Sam Altman 在短短 3 天内被董事会开除、又被请回去这件事。
-
纯 LLM:知识截止,无法评论训练之后才发生的事件。
-
LLM + RAG:先从外部文档检索相关片段(回归 CEO、董事会变动、微软角色等),再和原问题一起组成 Prompt,交给冻结的大模型生成有依据的评价。
四、RAG 的工作原理
4.1 标准三阶段总览
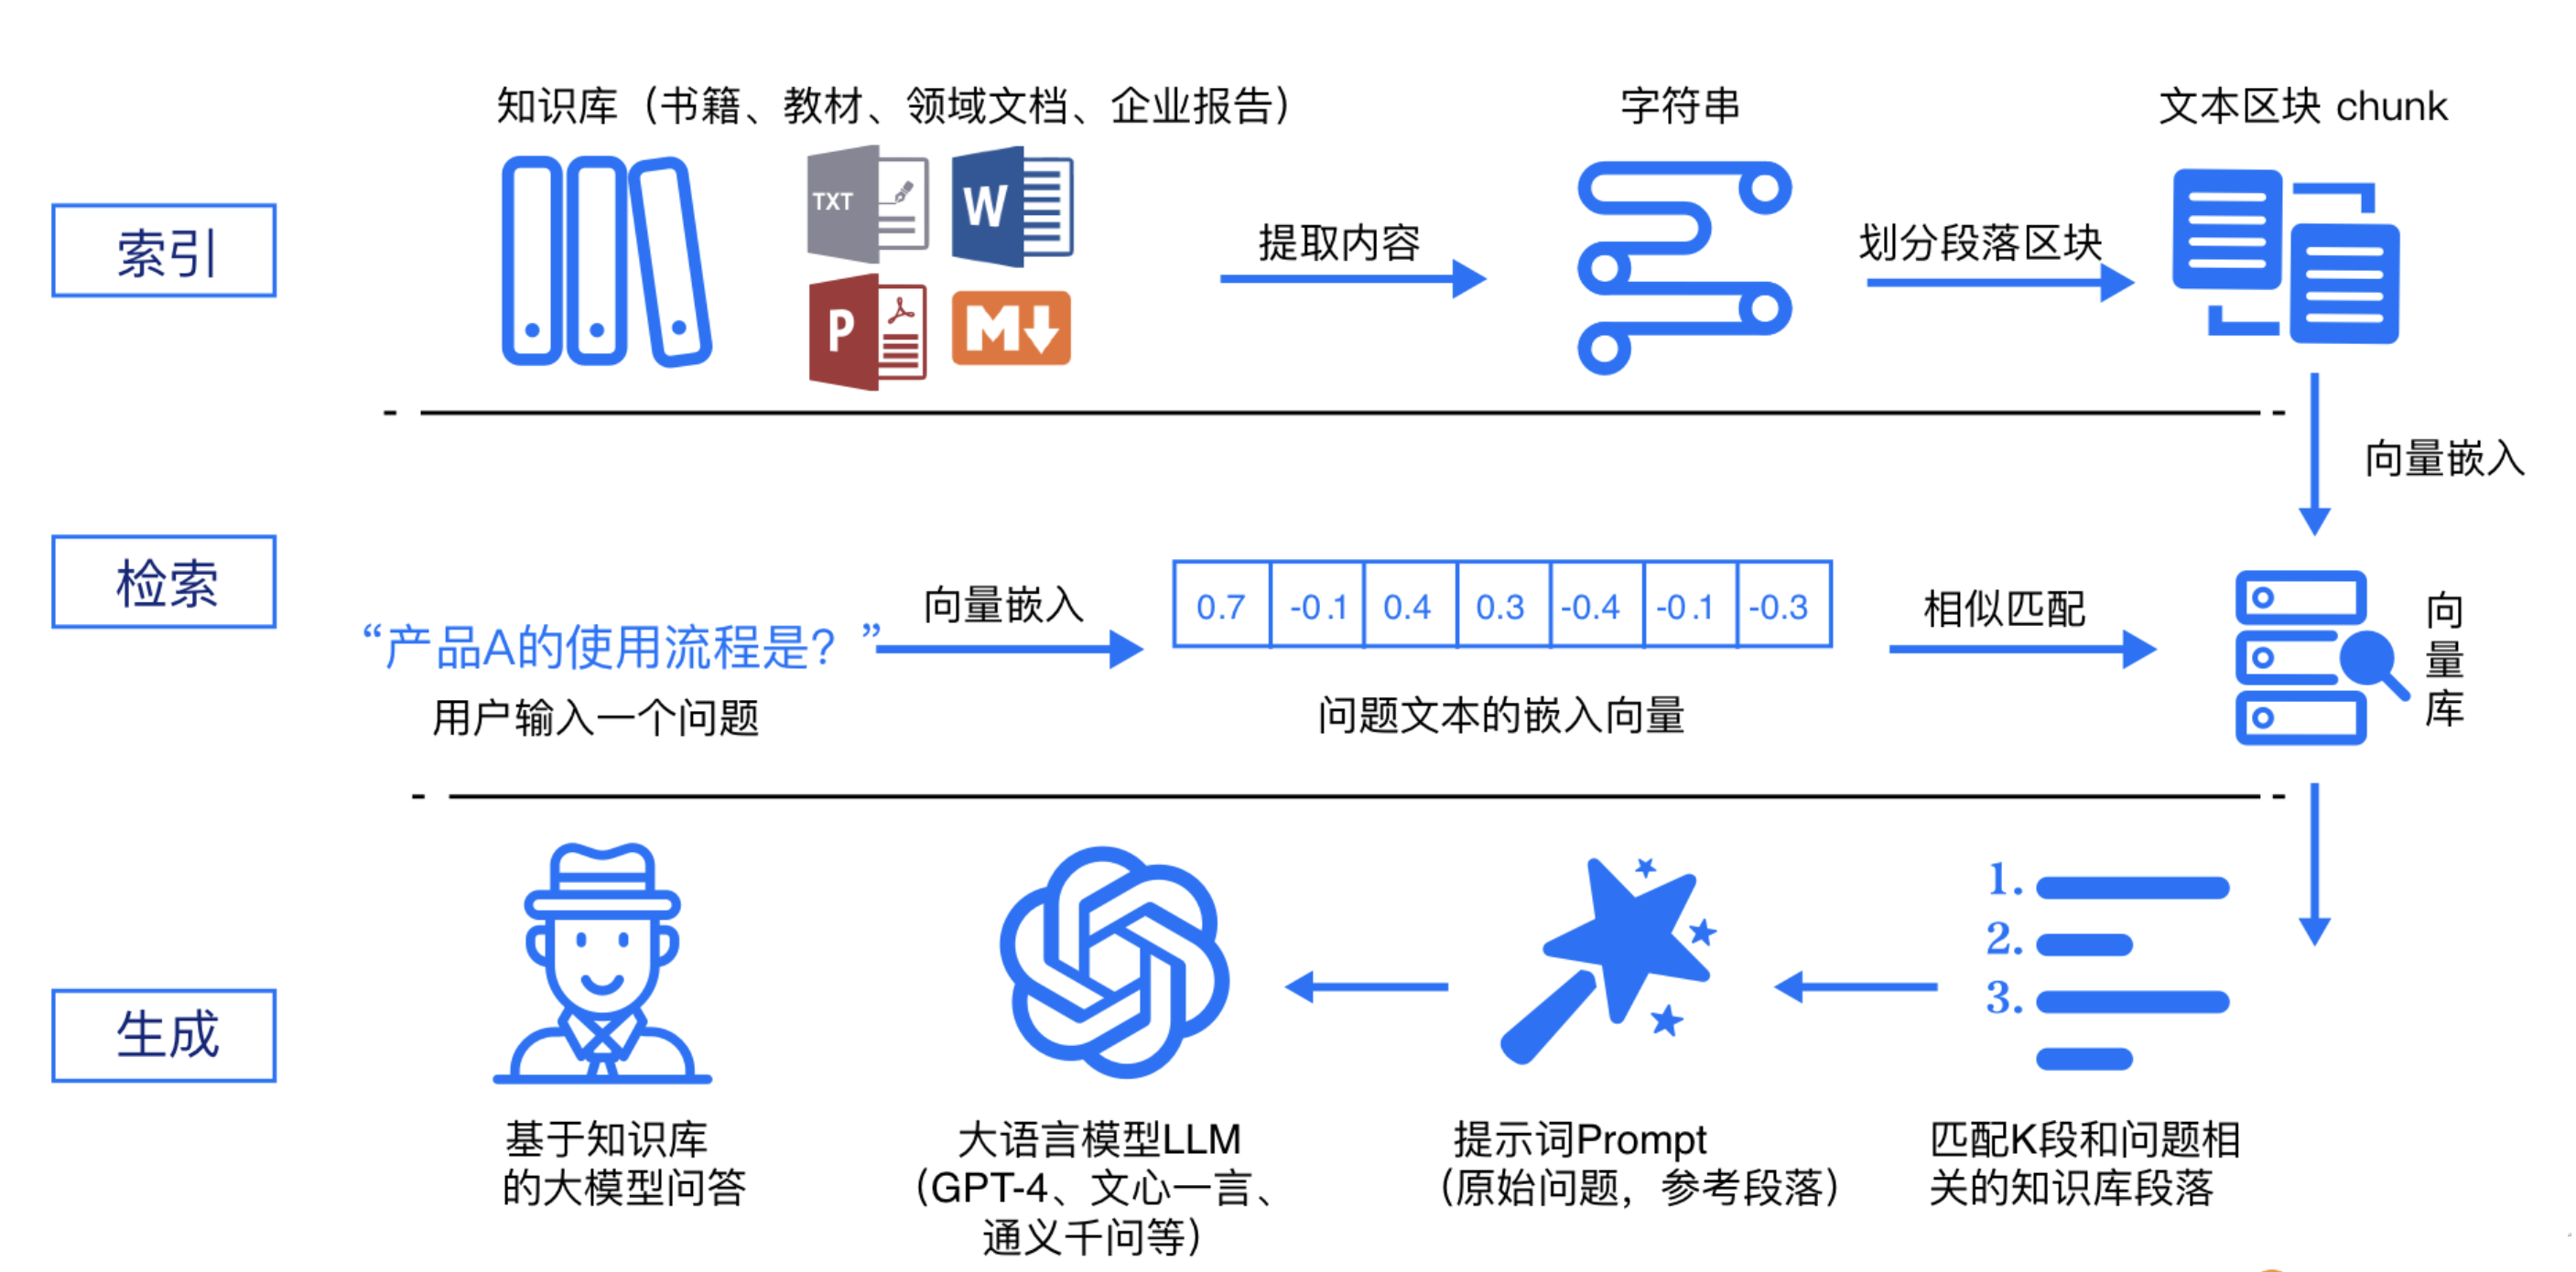
标准流程按三个阶段画:索引、检索、生成。
4.2 两条线:离线准备 / 在线服务
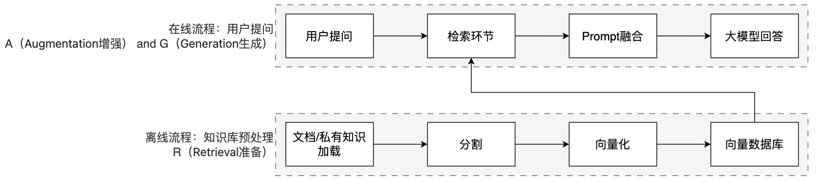
简单来说,RAG 工作分为两条线:离线准备线 / 在线服务线。
对应 RAG 三个字母:
| R Retrieval 准备 | 文档加载 → 分割 → 向量化 → 写入向量库 | 离线 |
| A Augmentation 增强 | 用户提问后做检索,再做 Prompt 融合 | 在线 |
| G Generation 生成 | 大模型基于融合后的 Prompt 回答 | 在线 |
4.3 三个核心阶段拆开看
RAG 标准流程由 索引(Indexing)、检索(Retriever) 和 生成(Generation) 三个核心阶段组成。
4.3.1 索引阶段
处理多种来源、多种格式的文档,提取文本,切分为标准长度的文本块(chunk),做嵌入向量化(embedding),存入向量数据库(vector database)。
-
加载文件
-
内容提取
-
文本分割,形成 chunk
-
文本向量化
-
存向量数据库
4.3.2 检索阶段
用户输入的查询(query)被转化为向量表示,通过相似度匹配从向量数据库中检索出最相关的文本块。
-
query 向量化
-
在文本向量中匹配出与问句向量相似的 top_k 个
4.3.3 生成阶段
检索到的相关文本与原始查询共同构成提示词(Prompt),输入大语言模型(LLM),生成精确且具备上下文关联的回答。
-
匹配出的文本作为上下文和问题一起添加到 prompt 中
-
提交给 LLM 生成答案
4.4 常见向量数据库(选型对照)
课件同时给出常见向量库对照(均支持混合搜索)。后续实战使用的是其中偏轻量的 Chroma。
| Weaviate | 开源 | Go | AI 原生,多模态支持 | 云 / Docker / K8s / 嵌入式 | 复杂 RAG |
| Qdrant | 开源 | Rust | 高性能,稀疏向量 | 云 / Docker | 大规模向量搜索 |
| Milvus | 开源 | Go/C++ | 专为向量搜索优化 | 云 / Docker / K8s | 大规模 AI |
| MyScale | 商业 | — | SQL 兼容,高性能 | 云 / 自托管 | SQL 开发者 |
| pgvector | 开源 | C | PostgreSQL 扩展 | 任意 PostgreSQL | PG 用户 |
| pgvecto-rs | 开源 | Rust | 高维向量支持 | PG 扩展 | 需要高维搜索 |
| Chroma | 开源 | Python | 轻量、易用 | 云 / 本地 | 快速原型(课件后续使用) |
| OpenSearch | 开源 | Java | 搜索分析一体化 | 云 / 自托管 | 企业搜索 |
| TiDB Vector | 商业 | Go | 统一数据管理 | Serverless / 专享 | 分布式 AI |
| Elasticsearch | 商业 | Java | 成熟搜索引擎 | 云 / 自托管 | 企业级搜索 |
五、RAG 的核心价值
5.1 本质:在输入上做功夫
模型本质上就是:用户输入,模型给出输出。用户能做的,就是在输入上做功夫。
RAG 就是在向模型提问之前,基于已有的知识库或文档内容做检索,确保向模型提问的内容更精准,以及包含足够的信息量用以提供给模型。
核心工作就是前面两条线:离线准备 和 在线服务。
5.2 三个价值
解决知识时效性问题:大模型的训练数据有截止时间,RAG 可以接入最新文档(如公司财报、政策文件),让模型输出「与时俱进」。
降低模型幻觉:模型的回答基于检索到的事实性资料,而非纯靠自身记忆,大幅减少编造信息的概率。
无需重新训练模型:相比微调(Fine-tuning),RAG 只需更新知识库,成本更低、效率更高。