文章目录
- 前言:Agent Memory 正从“存什么”走向“关系如何随使用而形成”
- 零、论文基本信息
- 一、背景与问题:向量检索能找到“像”的记忆,却不一定找到“曾经一起有用”的记忆
-
- 1. 现有长期记忆系统的三条路线
-
- 1.1 Knowledge organization
- 1.2 Retrieval-oriented memory
- 1.3 Architecture-driven memory
- 2. 纯 semantic similarity 的“语义陷阱”
- 3. 三个生物记忆直觉
- 二、相关工作:HeLa-Mem 与相邻路线的边界
-
- 1. 与向量 RAG 的区别
- 2. 与 knowledge graph memory 的区别
- 3. 与 Hopfield / attention 的关系
- 4. 与 consolidation memory 的关系
- 三、方法总览:一条持续运转的 Memory Lifecycle
-
- 为什么这里需要看 Figure 3?
- Figure 2 的作用:解释设计类比,而非系统结构
- 四、模块一:Memory Storage——把经历与抽象知识分开保存
-
- 1. Episodic Memory Graph
- 2. Semantic Memory Store
- 五、模块二:Online Encoding & Association——让共同检索成为边权学习信号
-
- 1. 动机
- 2. Hebbian 边权更新公式
- 3. 例子
- 4. 潜在风险:错误共检索的正反馈
- 六、模块三:Reflective Memory Agent——从高连接 episode 簇蒸馏稳定知识
-
- 1. 为什么需要 consolidation?
- 2. Hub Detection
- 3. Hebbian Distillation
- 4. Adaptive Forgetting
- 5. 为什么需要看 Figure 4?
- 七、模块四:Dual-Path Retrieval——直接相似度召回 + 关联扩散召回
-
- 1. Base Activation
- 2. Spreading Activation
- 3. Dual-Path Ranking
- 4. Semantic path
- 5. Case Study:Figure 5 与公式(6)
- 八、实验设置
-
- 1. 数据集
- 2. Baselines
- 3. Metrics
- 4. Backbones 与超参数
- 九、主实验结果:有效,但不能接受“所有模型所有类别一致领先”的宽泛结论
-
- 1. 为什么必须看 Table 1?
- 2. GPT-4o-mini:最完整、最强的一组结果
- 3. GPT-4o:总体强,但 Multi-hop 不是最佳
- 4. Qwen2.5-14B:三类领先,Multi-hop 落后
- 5. Qwen2.5-3B:小模型上的边界
- 6. Table 2:跨 backbone 平均排名
- 7. Figure 1:性能—Token 效率
- 十、消融实验:真正重要的是 Reflective Agent,其次才是 Spreading Activation
-
- 1. Reflective Agent 是最大贡献模块
- 2. Spreading Activation 有独立贡献
- 3. Forgetting 在当前 benchmark 上没有被验证
- 4. Table 3 存在报告口径疑点
- 5. 缺失的关键消融
- 十一、附加实验、案例与效率
-
- 1. LongMemEval-S
- 2. Figure 6:边权矩阵
- 3. 效率结论应该如何理解
- 十二、失败、反例与方法边界
-
- 1. Cold Start
- 2. Distillation Error 会进入长期存储
- 3. Co-activation 不是因果或事实关系
- 4. Popularity Bias 与 Hub Domination
- 5. Temporal Conflict 与 Knowledge Update
- 6. Privacy 与“遗忘”语义
- 7. 评测规模有限
- 十三、与 A-MEM / MAGMA / CoM / ReMemR1 / Mem²Evolve 横向比较
-
- 1. HeLa-Mem vs A-MEM
- 2. HeLa-Mem vs MAGMA
- 3. HeLa-Mem vs CoM
- 4. HeLa-Mem vs ReMemR1
- 5. HeLa-Mem vs Mem²Evolve
- 十四、对 Coding Agent / Tool Agent / Multi-Agent 的工程启发
-
- 1. Coding Agent:用“共同出现在成功修复中”学习代码关联
- 2. Tool Agent:学习工具组合而不是只学习工具相似度
- 3. Multi-Agent:从协作轨迹中形成 team memory
- 4. 更可靠的生产版应增加四层防护
- 十五、我的理解与启发
-
- 1. 真正的新意是把 Memory Retrieval 变成 Memory Learning
- 2. “被频繁使用”与“重要”仍不是同一个概念
- 3. 这篇论文最强的模块可能是 consolidation,而不是 association
- 4. Memory 系统正在形成“数据面 + 控制面”分工
- 5. 下一步不是更像大脑,而是更可验证
- 十六、局限性总结
-
- 论文明确承认
- 本文进一步识别
- 十七、总结
- 参考资料
前言:Agent Memory 正从“存什么”走向“关系如何随使用而形成”
这一轮 Agent Memory 研究大致经历了几次重心迁移。
- Mem0 / MemoryOS 关心的是记忆如何分层、抽取、更新和长期保存;
- A-MEM 把离散 note 组织成可链接、可演化的知识网络,开始强调 memory 之间的结构;
- MAGMA 进一步强调不同关系、不同视角下的多图组织,避免单一相似度空间压平复杂关系;
- Chain-of-Memory(CoM) 把重心从昂贵的写时构建转向 query-time 的动态 memory chain,让检索结果围绕当前问题逐步演化;
- ReMemR1 让顺序阅读型 Agent 在更新当前 memory 时能够 callback 历史 memory,修复早期证据被不可逆压缩的问题;
- Mem²Evolve 则把 memory 从“过去经验”扩展到“未来能力”,让 experience memory 与 tool / expert asset 共同演化。
这些工作已经回答了很多问题:记忆应该放在哪里、如何分层、如何连接、何时回看、如何围绕 query 组织、如何进一步转化为能力。但仍有一个更底层的问题没有被充分回答:
两段记忆之间的关系,应该只由写入时的一次 LLM 判断或 embedding 相似度决定吗?
如果答案是“是”,那么 memory graph 仍然只是一个静态索引。真实长期交互中的关联却常常不是第一次写入时就显而易见的。两件事可能用词完全不同,却在之后的多个任务中一再被共同使用;它们真正的关系,是被后续经验“用出来”的。
HeLa-Mem 把这一点作为出发点:
传统做法:
写入时决定关系 → 以后按固定关系检索
HeLa-Mem:
先建立弱关系 → 每次共同检索都强化关系
→ 强关系帮助下一次联想检索
→ 高频关联簇被蒸馏成稳定知识
→ 长期不用且弱连接的节点被遗忘
因此,这篇论文最值得关注的不是“脑科学”包装,而是一个很工程化的闭环:retrieval trace 被转化为 graph update signal。它使 memory graph 不再只是被查询的数据库,而成为被使用历史持续塑造的状态。
零、论文基本信息
- 论文名称:HeLa-Mem: Hebbian Learning and Associative Memory for LLM Agents
- 发表平台:ACL 2026 Long Paper,Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers),pp. 13757–13769
- 代码仓库:https://github.com/ReinerBRO/HeLa-Mem
- 作者:Jinchang Zhu, Jindong Li, Cheng Zhang, Jiahong Liu, Menglin Yang
一、背景与问题:向量检索能找到“像”的记忆,却不一定找到“曾经一起有用”的记忆
1. 现有长期记忆系统的三条路线
论文把现有 LLM Agent Memory 归纳为三类。
1.1 Knowledge organization
A-MEM、Think-in-Memory 等方法试图把记忆组织成 note network 或持续更新的 reasoning state。它们的优势是结构明确,但关系往往在写入或重构阶段由语义、实体或 LLM 一次性决定。
1.2 Retrieval-oriented memory
RAG、MemoryBank、Generative Agents、EmotionalRAG 等方法主要改进“如何从存储中找出当前相关信息”。它们可以加入 recency、importance、emotion 或 forgetting curve,但中心仍是当前 query 与每条 memory 的匹配。
1.3 Architecture-driven memory
MemGPT、SCM、Mem0、MemoryOS 从控制流和存储层级入手,例如显式 read/write、短中长期分层、分页或抽取合并。它们擅长管理容量,却不天然学习 memory 之间因反复共同使用而形成的关联。
论文认为三条路线通常各自优化 structure、retrieval 或 update,缺少三者之间的联动。更准确地说,缺少的是:检索结果反过来改变记忆结构,改变后的结构再影响未来检索。
2. 纯 semantic similarity 的“语义陷阱”
设问题是:
“你第一次在哪里遇到那个影响你职业选择的人?”
“Dr. Sarah 鼓励我从事心理咨询”与 query 中“影响职业选择”高度相似,因此容易被检索;“我在领养支持会议上遇见 Dr. Sarah”包含地点答案,却与“职业选择”表面相似度低,可能掉出 Top-k。
这里缺少的不是更大的 embedding model,而是关系链:
职业影响 → Dr. Sarah → 第一次见面地点
如果历史上这两条 memory 曾多次因相关任务共同出现,那么“共同出现”本身就是一种弱监督。HeLa-Mem 用 Hebbian update 将这种弱监督写成边权。
3. 三个生物记忆直觉
论文从认知神经科学借用三个直觉:
这里应避免把类比说得过强。HeLa-Mem 并不是神经层面的 Hebbian learning,也没有更新 LLM 参数;它是在外部 memory graph 上用一个简化的共激活规则更新边权。因此更准确的表述是:受 Hebbian principle 启发的图结构在线更新。
二、相关工作:HeLa-Mem 与相邻路线的边界
1. 与向量 RAG 的区别
普通 RAG 的核心分数通常是:
[ S(m_i,q)=\\operatorname{sim}(e_i,e_q) ]
每条 memory 独立竞争 Top-k。HeLa-Mem 保留这一路径,但增加图传播项,使候选 memory 还能因为与高相关 memory 的历史关联而被召回。
2. 与 knowledge graph memory 的区别
知识图谱的边通常来自实体/关系抽取;A-MEM 的链接也主要由写入时的语义分析产生。HeLa-Mem 的边不要求预定义关系类型,其强度来自检索历史中的 co-activation。因此它更像一个 usage graph,而不是显式事实图。
代价也很明显:边权表达的是“经常一起被取回”,不等价于逻辑、因果或事实关系。错误检索也可能自我强化。
3. 与 Hopfield / attention 的关系
论文回顾经典 Hebbian rule:
[ \\Delta w_{ij}=\\eta x_i x_j ]
以及 Hopfield network 将 recurrent connections 用作 associative memory、modern Hopfield network 与 attention 的数学联系。但 HeLa-Mem 并没有构造能量函数或进行 Hopfield attractor dynamics;这些工作提供的是设计动机,而不是方法等价关系。
4. 与 consolidation memory 的关系
Generative Agents 有 reflection,Mem0 有抽取与 consolidation,MemoryOS 有层级迁移。HeLa-Mem 的不同点在于 consolidation trigger 不是单纯时间、重要性或容量,而是图中节点累积的连接强度:被反复共同使用而成为 hub 的局部 episodic cluster,才进入 Hebbian Distillation。
三、方法总览:一条持续运转的 Memory Lifecycle
为什么这里需要看 Figure 3?
公式只能解释局部更新,Figure 3 才能看清三个模块如何构成反馈回路,以及 episodic / semantic 两条记忆路径在写入、巩固和检索时如何交汇。
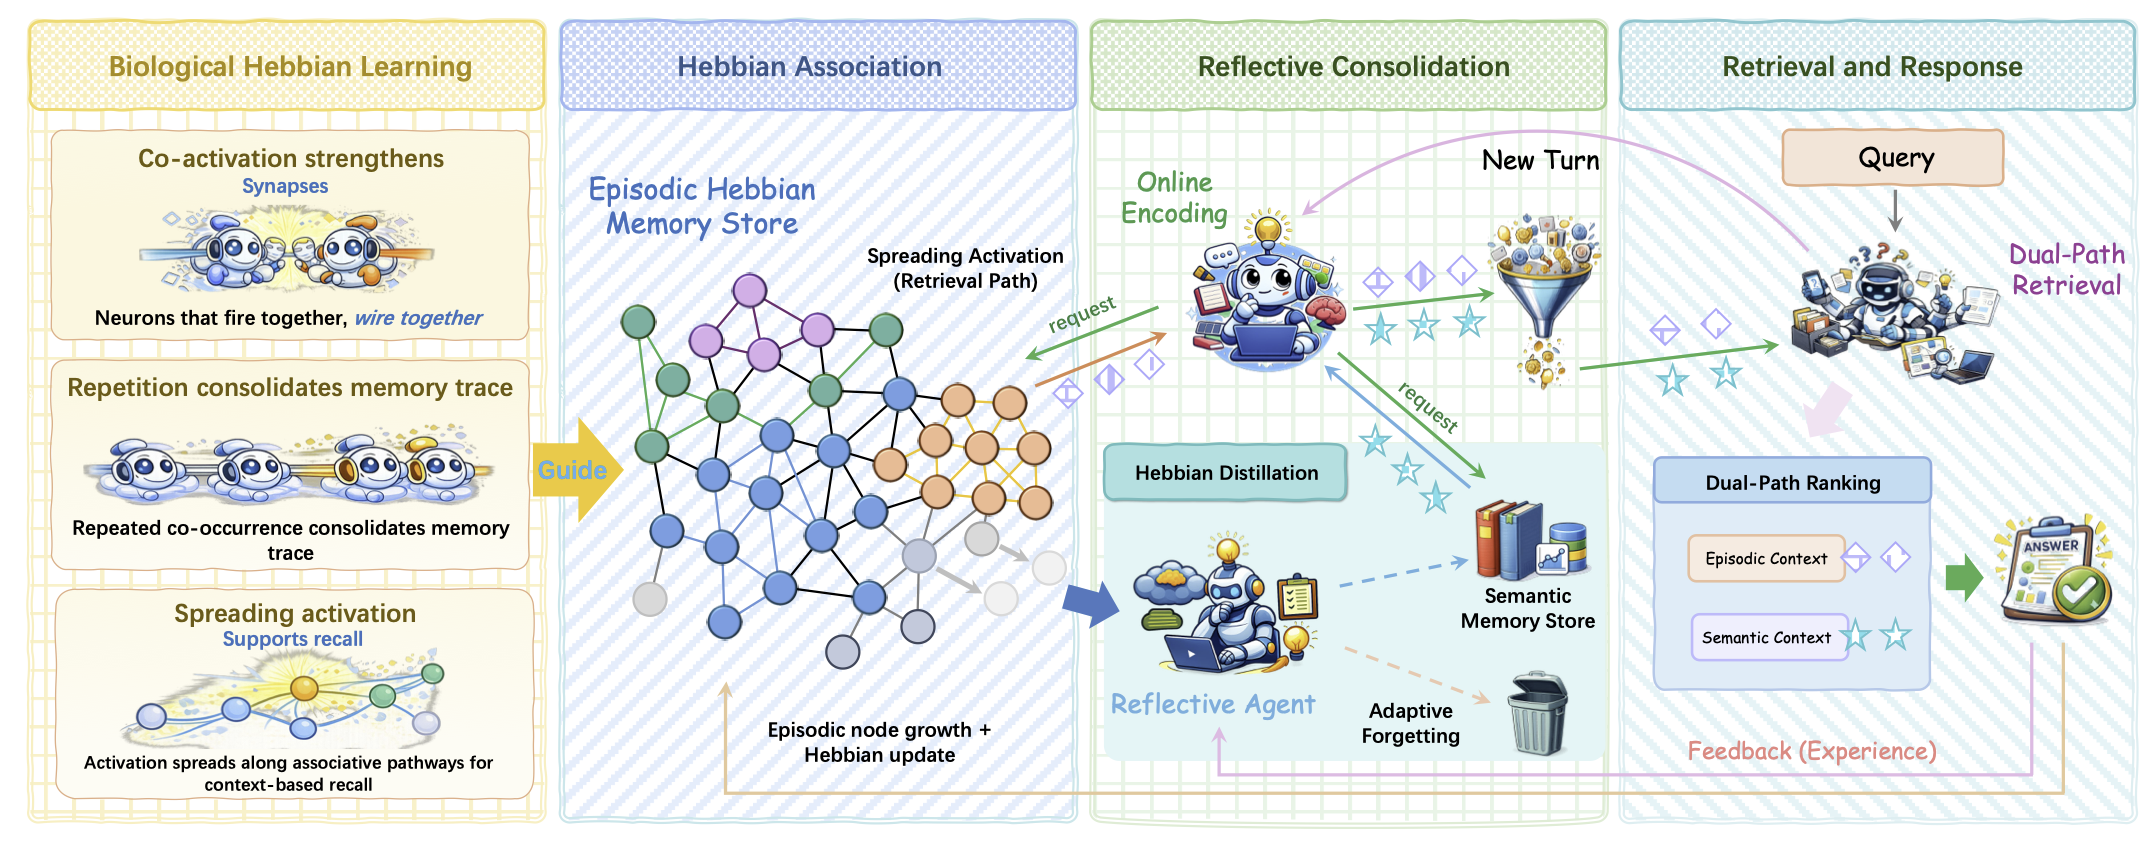
图源:原论文 Figure 3(PDF 第 3 页 / 论文页 13759)。 支撑结论:HeLa-Mem 不是单独的图检索器,而是 Association → Consolidation → Dual-Path Retrieval 的闭环。
完整生命周期如下:
New turn
↓
Online Encoding
↓
Episodic Hebbian Memory Graph
├─ retrieval co-activation → 更新/衰减边权
├─ hub threshold reached → Reflective Agent
│ ↓
│ Hebbian Distillation
│ ↓
│ Semantic Memory Store
└─ weak + old + unused → Adaptive Forgetting
Query
├─ Base semantic path ──────────────┐
├─ Hebbian spreading path ─────────┼→ merged context → Response
└─ Semantic Memory retrieval ──────┘
Figure 2 的作用:解释设计类比,而非系统结构
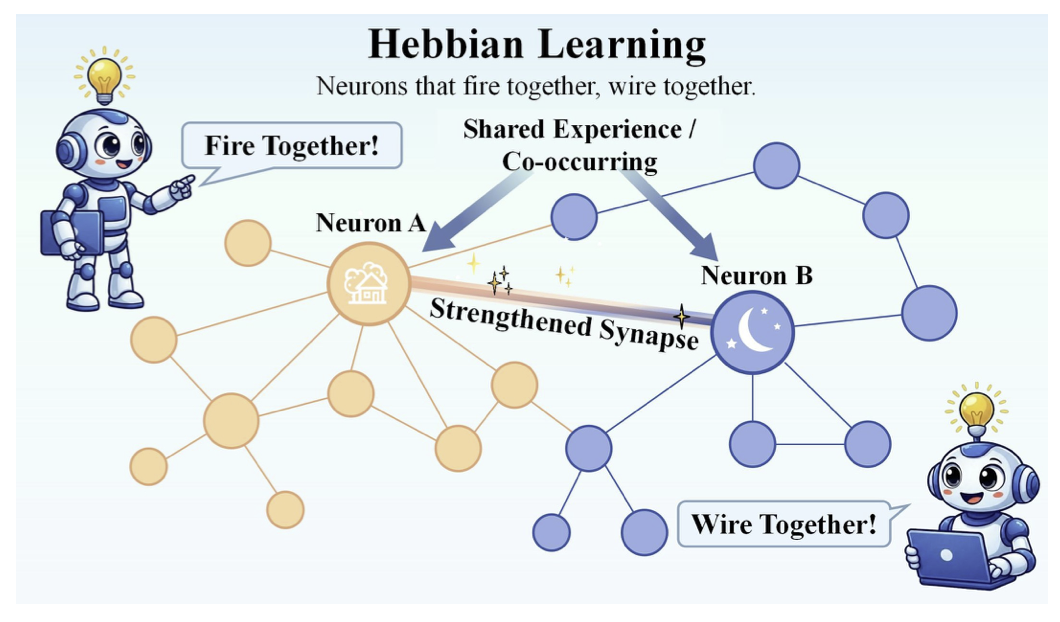
图源:原论文 Figure 2(PDF 第 2 页 / 论文页 13758)。 支撑结论:重复共同激活会增强关联边;此图只支撑概念动机,不直接证明性能。
四、模块一:Memory Storage——把经历与抽象知识分开保存
1. Episodic Memory Graph
每轮对话被存为加权图中的节点。节点至少包含:
- 原始文本;
- dense embedding;
- timestamp;
- extracted keywords;
- speaker role。
边表示 associative connection,边权表示关联强度。连续 turn 初始建立弱连接,之后依据共同检索不断演化。
动机是保存 provenance 和细节:如果只保留摘要,日期、措辞、一次性事件可能在压缩中丢失;episodic graph 保留可追溯的原始 turn。
2. Semantic Memory Store
Semantic Memory Store 保存从 hub-centered episodic cluster 蒸馏出的三类结构化知识:
episodic 与 semantic 不是简单的短期/长期二分:前者承担证据与细节,后者承担跨 episode 的稳定抽象。Semantic entry 还保留到 source turns 的 evidence links,这是抑制不可审计摘要的重要设计。
五、模块二:Online Encoding & Association——让共同检索成为边权学习信号
1. 动机
写入时的 semantic similarity 只能反映当下表面语义;真正长期有用的关系,往往要等多次任务共同使用后才显现。因此系统不一次性“定死”关系,而是让边权随 retrieval history 更新。
2. Hebbian 边权更新公式
[ w_{ij}^{(t+1)} =(1-\\lambda)w_{ij}^{(t)} +\\eta,\\mathbb{I}(v_i,v_j\\in K_t) \\tag{1} ]
其中:
- (K_t) 是第 (t) 次检索中共同激活的节点集合;
- (\\mathbb{I}(v_i,v_j\\in K_t)) 表示两个节点是否同时在该集合中;
- (\\eta) 是共同激活带来的强化幅度;
- (\\lambda) 控制旧关联衰减。
公式由两部分组成:
(1 – λ) · old weight 长期不用的边自然衰减
η · co-activation signal 本次共同检索的边得到强化
若一对节点连续 (n) 次共同激活且忽略其他更新,可写成:
[ w_n=(1-\\lambda)^n w_0+ \\eta\\sum_{r=0}{n-1}(1-\\lambda)r ]
这说明边权不会只记录最后一次共现,而是一个带遗忘的历史累积。若持续共同激活,理论稳态约为 (\\eta/\\lambda)(按论文公式中 (\\lambda) 被称为 decay rate 的写法);不过论文实现参数写 (\\lambda=0.995),与公式中 ((1-\\lambda)w) 的直觉存在命名/尺度歧义:若直接代入,旧权重每步只保留 0.5%,衰减极快。更可能的工程实现是把 0.995 当 retention factor,或公式符号与参数说明口径不一致。复现时必须以代码为准。
3. 例子
假设“Dr. Sarah 的职业建议”和“在支持会议第一次见到她”多次一起被检索。两节点的相似度未改变,但边权随着 co-activation 增强。以后 query 先命中职业建议节点,地点节点即可借助关联传播进入候选集。
4. 潜在风险:错误共检索的正反馈
系统默认“经常一起被取回”意味着“值得建立关系”。但 retrieval error 也可能被写回图中:一次偶然误召回产生弱边,增强后的边又提高未来共检索概率,形成 confirmation loop。论文没有给出负反馈、edge normalization 或基于答案正确性的 credit assignment,这是方法的重要未解问题。
六、模块三:Reflective Memory Agent——从高连接 episode 簇蒸馏稳定知识
1. 为什么需要 consolidation?
只让 episodic graph 增长会带来三个问题:节点和边无限增加、重复 episode 提高检索噪声、稳定规律仍分散在多条原始记录中。Reflective Agent 的作用不是回答 query,而是管理 memory lifecycle。
2. Hub Detection
节点 (v_i) 的 associative strength 定义为邻接边权之和:
[ D(v_i)=\\sum_{j\\in\\mathcal{N}(i)}w_{ij} \\tag{2} ]
当:
[ D(v_i)>\\delta_{hub} ]
系统将其标记为需要 consolidation 的 hub。随后取 hub 及其强连接邻居,让 LLM 抽取共同主题、因果关系、用户特征和事实,生成 structured semantic entries。
这个 trigger 的意义是:不是“写入次数多”就固化,而是“与多条 memory 形成稳定关联”才固化。
3. Hebbian Distillation
附录 Prompt 1 要求 LLM 只抽取有直接证据的事实,输出:
- observable user traits 与 evidence;
- content preferences 与 interaction patterns;
- 带日期和地点的事件;
- stated preferences;
- mentioned relationships。
其本质仍是 prompt-based LLM summarization。“Hebbian”主要体现在谁被送去蒸馏、簇如何形成,而不是蒸馏模型本身采用 Hebbian learning。
4. Adaptive Forgetting
一个 episodic node 只有同时满足三个条件才被删除:
这是一种 AND-gate 的保守垃圾回收:旧但强关联的 memory 不删;弱但刚被使用的 memory 不删;只有弱、旧、未访问同时成立才删。
5. 为什么需要看 Figure 4?
Figure 4 把 hub、normal、isolated 三类节点和两种 lifecycle action 放在一张真实图结构示意中,是理解“蒸馏谁、遗忘谁”的关键图。

图源:原论文 Figure 4(PDF 第 5 页 / 论文页 13761)。 支撑结论:Reflective Agent 同时执行“高连接簇上移为 semantic knowledge”和“弱连接孤立节点清理”。示例图含 23 个节点,其中 10 个 hub、4 个 isolated、9 个 normal。
七、模块四:Dual-Path Retrieval——直接相似度召回 + 关联扩散召回
1. Base Activation
每个 episodic node 的初始分数为:
[ S_{base}(v_i)= \\left(\\operatorname{sim}(q,e_i)+ \\alpha\\cdot\\operatorname{keyword_match}\\right) \\cdot\\gamma(v_i) \\tag{3} ]
其中:
[ \\gamma(v_i)=\\exp(-\\Delta t/\\tau) ]
- cosine similarity 提供语义相关性;
- keyword match 对实体/关键词精确匹配加分;
- temporal decay 降低长期未更新节点的基础激活;
- (\\tau) 是时间衰减常数,LoCoMo 实验取 60 天。
这里将 temporal decay 乘在整个语义与关键词和上,意味着再精确的关键词命中也会被时间统一衰减。对历史事实 QA,这可能伤害很老但仍有效的事实;系统依赖 Hebbian edge 或 semantic store 把它救回来。
2. Spreading Activation
初始高分节点沿 Hebbian edges 向邻居传播:
[ S(v_j)=S_{base}(v_j)+ \\beta\\sum_{i\\in\\mathcal{N}(j)}S_{base}(v_i)w_{ij} \\tag{4} ]
传播贡献由三项共同决定:源节点与当前 query 的相关性、源到目标的历史关联强度、全局传播系数 (\\beta)。因此一个节点即使自身语义分低,只要与高相关节点存在强边,也可能被提升。
值得注意的是,论文公式展示的是一跳传播,而不是任意深度图搜索。它降低了图爆炸风险,但也限制了真正多跳链的长度。
3. Dual-Path Ranking
最终集合不是简单对 (S) 统一排序,而是保留两条路:
[ R_{final}= \\operatorname{Top-k}(S_{base}) \\cup \\operatorname{Top-m} \\left(S\\mid v\\notin\\operatorname{Top-k}(S_{base})\\right) \\tag{5} ]
- base path 保证最直接的 semantic hits 不被图传播挤掉;
- flip path 专门加入原 Top-k 之外、因 spreading activation 被“翻入”的最多 (m) 个节点。
这是一种很稳健的工程折中:association 负责补充而不是完全接管 retrieval。
4. Semantic path
除 episodic base/flip 结果外,系统还从 Semantic Memory Store 取结构化知识,最终把 episodic context 与 semantic context 合并后交给 LLM 回答。LoCoMo 设置为 episodic top-10、semantic top-5。
5. Case Study:Figure 5 与公式(6)
为什么需要看 Figure 5?因为它是全文最直接的机制证据:展示一个低 semantic score 的关键地点节点如何被历史关联边救回,而不是只给平均分。

图源:原论文 Figure 5(PDF 第 8 页 / 论文页 13763)。 支撑结论:similarity-only baseline 因 Turn 15 的 0.35 分数未过 Top-k 而失败;HeLa-Mem 通过与 Turn 89 的 0.52 关联边增加约 0.36 分,将总分提升至约 0.71。
论文给出的实例计算是:
[ S_{total}= \\underbrace{0.35}{semantic}+ \\underbrace{0.36}{Hebbian} \\approx 0.71 \\tag{6} ]
最终系统同时拿到“谁影响了职业选择”和“在哪里第一次见到她”,回答 “At the adoption support conference.”
这个案例很好地说明机制,但它是单个成功案例,并不能排除 spreading activation 同样传播到错误邻居的情况。论文没有给出关联路径 precision、错误翻入率或按边权区间的 calibration。
八、实验设置
1. 数据集
主实验使用 LoCoMo long-context conversation split:10 段对话,平均约 300 turns / 9,000 tokens,共 1,986 个 QA。
表格位置:本节放置原论文 Table 4 与 Table 5。 Table 4 caption:LoCoMo dataset overview. Table 5 caption:Distribution of question types in the evaluation set. 分布为 Single-hop 841(42.3%)、Multi-hop 282(14.2%)、Temporal 321(16.2%)、Open-domain 96(4.8%)、Adversarial 446(22.5%)。 支撑结论:主表只报告四类而未展示 Adversarial;读者不能把四类均分自动当作全数据集总体表现。
附加实验使用 LongMemEval-S:500 items,并用 GPT-4o-mini 同时作为 backbone 与 LLM judge。
2. Baselines
LoCoMo 对比 LoCoMo Native、ReadAgent、MemoryBank、MemGPT、A-Mem、Mem0、LightMem、MemoryOS。部分结果来自既有论文,MemoryOS 的 † 项由作者复现。因此 Table 1 不是所有方法在完全同一代码路径下重新运行,公平性还受 prompt、retrieval budget 和来源实现差异影响。
3. Metrics
主实验使用 F1 与 BLEU-1;LongMemEval-S 使用 Accuracy。F1/BLEU 适合短答案 lexical overlap,但可能低估语义等价答案,也无法直接测量 memory provenance 是否正确。
4. Backbones 与超参数
- GPT-4o-mini、GPT-4o、Qwen2.5-14B、Qwen2.5-3B;
- (\\tau=60) days;
- episodic (k=10),semantic (k=5);
- (\\eta=0.02);
- 论文写 edge decay rate (\\lambda=0.995);
- (\\beta=0.1);
- spreading threshold (\\theta=0.6)。
LongMemEval-S 使用 episodic top-15 + semantic top-5,(\\theta=0.4),keyword weight 0.7,max flipped items (m=3)。
九、主实验结果:有效,但不能接受“所有模型所有类别一致领先”的宽泛结论
1. 为什么必须看 Table 1?
Figure 1 只画出平均性能—token trade-off;Table 1 才能看到不同 backbone、不同问题类型上的赢和输。
表格位置:本节开头放置原论文 Table 1。 原 caption 核对:Experimental results on LoCoMo dataset of QA tasks across four categories (Multi Hop, Temporal, Open Domain, and Single Hop) using different methods. Results are reported in F1 and BLEU-1 (%) scores. Best performance per model is marked in bold. Missing baselines are marked with “-” (Token Length (↓): lower values are better; †: Reproduced results). 图源/表源:原论文 Table 1(PDF 第 7 页 / 论文页 13762)。 支撑结论:HeLa-Mem 在多数设置领先并显著节省 token,但不是每个 backbone 的每个类别都第一。
2. GPT-4o-mini:最完整、最强的一组结果
| A-Mem | 27.02 | 45.85 | 12.14 | 44.65 | 2,520 |
| MemoryOS | 38.39 | 41.58 | 23.75 | 45.86 | 2,000 |
| HeLa-Mem | 40.14 | 47.29 | 29.70 | 51.89 | 1,010 |
相对 MemoryOS,HeLa-Mem 分别提升 +1.75、+5.71、+5.95、+6.03 F1,同时 token 减少约 49.5%。这组结果最能支持论文主张:既提升关联推理,也没有牺牲 single-hop,并且上下文更短。
3. GPT-4o:总体强,但 Multi-hop 不是最佳
HeLa-Mem 的 Multi-hop F1 为 39.12,低于 MemoryOS 的 40.23;Temporal、Open、Single-hop 则分别为 50.79、24.38、49.69,均优于表中 MemoryOS。它说明 association path 并非在更强模型上必然带来最高 multi-hop 分数。
另外,LoCoMo full-context 的 Single-hop F1 为 61.56,高于 HeLa-Mem 的 49.69。选择性检索节省了上下文,却可能遗漏单跳事实;这是效率与 recall 的真实 trade-off。
4. Qwen2.5-14B:三类领先,Multi-hop 落后
HeLa-Mem 的 Multi-hop F1 36.59,低于 MemoryOS 38.19;但 Temporal 36.08、Open 24.22、Single-hop 49.95 为该组最高。说明收益更稳定地出现在 temporal/open/single,而论文对 multi-hop 的机制解释不应被概括成无条件优势。
5. Qwen2.5-3B:小模型上的边界
HeLa-Mem 在 Multi-hop、Temporal、Single-hop 分别得到 20.12、24.79、29.51,均为该组最高;但 Open-domain F1 12.24,低于 A-Mem 16.48 和 MemoryOS 13.57。可能原因包括小模型难以利用蒸馏语义知识、open-domain 问题需要 memory 之外的知识,或 semantic distillation 质量受 backbone 限制。
6. Table 2:跨 backbone 平均排名
表格位置:上述逐模型分析后放置原论文 Table 2。 原 caption 核对:Averaged results across three backbone LLMs (GPT-4o-mini, GPT-4o, Qwen2.5-3b). Avg Rank is computed across all categories; lower is better († Reproduced results). 支撑结论:HeLa-Mem Average Rank = 1.25,优于 MemoryOS 2.25、A-Mem 3.00;平均 F1 为 Multi-hop 33.13、Temporal 40.96、Open 22.11、Single 43.70。
注意 Table 2 只平均三个 backbone,没有包括 Qwen2.5-14B。作者所说 robustness across backbones 有支持,但不是四个 backbone 的完整平均。
7. Figure 1:性能—Token 效率
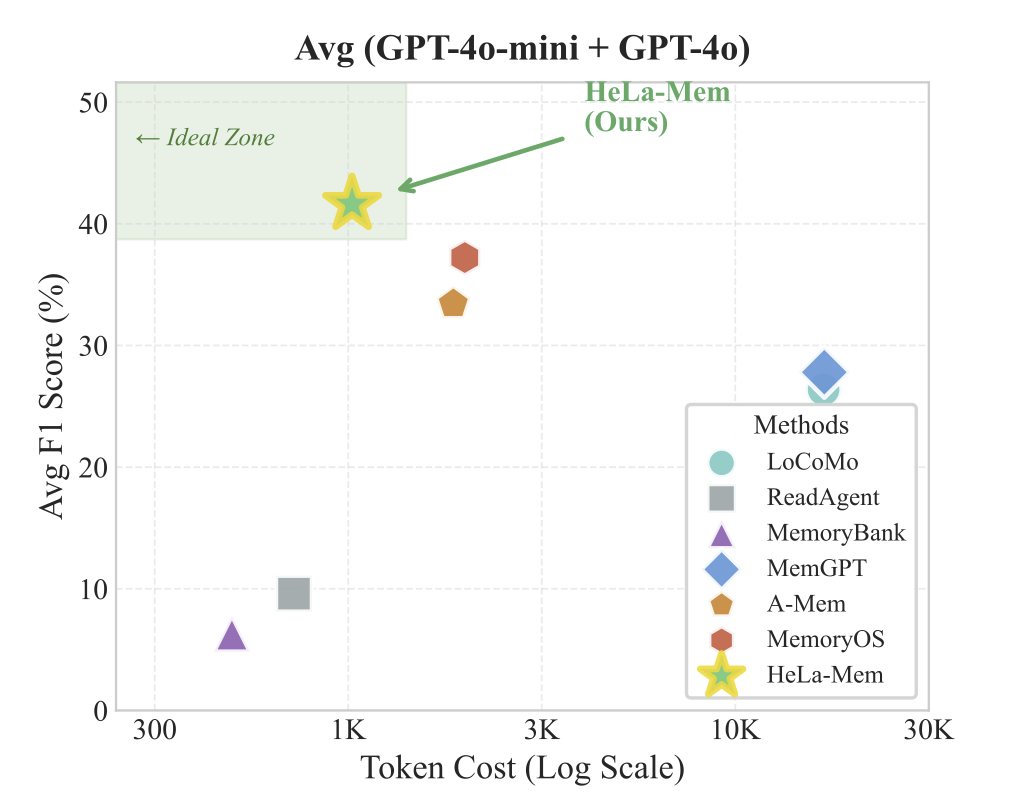
支撑结论:HeLa-Mem 位于高平均 F1、低 token 的左上区域。注意该图只平均 GPT-4o-mini 与 GPT-4o,不包括 Qwen backbone。
十、消融实验:真正重要的是 Reflective Agent,其次才是 Spreading Activation
表格位置:本节放置原论文 Table 3。 原 caption 核对:Ablation study on LoCoMo benchmark. Results show F1 / BLEU-1 scores (%). 表源:原论文 Table 3(PDF 第 7 页 / 论文页 13762),GPT-4o-mini。 支撑结论:移除 Reflective Agent 的降幅最大;移除 Spreading Activation 次之;当前 LoCoMo 长度下 Forgetting 未显示正向准确率贡献。
| Full | 36.04 | 46.23 | 29.50 | 45.04 | 34.74 |
| w/o Forgetting | 36.71 | 46.50 | 30.58 | 45.24 | 34.28 |
| w/o Spreading Activation | 33.88 | 44.36 | 27.76 | 43.34 | 32.19 |
| w/o Reflective Agent | 30.17 | 42.19 | 24.51 | 40.46 | 29.87 |
1. Reflective Agent 是最大贡献模块
表中 Avg F1 从 34.74 降到 29.87,Multi-hop 从 36.04 降到 30.17。说明将高连接 episode 簇蒸馏为 semantic knowledge 不只是节省容量,而是为回答提供了稳定、结构化的跨 episode 表征。
2. Spreading Activation 有独立贡献
去掉传播后 Avg F1 为 32.19,Multi-hop 降到 33.88。它支持“关联边能补充 semantic-only retrieval”的机制主张,但降幅小于去掉 Reflective Agent,说明全文最有效的部分可能是 consolidation,而不只是 Hebbian graph traversal。
3. Forgetting 在当前 benchmark 上没有被验证
去掉 Forgetting 后四个可见分类 F1 都略高于 Full。作者解释 LoCoMo 约 300 turns,尚未让 memory capacity 饱和;所以 forgetting 是面向部署扩展性的设计,而非当前实验已证明的性能模块。这个解释合理,但仍属推测:论文没有提供对话长度扩展曲线、graph size、retrieval latency 随 turns 增长的实验。
4. Table 3 存在报告口径疑点
四个可见类别 F1 的简单平均与“Avg F1”列对不上;更明显的是,w/o Forgetting 的四个分类 F1 均高于 Full,表中 Avg 却从 34.74 变为 34.28。可能 Avg 包含未展示的 Adversarial 类或采用样本加权,但 caption 与正文没有说明。读者不应自行把该列理解为四类宏平均。
5. 缺失的关键消融
论文没有分别消融:
- semantic memory retrieval;
- hub-based trigger 与定时/随机 consolidation;
- keyword match;
- temporal decay;
- Hebbian decay;
- base path 与 flip path 的配额;
- evidence links;
- 图边初始化策略。
因此仍无法确认“Hebbian hub trigger”是否优于更简单的 access-frequency trigger,也无法分离 dual-store 与 Hebbian graph 各自的贡献。
十一、附加实验、案例与效率
1. LongMemEval-S
表格位置:本节放置原论文 Table 6 与 Table 7。 Table 6 caption:Overall accuracy on LongMemEval-S. Table 7 caption:Category-wise accuracy on LongMemEval-S. 支撑结论:HeLa-Mem overall ACC 65.40,为表中最高;在 Temporal 50.38、Multi-Session 57.14、Knowledge-Update 78.21 三类最高,但 Single 78.85 低于 NaiveRAG 85.90 和 A-MEM 84.62。
整体准确率:LangMem 37.20、MemoryOS 44.80、Mem0 53.61、FullText 56.80、NaiveRAG 61.00、A-MEM 62.60、HeLa-Mem 65.40。相对 A-MEM 提升 2.8 个百分点,相对 NaiveRAG 提升 4.4 个百分点。
这组结果比 LoCoMo 更能支持“关联结构有利于跨 session / knowledge update”,也再次展示边界:简单 single-memory lookup 未必需要复杂图传播,NaiveRAG 反而更好。
2. Figure 6:边权矩阵
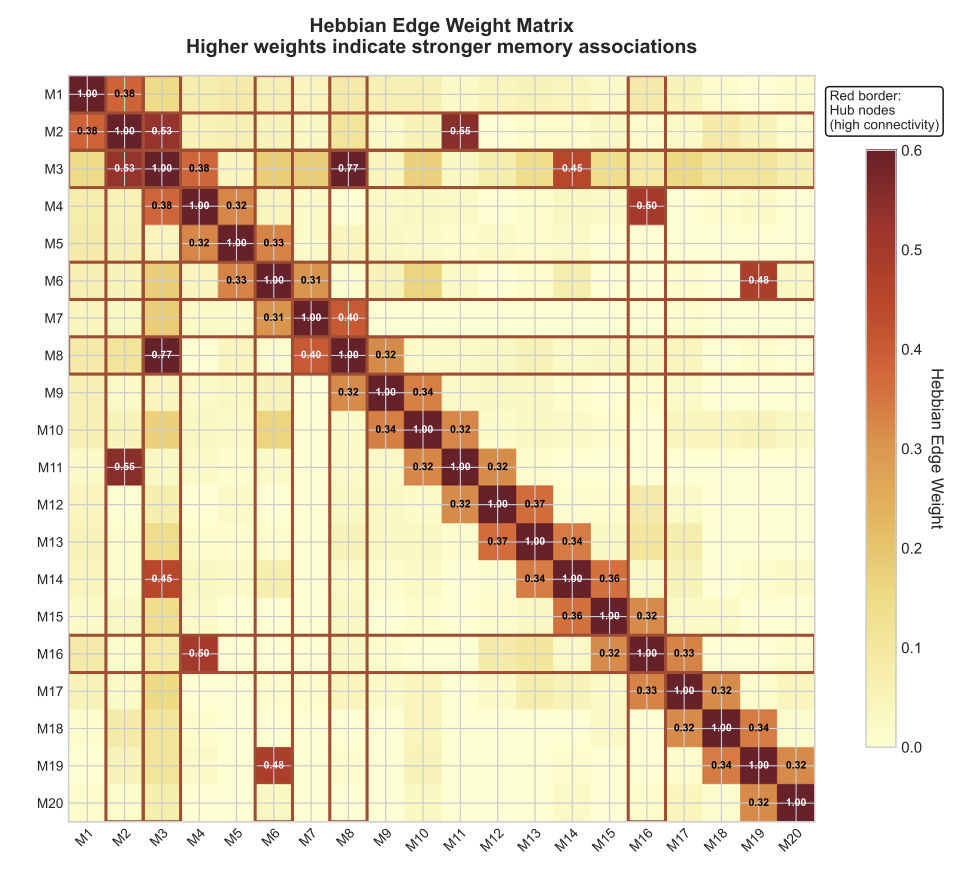
图源:原论文 Figure 6(Appendix B,PDF 第 12 页 / 论文页 13767)。 支撑结论:除对角附近局部连接外,也出现跨远距离节点的非局部强边;红框 hub 具有较高总连接度。它证明实现确实形成了非局部边,但没有证明这些边都正确或因果有效。
3. 效率结论应该如何理解
最明确的效率指标是 generation context token:GPT-4o-mini 下约 1,010 tokens,GPT-4o 下约 1,036;相较 full-context LoCoMo 的 16,910 tokens 大幅下降。
但论文没有完整报告:
- graph update 的 CPU/GPU 时间;
- 每次检索遍历多少边;
- distillation 调用次数与 LLM token 成本;
- memory ingestion latency;
- graph storage 随 turns 的增长;
- 端到端美元成本。
所以“token efficient”可成立,“系统总成本更低”尚未被完整证明。尤其 Reflective Agent 会额外调用 LLM,若只统计最终回答上下文,可能遗漏后台 consolidation 成本。
十二、失败、反例与方法边界
1. Cold Start
论文明确承认 Hebbian weights 需要足够历史才能积累。早期对话缺少 co-activation trace,系统接近普通 semantic retrieval。作者建议用 semantic similarity 作为初始 edge prior,但这会重新引入语义空间偏差。
2. Distillation Error 会进入长期存储
Reflective Agent 依赖 LLM 抽取 user model、事实和因果关系。一旦 hallucination 被写入 semantic store,未来多个 query 都可能复用这个错误;而 hub 越重要,错误传播范围越大。
3. Co-activation 不是因果或事实关系
两条 memory 一起被检索,可能只是 query 同时提到多个无关实体。Hebbian edge 没有 relation type 和 polarity,不能区分“支持”“冲突”“先于”“导致”或“恰好同时出现”。
4. Popularity Bias 与 Hub Domination
高频主题容易成为 hub,被反复传播和蒸馏;低频但关键的 one-off memory 可能长期保持弱连接,并在 age/prune 条件满足后被遗忘。这对事故、一次性承诺、罕见用户禁忌尤其危险。
5. Temporal Conflict 与 Knowledge Update
论文保存 absolute timestamp,也在 LongMemEval-S Knowledge-Update 上表现强,但方法没有显式展示冲突消解规则。旧事实与新事实可能共同进入一个 hub cluster;仅靠 LLM distillation 决定 current truth,缺少可验证的版本控制。
6. Privacy 与“遗忘”语义
Adaptive Forgetting 是相关性垃圾回收,不等同于用户请求的数据删除。即使 episodic node 被删,信息也可能已进入 semantic memory 或关联权重。生产系统需要 provenance-based cascade deletion,而论文未讨论这一点。
7. 评测规模有限
LoCoMo 只有 10 段长对话;附加 LongMemEval-S 有 500 items,但只用 GPT-4o-mini 并以同模型做 judge。缺少更长时间跨度、真实多用户、工具轨迹和开放式任务验证。
十三、与 A-MEM / MAGMA / CoM / ReMemR1 / Mem²Evolve 横向比较
| A-MEM | note network | 写入时由 LLM/语义生成链接 | 写入与更新 | 会,但偏显式 note evolution | 结构化、可链接 | 构建成本与错误链接 |
| MAGMA | 多关系 memory graphs | 不同语义/时序/实体视角 | 写入与图检索 | 结构可更新 | 关系类型更丰富 | 多图维护复杂 |
| CoM | query-time memory chain | query 相关性 + 当前 chain 连贯性 | 查询时 | chain 随当前 query 演化 | 构建轻、利用强 | 每个 query 重建路径 |
| ReMemR1 | 顺序阅读中的工作 memory | Agent 主动 callback 历史状态 | reading / update 时 | 当前状态可回溯修正 | 修复不可逆压缩 | RL 与 callback 成本 |
| Mem²Evolve | experience + capability assets | 经验指导 tool/expert 创建 | 跨任务迭代 | 经验与能力共同进化 | memory 改变 Agent 能力边界 | 工具安全与错误积累 |
| HeLa-Mem | episodic graph + semantic store | 历史检索中的 co-activation 强化边 | 持续检索 + 周期巩固 | 边权、hub、semantic knowledge、删除均演化 | 使用轨迹变成结构学习信号 | 错误共激活正反馈、hub 偏置 |
1. HeLa-Mem vs A-MEM
两者都有 graph,但图的语义不同。A-MEM 更像由 LLM 管理的 note network;HeLa-Mem 更像 usage-conditioned associative graph。前者擅长显式链接与内容更新,后者擅长从历史共同使用中发现潜在关系。
2. HeLa-Mem vs MAGMA
MAGMA 的优势是 relation-aware:不同图显式表达不同关系。HeLa-Mem 的单一加权边更轻量,但无法说明边是什么关系。可以把两者组合:MAGMA 提供 typed edges,HeLa-style update 提供每类边的使用强度。
3. HeLa-Mem vs CoM
CoM 的 chain 是针对当前 query 临时演化;HeLa-Mem 的 graph 跨 query 累积。CoM 问“这次问题应沿什么路径走”,HeLa-Mem 问“过去反复走过哪些路径”。前者适应即时需求,后者利用长期习惯。
4. HeLa-Mem vs ReMemR1
ReMemR1 解决 reading-time information loss,让 Agent 主动回看历史;HeLa-Mem 解决 retrieval-time association learning,让历史共同检索塑造未来路径。一个强调可回溯状态,一个强调可学习连接。
5. HeLa-Mem vs Mem²Evolve
HeLa-Mem 的 semantic consolidation 仍是“更好地记住与回答”;Mem²Evolve 会把经验转成工具/专家,改变可执行能力。HeLa-Mem 可以作为其 experience memory backend:哪些经验反复共同用于解决任务,就形成 hub,进一步触发 capability distillation。
十四、对 Coding Agent / Tool Agent / Multi-Agent 的工程启发
1. Coding Agent:用“共同出现在成功修复中”学习代码关联
Coding Agent 的 memory node 可以是:
- 文件、symbol、测试;
- error message;
- patch;
- issue / PR review;
- build command 与环境约束。
如果 auth middleware、token refresh test 和某个配置文件多次在成功修复中共同被访问,可增强关联边。以后出现相似错误,即使配置文件与错误文本 embedding 不相似,也能沿成功历史被召回。
但更新信号不应是“共同打开”,而应是“共同参与成功结果”。可以将公式(1)的指示函数改为带 outcome credit:
[ w_{ij}^{t+1}=\\rho w_{ij}^{t}+ \\eta,\\mathbb{I}(i,j\\in K_t)\\cdot r_t ]
其中 (r_t) 可由 test pass、review acceptance 或 regression-free score 给出。失败轨迹则应弱化或标为 negative association,避免错误检索自强化。
2. Tool Agent:学习工具组合而不是只学习工具相似度
单个 tool description 只能告诉 Agent 工具“看起来能做什么”。历史执行 trace 能告诉 Agent 哪些工具实际经常一起完成任务:
search issue → inspect logs → query database → update ticket
共成功执行可形成 tool-transition graph;spreading activation 可以从当前命中的工具补全下一步候选。Reflective consolidation 则把高频成功子图蒸馏成 reusable workflow / skill。
3. Multi-Agent:从协作轨迹中形成 team memory
把 agent、artifact、decision、message 作为节点,可以学习:
- 哪类任务常由哪些 agent 协同完成;
- 哪个决策依赖哪些证据;
- 哪些交接组合经常成功;
- 哪些 conflict pattern 需要升级给主 Agent。
但 team memory 必须保留 provenance 和权限边界,不能因为共同激活就让一个 agent 访问另一个 agent 的敏感记忆。
4. 更可靠的生产版应增加四层防护
十五、我的理解与启发
1. 真正的新意是把 Memory Retrieval 变成 Memory Learning
很多系统把 retrieval 当作纯读操作:从数据库取内容,不改变数据库。HeLa-Mem 的关键转变是:每次读都会留下结构痕迹。 这很像推荐系统中的 implicit feedback,也像代码库中由共同修改历史形成的 coupling graph。
这比“脑启发”标签更具有可迁移性。无论节点是对话、代码、工具还是 agent,只要存在重复任务,就可以从共同成功使用中学习关联。
2. “被频繁使用”与“重要”仍不是同一个概念
Hub detection 用总边权代理重要性,但高频日常话题容易成为 hub;一次性重大事实可能不是 hub。一个成熟系统至少要同时考虑:
[ Importance = f(usage, outcome, rarity, user_priority, risk, recency) ]
HeLa-Mem 只较好覆盖了 usage 与部分 recency。
3. 这篇论文最强的模块可能是 consolidation,而不是 association
消融显示移除 Reflective Agent 降幅最大。可能的真实因果链是:hub-based clustering 提供了更好的输入簇,LLM distillation 生成了直接有用的 semantic knowledge;spreading activation 是进一步补充。未来对比应加入 frequency-based clustering + same distillation,才能确认 Hebbian hub 是否不可替代。
4. Memory 系统正在形成“数据面 + 控制面”分工
- Episodic / semantic stores 是数据面;
- edge update、hub detection、forgetting、retrieval routing 是控制面;
- Reflective Agent 是 memory controller。
这个分工对工程实现很重要:主 Agent 不应亲自处理所有 memory maintenance;应该有异步、可审计、可回滚的 controller 管理生命周期。
5. 下一步不是更像大脑,而是更可验证
最值得继续研究的问题包括:
- 边权是否 calibrated,能否预测两条 memory 对答案的联合贡献?
- 错误共激活如何衰减或撤销?
- consolidation 生成的事实如何做 entailment verification?
- 删除证据后,派生 semantic knowledge 如何重算?
- graph benefit 能否在固定总成本、固定 retrieval recall 下成立?
HeLa-Mem 给出了一个有启发性的 learning loop,但生产级长期记忆还需要 provenance、credit assignment、conflict resolution 和 deletion semantics。
十六、局限性总结
论文明确承认
本文进一步识别
十七、总结
HeLa-Mem 用一个很简单但重要的思想重新组织长期 Agent Memory:
共同被检索
↓
关联边增强
↓
未来可沿边联想召回
↓
高连接记忆簇被蒸馏
↓
形成稳定 semantic knowledge
↓
弱、旧、未访问 episode 被清理
其最有价值的贡献,不是证明“LLM memory 就像人脑”,而是提出一个可实现的闭环:让历史检索轨迹成为外部记忆结构的在线学习信号。
实验显示它在 LoCoMo 多数 backbone/类别上取得较强结果,并以约 1K 回答上下文 token 达到优良性能;LongMemEval-S 整体准确率 65.40,也支持其在 Temporal、Multi-Session、Knowledge-Update 任务上的优势。同时,Table 1 的若干落后项、Table 3 的统计口径疑点、forgetting 未被长序列验证、后台总成本未报告,都意味着结论应保持克制。
最后一句话:HeLa-Mem 让 Agent 的记忆关系不再只由“内容像不像”决定,而由“过去是否反复一起帮助过推理”持续塑造;它把静态 memory graph 推向了 usage-conditioned associative memory,但距离可靠的长期学习仍缺少结果归因、错误撤销和可验证巩固。