NPS调研驱动AI产品迭代:从样本设计到改善闭环的完整方法论
一、当产品迭代变成"猜需求":为什么用户访谈代替不了系统调研
AI产品的需求发现有一个独特矛盾。用户嘴上说要更快的响应速度,但行为数据显示他们愿意多等3秒来换取更高质量的回答。用户说希望Agent"更智能",但这个表述无法转化为可执行的开发任务。
产品经理的直觉和小范围用户访谈可以提供方向感,但无法支撑量化决策。NPS(净推荐值)调研在这中间扮演的角色是:把分散的、感性的用户意见,转化为结构化的、可跟踪的量化指标。更重要的是,NPS不是一次性动作,而是一套持续反馈的闭环系统。
二、NPS调研的四阶段闭环架构
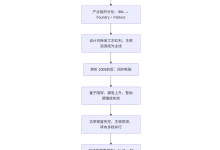
NPS调研的核心挑战不是"怎么发问卷",而是"发完问卷后怎么办"。很多团队做了调研却不了了之,根源在于缺少闭环机制。下图展示了从设计到改善的完整循环:
最容易被忽略的环节是"效果回归验证"。上一轮调研中识别出的问题修复后,下一轮调研需要验证改善效果。如果NPS没有提升,要么是问题定位偏差,要么是修复方案无效。这个回归验证的循环,才是NPS从调研工具升级为增长引擎的关键。
三、样本设计引擎与分群分析的生产级实现
以下代码实现了一套NPS调研的数据处理管道。从样本分层抽样开始,到分群NPS计算结束。核心设计在于:样本分层确保覆盖不同用户群体,避免"沉默大多数"被忽视。
from dataclasses import dataclass, field
from datetime import datetime, timedelta
from enum import Enum
from typing import Optional
import random
import statistics
class NPSGroup(Enum):
PROMOTER = "promoter" # 9-10分,推荐者
PASSIVE = "passive" # 7-8分,被动者
DETRACTOR = "detractor" # 0-6分,贬损者
class UserSegment(Enum):
"""用户分层维度:按活跃度和付费状态交叉切分。"""
ACTIVE_PAID = "active_paid"
ACTIVE_FREE = "active_free"
INACTIVE_PAID = "inactive_paid"
INACTIVE_FREE = "inactive_free"
@dataclass
class NPSResponse:
user_id: str
segment: UserSegment
score: int # 0-10
feedback: str # 开放式反馈文本
response_time: datetime
feature_usage: dict[str, bool] # 功能使用情况
@dataclass
class NPSSegmentResult:
segment: UserSegment
sample_size: int
nps_score: float # -100到+100
promoter_pct: float
passive_pct: float
detractor_pct: float
top_driver: str # 驱动NPS最高的功能
top_detractor_reason: str # 贬损者主要抱怨
class NPSSurveyPipeline:
"""NPS调研数据处理管道。
处理流程:样本分层 → 问卷投放 → 数据清洗 → 分群NPS计算 → 驱动分析
"""
MIN_SAMPLE_PER_SEGMENT = 30 # 每个分层的最小样本量
def __init__(self):
self.responses: list[NPSResponse] = []
def stratified_sample(
self,
user_pool: list[dict],
segments: list[UserSegment],
total_target: int = 500,
) -> list[str]:
"""分层抽样:确保每个用户群体的样本量满足统计显著性。
抽样策略:
– 活跃付费用户:权重最高,占比40%(核心用户)
– 活跃免费用户:占比30%(增长潜力)
– 不活跃用户:占比30%(流失预警)
每层保证>=30个样本,否则整层数据不具备统计意义。
"""
segment_users = {s: [] for s in segments}
for user in user_pool:
seg = UserSegment(user["segment"])
if seg in segment_users:
segment_users[seg].append(user)
sampled = []
ratios = {UserSegment.ACTIVE_PAID: 0.4,
UserSegment.ACTIVE_FREE: 0.3,
UserSegment.INACTIVE_PAID: 0.15,
UserSegment.INACTIVE_FREE: 0.15}
for seg, users in segment_users.items():
target = max(
self.MIN_SAMPLE_PER_SEGMENT,
int(total_target * ratios.get(seg, 0.25)),
)
target = min(target, len(users))
selected = random.sample(users, target)
sampled.extend(u["user_id"] for u in selected)
return sampled
def calculate_nps(self, scores: list[int]) -> float:
"""计算NPS得分 = (推荐者% – 贬损者%) * 100。
注意:NPS范围是-100到+100。结果保留一位小数。
"""
if not scores:
return 0.0
total = len(scores)
promoter_count = sum(1 for s in scores if s >= 9)
detractor_count = sum(1 for s in scores if s <= 6)
return round(
(promoter_count – detractor_count) / total * 100, 1
)
def segment_analysis(self) -> list[NPSSegmentResult]:
"""按用户分层计算NPS,并进行驱动因素分析。
驱动因素分析逻辑:
– 提取推荐者群体的功能使用交集,找Top3共同功能。
– 提取贬损者的反馈关键词,做词频统计。
"""
segment_scores: dict[UserSegment, list[int]] = {}
segment_feedback: dict[UserSegment, list[str]] = {}
segment_features: dict[UserSegment, dict[str, int]] = {}
for resp in self.responses:
seg = resp.segment
if seg not in segment_scores:
segment_scores[seg] = []
segment_feedback[seg] = []
segment_features[seg] = {}
segment_scores[seg].append(resp.score)
if resp.feedback:
segment_feedback[seg].append(resp.feedback)
for feature, used in resp.feature_usage.items():
if used:
segment_features[seg][feature] = (
segment_features[seg].get(feature, 0) + 1
)
results = []
for seg, scores in segment_scores.items():
nps = self.calculate_nps(scores)
promoter_pct = sum(
1 for s in scores if s >= 9
) / len(scores) * 100
passive_pct = sum(
1 for s in scores if 7 <= s <= 8
) / len(scores) * 100
detractor_pct = sum(
1 for s in scores if s <= 6
) / len(scores) * 100
# 找出该分层中使用频率最高的功能(驱动因素)
top_driver = max(
segment_features.get(seg, {"unknown": 0}).items(),
key=lambda x: x[1],
default=("unknown", 0),
)[0]
# 简化实现:在实际生产中应对反馈文本做NLP分析
top_reason = self._extract_top_complaint(
segment_feedback.get(seg, [])
)
results.append(NPSSegmentResult(
segment=seg,
sample_size=len(scores),
nps_score=nps,
promoter_pct=round(promoter_pct, 1),
passive_pct=round(passive_pct, 1),
detractor_pct=round(detractor_pct, 1),
top_driver=top_driver,
top_detractor_reason=top_reason,
))
return results
def _extract_top_complaint(self, feedbacks: list[str]) -> str:
"""从贬损者反馈中提取高频抱怨词。
生产环境中应使用更成熟的NLP方案(如jieba分词+TF-IDF)。
"""
if not feedbacks:
return "无明确反馈"
complaint_keywords = [
"慢", "卡", "不准", "错误", "贵", "复杂", "难用",
"崩溃", "闪退", "无法"
]
keyword_count: dict[str, int] = {}
for fb in feedbacks:
for kw in complaint_keywords:
if kw in fb:
keyword_count[kw] = keyword_count.get(kw, 0) + 1
if not keyword_count:
return "其他"
return max(keyword_count, key=keyword_count.get)
def overall_report(self) -> dict:
"""生成整体NPS调研报告。"""
all_scores = [r.score for r in self.responses]
overall_nps = self.calculate_nps(all_scores)
segment_results = self.segment_analysis()
return {
"overall_nps": overall_nps,
"total_responses": len(self.responses),
"segments": [
{
"segment": r.segment.value,
"nps": r.nps_score,
"sample": r.sample_size,
"top_driver": r.top_driver,
"top_complaint": r.top_detractor_reason,
}
for r in segment_results
],
"survey_date": datetime.now().isoformat()[:10],
}
分层抽样的权重设计是调研有效性的关键。活跃付费用户占比最高,是因为他们对产品价值感知最敏锐。不活跃用户虽然样本占比较低,但他们的反馈往往揭示流失的根本原因。
四、NPS调研方法论的局限与实践陷阱
NPS本身只是指标,不是答案。 调研结果显示NPS=35,这个数字本身不告诉你怎么改进。真正的价值在分群分析和驱动因素归因上。如果只看总分不看分群,NPS就只是一个虚荣指标。
样本偏差的自欺欺人。 只对活跃用户发NPS调研,得到的分数天然偏高。因为不满意的用户早就流失了,根本收不到问卷。调研覆盖必须包含近期流失用户和沉默用户。
反馈文本的解析难题。 开放式反馈的文本是金矿,但解析成本很高。简单的关键词匹配只能抓到显性问题,隐性问题(如"产品定位模糊")需要人工解读。
调研频率的度。 太频繁(每周一次)会让用户产生疲劳,回收率骤降。太稀疏(每年一次)让反馈失去时效性。月度抽样结合季度全量是实践中相对平衡的频率选择。
五、总结
NPS调研的本质不是打分,而是建立一个持续聆听用户的机制。
可立即执行的行动清单:第一,设计分层抽样方案,覆盖付费、免费、流失三类用户。第二,在NPS问题后紧跟一道开放式问题:"您给出这个分数的主要原因是什么?"这两个问题组合的信息密度远大于单题。第三,建立"调研→归因→改善→回归"的四步闭环,每次调研后的改善行动必须在下一轮调研中得到验证。
数据驱动的产品迭代从哪里开始?从系统化地理解用户的不满和期待开始。
NPS调研有一个隐性偏差:愿意填问卷的用户,通常是对产品有一定好感的用户。真正不满的用户可能直接流失,根本不理会调研。这意味着NPS分数天然存在向上偏差。更准确的用户满意度评估,应该结合"沉默流失率"和"降级率"。一个NPS很高但流失率在上升的产品,比NPS中等但流失率稳定的产品更危险。创业者需要同时看显性和隐性两个信号。
另一个实践经验:开放式反馈的文本分析,不能只依赖关键词匹配。用户说"系统太慢了"和"响应时间有点长",描述的是同一个问题,但紧急程度完全不同。语义分析能力在NPS反馈处理中非常关键。如果团队没有NLP能力,人工分类仍然是必要的。不要把所有反馈都交给AI分析,关键反馈必须人脑过一遍。