AI Reviewer 为什么会产生“正确的废话”?
专栏:《AI 代码评审实战:从 Diff 到 Agentic Review》09/12 ← 上一篇 · 专栏目录 · 下一篇 →
 👤 个人主页:zzz_2368 🧪 系列主题:Agent 评测|从结果、轨迹到持续迭代 🔥 热门专栏:Agent | 小z的碎碎念 | Java后端 | Agent 评测
📚 本系列内容:围绕“如何评测和改进 AI 代码评审能力”的技术专栏。 它不是泛泛讲“AI 帮你 Review 代码”,而是更偏工程化、方法论和实战复盘,重点讨论 AI Code Review 里最容易被忽略的几个核心问题
文章目录
- AI Reviewer 为什么会产生“正确的废话”?
-
- 1. 什么是“正确的废话”
- 2. 噪声从哪里来
-
- 提示词奖励“多说”
- 缺乏业务背景
- 规则重复
- 分治导致重复
- 严重程度缺乏校准
- 3. 评论应该通过五道门
- 4. “保持沉默”也是产品能力
- 5. Reflection 能做什么,不能做什么
- 6. 把重复问题升级成确定性检查
- 7. 用反馈闭环校准噪声
- 结论
- 参考资料
“建议补充测试。”“这里可以增加错误处理。”“请考虑并发安全。”这些话通常没有错,却可能对合并决策毫无帮助。AI Reviewer 的最大敌人不一定是幻觉,而是大量语义正确、工程价值接近于零的评论。
1. 什么是“正确的废话”
一条评论事实不假,但满足下列任一情况,就可能缺乏操作价值:
- 没有具体触发条件;
- 没有指出与本次 Diff 的关系;
- 重复编译器、lint 或已有评论;
- 只表达通用最佳实践,不考虑当前权衡;
- 建议修改却不说明风险;
- 严重程度明显夸大;
- 对每个文件重复相同模板。
例如:
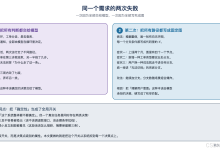
低价值:建议对数据库操作增加异常处理。
可操作:insertOrder 返回 duplicate key 时当前代码统一映射为 500,
会让客户端重试并重复扣减库存;应将该分支映射为幂等成功或 409,
并补充相同 idempotency_key 的重放测试。
后者包含输入、路径、影响和验证方式,Reviewer 才能判断。
2. 噪声从哪里来
提示词奖励“多说”
“全面评审并列出所有问题”会诱导模型提高 Recall,代价是 Precision 下降。对于 PR 评论,默认目标应是“只报告高置信度且值得作者处理的问题”。
缺乏业务背景
模型不知道某段兼容代码为什么存在,就会建议删除;不知道错误由上层统一处理,就会要求每层捕获。没有契约时,它只能回退到通用最佳实践。
规则重复
同一问题同时被 ESLint、Sonar、SAST 和 AI 报告,正确评论仍然是重复成本。AI Reviewer 应读取或至少尊重现有检查边界。
分治导致重复
文件级子 Agent 各自发现同一个根因,最后产生多条局部评论。需要在汇总阶段按根因、调用链和修复点去重。
严重程度缺乏校准
模型可能把“建议添加日志”标为 High,也可能把数据覆盖描述成普通改进。严重程度必须关联可观察影响,而不是使用情绪化措辞。
3. 评论应该通过五道门
发布到 PR 前,候选评论应回答:
任何一项不满足,可以留在内部报告,不必公开评论。
4. “保持沉默”也是产品能力
Review 系统常用评论数量展示价值,但团队真正需要的是信任。十次运行只输出三条评论,如果三条都重要,价值可能高于每个 PR 固定输出十条。
建议给工具三个输出层级:
- publish:高置信度、证据充分,写入 PR;
- investigate:可能重要但证据不足,进入摘要供人工调查;
- drop:风格、重复、低影响或无法验证,静默丢弃。
OpenCodeReview 委托模式文档也采用类似严重程度策略:Critical/High 始终报告,Medium 带上下文报告,Low 默认丢弃。这是项目规则,不是普遍真理,但方向符合降噪目标。
5. Reflection 能做什么,不能做什么
让第二个阶段重新检查候选评论,可以发现行号错误、证据矛盾和低价值建议。更可靠的 Reflection Prompt 不应只是“请检查上一条评论是否正确”,而应要求寻找反证:
请尝试证明候选问题不成立:
1. 搜索现有保护逻辑;
2. 检查调用方是否已校验;
3. 检查异常是否由框架统一处理;
4. 确认问题是否由本次 Diff 引入;
5. 无法获得明确证据时降低置信度或丢弃。
但 Reflection 不是独立真相来源。同模型、同上下文可能重复同一错误。它必须通过对照实验验证是否真正提高 Precision。
6. 把重复问题升级成确定性检查
如果 AI 连续多次正确指出同一种问题,下一步不是让它继续收费,而是把知识固化:
- 写 lint 规则;
- 添加静态扫描规则;
- 加类型约束或 Schema;
- 写单元测试模板;
- 更新代码生成器;
- 加 CI 门禁。
AI 的长期价值之一,是发现团队尚未自动化的质量模式。成熟之后,这些模式应离开 LLM,进入更便宜、更稳定的检查。
7. 用反馈闭环校准噪声
不要只提供“有帮助/没帮助”两个按钮。至少记录:
true_bug / useful_non_bug / false_positive / duplicate / out_of_scope / unclear
每周复盘三个列表:最常见误报、最常见漏报、最常见重复建议。对应调整规则、背景、过滤和发布阈值。若某类评论长期没有被处理,应先停止发布,而不是继续教育开发者。
结论
高质量 AI Review 的标志不是覆盖每一行,而是知道何时发言、如何举证以及何时保持沉默。通过候选评论门禁、反证式 Reflection、根因去重和确定性规则沉淀,才能把“正确的废话”变成少量可执行的风险线索。
下一篇进入海外产品横评。比较重点不会是营销功能数量,而是 Review 发生在哪里、能调查什么、如何定制以及出了错由谁兜底。
参考资料
- OpenCodeReview:委托模式
- OpenCodeReview:论文
- Google Research:Resolving Code Review Comments with Machine Learning
- Microsoft Research:Frustrated with Code Quality Issues? LLMs Can Help!
感谢阅读,记得点赞、关注、收藏,欢迎各位评论区交流!!!