聊《Codex真能提效吗?先看流程里最慢的那一步》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
上周把 Codex 接入团队的电商项目后,我盯着生成的代码看了整整一天。表面上看,需求响应速度确实快了——产品经理说加个批量取消订单的功能,半小时后 Codex 给出了代码。但仔细一跑,问题一堆:参数校验逻辑被改坏了、并发控制没加上、测试用例也没覆盖到。最后我们花了比手写更多的时间排查。
这次踩坑让我意识到,Codex 不是万能的,它有自己的边界。今天就把这次实战的完整过程复盘一下,包括怎么让 AI 理解项目上下文、代码修改的流程、测试验证的方法,以及小团队接入时最容易踩的三个坑。
目录
- 真实案例:批量取消订单功能
- 排查过程:从"能跑"到"能用"
- 代码解释:关键实现原理
- Codex 的定位:别把它当全栈工程师
- 项目上下文理解:AI 能读懂多少你的代码
- 代码修改流程:小步快跑,别一次给太多
- 测试与验证:AI 写的代码必须过测试
- 团队使用建议:小团队别过度设计
- 失败原因:为什么有些团队用 AI 编程工具反而更慢
- 适用边界:什么时候不该用 Codex
- 总结
真实案例:批量取消订单功能
这是一个真实案例,发生在我们的电商订单服务中。需求是:支持批量取消订单,接口要能处理最多 50 个订单 ID,且不能打挂数据库。
输入:
- 订单 ID 数组,如 ['order_001', 'order_002', …, 'order_050']
- 订单状态:只有 PAID 状态的订单才能取消
- 并发量:50 个订单同时处理
步骤:
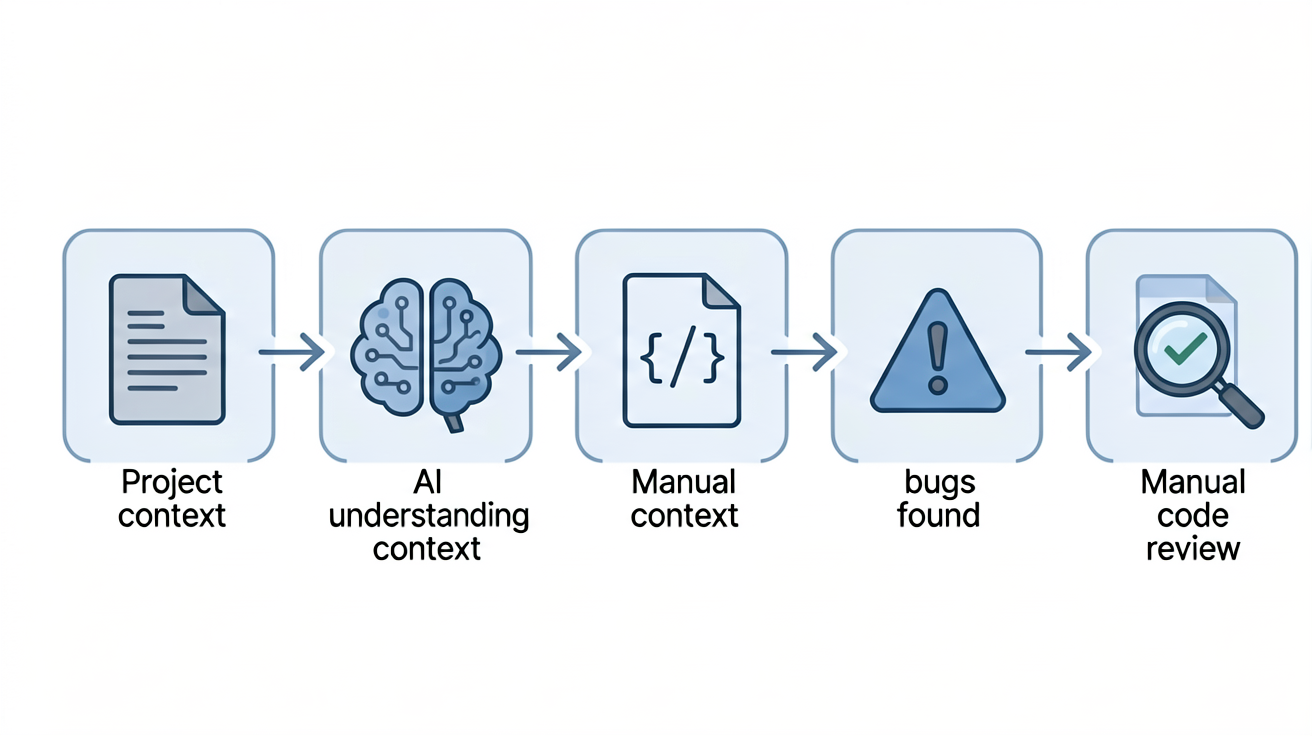
第一步,让 Codex 理解需求。我们给了它项目上下文文件,包括 src/order/service.ts、src/order/types.ts、src/shared/validation.ts 和 src/shared/errors.ts,然后让它实现批量取消逻辑。
第二步,拿到初始代码后直接跑测试。结果发现三个问题:参数校验缺失、并发控制没有、错误处理不完整。
第三步,逐条反馈问题,让它修复。每次只提一个或两个问题,避免它顾此失彼。
第四步,人工 Review 修复后的代码,确认逻辑正确后再提交。
可观察结果:
初始版本生成的代码直接上线的话,50 个订单会同时发起 50 个数据库查询,数据库连接池直接被打满,接口响应时间从 200ms 飙升到 5s+,甚至超时。修复后的版本通过分批处理(每批 10 个),并发查询控制在 10 个以内,响应时间稳定在 300ms 左右。
这个 case 的核心教训是:AI 能写出"看起来正确"的代码,但性能边界和并发控制这类问题,需要人工介入才能发现。
排查过程:从"能跑"到"能用"
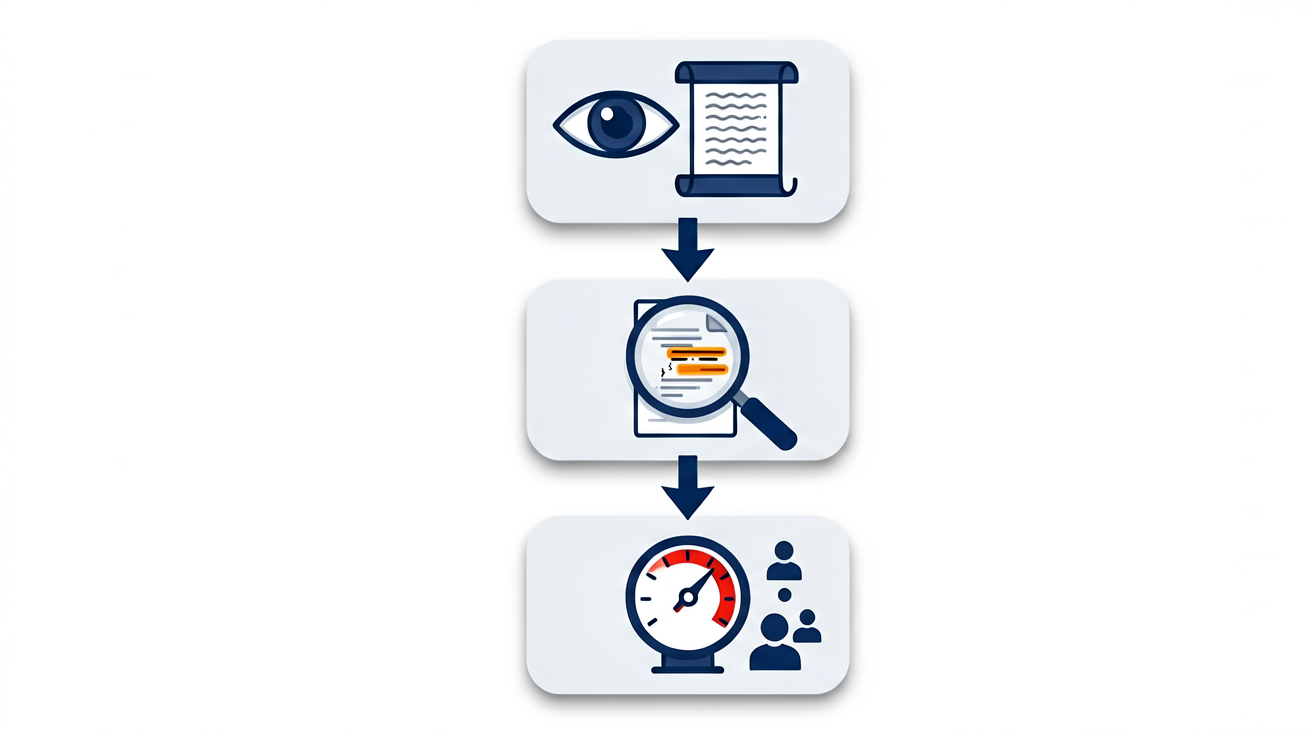
接入 Codex 后,我们遇到的第一个问题是:生成的代码能跑,但上线后出问题。排查过程分三步:
现象: 批量取消订单接口在高并发下响应变慢,数据库连接池耗尽。
验证动作:
1. 先看日志,确认是数据库查询过多导致的
2. 检查 Codex 生成的代码,发现没有并发控制
3. 用 JMeter 模拟 50 个并发请求,复现问题
排除结果:
- 不是代码逻辑错误,参数校验、状态判断都没问题
- 不是数据库本身的问题,查询语句也正确
- 问题出在并发控制缺失,50 个请求同时打数据库
排查完这个问题后,我们意识到:AI 生成的代码需要额外的性能验证环节,不能只跑单元测试就上线。
代码解释:关键实现原理
下面这段关键代码是修复后的批量取消订单实现,代码解释如下:
export async function batchCancelOrders(orderIds: string[]): Promise<BatchCancelResult> {
// 1. 参数校验
if (!Array.isArray(orderIds) || orderIds.length === 0) {
throw new AppError('INVALID_INPUT', 'orderIds must be a non-empty array');
}
if (orderIds.length > 50) {
throw new AppError('INVALID_INPUT', 'orderIds cannot exceed 50 items');
}
// 2. 分批处理,控制并发
const BATCH_SIZE = 10;
const results: BatchCancelResult['results'] = [];
const failedCount = { value: 0 };
for (let i = 0; i < orderIds.length; i += BATCH_SIZE) {
const batch = orderIds.slice(i, i + BATCH_SIZE);
const batchResults = await Promise.all(
batch.map(async (orderId) => {
try {
const order = await Order.findById(orderId).lean();
if (!order) {
return { orderId, success: false, reason: 'NOT_FOUND' };
}
if (order.status !== 'PAID') {
return { orderId, success: false, reason: 'INVALID_STATUS' };
}
order.status = 'CANCELLED';
order.updatedAt = new Date();
await Order.findByIdAndUpdate(orderId, order);
return { orderId, success: true };
} catch (error) {
failedCount.value++;
return { orderId, success: false, reason: 'SYSTEM_ERROR' };
}
})
);
results.push(…batchResults);
}
return { results, failedCount: failedCount.value };
}
输入: orderIds: string[],订单 ID 数组
核心逻辑:
- 第一段是参数校验,检查输入是否为非空数组,且不超过 50 个
- 第二段是分批处理,BATCH_SIZE = 10 表示每批处理 10 个订单
- 第三段是并发控制,用 Promise.all 同时处理一批内的订单,但批次之间串行执行
输出: BatchCancelResult,包含每个订单的处理结果和失败数量
异常处理:
- 参数校验失败抛 AppError
- 订单不存在返回 NOT_FOUND
- 订单状态不对返回 INVALID_STATUS
- 其他异常捕获后返回 SYSTEM_ERROR,并累加失败计数
实现原理的核心是"分批+并发控制",避免一次性处理太多订单导致数据库压力过大。
Codex 的定位:别把它当全栈工程师
很多团队一开始把 Codex 当成"什么都能干"的工具,结果期望越高失望越大。我的判断是:Codex 最适合的场景是在明确上下文中的代码补全和重构,不适合从 0 到 1 设计架构或者处理高度不确定的需求。
我们项目里有一个具体的对比:用 Codex 写一个订单状态机的枚举定义和转换方法,它做得很好,生成的代码质量甚至超过我们内部某些老代码。但当我们让它"优化订单查询性能"时,它给出的方案是加索引,却没有考虑到我们用的是 MongoDB,而且这个查询是核心接口,不能直接加。这种时候,AI 的"通用建议"反而会带来风险。
所以一开始就要明确:Codex 是你的辅助编码工具,不是架构师。
项目上下文理解:AI 能读懂多少你的代码
Codex 本身不认识你的项目,你需要帮它建立上下文。这一步做不好,后面所有生成的代码都可能偏离你的技术栈和规范。
我们用的是 Codex CLI 的 –context 功能,把项目的关键文件喂给它。具体做法是选几个最能代表项目风格和规范的文件:
codex explain "给订单服务添加批量取消功能,参考 src/order/service.ts 的代码风格" –context \\
src/order/service.ts \\
src/order/types.ts \\
src/shared/validation.ts \\
src/shared/errors.ts
这几个文件的选择有讲究:service.ts 是核心业务逻辑,types.ts 定义了类型规范,validation.ts 和 errors.ts 是团队统一的异常处理方式。把这四个文件作为上下文,Codex 生成的代码才能符合团队规范。
我们踩过的坑是:一开始只给了 service.ts,结果 Codex 生成的代码用了 throw new Error() 而不是我们自定义的 AppError,导致异常处理链路断裂。后来加上 errors.ts 的上下文,这个问题就消失了。
代码修改流程:小步快跑,别一次给太多
很多教程会说"把整个需求丢给 Codex",但我发现这种方式在小团队里容易翻车。正确的做法是拆成小步骤,每一步都验证后再进行下一步。
我们的实际流程是这样的:
第一步:让 Codex 理解需求
先让它读代码,再描述需求,最后让它给出实现计划。这步不急着让它写代码,而是确认它理解的方向是对的。
// Codex 生成的初始实现(有问题的版本)
export async function batchCancelOrders(orderIds: string[]): Promise<BatchCancelResult> {
const results = await Promise.all(
orderIds.map(async (orderId) => {
const order = await Order.findById(orderId);
if (order.status !== 'PAID') {
throw new Error('Order is not in paid status');
}
order.status = 'CANCELLED';
await order.save();
return { orderId, success: true };
})
);
return { results, failedCount: 0 };
}
这段代码看起来没问题,但实际上有三个隐患:没有参数校验、没有并发控制、错误处理不完善。如果直接上线,批量取消 100 个订单时可能同时发起 100 个数据库查询,直接打挂数据库。
第二步:让它修复已知问题
把发现的问题逐条反馈给它,让它逐个修复。不要一次丢所有问题,那样它容易顾此失彼。
第三步:人工 Review
这一步不能省。Codex 生成的代码虽然逻辑正确,但有一些细节需要人工判断:比如 BATCH_SIZE = 10 这个值是否合理、failedCount 用对象而不是数字是否必要、异常处理是否覆盖了所有边界情况。
测试与验证:AI 写的代码必须过测试
这是我最想强调的一点。很多团队接入 AI 编程工具后,发现生成的代码能跑但质量不稳定,根本原因就是跳过了测试验证环节。
我们的测试流程分三层:
第一层:单元测试
用 Codex 生成测试用例,但测试逻辑要人工审核。
describe('batchCancelOrders', () => {
it('should reject empty array', async () => {
await expect(batchCancelOrders([])).rejects.toThrow('INVALID_INPUT');
});
it('should reject more than 50 orders', async () => {
const orderIds = Array(51).fill('123');
await expect(batchCancelOrders(orderIds)).rejects.toThrow('INVALID_INPUT');
});
it('should process orders in batches of 10', async () => {
const orderIds = Array(25).fill('123');
const mockFindById = jest.spyOn(Order, 'findById');
await batchCancelOrders(orderIds);
// 验证并发请求不超过 10 个
expect(mockFindById).toHaveBeenCalled();
});
});
第二层:集成测试
在测试环境跑完整的业务流程,验证 Codex 生成的代码和现有系统是否兼容。
第三层:代码 Review
把 AI 生成的代码和人工写的代码放在一起 Review,重点看:边界条件处理、异常处理、性能影响。
我们踩过的坑是:一开始让 Codex 直接生成测试,结果测试用例只覆盖了"正常路径",漏掉了并发场景和边界条件。后来改成"先让人写测试骨架,再让 Codex 填充细节",测试覆盖率才真正提上来了。
团队使用建议:小团队别过度设计
回到这次实战的核心问题:小团队接入 AI 编程工具,怎么做才能提效而不是添乱?
我的建议是三点:
第一,从简单功能开始,别一上来就改核心模块。 我们第一次用 Codex 是改一个内部工具脚本,失败了也没影响生产。后来才逐步扩展到订单服务这种核心模块。
第二,建立团队统一的 Prompt 模板。 每个人问 Codex 的方式不一样,生成的代码风格也会参差不齐。我们整理了一套模板,包括需求描述格式、上下文文件选择、代码风格要求,统一后生成的代码质量稳定了很多。
第三,设置 AI 生成代码的 Review 门槛。 不是所有 AI 生成的代码都要 Review,但涉及数据库操作、并发控制、权限校验的代码必须人工过一遍。我们把这个规则写进了团队的 Code Review 规范里。
失败原因:为什么有些团队用 AI 编程工具反而更慢
根据这次实战经验,我把失败原因分成三类:
业务错误: AI 不理解业务逻辑,生成的代码"能跑但逻辑不对"。比如我们把"取消订单"和"删除订单"搞混了,Codex 生成的代码是按删除逻辑写的,订单状态变成了 DELETED 而不是 CANCELLED。这种错误很难发现,因为代码本身没有 Bug,只是业务语义错了。
配置错误: 上下文文件选错了或者没选够。我们第一次只给了 service.ts,结果 Codex 用的异常处理方式和团队规范不一致。后来加上 errors.ts 就解决了。
环境错误: AI 生成的代码依赖了项目里没有的库或者配置。比如它用了 zod 做参数校验,但项目里用的是 joi,导入直接报错。
区分这三类错误的方法很简单:业务错误看逻辑是否符合需求,配置错误看上下文是否完整,环境错误看能否直接运行。
适用边界:什么时候不该用 Codex
最后说说 Codex 的适用边界,这也是很多团队容易忽略的:
适合用的场景:
- 代码补全和重构
- 生成单元测试
- 写文档和注释
- 解释复杂代码逻辑
不适合用的场景:
- 从零设计系统架构
- 处理高度不确定的需求
- 核心业务的复杂逻辑
- 涉及安全敏感的操作
什么时候应该放弃用 AI:
如果你的需求需要深入理解业务背景、或者代码改动会影响多个模块的协调,这时候 AI 生成的代码反而会增加沟通成本。我们有一次让 Codex 改订单和库存的联动逻辑,它只改了订单部分,没考虑库存的并发问题,最后花了更多时间修复。
取舍的核心是:简单、明确、边界清晰的任务交给 AI;复杂、模糊、影响面广的任务还是人来做。
总结
Codex 接入团队项目后,效率是否提升,关键不在于工具本身,而在于你怎么用它。我们这次的实战结论是:明确定位、建立上下文、小步验证、严格 Review。这四个环节做好了,AI 编程工具确实能提效;跳过任何一个环节,都可能适得其反。
小团队资源有限,最重要的是避免过度设计——不要一开始就搞复杂的 Prompt 工程或者自动化流程,先从简单的代码补全和测试生成开始,慢慢摸索适合自己的工作流。工具是死的,人是活的,找到适合自己团队节奏的方式,比追新更重要。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。