在学 MySQL 时,我们常听到四句话:
- mysql 是客户端,mysqld 是服务端;
- 创建数据库后,/var/lib/mysql 下就多了一个文件夹;
- 备份就是用 mysqldump 把 SQL 语句保存下来,还原就是 source 执行一遍;
- 存储引擎决定了数据怎么存、怎么索引、怎么锁。
这些话背后藏着几个值得深究的问题:
我们从第一个问题入手,逐层拆解。
一、什么是 MySQL
1.1 本质:一个基于 C/S 模式的网络服务
MySQL 本质上是一个网络数据库服务,采用经典的 C/S(Client/Server,客户端 / 服务端)架构:
- mysql:客户端程序(CLI 命令行工具),是用户输入 SQL 命令的交互入口;
- mysqld:服务端守护进程(d 代表 daemon),是真正执行计算、管理数据的核心程序 —— 接收指令、解析语法、查询优化、执行操作、返回结果。
客户端和服务端可以部署在不同机器上(通过 -h 指定 IP 远程连接),也可以运行在同一台机器上。单机开发时,你的主机上同时运行着两个独立进程:一个 mysql 客户端进程、一个 mysqld 服务端进程,准确说法是 “这台机器同时承担了客户端和服务端角色”。
两者的通信方式:
- 默认通过 TCP/IP 协议的 3306 端口 通信,支持跨网络访问;
- 本地登录时也可走 Unix Socket 文件(本地套接字),无需走网络协议栈,速度更快。
注意:Socket 文件默认路径因发行版而异:Ubuntu 多为 /var/run/mysqld/mysqld.sock,CentOS 多为 /var/lib/mysql/mysql.sock,可通过配置文件修改。
1.2 mysqld 提供什么服务
mysqld 提供的是完整的数据库管理系统(DBMS)服务,而不是简单的文件读写。
1.3 什么是数据库服务
所有数据最终在硬盘上都是二进制字节,普通文件系统只负责 “把字节存进磁盘块、按文件名检索”,不对数据本身做任何结构化加工。
而数据库服务,是在文件系统之上,对数据做了一层 “结构化管理加工”:
- 结构化组织:按库、表、行、列组织数据,定义清晰的二维表结构;
- 类型与约束:每列有明确的数据类型、非空、唯一、主键等约束,从写入端保证数据合法性;
- 索引机制:建立索引将查询复杂度从全表扫描降为对数级,大幅提升检索速度;
- 事务与一致性:通过 ACID 特性保证多步操作要么全部成功、要么全部失败,不会出现中间状态;
- 并发控制:通过锁机制 + MVCC 支持多用户同时读写,互不干扰;
- 崩溃恢复:异常断电后能自动恢复到一致状态,不丢失已提交数据。
1.4 登录操作
基础登录命令:
mysql -h IP -P 端口 -u 用户名 -p
| -h | 目标服务器 IP | 不写默认连接本机 localhost |
| -P | 端口号 | 大写 P,默认 3306 |
| -u | 登录用户名 | 如 root |
| -p | 登录密码 | 小写 p |
两个关键实操细节:
- mysql -u root -p123456 合法,密码为 123456;
- mysql -u root -p 123456 会被解析为 “密码为空,123456 是要连接的数据库名”,直接报错。
- 只写 -p,回车后交互式输入密码;
- 使用 mysql_config_editor 加密存储登录凭证,无需每次输入密码。
二、常见的数据库服务软件
| SQL Server | 微软 | 深度集成 Windows/.NET 生态,图形化工具完善 | 中大型企业项目、.NET 技术栈 |
| Oracle | 甲骨文公司 | 功能全面,高并发、复杂事务处理能力极强,稳定性极高;商业授权昂贵、运维复杂 | 超大型企业、金融、核心业务系统 |
| MySQL | 甲骨文(收购 Sun 后获得) | 开源流行,InnoDB 行锁 + MVCC 并发性能优秀,简单 SQL 执行效率高,生态完善 | 电商、社交、互联网业务、中小项目 |
| PostgreSQL | 加州大学伯克利分校 | 完全开源,功能强大,复杂查询、高级数据类型(地理信息、JSON)支持好 | 数据分析、复杂查询、GIS 系统 |
| SQLite | 开源社区 | 轻量级嵌入式数据库,单文件存储,占用资源极低,支持 ACID | 移动端、嵌入式设备、桌面应用内嵌 |
| H2 | 开源(Java) | Java 语言开发的嵌入式数据库,可作为类库直接嵌入应用 | Java 项目开发测试、内嵌数据库 |
补充说明:“Oracle 并发不如 MySQL” 是常见误区。Oracle 在超大规模并发与复杂事务处理上的能力并不弱于 MySQL,甚至更强;两者的核心差距在于授权成本、运维复杂度和生态定位,而非并发能力本身。
三、客户端与服务端的交互模型
整个交互流程可以简化为一条链路:
客户端 mysql ── 发送 SQL 语句 ──> 服务端 mysqld
↓
词法/语法解析
↓
查询优化
↓
调用存储引擎执行
↓
客户端 mysql <── 返回结果集/状态 ────┘
单机部署时,mysqld 以操作系统用户的身份直接读写本地磁盘上的数据文件(默认 /var/lib/mysql 目录),本质还是本地文件 IO;但对客户端来说,所有操作都通过 SQL 接口完成,不需要直接操作文件。
四、数据库服务的类型:SQL 分类
SQL 按功能分为五大类,这是数据库原理的核心考点:
| DDL | Data Definition Language 数据定义语言 | 定义和修改数据的结构(库、表、索引) | CREATE、DROP、ALTER、TRUNCATE |
| DML | Data Manipulation Language 数据操纵语言 | 对表中的数据进行增删改操作 | INSERT、DELETE、UPDATE |
| DQL | Data Query Language 数据查询语言 | 查询数据 | SELECT |
| DCL | Data Control Language 数据控制语言 | 权限与访问控制 | GRANT(授权)、REVOKE(撤权) |
| TCL | Transaction Control Language 事务控制语言 | 事务管理与一致性控制 | START TRANSACTION、COMMIT、ROLLBACK、SAVEPOINT |
两个重要辨析:
五、存储引擎(重点:讲透本质)
5.1 到底什么是存储引擎
既然 MySQL 本身就是数据库软件,为什么还要有 “存储引擎” 这一层?核心在于分层解耦的可插拔架构。
MySQL 整体分为上下两层:
┌───────────────────────────────────────────────────┐
│ SQL 层(MySQL Server 层) │
│ 负责:连接管理、权限校验、语法解析、查询优化、 │
│ 缓存管理、统一 SQL 接口 │
├───────────────────────────────────────────────────┤
│ 存储引擎层(可插拔) │
│ 负责:数据怎么存磁盘、怎么建索引、怎么加锁、 │
│ 怎么实现事务、怎么保证崩溃恢复 │
└───────────────────────────────────────────────────┘
存储引擎,就是 “数据存储与访问的底层实现引擎”。打个比方:
- MySQL Server 层是汽车的车身、方向盘、仪表盘、油门刹车 —— 对外的操作接口都是统一的 SQL;
- 存储引擎是汽车的发动机 —— 换上不同的发动机,动力、油耗、稳定性、越野能力完全不同。
这就是 MySQL “可插拔存储引擎” 的含义:同一套 SQL 语法,底层存储实现可以自由切换,上层业务无感知。
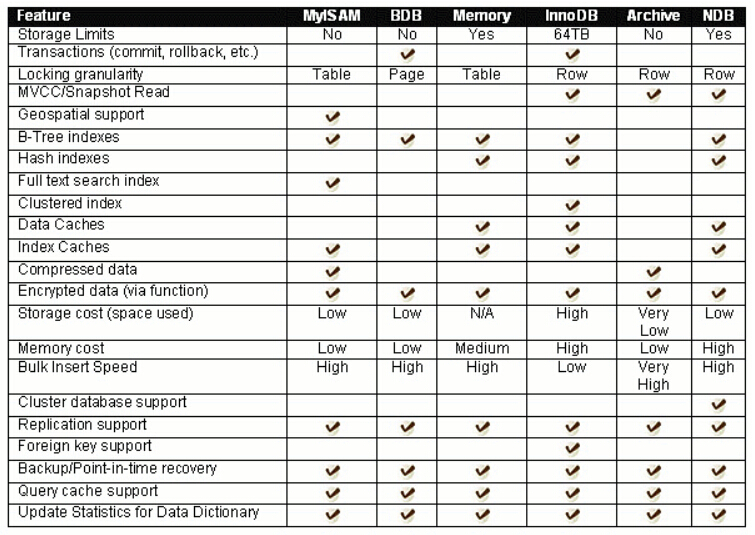
查看当前 MySQL 支持的所有存储引擎:
SHOW ENGINES;
 5.2 常用的 InnoDB 和 MyISAM
这是面试和考试的核心对比,也是 MySQL 发展史上最重要的两个引擎。
| 事务支持 | ✅ 支持完整 ACID 事务 | ❌ 不支持事务 |
| 锁粒度 | ✅ 行级锁(基于索引)+ 意向锁 + 间隙锁,并发性能高 | ❌ 仅支持表级锁,读写互斥,并发差 |
| 外键约束 | ✅ 支持外键 | ❌ 不支持外键 |
| 索引结构 | ✅ 聚簇索引(主键索引和数据存放在一起) | ❌ 非聚簇索引(索引和数据分离) |
| MVCC 多版本并发 | ✅ 支持,读写不阻塞 | ❌ 不支持 |
| 崩溃恢复 | ✅ 支持(Redo Log + Undo Log 自动恢复) | ❌ 崩溃后易损坏,需手动修复 |
| 磁盘文件 | 独立表空间下:.ibd(数据 + 索引) | .MYD(数据文件)+ .MYI(索引文件) |
| 适用场景 | 绝大多数业务:电商、金融、社交等需要事务和高并发的场景 | 只读多、写入少的历史归档场景,老系统兼容 |
核心扩展:为什么 InnoDB 并发更好?
5.3 如何指定引擎
建表时显式指定(推荐):
CREATE TABLE t (id INT) ENGINE=InnoDB;
已有表修改引擎(会重建表,大表谨慎操作):
ALTER TABLE t ENGINE=InnoDB;
注意:修改引擎是全表重建操作,大表会产生大量 IO,生产环境需在低峰期执行。
六、数据库(database)的操作
6.1 创建数据库
CREATE DATABASE [IF NOT EXISTS] 库名;
- MySQL 以分号 ; 作为命令结束标志;
- IF NOT EXISTS:如果库已存在则不报错,不存在则创建,避免重复创建报错。
示例:
CREATE DATABASE IF NOT EXISTS bksw;
6.2 查看有哪些数据库
SHOW DATABASES;
执行后可以看到系统自带库(mysql、information_schema、performance_schema、sys)和用户创建的库。
6.3 数据库文件存储在哪里
Linux 系统下,MySQL 默认数据目录为 /var/lib/mysql。
对应关系非常直观:
- 一个数据库 = 数据目录下的一个文件夹;
- 文件夹里存放该库所有表的数据文件、索引文件。
补充细节:
- InnoDB 独立表空间模式下(innodb_file_per_table=1,默认开启),每张表对应一个 .ibd 文件;
- MySQL 8.0 开始,表结构定义(元数据)统一存入系统数据字典,不再有单独的 .frm 结构文件;
- 如果开启共享表空间,所有表的数据会集中存放在 ibdata1 文件中,不会按表拆分。
6.4 如何使用这个数据库
USE 库名;
例如 USE bksw;,可以理解成 cd 进入这个目录,后续操作默认都针对这个库。
6.5 自定义数据库字符集和校验规则
- 字符集(charset):定义字符用什么字节编码存储,解决 “怎么存” 的问题。
- utf8mb3:MySQL 历史版本的 “utf8”,最多 3 字节,不支持 emoji 等 4 字节字符,不推荐;
- utf8mb4:完整标准 UTF-8,支持所有字符,推荐使用。
- 校验规则(collation):定义字符串比较、排序的规则,解决 “怎么比大小、怎么排序” 的问题。
- utf8mb4_general_ci:ci = case insensitive,大小写不敏感,通用排序;
- utf8mb4_bin:二进制比较,大小写敏感,精度高。
重要原则:字符集和校验规则必须配套,每个字符集都有对应的一组校验规则,不能跨字符集乱配。
常用查看命令:
SHOW CHARSET; — 查看所有支持的字符集
SHOW COLLATION; — 查看所有支持的校验规则
SHOW VARIABLES LIKE 'character_set_database'; — 查看当前库默认字符集
SHOW VARIABLES LIKE 'collation_database'; — 查看当前库默认校验规则
创建数据库时显式指定(推荐):
CREATE DATABASE IF NOT EXISTS xxx
CHARSET = utf8mb4
COLLATE = utf8mb4_general_ci;
6.6 查看创建 database 的执行语句
SHOW CREATE DATABASE 库名; — 表格形式显示
SHOW CREATE DATABASE 库名 \\G — 命令行垂直显示,内容更清晰
示例输出说明:
+———-+———————————————————————+
| Database | Create Database |
+———-+———————————————————————+
| bksw | CREATE DATABASE `bksw` /*!40100 DEFAULT CHARACTER SET utf8mb3 */ |
| | /*!80016 DEFAULT ENCRYPTION='N' */ |
+———-+———————————————————————+
- /*!版本号 内容 */:MySQL 特有的版本条件注释。当 MySQL 版本大于等于注释中的版本号时,才执行里面的内容;低版本会自动忽略,用于向下兼容。
- 示例中的 utf8mb3 说明这个库是老版本创建的,8.0 新库默认字符集为 utf8mb4。
6.7 修改数据库
主要用于修改默认字符集和校验规则:
ALTER DATABASE 库名 CHARSET = utf8mb4 COLLATE = utf8mb4_general_ci;
⚠️ 高频踩坑提醒: ALTER DATABASE 只修改数据库的默认字符集,仅对之后新建的表生效,不会修改已有表和字段的字符集。已有表需要单独执行 ALTER TABLE 才能修改。
另外,MySQL 没有提供修改数据库名的命令。因为库名被上层业务引用后修改会引发严重故障,如需改名只能通过 “导出数据 → 新建库 → 导入数据” 的方式实现。
6.8 删除数据库
DROP DATABASE [IF EXISTS] 库名;
执行后,/var/lib/mysql 下对应的文件夹会被直接删除,所有数据永久消失,不可逆。因此删除前务必确认备份。
6.9 备份数据库
mysqldump 是 MySQL 自带的逻辑备份工具,本质是把库表结构和数据转换成 SQL 语句导出。
备份单个数据库
mysqldump -P 端口 -u 用户名 -p -B 库名 > 备份文件路径.sql
- -B:包含 CREATE DATABASE 和 USE 语句,还原时无需手动建库。
备份多个数据库
mysqldump -P 端口 -u 用户名 -p -B 库1 库2 库3 > 备份文件路径.sql
备份指定表(重点:不能加 -B)
mysqldump -P 端口 -u 用户名 -p 库名 表1 表2 > 备份文件路径.sql
注意:-B 参数后面的所有参数都会被识别为数据库名。备份单库内的表时,第一个参数写库名,后面直接写表名,不能加 -B,否则会把表名当成库名报错。
还原数据库
方式一:登录 MySQL 后用 source 命令
source /路径/备份文件.sql;
方式二:命令行直接导入
mysql -u 用户名 -p < 备份文件.sql
生产环境备份补充:
- InnoDB 引擎请加上 –single-transaction 参数,通过事务一致性实现热备份,备份期间不锁表;
- 大库备份推荐使用物理备份工具(如 xtrabackup),速度远快于逻辑备份。
6.10 查看数据库的连接情况
SHOW PROCESSLIST;
示例输出:
+—–+—————–+———–+———+———+———+————————+——————+
| Id | User | Host | db | Command | Time | State | Info |
+—–+—————–+———–+———+———+———+————————+——————+
| 5 | event_scheduler | localhost | NULL | Daemon | 1194881 | Waiting on empty queue | NULL |
| 959 | root | localhost | test9_8 | Query | 0 | init | show processlist |
+—–+—————–+———–+———+———+———+————————+——————+
常见疑问:为什么有两行?哪一行是 mysqld?
两行都不是 “mysqld 本体”,它们都是 mysqld 进程内部的线程:
补充:
- 实际环境中 mysqld 还有更多后台线程(主线程、IO 线程、锁监控线程等),只是默认不一定都显示在 processlist 中;
- 排查非法连接时,重点看 User、Host 列是否有陌生来源,以及 Command 是否为异常的 Query/Sleep;
- 想看完整的正在执行的 SQL,使用 SHOW FULL PROCESSLIST;。
七、表(table)的操作
7.1 什么是表
数据库是数据的命名空间(相当于文件夹),真正存储数据的载体是表(table)。
类比文件系统:
- 数据库(database) ≈ 文件夹,用于分类管理;
- 表(table) ≈ 文件夹里的文件,真正存储数据;
- 行(row) ≈ 文件里的一条记录;
- 列(column) ≈ 记录里的一个字段 / 属性,有明确的类型和约束。
一张 InnoDB 表,在独立表空间模式下落盘后就是 /var/lib/mysql/库名/ 下的一个 .ibd 文件。
注意:创建表之前,必须先通过 USE 进入对应的数据库。
7.2 创建表
基础语法:
CREATE TABLE 表名 (
字段1 数据类型 [约束],
字段2 数据类型 [约束],
字段3 数据类型 [约束]
) [DEFAULT CHARACTER SET 字符集]
[COLLATE 校验规则]
[ENGINE 存储引擎];
- 字符集、校验规则、引擎默认继承数据库的配置,显式指定则优先使用显式值;
- 常见数据类型:INT(整数)、VARCHAR(n)(变长字符串)、CHAR(n)(定长字符串)、TEXT(长文本)、DATE、DATETIME 等。
7.3 查看表的结构
DESC 表名;
— 等价于
DESCRIBE 表名;
— 也可以用
SHOW COLUMNS FROM 表名;
可以查看字段名、数据类型、是否允许空、键类型、默认值等信息。
7.4 修改表
ALTER TABLE 是修改表结构的总命令,支持多种操作,逗号分隔可同时执行多个(改表名除外)。
| 新增列 | ALTER TABLE 表名 ADD 列名 类型 [约束]; | 添加新字段 |
| 修改列类型 / 约束 | ALTER TABLE 表名 MODIFY 列名 新类型 [约束]; | 只改类型 / 约束,不改列名 |
| 删除列 | ALTER TABLE 表名 DROP COLUMN 列名; | 删除字段及所有数据 |
| 修改列名 + 类型 | ALTER TABLE 表名 CHANGE 旧列名 新列名 完整类型定义; | 既改名又改类型,必须重写完整定义 |
| 仅修改列名 | ALTER TABLE 表名 RENAME COLUMN 旧列名 TO 新列名; | MySQL 8.0+ 支持,只改名不改类型 |
| 修改表名 | ALTER TABLE 旧表名 RENAME TO 新表名; | 整表改名 |
同时执行多个修改操作
除了改表名(RENAME TO)必须单独语句外,ADD、MODIFY、DROP、CHANGE、RENAME COLUMN 都可以写在同一条 ALTER 里,逗号分隔,原子执行:
ALTER TABLE employee
ADD age INT,
MODIFY name VARCHAR(60),
CHANGE salary emp_sal DECIMAL(10,2),
RENAME COLUMN dept TO dept_name;
⚠️ 重要规则:
- CHANGE 后面必须跟 “旧列名 + 新列名 + 完整类型定义”,哪怕只改名不改类型,也必须重写类型;
- ALTER TABLE … RENAME TO 改表名不能和其他操作合并,必须单独一条语句;
- 同一条 ALTER 内的多个操作是原子的,要么全部成功,要么全部失败。
7.5 删除表
DROP TABLE [IF EXISTS] 表名;
删除后表结构和数据全部消失,不可逆。
7.6 为属性添加注释
建表时可以给字段加注释,提升可读性:
CREATE TABLE employee (
name VARCHAR(60) COMMENT '员工姓名',
salary DECIMAL(10,2) COMMENT '员工月薪'
);
说明:MySQL 默认模式下,单引号和双引号都可以表示字符串;只有开启 ANSI_QUOTES 模式时,双引号才会被当作标识符(表名、列名)而非字符串。
7.7 查看创建表的语句
SHOW CREATE TABLE 表名;
SHOW CREATE TABLE 表名 \\G
可以查看完整的建表语句、字符集、引擎、注释等所有信息。
7.8 向表中插入数据
基础插入:
INSERT INTO 表名 (字段1, 字段2) VALUES (值1, 值2);
示例:
INSERT INTO employee (name, salary) VALUES ('张三', 8000);
扩展:批量插入 一条 INSERT 可以插入多行,性能远高于逐条插入:
INSERT INTO employee (name, salary)
VALUES ('张三', 8000), ('李四', 9000), ('王五', 10000);