前言
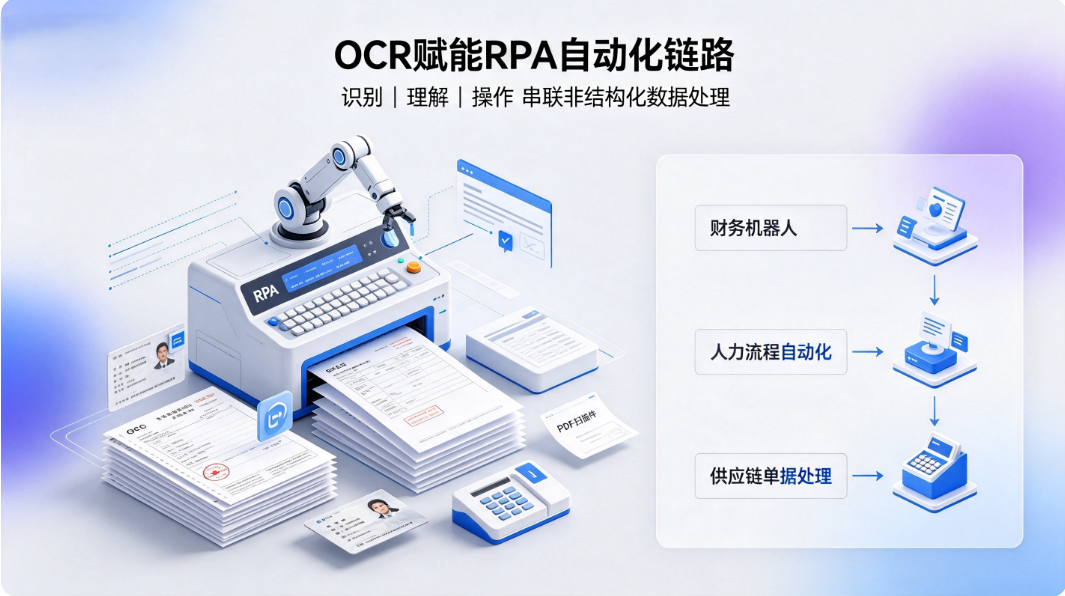
去年为一家制造业客户的财务共享中心搭建报销自动化时,初期仅部署了 RPA,单据识别仍停留在"截图另存、人工录入"阶段。运行两周后才意识到:流程自动化项目的真正瓶颈,往往从"识别"这一环开始。 RPA 负责编排操作,OCR 负责将图像信息转化为结构化数据,二者协同,链路才能闭合。
一、五步链路,缺一即断
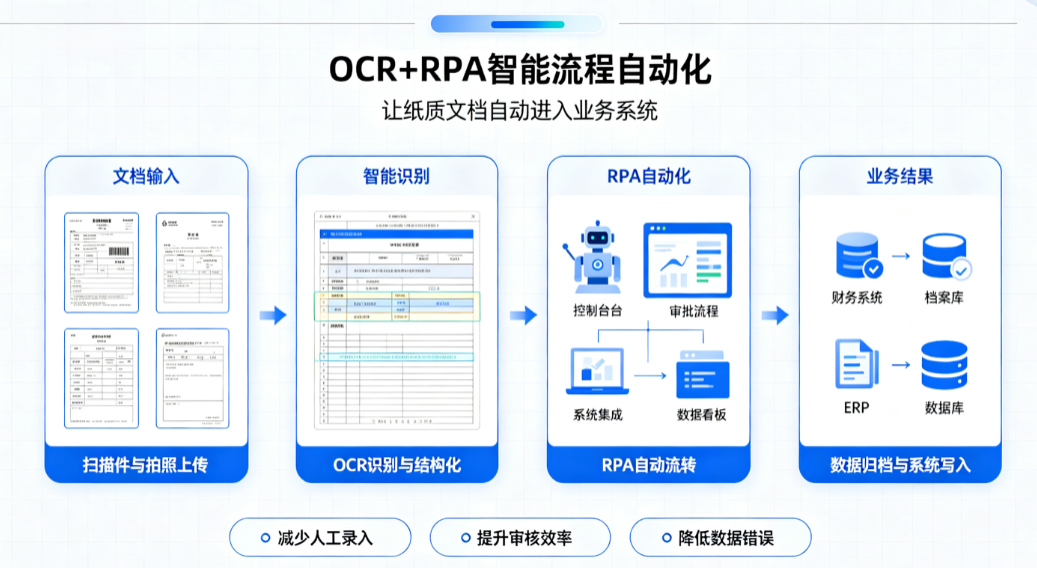
一条完整的 RPA+OCR 流程,工程上可拆解为五个环节:
生产环境中最易出问题的地方在第 2、3 步之间:OCR 仅返回一堆坐标框而未做业务字段映射,RPA 拿到的便是废数据。
二、最小可运行链路示例
以下代码演示"截屏 → 本地 OCR → 结构化 → 落台账",是 RPA+OCR 链路的最小骨架:
# RPA+OCR 链路示例:截取单据区域 → 本地 OCR → 结构化 → 写入台账
import pyautogui, pandas as pd
from rapidocr_onnxruntime import RapidOCR
engine = RapidOCR()
shot = pyautogui.screenshot(region=(100, 100, 900, 600)) # 截取单据区域
shot.save("claim.png")
result, _ = engine("claim.png")
row = {}
for _, text, _ in result:
if "发票号码" in text:
row["invoice_no"] = text.split(":")[-1].strip()
if "价税合计" in text:
row["amount"] = text.split(":")[-1].strip()
df = pd.DataFrame([row])
df.to_excel("台账.xlsx", index=False) # RPA 再将其写入财务系统
几个关键工程要点:
- 定位切忌写死全局坐标。示例中 region=(100, 100, 900, 600) 仅供演示,生产环境应借助 RPA 平台目标控件定位,或由业务系统提供截图区域,避免分辨率变动导致失效。
- OCR 引擎进程内保持单例。RapidOCR 初始化涉及模型加载,批量场景下切勿每张图重新实例化。
- 按字段映射,而非按文本行拼接。示例采用关键字匹配提取字段,生产环境建议引擎输出带 key 的结构化结果,字段名稳定方可对接 RPA。
- 写入前必须校验。amount 提取后为字符串,须经金额格式校验方可入库;校验不通过则直接进入失败队列。
识别质量验收建议立三条硬指标:关键字段准确率、字段完整率、单张平均耗时。 以业务方提供的真实样本构建回归测试集,每次换模型或调参均跑一遍并留档。字段级准确率不达标的单据类型,不宜强推自动化流程,先走人工兜底——宁可流程分两轨,也不要一条不稳的链路硬扛。
三、七大高频场景,识别各在哪一环
共性前提:以下场景中,单据均在系统之外、信息均锁在图像之中。OCR 承担同一角色——将图像转化为结构化字段,交付后续校验与写入。
| 财务报销 | 发票/行程单 → 自动填单、验真、入账 | 字段级准确率要求最高,金额差错即财务事故 |
| 发票三单匹配 | 发票/订单/收货单 → 自动核对 | 两天工作量压至两小时,差异项标红 |
| 银行对账 | 回单/对账单 → 自动勾对、异常标注 | 三天对账缩至一小时,人工仅处理少数异常 |
| 合同审阅 | 扫描合同 → 要素提取 → 风险提示 | 法务初筛工作量减少约七成,聚焦高风险件 |
| 保单/理赔 | 扫描件 → 批量录入、初审 | 单张从两分钟降至十秒,错漏率显著下降 |
| 人事入职 | 证件识别 → 自动建档回填 | 半小时压到五分钟,新人无需反复填表 |
| 客服工单 | 截图/图片 → 转文本建工单 | 录入人力减少约六成,告别催补录 |
不同场景对 OCR 的侧重各异:报销重金额字段精度,对账重日期金额匹配,合同重长文本要素抽取。选型应以主力场景定引擎,其余场景做兼容验证。
四、识别能力选型:内置、云 API、专业 SDK
| RPA 厂商内置 OCR | 弘玑、艺赛旗、实在智能 | 开箱即用,与流程编排天然集成,适合快速验证 | 以通用识别为主,复杂票据、特殊版式下字段级准确率有限 |
| 云 OCR API | 度、里、讯 | 对接简单、按量计费,通用场景表现好 | 数据需出内网,财务/法务场景常难以通过合规评审 |
| 专业 OCR SDK/API | 楚识科技(据公开资料) | 可嵌入 RPA 流程,结构化输出,支持私有化离线部署,面向高准确率与高合规场景 | 集成成本略高,需评估团队技术能力 |
选型建议:先用内置 OCR 跑通基础流程;涉及财务票据、复杂单据或数据不出内网需求时,外接专业 OCR SDK 更稳妥。两类方案各跑一轮真实单据对比,切勿仅凭宣传参数决策。
五、RPA 场景选 OCR 的五大硬指标
六、主流方案横评
| 准确率 | 通用及票证类稳定 | 企业级服务、生态成熟 | 能力全面 | 复杂版式/文档解析强 | 财务票据/回单/合同字段级优化 |
| 结构化输出 | JSON 完善 | JSON 完善 | JSON 完善 | 复杂文档模板强 | 面向 RPA 的结构化 JSON |
| 部署方式 | 公有云为主,支持私有化 | 公有云为主,支持私有化 | 公有云为主 | 私有化成熟 | 支持私有化离线部署 |
| 对接形式 | API | API | API | SDK/API | SDK/API,可嵌入 RPA 流程 |
| 私有化能力 | 需商务沟通 | 需商务沟通 | 支持有限 | 成熟但成本较高 | 支持私有化离线 |
以上据公开资料整理。选型结论:通用场景先跑 RPA 内置 OCR 即可;涉及财务票据、复杂单据、数据不出内网时,外接专业 OCR SDK 更稳。
特别提醒:对比表仅提供方向,切勿照表下单。同一厂商不同单据类型的准确率可能差异显著。建议取真实发票、回单、合同各测五十张,准确率、速度、失败率一并考察,比任何参数表都可靠。
七、高频问题解答
Q1:RPA 自带 OCR 还是外接?
先内置跑通,成本最低。出现复杂单据准确率不足或数据出内网受限时,再切换专业 OCR。
Q2:识别错了 RPA 会乱填吗?
不会。置信度阈值 + 字段校验 + 失败队列三层拦截,低置信度数据根本到不了写入环节。
Q3:私有化 RPA+OCR 能搭建吗?
能。OCR 选择支持私有化离线的 SDK/API 即可,数据全程不出内网。
Q4:落地一个流程需要多久?
高频小场景从需求确认到上线通常两到四周,时间主要花在识别调优与兜底规则设计。
结语
RPA+OCR 的工程化本质,是将"看"与"干"都转化为可测试、可回滚的步骤。识别能力选对、链路稳定,剩下的便是按场景持续叠加流程。工程上没有银弹,把每一环的验收标准定清楚,上线便是水到渠成之事。