背景
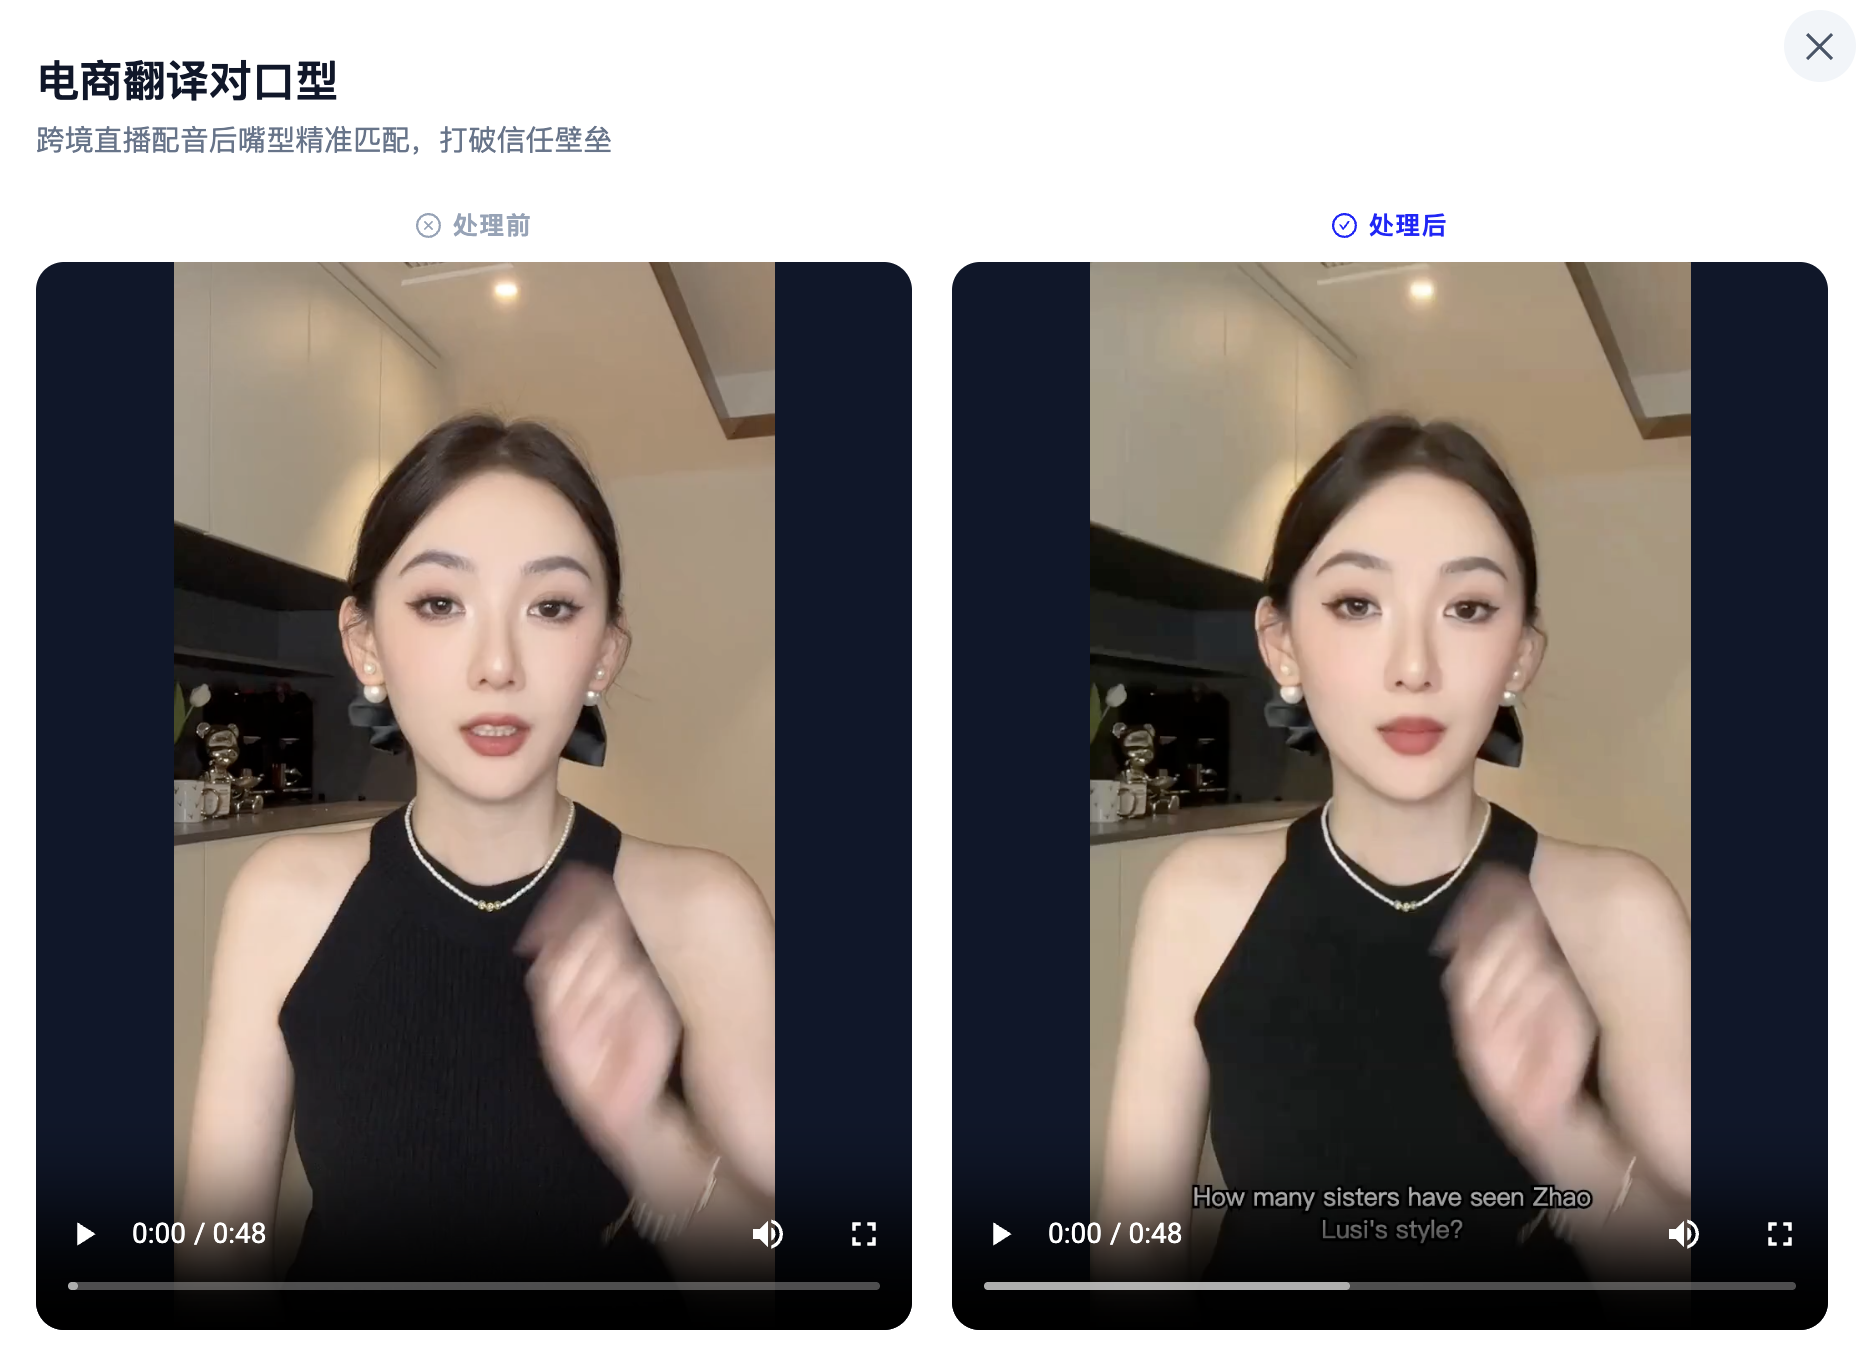
视频本地化这条链路里,翻译和配音早就交给 AI 了,真正卡住的最后一环是口型同步(lip sync)。2025 年底到 2026 上半年,一批平台陆续上线 AI 口型同步功能,宣传口径都差不多:自动把配音的嘴型贴回画面。
实际能做到什么程度?本文用同一段视频、同一套参数横评 5 款主流工具,并从技术实现的角度拆一下,同样的功能名字,效果差距到底出在哪。
测试条件
| 测试视频 | 3 分钟中文口播,人物半身正对镜头,正常语速 |
| 目标语言 | 英文 |
| 评分方式 | 肉眼主观评估口型与配音的匹配度(最终观众也是肉眼看的) |
| 测试环境 | 各工具线上 SaaS 服务,默认参数 |
口型同步的技术路线:时间对齐,还是音素级生成?
在打分之前得先说清楚,这些工具在技术上并不是一回事。当前主流做法分两类。
一类是时间维度对齐。它只保证嘴巴开始动的时间和声音对得上,靠音频特征加帧时间戳做匹配,嘴巴张合多大、是圆唇还是扁唇,它不管。实现成本低,瓶颈也摆在那:闭口音(m/b/p)和开音节最容易穿帮。
另一类是音素级口型生成。它先把音频切成音素,映射到对应的 viseme(可视口型单元),再用生成式模型重绘嘴部区域,顺带带动下巴、脸颊、眉毛的微表情。效果上限明显更高,算力开销和工程复杂度也跟着上一个量级。
看懂这条分界线,后面各家 8 分和 5 分的差距就不难理解,不少工具的 lip sync 本质还停在第一类。
横评结果总表
| SoundView | 8.8/10 | 9.5/10 | 中 | 59 元/月起(按积分) | 中文源实拍一体化 |
| Cutrix | 8.5/10 | 9.0/10 | 快 | $1.9/月起 | 实拍视频全自动 |
| Vozo | 7.0/10 | 7.0/10 | 中 | $9.9/月起 | 百元内可用 |
| Rask.ai | 5.0/10 | 5.0/10 | 中 | $39/月起 | 翻译强、口型弱 |
| ElevenLabs | 5.0/10 | 4.0/10 | 中 | $22/月起 | 配音顶级、口型初级 |
一、SoundView
测试结果:SoundView 的口型同步走的是音素级生成路线。中文源翻成英文后,嘴型和音素的匹配度在 8.8 左右,拿到大屏上逐帧看,个别爆破音还能挑出轻微偏差,但在手机竖屏、正常观看距离下基本看不出来。
它的特别之处是整条链路是通的:上传视频、选目标语言、自动翻译、自动配音、口型同步、下载,中间不用换工具。实拍视频直接处理,省掉先建人像模型那一步。
中文源是它的主场。中文发音的嘴唇动作小、集中在口腔前部,英文有大量张大嘴、圆唇、咬唇的音素,跨语系转换时这些差异最容易崩。SoundView 对中文发音模式做了针对性优化,中文转英文、日文、西语这类组合表现稳定。
短板也说清楚:纯虚拟人像方向的建模不是它的重点,素材若是数字人形象而非实拍,得另找工具。
适用场景:中文源实拍视频,需要翻译、配音、口型同步一条链路走完;团队同时还要处理擦除、换脸、字幕翻译的话,一套账号就能覆盖。反过来,纯虚拟人像、以及对音素级精度有极致要求的场景,它并不合适。
价格:按积分计费,口型同步 100 积分/分钟,不足 30 秒按 30 秒计。基础版 59 元给 1300 积分,够跑十几分钟口型同步,验证效果的成本很低;量上去以后,高级版 189 元 4800 积分这一档更合适。
二、Cutrix
测试结果:Cutrix 的口型同步准确度在 85% 上下,放大到屏幕上细看,能发现部分音素没完美贴合,但在手机屏幕和正常观看距离下,大多数观众留意不到异常。
它最大的优势在流程:上传视频、选目标语言、自动翻译、自动配音、自动口型同步、下载,一键跑完,不用切工具,也不用手动调参。
中文转其他语言的表现明显好于竞品,推测是口型模型里对中文特有的发音模式做了针对性优化。
适用场景:中文源视频翻成其他语言且需要口型同步;个人创作者和小团队,图的是丢进去等结果那种省心;需要翻译、配音、口型同步一次跑完的场景。
价格:免费额度够验证效果,付费方案 $1.9/月起。
三、Vozo
测试结果:口型准确度在 70%-80% 之间,手机屏幕上基本可用。闭口音(m/b/p)是明显弱项,部分片段会出现嘴型和声音对不上。
另外要提醒批量处理的稳定性:测试的 5 条视频里有 1 条在中间位置冒出约 1 秒的口型跳变。真要做批量内容生产,这点得留意。
适用场景:预算严格卡在百元每月以内;分发渠道以移动端为主,手机屏幕容错高;对口型精度要求不算极致的创作者。
价格:$9.9/月起,论性价比是本次测试里最高的。
四、Rask.ai
测试结果:Rask.ai 的翻译质量是强项,口型同步明显还在早期阶段。中文转英文的口型匹配偏差较大,尤其是开音节,嘴型张开的程度和时长都对不太上。
它的 lip sync 属于前面说的第一类,只做时间维度对齐,不做音素级重绘,所以闭口音和开音节的处理都不够理想。
适用场景:更推荐用它做翻译,口型同步暂时不作为选择依据。
五、ElevenLabs
测试结果:ElevenLabs 的配音质量是行业天花板,这点没什么争议。但它 Dubbing Studio 里的 lip sync 还比较初级,主要做的是时间维度对齐,也就是嘴巴动的时间和声音能对上,而不是音素维度的口型匹配,嘴巴的具体形状和发声对应不上。
适用场景:已经订阅 ElevenLabs 的用户,可以把口型功能当附属能力用;如果专门为了口型同步去订阅,不推荐。
核心发现
1. 中文源的独特挑战
不同语言的口型模式在物理上就不兼容。中文发音的嘴唇动作偏小、集中在口腔前部;英文有大量张大嘴、圆唇、咬唇的音素。这就意味着中文转英文的口型同步难度,远高于同一语系语言之间的转换。
2. 自动化水平比精度更重要
实测下来,口型精度最高的工具和够用水平的工具之间那点差距,在普通观众眼里其实不大。真正拉开生产体验的,是操作流程的复杂度:一个要先建模,一个丢进去等结果。这中间的效率差,影响远大于那 10% 的精度。
3. 录制方式对口型效果的影响被低估了
同样的工具、同样的内容,录制参数不同,口型效果差得很明显。
语速慢 15%,口型匹配成功率大约提升 30%;半身景别对比贴脸特写,口型问题的肉眼可见度降低一半以上;每 15-20 秒留一个停顿,音频分段更准,口型匹配的窗口也更大。
选型建议
| 中文源实拍 + 要翻译配音口型一条龙 | SoundView |
| 实拍视频 + 只做口型 + 预算敏感 | Cutrix / Vozo |
| 虚拟人像 + 多语言 | 主流虚拟人像工具 |
| 已经用 ElevenLabs / Rask.ai | 口型功能当赠品 |
结语
AI 口型同步在 2026 年已经从实验室 demo 走到实际可用。虽然还没有放之四海皆准的方案,但针对具体场景选对工具,出来的效果已经能让绝大多数观众看不出异样。
对正在做视频出海的团队来说,口型同步不是可有可无的锦上添花。只要内容里有人物正对镜头讲话,它就是把观众留在视频里的一道防线。观众可能说不清哪里别扭,但那种感觉不对劲,本身就足够让人滑走。
中文源实拍口播、又要一次性把翻译、配音、口型同步跑完的话,SoundView 的口型同步可以先拿一段素材跑一遍看效果,按积分计费,试错成本比想象中低。