系统确认了一个检测器从未验证过的来源
先看一个用于说明架构问题的工程场景。它不是某家公司的真实事故复盘。
视频片段 M 进入系统时,携带了一个声明:它由采集源 S 拍摄。这里的“采集源 S”指声称实际采集该视频的来源,而不是把文件或流发送给平台的某个网络节点。
平台选择了码流版本(rendition)R0 和时间区间 [t0,t1),然后运行深度伪造检测器(Deepfake Detector,以下简称“检测器”)。
检测器执行成功,返回结果符合预期的输出契约;当前分析配置中可检查的适用条件也被认为满足。它报告“未检测到受支持类型的合成篡改信号”,但平台随后向用户显示“声明的采集源 S 已确认”。
架构错误就发生在这两个结论之间。图1把这种语义越界(semantic overreach)放在同一条链上:检测器回答的是“是否检测到受支持类型的篡改信号”,平台却确认了“采集来源”这一属性。
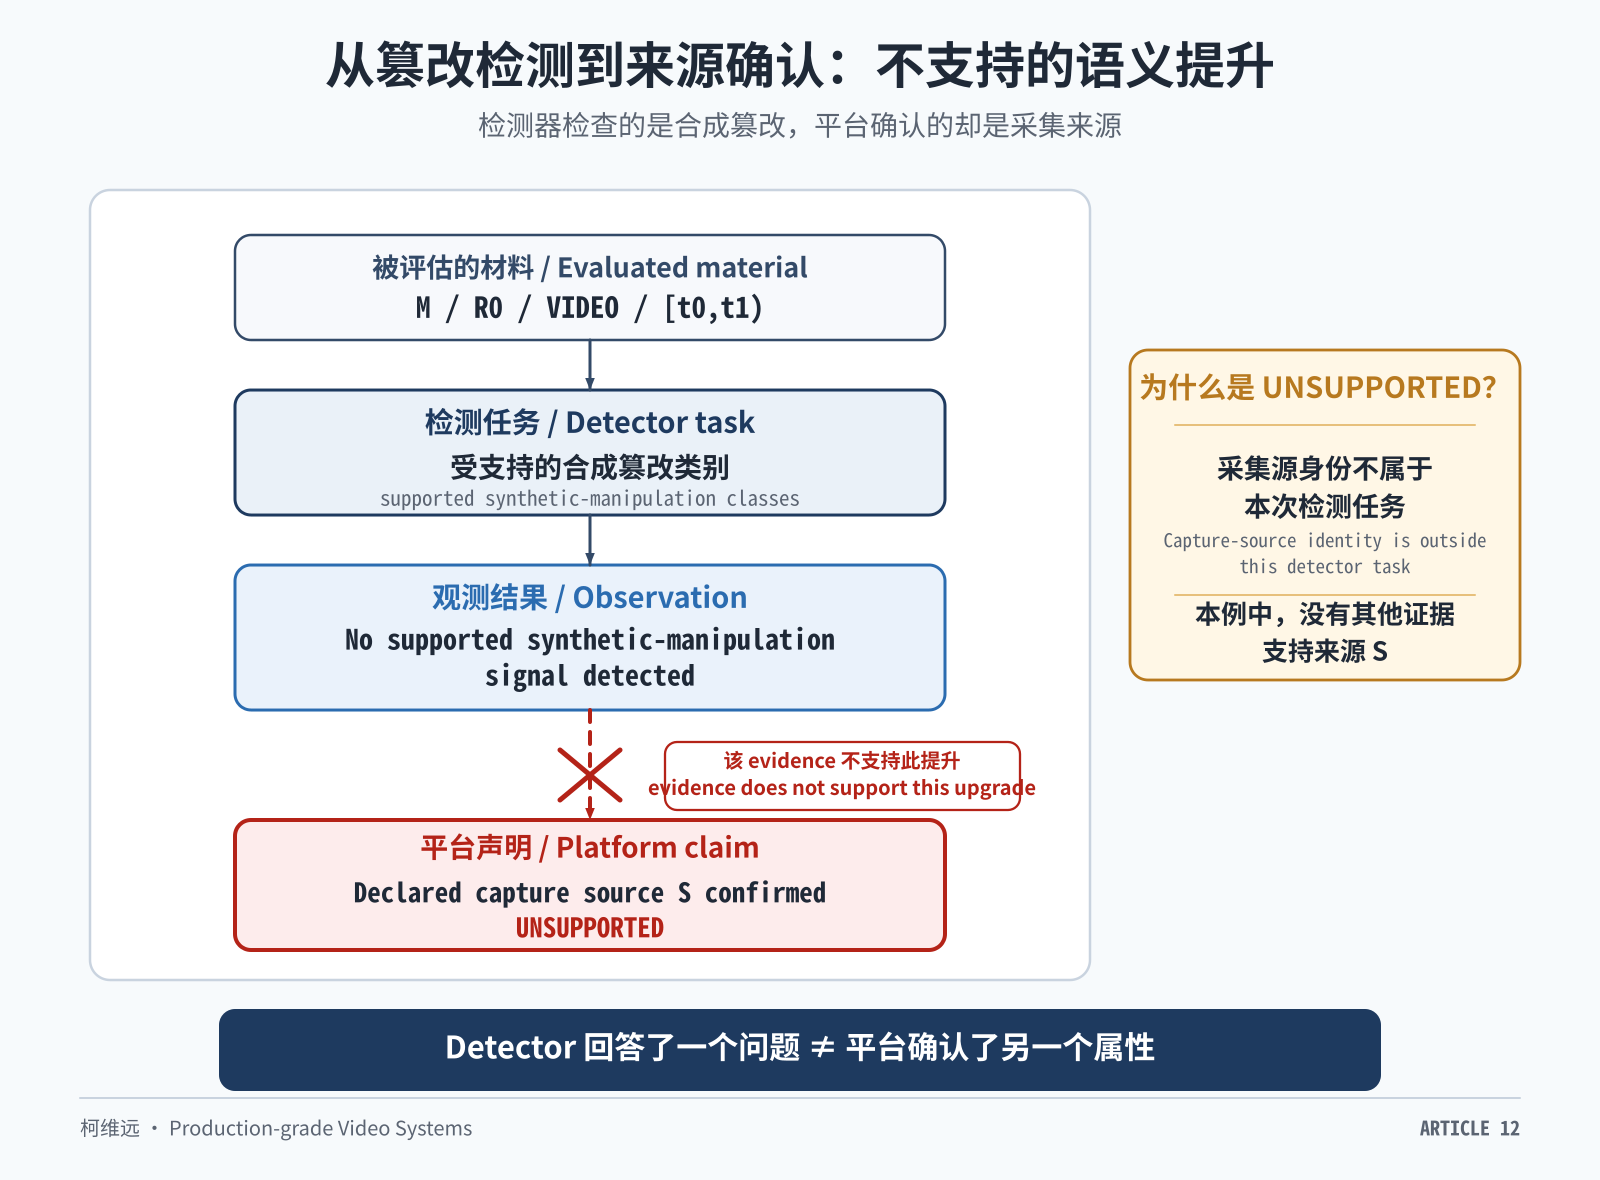
No supported synthetic-manipulation signal detected
≠
Declared capture source S confirmed
本文标题中的“唯一信任边界”,并不是说检测器在 DFD 图上天然就是一条几何意义上的信任边界(trust boundary)。这里讨论的是另一种更实际的风险:检测器输出被当成唯一依据,把一个原本为 UNKNOWN 或不可信的平台声明,直接提升为 CONFIRMED / TRUSTED。
检测器检查的是某些已声明类别的合成篡改信号,而且只检查了特定视频输入。平台却确认了视频的采集来源。在这个场景里,采集源身份根本不属于检测器的任务;系统也没有其他证据(evidence)支持来源 S。
要证明这个架构缺陷,并不需要先证明模型漏检了 deepfake,也不需要找到 false positive、adversarial bypass 或错误 threshold。检测器对自身任务的判断可能正确,也可能错误;无论哪一种情况,“来源 S 已确认”都不能从现有证据中推出。
一个问题上的正确答案,不会自动变成另一个问题的答案。
这就是 Article 12 的核心边界:
Detector Result ≠ Authenticity Proof
Detector Observation ≠ Platform Trust Verdict
本文中的真实性(authenticity)不是一个模糊的“视频是真的”。我们只讨论一个明确声明(claim):
C = “M 由声明的采集源 S 采集”
如果现有证据并不支持这个声明,平台就不能把它标记为已确认。
Article 11 已经给出过一个更一般的原则:某一层的证据,不能自动封闭更宽的端到端正确性声明。Article 12 不重复证明这个原则,而是把它具体化到 ML 证据:检测器实际回答了什么问题、处理了什么材料,以及它的结果最多能支持多强的声明。
深度伪造检测器不是通用的“真 / 假测试器”
语义越界的第一个来源,是把 detection task 理解得过宽。
在 NIST OpenMFC 中,Video Manipulation Detection 和 Video GAN Manipulation Detection 被定义为针对具体 probe video 的特定篡改检测任务。Camera Verification 则被单独定义:它回答的是 probe 是否与所声明的 camera fingerprint 相匹配。Provenance-oriented tasks 也被分别描述。12
这不是术语游戏。它说明 media-forensics component 的结果,只能按照产生它的 task contract 来解释:
Input unit
Target property
Supported manipulation classes
Output semantics
Evaluation conditions
如果检测器执行的是 manipulation-detection task,那么一个 negative result 最多可以支持这样的窄声明:
在被分析的 input 中,没有检测到该检测器所支持类别的篡改信号。
它不会自动产生下面这些结论:
采集源 S 已验证
录制时间已验证
传输历史已验证
provenance 已验证
audio 已验证
关于画面事件的上下文声明为真
同样的限制也适用于 dataset 中的 real、pristine、genuine、non-Deepfaked 等标签。FaceForensics++、Celeb-DF 和 DFDC 中的这些 labels,是依据各自 dataset construction protocol 定义的正类和负类。345
这并不意味着 dataset 一定没有控制 acquisition,更不意味着所有 dataset 都不知道材料的来源。真正安全的结论要窄得多:
Dataset label 描述的是 dataset protocol 所定义的类别。REAL 本身不是对任意 production capture source S 的来源证明。
当 platform API 或 UI 把这种 label 直接显示成绿色的 Authentic badge 时,系统可能已经悄悄换了问题:模型按 benchmark taxonomy 对 sample 进行了分类,用户却把结果理解成“真实来源已被确认”。
0 到 1 之间的数字,不等于真实性概率
语义越界的第二个来源,是对 score 的错误解释。
OpenMFC 使用 [0,1] 范围内的 confidence score。但在这个 contract 中,较大的值指向 manipulated label;区间内的内部尺度可以是任意的;同一系统的所有 test trials 之间需要保持一致,但不同系统之间并不要求可直接比较。1
因此,下面这个值:
detector_score = 0.03
并不能被平台转换为:
97% probability authentic
不同检测器的 score 语义可能完全不同:它可能是某个 task label 的 probability,也可能是 anomaly score、logit、similarity 或 distance。[0,1] 看起来很像概率,但数值范围本身并不定义 calibration semantics。
正确解释一个 score,至少要知道:
它实际测量什么
数值增大的方向对应哪个 class
使用了哪个 threshold / profile
是否做过 calibration
该语义适用于哪个 model / version / data regime
即使某个检测器确实输出了经过 calibration 的概率,核心问题仍然存在。它估计的可能只是某个受支持 face-manipulation task 的 label probability,而不是:
P(M 由声明的采集源 S 采集)
对 task label 的校准概率,不是对采集源声明的概率评估。
所以生产系统不能只保存一个数字,还必须保存这个数字的语义。否则下游服务、UI 或运营人员很容易给它附加一个原本不存在的更强含义。
证据只属于实际处理的材料范围(Material Scope)
第三类错误,是扩大材料范围。
不同评测协议中,检测器可能处理完全不同的单位:
probe video
frame
face crop
short clip
mouth crop
frame / clip predictions 的 video-level aggregation
FaceForensics++ 描述的是在 face region 上进行 frame-level classification。LipForensics 使用 frames 或 clips,再把 predictions 聚合到 video level。36 因此,“检测器检查了这个视频”这句话,可能掩盖了非常不同的处理流程。
对生产架构来说,media_id = M 和 result = NOT_DETECTED 远远不够。系统还必须知道码流版本、模态、时间区间、实际覆盖范围、裁剪/缩放路径、采样规则与预处理配置。
图2把“实际进入检测证据的材料范围”与“仍未被评估的部分”放在同一个范围树中。视频帧的结果不是音轨的证据;R0 的结果也不能自动扩展到其他码流版本。因采样、吞吐限制或解码错误被跳过的帧,不能被默认为未检出结果。
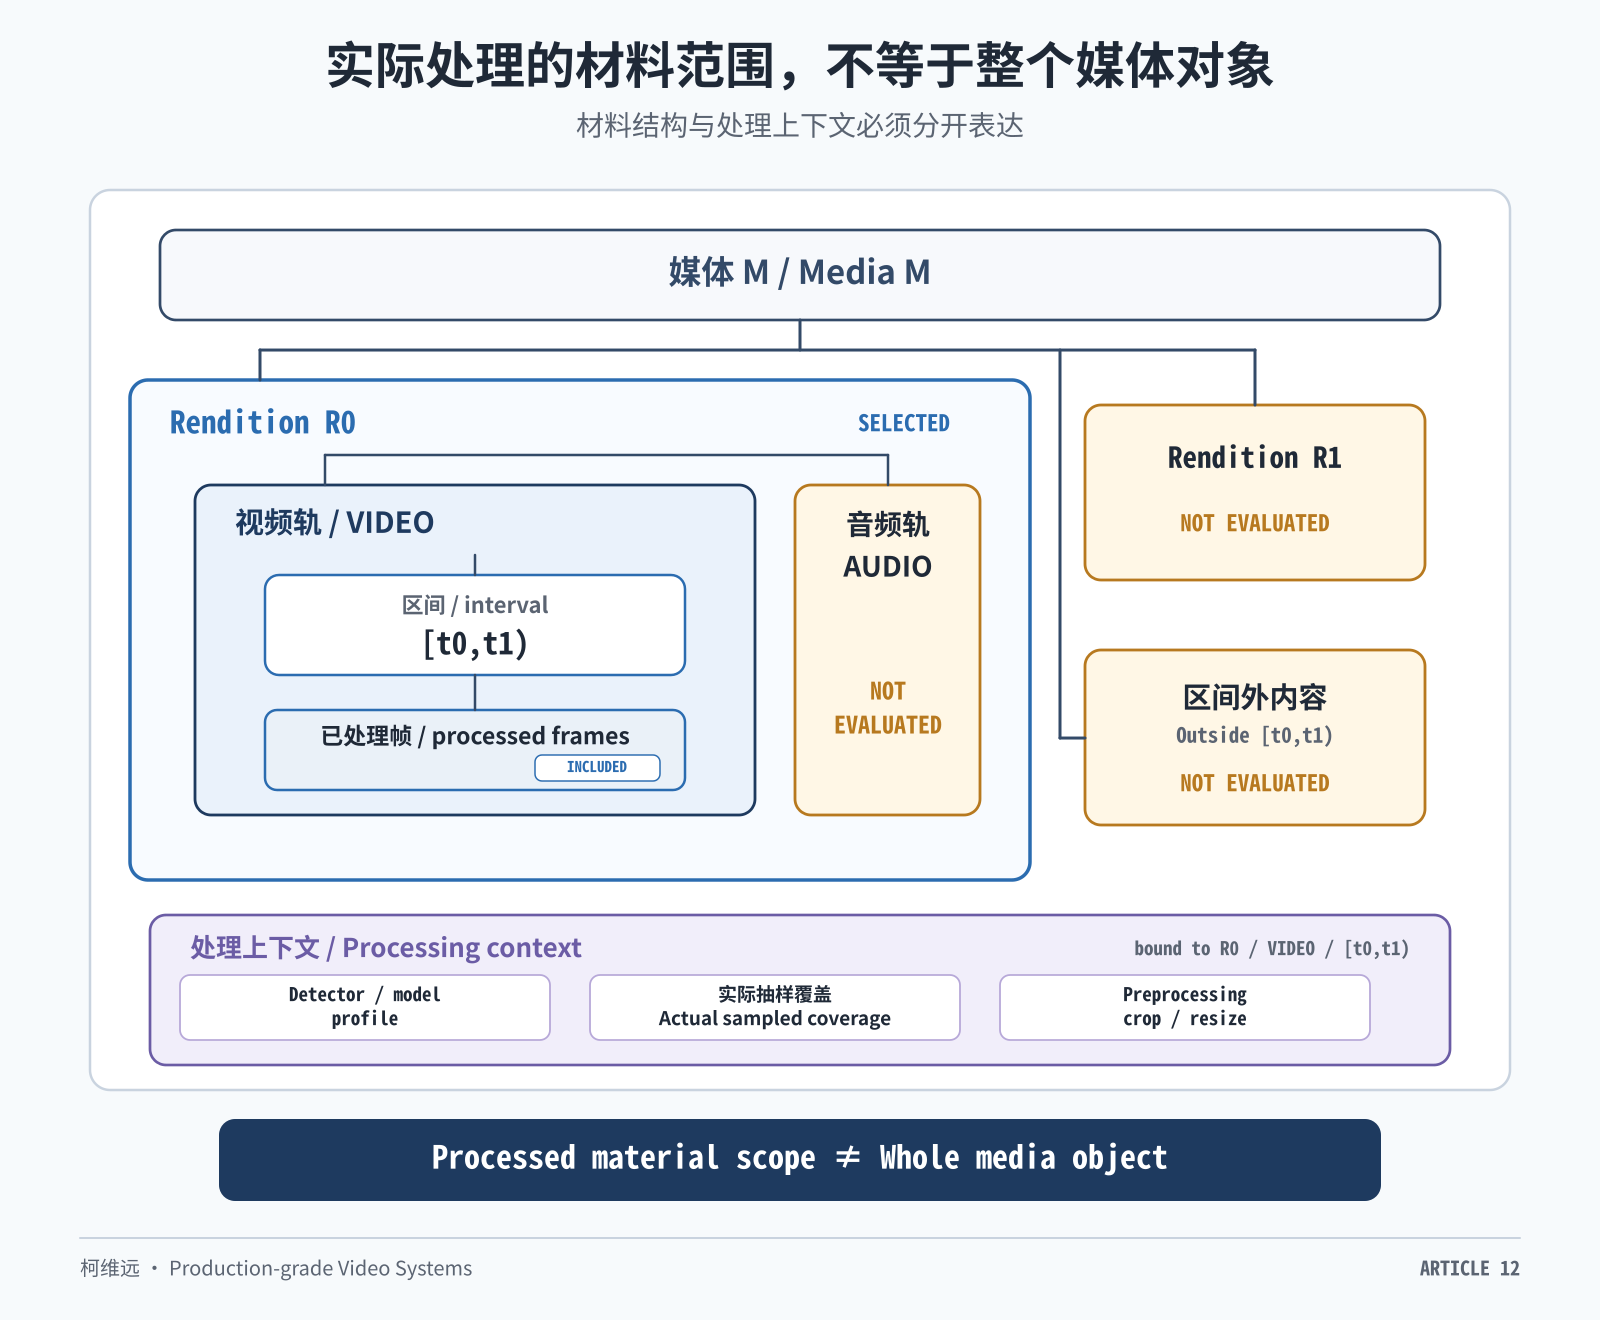
Processed material scope
≠
Whole media object
这在直播 / OTT 处理链中尤其重要。检测器得到的可能不是源母版(source mezzanine),而是经过缩放、降码率、帧率转换或再次编码的一条转码码流。此时观测结果属于检测器实际看到的媒体对象,而不是一个它从未处理过的抽象“原始视频”。
适用性(Applicability)与证据充分性(Evidence Sufficiency)回答的是两个不同问题
这里必须拆开两个经常被混在一起的问题。
适用性:这个结果可以用于当前输入吗?
适用性回答:
在声明的分析配置下,这个检测结果是否可以被解释和使用?
可检查的前提可能包括:
supported codec / container
expected modality
resolution or crop assumptions
required frame coverage
known preprocessing path
model / profile version
supported manipulation / domain scope
APPLICABLE 不意味着系统能够识别所有未知 distribution shift,也不意味着检测器对现实世界“全知”。它只是说明:针对某组明确、可检查的前提,当前结果被认为可以使用。
证据充分性:这些证据足够支持目标声明吗?
证据充分性回答另一个问题:
对一个具体目标声明来说,当前可用且适用的证据是否充分?
检测器证据可以适用于已经处理过的帧,但同时完全不足以确认这些帧的采集来源。
Applicable evidence
≠
Sufficient evidence for claim C
在本文核心场景中,检测器观测结果对 M/R0/[t0,t1) 的篡改检测任务是适用的;但声明 C 询问的是采集源 S。因为检测器没有评估采集源身份,而且系统没有其他支持 S 的证据,所以:
Evidence sufficiency for C: INSUFFICIENT
Platform assessment of C: UNKNOWN
不是 FALSE,也不是 FAKE,而是 UNKNOWN。
这个结论并不禁止平台在未来确认来源 S。只要平台获得了其他相关证据,并对它们进行充分性评估,就可以形成更宽的评估。被禁止的不是“更宽的声明”本身,而是从一个窄检测结果无依据地推出更宽声明。
检测器观测结果(Detector Observation)应该形成带作用域的检测证据(Scoped Detection Evidence),而不是直接变成平台判定
ML component 的结果不能以一个没有上下文的 REAL、FAKE 或 0.97 继续向下游传播。
在本文提出的逻辑模型中,原始观测结果(raw observation)与平台声明评估之间存在一个对象:
带作用域的检测证据
图3给出从检测器输出到平台动作的完整逻辑解释链,并显式保留目标声明、评估条件、其他相关证据、策略版本与决策上下文。它同时标出两条不能被压缩的边界:Applicability ≠ Evidence Sufficiency,以及 Platform Claim Assessment ≠ Policy Decision / Action。
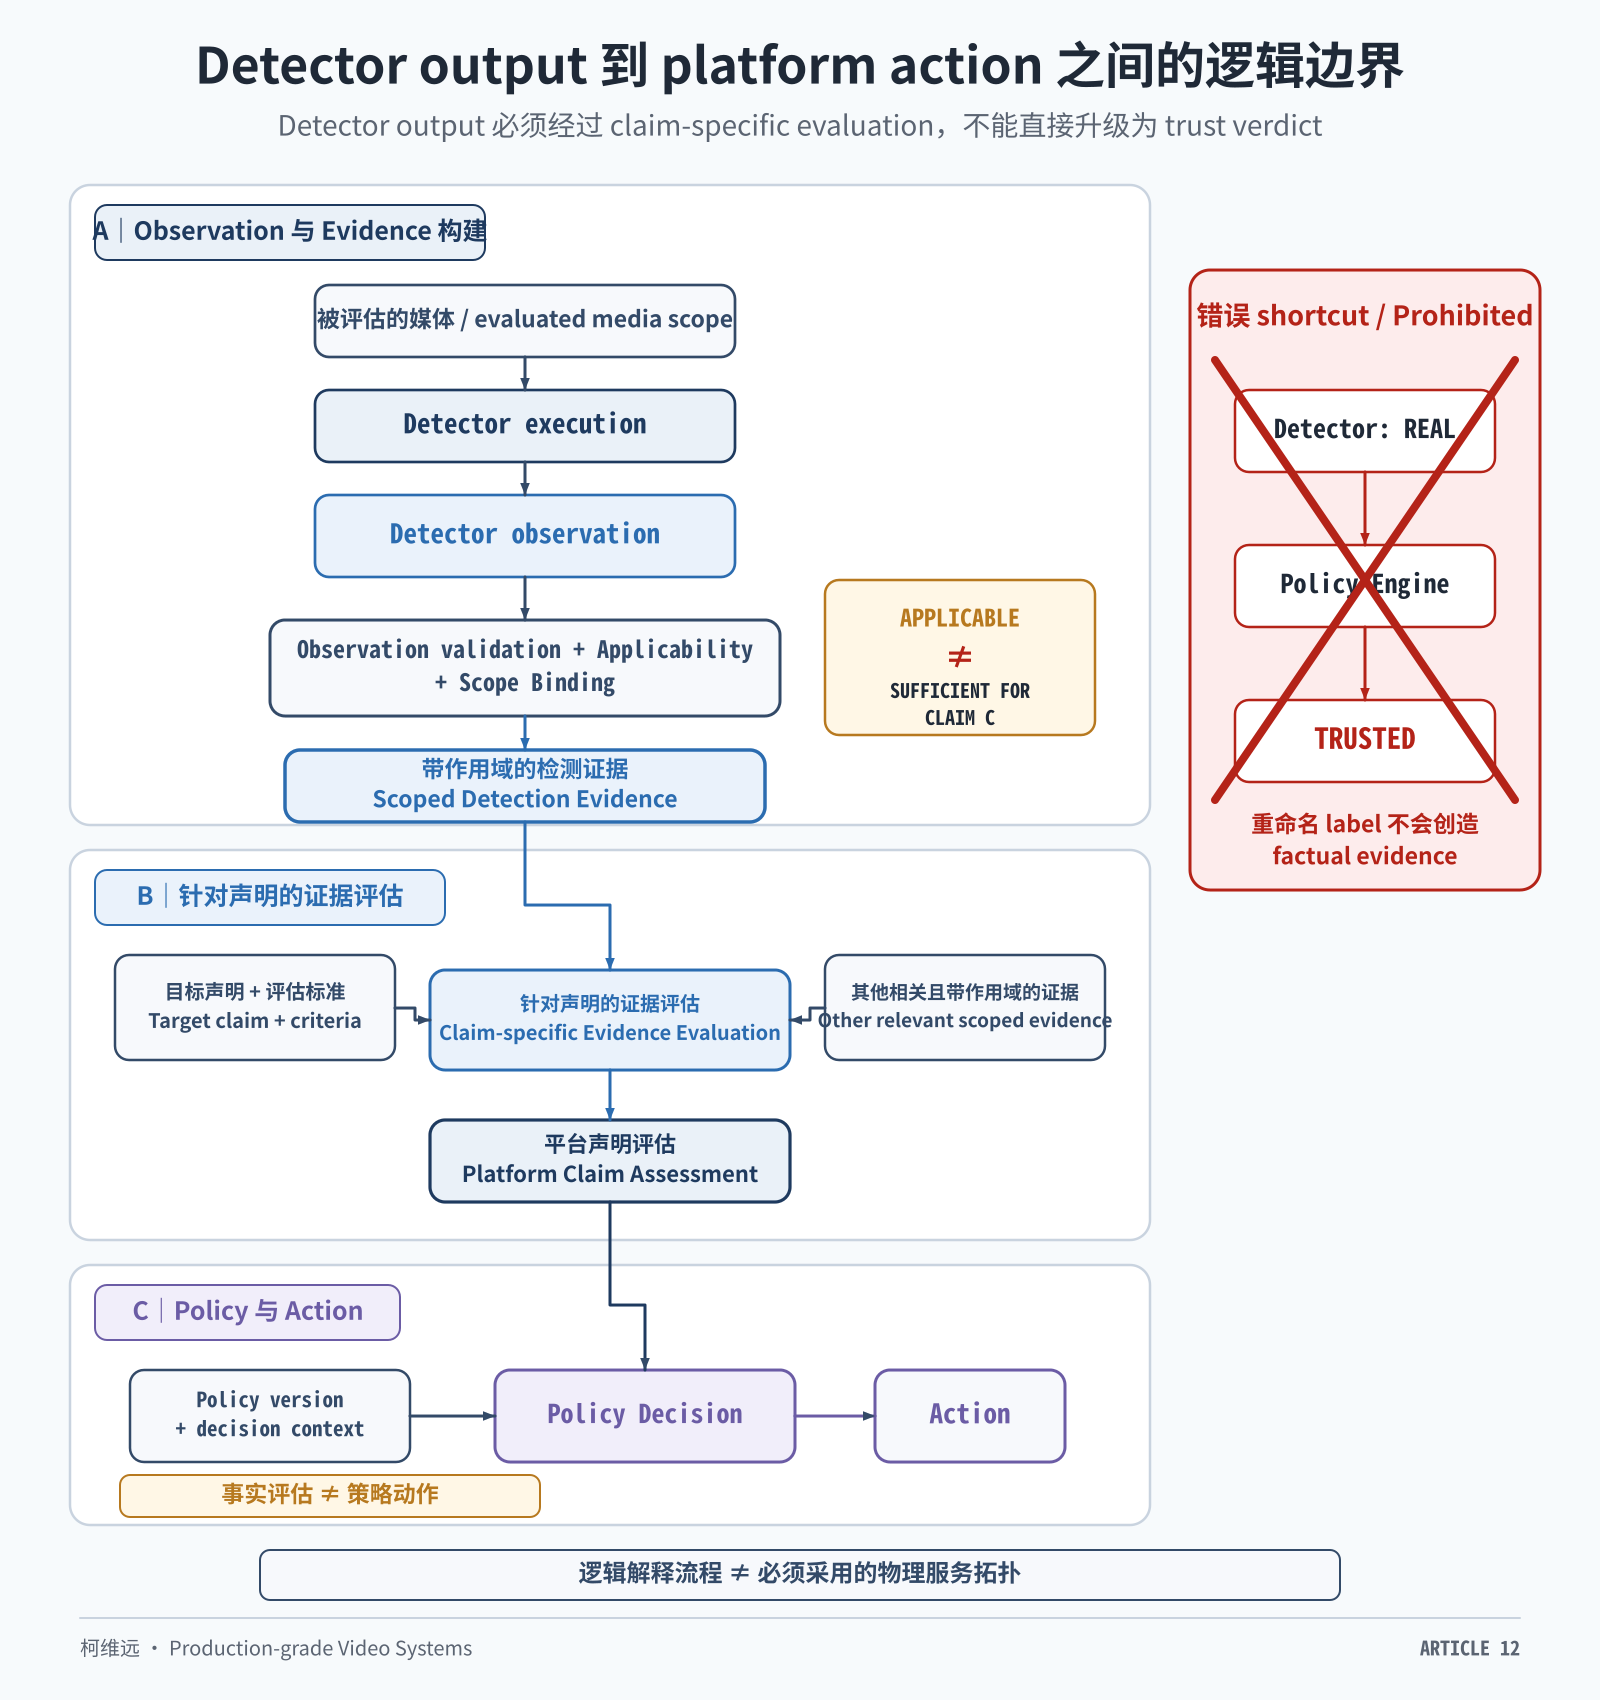
这是一条逻辑依赖与解释链,不一定是同步 data path,也不要求每个方框都对应独立 service 或 deployment unit。它是本文提出的架构模型,并不是 NIST、Microsoft 或某篇论文规定的固定 pipeline。模型的目的只有一个:不允许某一步悄悄替代下一步。
一个最小的逻辑上下文可以写成:
ScopedDetectionEvidence {
detector_ref
model_or_profile_ref
observation
observation_semantics_ref
media_ref
modality
rendition
interval
actual_coverage
preprocessing_context
applicability_assessment
applicability_basis
supported_claim_scope
evaluated_at
}
这不是通用 wire schema。具体实现可以使用其他字段。但这些引用必须能够恢复具体的 model / profile / preprocessing 版本,并准确定位真正被分析的材料。像 current-model 这样的可变 alias 不足以支撑后续审计。
系统至少应该能够回答五个问题:
前述实验给出了保留模型与处理上下文的经验理由:测得的表现会随模型、输入构造、训练/测试数据域和压缩条件变化。36 但具体字段仍然是 Article 12 的工程设计,而不是研究论文规定的标准。
为什么多加一个“策略(Policy)”方框仍然不能解决问题?
图3右侧同时保留一个被禁止的 shortcut:Detector: REAL → Policy Engine → TRUSTED。如果 Policy Engine 只是把一个 label 改名成另一个 label,语义越界仍然存在。
策略不会创造新的事实证据。它可以根据评估、业务要求和风险选择动作,但不能把“没有确认”改写成“已经确认”。
基准测试(Benchmark)结果不是永久有效的生产保证
经验结果并不能支持“深度伪造检测器都没有用”这样的普遍结论。它们能支持一个更窄、也更重要的工程事实:检测器观测结果不能脱离模型、评估子集和运行上下文单独解释。
在 LipForensics 的 cross-dataset evaluation 中,models 在 FaceForensics++ 上训练,然后在 Celeb-DF-v2、DFDC、FaceShifter 和 DeeperForensics 上评估。Xception 的 video-level AUC 分别为 73.7 / 70.9 / 72.0 / 84.5,LipForensics 则为 82.4 / 73.5 / 97.1 / 97.6。6
其中 DFDC 数值并不代表整个 DFDC corpus。Appendix A.2 描述的是一个经过筛选的 3,215 个 test videos 子集:只使用单人视频,并排除了 face detector 或 landmark detector 失败的 samples。6 因而该 AUC 描述的是这个 evaluated subset 及其 preprocessing path,而不是抽象的“DFDC 整体表现”。
这些数字不能被当作通用排行榜。它们属于特定 training/test regime、选定 test sets、input processing 和 metric。但它们说明了一个关键事实:一个 benchmark number 不会在不同 domain 之间自动保持不变。
同一研究中的 leave-one-manipulation-out experiment 也显示,结果同时依赖 held-out manipulation family 和具体检测器。6 这不意味着每一种新 generator 都一定能绕过每一个模型。安全的结论是:
受支持的 manipulation / domain profile,本身就是检测器证据语义的一部分。
Processing context 的影响也出现在 compression experiments 中。FaceForensics++ Table 1 中,使用 face crop 的 Xception 在论文定义的 Raw / HQ(H.264 QP 23)/ LQ(H.264 QP 40)条件下,frame-level binary accuracy 分别为 99.26% / 95.73% / 81.00%。3
这是一组 benchmark protocol 内的比较,不是同一个冻结的 production checkpoint 在任意 transcode 前后的测试。其他检测器呈现出不同 pattern。LipForensics 在自己的 named experiments 中表现出更高的鲁棒性,但这也不是建立跨论文模型排行榜的依据。6
来源只支持下面这个有限结论:
processing regime can affect measured detector behavior
and the magnitude is model- and experiment-specific
因此,不能写成:
compression always defeats detection
同样危险的是默认下面的推理成立:
validated on benchmark input
→ equally valid after arbitrary production transforms
生产系统必须知道:当前结果是相对于哪个分析配置被判定为适用的。
每一种不确定性都必须有明确的归属对象
Binary REAL / FAKE 对 demo 很方便,但对 production trust architecture 不够。
OpenMFC 已经展示了一个更窄的分离:处理状态与检测器分数是两个不同对象。Processed 只表示 trial 被处理并产生了输出,并不表示分类结论在事实层面一定正确。1
Article 12 把这个原则扩展到多个逻辑对象:
| UNAVAILABLE | 执行分析的能力 | 检测器无法执行所请求的分析 | 内容是伪造或恶意的 |
| INCONCLUSIVE | 检测器结论 | 分析已执行,但契约不允许给出确定结论 | FAKE |
| NOT_EVALUATED | 适用性评估 | 适用性还没有被评估 | APPLICABLE |
| INSUFFICIENT | 声明 C 的证据充分性 | 当前证据集合不足以确认 C | 这些证据对所有声明都没有价值 |
| UNKNOWN | 对 C 的平台声明评估 | 当前证据集合没有建立 C | C = FALSE |
完整状态集合是作者架构综合,并不是所有检测器都遵循的标准 enum。特别是,只有检测器原生契约或显式设计的适配器定义了其语义时,才能使用 INCONCLUSIVE。
不能把不同原因的不确定性压缩成一个二元 label:
UNAVAILABLE ≠ FAKE
INCONCLUSIVE ≠ FAKE
NOT_EVALUATED ≠ APPLICABLE
INSUFFICIENT ≠ FALSE
UNKNOWN ≠ FALSE
在核心工程场景中,执行状态是 SUCCEEDED,观测结果 schema 是 VALID,适用性是 APPLICABLE;但对采集源声明来说,证据充分性是 INSUFFICIENT,因此来源评估只能是 UNKNOWN。
检测器分类结论在事实层面的正确性仍然是 NOT ESTABLISHED。要识别当前架构错误,并不需要先解决这个问题。
事实评估(Factual Assessment)与策略动作(Policy Action)是两个不同的契约
生产系统需要分开两个逻辑契约。
平台声明评估(Platform Claim Assessment)
它回答:
现有证据对声明 C 和当前评估范围,究竟允许平台建立什么结论?
逻辑上至少需要:
verdict_claim
assessment_scope
evidence_refs
assessment_basis_ref
策略决策与动作(Policy Decision / Action)
它回答:
在评估、业务要求和允许风险的基础上,系统接下来做什么?
逻辑上至少需要:
decision_scope
assessment_ref
policy_version
Scoped factual assessment ≠ Policy action
如果策略允许,平台可以发布一个来源仍为 UNKNOWN 的材料。但这个动作不会把来源评估变成 CONFIRMED。
反过来,平台也可以临时停止或升级处理一个 UNKNOWN 材料;这个动作同样不能证明它是 FAKE。
Article 12 在这里停止。验证证据暂时缺失或不足时,频道是否继续、何时进入降级模式、采用 fail-open 还是 fail-closed,属于 Channel Availability ≠ Verification Availability 的问题,也就是 Article 14 的主题。
信任边界(Trust Boundary)到底在哪里?
在经典 security terminology 中,trust boundary 通常表示不同 trust / privilege level 之间的转换;跨越边界的数据需要被验证。7
Article 12 只借用这个术语原则。深度伪造检测器不是 DFD 上天然的一堵“边界墙”。如图1所示,真正危险的是未受支持的信任提升,而不是检测器本身:系统把有边界的观测结果提升成了更强的平台可信声明。
如果这个转换仅仅因为组件返回了 REAL、NOT_DETECTED 或较低的 manipulation score,检测器实际上就成了整个信任提升的唯一权威。
问题不在于检测器没有价值。相反,它可以生成非常有价值的证据。问题在于,它的权限必须被限制在它真正评估过的问题内:
Detector authority
≤
Supported claim scope of its evidence
平台只有在获得其他相关证据,并显式完成充分性评估后,才可能形成更宽的评估。
检测证据(Detection Evidence)、来源证据(Provenance Evidence)与语义真实性(Semantic Truth)是三个不同问题
NIST AI 100-4 把 synthetic-content detection 与 provenance tracking 视为可区分、但在技术实现上可能存在交集的类别。该文档也明确提醒:即使材料被判断为 authentic 或 non-synthetic,也不意味着它自动 trustworthy;未被篡改的内容仍可能脱离上下文,或者被用于误导性声明。8
对 Article 12 来说,只需要保留三条边界:
No supported manipulation detected
≠
Capture source verified
A negative result from a content-based manipulation detector
does not by itself confirm
Capture provenance
Unmanipulated media
≠
Semantic truth of the contextual claim
本文不讨论 manifests、signatures、certificate chains、trusted signers 或 provenance validation。那是下一篇 Article 13 的主题。
这里只需要避免强迫深度伪造检测器同时回答三个问题:
即使第一个问题得到了理想答案,也不能自动替代第二和第三个问题。
回到工程场景:最终的证据边界
把这个工程场景压缩成最终状态:
Evaluated material:
M / R0 / VIDEO / [t0,t1)
Detector task:
Detect declared classes of synthetic manipulation
Detector observation:
No supported synthetic-manipulation signal detected
Other evidence for capture source S:
None
Legacy platform output:
Declared capture source S confirmed
| 检测器执行 | SUCCEEDED |
| 观测结果 / schema validity | VALID |
| 适用性 | APPLICABLE within declared profile |
| 检测器 conclusion 的 factual correctness | NOT ESTABLISHED |
| 采集源声明的证据充分性 | INSUFFICIENT |
| 对来源声明的平台评估 | UNKNOWN |
| 对旧平台确认的审计结论 | UNSUPPORTED |
这里的 UNSUPPORTED 不是本文要求系统新增的 runtime enum。它是对一个已经被输出的平台声明的审计判断:可用证据不支持这个声明的含义。
即使之后证明检测器在自身任务上完全正确,片段也确实没有包含受支持类别的篡改,架构缺陷仍然存在。检测器回答的是一个问题,系统却把这个回答当成了另一个属性的证明。
识别语义越界,不需要先证明检测器出错;只需要证明平台声明比它所依据的证据更宽。
Article 12 的主规则是:
即使检测器结果具有适用性,也不能支持超出其证据范围的平台声明。
深度伪造检测器执行有限的检测任务,并产生观测结果。生产系统必须保留结果语义,把它绑定到实际处理过的材料范围,检查适用性,并形成带作用域的检测证据。之后,针对声明的证据评估才能把这些证据与目标声明、评估标准以及其他相关证据放在一起评估。策略可以选择动作,但不能创造事实证据。
在本文场景中,篡改检测的阴性结果不能确认采集源 S。下一步的问题是:什么证据才能支持视频来源声明?有效 signature、可信 signer 和 provenance chain 分别能证明什么?这属于 Article 13。
参考资料
NIST Media Forensics Challenge Team. Open Media Forensics Challenge 2020–2021 Evaluation Plan. Revision 2021-05-14. Official PDF. 本文用于 VMD/VGMD task definition、score semantics 以及 processing status 与 score 的分离。 ↩︎ ↩︎ ↩︎
H. Guan, A. Delgado, Y. Lee, A. N. Yates, D. Zhou, T. N. Kheyrkhah, J. G. Fiscus. User Guide for NIST Media Forensic Challenge (MFC) Datasets. NISTIR 8377, 2021. DOI: 10.6028/NIST.IR.8377. 本文用于区分 VMDL、Camera Verification 和 provenance-oriented tasks。 ↩︎
A. Rössler, D. Cozzolino, L. Verdoliva, C. Riess, J. Thies, M. Nießner. FaceForensics++: Learning to Detect Manipulated Facial Images. ICCV 2019. DOI: 10.1109/ICCV.2019.00009. 本文用于 dataset/task scope、frame/face-region processing 和 compression example。 ↩︎ ↩︎ ↩︎ ↩︎
Y. Li, X. Yang, P. Sun, H. Qi, S. Lyu. Celeb-DF: A Large-Scale Challenging Dataset for DeepFake Forensics. CVPR 2020. Official CVF page. 本文仅用于约束 dataset class 的语义。 ↩︎
B. Dolhansky, J. Bitton, B. Pflaum, J. Lu, R. Howes, M. Wang, C. Canton Ferrer. The DeepFake Detection Challenge (DFDC) Dataset. 2020. arXiv:2006.07397. 本文仅用于约束 dataset construction / class semantics。 ↩︎
A. Haliassos, K. Vougioukas, S. Petridis, M. Pantic. Lips Don’t Lie: A Generalisable and Robust Approach To Face Forgery Detection. CVPR 2021. Official CVF page. 本文用于 frame/clip aggregation、cross-dataset、held-out manipulation 和 compression findings;DFDC subset scope 对应 §4.2、Table 2 与 Appendix A.2。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Microsoft Learn. Windows Security Model for Driver Developers, “Windows security boundaries”. Official documentation. 本文仅将其作为 terminology anchor;从 detector evidence 到 platform claim 的 semantic upgrade 模型属于作者架构。 ↩︎
B. Chandra, J. Dunietz, K. Roberts, Y. Lee, P. Fontana, G. Awad. Reducing Risks Posed by Synthetic Content: An Overview of Technical Approaches to Digital Content Transparency. NIST AI 100-4, 2024. DOI: 10.6028/NIST.AI.100-4. 本文仅用于区分 synthetic-content detection、provenance tracking 与 trustworthiness。 ↩︎