目录
一、为什么 LangGraph 会出现?
(一)AI Agent 场景充满了动态决策
(二)后端类比看Chain和StateGraph
二、LangGraph 到底解决了什么?
(一)Chain 与 Graph 的本质区别
(二)决策划分
三、LangGraph 的核心原理
(一)关键组成一览
(二)执行流程简单理解
(三)Node 的统一模型
(四)核心设计思想
四、LangGraph 的核心关键源码
(一)StateGraph
1. State:全局共享状态
2. StateGraph源码
(二)add_node()
(三)add_edge()
(四)compile():编译图
(五)invoke():执行图
五、30 行关键代码:你的第一个 LangGraph
(一)完整代码展示
(二)关键实战代码
(三)运行效果
六、常见坑与排查
(一)坑 1:忘记 add_edge(START, …),图根本不执行
错误示例
正确写法
核心理解
(二)坑 2:直接修改 state,而不是返回增量更新
正确写法
核心理解
(三)坑 3:每个请求都 compile()
正确写法
核心理解
(四)坑 4:State 字段缺失导致 KeyError
解决方案
核心理解
七、工程化实践建议
(一)使用 TypedDict 管理 State
不推荐
推荐
好处
(二)节点避免副作用
(三)compile() 全局复用
(四)节点内部做好异常处理
(五)使用 stream() 做可观测
八、总结 & 下一篇预告
干货分享,感谢您的阅读!
本文是「LangGraph 实战」系列的第 1 篇。
我们从最小的 `StateGraph` 出发,把「State + Node + Edge + compile + invoke」这套地基彻底夯实。读完你能独立写出一个可运行、可调试、可观测的图。
假设你在做一个内容审核服务。产品经理提了个看似简单的需求:
> 用户提交内容后,先让 LLM 打分;分数够高就直接发布,不够就退回让用户改,改完再打分——如此循环,直到通过为止。
你打开熟悉的 LangChain,写了个 Chain,然后卡住了:Chain 是一条“单向流水线”,数据从头流到尾,中间没法「回头」,也没法「根据结果分叉」。你只能在外面套一层 `while` 循环手动管理状态,代码越写越像意大利面。
这正是 LangGraph 要解决的问题。它把 AI 工作流从「链」升级成「图」——节点可以分支、可以循环、可以共享一份全局状态。本文我们先把最简单的「直线图」跑通,建立肌肉记忆。
一、为什么 LangGraph 会出现?
(一)AI Agent 场景充满了动态决策
如果你用过 LangChain,一定遇到过这样的困境:
> 我想让 Agent 根据 LLM 的回复决定下一步做什么,但 Chain 只能线性执行。
LangChain 的 Chain 模式天生是“单向管道”——数据从头流到尾,你无法在中间插入分支、循环或暂停。而真实的 AI Agent 场景充满了动态决策:
- 回复质量不够?重新生成
- 需要调用工具?跳转到工具节点
- 需要人工审核?暂停等待确认
LangGraph 的 `StateGraph` 就是为了填补这个空白——它用“图”替代“链”,让 AI 工作流的编排变得真正灵活。
(二)后端类比看Chain和StateGraph
如果你写过 Spring,`Chain` 像是一串固定顺序的 `Filter`——请求依次穿过,顺序在编译期就定死了。而 `StateGraph` 更像一个**带状态机的工作流引擎**(如 Activiti / Camunda):节点之间的跳转可以在运行时根据数据决定,整个流程还共享一份「流程变量」(就是这里的 State)。
二、LangGraph 到底解决了什么?
(一)Chain 与 Graph 的本质区别
| 线性执行 | ✅ | ✅ |
| 条件分支 | ❌ | ✅ |
| 循环执行 | ❌ | ✅ |
| 全局状态共享 | ❌ | ✅ |
| 中断恢复 | ❌ | ✅ |
| 实时流式观测 | 弱 | 强 |
| Agent 编排 | 有限 | 原生支持 |
(二)决策划分
一句话总结:Chain 适合「确定的、一次性的」管道;StateGraph 适合「动态的、有状态的、可能循环的」工作流。
当你的流程里出现「如果……就……否则……」「重试直到……」这类逻辑时,就该上 StateGraph 了。
三、LangGraph 的核心原理
StateGraph 是 LangGraph 中最核心的图编排模型,本质上是一套“基于状态驱动”的工作流执行机制。
(一)关键组成一览
它由 7 个关键组成部分构成:
| State | 全局共享状态对象,通常使用 TypedDict 定义 | 流程上下文 / 流程变量 |
| StateGraph | 用于定义整个执行图结构 | 工作流 DSL / 流程画布 |
| Node | 一个具体执行单元,本质是 Python 函数 | Service 方法 / Handler |
| Edge | 节点之间的执行路径 | 流程连接线 |
| START / END | 图的起点与终点 | 工作流开始/结束节点 |
| compile() | 将图结构编译成可运行对象 | 编译生成可执行流程 |
| invoke() / stream() | 执行图并驱动状态流转 | 启动流程实例 |
(二)执行流程简单理解
一个最简单的执行链路如下:
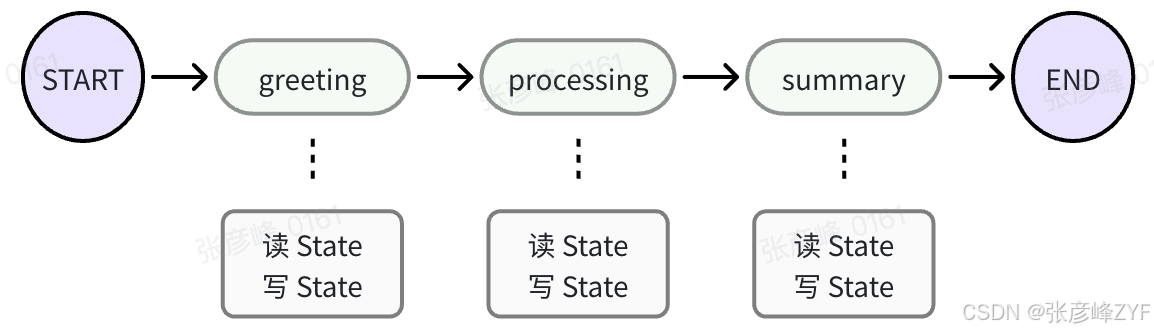
在整个执行过程中:
- 每个 Node 都会读取当前 State
- Node 执行完成后返回新的字段更新
- LangGraph 自动将结果合并回全局 State
- 更新后的 State 会继续传递给下一个节点
因此,整个 Graph 的本质是:
State 驱动 Node
Node 更新 State
State 推动下一步执行
(三)Node 的统一模型
所有节点都遵循统一函数签名:
def node_fn(state: State) -> dict:
其含义如下:
| state | 当前完整的全局状态 |
| dict 返回值 | 当前节点需要更新的字段 |
例如:
def greeting(state: State) -> dict:
return {
"message": "Hello LangGraph"
}
LangGraph 会自动执行:
旧 State
+
Node 返回字段
=
新 State
开发者无需手动维护状态合并逻辑。
(四)核心设计思想
StateGraph 的本质可以理解为:以 State 为中心的数据流执行引擎
它与传统函数调用最大的区别在于:
| 参数层层传递 | 全局共享 State |
| 调用链固定 | Graph 动态流转 |
| 函数返回值直接结束 | 返回值进入 State 持续传播 |
| 更像同步代码 | 更像状态机 + 工作流 |
因此它非常适合:
- Agent 工作流
- 多步骤推理
- Tool Calling
- RAG Pipeline
- 多 Agent 协作
- 长链路 AI 编排系统
因为所有节点都围绕同一个 State 协同工作。
四、LangGraph 的核心关键源码
(一)StateGraph
1. State:全局共享状态
State 是整个图共享的数据容器。
通常使用:
TypedDict
定义。
例如:
class HelloState(TypedDict):
message: str
steps: list[str]
step_count: int
它很像:
- 工作流变量
- 上下文 Context
- 请求作用域数据
2. StateGraph源码
`StateGraph` 在初始化时会解析 `TypedDict` 的每个字段,把它映射成内部的 **Channel**(数据管道抽象):
# langgraph/graph/state.py(简化)
class StateGraph(Graph):
def __init__(self, state_schema, config_schema=None):
super().__init__()
self.state_schema = state_schema
# 解析 TypedDict 字段,提取 Reducer(聚合器)
self.channels = _get_channels(state_schema)
- 普通字段 → `LastValue` Channel(每次赋值直接覆盖)
- 带 Reducer 的字段 → `BinaryOperatorAggregate`(用自定义函数聚合,后续文章详讲)
(二)add_node()
`add_node()` 做的事很关键——它把你的普通 Python 函数包装成 `RunnableLambda`:
def add_node(self, node_name, action):
if node_name in self.nodes:
raise ValueError(f"Node '{node_name}' already exists")
self.nodes[node_name] = (
action if isinstance(action, Runnable)
else RunnableLambda(action, name=node_name) # ← 这行:普通函数 → Runnable
)
包装成 `Runnable` 之后,你的函数就自动获得了 `invoke / stream / batch / callbacks` 等能力——这就是为什么节点能被流式执行、能挂回调。
(三)add_edge()
LangGraph 源码(简化版):
class Graph:
def add_edge(self, start_key: str, end_key: str) -> None:
if start_key == END:
raise ValueError("END cannot be a start node")
if end_key == START:
raise ValueError("START cannot be an end node")
self.edges.add((start_key, end_key))
第一眼会觉得:就这?确实。表面上它只是:
self.edges.add((start, end))
即把边存起来,但真正关键的是:compile() 如何解释这些 edge。
注意LangGraph 执行时根本不是“函数调用”。而是:
当前节点执行完成
→ Runtime 查询 Edge
→ 找下一批节点
→ 动态调度
即:
- Node 不决定下一步
- Edge 决定下一步
这是工作流系统最核心的思想。
(四)compile():编译图
`compile()` 会先做图验证(可达性、终止性检查),再构建 Pregel 执行引擎,返回 `CompiledStateGraph`。这是很多人第一次接触时最容易忽略的设计。
LangGraph 不是直接执行函数,而是:
先定义图
→ 再编译
→ 再执行
即:
app = graph.compile()
它会:
- 校验图合法性
- 检查是否能到达 END
- 构建执行计划
- 构建 Pregel Runtime
- 初始化 Channel 系统
这其实已经非常接近:一个真正的工作流引擎。
(五)invoke():执行图
`invoke()` 的核心是一个循环:
# CompiledStateGraph.invoke()(简化)
def invoke(self, input, config=None):
state = self._init_state(input) # 1. 初始化 State
current = self._get_next_nodes(START) # 2. 从 START 找到第一批节点
while current: # 3. 循环执行
for node_name in current:
output = self.nodes[node_name].invoke(state) # 执行节点
for k, v in output.items():
self.channels[k].update(v) # 通过 Channel 合并更新
state = self._read_state()
current = self._get_next_nodes(current) # 找下一批节点
return state # 4. 返回最终 State
主要核心逻辑在源码中已如上标注,注意第 3 步里的 `self.channels[k].update(v)`——节点返回的 dict 不是「直接 assign」,而是交给对应 Channel 决定怎么合并。这我们在下一篇 Reducer 中来分析,这里留个伏笔。
五、30 行关键代码:你的第一个 LangGraph
(一)完整代码展示
"""Demo 01: Hello Graph — 最小 StateGraph 示例。
演示 LangGraph 的七大核心要素:
1. State(状态定义)
2. StateGraph(图容器)
3. Node(节点函数)
4. Edge(边连接)
5. START / END(起止节点)
6. compile()(编译)
7. invoke()(调用)
运行方式:
python stages/stage1_fundamentals/01_hello_graph/main.py
"""
from __future__ import annotations
import sys
from pathlib import Path
from typing import TypedDict
from langgraph.graph import END, START, StateGraph
sys.path.insert(0, str(Path(__file__).resolve().parent.parent.parent.parent))
from shared import get_logger, log_step, log_success
logger = get_logger("demo.01_hello_graph")
# ============================================================
# 第一步:定义 State(状态)
# State 是整个图共享的数据容器,所有 Node 读写同一份 State
# ============================================================
class HelloState(TypedDict):
"""图的状态定义。
TypedDict 提供类型安全,IDE 能自动补全字段名。
"""
message: str
steps: list[str]
step_count: int
# ============================================================
# 第二步:定义 Node 函数
# 每个 Node 接收完整 State,返回需要更新的字段
# ============================================================
def greeting_node(state: HelloState) -> dict:
"""问候节点 — 图的第一个执行节点。"""
log_step(logger, "greeting_node", "正在执行问候节点…")
return {
"message": f"你好!欢迎来到 LangGraph 的世界!原始输入: {state['message']}",
"steps": state.get("steps", []) + ["greeting_node"],
"step_count": state.get("step_count", 0) + 1,
}
def processing_node(state: HelloState) -> dict:
"""处理节点 — 对消息进行加工处理。"""
log_step(logger, "processing_node", f"正在处理消息: {state['message'][:30]}…")
processed = f"[已处理] {state['message']}"
return {
"message": processed,
"steps": state["steps"] + ["processing_node"],
"step_count": state["step_count"] + 1,
}
def summary_node(state: HelloState) -> dict:
"""总结节点 — 生成执行总结。"""
log_step(logger, "summary_node", "正在生成执行总结…")
summary = (
f"执行完成!共经过 {state['step_count']} 个节点: "
f"{' → '.join(state['steps'])} → summary_node"
)
return {
"message": summary,
"steps": state["steps"] + ["summary_node"],
"step_count": state["step_count"] + 1,
}
# ============================================================
# 第三步:构建图
# ============================================================
def build_hello_graph() -> StateGraph:
"""构建 Hello Graph。
Returns:
编译后的可执行图
"""
graph = StateGraph(HelloState)
graph.add_node("greeting", greeting_node)
graph.add_node("processing", processing_node)
graph.add_node("summary", summary_node)
graph.add_edge(START, "greeting")
graph.add_edge("greeting", "processing")
graph.add_edge("processing", "summary")
graph.add_edge("summary", END)
return graph
def run_demo() -> dict:
"""运行 Hello Graph Demo。
Returns:
图执行的最终状态
"""
print("=" * 60)
print(" Demo 01: Hello Graph — 最小 StateGraph 示例")
print("=" * 60)
print()
# 构建并编译图
log_step(logger, "构建图", "创建 StateGraph,添加 3 个节点和 4 条边…")
graph = build_hello_graph()
app = graph.compile()
log_success(logger, "图编译成功!")
# 准备初始状态
initial_state: HelloState = {
"message": "Hello, LangGraph!",
"steps": [],
"step_count": 0,
}
log_step(logger, "初始状态", f"message='{initial_state['message']}'")
# 执行图(invoke 模式:同步执行,返回最终状态)
print()
log_step(logger, "开始执行", "invoke 模式 — 同步执行完整图…")
print("-" * 40)
result = app.invoke(initial_state)
print("-" * 40)
# 输出结果
print()
log_success(logger, "执行完成!最终状态:")
print(f" message : {result['message']}")
print(f" steps : {' → '.join(result['steps'])}")
print(f" step_count: {result['step_count']}")
# 演示 stream 模式
print()
log_step(logger, "Stream 模式", "逐步观察每个节点的输出…")
print("-" * 40)
for step in app.stream(initial_state):
node_name = list(step.keys())[0]
node_output = step[node_name]
print(f" 节点 [{node_name}] 输出: message='{node_output['message'][:50]}…'")
print("-" * 40)
log_success(logger, "Stream 模式执行完成!")
print()
print("=" * 60)
print(" 关键概念回顾")
print("=" * 60)
print(" 1. State : 使用 TypedDict 定义,是所有节点共享的数据容器")
print(" 2. Node : 普通 Python 函数,接收 State,返回需要更新的字段")
print(" 3. Edge : 连接节点的路径,定义执行顺序")
print(" 4. START/END: 图的入口和出口")
print(" 5. compile(): 将图定义编译为可执行的 Runnable")
print(" 6. invoke() : 同步执行图,返回最终 State")
print(" 7. stream() : 流式执行图,逐步返回每个节点的输出")
print()
return result
if __name__ == "__main__":
run_demo()
备注:
一些关键的辅助代码暂不做关键分析,此专栏结束后我们直接提交源码供查看。
(二)关键实战代码
下面是本 Demo 的精简骨架(完整版见同目录 [main.py](main.py))。三个节点串成一条直线:问候 → 处理 → 总结。
from typing import TypedDict
from langgraph.graph import StateGraph, START, END
# 1. 定义 State:所有节点共享的数据容器
class HelloState(TypedDict):
message: str
steps: list[str]
step_count: int
# 2. 定义节点:接收 State,返回需要更新的字段
def greeting_node(state: HelloState) -> dict:
return {
"message": f"你好!原始输入: {state['message']}",
"steps": state.get("steps", []) + ["greeting_node"],
"step_count": state.get("step_count", 0) + 1,
}
def processing_node(state: HelloState) -> dict:
return {
"message": f"[已处理] {state['message']}",
"steps": state["steps"] + ["processing_node"],
"step_count": state["step_count"] + 1,
}
def summary_node(state: HelloState) -> dict:
summary = f"共经过 {state['step_count']} 个节点: {' → '.join(state['steps'])}"
return {"message": summary, "steps": state["steps"] + ["summary_node"]}
# 3. 构建图:加节点、连边
graph = StateGraph(HelloState)
graph.add_node("greeting", greeting_node)
graph.add_node("processing", processing_node)
graph.add_node("summary", summary_node)
graph.add_edge(START, "greeting") # 入口
graph.add_edge("greeting", "processing")
graph.add_edge("processing", "summary")
graph.add_edge("summary", END) # 出口
# 4. 编译 + 执行
app = graph.compile()
result = app.invoke({"message": "Hello, LangGraph!", "steps": [], "step_count": 0})
print(result["message"])
运行方式:
source .venv/bin/activate
python stages/stage1_fundamentals/01_hello_graph/main.py
(三)运行效果
实际执行 `main.py`,截取代表性输出:
============================================================ Demo 01: Hello Graph — 最小 StateGraph 示例 ============================================================
—————————————- —————————————-
message : 执行完成!共经过 2 个节点: greeting_node → processing_node → summary_node steps : greeting_node → processing_node → summary_node step_count: 3
—————————————- 节点 [greeting] 输出: message='你好!欢迎来到 LangGraph 的世界!原始输入: Hello, LangGraph!…' 节点 [processing] 输出: message='[已处理] 你好!欢迎来到 LangGraph 的世界!原始输入: Hello, LangGraph…' 节点 [summary] 输出: message='执行完成!共经过 2 个节点: greeting_node → processing_node → …' —————————————-
============================================================ 关键概念回顾 ============================================================ 1. State : 使用 TypedDict 定义,是所有节点共享的数据容器 2. Node : 普通 Python 函数,接收 State,返回需要更新的字段 3. Edge : 连接节点的路径,定义执行顺序 4. START/END: 图的入口和出口 5. compile(): 将图定义编译为可执行的 Runnable 6. invoke() : 同步执行图,返回最终 State 7. stream() : 流式执行图,逐步返回每个节点的输出
2026-06-03 14:37:47 INFO demo.01_hello_graph | 📌 [构建图] 创建 StateGraph,添加 3 个节点和 4 条边… INFO demo.01_hello_graph | ✅ 图编译成功! INFO demo.01_hello_graph | 📌 [初始状态] message='Hello, LangGraph!' INFO demo.01_hello_graph | 📌 [开始执行] invoke 模式 — 同步执行完整图… INFO demo.01_hello_graph | 📌 正在执行问候节点… INFO demo.01_hello_graph | 📌 正在处理消息: 你好!欢迎来到 LangGraph 的世界!原始输入: He… INFO demo.01_hello_graph | 📌 正在生成执行总结… INFO demo.01_hello_graph | ✅ 执行完成!最终状态: INFO demo.01_hello_graph | 📌 [Stream 模式] 逐步观察每个节点的输出… INFO demo.01_hello_graph | 📌 正在执行问候节点… INFO demo.01_hello_graph | 📌 正在处理消息: 你好!欢迎来到 LangGraph 的世界!原始输入: He… INFO demo.01_hello_graph | 📌 正在生成执行总结… INFO demo.01_hello_graph | ✅ Stream 模式执行完成!
Process finished with exit code 0
怎么解读这段输出?
六、常见坑与排查
LangGraph 的学习曲线其实并不陡,但由于它本质是一个「Graph Runtime」,而不仅仅是函数调用工具,因此我们很多时候会不自觉地沿用传统编程思维,导致踩坑(我就是,受常年Java编程思路)。
下面是最常见、也是生产里最容易出问题的几个点。
(一)坑 1:忘记 add_edge(START, …),图根本不执行
compile() 不报错,但:
app.invoke(…)
返回的还是初始 State,节点像完全没执行一样。
我们虽然:
-
添加了节点
-
添加了节点之间的边
但忘了:
graph.add_edge(START, "第一个节点")
也就是说:图没有入口。Runtime 根本不知道应该从哪个节点开始调度。
错误示例
graph.add_node("greeting", greeting_node)
graph.add_node("summary", summary_node)
graph.add_edge("greeting", "summary")
这里START ❌ 没有连接任何节点
正确写法
graph.add_edge(START, "greeting") # ✅ 图入口
graph.add_edge("summary", END) # ✅ 图出口
核心理解
LangGraph 本质是Graph Runtime,而不是函数调用链,所以:
-
START 是调度入口
-
END 是终止标记
缺一不可。
(二)坑 2:直接修改 state,而不是返回增量更新
状态行为异常:
-
有时更新成功
-
有时状态错乱
-
有时并发下数据污染
-
Debug 极其困难
很多人会这样写:
def bad_node(state):
state["steps"].append("bad")
return state
这是典型的:
副作用式修改(Side Effect)
问题在于:LangGraph 的 State 应被视为“只读快照”。真正的状态更新,应该交给Channel + Reducer机制处理。
你直接修改:
state["steps"]
等于绕过了 Runtime。
正确写法
def good_node(state):
return {
"steps": state["steps"] + ["good"]
}
即:
返回“增量更新”
而不是修改原对象
核心理解
- Node 的职责:计算更新内容
- Runtime 的职责:合并 State
不要混用。
(三)坑 3:每个请求都 compile()
系统上线后:
-
QPS 一高 CPU 就飙升
-
RT(响应时间)明显增加
-
压测性能极差
很多人会这样写:
def handle_request(req):
app = graph.compile()
return app.invoke(…)
问题在于 compile() 并不是轻量操作。它会:
-
校验图结构
-
构建执行计划
-
初始化 Channel
-
构建 Pregel Runtime
-
分析依赖关系
本质上接近:“编译工作流”。
正确写法
应该:
# 应用启动时执行一次
app = build_graph().compile()
def handle_request(req):
return app.invoke(…)
即:
Compile Once
Invoke Many Times
核心理解
CompiledStateGraph:
-
无状态
-
线程安全
-
可并发 invoke
所以:
compile 是“构建 Runtime”
invoke 才是“执行 Runtime”
(四)坑 4:State 字段缺失导致 KeyError
运行时突然报:
KeyError: 'steps'
例如:
state["steps"] + ["node1"]
但初始化时:
{
"message": "hello"
}
没有:
"steps": []
解决方案
初始化完整 State:
app.invoke({
"message": "hello",
"steps": [],
"step_count": 0
})
或者:
state.get("steps", [])
核心理解
LangGraph 不会自动补全字段。
State Schema:
TypedDict
只是:
类型约束
而不是:
默认值系统
七、工程化实践建议
真正进入生产环境后,LangGraph 的重点就不再是“能跑”,而是:
稳定性
可观测性
性能
可恢复性
下面是几个关键实践。
(一)使用 TypedDict 管理 State
不推荐
state = {}
推荐
class GraphState(TypedDict):
message: str
steps: list[str]
好处
-
IDE 自动补全
-
静态类型检查
-
减少 KeyError
-
State 结构更清晰
(二)节点避免副作用
Node 内:
不要:
-
改全局变量
-
改数据库连接状态
-
改共享对象
推荐:
输入 State
输出增量更新
保持:
Node = Pure Function
这样:
-
更容易 Debug
-
更容易重试
-
更容易并发
(三)compile() 全局复用
正确结构:
# app.py
graph = build_graph()
app = graph.compile()
请求阶段:
result = app.invoke(state)
不要:
每次请求 compile
(四)节点内部做好异常处理
因为:
Node Exception
= 整张图中断
推荐:
def safe_node(state):
try:
…
except Exception as e:
return {
"error": str(e)
}
或者:
-
增加 fallback node
-
增加 retry node
-
增加 human review node
(五)使用 stream() 做可观测
不要只用:
invoke()
更推荐:
for event in app.stream(state):
print(event)
因为:
stream = 天然单步调试器
它能看到:
-
当前节点
-
当前输出
-
State 如何变化
-
Runtime 如何流转
这是排查问题最有效的方式。
LangGraph 最容易踩坑的根源,其实只有一句话:
不要把它当“函数调用工具”。
要把它当“工作流 Runtime”。
理解这一点后:
-
START / END
-
State
-
Edge
-
Channel
-
compile
-
invoke
这些设计都会突然变得非常合理。
八、总结 & 下一篇预告
`StateGraph` 是 LangGraph 的基石——理解了「State + Node + Edge + compile + invoke」这五个核心概念,你就掌握了构建任何 AI Agent 工作流的基础能力。本篇我们刻意用了「直线图」,把注意力集中在地基上。
但你可能已经注意到一个伏笔:节点返回的 dict 是怎么合并进全局 State 的?如果两个节点都往 `messages` 里写,是覆盖还是追加?
下一篇《深入 LangGraph State:Reducer 是如何让状态"自动合并"的》,我们就来拆解 Channel 与 Reducer 机制——这是从「会写直线图」到「会写真实 Agent」的关键一跃。
备注系列导航:LangGraph从零构建生产级 AI Agent 平台的递进式学习项目从零构建生产级 AI Agent 平台的递进式学习项目