一、先建立直觉
没有合适索引时,数据库常常要:把候选行一张张翻过去(全表/大范围扫描)。 有了合适索引,更像:先查目录,再翻到那一页。
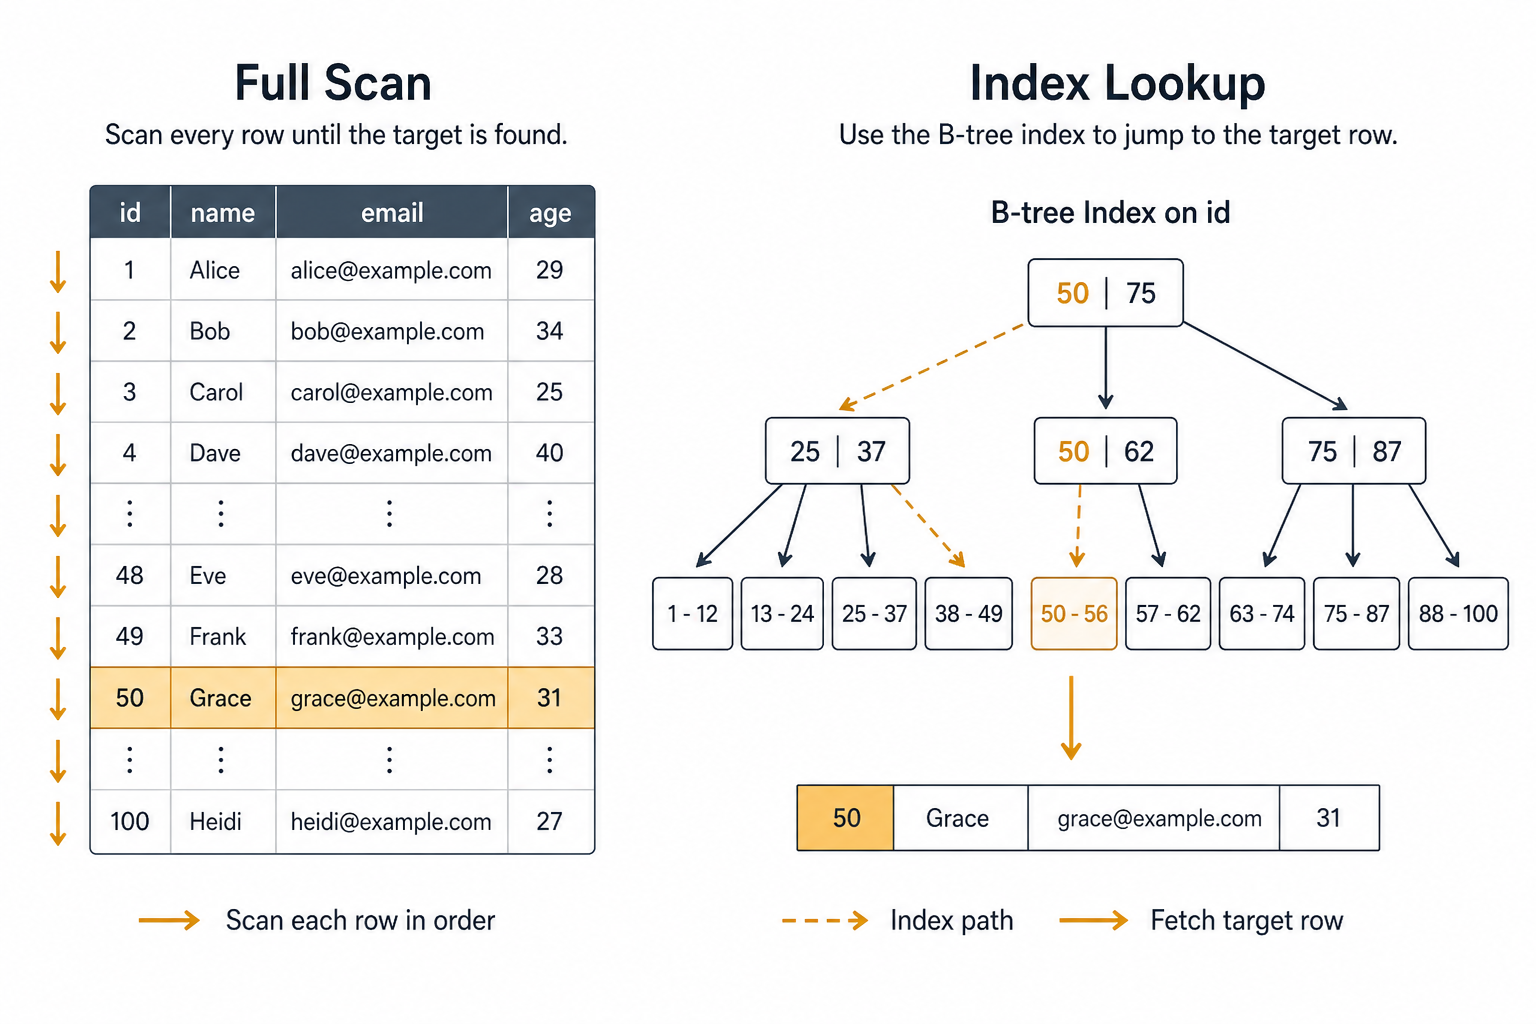
【一句话】 索引不是魔法加速器,而是用额外结构换「更少的数据触摸次数」。
二、索引主要优化什么
| 减少扫描量 | 从「看很多行」变成「看很少行」 |
| 支持排序/分组 | 某些 ORDER BY / GROUP BY 可少一次文件排序 |
| 加速关联 | JOIN 条件上的索引往往决定计划质量 |
代价同样真实:
-
占用存储
-
拖慢 INSERT/UPDATE/DELETE(要维护索引)
-
过多索引会让优化器更「犹豫」
所以索引是权衡,不是越多越好。
三、哪些条件更容易用上索引
以常见 B+Tree 二级索引心智为例(不同引擎细节有别,但直觉通用):
更友好
-
等值查询:WHERE user_id = ?
-
左最长前缀匹配的联合索引
-
范围查询在前缀列之后要小心组合方式
容易失效或变差
-
对索引列做函数/隐式类型转换:WHERE DATE(created_at)=…
-
前导模糊:LIKE '%keyword'
-
选择性极低的列单独建索引(如性别)
-
取回大量行再回表,优化器可能直接选扫描
【避坑】 「列上有索引」≠「这条 SQL 会走索引」。要用执行计划说话。
四、联合索引:顺序就是生产力
假设常查:WHERE app_id=? AND status=? AND created_at>?
一个常见设计是联合索引:(app_id, status, created_at)
原则记忆:
区分度高、常等值 的列更靠前(结合真实查询)
范围条件列通常放在等值列之后
不要为每一种排列都建一套,优先覆盖主路径
【结论】 联合索引的顺序,应按查询模式设计,而不是按表字段顺序瞎排。
五、上线前清单
【清单】
先用慢查询日志找到 Top SQL,而不是凭感觉加索引
看执行计划:类型、扫描行数、是否回表、是否临时表/文件排序
确认写入量:高频写表慎加大量索引
能合并的联合索引,不要拆成一堆单列索引
上线后观察:QPS、写延迟、磁盘与缓冲池命中
写在最后
索引解决的是「找得慢」,不是「算得笨」或「架构不合理」。 数据模型糟糕、一次查出十万行到应用再过滤,加十个索引也救不了。
【一句话带走】 先问查询要触达多少数据;再决定目录该怎么建。
你最近一次慢 SQL,是没索引、索引建错,还是回表太多?欢迎留言。