◆ 博主名称: 小此方-CSDN博客
大家好,欢迎来到小此方的博客。
⭐️网络系列个人专栏:
【主题曲】计算机网络
⭐️此方的GitHub:
github_此方
⭐️
我们思考 (Rethink) · 我们重建 (Rebuild) · 我们记录 (Record)
文章目录
- 概要&序論
- 一、什么是重定向
-
- 1.1 临时重定向的故事
- 1.2 永久重定向的故事
- 1.3重定向状态码有哪些
-
- 1.3.1两种重定向分别拿来干什么
- 1.4临时重定向和永久重定向的严谨概念
-
- 1.4.1HTTP状态码301(永久重定向)
- 1.4.2HTTP状态码302(临时重定向)
- 1.4.3永久重定向真正的价值
- 二、重定向的原理/应用
-
- 2.1用重定向处理错误请求
- Tips:讲点故事
- 三、HTTP常见的方法
-
- 3.1详解POST/GET方法
-
- 3.1.1 表单提交与参数传递方式
- 3.1.2 GET与POST的核心区别总结
-
- 3.1.2.1 传输机制与数据位置
- 3.1.2.2 参数长度限制
- 3.1.2.3安全性分析
- Tips:抓包工具介绍——费德勒
-
- 3.2.1 Fiddler的基本原理
- 3.2.2 混杂模式与网络代理的区别
概要&序論
Hello大家好,我是此方,上一期我们讲了状态码,异常处理和HTTP请求与应答报文的字段,本文继续深入 HTTP 协议,首先从实际场景出发理解什么是重定向,并区分临时重定向与永久重定向,重点分析 301、302 等状态码及其应用。随后深入介绍 HTTP 中常见的 GET 与 POST 方法,从表单提交、参数传递、数据位置、长度限制和安全性等角度理解二者的区别。最后介绍 Fiddler 抓包工具及网络代理的基本原理,通过实际观察 HTTP 请求与响应,加深对 HTTP 通信过程的理解。
一、什么是重定向
我们先不讲复杂难懂的概念,先来讲两个故事。
1.1 临时重定向的故事
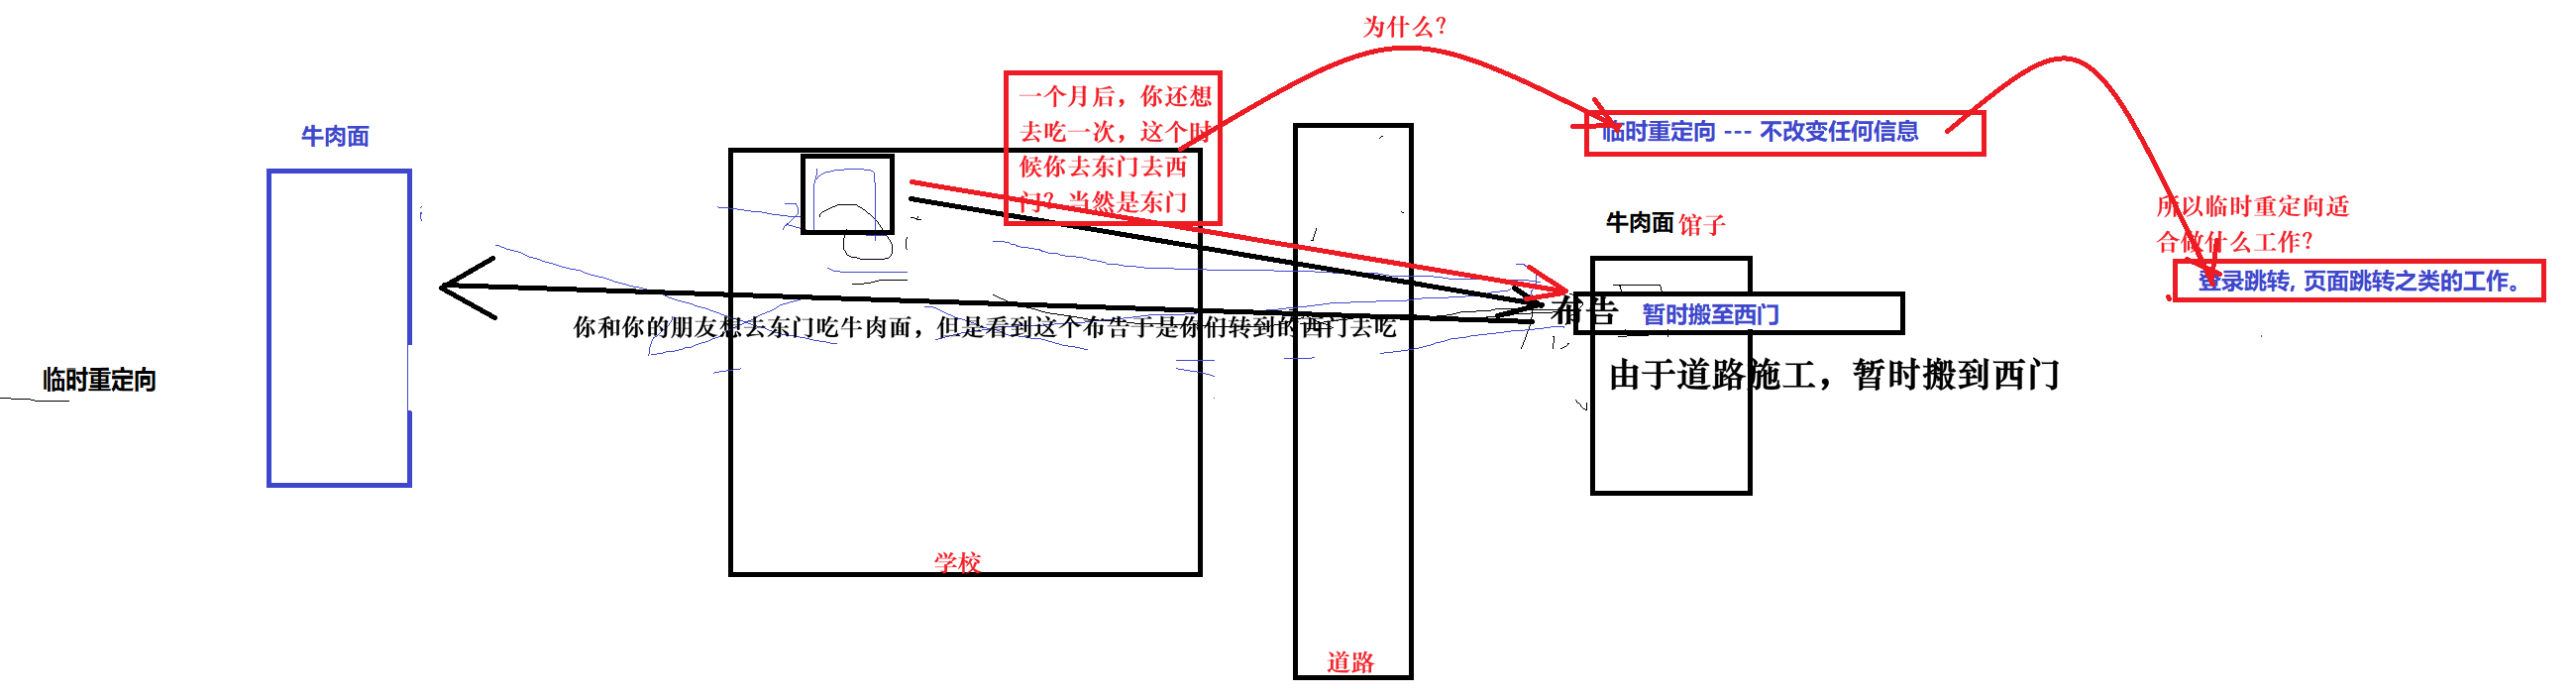
你们学校的西门外有一家牛肉面馆。你和你的朋友有一天想去东门吃牛肉面,到了东门看到店门口贴着一张告示:“由于道路施工,本馆临时搬迁至西门”。于是你和你的朋友转到西门去吃。 一个月后,你还想去吃一次牛肉面,这个时候你去东门还是去西门?当然是先去西门看看,因为你不知道他们家有没有搬回来了。
这个过程就是临时重定向。
1.2 永久重定向的故事
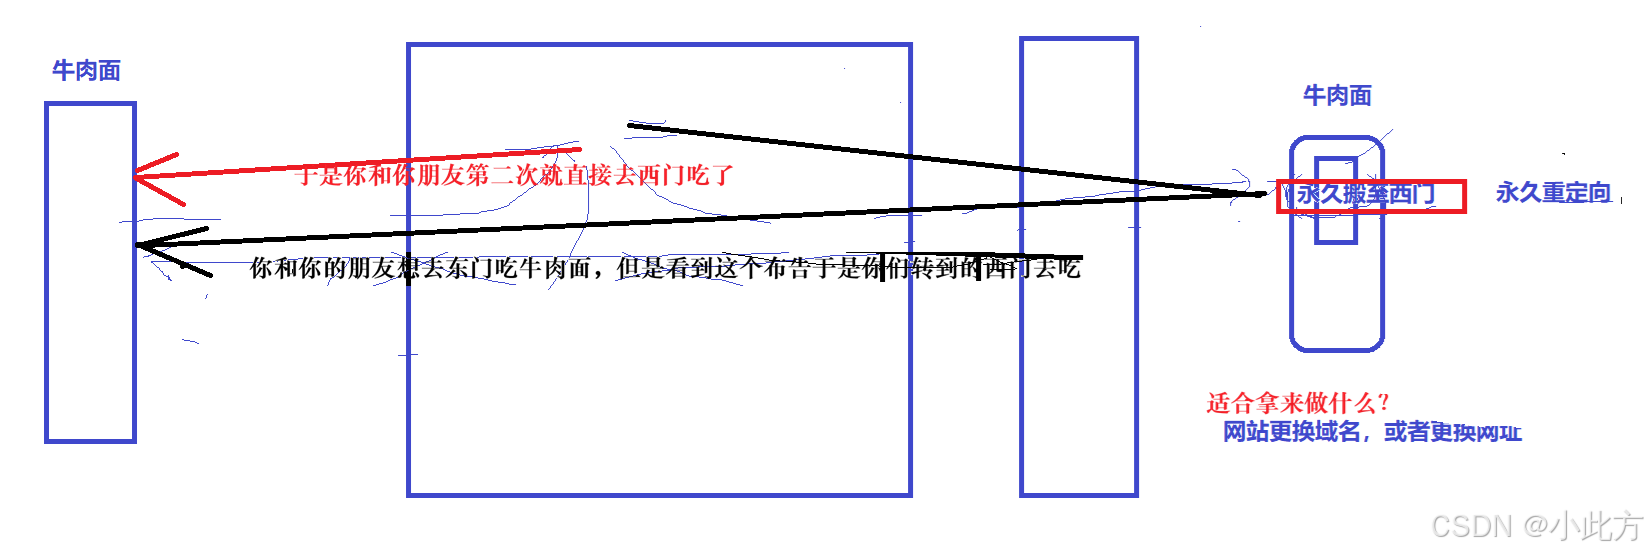
好,我们继续,又过了一个月后,你还想去吃一次牛肉面,到了西门看到布告上面写着 “本店永久搬迁到东门”,于是你去东门吃。又又过了一个月,你再去吃牛肉面,你会去哪里?当然是去东门。因为你知道牛肉面馆永久搬迁到东门了。
这个过程就是永久重定向。
1.3重定向状态码有哪些
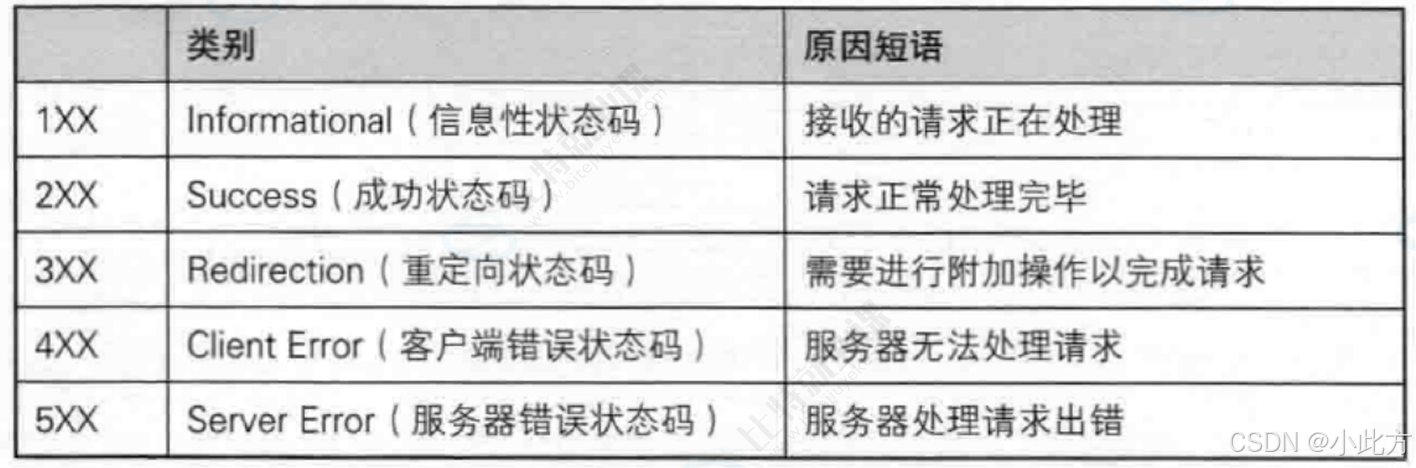
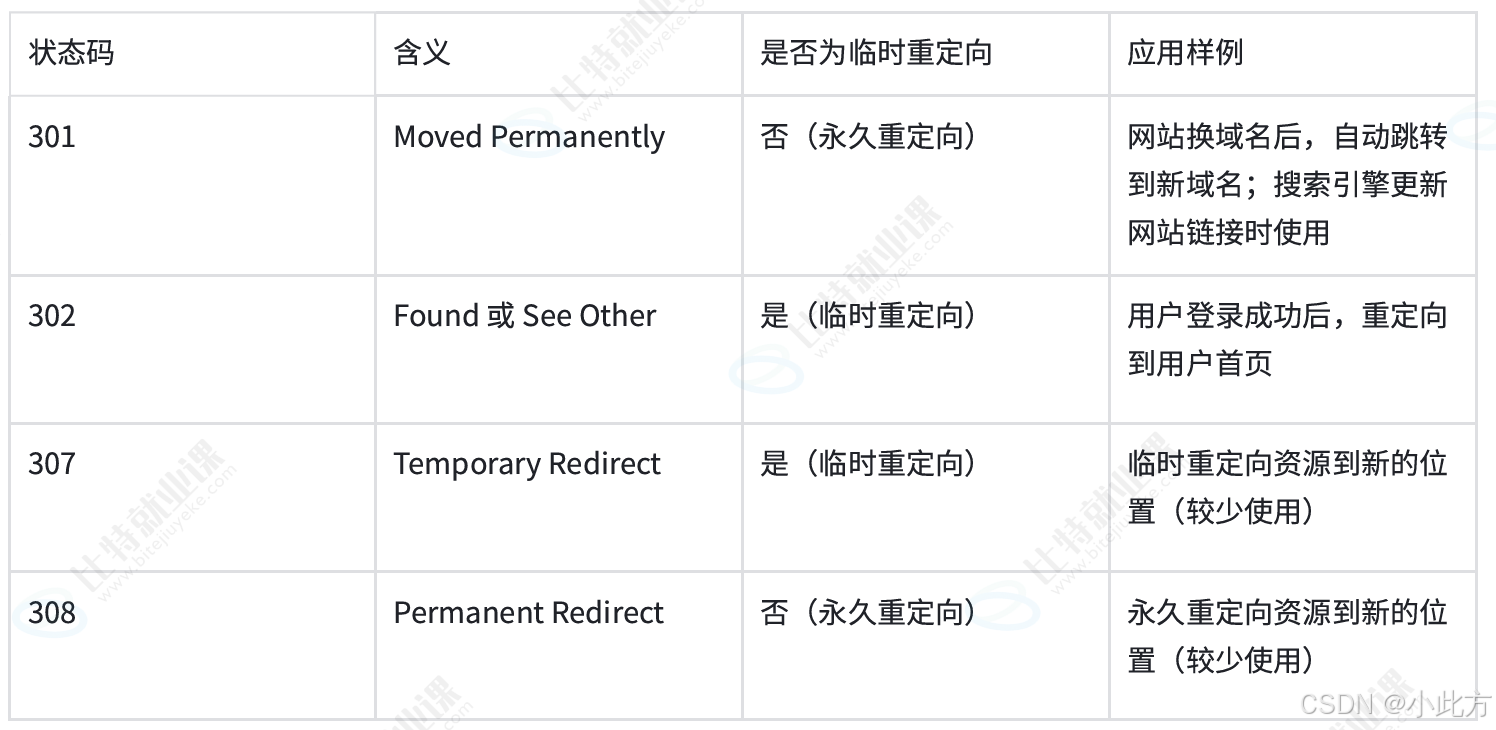
HTTP我们有很多状态码,我们在上一期基本讲过了,还剩下一个重定向,重定向3xx状态码展开有四种情况
1.3.1两种重定向分别拿来干什么
- 从这张表格中我们不难看出来,临时重定向不改变任何信息所以临时重定向适合做什么工作?登录跳转,页面跳转之类的工作。
- 那么永久重定向适合拿来干什么?适合网站更换域名,或者更换网址。
好的,是时候把专业的概念搬出来了。
1.4临时重定向和永久重定向的严谨概念
HTTP状态码301(永久重定向)和302(临时重定向)都依赖Location选项。(包括这个,我们上一篇零零总总聊了很多的报头选项,是的,我们待会儿会做总结。) 以下是关于两者依赖Location选项的详细说明:
1.4.1HTTP状态码301(永久重定向)
- 当服务器返回HTTP 301状态码时,表示请求的资源已经被永久移动到新的位置。
- 在这种情况下,服务器会在响应中添加一个Location头部,用于指定资源的新位置。这个Location头部包含了新的URL地址,浏览器会自动重定向到该地址。
- 例如,在HTTP响应中,可能会看到类似于以下的头部信息:
HTTP/1.1 301 Moved Permanently\\r\\n
Location: [https://www.new-url.com](https://www.new-url.com)\\r\\n
1.4.2HTTP状态码302(临时重定向)
- 当服务器返回HTTP 302状态码时,表示请求的资源临时被移动到新的位置。
- 同样地,服务器也会在响应中添加一个Location头部来指定资源的新位置。浏览器会暂时使用新的URL进行后续的请求,但不会缓存这个重定向。
- 例如,在HTTP响应中,可能会看到类似于以下的头部信息:
HTTP/1.1 302 Found\\r\\n
Location: [https://www.new-url.com](https://www.new-url.com)\\r\\n
总结来讲,无论是HTTP 301还是HTTP 302重定向,都需要依赖Location选项来指定资源的新位置。 这个Location选项是一个标准的HTTP响应头部,用于告诉浏览器应该将请求重定向到哪个新的URL地址。
也许你还没有真正理解——什么是永久重定向。 这确实很抽象,我给你举一个例子你就明白了。
1.4.3永久重定向真正的价值
临时重定向和永久重定向对于用户来说,实际上没什么区别。关键影响的是搜索引擎。 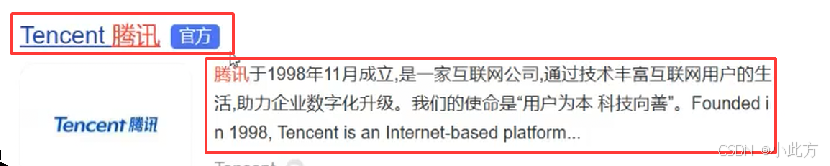
你向搜索引擎搜索东西,比如腾讯,搜索引擎就会拿着自己保存的那条这个公司的网址加上关键字加上描述信息给你构建出一条搜索结果。 搜索引擎定期会去更新他保存的那一堆网址。但是如果公司修改了网址,并且没有在搜索引擎请求的时候返回“301永久重定向”,这样搜索引擎就不会更新他的数据,依然用老的链接。 所以这就是永久重定向真正并且是最大的价值:网站换域名后,自动跳转到新域名;搜索引擎更新网站链接时使用!
二、重定向的原理/应用
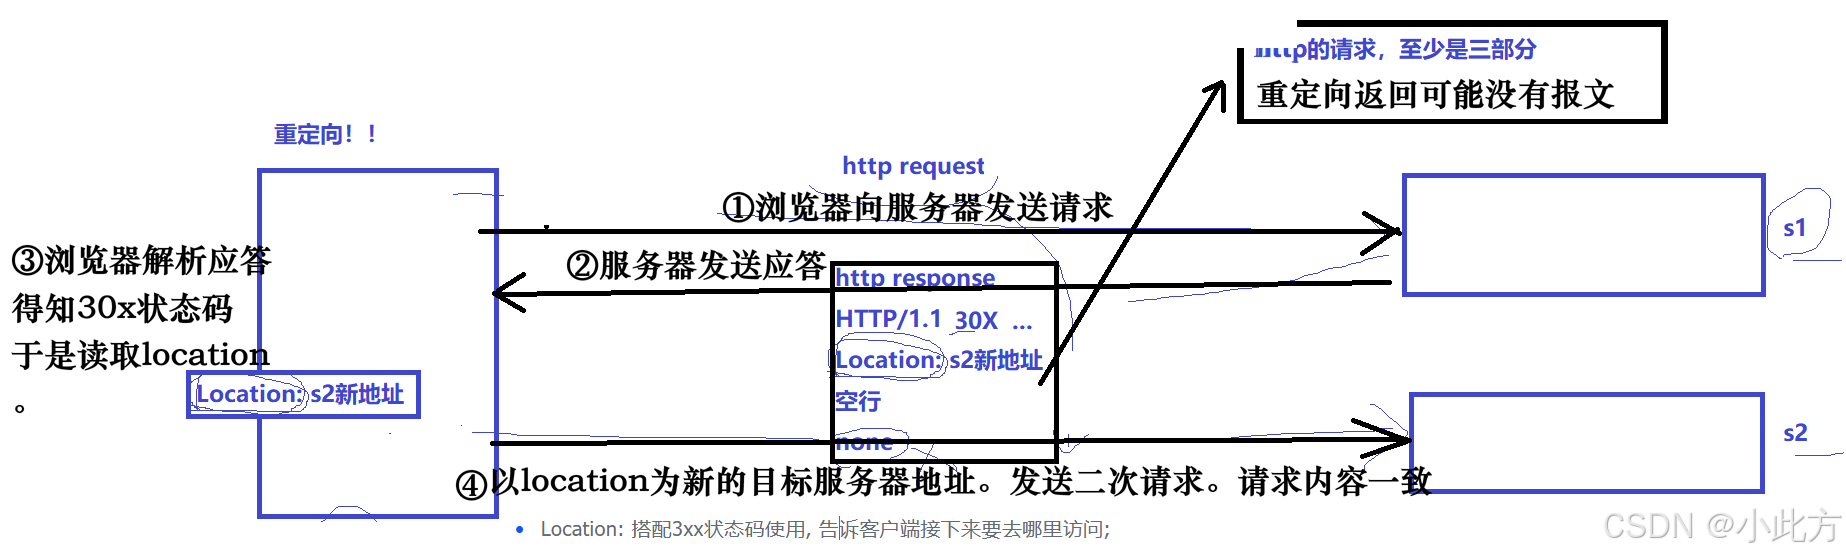
讲完什么是重定向,那么重定向到底是什么实现的呢?我们来看看。
2.1用重定向处理错误请求
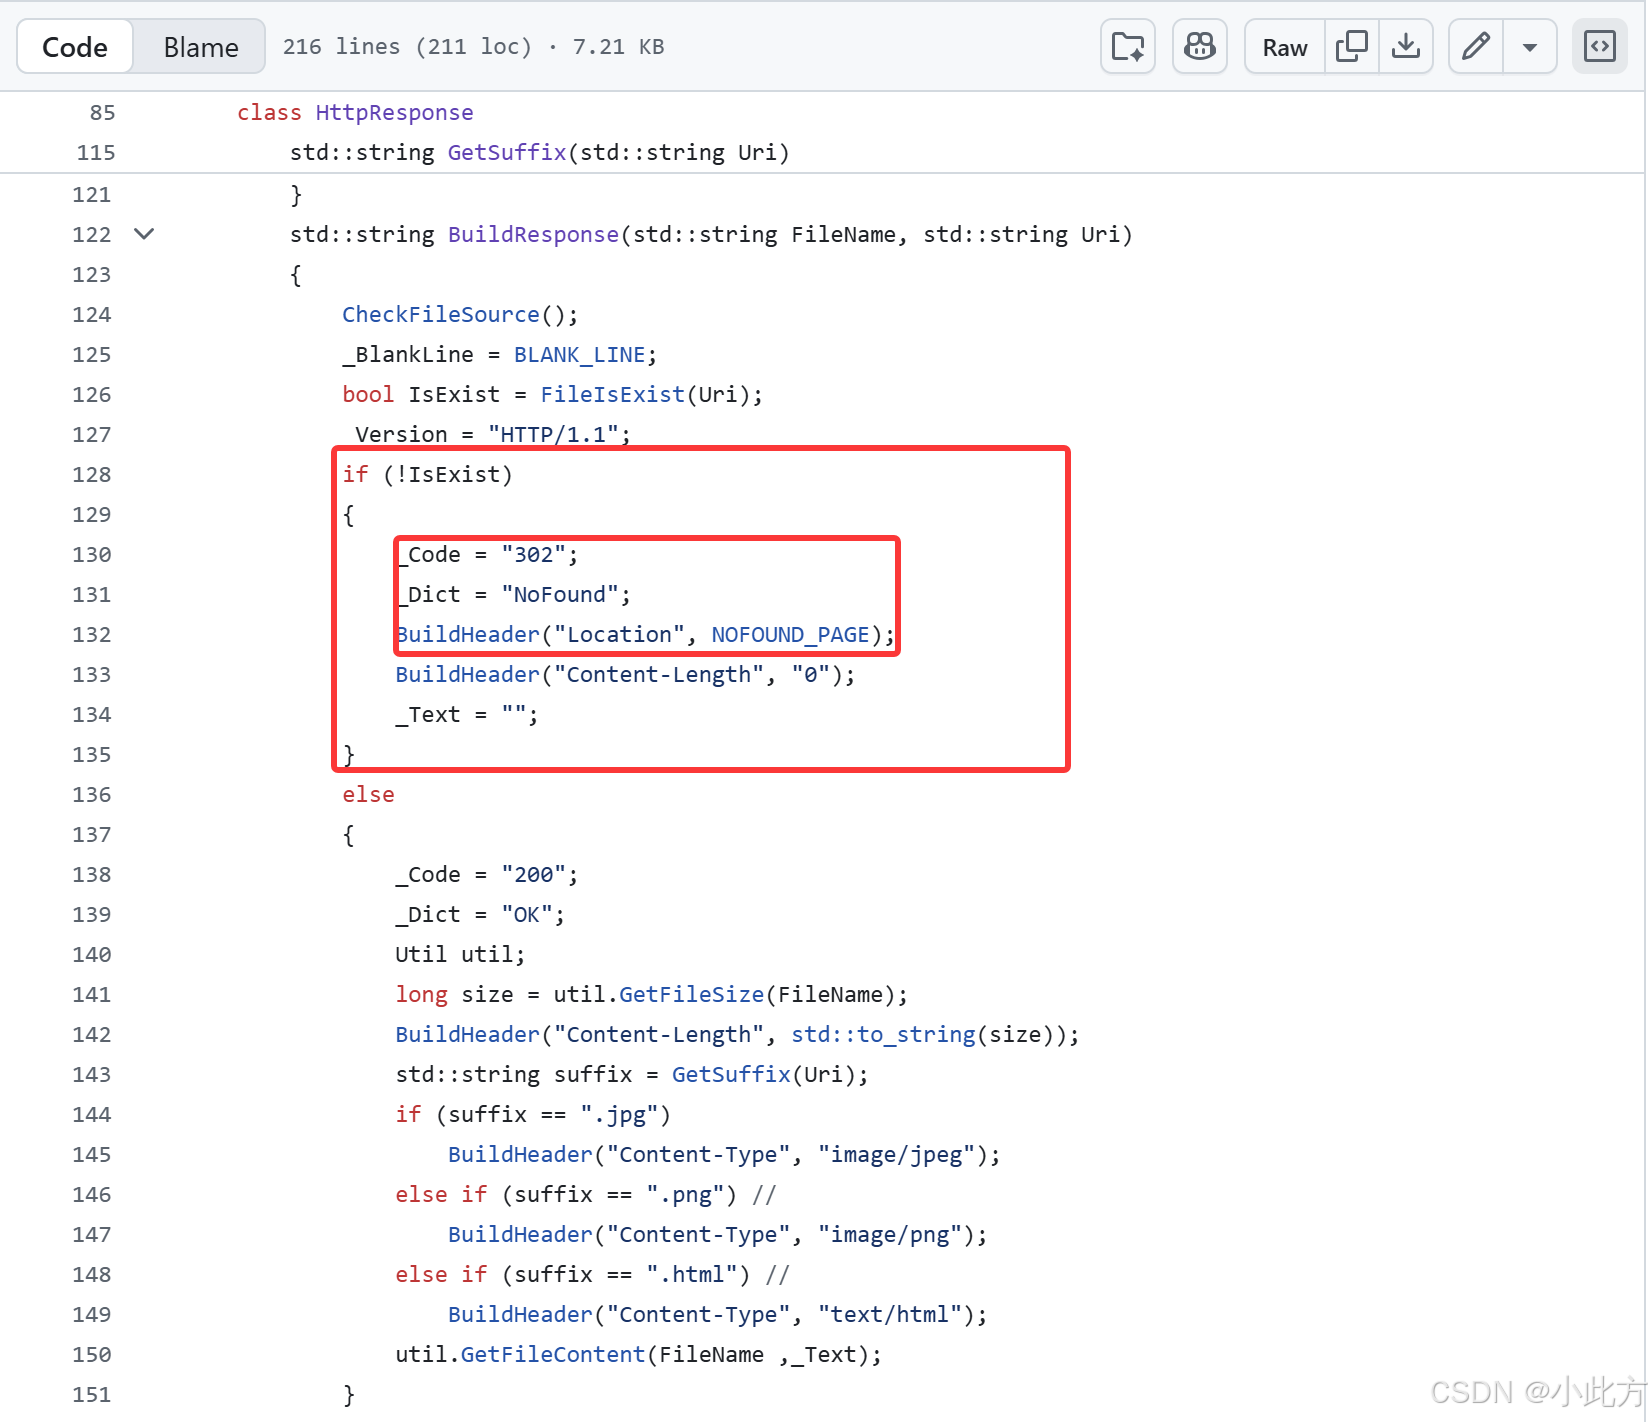
一种新的设计思路,我们可以以后如果出错了,本应该跳转到对应的错误页面,需要我们手动构建。 但是现在我们可以直接重定向,然后二次请求的时候我们返回重定向后的错误页面,这个时候我们就可以返回200状态码了。
SetCode(302);
SetHeader("Location", "[http://8.137.19.140:8080/404.html](http://8.137.19.140:8080/404.html)");
return true;
对应我们的代码就是:Network-Programming
Tips:讲点故事
(和文章内容无关,可以跳过)
在千禧年前后,那是上网都用电脑的时代,最重要的一款软件就是浏览器,所有人想上网都想打开它。在还没进入移动互联网时代的当年,浏览器就是绝对的流量入口。 早期最厉害的浏览器叫做领航员(Netscape Navigator)浏览器。
后来微软看到了巨大的商机,于是基于现有的 Windows 操作系统市场,推出了自己的 IE 浏览器,依靠软件预装的优势迅速占领了全球市场,领航员浏览器也就这样挂掉了。 随后,很多公司都开始做浏览器,因为浏览器有利可图,不仅能掌握流量,还可以内置搜索引擎。为了竞争这块市场,谷歌也卷入其中,于是 Chrome 浏览器应运而生,并且 Chrome 是开源的。 然而,浏览器距离利益实在是太近了!各家都有各自的浏览器技术,谁也不服谁。一个行业想要蓬勃发展就需要一套统一的标准,但当时大家的水平都差不多,对标准的支持也都不太好。 直到万维网联盟(W3C)等标准化组织发力,加上 Chrome 凭实力建立起事实上的标准,浏览器之间各自为政的乱局才终于画上了句号。
三、HTTP常见的方法
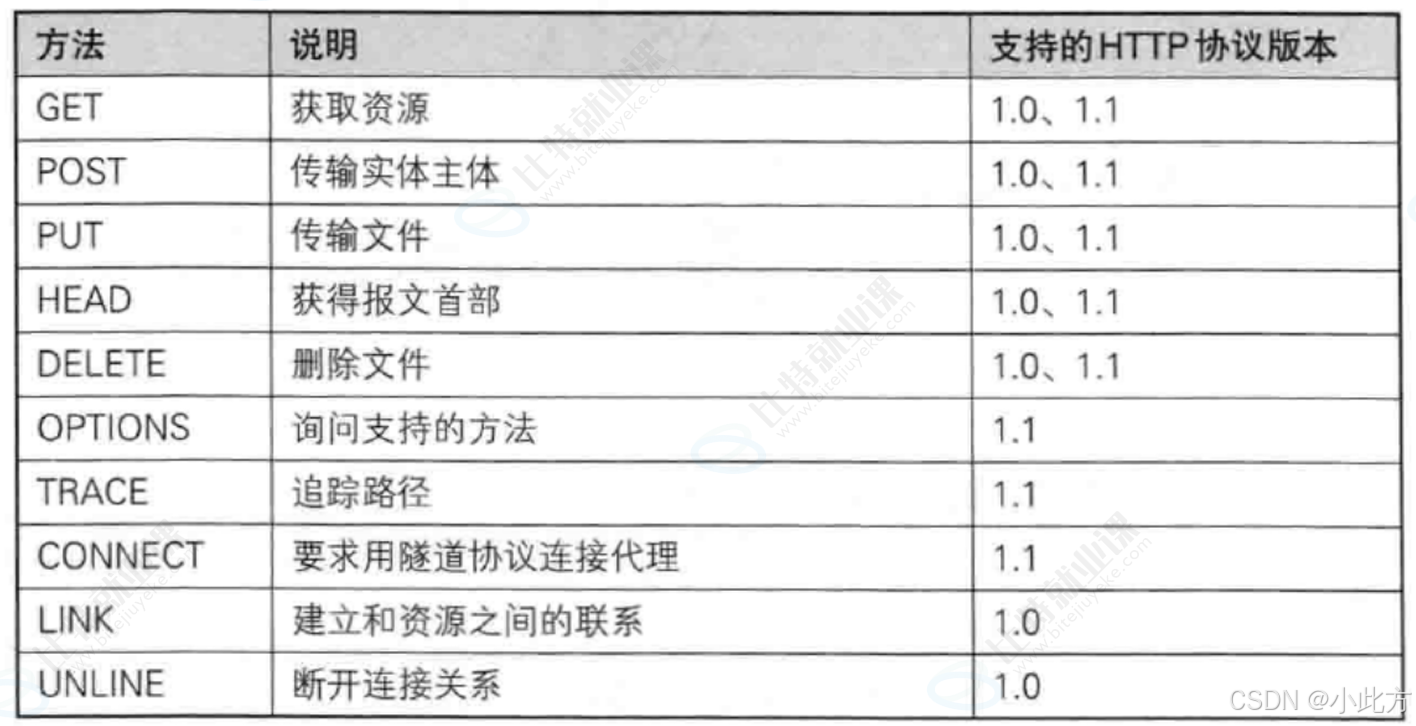
讲讲HTTP的方法,前两篇我们提到过。
3.1详解POST/GET方法
在HTTP协议中,GET与POST是最常使用的两种请求方法。通常情况下,GET方法主要用于获取静态资源(如图片、视频、音效、网页等),而POST方法主要用于上传资源。但在实际应用中,GET既可以获取资源也可以上传资源。
3.1.1 表单提交与参数传递方式
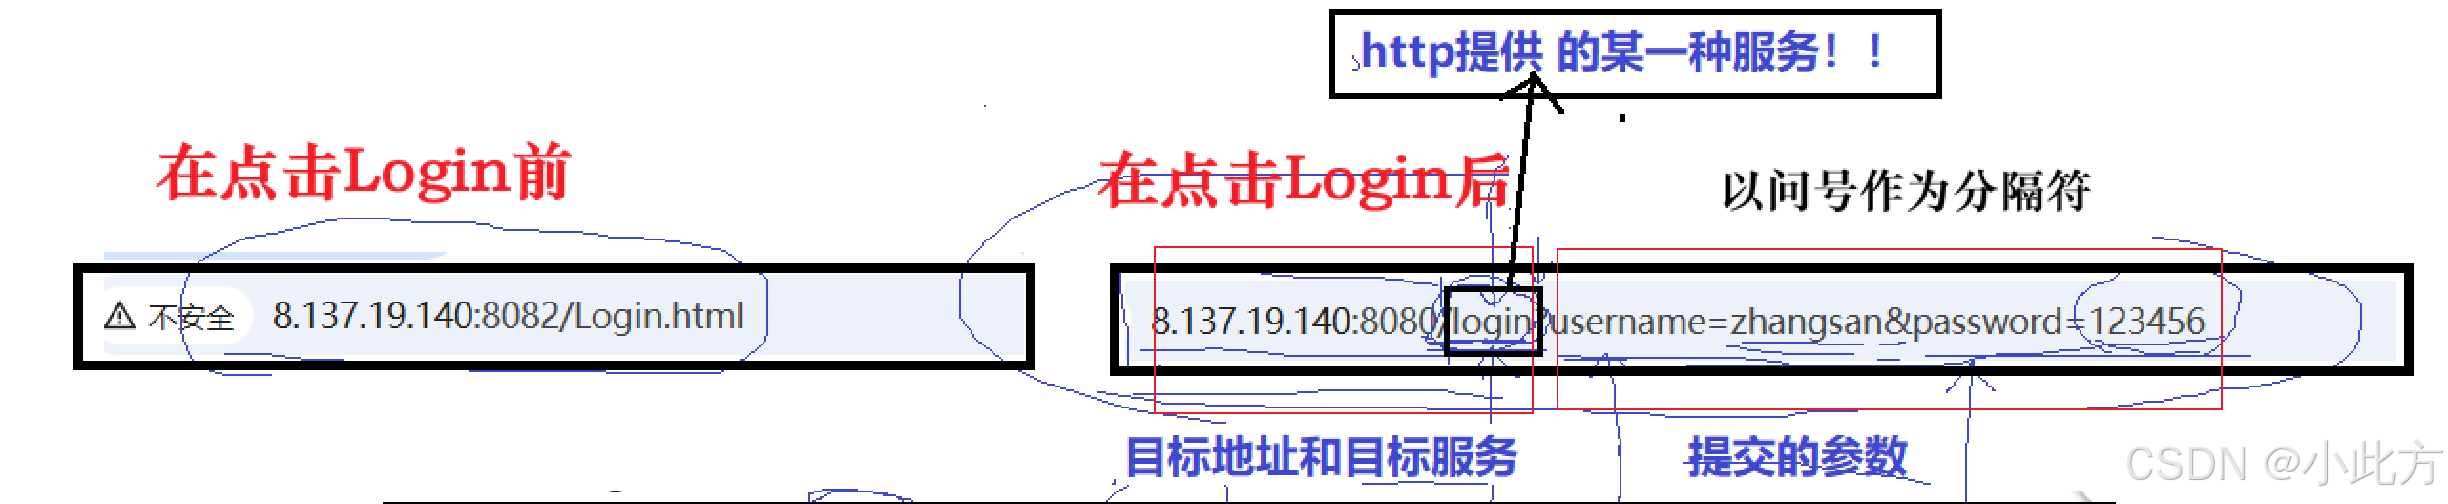
在网页前端(例如登录页面Login),表单提交参数时默认的方式是GET。当用户在登录界面输入用户名和密码点击登录时,请求会被发送至后台:
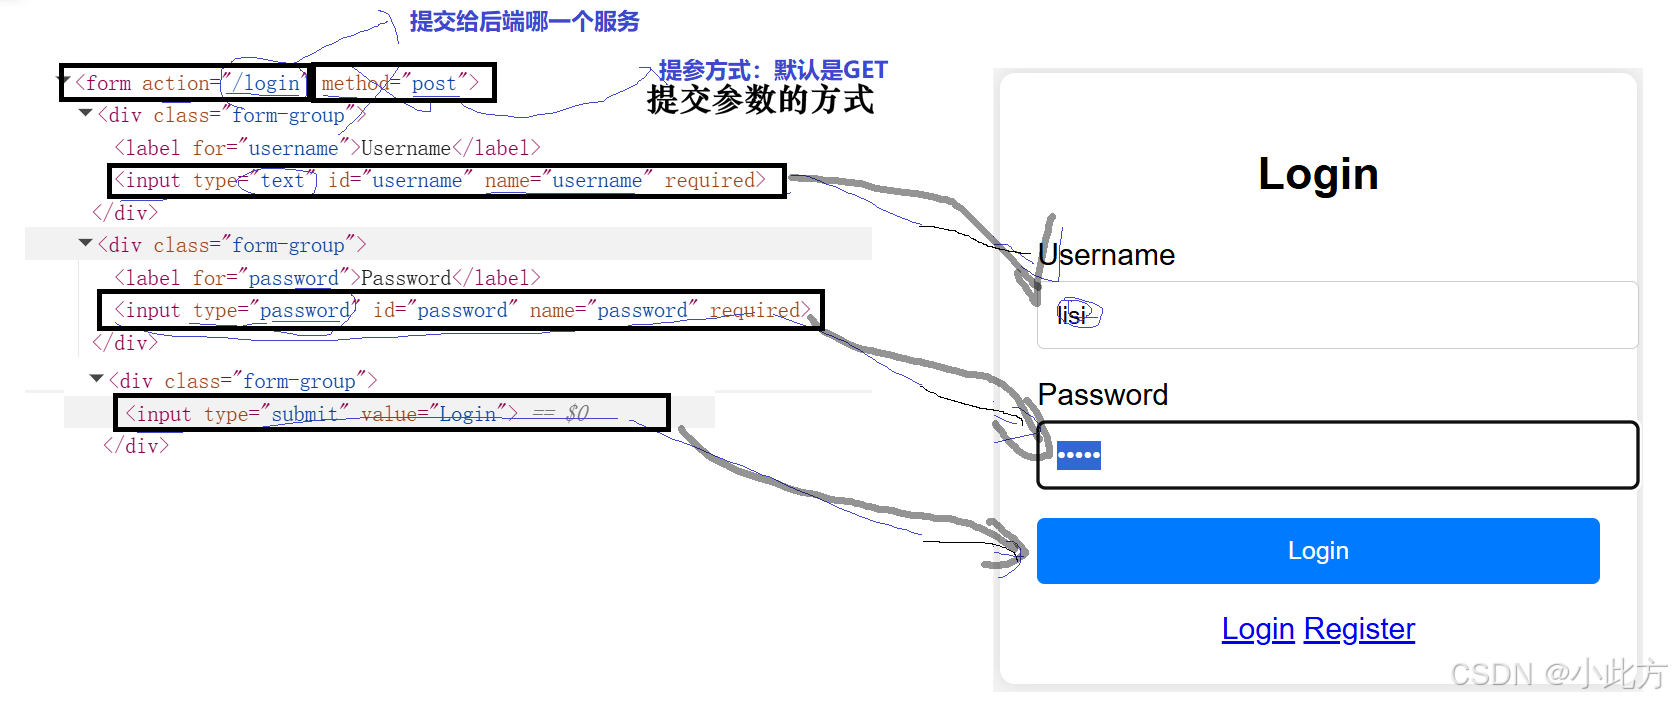
- GET提交参数:GET如果需要进行参数的提交,主要是通过URI的方式进行提交。提交的参数会以问号(?)作为分隔符挂在URL的后面(例如:http://8.137.19.140:8080/Login?username=lisi&password=54321)。
- POST提交参数:POST提交参数时,参数是通过HTTP请求正文(Request Body)进行提交的,例如在请求报文的正文末尾附带username=lisi&password=54321。
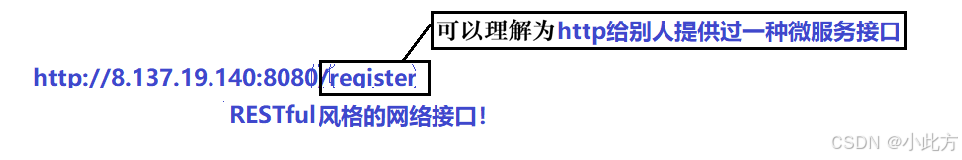
我们在后台制作和注册服务接口,客户端就可以以HTTP请求代码的形式来获取这种服务,这种风格的后台服务我们称之为RESTful。
3.1.2 GET与POST的核心区别总结
针对GET和POST的使用场景与传输特性,可以从以下几个维度进行对比:
3.1.2.1 传输机制与数据位置
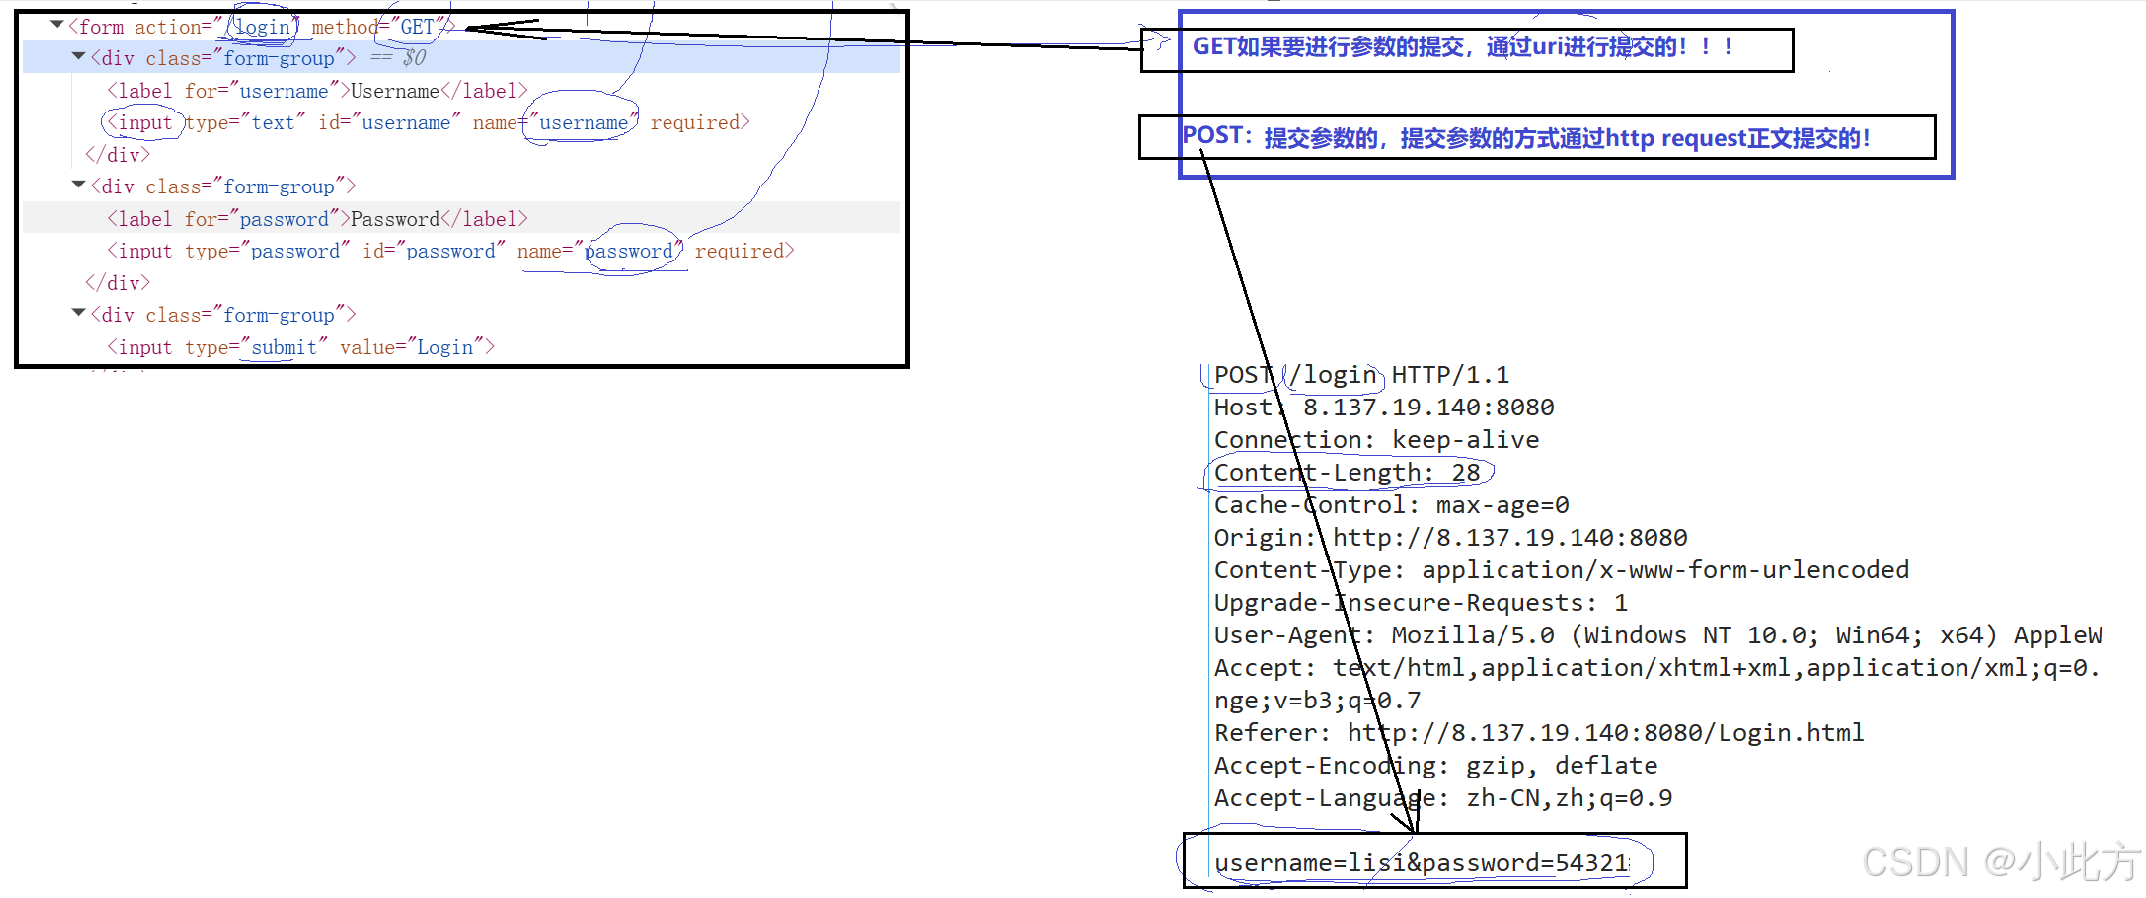
- GET方式:主要用于获取静态网页或资源,若要提交参数,必须以URI的方式进行提交。
- POST方式:主要通过请求正文(Body)进行数据提交。
3.1.2.2 参数长度限制
- GET提交参数:建议提交的参数不要过长,因为URI的长度一般都是有限制的。
- POST正文传参:通过正文传输意味着可以传递长数据,突破了URI的长度约束。
3.1.2.3安全性分析
- GET方式:提交参数时会在地址栏回显,显式呈现在URL中,非常直观且不够安全。
- POST方式:提交参数时不会回显在地址栏,相对更加隐蔽。
需要特别注意的是,无论GET还是POST,明文传输都不安全,因为数据都可以被抓包工具截获。要做到真正的安全,必须对报文进行加密,也就是采用HTTPS协议。
Tips:抓包工具介绍——费德勒
3.2.1 Fiddler的基本原理
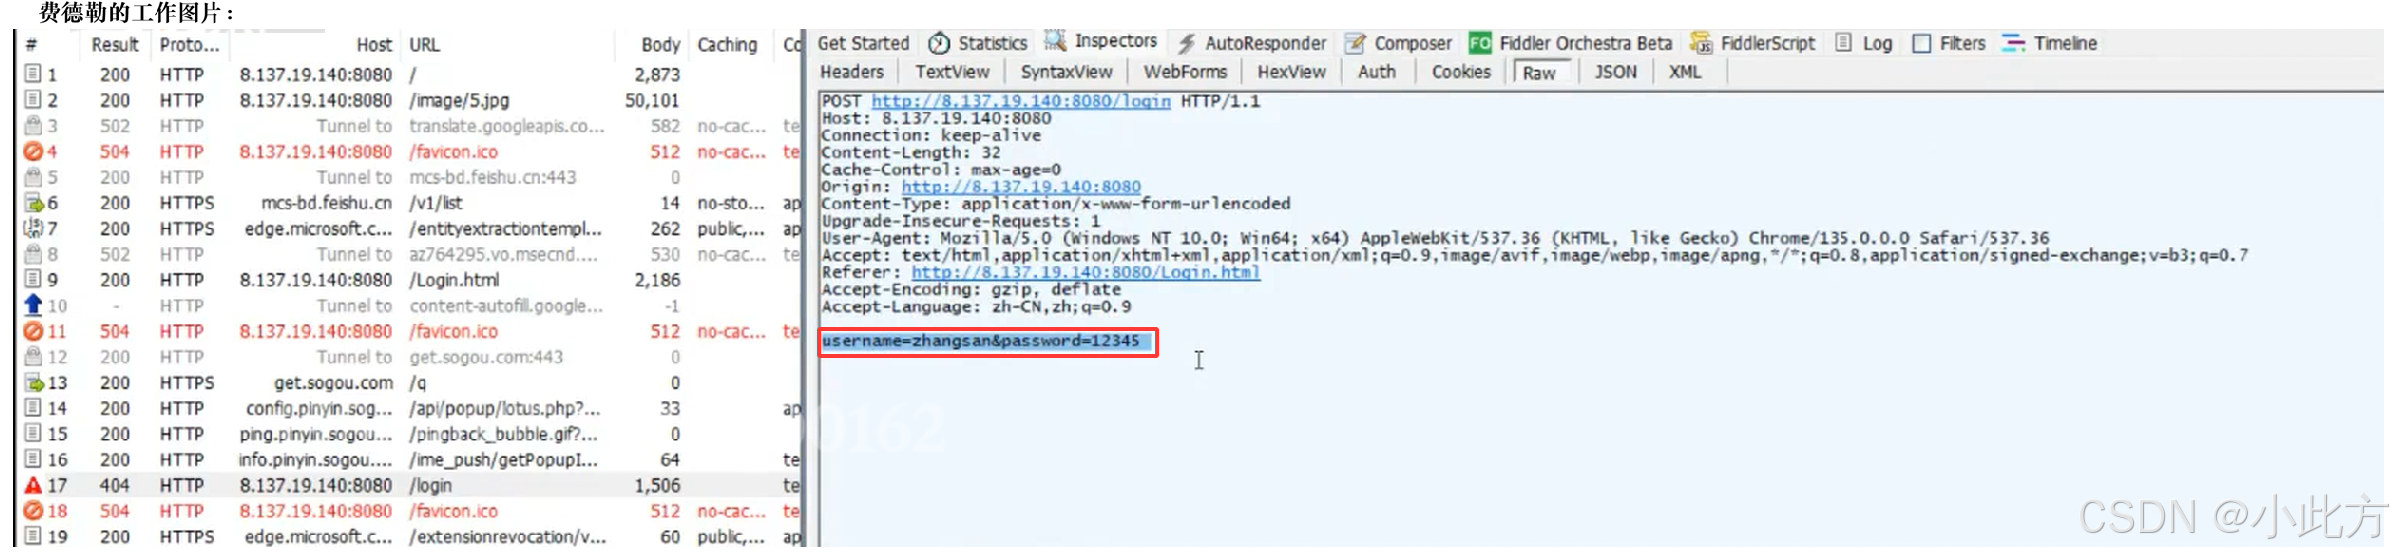
当我们在浏览器中输入用户名和密码向服务器发起请求时,Fiddler作为抓包工具介入了整个交互过程:
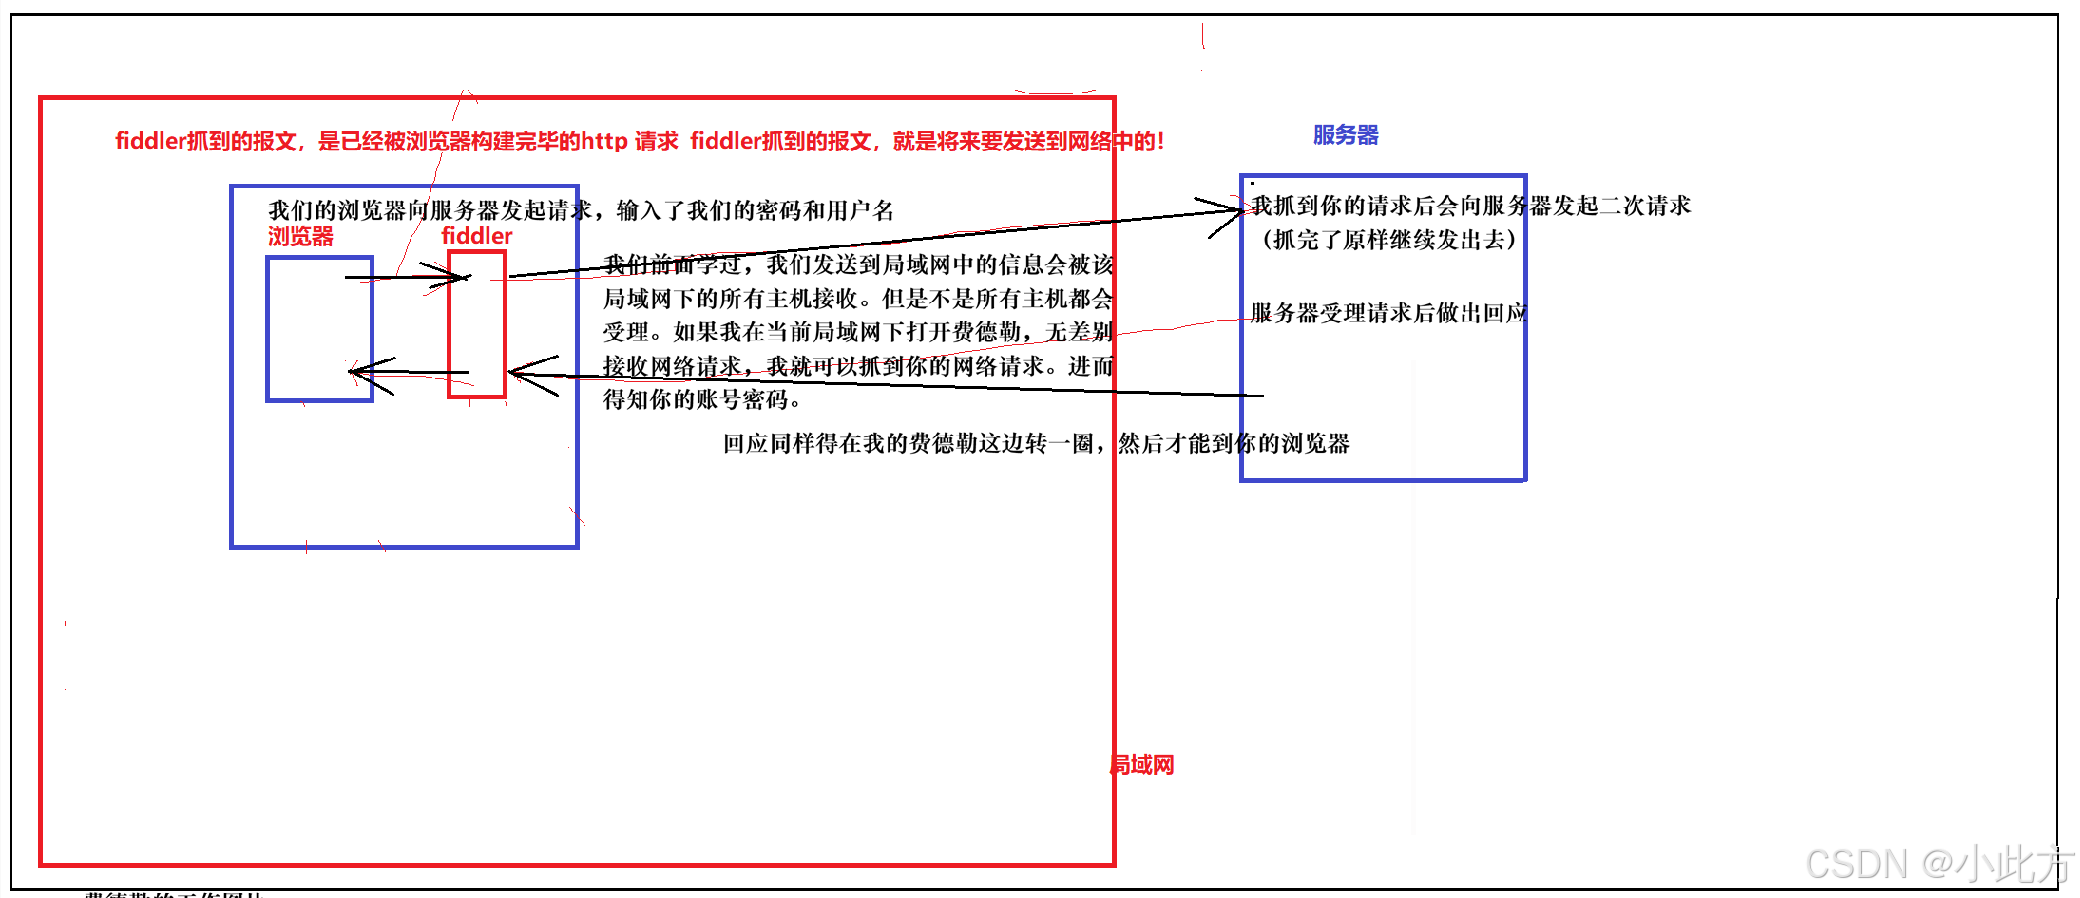
通过这样的机制,使用者就可以在Fiddler中清晰地看到拦截到的请求内容,进而得知传输的数据与账号密码信息。
3.2.2 混杂模式与网络代理的区别
在理解Fiddler的工作机制时,需要注意避免一个常见的技术误区。 部分资料中提及“发送到局域网中的信息会被局域网下的所有主机接收,打开费德勒无差别接收网络请求”,这实际上描述的是Wireshark等网卡抓包工具的工作原理。Wireshark是利用网卡的混杂模式(Promiscuous Mode)来监听局域网中的数据包。 而Fiddler的真正工作原理是HTTP/HTTPS代理(Proxy):
- 代理设置:Fiddler在启动时,会自动将系统的HTTP/HTTPS代理设置为127.0.0.1:8888。
- 请求重定向:浏览器感知到系统代理后,会主动将原本要发送给远端服务器的请求,先发送给Fiddler。
- 中间人转发:Fiddler收到请求后,作为“中间人”代为发送给目标服务器;收到服务端响应后,再将响应原封不动转交给浏览器。
关于代理的相关内容,已经在写了,敬请期待。
好的本期内容就到这里,如果对你有帮助,还不要忘记点赞三联支持。我是此方,我们下期再见。bye!