做工业视觉部署这些年,遇到最多的性能瓶颈不是算法不够先进,而是硬件不给力。产线上的工控机很多还是i5-7代、8代,没有独立显卡,跑一个YOLOv8n单帧就要200多毫秒,节拍卡得死死的。加GPU吧,成本、功耗、稳定性都是问题,很多场景还不允许。这时候模型轻量化就成了必选项,但真正做过的人都知道,Python里训出来的轻量模型,到C#端一部署,要么算子不支持,要么精度崩了,要么速度根本没提上去。
这篇文章就把知识蒸馏和模型剪枝在C#工业部署场景下的完整落地链路讲清楚,包括每个环节的技术细节、参数怎么调、哪些坑容易踩,所有方案都基于ONNX Runtime在C#端验证过,适用于工控机、边缘相机这类算力受限的部署环境。
为什么工业场景必须做轻量化,而且要在C#端验证
工业现场做轻量化,和学术界刷榜完全是两回事。学术界追求的是在COCO上mAP掉最少、参数量压最低,工业场景追求的是在自己的产线数据上,漏检率不超标、单帧延迟稳定在节拍以内、在目标硬件上真的能跑快。这中间有巨大的鸿沟。
第一个现实问题是边缘算力受限。大量在役工控机没有独立GPU,CPU还是几代之前的型号,原生中大型模型根本跑不动。就算能跑,帧率也上不去,高速产线要求单帧20到50毫秒,原生模型很难达标。第二个问题是部署生态差异。PyTorch里做的非结构化剪枝,到了ONNX Runtime里根本不生效,稀疏权重反而可能让推理更慢;TensorRT里的优化,到了OpenVINO或者纯CPU上又是另一回事。第三个问题是精度红线。工业检测可以慢一点,但漏检和误检不能超标,尤其是缺陷检测,轻量化不能以牺牲召回率为代价。
所以轻量化不是训练端剪一剪、导个模型就完事了,它是一个从训练策略、剪枝粒度、蒸馏适配,到C#端推理优化、产线精度验证的完整链路,而且很多坑只有在C#部署环境里才会暴露出来。
知识蒸馏和模型剪枝,到底解决什么问题
很多人把这两个技术混为一谈,其实是完全不同的路线。知识蒸馏的核心是用一个参数量大、精度高的教师模型,去指导一个参数量小、速度快的学生模型训练,让学生学到教师模型的软标签信息和特征分布,而不只是学硬标注。它最大的价值在小数据集场景,工业项目通常只有几千张标注图,直接训小模型精度很差,用大模型当教师蒸馏一下,精度能高出5到10个点。
蒸馏里有两个关键参数。一个是温度T,控制软标签的平滑程度,工业视觉一般设4到10。太高会模糊类别差异,太低起不到蒸馏效果,小目标和缺陷检测场景建议偏低,避免小目标特征被抹平。另一个是损失权重,分类损失和蒸馏损失的比例,工业场景一般蒸馏损失权重设0.3到0.5,不要让蒸馏损失盖过真实标签的监督信号。
模型剪枝的核心是剪掉模型里冗余的权重和通道。它分两大类,非结构化剪枝是剪掉单个权重,剪枝比例高但产生稀疏矩阵,大部分推理硬件不支持,实际速度反而可能变慢,工业部署基本不用。结构化剪枝是按通道、层、模块为单位剪掉整个卷积通道,剪完之后模型结构完整,所有推理框架都支持,速度提升和参数量下降成正比,这才是工业边缘部署的首选。
工业里最常用的是基于BN层gamma权重的通道剪枝。卷积层后面接BN层,gamma权重的大小代表这个通道对输出的贡献度,gamma越小说明通道越不重要,就可以剪掉。这个方法最成熟也最稳定,一般剪枝30%到40%,精度损失可以控制在1%以内,推理速度提升30%到50%;剪枝超过50%,精度就会明显下降,尤其是小目标检测。
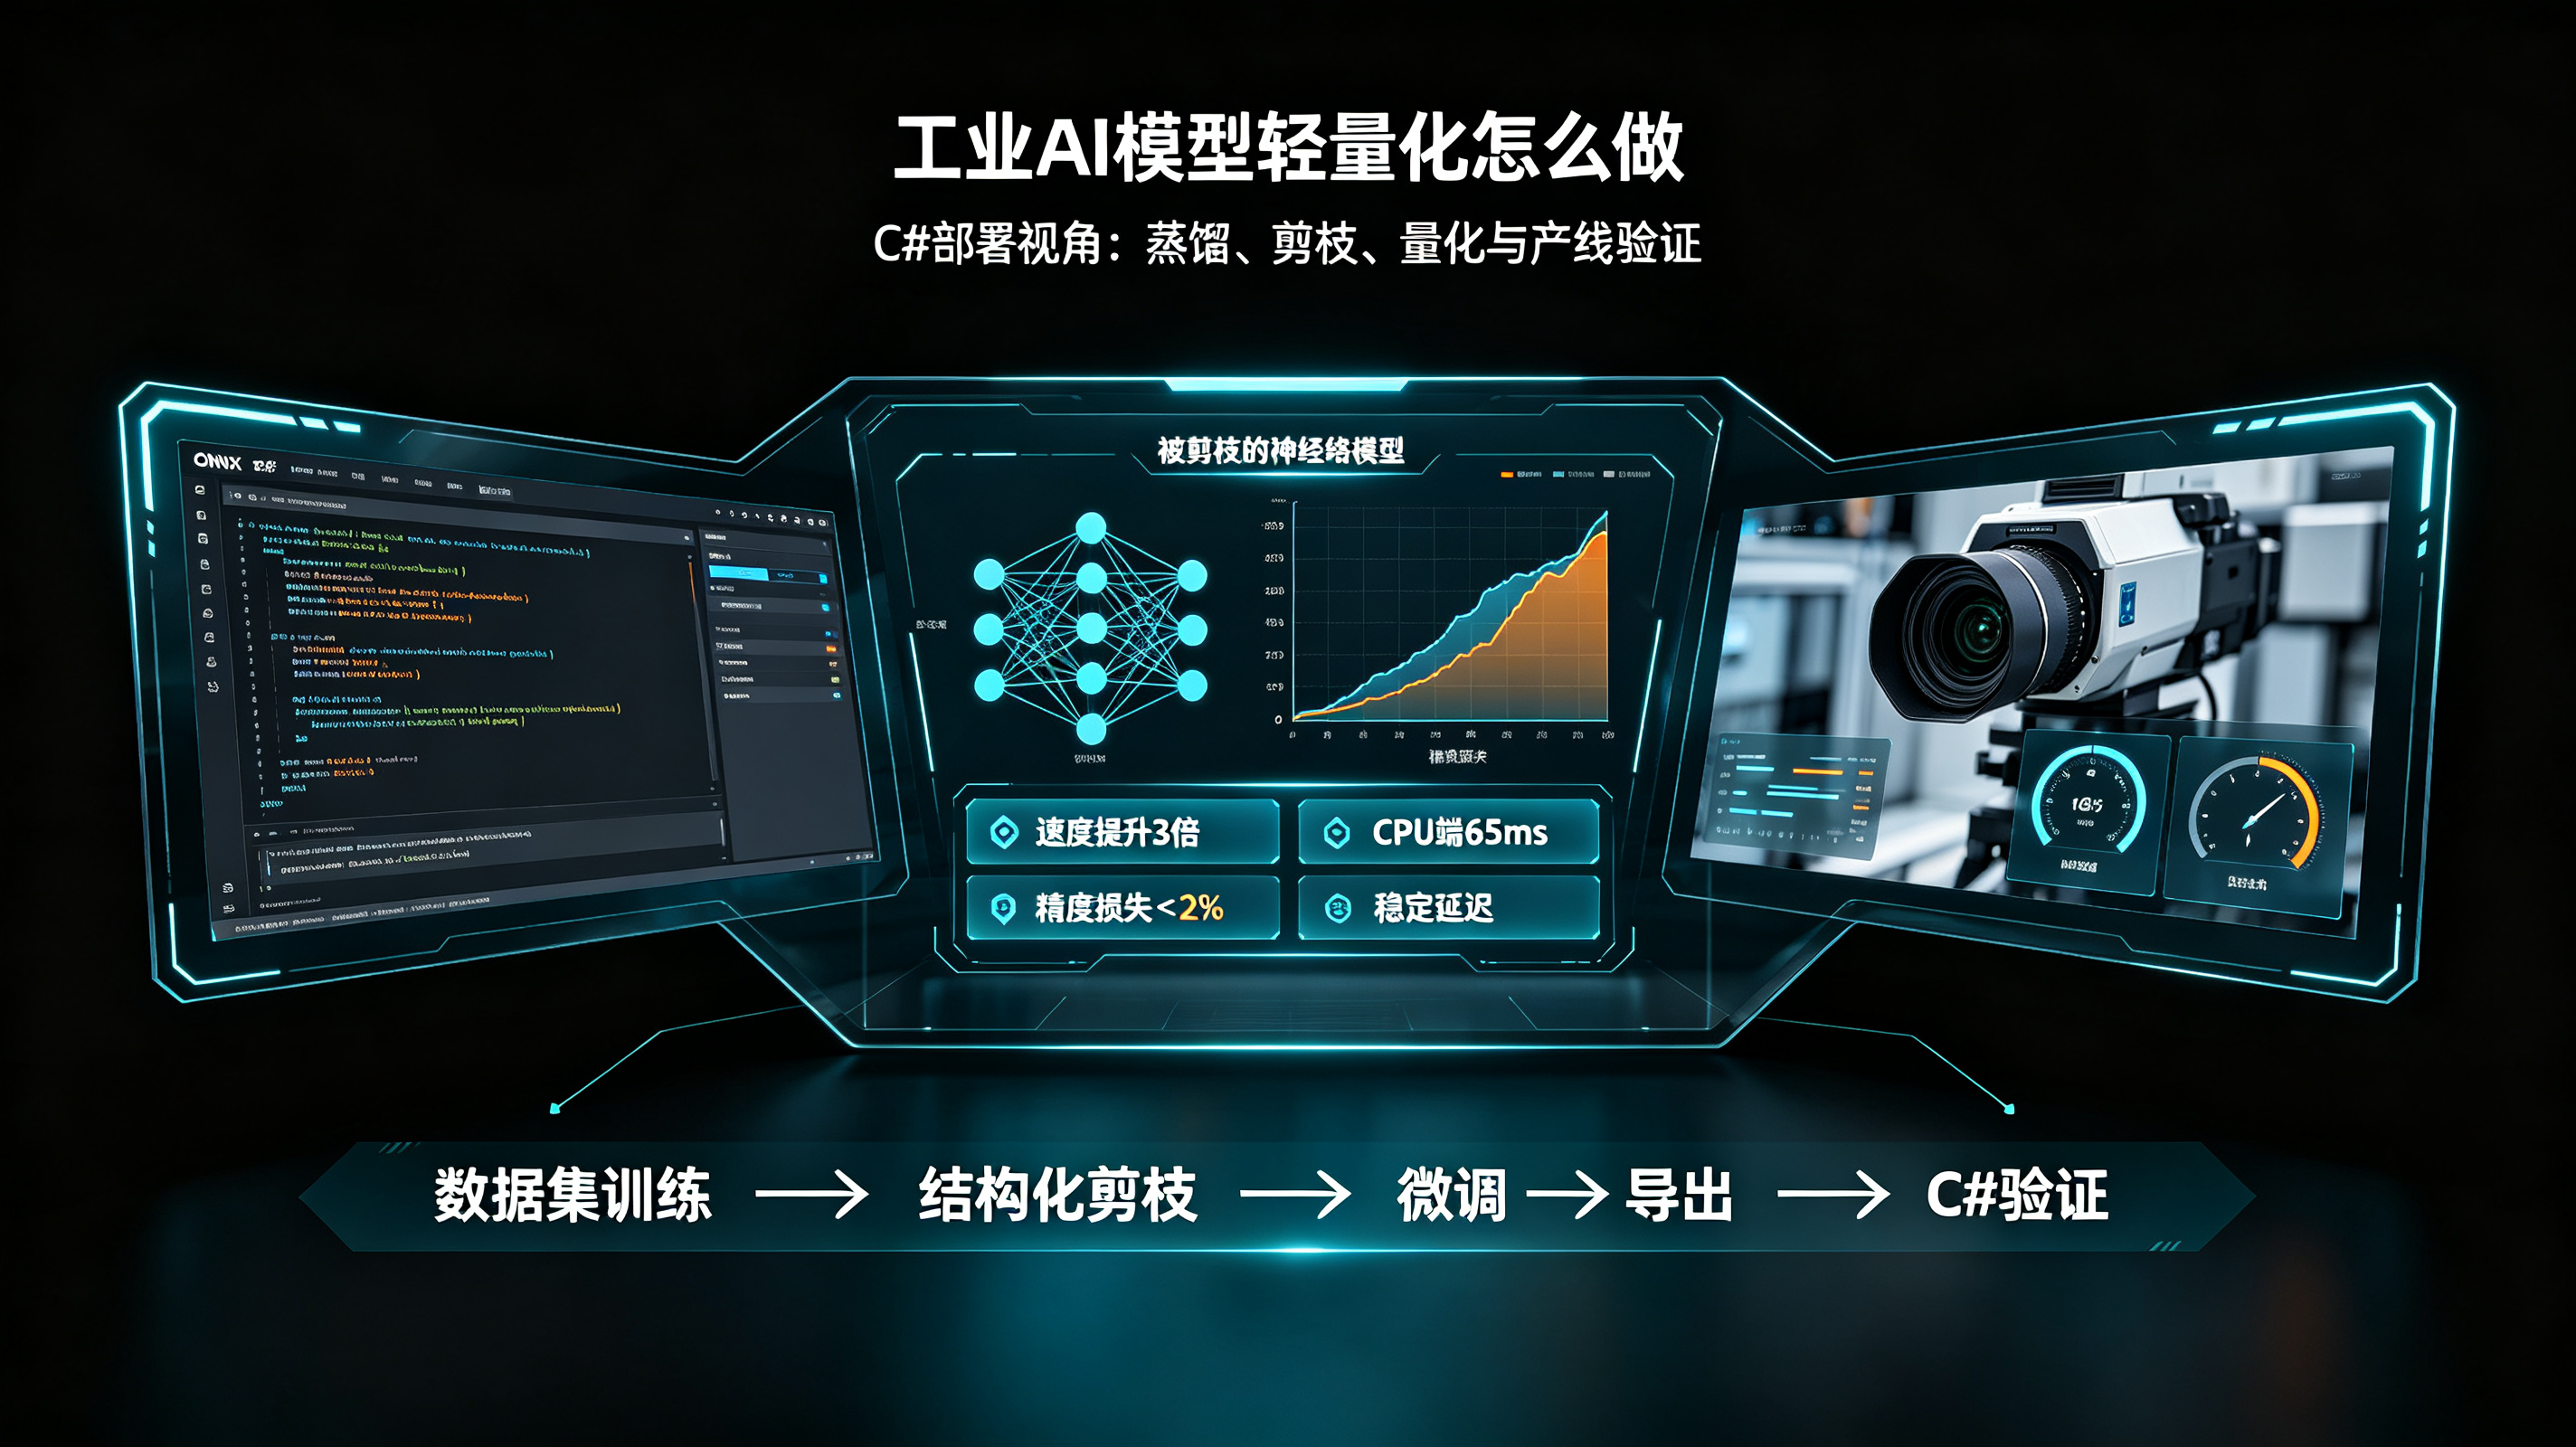
实际项目里两者结合效果最好:先蒸馏得到学生模型,再做结构化剪枝,最后用小学习率微调恢复精度,通常能在精度损失小于2%的前提下,速度提升2到3倍。
完整落地流程,每一步都和C#部署强相关
整个轻量化链路从教师模型准备开始,到最终产线验证,一共七个环节,每个环节的决策都会影响C#端的最终效果。
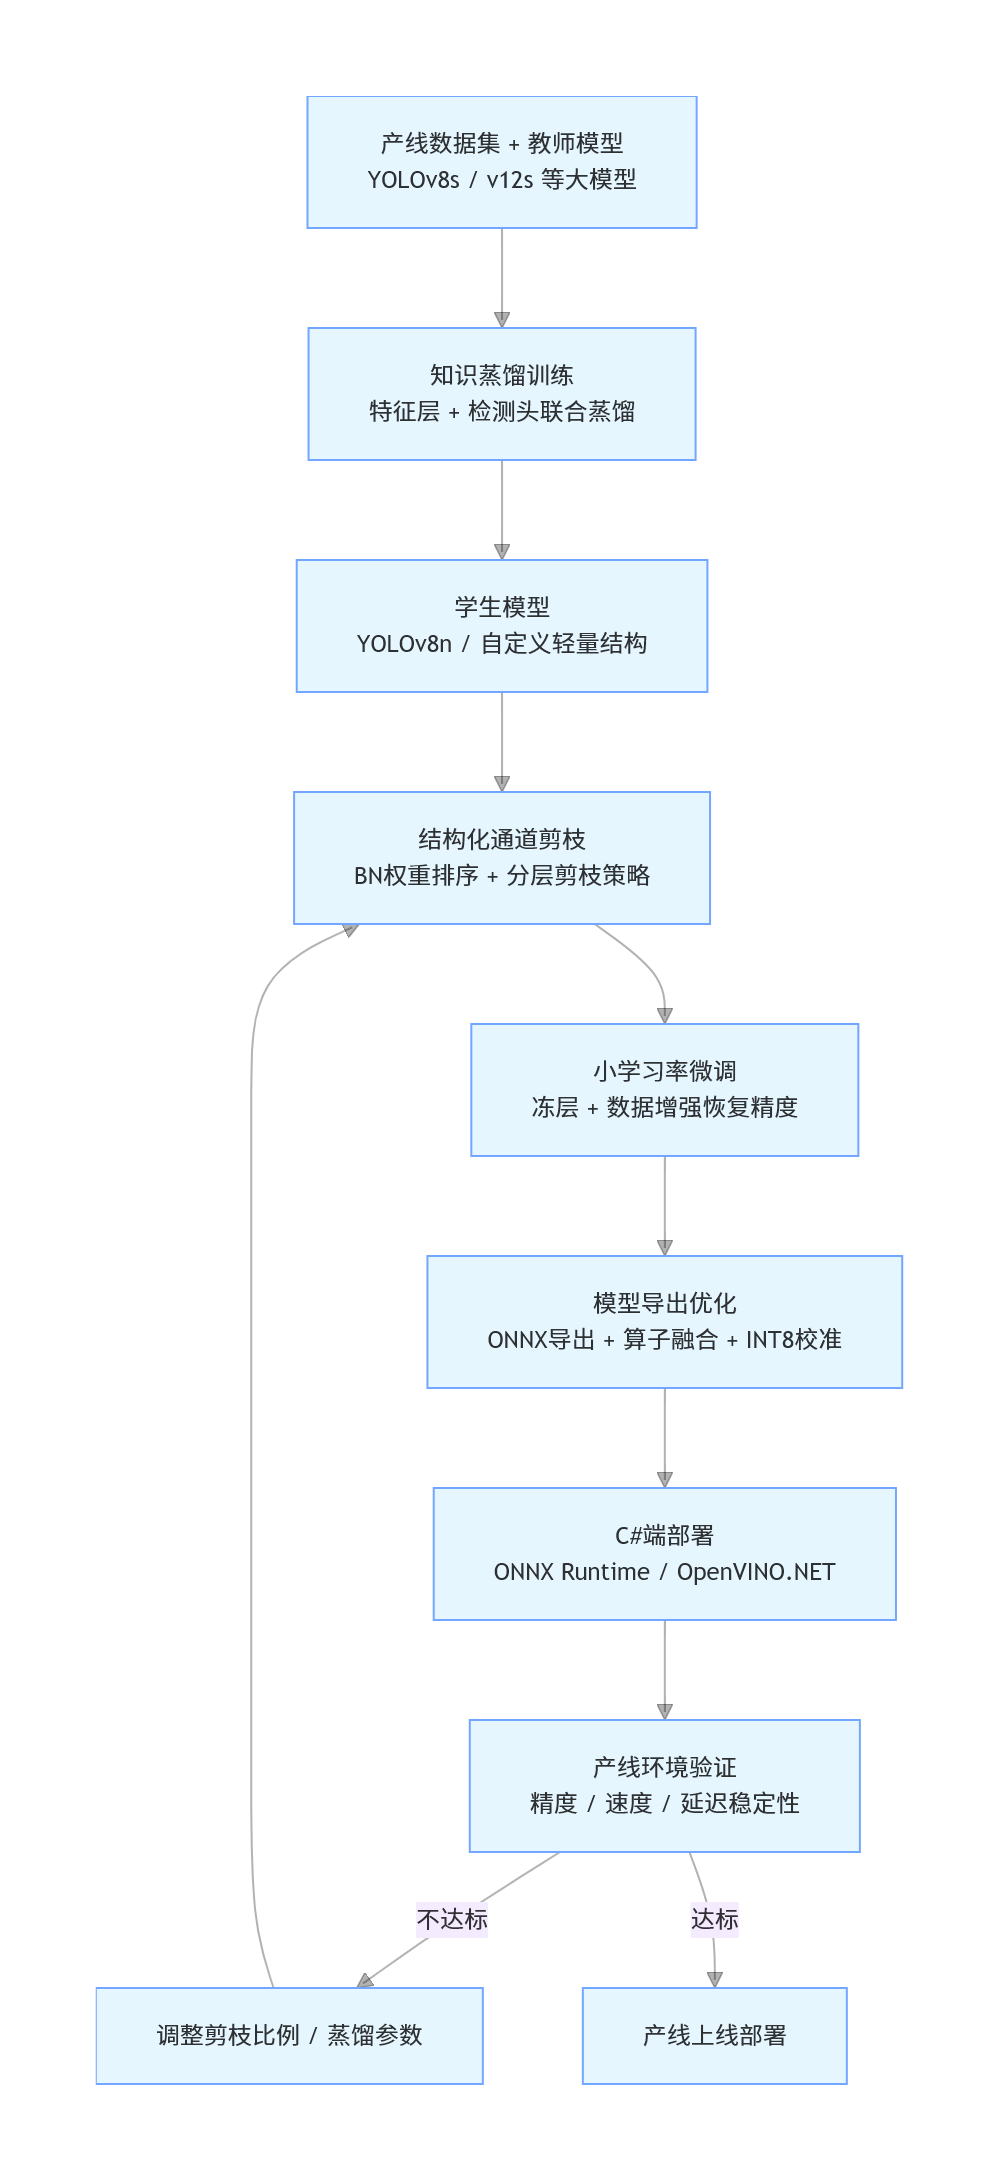
先说教师模型选择,不是越大越好,一般选比学生模型大两个量级就够了。比如学生用v8n,教师用v8s或者v12s就足够,用v12x去教v8n不仅训练慢,蒸馏收益还很低。蒸馏策略上,工业检测场景不要只蒸馏分类头,要同时蒸馏检测头的回归分支和中间特征图,也就是特征蒸馏,这对小目标和缺陷检测的提升更明显。还有一点非常重要,所有精度验证必须和C#端使用完全一致的预处理、推理引擎和后处理逻辑,PyTorch的算子实现和ONNX Runtime有差异,直接用Python的精度指标做参考,到部署端很容易翻车。
然后是结构化剪枝的策略,这一步最容易出问题。很多人就是拿工具一键剪,结果精度崩了。工业场景的剪枝一定要有分层策略,不是所有层都能剪。输入输出层绝对不能剪,通道数和任务强相关,剪了直接崩。下采样层要少剪,它负责提取低维特征,剪多了小目标特征直接丢失。主干网络的普通卷积层冗余度最高,可以多剪,颈部的特征融合层冗余度低,要少剪。剪枝比例要循序渐进,先剪20%测精度,没问题再剪30%、40%,不要一下剪50%。剪完之后必须微调,哪怕只剪10%,也要用小学习率微调10到20轮恢复精度,直接用剪枝后的模型推理,精度一定会掉。
不同场景的剪枝比例也不一样。高节拍、低精度要求的物流分拣,可以剪30%到40%;普通工业零件检测,剪20%到30%;高精度缺陷检测,剪10%到20%,或者只做蒸馏不剪枝。
接下来是模型导出,这是最容易踩坑的一步。很多人剪枝完导出ONNX,到C#里跑不起来,或者速度根本没提升。导出前必须做算子融合,把Conv+BN+激活函数融合成一个算子,这是速度提升最大的优化,没有之一。然后要移除训练专用的算子,比如Dropout。ONNX的opset版本优先选17到19,C#的ONNX Runtime支持最好,不要用太新的opset,很多算子还不支持。
结构化剪枝最大的优势就在这里:剪枝后的模型和原生模型的加载、推理、后处理代码完全不用改,C#端可以无缝迁移。
using Microsoft.ML.OnnxRuntime;
using Microsoft.ML.OnnxRuntime.Tensors;
public class YoloLightInference : IDisposable
{
private readonly InferenceSession _session;
private readonly int _inputWidth = 640;
private readonly int _inputHeight = 640;
public YoloLightInference(string modelPath, bool useGpu = false)
{
var options = new SessionOptions();
if (useGpu)
{
options.AppendExecutionProvider_CUDA();
}
else
{
options.AppendExecutionProvider_CPU();
options.IntraOpNumThreads = Environment.ProcessorCount;
options.InterOpNumThreads = 2;
options.OptimizationLevel = GraphOptimizationLevel.ORT_ENABLE_ALL;
}
_session = new InferenceSession(modelPath, options);
}
public DetectionResult[] Inference(byte[] imageData)
{
var inputTensor = Preprocess(imageData);
using var results = _session.Run(new List<NamedOnnxValue>
{
NamedOnnxValue.CreateFromTensor("images", inputTensor)
});
return PostProcess(results.First().AsTensor<float>());
}
}
模型部署到C#端之后,还可以做二次优化。首先是INT8量化,工业场景优先静态量化,用自己的产线数据做校准,精度损失更小,CPU端INT8推理通常能再提速30%到50%,内存占用减半。然后是输入尺寸优化,很多人默认640×640,其实工业场景目标大的话,416×416甚至320×320就足够,速度能再翻一倍。还有后处理优化,剪枝后的模型输出候选框更少,可以针对性减少NMS的候选框数量,进一步降低延迟。
给一个实测数据参考,硬件是i5-10代CPU,用ONNX Runtime,640×640输入:原生YOLOv8n大约210毫秒;蒸馏加30%剪枝之后大约110毫秒,精度损失不到1%;再加INT8量化,大约65毫秒,精度损失不到1.5%。这个提升幅度,在不换硬件的前提下,已经能满足大部分产线的节拍要求了。
落地过程中踩过的坑,每一个都是真金白银
第一个坑,不要迷信剪枝比例,速度提升才是硬道理。很多人追求剪枝50%、60%,但实际推理速度的提升和剪枝比例不是线性的。剪枝30%可能速度提升40%,剪枝50%可能速度只提升50%,但精度掉一大截。工业场景优先保证精度,再追求速度,不要为了剪枝而剪枝。
第二个坑,蒸馏温度参数在小目标场景要调低。很多人照搬通用设置T=10,工业小目标、缺陷检测场景,温度太高会把小目标的特征抹平,漏检率飙升。建议从T=4开始调,根据召回率逐步调整。
第三个坑,所有精度验证必须以C#部署环境为准。Python里PyTorch测出来的精度,和C#里ONNX Runtime测出来的,经常差1到2个点,因为算子实现、浮点精度、预处理都不一样。不要拿Python的精度当最终指标,产线认的是部署端的结果。
第四个坑,不要剪检测头,不要剪下采样层。这是新手最容易犯的错误。检测头的通道和类别、检测头结构强相关,剪了直接崩;下采样层负责提取低维特征,剪多了小目标直接没了。主干的普通卷积层是冗余度最高的,优先剪这里。
第五个坑,INT8量化一定要用自己的数据集校准。用COCO数据集校准的量化模型,到工业场景里精度会崩。一定要用自己产线的100到200张图片做校准,覆盖不同光照、不同角度、不同缺陷类型。
第六个坑,工业场景优先CPU优化,不要盲目上GPU。很多人觉得GPU快,但工业工控机加GPU成本高、功耗高、稳定性差,很多场景还不允许。通过蒸馏加剪枝加INT8量化,CPU就能跑到30FPS以上,完全满足大部分产线需求。
第七个坑,延迟稳定性比平均速度更重要。产线最怕的不是平均慢,而是偶尔卡一下。剪枝和量化之后,模型的算子更简单,延迟抖动会更小,这对工业场景来说,比平均速度快几毫秒更重要。
最后一个坑,存量项目不要盲目轻量化。如果现有模型已经能满足节拍和精度要求,不要为了技术优化而去剪枝蒸馏。工业项目的第一原则是稳定,轻量化带来的收益,往往抵不上测试和验证的成本。
很多人觉得模型轻量化是算法工程师的事,和C#开发者没关系。但真正做过工业落地的人都知道,部署端才是检验轻量化效果的唯一标准。对C#开发者来说,做轻量化不需要从头写训练代码,核心是理解背后的原理,知道什么场景用什么方案,能把训练好的模型适配到C#环境,能在产线里验证效果,能解决实际的性能问题。比起追最新的模型和算法,更重要的是结合工业场景的需求,在精度、速度、稳定性之间找到最佳的平衡点。