目录
一、重新定义 AI 评测:它不是跑分工具,而是决策基础设施
(一)从“上线前验收”转向“持续控制回路”
1. 为什么传统评测思维正在失效
1.1 概率性打破“一次验收”的假设
1.2 系统性打破“只看模型”的假设
2. 评测的真正交付物不是分数,而是“下一步动作”
(二)把评测理解成“测量科学”而不只是“测试工程”
1. AI评测首先是构念测量问题
2. 三类误差必须被分开
(三)评测的三个层级:测能力、做决策、驱动进化
1. 第一层:描述性评测——系统现在表现怎样
2. 第二层:决策性评测——这次改动应不应该上线
3. 第三层:进化性评测——失败能否自动成为下一轮能力
二、先确定被测对象:模型、产品、Agent、流程完全不是一回事
(一)被测对象决定评测方法,而不是反过来
1. 基础模型:主要测“能不能”
2. AI产品能力:主要测“哪个环节出了问题”
3. Agent:主要测“结果是否真实、过程是否可靠”
4. Skill与业务流程:主要测“有没有增量价值”
(二)不要把边界画在“模型”,要画在 Harness
1. 为什么 Harness 是真实被测对象的一部分
2. 一个实用的边界清单
(三)长链路任务必须把“检查点与回滚”纳入评测边界
1. 单步高准确率不等于系统可靠
2. 评测要验证“系统如何失败”,而不仅是“有没有失败”
三、把十个能力维度重组为六层控制面:企业评测体系如何搭起来
(一)为什么需要从“指标清单”升级为“系统架构”
(二)第一层:边界与决策面——定义“测什么”和“为什么测”
(三)第二层:数据与判分面——决定“现实如何进入评测”
1. SET 决定你看见哪一块现实
2. JDG 决定这块现实如何被解释
(四)第三层:指标与统计面——把“现象”变成可信结论
(五)第四层:归因与行动面——把 Bad Case 变成修复队列
(六)第五层:门禁与工程面——让评测真正有“牙齿”
(七)第六层:元评测与治理面——回答“凭什么信”
四、指标设计的核心不是公式,而是业务代价与操作点
(一)不要默认用 F1:先问“漏一个”和“错报一个”谁更贵
指标是业务代价函数的代理变量
1. 先把错误翻译成业务损失
2. 用“约束 + 优化目标”替代万能综合分
(二)单一阈值下的指标不能代表模型本身
1. 能力与操作点必须分离
2. 冻结 Prompt 不等于跨模型公平
(三)Precision 为什么会随线上分布“塌陷”
1. 平衡集适合看区分能力,不适合估算线上负担
2. 建议同时维护三种分布视图
(四)任何指标都应该有“下降时看什么”的诊断语义
五、统计可信性:一次跑分只是轶事,不是证据
(一)概率系统必须多次运行
1. 为什么 pass@1 不足以表达 Agent 稳定性
2. 不要把 pass@k 和可靠性混为一谈
(二)必须报告区间,不要只报单点
(三)版本比较要用“配对差异”,而不是两份平均分
(四)多重比较会制造“总有一个显著”的假象
(五)Flaky 用例不能简单删除
六、判分体系:规则、执行验证、LLM Judge 与人工如何组合
(一)最重要的原则:能用确定性规则,就不要让 LLM 当裁判
(二)Judge 应该判“原子失败模式”,不要一口气打综合分
1. 原子二分类比 1~10 分更容易校准
2. Uncertain 不是软弱,而是降低噪声的机制
(三)开放式任务优先做相对判断,而不是绝对打分
“谁更好”通常比“值几分”更稳定
(四)Judge 上线前必须经过校准
(五)多 Judge 的价值是暴露分歧,不是简单求平均
七、Agent评测:必须同时看 Output、Outcome 与 Process
(一)只看回复,会奖励“说得对但没做成”
Output 与 Outcome 的分离是 Agent 时代的分水岭
1. 用真实状态变化定义任务是否成功
2. 把语言质量与任务完成拆成两层
(二)只看 Outcome,又会奖励“蒙对”
(三)Process 不应要求“唯一思路”,而应约束不变量
(四)工具调用至少拆成五个环节
(五)Agent Eval 应把成本和延迟作为一等公民
八、测试集工程:代表性、难度、污染与持续生长
(一)不要等“大而全”,先从真实失败开始
20~50 条真实 Bad Case 的价值往往高于几千条合成题
(二)难度要有区分度,不要把低分难题轻易删掉
50%~70% 通过率区间往往最有迭代信息
(三)必须同时有正例与反例
单边测试会把系统训练成极端策略
(四)给测试集设置三道自检:Oracle、Dummy、人工复核
1. Oracle 与 Dummy:先校验量尺两端
2. 人工复核:判断失败究竟属于题目、环境还是能力
(五)数据污染会让系统“提前看答案”
(六)测试集应该像产品一样持续生长
最有价值的 Eval 数据来自生产新失败
九、从坏分数到可行动归因:评测如何真正驱动优化
(一)归因第一步不是怪模型,而是排除“非能力失败”
(二)级联失败只归因第一个出错环节
(三)建立“失败模式 → 根因 → 修复手段”的映射表
(四)总分之外必须切片
1. 平均值最擅长掩盖局部灾难
2. 对高风险长尾采用“风险加权关注”,而非简单样本加权
(五)归因报告必须带 Owner 与验收标准
十、门禁与 EvalOps:把评测嵌入研发、发布和生产
(一)门禁必须分级,否则不是太烦就是没用
(二)平均分之外必须有“等级约束规则”
(三)阈值与验证方法必须成对出现
“幻觉率 <5%”如果不说明怎么测,就不是门禁
(四)EvalOps 的目标是“任何结论都能重放”
1. run 与 score 必须分离
1.1 Run 层保存可重放证据
1.2 Score 层允许判分口径独立演进
2. 最容易漏的是 Context 与环境版本
(五)人工抽检不应随机平均撒,而应投向“信息量最高的分歧样本”
(六)失败回流让门禁产生复利
十一、元评测:谁来评评测系统本身
(一)为什么“评测系统自己也会错”必须成为一等公民
(二)元评测至少检查四类可信度
1. 数据可信度
2. 裁判可信度
3. 统计可信度
4. 外部效度
(三)元评测的交付物应该是“分数的质量说明”
1. 从“82分”升级为“82分,高可信度”
1.1 先报告结果,再报告结果的质量
1.2 可信度决定分数能支持哪一类决策
(四)校准不是一次性动作,而是持续治理
十二、从零到可用:90天建立企业级“最小可信评测闭环”
(一)0~30天:不要追求平台化,先建立基线
(二)31~60天:建立可信度,而不是扩数量
(三)61~90天:把评测接入发布流程
(四)90天以后:平台化的顺序应该是“可信度 → 自动化 → 规模化”
十三、进一步推论:未来的AI工程会越来越接近“面向评测的开发”
(一)从 TDD 到 Eval-Driven Development
(二)评测会成为 AI 产品的“可执行规格说明书”
(三)模型选择会从“排行榜导向”转向“系统匹配度导向”
(四)元评测将成为高风险AI治理的核心能力
(五)最强的评测体系不是“测得最多”,而是“错误最难悄悄溜过去”
十四、结语:把评测建成“组织记忆”,AI应用才有复利
(一)每一次失败都应该变成未来的资产
(二)一个可落地的最终定义
可参考文章与资料
干货分享,感谢您的阅读!
过去两年,AI 产品的竞争焦点正在从“谁拥有更强的基础模型”转向“谁能更稳定地把模型能力转化为业务结果”。在这个变化中,评测不再是发布前跑一次 Benchmark、得到一个分数,而是决定需求如何被表达、系统如何被拆解、优化是否真的有效、风险是否能够被拦截、迭代是否可以持续累积的核心基础设施。尤其当被测对象从基础模型演进到 RAG、Agent、Skill 与复杂业务流程后,传统“输入—输出—标准答案”的静态评测范式迅速失效:答案可能不唯一,错误可能来自多个环节,Agent 的输出与真实结果可能分离,工具调用存在副作用,长链路中的单步高准确率也会被指数级放大成整体失败。
企业级 AI 评测的目标,不是产生更漂亮的分数,而是建立“可验证、可归因、可决策、可回流”的闭环。 为此,需要同时解决六类问题:被测边界、测试集与判分、指标与统计、归因与修复、门禁与工程、元评测与治理。我们尝试给出一套从模型到 Agent、从离线到线上、从单点指标到可信决策的完整框架,并提供 90 天落地路线,帮助团队把评测真正变成 AI 系统持续进化的控制回路。
一、重新定义 AI 评测:它不是跑分工具,而是决策基础设施
(一)从“上线前验收”转向“持续控制回路”
1. 为什么传统评测思维正在失效
1.1 概率性打破“一次验收”的假设
在传统软件工程中,很多质量问题是确定性的:函数给定输入后应返回确定结果,接口应满足固定 Schema,数据库写入要么成功要么失败。测试的主要任务是确认实现是否符合规格。大模型系统则不同。模型输出天然具有概率性,同一输入在不同采样、不同上下文、不同工具状态下可能给出不同结果;与此同时,系统质量也不只由模型决定,还受到 Prompt、检索、路由、缓存、上下文裁剪、工具编排、权限、重试策略与运行环境影响。
1.2 系统性打破“只看模型”的假设
因此,“模型上线前跑一次分”越来越像是在复杂系统上做一次静态体检:它能给出一个瞬时快照,却无法回答真正重要的问题——这次改动为什么变好?改善来自模型、Prompt 还是脚手架?离线提升会不会在线上消失?某个高分是否只是测试集分布带来的幻觉?一个 Agent 回复“已退款”,但订单状态仍未变化,这到底算成功还是失败?
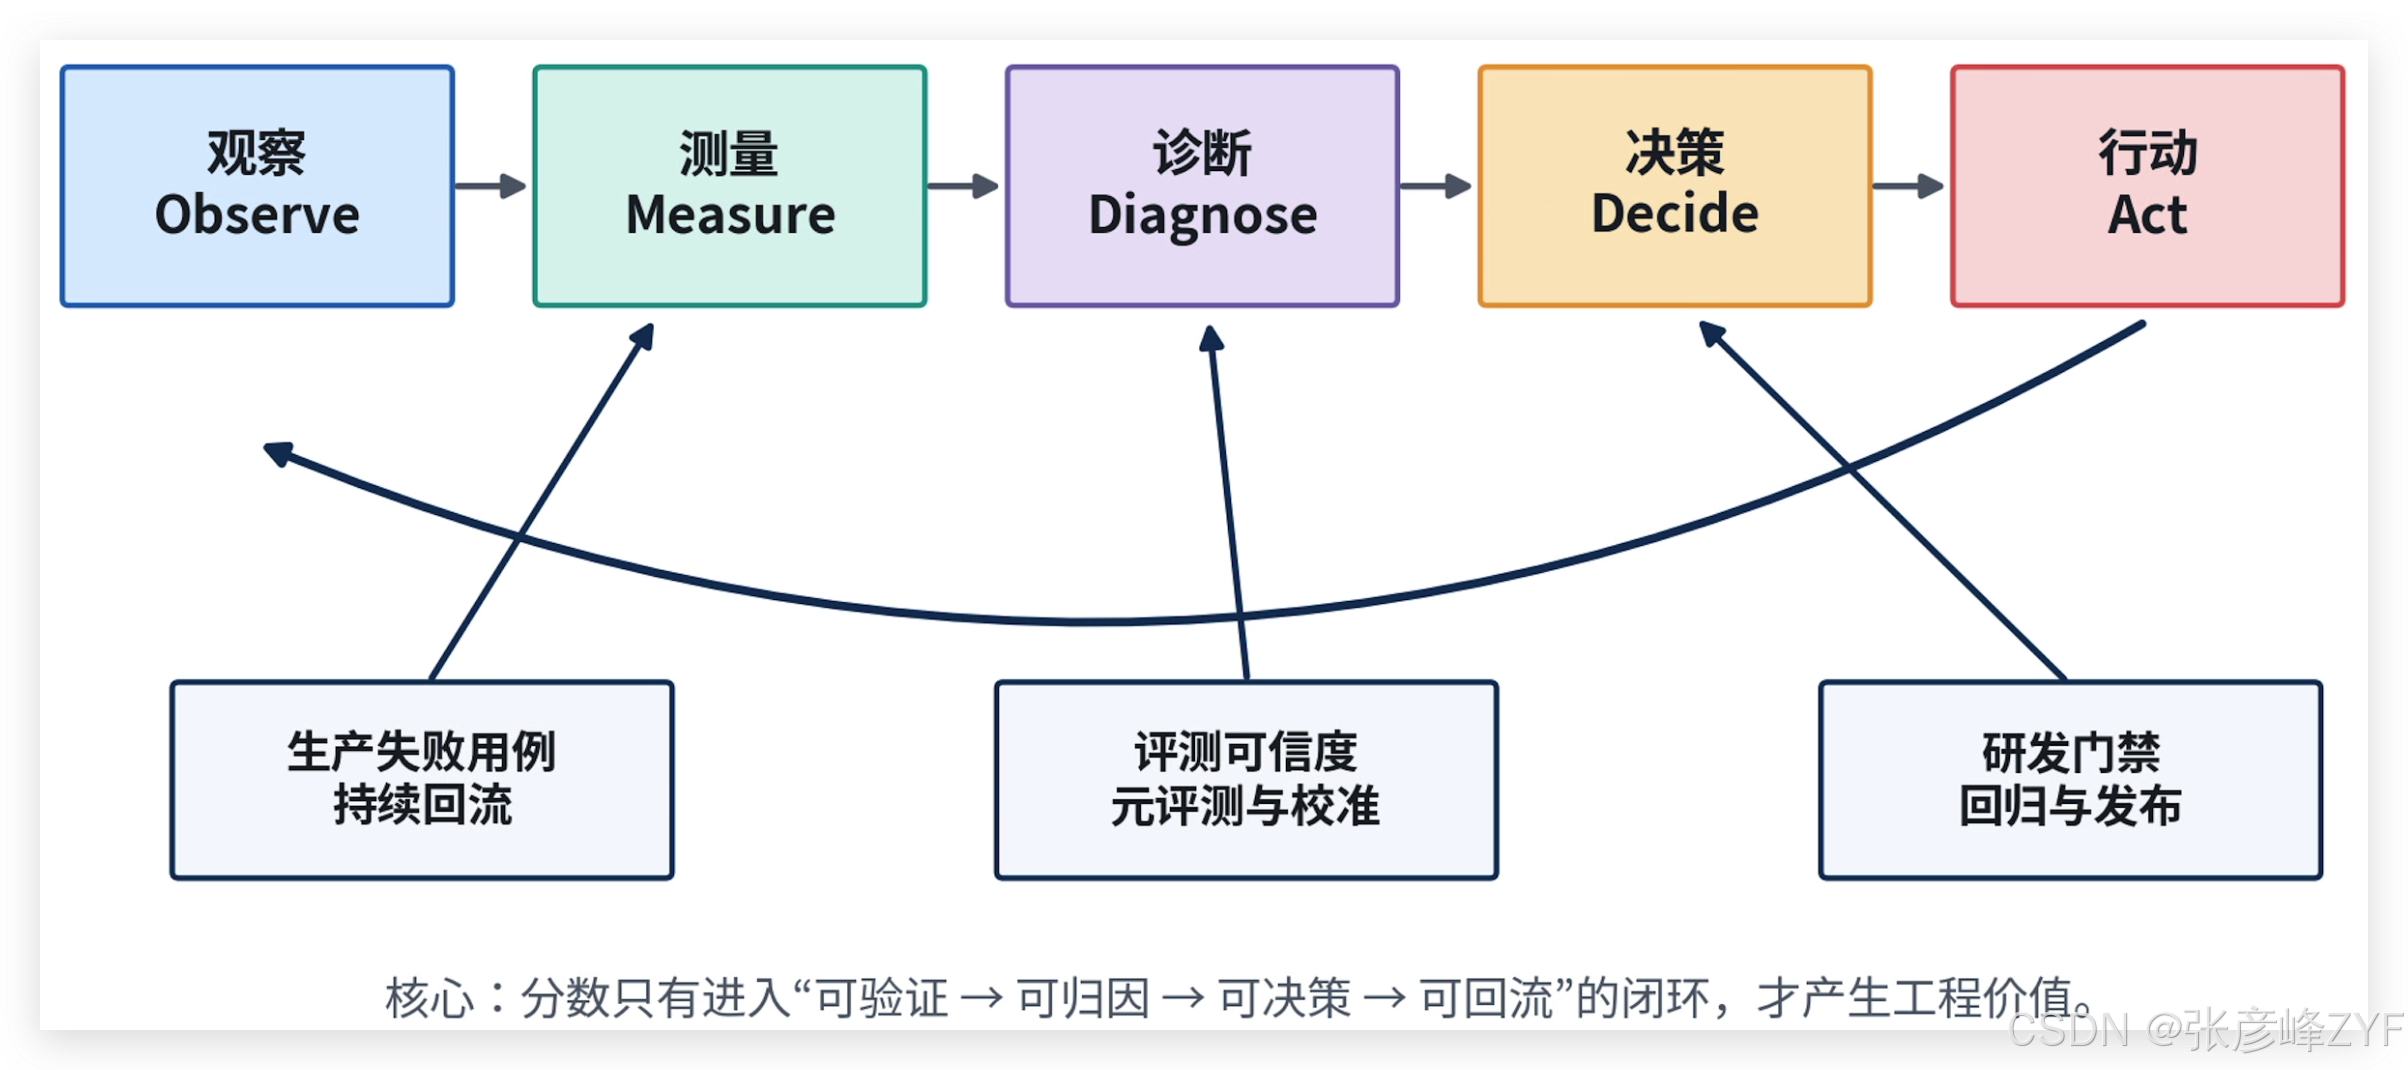
评测只有从“结果记录器”升级为“系统控制器”,这些问题才有解。所谓控制器,是指它持续执行观察、测量、诊断、决策和行动,并把生产失败重新注入测试集,形成闭环。这样,评测就不再是研发流程末端的一次验收,而是从需求定义开始就参与设计,在研发中约束迭代,在发布时执行门禁,在生产中吸收新失败。
2. 评测的真正交付物不是分数,而是“下一步动作”
一个 82 分的模型,单独看几乎没有决策意义。它至少还缺少四个上下文:第一,这个分数代表什么业务能力;第二,它在什么测试分布、运行协议与判分口径下得到;第三,相比旧版本的差异是否显著且稳定;第四,如果它下降,应该由谁去改什么。
因此,一个成熟评测结果的最小表达不应是“v2 = 82.4”,而应类似于:
在真实比例测试集上,v2 的核心任务完成率为 82.4%(95% CI:79.1%~85.4%),相对 v1 提升 4.8 个百分点;配对差异区间不跨 0。主要增益来自“跨文档证据整合”,但“工具超时后的恢复”下降 6.2 个百分点,触发黄灯。建议由 Agent Platform Owner 在下一版本中增加超时分类与幂等重试,验收标准为该切片恢复到 90% 以上且 P95 延迟不增加超过 8%。
这段话里,分数只是证据之一。真正驱动决策的是差异、区间、切片、风险、根因、Owner 和验收标准。换言之,评测的终点不是“知道表现如何”,而是“知道该不该发、该改哪里、怎么证明改好了”。
(二)把评测理解成“测量科学”而不只是“测试工程”
1. AI评测首先是构念测量问题
现实世界里,“好回答”“可靠 Agent”“有用的 Skill”“安全的业务助手”都不是可以直接读取的物理量,它们是抽象构念。评测做的事情,是用可观察信号去逼近这些构念。例如,用 Recall 近似“漏判能力”,用 Outcome 成功率近似“真实任务完成”,用专家偏好近似“交付质量”,用风险灯号近似“不可接受的失控行为”。
这意味着评测天然存在测量误差。如果一个指标很稳定,但测错了对象,它仍然没有价值;如果一个裁判高度一致,但总是在偏袒更长的答案,它只是“稳定地错”;如果一个测试集覆盖了大量样本,却没有覆盖生产中真正昂贵的失败,它只是“样本很多但现实很少”。
从这个角度看,企业评测的第一原则不是“多指标”,而是构念效度:我们声称在测什么?这个指标真的代表它吗?如果分数变化,是否可以合理解释为目标能力变化?NIST 的生成式 AI 风险框架也强调对测量过程本身进行评估,并关注指标是否真正操作化了目标概念。这说明“评测评测本身”不是学术洁癖,而是工程可信度的核心。
2. 三类误差必须被分开
评测结果中的噪声至少来自三层:
-
对象噪声:模型或 Agent 自身随机性导致同一任务多次运行结果不同;
-
测量噪声:Judge、规则、测试环境或人工标注不一致;
-
抽样噪声:测试集样本太少或分布偏离线上,导致结论不能外推。
如果不把三类噪声区分开,团队会把“Judge 不稳定”误判成“模型不稳定”,把“测试集正类比例变化”误判成“模型 Precision 退化”,甚至把“环境故障”误判成“Agent 能力失败”。于是研发开始对着错误的方向优化,越努力越偏。
(三)评测的三个层级:测能力、做决策、驱动进化
1. 第一层:描述性评测——系统现在表现怎样
这类评测输出通过率、准确率、偏好胜率、延迟、成本等指标,适合回答“当前水位如何”。它必要,但远远不够。
2. 第二层:决策性评测——这次改动应不应该上线
这一层要求引入基线、置信区间、配对比较、风险阈值和门禁规则。它回答的是“变化是否真实”“是否值得”“是否可接受”。
3. 第三层:进化性评测——失败能否自动成为下一轮能力
最成熟的评测会把生产 Bad Case 自动分类、回流,沉淀为长期回归资产;同时把根因映射到 Prompt、数据、模型、工具、路由、缓存等可修复对象。此时评测不再是旁观者,而是 AI 系统的“学习回路”。
二、先确定被测对象:模型、产品、Agent、流程完全不是一回事
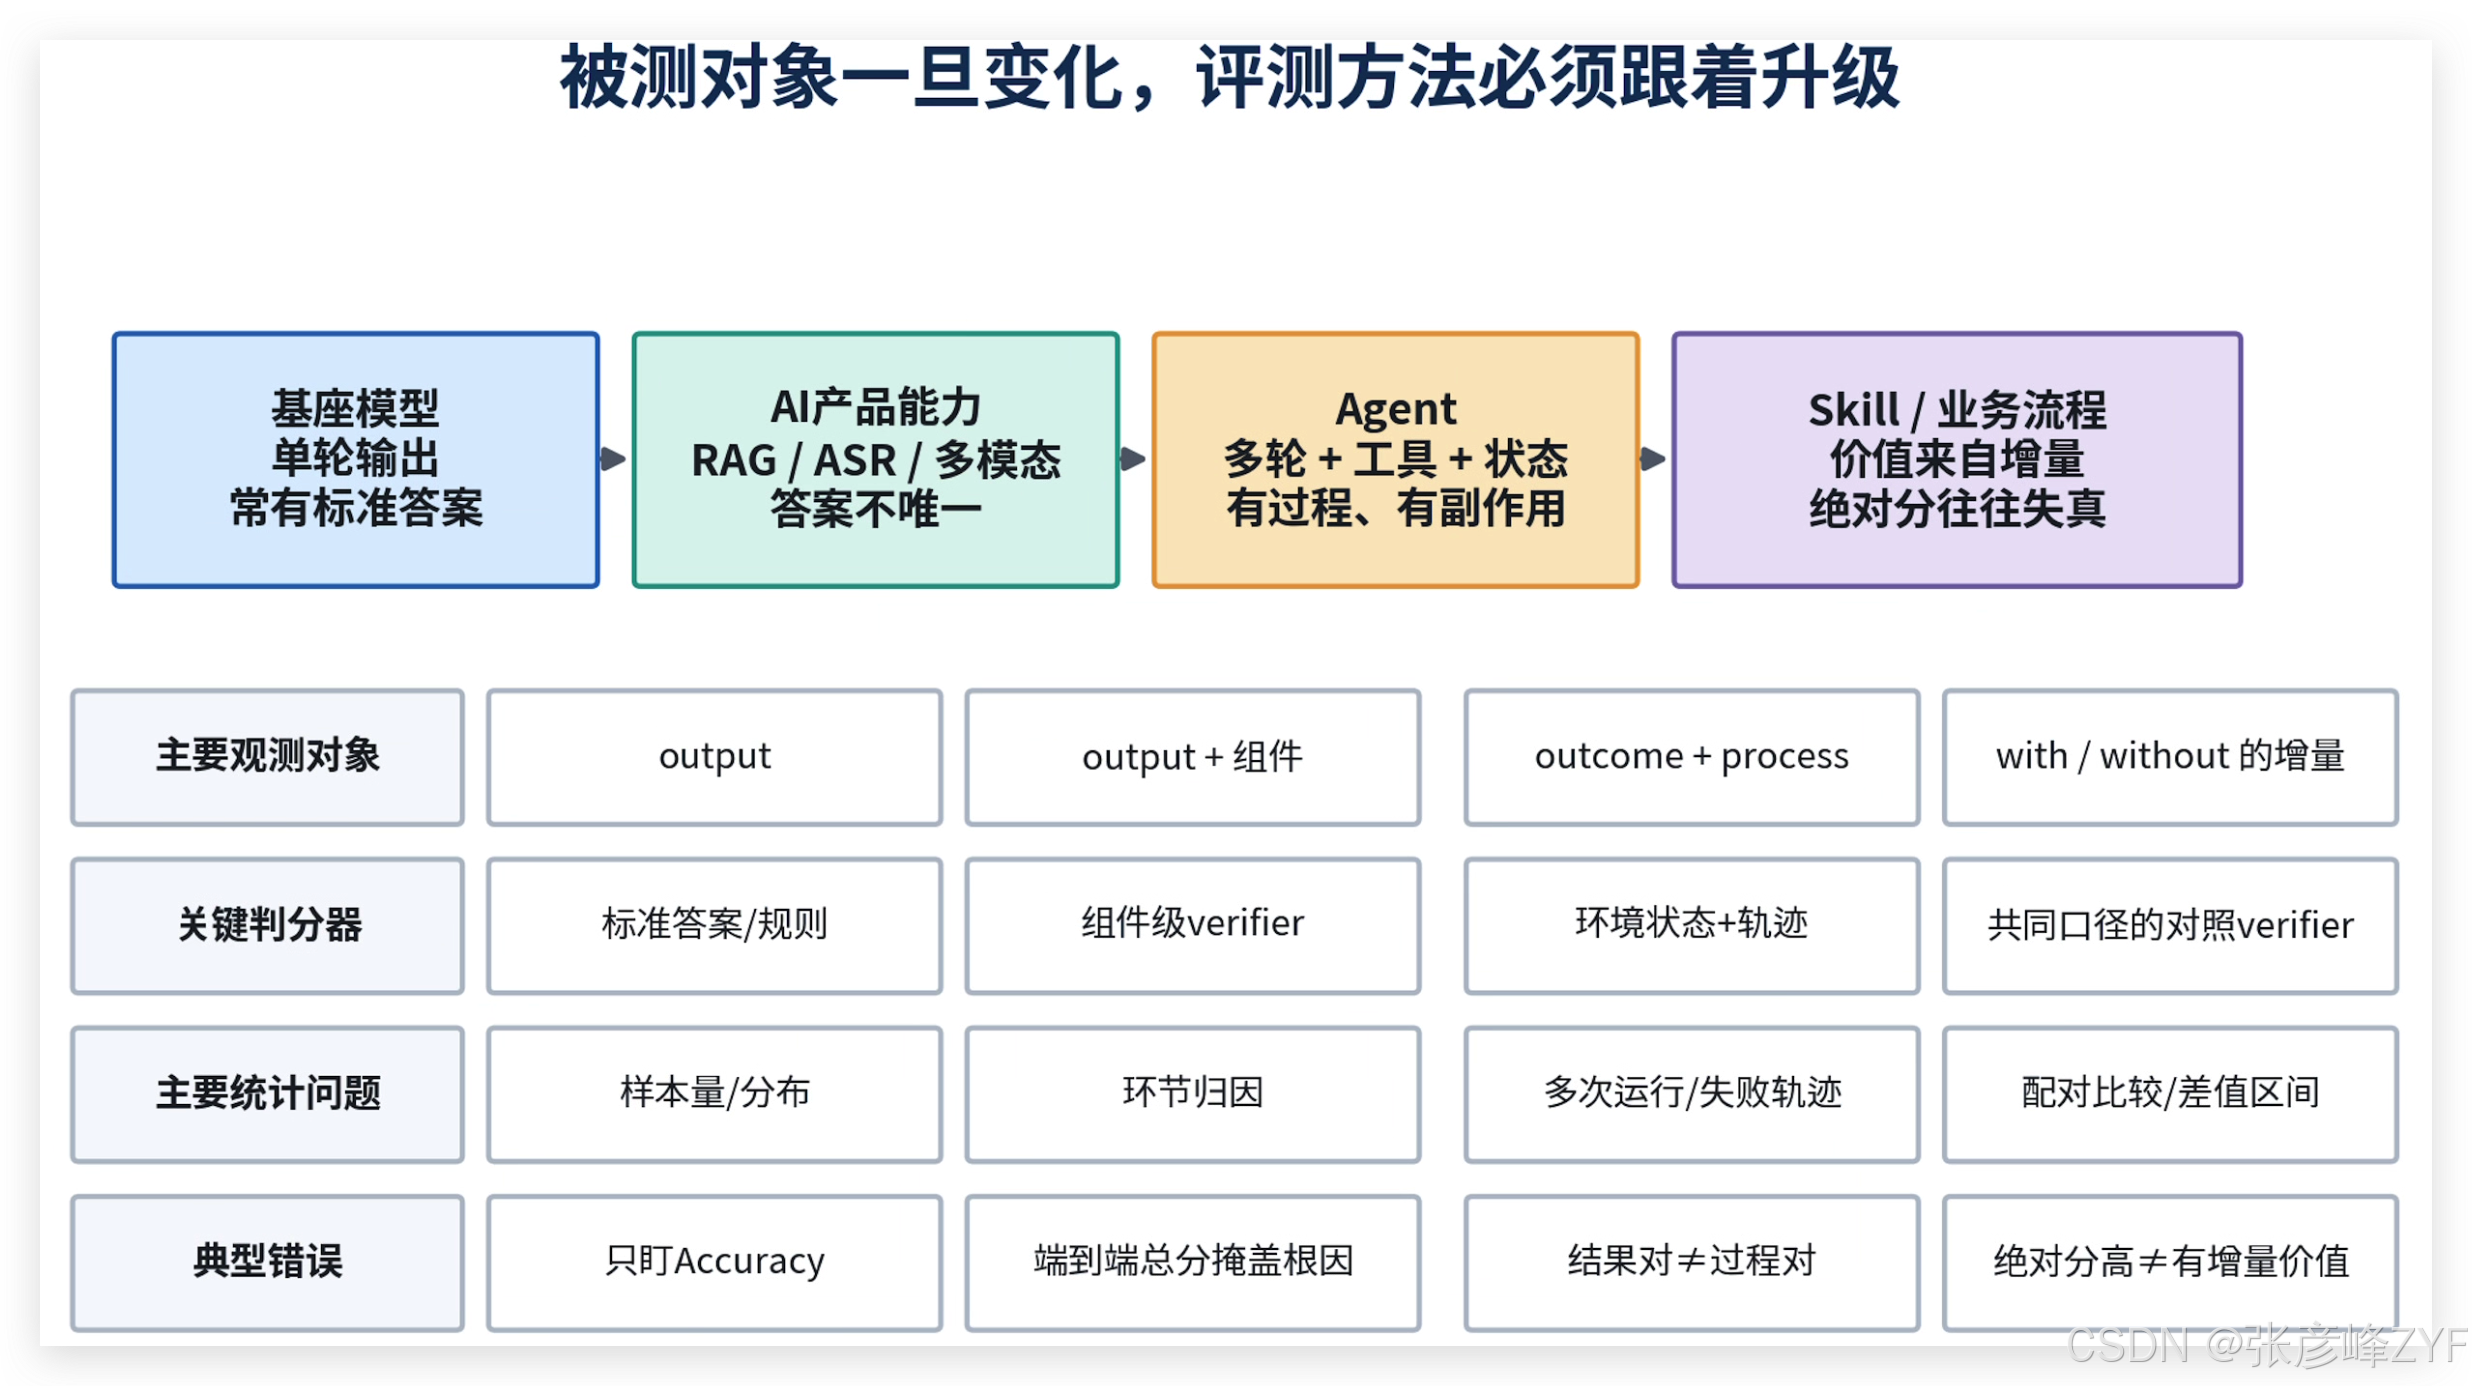
(一)被测对象决定评测方法,而不是反过来
1. 基础模型:主要测“能不能”
基础模型通常面对相对封闭的任务,输入输出边界清晰,很多任务存在标准答案或可执行验证。此时 Benchmark、准确率、pass@k、AUC 等指标有较好解释力。问题主要集中在样本分布、操作点、统计可信度和数据污染。
2. AI产品能力:主要测“哪个环节出了问题”
当系统变成 RAG、ASR、多模态理解或 Text-to-SQL,最终错误可能来自上游多个组件。RAG 回答错误,可能是检索没有找到证据,也可能是找到了但生成阶段忽略证据;Text-to-SQL 失败,可能是 Schema 链接错,也可能是 SQL 生成错,还可能是 SQL 正确但执行环境异常。
如果仍然只看端到端总分,修复方向会混乱。复合能力必须拆成组件指标与端到端指标两层:端到端决定用户是否成功,组件指标决定工程师应该改哪里。
3. Agent:主要测“结果是否真实、过程是否可靠”
Agent 会调工具、写数据库、跨多轮规划,因此评价对象不再只是文本,而是一个具有状态变化的动态系统。此时“回复写得好”与“任务真的完成”可能完全分离;同时,即便结果成功,也可能是靠危险或不可复制的路径偶然蒙对。
4. Skill与业务流程:主要测“有没有增量价值”
一个 Skill 或工作流附加在底座模型之上,绝对分很难说明价值。比如“装 Skill 后通过率 92%”,如果不装 Skill 也有 92%,那么这个 Skill 的业务增量为零。流程类对象因此天然需要 with / without、A/B 或配对对照设计。
(二)不要把边界画在“模型”,要画在 Harness
1. 为什么 Harness 是真实被测对象的一部分
在生产中,用户接触的从来不是“裸模型”。真正决定结果的是模型与系统配置的组合:系统 Prompt、工具集合、上下文构造、检索、记忆、重试、并发、权限、缓存和输出解析都属于真实能力的一部分。公开 Benchmark 也越来越暴露这一点:同一个模型换不同脚手架、上下文管理和工具策略,表现可能显著变化。
因此,企业做版本比较时必须明确:
-
是在比较“裸模型能力”,还是比较“完整系统能力”;
-
Harness 是否固定;
-
如果 Harness 不同,结论应写成“系统A优于系统B”,而不是“模型A优于模型B”;
-
运行预算、工具权限、重试次数、上下文长度是否一致。
这不是表述上的严谨,而是因果归因的前提。把 Harness 省略掉,相当于在汽车测试中只写发动机型号,却不说明变速箱、轮胎、控制系统与路况。
2. 一个实用的边界清单
在任何一次 Eval 立项前,建议强制回答七个问题:
-
决策问题:这次分数最终要支持什么行动——选型、上线、回归、诊断还是资源分配?
-
被测版本:模型、Prompt、工具、索引、代码、配置分别是什么版本?
-
测试任务:样本来自哪里,代表什么场景,哪些场景明确不代表?
-
运行协议:温度、随机种子、重试、并发、Token 预算、工具权限是什么?
-
观察证据:只记录输出,还是包含 Trace、工具调用、环境终态与成本?
-
评价方式:规则、执行验证、Judge、人工如何组合?
-
结果动作:什么结果会触发发布、阻断、人工复核或回流?
如果七个问题有任何一个答不出来,评测很可能只是“有动作但没有工程闭环”。
(三)长链路任务必须把“检查点与回滚”纳入评测边界
1. 单步高准确率不等于系统可靠
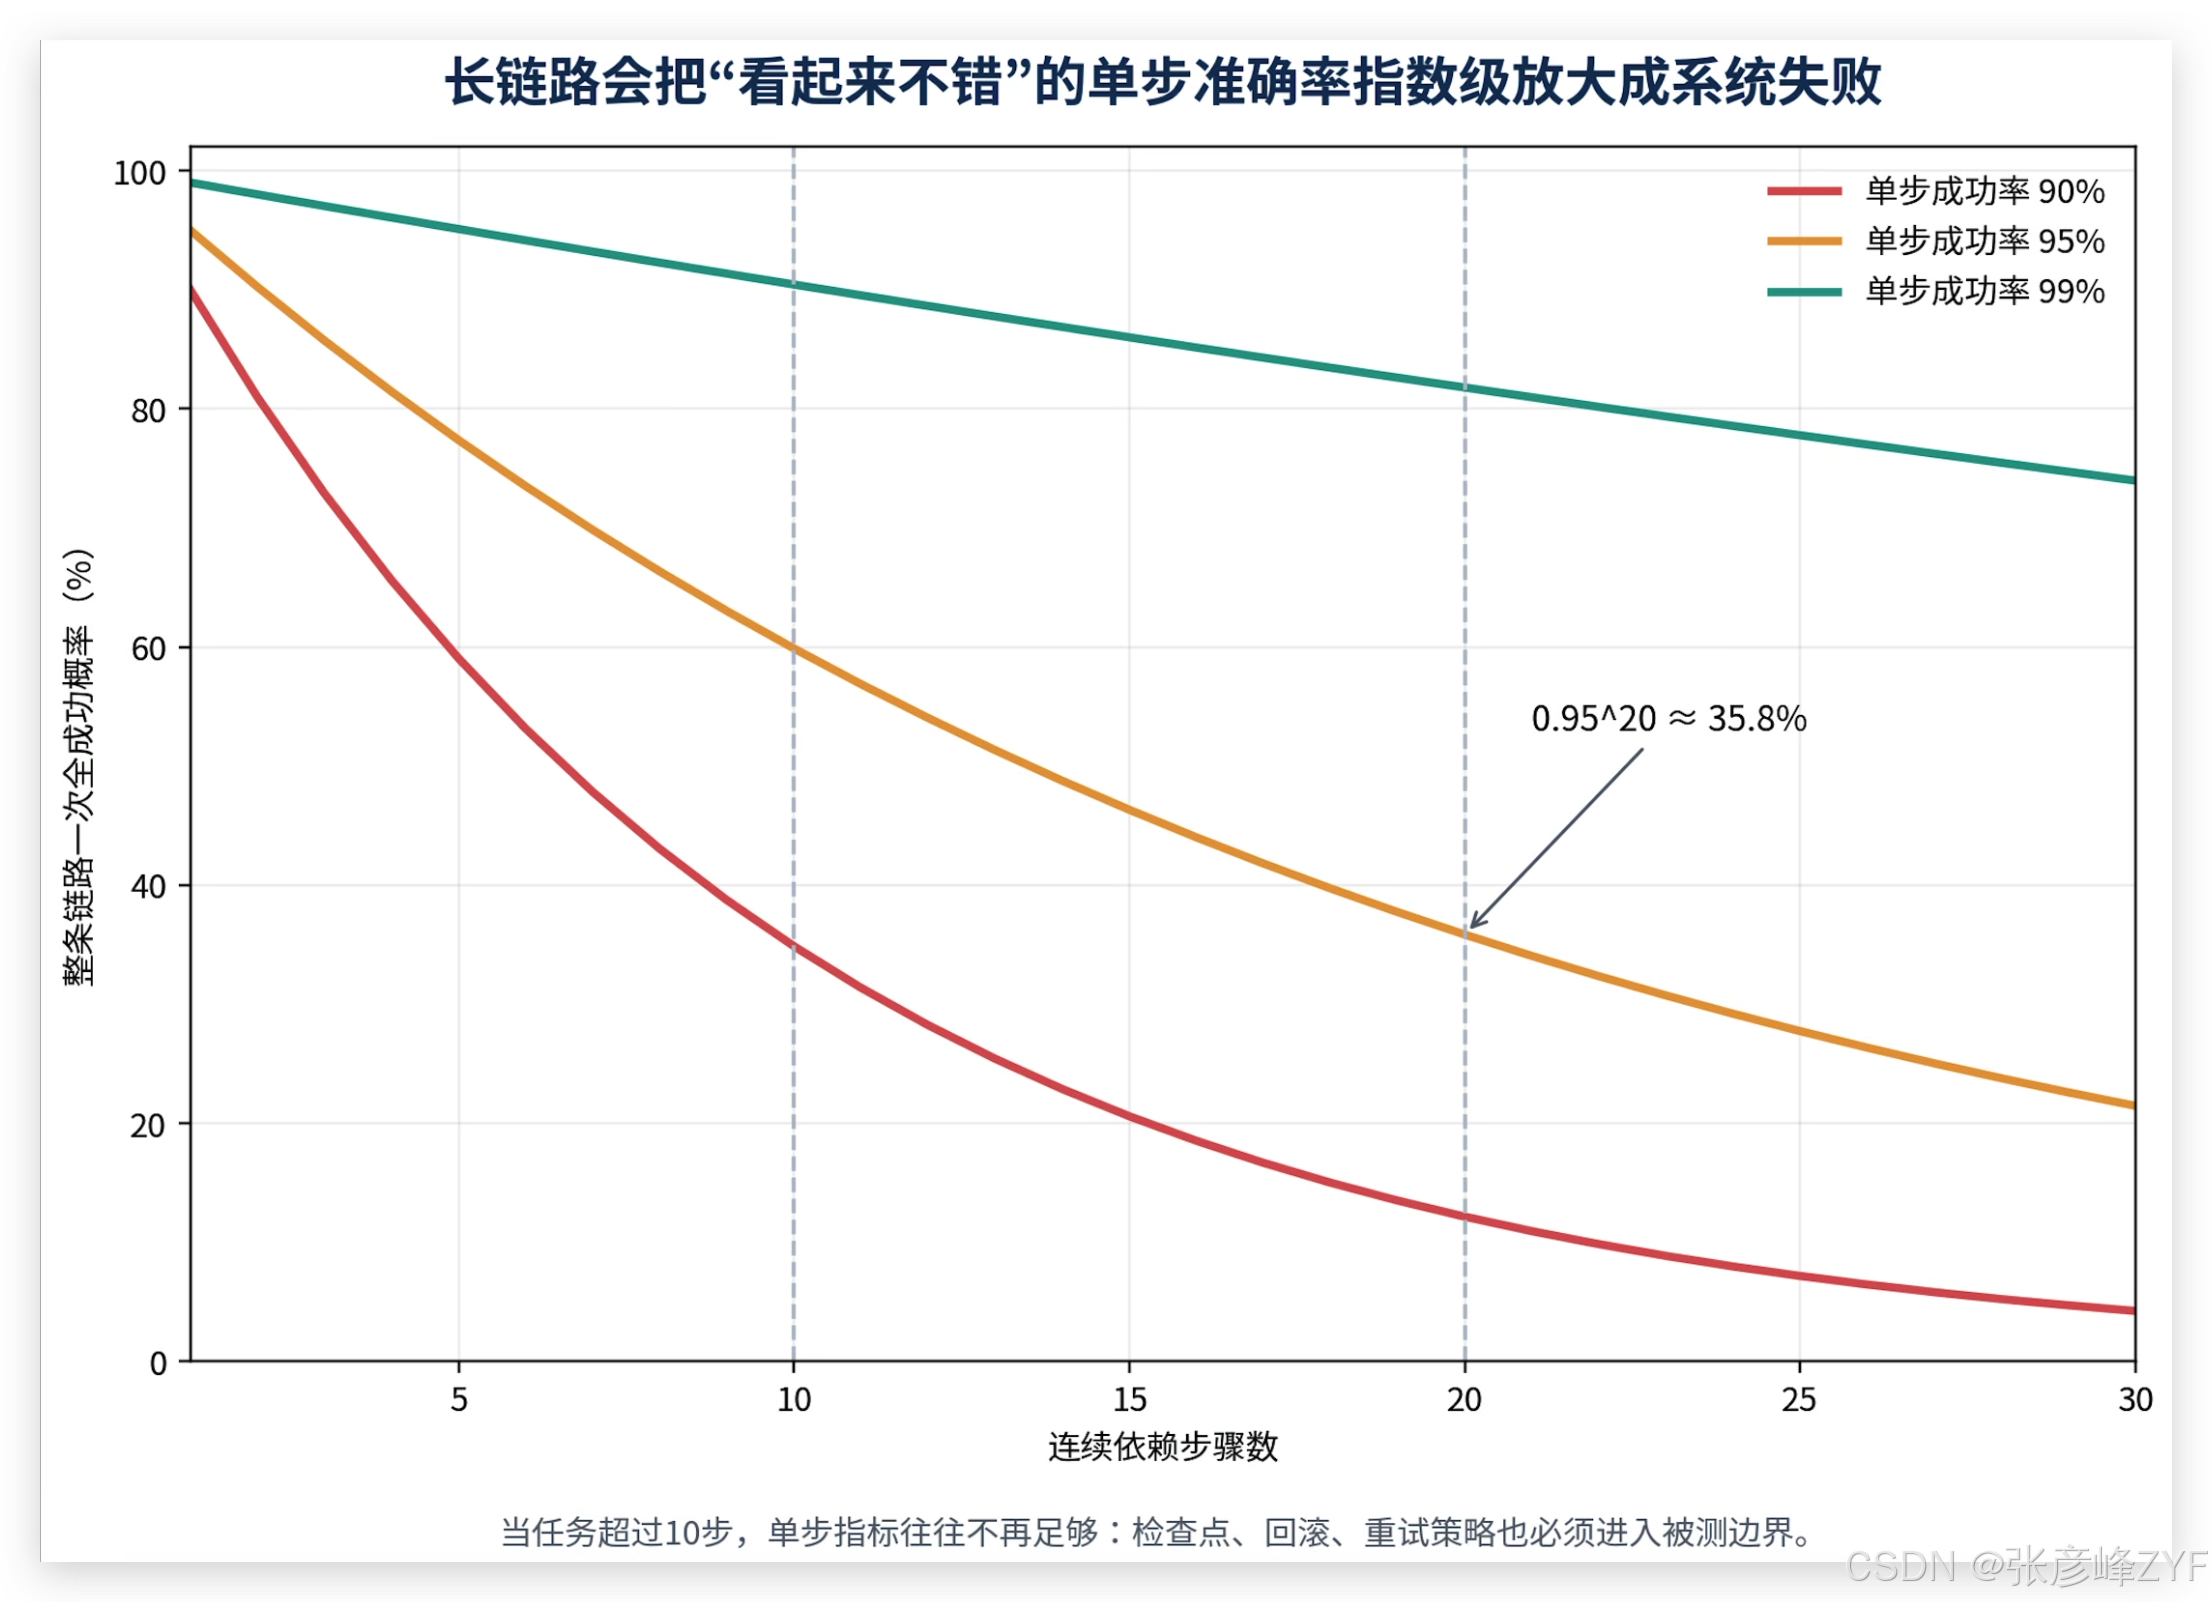
假设一个 20 步任务中,每一步独立成功率都达到 95%,整条链路一次全部成功的概率只有约 35.8%。如果单步成功率为 90%,10 步链路的一次全成功概率约 34.9%。这就是为什么很多团队在组件评测里看到“每一步都挺高”,上线后却发现复杂 Agent 非常脆。
2. 评测要验证“系统如何失败”,而不仅是“有没有失败”
超过一定链路长度后,真正决定可用性的不是把每一步从 95% 再抠到 96%,而是系统是否具备检查点、幂等、回滚、错误分类、超时处理、补偿事务和人工接管。也就是说,容错机制本身必须进入 Eval。
例如,一个付款 Agent 的理想测试不应只是“最终付款成功率”,还要注入接口超时、重复回调、权限失效、余额不足、状态延迟等异常,并确认系统是否:
-
不会在未知结果时向用户声称“已成功”;
-
不会重复扣款;
-
能区分可重试与不可重试错误;
-
在多次失败后进入人工接管;
-
能从 Trace 中还原决策依据。
这时,评测已经从“模型测试”进入“可靠性工程”。
三、把十个能力维度重组为六层控制面:企业评测体系如何搭起来
(一)为什么需要从“指标清单”升级为“系统架构”
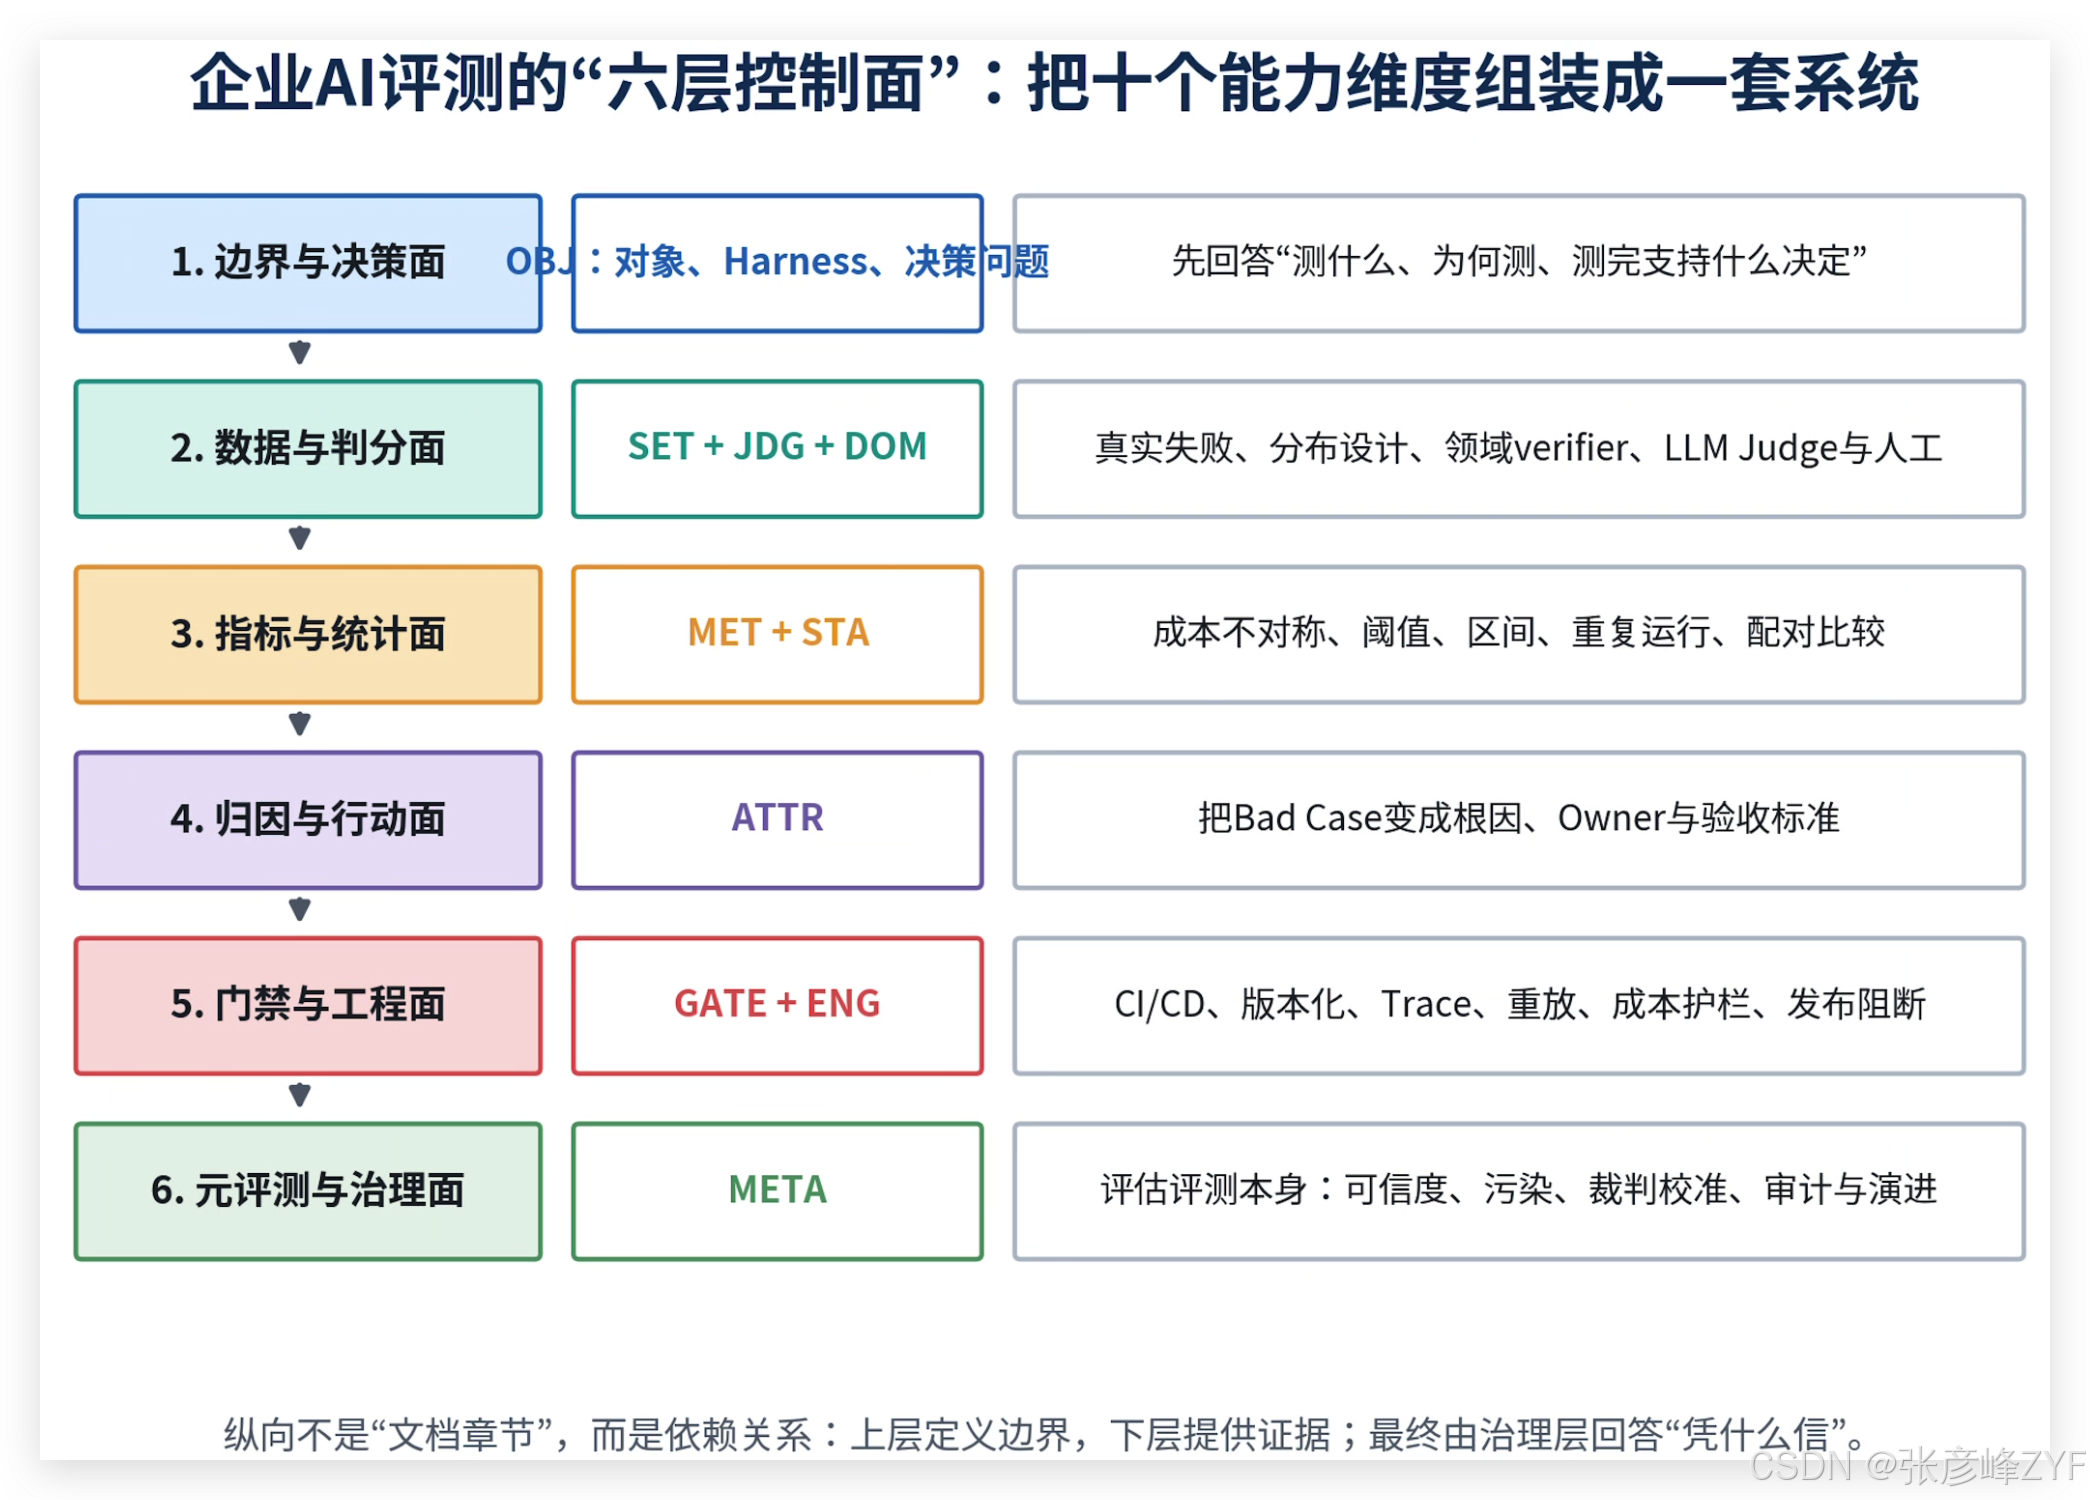
原始材料把企业评测能力拆成 OBJ、SET、JDG、MET、STA、ATTR、GATE、ENG、DOM、META 十个维度。这个拆法的价值在于完整,但真正落地时,如果团队把十个维度做成十份文档、十张表,仍然会出现“每个局部都认真,但系统结论仍然不可信”的问题。
更适合工程落地的方式,是把它们重组为六个控制面:边界与决策、数据与判分、指标与统计、归因与行动、门禁与工程、元评测与治理。六层不是为了减少概念,而是明确依赖关系:上层先定义问题,下层再提供证据,最后由元评测回答“这些证据凭什么可信”。
(二)第一层:边界与决策面——定义“测什么”和“为什么测”
OBJ 的核心不是对象名字,而是决策语义
同一套系统可以有完全不同的 Eval:如果目标是“模型选型”,重点是相对排序;如果目标是“发布门禁”,重点是绝对下限与风险红线;如果目标是“问题诊断”,重点是过程证据和失败模式;如果目标是“能力探索”,重点是难题与上限。
因此,评测立项的第一张表不应是“指标有哪些”,而应是“决策问题—风险—证据—动作”。只有知道这次结果要支撑什么决定,后续的样本、判分和统计才有方向。
(三)第二层:数据与判分面——决定“现实如何进入评测”
1. SET 决定你看见哪一块现实
测试集不是现实本身,而是现实的投影。一个模型在 1:1 平衡集上 90% 准确,并不代表线上 1% 正类比例下也有同样的告警质量;一个 Benchmark 只包含“该调用工具”的正例,可能把 Agent 训练成“什么都调用”;一个客服集只覆盖常见问题,会对罕见但高损失的欺诈、退款、权限场景视而不见。
2. JDG 决定这块现实如何被解释
同一条样本,用严格单测、LLM Judge、人工专家可能得到不同结论。因此判分器必须像模型一样被版本化、校准和审计。尤其是 LLM Judge,一旦 Rubric、模型版本或解析代码变化,历史分数就可能失去可比性。
(四)第三层:指标与统计面——把“现象”变成可信结论
MET 解决业务代价,STA 解决随机性
指标选择回答“哪种错更贵”;统计回答“这次变化是真的还是运气”。二者必须组合。只做 MET,会有漂亮但不稳定的指标;只做 STA,会得到非常精确地测错东西。
(五)第四层:归因与行动面——把 Bad Case 变成修复队列
ATTR 的终点不是标签,而是可执行建议
高质量归因至少要输出根因、证据、影响范围、Owner、优先级和验收标准。如果只输出“幻觉”“工具调用错误”“不相关”,它仍然只是描述,没有进入工程动作。
(六)第五层:门禁与工程面——让评测真正有“牙齿”
GATE 决定什么能发,ENG 决定评测能不能反复跑
门禁要求严重度、阈值、验证方法成对出现;工程化要求 run 与 score 分离、版本可复现、Trace 完整、环境隔离、成本可控。没有 ENG,GATE 的结论不可复现;没有 GATE,ENG 只是更快地产出报告。
(七)第六层:元评测与治理面——回答“凭什么信”
META 是整套体系的可信度保险
META 不评模型,而是评测试集、Judge、指标、统计与流程本身。它检查污染、偏差、稳定性、区分度、外部效度和历史可比性。越到高风险业务,这一层越不能省略。
四、指标设计的核心不是公式,而是业务代价与操作点
(一)不要默认用 F1:先问“漏一个”和“错报一个”谁更贵
指标是业务代价函数的代理变量
1. 先把错误翻译成业务损失
F1 把 Precision 与 Recall 等权合并,隐含一个强假设:漏判与误报代价大致相当。但真实业务很少满足这个条件。
在内容安全场景,漏掉严重违规可能带来合规风险,Recall 可能是硬约束;在代码审查中,误报太多会让工程师逐渐忽略机器人,Precision 直接决定工具是否被采用;在欺诈拦截里,Recall 与误杀损失都很高,通常需要在固定 FPR 或固定人工审核量下优化召回;在客服生成中,“是否完成任务”与“是否捏造事实”甚至不能简单加权,安全项往往需要一票否决。
2. 用“约束 + 优化目标”替代万能综合分
因此更实用的设计是“约束 + 优化目标”:
-
Recall ≥ 95% 的候选中最大化 Precision;
-
安全违规率 = 0 的前提下最大化任务完成率;
-
P95 延迟 ≤ 3 秒的条件下最大化成功率;
-
成本不超过基线 1.2 倍的前提下最大化增量价值。
这比一个综合分更接近真实决策。
(二)单一阈值下的指标不能代表模型本身
1. 能力与操作点必须分离
对于分类、审核、检索和很多 Judge 场景,Precision、Recall、FPR 都取决于阈值。把阈值从 0.7 调到 0.5,Recall 上升并不意味着模型学会了更多,只是操作点发生变化。Prompt 的“严格”“激进”人设也可能扮演类似阈值旋钮:它让模型更愿意判正,从而同时抬高 Recall 与误报。
因此,当团队声称“能力提升”时,应尽量提供阈值无关证据,例如 ROC/AUC、PR 曲线,或在统一业务约束下比较最优操作点。否则,很容易把“策略更激进”误写成“模型更聪明”。
2. 冻结 Prompt 不等于跨模型公平
同一 Prompt 在不同模型上可能触发不同的内部偏置和判断边界。因此“所有模型都用同一 Prompt,所以比较公平”只保证了输入文本相同,却不保证决策阈值相同。跨模型比较更稳妥的方式,是先定义业务约束,例如固定 FPR、固定人工审核量或固定风险下限,再比较各模型在该约束下的可达性能。
(三)Precision 为什么会随线上分布“塌陷”
1. 平衡集适合看区分能力,不适合估算线上负担
假设某模型 Recall=90%、FPR=5%。在正负各半的测试集中,Precision 约为 94.7%;当真实线上正类只有 10% 时,Precision 下降到约 66.7%;正类 1% 时,Precision 只剩约 15.4%。模型本身没有变,变的是基率。
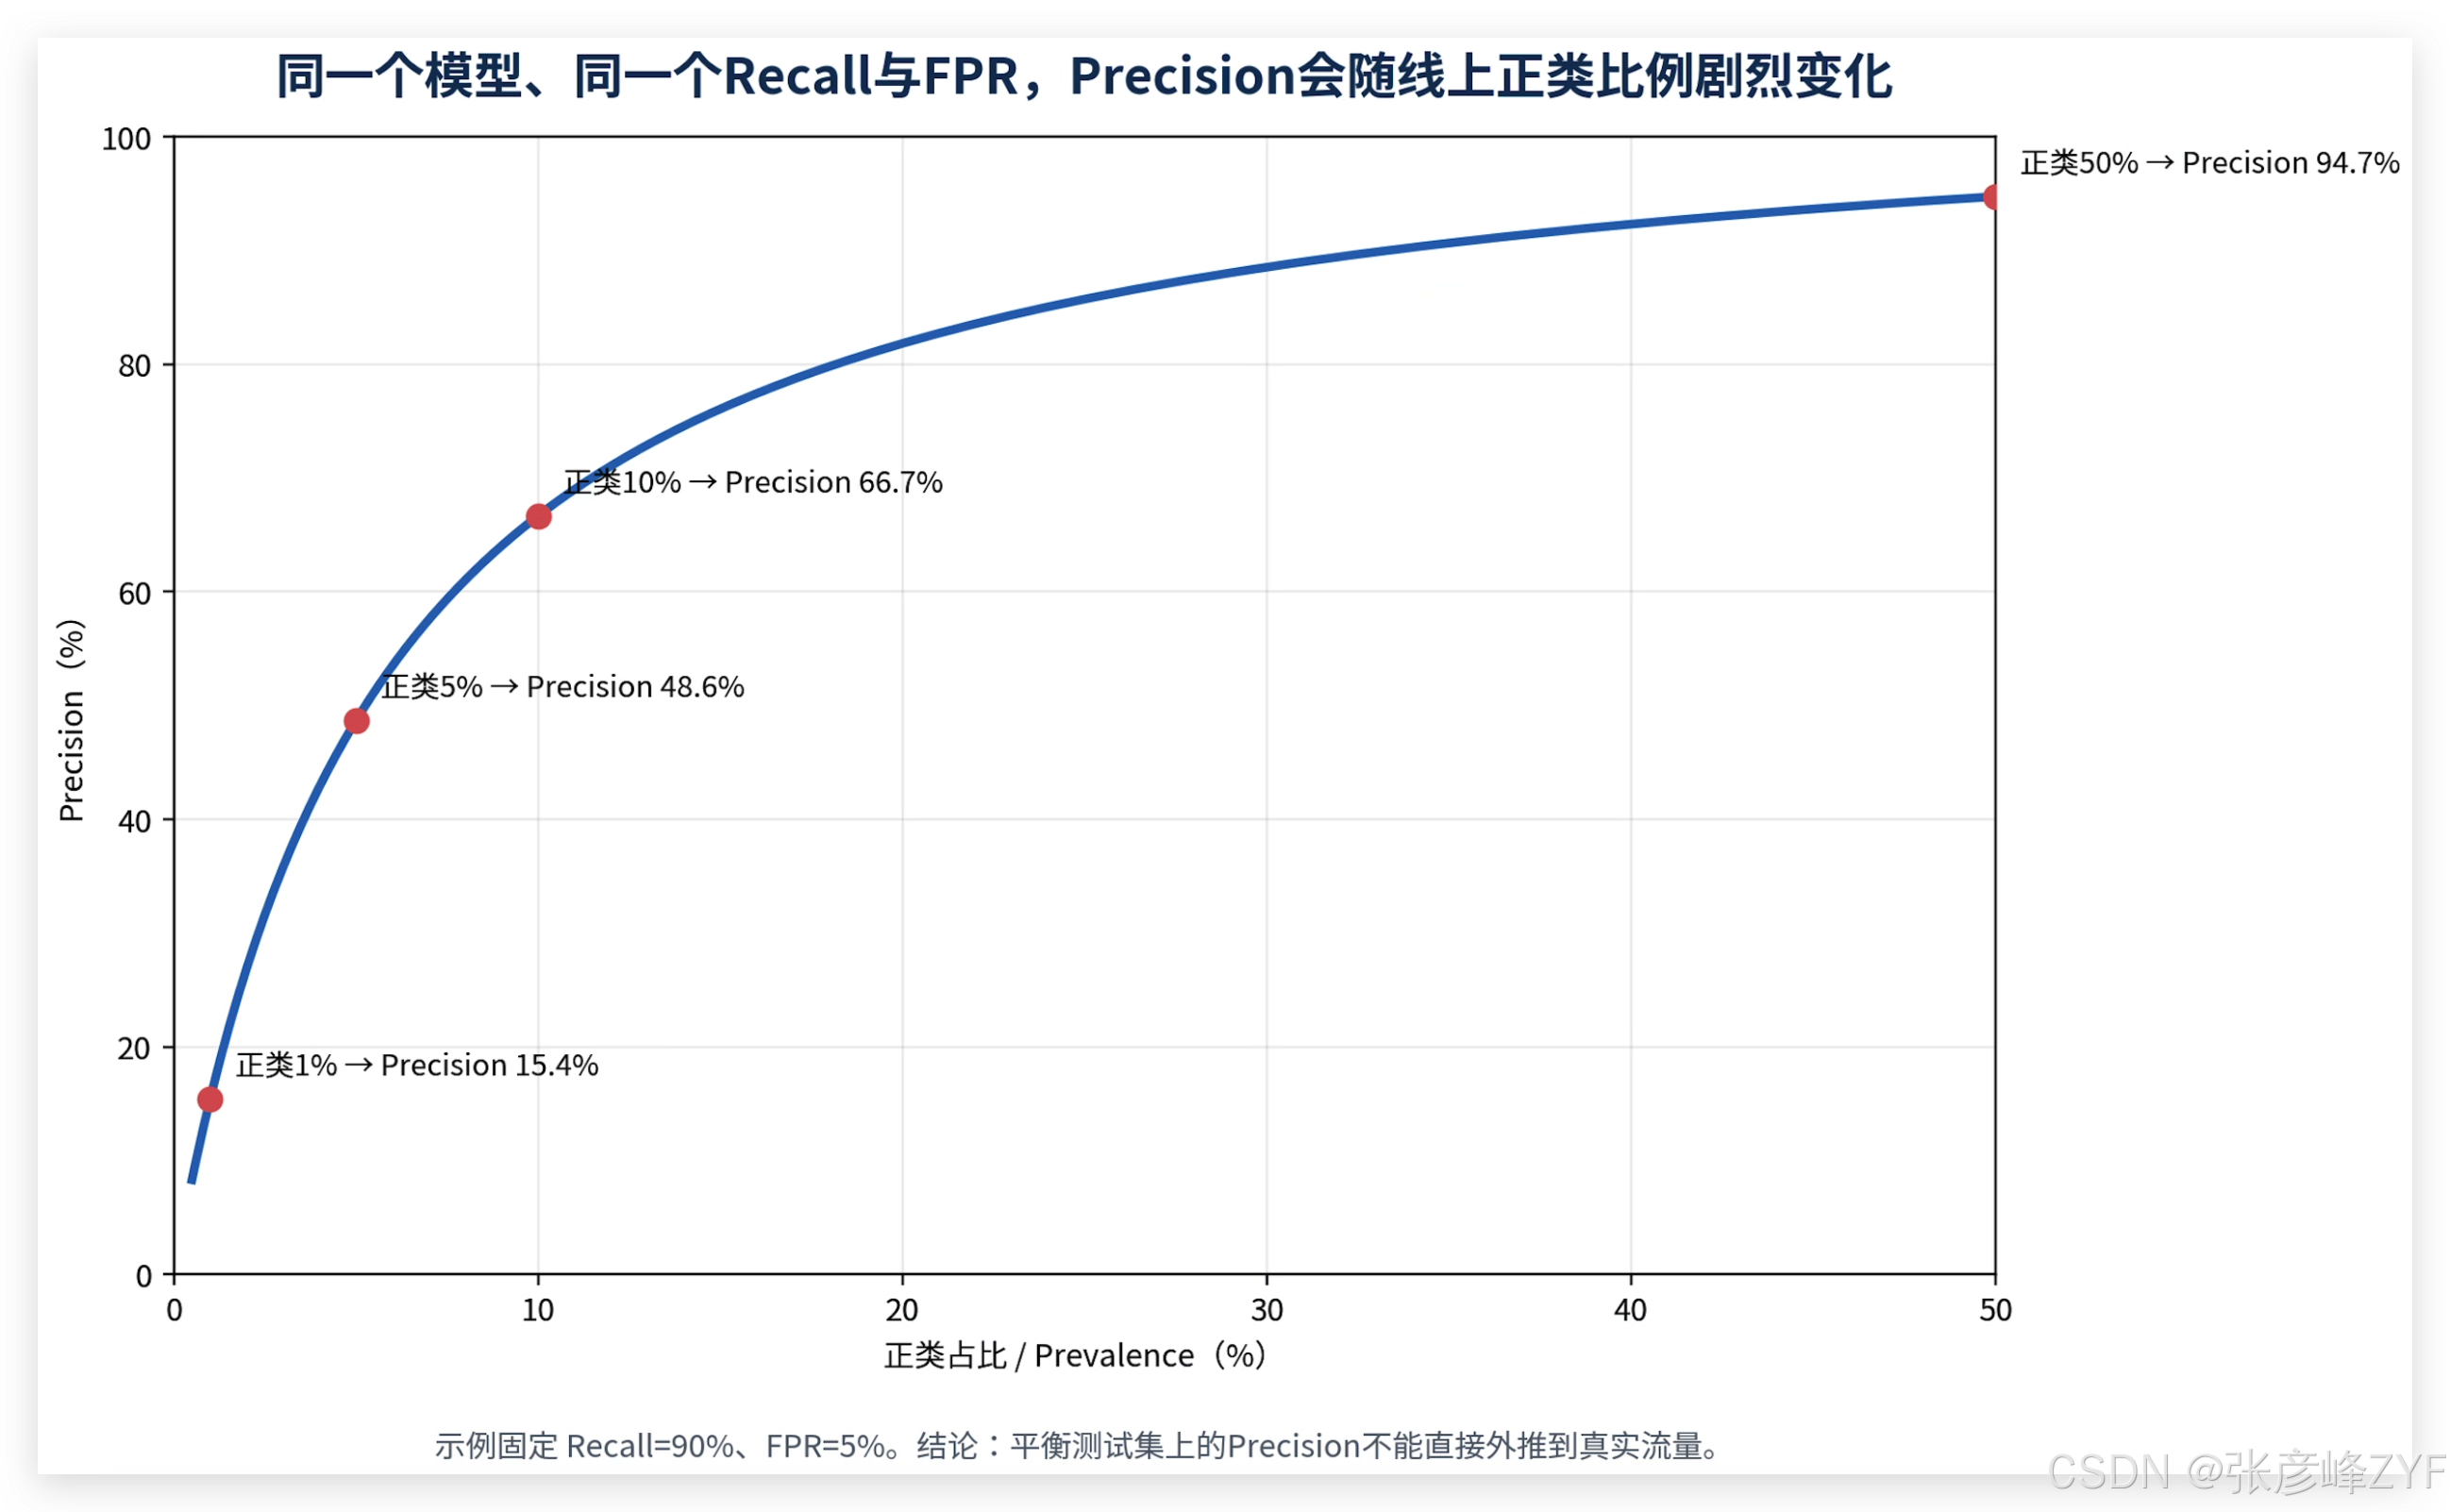
这给出一个非常重要的工程结论:平衡集上的 Precision 不能直接外推到生产。 平衡集适合比较区分度,真实比例集才适合估算告警量、人工审核负担和用户干扰。
2. 建议同时维护三种分布视图
一个成熟的分类类 Eval 至少应同时保留:
-
平衡集:看模型是否具备区分能力;
-
压力分布集:改变正类比例、难度、噪声,观察指标对分布的敏感性;
-
真实比例集:估算线上实际效果与资源负担。
三者不能相互替代。
(四)任何指标都应该有“下降时看什么”的诊断语义
没有动作语义的指标应该被删掉
一个很实用的指标审查问题是:“如果这个指标下降 10%,团队下一步去看哪里?”
如果答案是“再看看”“不太确定”,说明指标没有进入工程闭环。真正有用的指标应该能映射到具体排查路径,例如:
-
Context Recall 降低 → 先看索引覆盖、Query 改写、召回策略;
-
Faithfulness 降低 → 看证据约束、上下文引用与生成模型;
-
工具参数正确率降低 → 看 Schema 映射、参数提取与工具描述;
-
Outcome 成功率降低但 Process 稳定 → 看外部依赖、权限、限流、环境;
-
Judge 分歧率升高 → 看 Rubric、样本模糊度或 Judge 版本漂移。
指标一旦与诊断路径绑定,就从“仪表盘装饰”变成“故障定位接口”。
五、统计可信性:一次跑分只是轶事,不是证据
(一)概率系统必须多次运行
1. 为什么 pass@1 不足以表达 Agent 稳定性
一个 Agent 在某任务上第一次成功,并不代表它具备稳定能力。对于长推理、工具选择、网页操作等任务,随机路径可能导致结果高度波动。真正需要的是“在重复运行中有多大概率成功”,而不是“这一次成功了没有”。
对于高价值任务,建议至少记录:成功率、失败类型分布、平均尝试次数、超时率、成本分位数,并根据任务风险决定重复次数。探索期可从 5 次开始,关键门禁任务可增加到 10~20 次。若成本过高,可以用分层策略:高风险或历史 Flaky 样本多跑,稳定样本少跑。
2. 不要把 pass@k 和可靠性混为一谈
pass@k 回答的是“给 k 次尝试,至少有一次成功的概率”,适合测能力上限;生产可靠性往往关心的是“单次就成功”“连续多个步骤都成功”。二者的业务含义相反。一个系统 pass@10 很高,但 pass@1 很低,说明它“多试几次能做出来”,却不一定适合强实时、高成本场景。
(二)必须报告区间,不要只报单点
80% 可能并没有你想象得那么确定
如果 25 条样本里 20 条通过,点估计是 80%,但 95% 置信区间会很宽。小样本上的“涨 3 个点”“降 2 个点”很可能只是抽样波动。
因此,版本报告建议至少包含:样本量、点估计、95% 置信区间。对于没有简单解析区间的合成指标,可以用 Bootstrap;对于新旧版本比较,优先使用配对 Bootstrap 或其他配对方法,而不是把两个独立均值直接相减。
(三)版本比较要用“配对差异”,而不是两份平均分
同一任务上的差异最有信息量
如果 v1 和 v2 跑的是同一批任务,最自然的比较单位不是两边各自的总分,而是“每个任务上 v2-v1 的差”。这样可以消除任务难度的大量方差。
例如,100 条任务中,v2 总分提升 3%,但如果提升主要来自几条简单题,且核心难题反而退化,那么总分会掩盖事实;配对差异与切片则能直接显示“哪些任务被改善,哪些被牺牲”。
(四)多重比较会制造“总有一个显著”的假象
版本越多、指标越多,越容易误报改进
如果一次同时试 20 个 Prompt、10 个温度、8 个模型,再从几十个指标里挑最好看的结果,很容易偶然找到“显著提升”。这不是作弊,而是统计上的选择偏差。
因此,实验前应明确主指标和主假设;若确实做大规模候选搜索,应对多重比较进行校正,或把探索集与确认集分离。探索阶段可以大胆试,确认阶段必须重新验证。
(五)Flaky 用例不能简单删除
先区分“题目飘”与“Agent飘”
有些样本不稳定是题目、Ground Truth、环境或 Judge 有问题,这类应修复或暂时剔除;但如果不稳定来自 Agent 本身,则它恰恰暴露了真实脆弱点。把所有 Flaky 用例都删掉,会得到一个“更稳定但更虚假”的评测集。
更合理的做法是给 Flaky 用例打标签,退出 CI 硬门禁,但保留在稳定性看板中长期跟踪。这样既避免随机波动频繁阻断,又不掩盖系统可靠性问题。
六、判分体系:规则、执行验证、LLM Judge 与人工如何组合
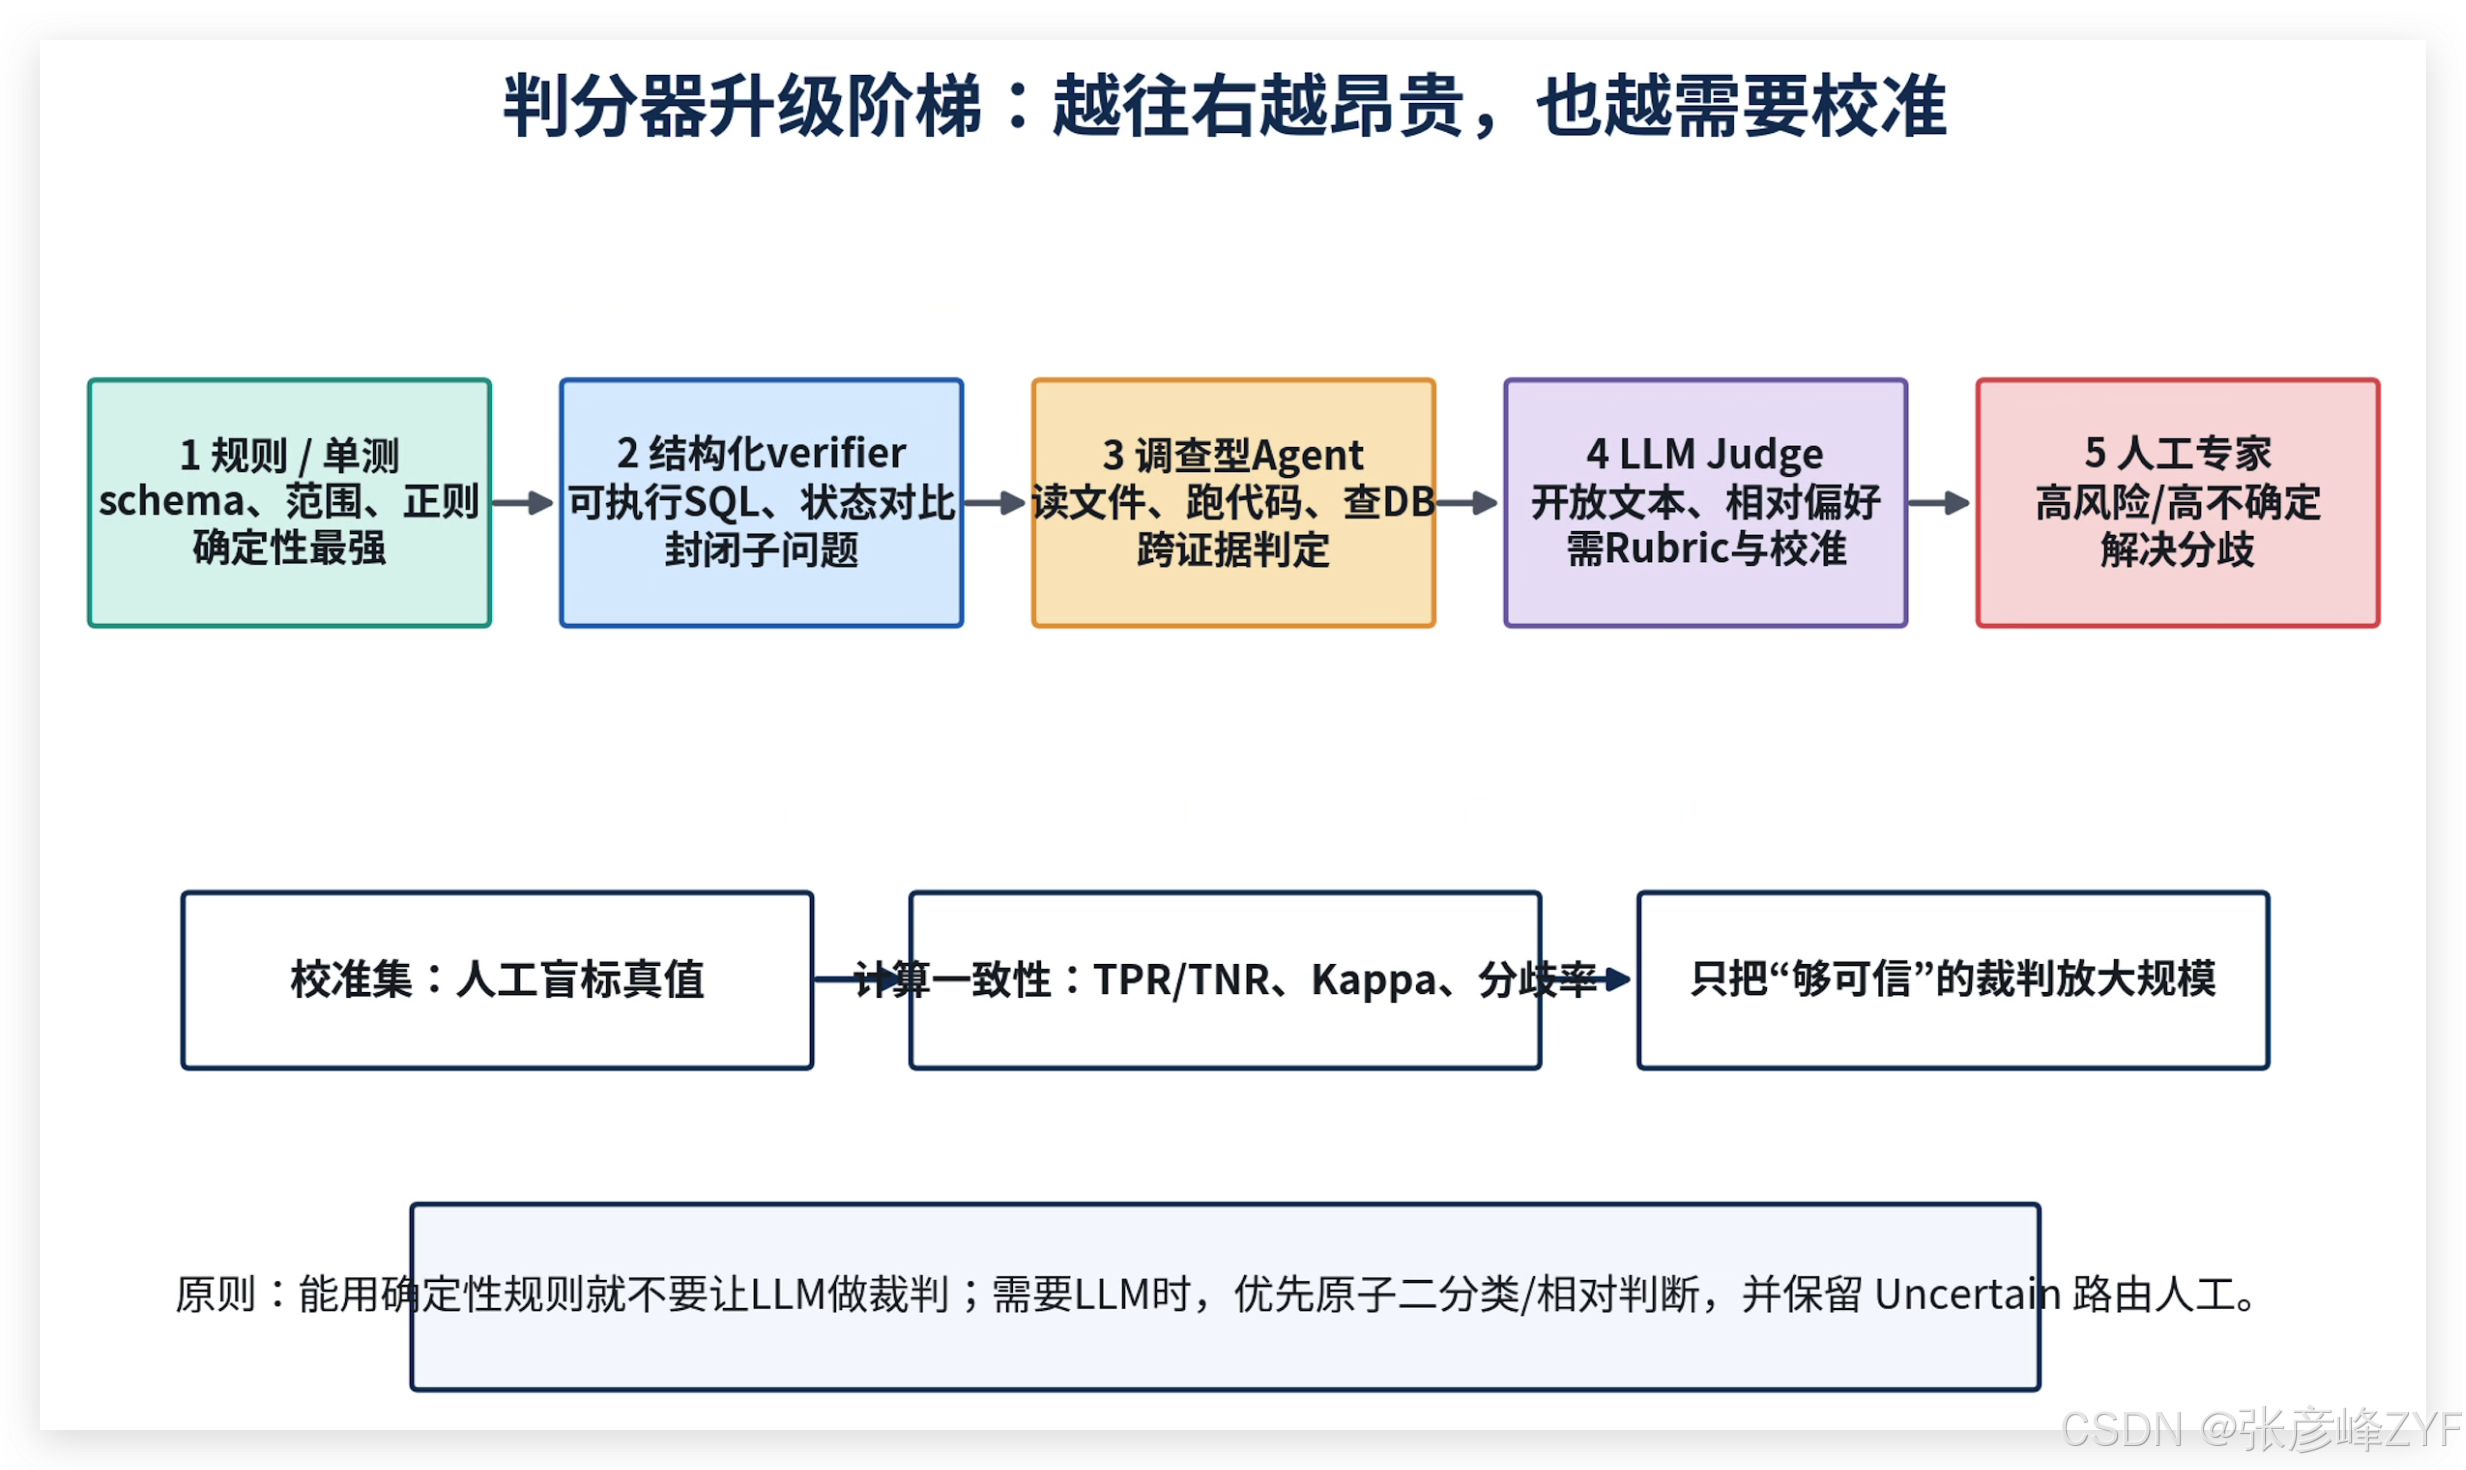
(一)最重要的原则:能用确定性规则,就不要让 LLM 当裁判
很多团队因为 LLM Judge 易用,就把所有任务都交给一个大模型“从 1 到 10 打分”。这会引入三个问题:成本更高、随机性更大、解释性更弱。
如果可以通过文件是否存在、JSON Schema、数值范围、单元测试、SQL 执行结果、数据库状态、正则或集合差异直接判定,就应优先使用确定性 verifier。只有当任务真正涉及开放表达、语义等价、跨文档证据或主观偏好时,才升级到 Agent Judge 或 LLM Judge。
(二)Judge 应该判“原子失败模式”,不要一口气打综合分
1. 原子二分类比 1~10 分更容易校准
“答案整体质量 7 分”很难建立稳定边界,因为 7 与 8 之间没有客观切点。更好的设计是拆成多个可观察行为:
-
是否引用了不存在的事实;
-
是否回答了用户核心问题;
-
是否遗漏了必须包含的限制条件;
-
是否违反了拒答政策;
-
是否在工具空返回时捏造结果。
每个 Judge 只判断一个原子维度,输出 Pass / Fail / Uncertain。这样才能分别估算 TPR、TNR、错误类型和置信度,失败也能直接进入归因。
2. Uncertain 不是软弱,而是降低噪声的机制
强迫 Judge 在模糊样本上二选一,会把不确定性伪装成确定性。保留 Uncertain 可以把争议样本路由到人工,让主指标只由高置信判定构成,同时单独监控“不确定率”。如果某一版本突然让 Uncertain 大增,这本身就是系统变化信号。
(三)开放式任务优先做相对判断,而不是绝对打分
“谁更好”通常比“值几分”更稳定
对于写作、客服回复、研究报告等开放任务,绝对分需要 Judge 自己校准量纲,而相对比较只需要判断 A、B 哪个更好或持平。相对评测可以显著降低不同轮次量纲漂移。
实践中可以采用 Good / Same / Bad 或 Win / Tie / Loss,并明确“平局”条件。例如,当新旧答案都明显答非所问时应判 Tie,而不是强迫 Judge 从两个坏答案中挑一个“稍微没那么坏的”。否则,系统会制造大量没有业务意义的胜负。
(四)Judge 上线前必须经过校准
校准与验证是两件事
校准是调 Prompt、Rubric 和阈值,让 Judge 在校准集上接近人工;验证则是在独立样本上确认它仍然有效。很多团队在同一批样本上反复调 Judge,然后直接报告高一致率,这相当于把裁判“训练到会做这套题”,却没有证明泛化。
一个可操作流程是:
-
由领域专家盲标一批代表性样本;
-
一部分用于 Judge 迭代,另一部分永不参与调参;
-
报告总体一致率,同时报告不同失败模式的 TPR/TNR;
-
对高风险维度使用更严格阈值;
-
模型版本、Rubric 或业务定义发生变化时重新校准。
(五)多 Judge 的价值是暴露分歧,不是简单求平均
分歧本身就是信息
三个 Judge 分别给出 0.9、0.5、0.1,平均后是 0.5,看起来像一个“中等确定”的结论;但真实信息是“裁判严重不一致”。因此,多 Judge 更适合并排输出一致性与分歧标志,而不是把差异压成平均值。
高分歧样本通常有三种价值:Rubric 模糊、样本本身边界模糊、或模型输出触及新的失败模式。它们正是最值得人工投入的地方。
七、Agent评测:必须同时看 Output、Outcome 与 Process
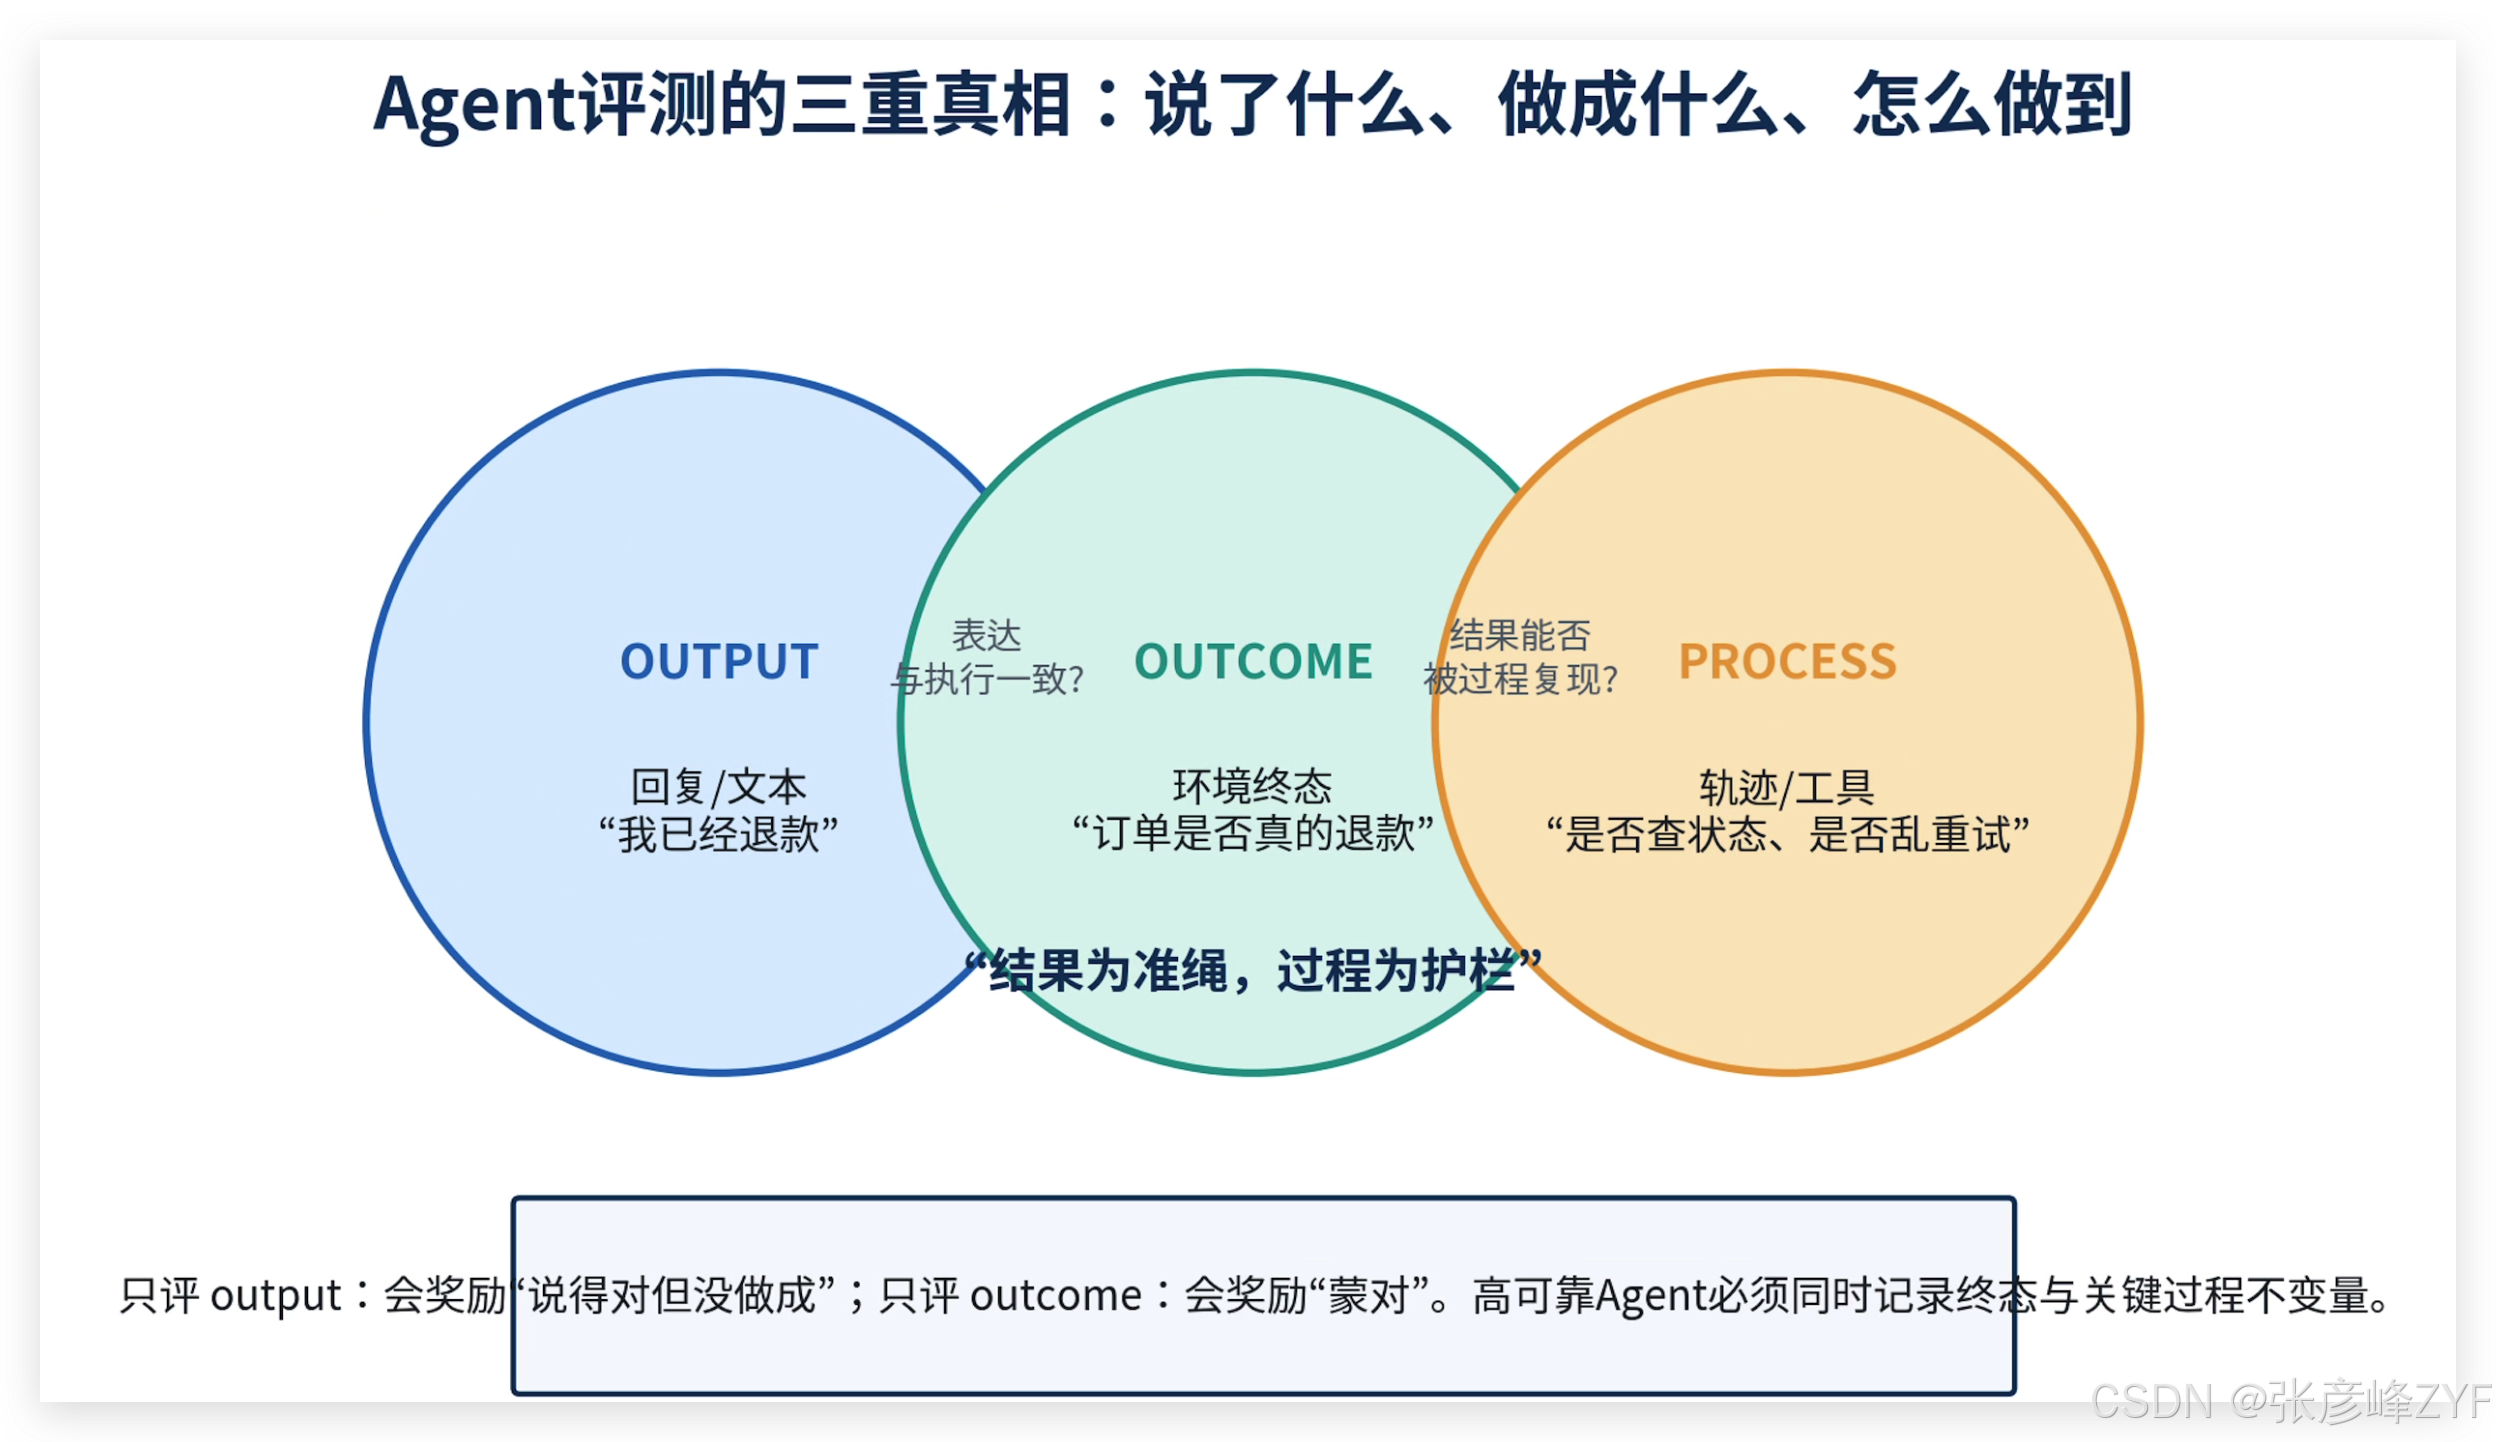
(一)只看回复,会奖励“说得对但没做成”
Output 与 Outcome 的分离是 Agent 时代的分水岭
1. 用真实状态变化定义任务是否成功
一个退款 Agent 调用接口时收到超时,但仍回复“已为您退款”。如果只评文本质量,这个答案可能非常礼貌、完整、符合风格;如果检查订单状态,它却是彻底失败。
2. 把语言质量与任务完成拆成两层
一旦系统具有写操作——改数据、发消息、转账、取消订单、创建工单——评测就必须验证环境终态。Output 是“它说了什么”,Outcome 是“世界因此发生了什么”。没有副作用的纯问答可以近似认为二者一致,有副作用的 Agent 绝不能这么假设。
(二)只看 Outcome,又会奖励“蒙对”
结果正确不代表路径可靠
假设 Agent 没有查询订单状态,直接调用退款,碰巧这笔订单允许退款,最终结果成功。Outcome 是对的,但过程违反了业务规则。换一个状态,它就可能造成重复退款或越权。
因此,一个成熟 Agent Eval 应同时维护结果与过程两个轴:
-
过程对 + 结果对:理想能力,可复制;
-
过程错 + 结果对:侥幸成功,是“定时炸弹”;
-
过程对 + 结果错:可能是外部条件、环境或依赖问题,有很强诊断价值;
-
过程错 + 结果错:明确能力失败。
最实用的原则是:结果为准绳,过程为护栏。 Outcome 决定是否完成任务,Process 负责限制不可接受的路径。
(三)Process 不应要求“唯一思路”,而应约束不变量
不要把实现细节误当成正确路径
Agent 可能有多条合理路径。如果评测强制要求“必须先调用 A 再调用 B”,很容易把某个实现写死,误杀更好的策略。过程判分更适合关注不变量:
-
必须在高风险操作前做权限确认;
-
不得在工具空返回时编造结果;
-
不得无限重复同一失败调用;
-
关键状态变更必须有审计证据;
-
对不可逆操作必须二次确认;
-
依赖失败后必须停止宣称成功。
这些约束与具体路径解耦,更能衡量“可靠性”而非“模仿参考轨迹”。
(四)工具调用至少拆成五个环节
“格式合法”远远不够
工具调用可拆为:选对工具、传对参数、调用顺序、是否冗余或漏调、如何处理返回值。尤其第五项经常被忽略:工具报错、空结果、部分结果、慢响应时 Agent 如何处理,往往比正常路径更能区分生产可靠性。
故障注入因此是 Agent Eval 的关键手段。主动模拟超时、429、权限错误、空数组、Malformed JSON、脏状态,可以验证 Agent 是合理恢复还是盲目重试。看日志时,两者都可能表现为“重复调用”,只有注入上下文才能区分。
(五)Agent Eval 应把成本和延迟作为一等公民
能做成但代价失控,也不能算生产可用
复杂 Agent 很容易通过增加思考、搜索、重试和工具调用提高成功率,但同时把成本和时延推到不可接受水平。评测因此至少需要记录 Token、工具调用次数、外部 API 成本、P50/P95/P99 延迟、重试次数。
更重要的是,不要只看平均值。生产体验通常被尾部延迟决定,一个均值 1.2 秒但 P99 15 秒的系统,远不如均值 1.8 秒、P99 4 秒稳定。对于风险灯号,性能维度更适合绑分位数而不是均值。
八、测试集工程:代表性、难度、污染与持续生长
(一)不要等“大而全”,先从真实失败开始
20~50 条真实 Bad Case 的价值往往高于几千条合成题
早期团队常见误区是“评测集不够大,先收集几百上千条再开始”。这会把 Eval 推迟到产品已经复杂之后,导致历史问题无法复现、迭代没有基线。
更有效的起点是从 20~50 条真实失败案例启动,优先级通常为:线上 Bug / 投诉 > 人工测试记录 > 高频场景 > 边界条件 > 合成扩展。小集的价值不在统计精度,而在快速建立“我们已知的问题必须能被 Eval 抓住”的基础能力。
(二)难度要有区分度,不要把低分难题轻易删掉
50%~70% 通过率区间往往最有迭代信息
所有版本都 100% 的题适合回归,却不适合测进步;所有版本都 0% 的题可能过难,也可能题目或判分器有问题。对于能力评测,最好保留一批位于当前能力边界附近的题,让新版本有空间拉开差距。
难题低通过率会拉低总分,因此最容易被“数据清洗”误删。但难题恰恰是能力上限的标尺。合理做法不是删,而是给题目分层:回归题、边界题、挑战题、红队题,各自使用不同期望。
(三)必须同时有正例与反例
单边测试会把系统训练成极端策略
只测“该搜索时有没有搜索”,模型最容易学会“什么都搜”;只测“是否拒绝高风险请求”,模型可能学会“什么都拒绝”;只测“是否找到异常”,系统可能通过大幅降低阈值提高 Recall,却把误报推爆。
每个行为都应该有反例:该调用工具与不该调用工具、该拒绝与不该拒绝、该追问与不该追问、该写入与只读。只有双边样本才能测真正区分能力。
(四)给测试集设置三道自检:Oracle、Dummy、人工复核
1. Oracle 与 Dummy:先校验量尺两端
一个非常低成本但高价值的自检组合是:
-
Oracle 必须通过:用已知正确答案、黄金轨迹或专家解运行,若仍失败,优先怀疑 grader;
-
Dummy 必须失败:用不操作、随机回答或显然错误方案运行,若能通过,说明题目可被蒙对或规则过松;
-
人工复核失败轨迹:区分“题目错”“环境错”“Agent 错”。
2. 人工复核:判断失败究竟属于题目、环境还是能力
公开 Benchmark 的经验反复证明,评测系统本身会成为主要错误来源。OpenAI 在 2026 年对 SWE-bench Verified 的复盘中,就报告其审查的高难失败子集中至少 59.4% 存在实质性测试设计或问题描述缺陷。这类案例最重要的启示不是某个具体百分比,而是:Benchmark 不是裁判席上的上帝,它也需要被审计。
(五)数据污染会让系统“提前看答案”
企业内部 Eval 常见污染包括:
-
上一次运行生成的文件未清理;
-
缓存返回旧答案;
-
git history 或日志中残留修复代码;
-
测试之间共享状态;
-
评测样本被长期暴露给 Prompt 优化人员;
-
Judge 与被测模型来自高度同源模型,产生自偏袒。
因此,每次运行应尽量从干净环境启动,开发集与保密集物理隔离,定期更新任务,并监控异常高分。对于公开基准,还应关注训练污染与题解泄露。
(六)测试集应该像产品一样持续生长
最有价值的 Eval 数据来自生产新失败
门禁真正的复利来自回流:每周把线上低分、投诉、异常 Trace、人工接管案例自动筛选,经过脱敏和去重后进入离线测试。这样,每一次事故都会变成以后不能再犯的回归资产。
一个成熟团队的 Eval 集不是“一次性数据集”,而是一个具有版本、Owner、变更记录和生命周期的产品。
九、从坏分数到可行动归因:评测如何真正驱动优化
(一)归因第一步不是怪模型,而是排除“非能力失败”
四类失败要先分开。面对一个 Bad Case,推荐按以下顺序排查:
数据/题目问题:Ground Truth 错、约束冲突、描述不完整;
环境问题:外部 API、权限、限流、网络、依赖异常;
随机波动:同一条件多次运行结果不一致;
能力问题:在明确规约与稳定环境下仍持续失败。
只有完成前三层排除,最后一类才值得算作“模型或系统能力缺陷”。这一步非常关键,因为错误归因会直接把研发资源投向错误对象。
(二)级联失败只归因第一个出错环节
避免把一个根因记成五个问题,如果路由先选错工具,后续参数必然错、执行必然失败、答案也会错。若每个环节都记一次 Fail,报告会显示“参数错误率、执行错误率、回答错误率都很高”,团队会同时优化三处,实际上只需修路由。
因此,流程型 Eval 需要依赖关系:上游失败时,下游依赖指标标记为 skipped / not applicable,而不是继续累计错误。这能显著提高归因的可行动性。
(三)建立“失败模式 → 根因 → 修复手段”的映射表
当 Bad Case 从几十条增长到几千条,人工逐条阅读会失去效率。更好的方式是建立结构化失败分类码,并让每个分类直接对应修复杠杆。例如:
| 检索漏召回 | 索引覆盖、Query 改写、召回器 | 扩展索引、混合检索、查询重写 |
| 检索到但未引用 | 生成约束、上下文排序 | 引用要求、重排、证据模板 |
| 工具选择错 | Tool 描述、路由 | 工具语义重写、路由分类器 |
| 参数缺失 | Schema 与抽取 | 结构化输出、必填校验 |
| 超时后假成功 | 错误处理 | 状态机、幂等、未知态提示 |
| 长上下文丢关键信息 | Context 管理 | 压缩策略、记忆、检查点 |
| Judge 分歧高 | Rubric/边界模糊 | 拆原子维度、人工定标 |
当映射稳定后,评测报告可以自动生成“根因热力图”和修复优先级。
(四)总分之外必须切片
1. 平均值最擅长掩盖局部灾难
一个总分 90 的系统可能在 95% 的普通任务上接近满分,却在 5% 的高风险退款场景里只有 40%。平均后仍然漂亮,但业务上不可接受。
至少建议从三个维度切片:业务场景、能力维度、风险类型。同时报告每格样本量,避免在 3 条样本上得出“该场景提升 20%”的过度结论。
2. 对高风险长尾采用“风险加权关注”,而非简单样本加权
高风险样本在真实流量中可能很少,却不能因为占比低就被平均值淹没。更合理的做法是:总分用于描述整体体验,风险切片用硬门禁单独管理。这样既不扭曲总体指标,也不牺牲安全底线。
(五)归因报告必须带 Owner 与验收标准
一个完整的改进项至少包含:问题摘要、影响范围、根因、证据、建议动作、Owner、优先级、验收标准、目标版本。没有验收标准,修完以后仍然不知道是否真的解决;没有 Owner,建议会留在报告里慢慢失效。
从这个角度看,评测报告应该直接连接 Issue Tracker 或研发任务系统,而不是停留在 PDF 或周报里。
十、门禁与 EvalOps:把评测嵌入研发、发布和生产
(一)门禁必须分级,否则不是太烦就是没用
如果所有指标都一票否决,随机波动大的辅助指标会频繁误杀,团队很快绕过门禁;如果所有指标都只发警告,门禁又形同虚设。
推荐把指标分成:
-
硬门禁:安全、合规、数据破坏、不可逆业务错误;
-
核心质量门禁:任务完成、关键能力回归;
-
软告警:风格、次要体验、成本轻微波动;
-
观察项:探索指标,不参与决策。
严重度与阻断权绑定,才有可持续性。
(二)平均分之外必须有“等级约束规则”
如果四个维度都是 0.91,但一个隐私红灯指标只有 0.45,简单平均仍会得到很高等级。真实发布决策却必须被红灯拦下。
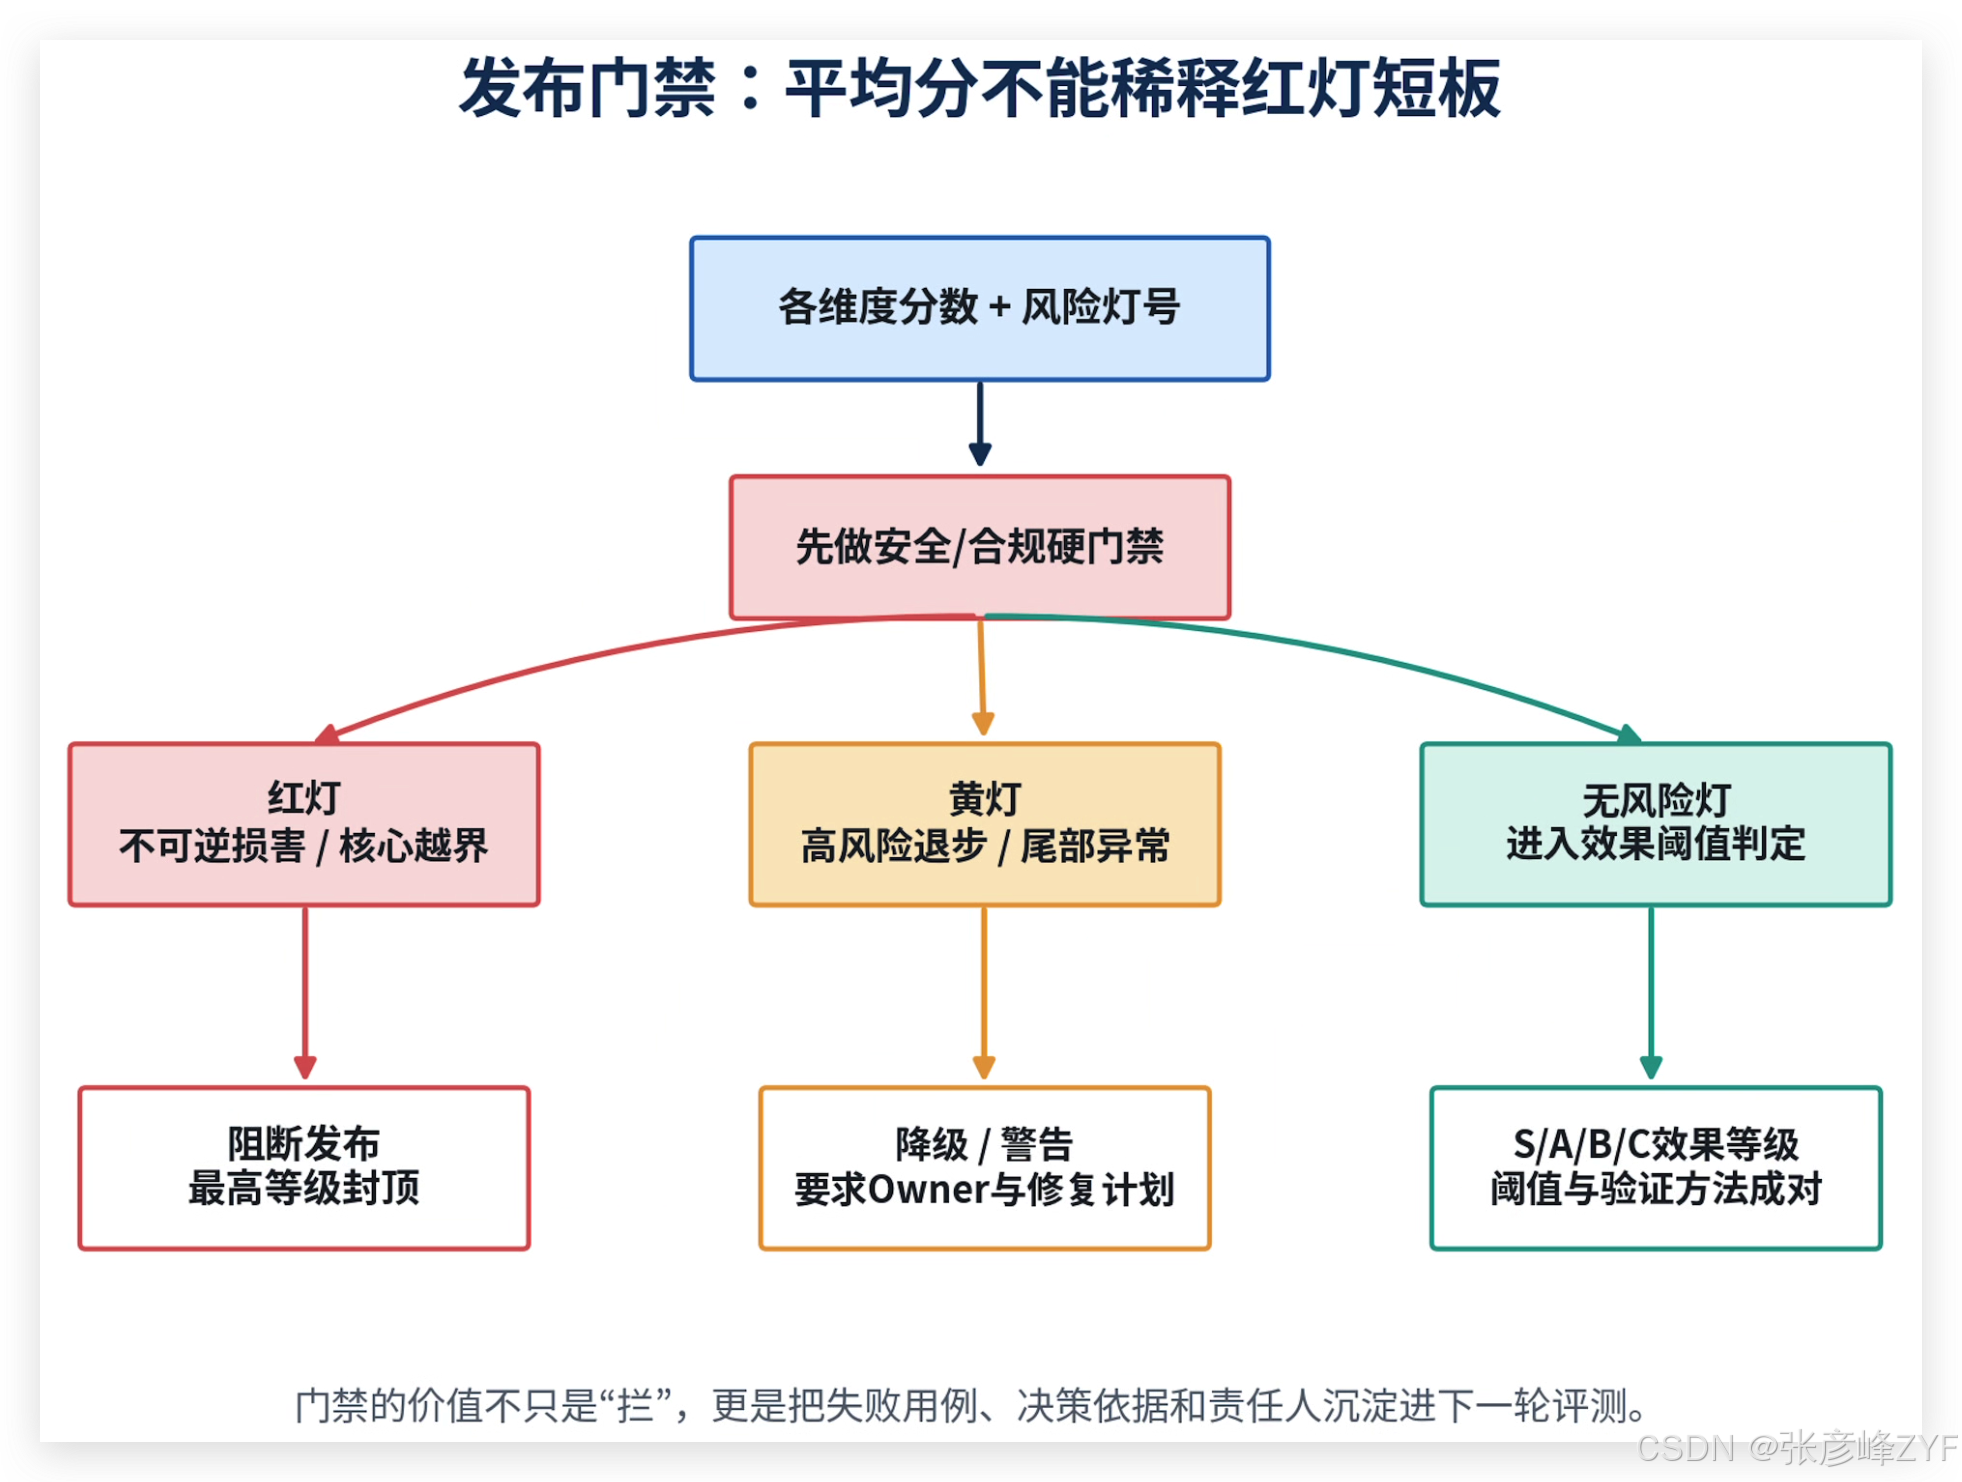
因此可采用“数值等级 + 风险约束”两阶段:先按核心维度决定 S/A/B/C,再用红黄灯封顶。例如有红灯最高 B,有多个黄灯最高 A。具体阈值必须由业务风险决定,不能机械照搬。
(三)阈值与验证方法必须成对出现
“幻觉率 <5%”如果不说明怎么测,就不是门禁
任何门禁都应同时声明:数据集版本、样本量、运行次数、Judge 版本、统计方法、切片、置信要求。否则同一个“5%”在不同团队手里可以得到完全不同结论。
阈值是决策规则,验证方法是证据生成规则。二者缺一,门禁不可复现。
(四)EvalOps 的目标是“任何结论都能重放”
1. run 与 score 必须分离
1.1 Run 层保存可重放证据
推荐把一次评测拆成两个阶段:
-
Run:固定模型、Harness、环境和协议,生成原始 Trace、输出与终态;
-
Score:用某个版本的 grader 对已保存的结果打分。
1.2 Score 层允许判分口径独立演进
这样 Judge 更新后可以重打历史数据,而无需重新调用昂贵模型;模型退化时也可以区分“运行行为变化”还是“评分规则变化”。
2. 最容易漏的是 Context 与环境版本
真正可复现不仅要保存 model name 和 Prompt,还要保存:检索索引版本、上下文拼接结果、工具 Schema、依赖版本、测试数据库快照、环境变量、重试策略、时间戳、随机种子。否则“同样的代码”也可能复现不出同样结论。
(五)人工抽检不应随机平均撒,而应投向“信息量最高的分歧样本”
成熟 Eval 中,人工最应该看的是规则与 Judge 冲突、多 Judge 分歧、风险高但置信低、版本差异最大的样本。这些样本对 Rubric、分类边界和根因最有信息量。
把有限专家时间集中在分歧处,可以让少量人工产生最大边际价值;而大规模随机抽样更适合做周期审计,不适合作为日常主流程。
(六)失败回流让门禁产生复利
发布门禁如果只给“Pass/Fail”就结束,价值很有限。真正的复利是把触发门禁和线上故障的样本回流到回归集,并记录其根因与修复版本。长期看,回归集就是团队“已经付过学费”的知识库。
十一、元评测:谁来评评测系统本身
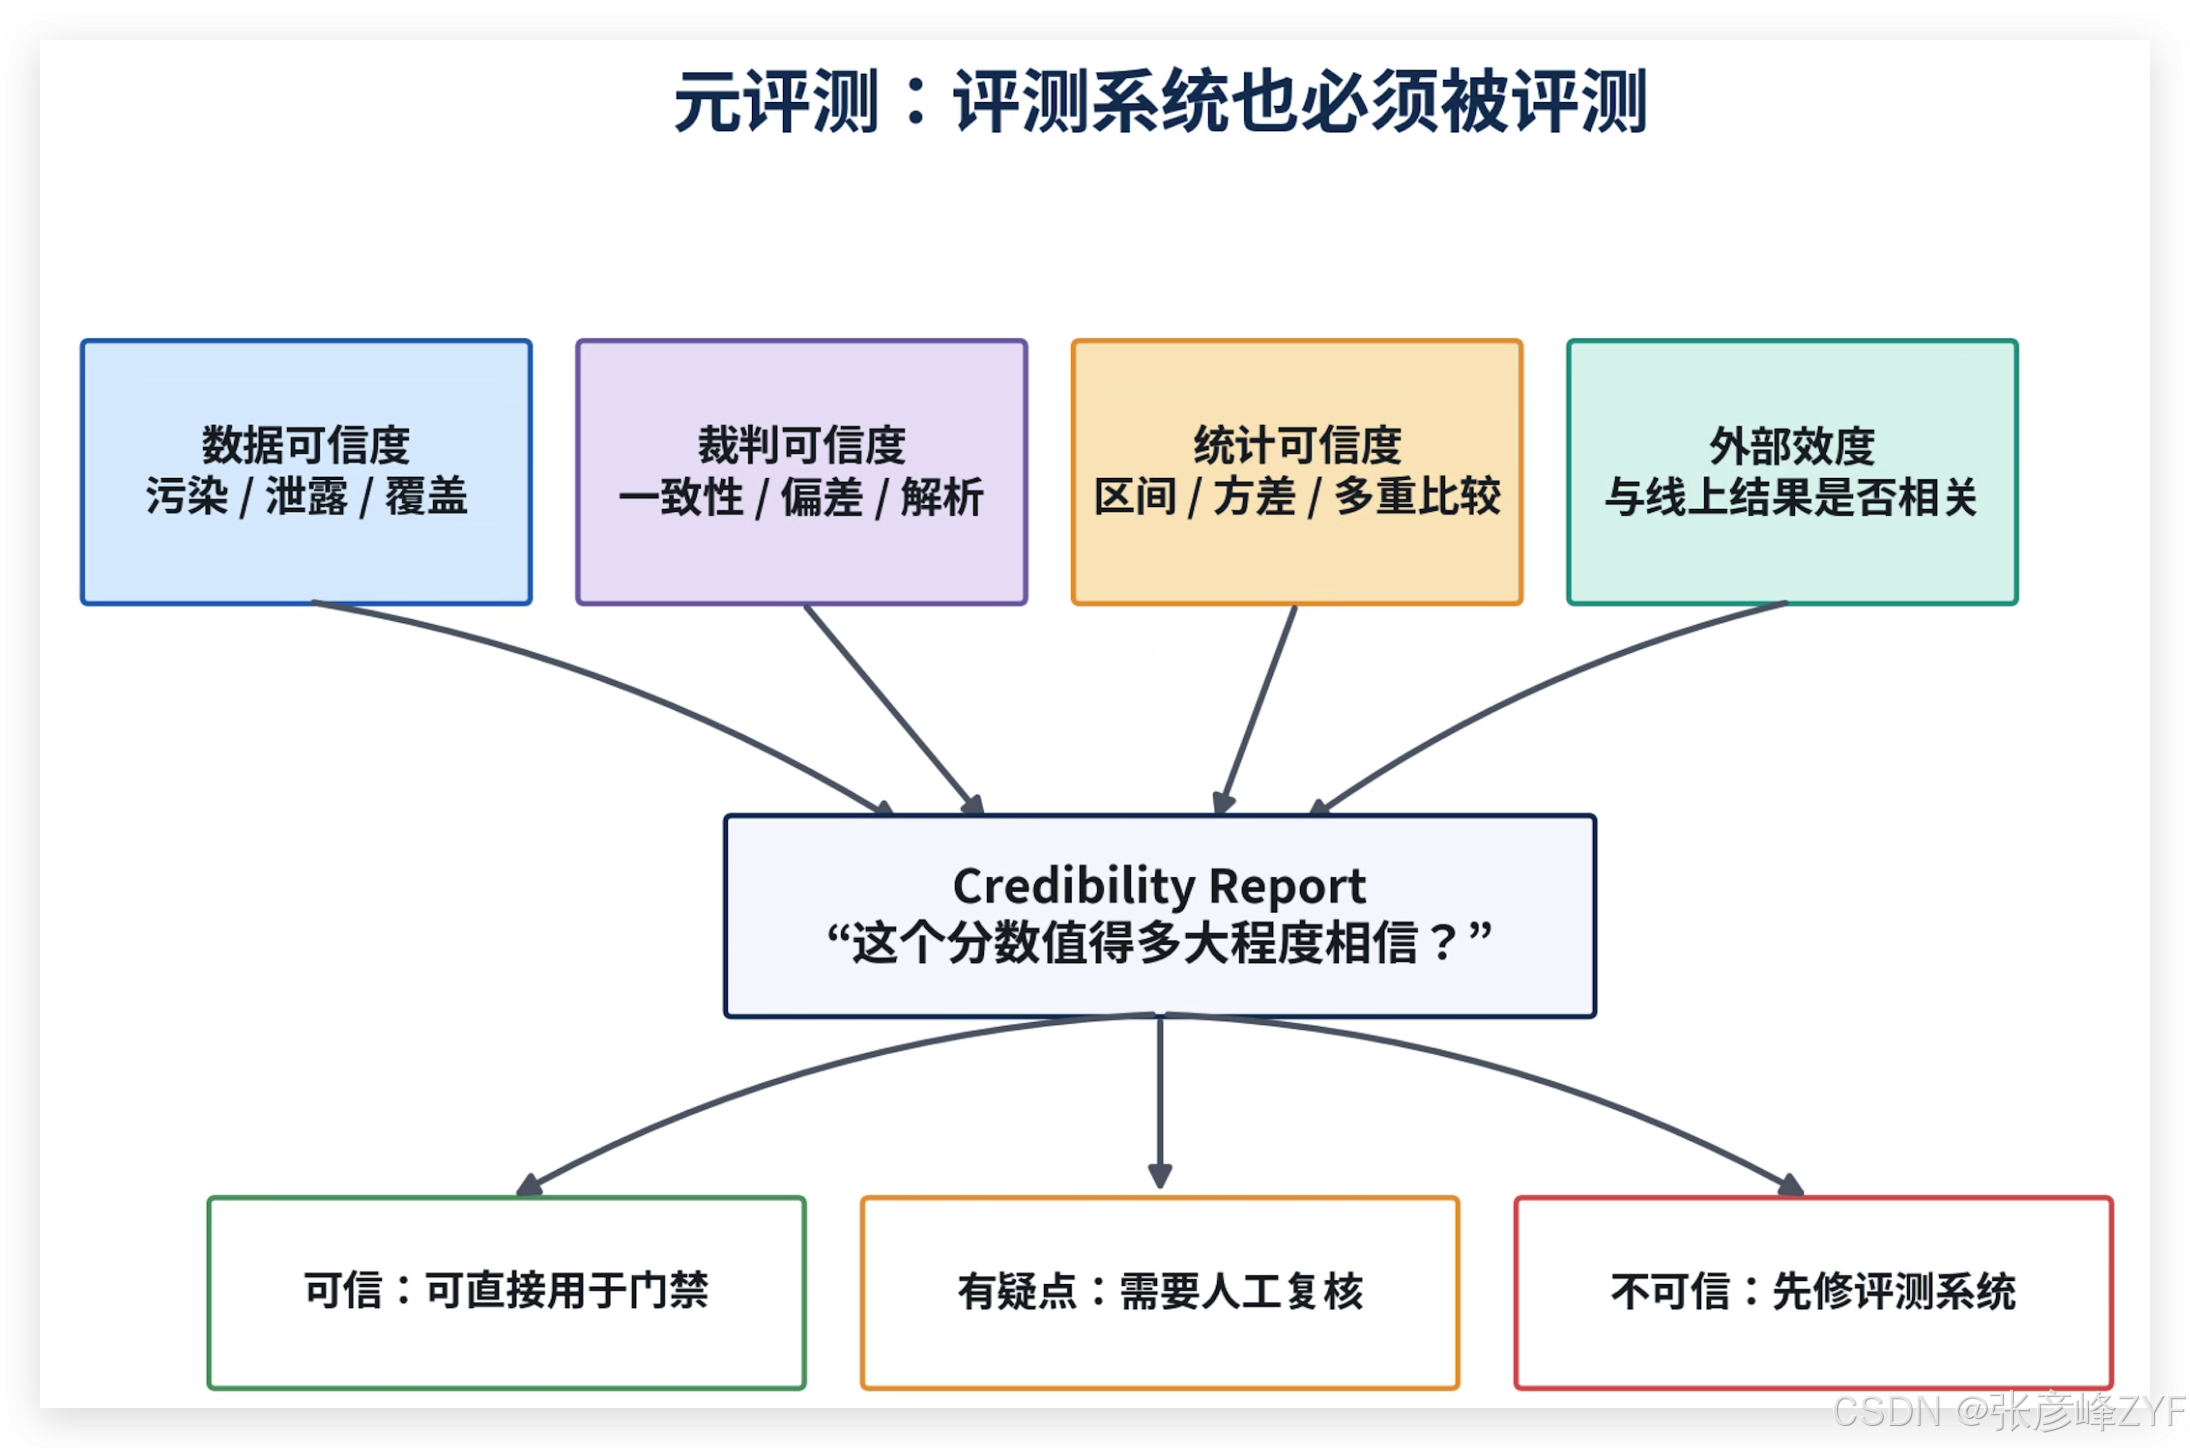
(一)为什么“评测系统自己也会错”必须成为一等公民
公开 Benchmark 会有题目缺陷、污染、过窄测试、环境偶然失败;企业内部 Eval 也会有 Judge 偏差、Ground Truth 过时、Rubric 模糊、数据分布漂移。越依赖自动评测做发布决策,就越需要对评测本身建立质量报告。
{width=90%}
(二)元评测至少检查四类可信度
1. 数据可信度
检查覆盖、重复、泄露、污染、样本来源、分布漂移、保密集暴露。核心问题是:这些任务是否仍代表我们声称代表的现实?
2. 裁判可信度
检查与专家标注的一致性、不同错误类型的 TPR/TNR、位置偏差、长度偏差、自偏袒、解析失败、Uncertain 比例。核心问题是:Judge 的错误是否被看见?
3. 统计可信度
检查样本量、区间宽度、重复运行稳定性、多重比较、切片最小样本数。核心问题是:这个差异是否超过随机噪声?
4. 外部效度
检查离线指标与线上成功率、用户满意度、人工接管率、退款率、投诉率等真实结果的相关性。核心问题是:离线分数上涨,业务是否真的更好?
(三)元评测的交付物应该是“分数的质量说明”
1. 从“82分”升级为“82分,高可信度”
1.1 先报告结果,再报告结果的质量
成熟报告可以给每次 Eval 附一个 Credibility Report,例如:
-
测试集覆盖:良好,近 30 天生产失败覆盖率 87%;
-
Judge 与专家一致:89%,高风险维度 94%;
-
重复运行 CV:0.11;
-
关键切片最小样本量:42;
-
与线上人工接管率 Spearman:-0.78;
-
数据泄露扫描:未发现;
-
综合可信度:高,可用于发布门禁。
1.2 可信度决定分数能支持哪一类决策
当可信度不足时,报告应明确写“仅用于探索,不得作为发布依据”。这能防止组织把一个“看起来精确”的数字误当成事实。
(四)校准不是一次性动作,而是持续治理
同一 Rubric 在半年后可能已经过时;新的模型行为可能突破旧 Judge 的识别边界;生产流量也会变化。因此应设定周期性复校机制:模型大版本更新、业务政策变化、Judge 分歧显著上升、离线—线上相关性下降时,自动触发重新校准。
十二、从零到可用:90天建立企业级“最小可信评测闭环”
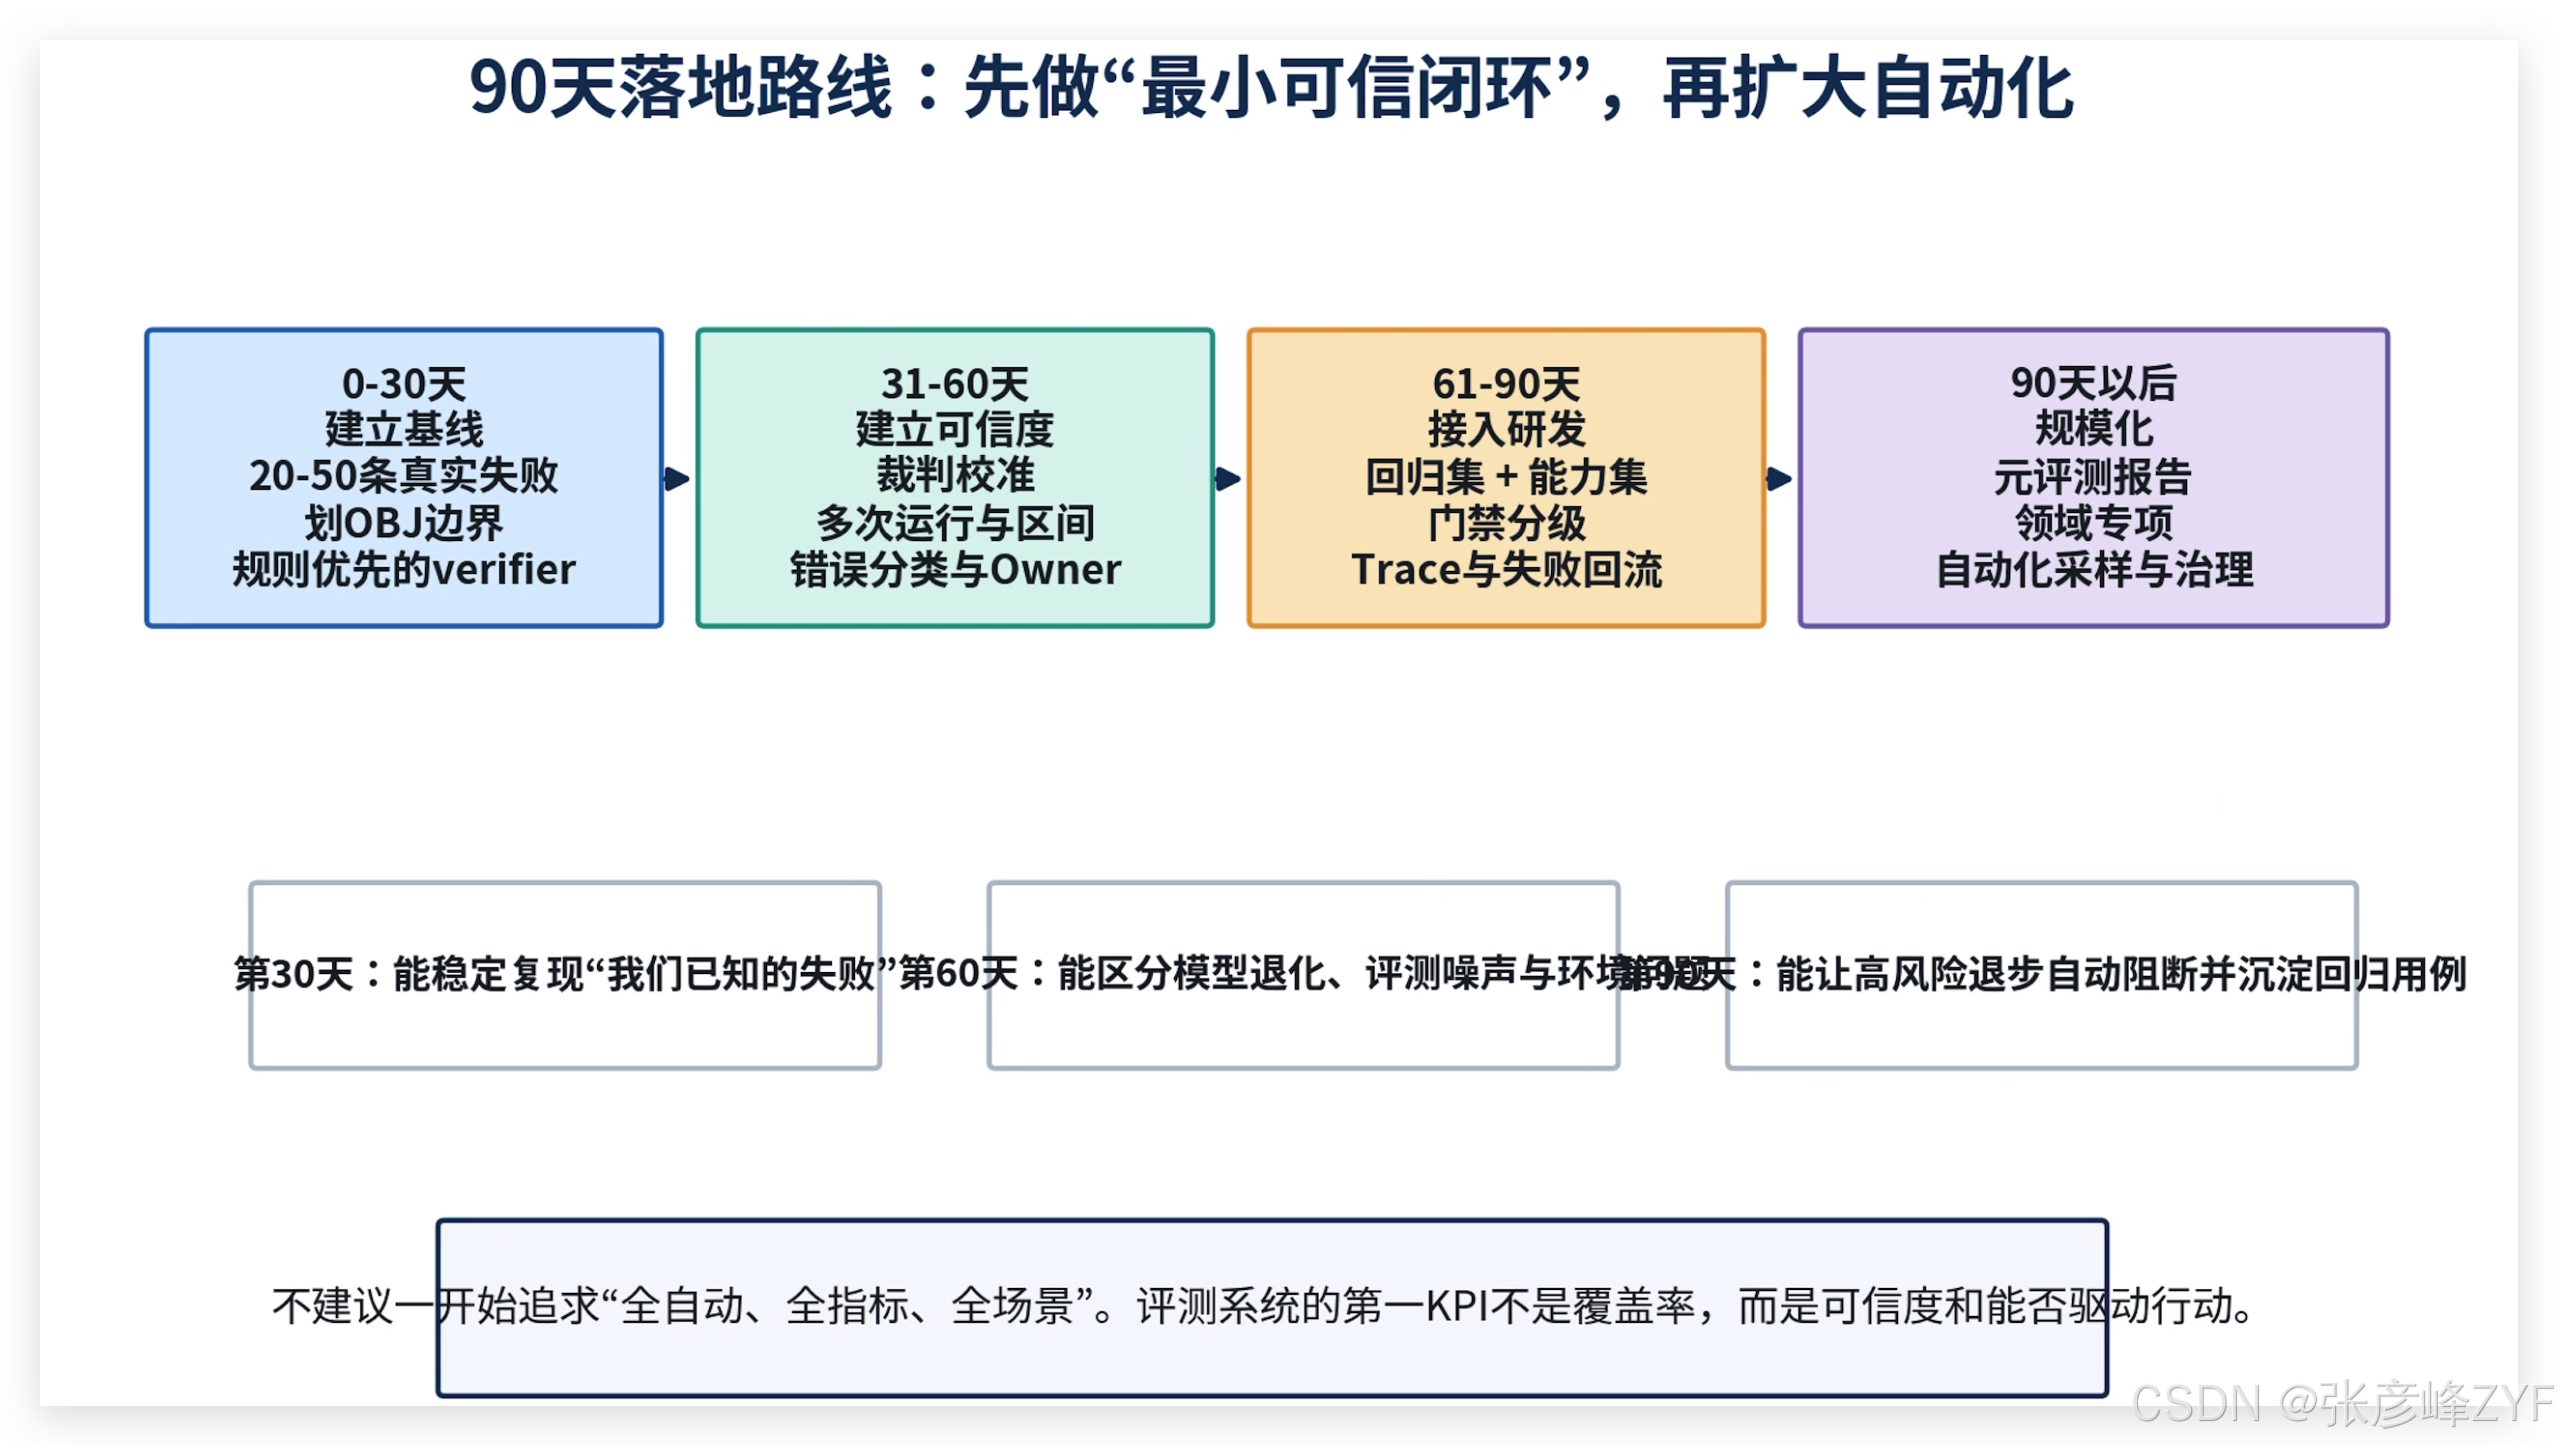
(一)0~30天:不要追求平台化,先建立基线
第一个月建议只做三件事:划清 OBJ 边界、收集 20~50 条真实失败、建立规则优先的 verifier。不要一开始就做复杂 LLM Judge 平台、全指标大盘或自动红队。
交付物包括:
-
一份 Eval Charter:决策问题、被测对象、运行协议;
-
一个最小测试集:真实失败 + 高频正常场景 + 关键反例;
-
一个可重复运行的 Runner;
-
一份失败分类码;
-
第一版基线报告。
第30天的验收标准不是“覆盖 1000 条”,而是团队能稳定回答:“我们最关心的 30 个历史问题,现在还能不能复现?”
(二)31~60天:建立可信度,而不是扩数量
第二个月重点是让分数“可相信”:
-
对开放任务引入原子 Judge 与人工校准集;
-
对 Agent 高波动任务做多次运行;
-
所有主指标报告区间;
-
新旧版本使用配对比较;
-
把题目错、环境错、能力错分开;
-
给每类问题指定 Owner 与验收标准。
到第60天,团队应该能回答:“这次掉分究竟是模型退化、环境异常,还是我们的尺子坏了?”
(三)61~90天:把评测接入发布流程
第三个月把测试集拆成两条线:
-
能力集:难度高、有区分度,用来测进步;
-
回归集:历史上已稳定通过,用来防退步。
能力集低分不一定是坏事,它代表上限;回归集突然掉分则优先怀疑系统退化或评测基础设施异常。
同时建立红黄灯门禁、失败自动回流、Trace 版本化与成本护栏。到第90天,关键高风险退步应能自动阻断,不再依赖人工“记得跑一下”。
{width=94%}
(四)90天以后:平台化的顺序应该是“可信度 → 自动化 → 规模化”
很多企业先投入大量资源建设 Eval 平台、可视化和调度,后来才发现测试集、Judge 和决策口径本身并不可信。结果只是“更高效地产出错误结论”。
更健康的扩展顺序是:
先证明少量关键 Eval 能支撑真实决策;
再自动化数据采集、运行与评分;
再扩大任务覆盖和团队共享;
最后引入元评测、领域专项与组织治理。
平台应该放大已经正确的方法,而不是替代方法设计。
十三、进一步推论:未来的AI工程会越来越接近“面向评测的开发”
(一)从 TDD 到 Eval-Driven Development
传统测试驱动开发强调“先写测试,再写实现”。AI 系统同样需要类似转变:每个重要需求,在进入 Prompt 或代码之前,先转成可评测行为。
例如,需求“客服 Agent 要更稳健”太模糊,应该被拆成:超时不假成功、空结果不编造、用户拒绝后停止挽回、退款前检查状态、关键写操作二次确认。只有这些行为进入 Eval,团队才知道“稳健”是否真的被实现。
这意味着未来 Prompt 工程、Agent 工程和产品需求之间会出现一层新的共同语言:Eval Contract。产品经理描述业务意图,评测工程师把它变成可观察行为和风险边界,研发再实现系统。没有 Eval Contract 的需求,会越来越难在概率系统中稳定交付。
(二)评测会成为 AI 产品的“可执行规格说明书”
随着模型能力和工具链快速变化,静态规格很快过时。Eval 集则不同:它通过样本、断言、环境和门禁把规格变成可执行对象。一个功能被定义为什么,不再只写在 PRD 中,而是同时体现在“哪些样本必须通过、哪些行为绝不能发生”。
长期看,企业最有价值的 AI 资产之一不是某一版 Prompt,而是经过生产验证、持续回流、带有风险语义和根因标签的 Eval Corpus。
(三)模型选择会从“排行榜导向”转向“系统匹配度导向”
公开 Benchmark 适合回答“哪些模型值得进入候选”,却不能直接回答“哪个模型最适合我的业务”。不同组织的任务分布、工具、延迟预算、风险偏好、上下文长度、语言和成本结构都不同。
未来更成熟的选型流程会是:先用公开 Benchmark 识别候选,再在固定 Harness 下跑企业 Eval,最后用成本—质量—延迟—风险的多目标约束做决策。模型榜单从“结论”退回到“线索”。
(四)元评测将成为高风险AI治理的核心能力
当 Eval 直接决定发布、回滚、自动优化甚至模型选择时,Judge 与数据集本身就成为治理关键点。谁能修改 Rubric、谁能更新保密集、谁能改变门禁阈值,都应有版本和审计记录。
这与传统软件中的测试权限、生产变更权限类似。未来的 AI 治理不会只盯模型,也会治理“测模型的系统”。
(五)最强的评测体系不是“测得最多”,而是“错误最难悄悄溜过去”
评测系统最危险的失败不是报错,而是不报错地给出一个看起来合理的分数。题目有缺陷、Judge 解析失败默认 PASS、平衡集 Precision 被外推到线上、脚手架不同却比较模型、平均分稀释红灯、Flaky 用例被删除——这些问题都不会让流水线崩溃,却会让结论失去意义。
因此,一套成熟 AI Eval 的设计目标可以归结为一句话:让系统很难“在不知道自己错的情况下继续自信前进”。
这也是为什么元评测、Oracle/Dummy 自检、区间、分歧样本、失败回流和版本化如此重要。它们不一定让分数更高,但会让组织更少被分数欺骗。
十四、结语:把评测建成“组织记忆”,AI应用才有复利
评测的长期价值来自积累,而不是一次性证明:
(一)每一次失败都应该变成未来的资产
AI 系统的能力会持续变化,模型、Prompt、工具和业务环境都在更新。一个今天有效的方案,三个月后可能被新模型行为、分布变化或外部依赖打破。因此,企业真正需要的不是某一份 Benchmark 报告,而是一套持续维护的评测基础设施。
当生产失败被结构化回流,评测集逐渐承载组织历史;当根因与修复版本被记录,团队开始拥有“哪些坑已经踩过”的机器可读记忆;当门禁与统计规则固定下来,新人也能复用已有决策纪律;当元评测持续检查尺子本身,组织才不会因为自动化而更快地自我欺骗。
(二)一个可落地的最终定义
可以把企业 AI 评测体系定义为:
一套围绕真实决策问题建立的、可重复运行的证据系统。它用代表性测试集和分层判分器观察模型与系统行为,用业务指标和统计方法把行为转化为可信结论,用归因和门禁把结论转化为研发行动,再把生产失败持续回流为新的测试资产;同时,它通过元评测持续验证自己的尺子仍然可信。
如果做到这一点,评测就不再是“项目结束时的验收”,而是 AI 工程的地基、导航系统和组织记忆。模型训练决定了能力的上限,而评测决定了这些能力能否被稳定、安全、可解释地转化成真实价值。
可参考文章与资料
OpenAI:Why SWE-bench Verified no longer measures frontier coding capabilities —— 讨论 Benchmark 测试缺陷、数据污染与前沿能力测量失真。
OpenAI:A shared playbook for trustworthy third-party evaluations —— 讨论强能力激发、Harness、工具与脚手架对评测结论的影响。
OpenAI:GDPval – Measuring AI model performance on real-world tasks —— 面向真实职业任务的评测设计与专家评分。
OpenAI API:Graders —— 规则、文本相似度等自动评分器的工程接口。
Anthropic:Demystifying evals for AI agents —— Agent 多轮、工具、Outcome 与不同 grader 组合的实践方法。
NIST:AI Risk Management Framework – Generative AI Profile —— 将测量、验证、风险管理与治理结合的框架。
Liang et al.:Holistic Evaluation of Language Models (HELM) —— 多场景、多指标、透明化语言模型评测框架。
Zheng et al.:Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena —— LLM Judge 的可用性、位置偏差、长度偏差和自偏袒问题。
Jimenez et al.:SWE-bench —— 基于真实 GitHub Issue 的软件工程 Agent 评测基准。
Liu et al.:AgentBench —— 多环境、多轮交互式 Agent Benchmark。
Es et al.:RAGAS —— 将 RAG 拆为检索、忠实性、相关性等维度进行评测。
Chen et al.:Evaluating Large Language Models Trained on Code —— HumanEval 与 pass@k 的经典来源。