📖标题:WeAgent-MMGenEdit: A Full-Stack Recipe for Multimodal Agentic Image Generation and Editing
🌐来源:arXiv, 2609.05171v1
🛎️文章简介
🔸研究问题:现有的图像生成模型在处理需要外部实时知识或特定视觉事实的复杂任务时,往往因为缺乏准确信息而产生幻觉,如何解决这一痛点?
🔸主要贡献:论文提出了一套全栈式解决方案WeAgent-MMGenEdit,通过改进智能体运行环境、构建高质量数据集和基准测试,并对策略模型及图像后端进行双重后训练,显著提升了知识密集型图像生成与编辑的准确性。
📝重点思路
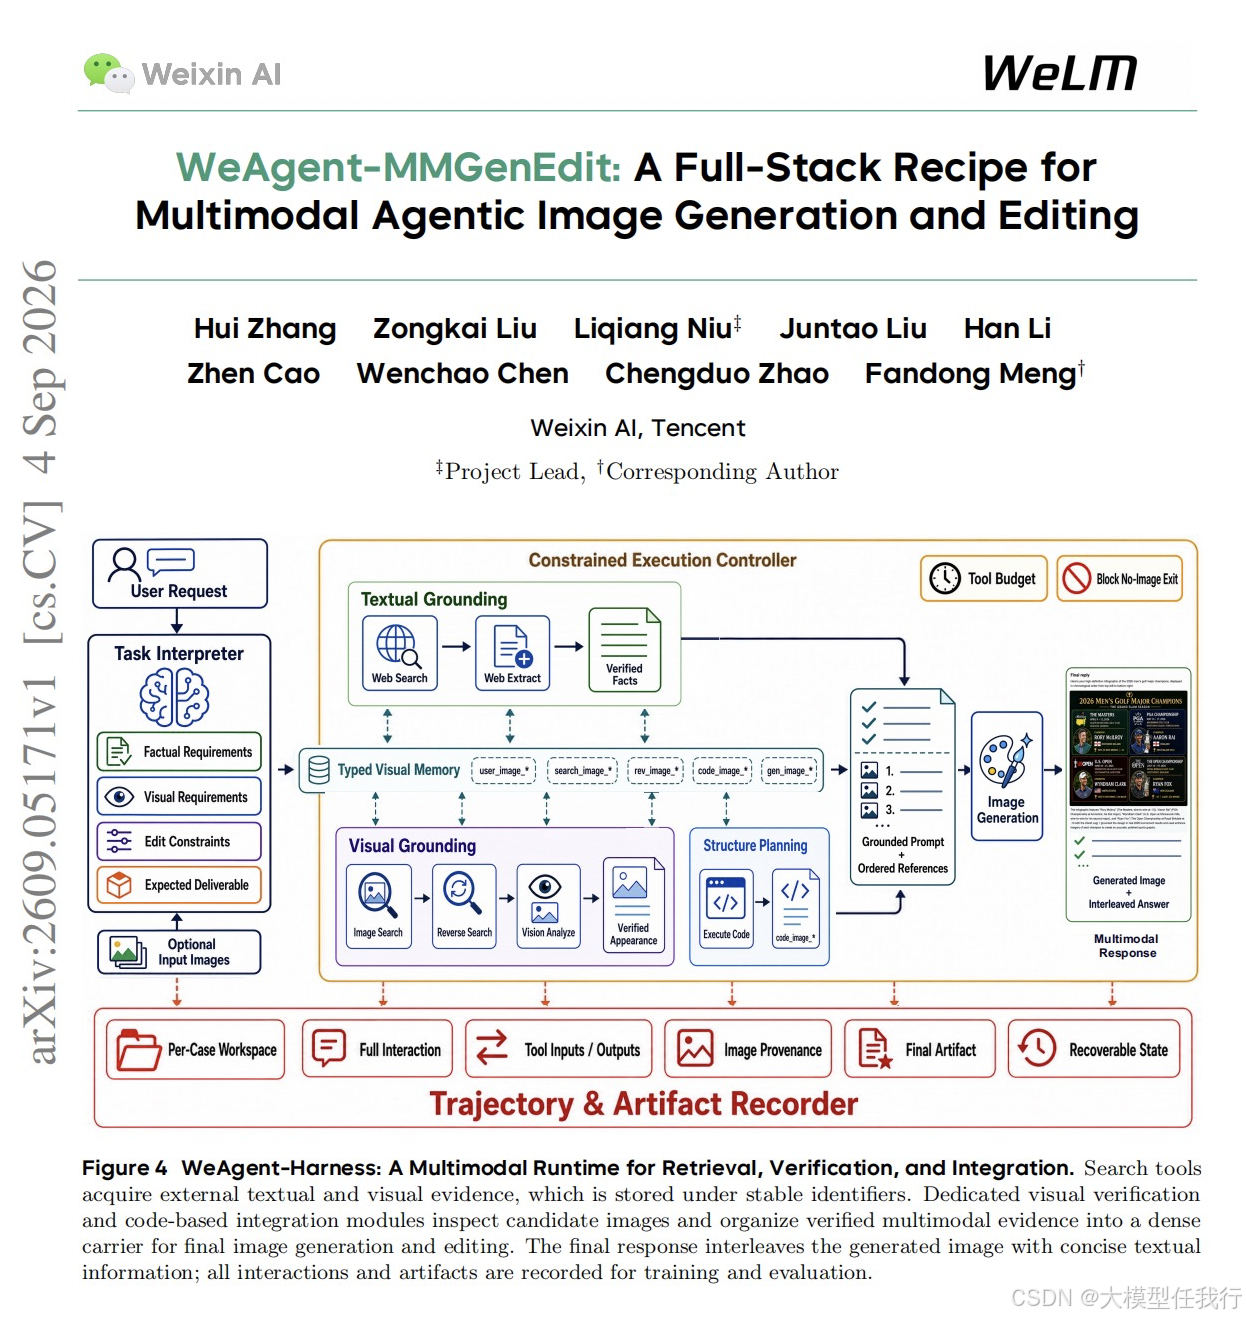
🔸设计WeAgent-Harness多模态智能体运行环境:引入检索-验证-整合-交付的工作流。利用持久化证据管理存储检索到的图文信息,通过专用工具对候选图片进行显式像素级验证,并使用代码将验证后的多模态证据整合成结构化的密集载体,解决跨模态绑定弱的问题。
🔸构建可验证的数据集与基准测试:开发WeDataset-MMGenEdit数据构建流水线,生成包含三层可验证检查清单(智能体过程、生成输入、最终图像)的任务,产出2.3万条监督微调和1.47万条强化学习任务;建立WeBench-MMGenEdit双语基准,均衡覆盖生成与多参考图编辑任务。
🔸实施双侧后训练策略:在智能体侧,先通过监督微调学习工具使用规范,再基于检查清单进行强化学习以优化证据获取与整合;在图像侧,针对多参考图编辑进行监督微调和基于多维奖励的强化学习,提升对异构视觉引用的处理能力。
🔎分析总结
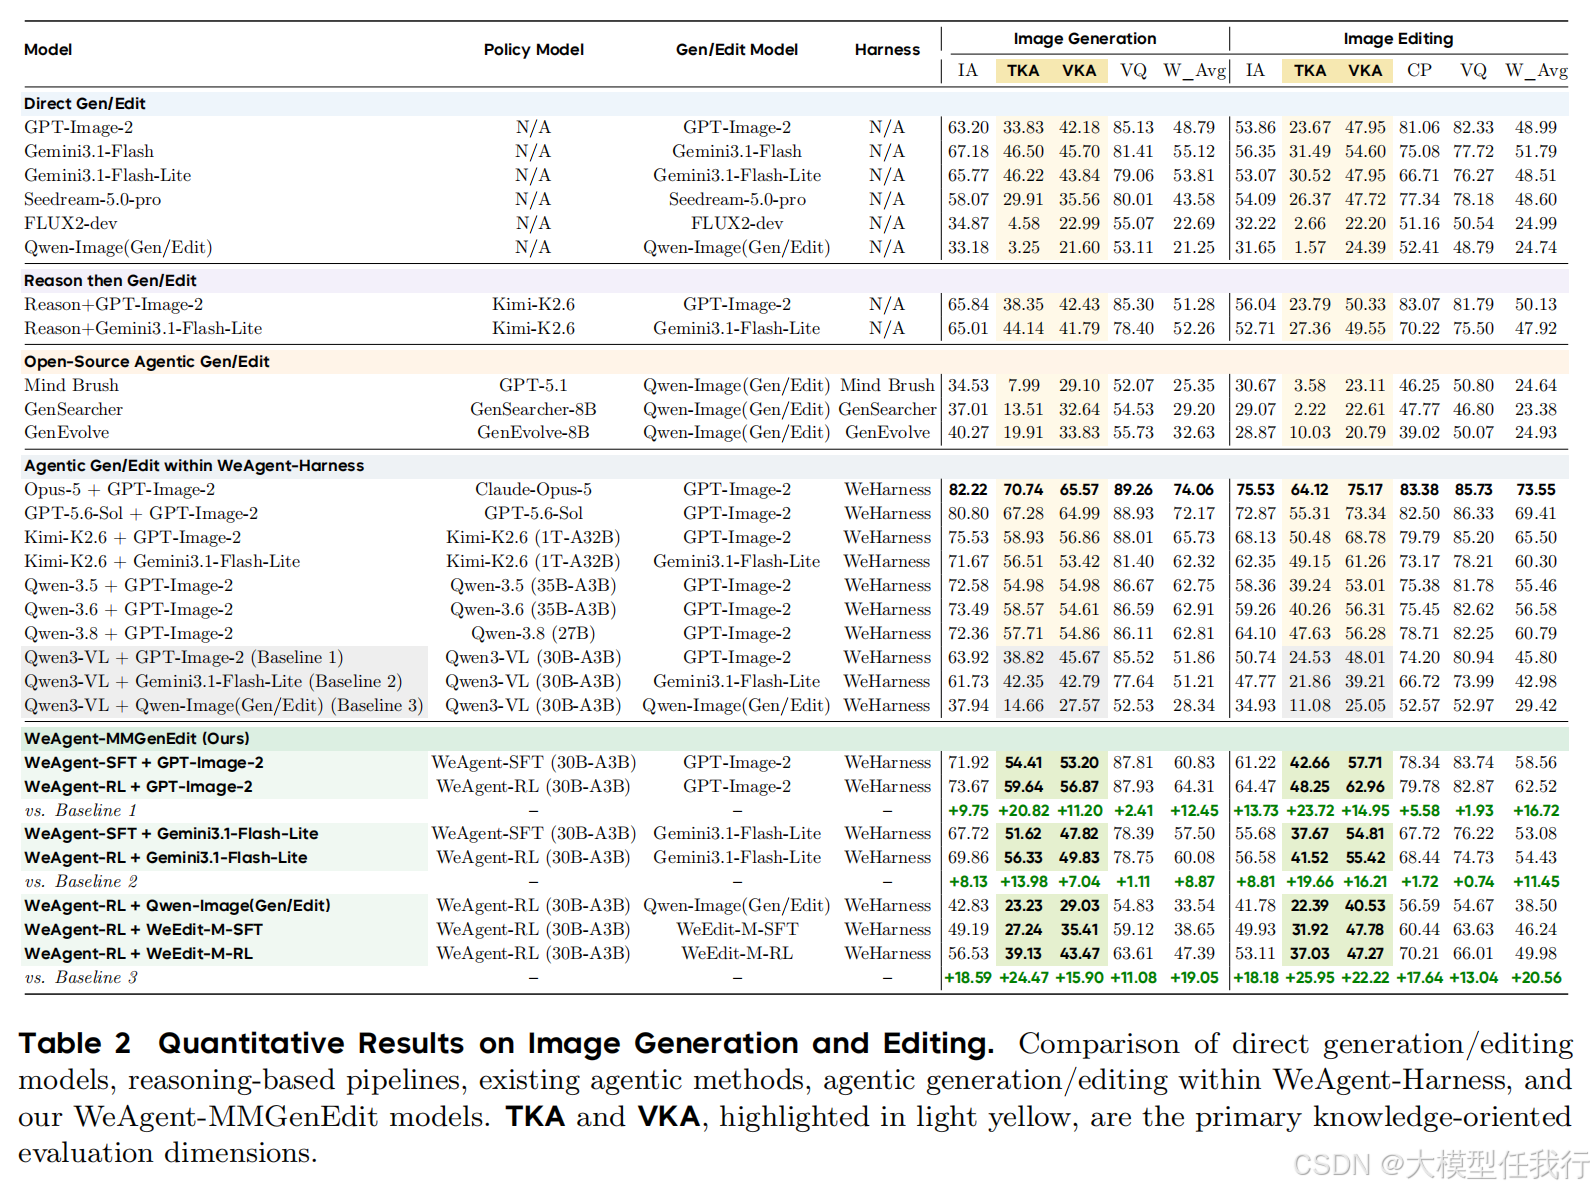
🔸实验表明,仅靠检索不足以解决问题,显式的视觉验证和结构化证据整合能带来显著性能提升,特别是在视觉知识准确性上。
🔸经过后训练的30B参数策略模型,在相同运行环境下,其表现超越了同等规模的基线模型,并接近万亿参数智能体的水平,证明了高效协作机制的有效性。
🔸图像侧的后训练进一步增强了模型对复杂参考图的遵循能力,使得最终生成的图像在指令遵循、文本准确性和视觉质量上均有大幅提高,尤其在多图像编辑任务中优势明显。
💡个人观点
论文通过工程化的“全栈”优化来解决知识幻觉问题,用代码生成的结构化载体代替了松散的图片拼接,让生成模型更容易理解布局和内容关系。