文章目录
-
- 前言
- 一、学习前置认知
-
- 1\\. 什么是DashScope?
- 2\\. 核心优势(为什么学它)
- 3\\. 核心名词扫盲(新手必懂)
- 4\\. 学习前置条件
- 二、环境搭建与账号配置
-
- 1\\. 注册登录与API\\-Key获取
- 2\\. Python SDK安装(主流开发方式)
- 3\\. 安全配置API密钥(两种方式,推荐方式二)
-
- 方式1:代码临时配置(适合本地测试)
- 方式2:环境变量配置(安全、推荐,永久生效)
- 4\\. 环境验证(必做,排查报错)
- 三、相关类和方法介绍
-
- 1. dashscope.Generation 介绍
-
- 1.1 模块概述
- 1.2 Generation 常用方法说明
- 1.3 通用请求入参对照表
- 1.4 返回结果通用属性对照表
- 2. dashscope.MultiModalConversation 介绍
-
- 2.1 模块概述
- 2.2 MultiModalConversation 常用方法说明
- 2.3 通用请求入参对照表
- 2.4 messages.content 特殊结构说明
- 2.5 返回结果通用属性对照表
- 2.6 与 Generation 核心区别对比
- 四、基础核心能力学习
-
- 1\\. 主流模型选型
- 2\\. 核心功能1:单轮对话(基础中的基础)
- 3\\. 核心功能2:多轮对话(带上下文记忆)
- 4\\. 核心功能3:流式输出(实时打字效果)
- 五、进阶核心功能
-
- 1\\. 模型参数调优(控制回答风格)
- 2\\. 多模态能力:图片理解(图文问答)
- 3\\. 结构化输出(JSON格式,适配业务开发)
- 六、实战小项目
- 七、常见报错与避坑指南(新手必备)
- 八、进阶学习方向(学完入门后的提升路线)
前言
本教程面向零基础学习者,无需大模型开发经验,从概念认知、环境搭建、基础调用,到进阶功能、项目实战、生产部署,分阶段系统化讲解DashScope(阿里云百炼大模型服务平台)核心用法,全程配套可运行代码、避坑指南和阶段任务,帮助7天完成从入门到上手实战。
一、学习前置认知
1. 什么是DashScope?
DashScope(阿里云百炼Model Studio)是阿里云官方大模型服务平台,整合通义千问全系大模型、多模态模型、智能体、知识库等能力,提供标准化API和SDK,支持快速开发对话、文生图、语音、文本理解、智能体等AI应用,是国内主流、稳定、商用友好的大模型开发平台。
2. 核心优势(为什么学它)
-
低门槛:开箱即用,无需训练模型,仅调用接口即可实现AI能力
-
模型齐全:文本、图像、语音、多模态、推理、联网搜索全品类模型
-
商用稳定:阿里云官方运维,支持高并发、流式输出、企业级权限管控
-
免费额度友好:新用户赠送免费调用额度,足够零基础学习实战
3. 核心名词扫盲(新手必懂)
-
API-Key:平台调用密钥,身份凭证,所有接口调用必备
-
Token:大模型计费单位,输入输出文本均会消耗Token
-
流式输出:逐字返回回答,适配聊天框实时打字效果
-
多模态:支持文本、图片、语音等多种输入输出形式
-
上下文窗口:模型单次可接收的最大对话文本长度
4. 学习前置条件
-
基础:Python基础语法(变量、函数、简单脚本)
-
设备:电脑一台,可联网
-
账号:阿里云账号(免费注册即可)
二、环境搭建与账号配置
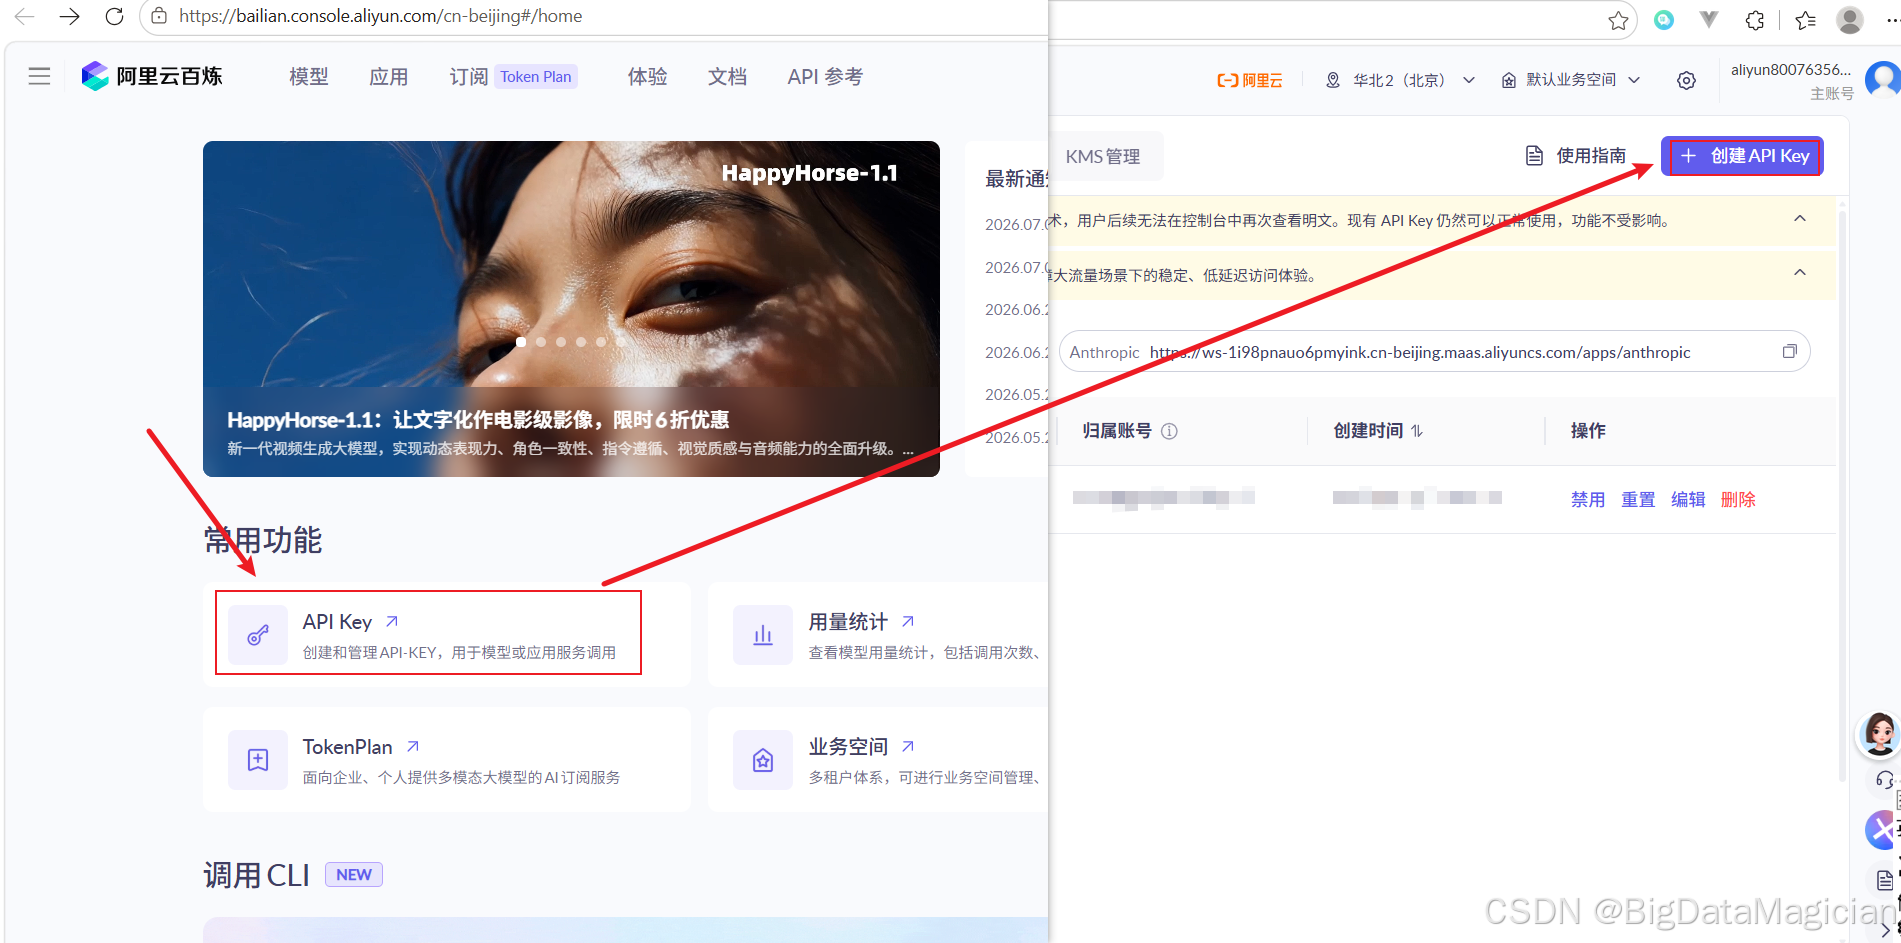
1. 注册登录与API-Key获取
步骤1:登录阿里云百炼DashScope控制台,使用阿里云账号登录
步骤2:进入「API-KEY管理」,创建新密钥,复制保存API-Key(仅展示一次)
⚠️ 重要禁忌:禁止公开、上传代码仓库、分享API-Key,避免被盗刷扣费
2. Python SDK安装(主流开发方式)
DashScope支持Python/Java/HTTP接口调用,新手优先Python,最简单易上手。
# 安装最新版SDK
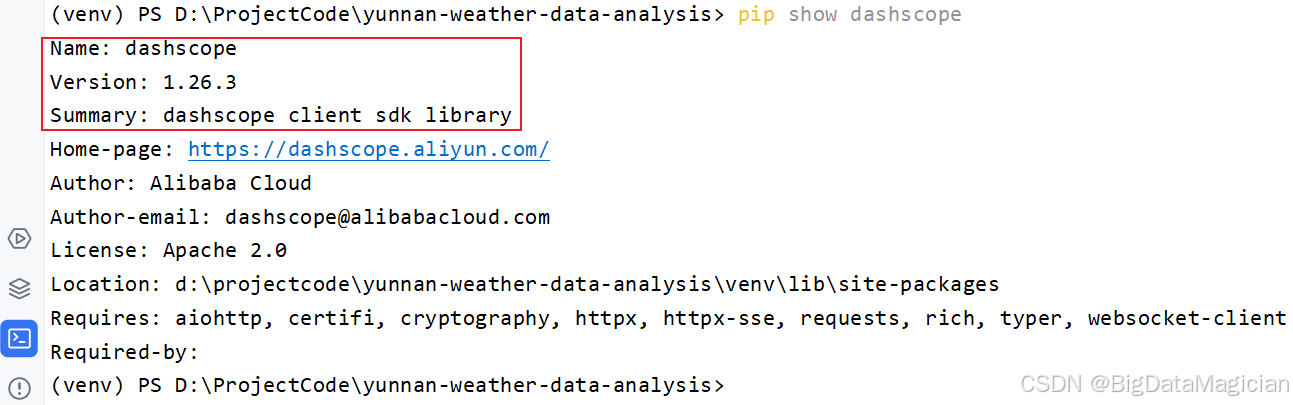
pip install -U dashscope
# 验证安装成功
pip show dashscope
3. 安全配置API密钥(两种方式,推荐方式二)
方式1:代码临时配置(适合本地测试)
import dashscope
# 替换为自己的API-Key
dashscope.api_key = "你的DashScope_API_KEY"
方式2:环境变量配置(安全、推荐,永久生效)
Windows/Linux/Mac通用,避免密钥硬编码泄露
# Mac/Linux 终端执行
export DASHSCOPE_API_KEY="你的API_KEY"
# Windows CMD执行
set DASHSCOPE_API_KEY=你的API_KEY
# Windows PowerShell执行
$env:DASHSCOPE_API_KEY="你的API_KEY"
配置后无需在代码中写密钥,SDK自动读取,安全性拉满。
4. 环境验证(必做,排查报错)
运行极简测试代码,验证环境、密钥、网络全部正常
import dashscope
from dashscope import Generation
dashscope.api_key = "api_key"
# 极简单轮对话测试
response = Generation.call(
model="qwen-max",
messages=[{"role": "user", "content": "你好,介绍一下自己"}]
)
print(response.output.text)

运行成功即代表环境搭建完成,可进入正式学习。
三、相关类和方法介绍
1. dashscope.Generation 介绍
1.1 模块概述
dashscope.Generation 是DashScope SDK中专门用于调用通义千问文本类大模型的核心类,仅处理纯文本生成任务,支持单轮问答、多轮对话、长文本续写、摘要、文案、代码生成等场景;视觉、向量、图像生成等任务需使用其他专用类。
1.2 Generation 常用方法说明
1.3 通用请求入参对照表
| model | 必填,指定调用模型 | qwen-turbo、qwen-plus、qwen-max、qwen-flash、qwen-coder-plus、qwq-32b等文本系列模型 |
| prompt | 单轮对话提示词 | 字符串,仅单轮简单提问时使用,与messages二选一 |
| messages | 多轮对话消息列表 | 数组,存储多轮历史对话,包含role(user/assistant/system)、content字段,复杂对话优先使用 |
| result_format | 结果输出格式 | text:直接返回文本;message:返回结构化消息对象,多轮对话推荐message |
| stream | 是否开启流式输出 | True开启流式,False一次性返回完整内容,默认False |
| max_tokens | 模型最大输出token数 | 整数,控制生成内容长度,数值越大生成文字越多 |
| temperature | 生成随机性系数 | 0~1区间,数值越低回答严谨、重复度低;数值越高创意越强、发散性高 |
| top_p | 核采样阈值 | 0~1区间,控制候选词范围,越小输出越固定 |
| enable_search | 是否开启联网搜索增强 | True联网补充实时信息,False仅依靠模型自有知识库 |
| system | 系统角色设定 | 字符串,用于定义模型身份、回答规则、输出格式要求 |
1.4 返回结果通用属性对照表
| code | 请求状态码,2000代表请求成功,非2000为异常 |
| output.text | 生成的完整文本内容,result_format为text时使用 |
| output.choices[0].message | 结构化对话消息,包含role、content,多轮模式使用 |
| usage.input_tokens | 输入内容消耗的token数量,用于计费统计 |
| usage.output_tokens | 输出内容消耗的token数量,用于计费统计 |
| request_id | 当前请求唯一标识,用于日志排查、问题反馈 |
2. dashscope.MultiModalConversation 介绍
2.1 模块概述
dashscope.MultiModalConversation 是DashScope SDK中多模态对话专用核心类,专门处理图文混合输入的多模态大模型调用,支持图片+文本联合提问、图像理解、OCR图文识别、图片描述、图表分析、识图问答等场景。 仅支持多模态视觉对话模型,纯文本生成请使用上方 Generation;文生图、向量嵌入等任务仍需独立专用类。 支持模型:qwen-vl、qwen-vl-plus、qwen-vl-max、qwen-vl-ocr 等全系通义视觉多模态模型。
2.2 MultiModalConversation 常用方法说明
2.3 通用请求入参对照表
| model | 必填,指定多模态模型 | qwen-vl、qwen-vl-plus、qwen-vl-max、qwen-vl-ocr 等视觉系列模型 |
| messages | 必填,多模态消息数组 | 多轮对话主体,数组内每条消息包含 role + content;content 为混合列表,可同时放文本、图片资源 |
| result_format | 返回数据格式 | text:纯文本;message:结构化消息对象,多轮对话推荐 message |
| stream | 是否开启流式输出 | True 分段返回内容;False 一次性返回完整回答,默认False |
| max_tokens | 模型最大输出token | 整数,限制识图后回答文字长度 |
| temperature | 生成随机系数 | 0~1,越低回答越客观严谨,越高创意发散性强 |
| top_p | 核采样概率阈值 | 0~1,缩小候选词汇范围,输出结果更稳定 |
| system | 系统角色设定 | 自定义模型身份、识图规则、输出格式、回答语气等全局约束 |
| enable_search | 联网搜索增强 | True 可结合图片+联网实时信息作答;False 仅基于图片与模型知识库 |
2.4 messages.content 特殊结构说明
多模态区别于纯文本Generation,content是数组,支持混合文本与图片资源,三种图片传入方式:
# 示例1:网络图片URL
content = [
{"text": "图里有什么?"},
{"image": "https://xxx/test.jpg"}
]
# 示例2:本地文件路径
content = [
{"text": "识别图片文字"},
{"image": "file:///local/xxx.png"}
]
# 示例3:Base64编码图片
content = [
{"text": "分析图表数据"},
{"image": "data:image/png;base64,xxxxxx"}
]
2.5 返回结果通用属性对照表
| code | 请求状态码,2000请求成功,其余为调用异常 |
| output.text | 完整回答文本,result_format=text时使用 |
| output.choices[0].message | 结构化对话消息,包含role、content,多轮图文对话读取此处 |
| usage.input_tokens | 输入图文总消耗token(图片会折算对应token计费) |
| usage.output_tokens | 输出回答文字消耗token |
| request_id | 请求唯一ID,用于日志排查、计费核对、官方问题反馈 |
| usage.image_tokens | 单独统计图片折算消耗的token,区分文本输入token |
2.6 与 Generation 核心区别对比
| 适用模型 | 纯文本大模型(qwen-turbo/max/coder等) | 图文多模态模型(qwen-vl系列) |
| 输入格式 | 仅字符串文本 prompt / messages 纯文本content | messages.content支持文本+图片混合资源 |
| token计费 | 仅统计文字输入输出 | 文本token + 图片单独折算image_tokens双重统计 |
| 核心场景 | 问答、文案、代码、摘要、长文本续写 | 识图、OCR、图表分析、图文问答、图片描述 |
| 特殊参数 | 无图片相关传入逻辑 | 支持URL/本地文件/Base64三种图片传入形式 |
四、基础核心能力学习
1. 主流模型选型
不用盲目选大参数模型,按需选择性价比最高的模型:
- qwen-turbo:轻量快速、低成本,适合日常测试、简单对话、入门学习
- qwen-flash:超低价格、超高并发、长上下文,适合批量文本处理、客服问答、接口压测、文本标签分类
- qwen-plus:商用主力模型,平衡速度与精度,适合绝大多数业务场景
- qwen-max:旗舰高精度模型,适合复杂推理、文案创作、专业问答、长文档分析
- qwen-max-preview:前瞻旗舰模型,推理、多语言、工具调用能力更强,适合高要求核心业务
- qwen-vl:多模态视觉模型,支持图片理解、图文问答
- qwen-vl-flash:轻量化识图模型,低成本高并发,适合简单OCR、截图文字提取、图片分类
- qwen-vl-plus:进阶视觉模型,可解析表格、PDF、多图、手写内容,适合财报识别、试卷解析、图文质检
- qwen3.5-omni:全模态模型,兼容文本、图片、音频、视频,适合实时语音对话、会议录音转写、音视频分析
- qwen-coder-plus:代码专用模型,擅长代码编写、调试、SQL生成,适合开发助手、低代码平台
- qwq-32b:深度数理推理模型,擅长高数、奥数、量化计算、逻辑证明,适合科研、数学竞赛、金融测算
- qwen-translate:专业翻译模型,多语种精准互译,适合外贸、外文文档本地化
- qwen-embedding:向量嵌入模型,用于文本向量化,适配知识库RAG检索、文档相似度匹配
- qwen-image:图像生成模型,支持文生图、图生图、高清渲染,适合海报、产品配图、插画设计
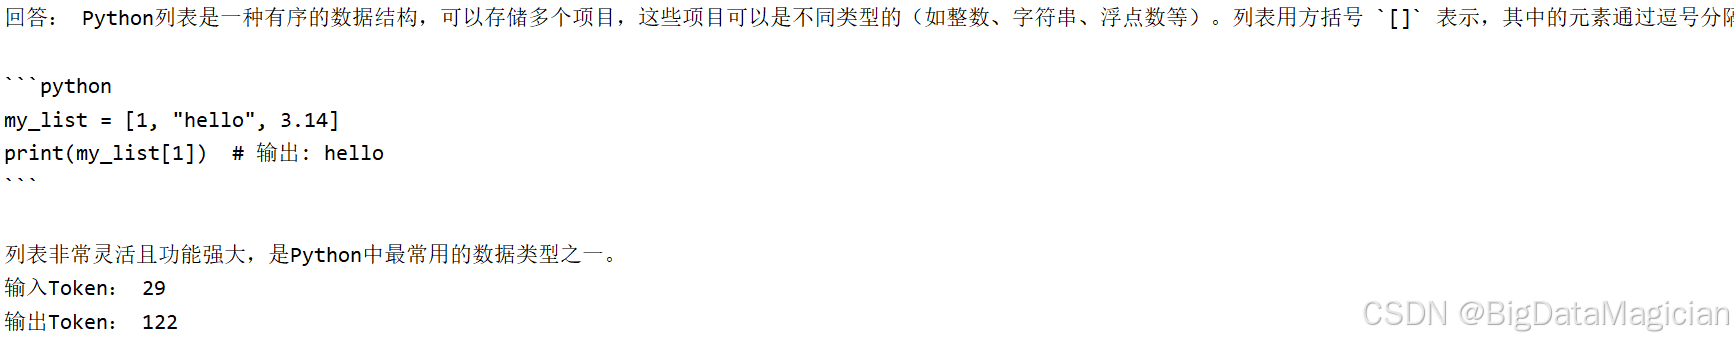
2. 核心功能1:单轮对话(基础中的基础)
单次提问单次回答,无上下文记忆,适合独立问答场景
import dashscope
from dashscope import Generation
dashscope.api_key = "api_key"
# 调用通义千问大模型 API 生成对话回复
response = Generation.call(
model="qwen-max", # 指定调用的模型版本,这里使用的是 qwen-max
messages=[ # 构建对话消息列表,支持多轮对话上下文
# 系统角色提示词(System Prompt),用于设定 AI 的行为准则和人设
{"role": "system", "content": "你是一名专业的Python助教,回答简洁易懂"},
# 用户输入的消息内容
{"role": "user", "content": "解释一下Python列表是什么"}
],
result_format="message" # 指定返回结果的格式为 message(便于后续结构化提取)
)
# 打印模型生成的文本回复内容
print("回答:", response.output.choices[0].message.content)
# 打印本次请求消耗的 Token 数量,用于监控成本和学习计费逻辑
print("输入Token:", response.usage.input_tokens) # 提示词(Prompt)消耗的 Token 数
print("输出Token:", response.usage.output_tokens) # 模型生成内容消耗的 Token 数
3. 核心功能2:多轮对话(带上下文记忆)
保存对话历史,模型可记住前文内容,适配聊天机器人场景
import dashscope
from dashscope import Generation
dashscope.api_key = "api_key"
# 初始化对话列表,用于存储多轮对话的上下文历史
# "system" 角色用于设定 AI 的全局人设和行为准则
messages = [{"role": "system", "content": "你是贴心的AI助手"}]
# ========== 第一轮对话 ==========
# 将用户的提问追加到对话列表中
messages.append({"role": "user", "content": "推荐3个Python入门项目"})
# 调用大模型 API 生成回复(使用 qwen-max 模型)
res1 = Generation.call(model="qwen-max", messages=messages)
# 打印第一轮的回答内容
print("第一轮回答:", res1.output.text)
# 将 AI 的回复也追加到对话列表中,作为下一轮对话的上下文记忆
messages.append({"role": "assistant", "content": res1.output.text})
# ========== 第二轮对话(基于上文提问) ==========
# 继续追加用户的新提问,此时 messages 中已包含完整的对话历史
messages.append({"role": "user", "content": "选最简单的一个详细说步骤"})
# 携带完整的历史上下文再次调用大模型(这里切换使用了 qwen-turbo 模型)
res2 = Generation.call(model="qwen-turbo", messages=messages)
# 打印第二轮的回答内容
print("第二轮回答:", res2.output.text)
4. 核心功能3:流式输出(实时打字效果)
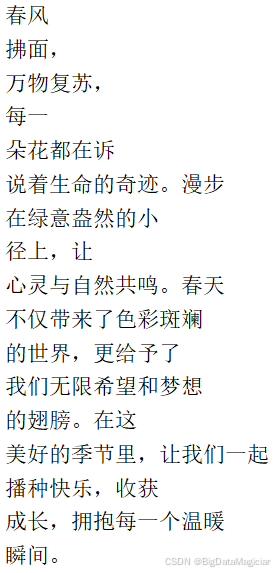
网页/小程序聊天必备,逐字返回内容,体验更流畅
import dashscope
from dashscope import Generation
dashscope.api_key = "api_key"
# 调用模型生成接口,stream=True 开启流式分段输出(打字机实时效果)
response = Generation.call(
# 指定使用qwen-max高精度旗舰模型
model="qwen-max",
# 多轮对话消息列表,role区分用户/助手角色,content为对话内容
messages=[{"role": "user", "content": "写一段100字的春日文案"}],
# 开启流式输出,返回可循环迭代的分段结果
stream=True,
# 核心修复参数:开启增量输出,每个分片只返回【新增内容】,解决文本重复打印bug
incremental_output=True,
# 设置返回结果为结构化message格式,适配多轮对话场景
result_format="message"
)
# 循环遍历流式返回的每一段文本分片
for chunk in response:
# 捕获异常,防止结构缺失报错
try:
# message格式下,真实生成文本存储位置
text = chunk.output.choices[0].message.content
if text:
print(text, end="\\n", flush=True)
except Exception:
# 无文本的空分片直接跳过
continue
print("\\n") # 生成结束自动换行
五、进阶核心功能
1. 模型参数调优(控制回答风格)
通过核心参数精准控制模型输出效果,新手必掌握:
-
temperature:随机性(0-1),越低越严谨、越高越创意
-
top_p:采样概率,控制回答多样性
-
max_tokens:限制最大输出长度
temperature 参数取值与应用场景对照表
| 0 ~ 0.2 | 极致稳定、无随机,固定最优答案,几乎无幻觉,格式不易错乱 | JSON结构化输出、数据抽取、标签分类、工具函数调用、严格公式计算、标准化翻译 | 0.3~0.7 | 必须强约束输出格式,同一prompt多次请求结果高度一致 |
| 0.2 ~ 0.5 | 严谨保守,低发散,事实优先,少量句式变化 | 知识库问答、技术文档、考题作答、摘要总结、法律/医疗严谨文案 | 0.7~0.85 | 兼顾准确与自然,适合客服知识库、专业答疑 |
| 0.5 ~ 0.7 | 平衡区间,稳定+适度灵活,通用万能配置 | 日常聊天、普通软文、产品说明、通用对话机器人、简单文案 | 0.85~0.9 | 通义千问默认常用区间,绝大多数普通业务直接用 |
| 0.8 ~ 1.0 | 高创意、句式丰富、意象发散,多样性强 | 诗歌、短文、故事、短视频脚本、广告文案、仿写、自由创作 | 0.9~0.95 | 你代码中 temperature=0.8 就属于该区间,适合文学创作 |
| 1.0 ~ 1.2 | 极高发散,脑洞大,容易出现新奇表达,逻辑轻微跳跃 | 头脑风暴、创意点子、脑洞小说、多风格仿写、多角度构思 | 0.95~0.98 | 容易出现轻微幻觉,不适合需要严谨事实的内容 |
| > 1.2 | 随机性过强,语句容易断裂、逻辑混乱、跑偏 | 极少使用,仅纯灵感发散、无逻辑限制的创意涂鸦 | 0.98~1.0 | 生产环境不推荐,仅临时灵感测试 |
快速使用口诀
top_p 参数取值区间、特征与应用场景对照表
| 0.0 ~ 0.3 | 仅选用概率最高的少量词汇,输出死板、句式单一,几乎无变化 | 固定格式JSON、数据提取、规则化分类、标准化输出 | 0.0~0.2 | 追求结果完全统一,不适合创作类需求 |
| 0.3 ~ 0.7 | 选词范围窄,用词严谨,少生僻表达,逻辑一致性强 | 专业问答、技术文档、试题解答、摘要、官方说明文 | 0.2~0.5 | 事实类场景首选,降低幻觉、减少离谱表述 |
| 0.7 ~ 0.85 | 选词适中,流畅自然,小幅句式变化,兼顾准确与可读性 | 日常客服对话、产品介绍、通用短文、普通聊天机器人 | 0.5~0.7 | 通用业务默认搭配,平衡稳定与自然度 |
| 0.85 ~ 0.95 | 开放大量候选词汇,表达丰富,意象多变,文采更强 | 诗歌、散文、故事、广告文案、短视频脚本、仿写创作 | 0.8~1.0 | 你写诗代码 top_p=0.9 属于此区间,创意场景主流配置 |
| 0.95 ~ 1.0 | 纳入全部概率词汇,生僻词、新奇句式大幅增加,逻辑易跳跃 | 头脑风暴、脑洞故事、多风格创意构思、自由文学创作 | 1.0~1.2 | 容易出现逻辑跑偏、无关内容,严谨场景禁用 |
搭配小规则
import dashscope
from dashscope import Generation
dashscope.api_key = "api_key"
# 调用通义千问生成接口,发起文本生成请求
response = Generation.call(
# 指定使用的模型:qwen-turbo 轻量高速版通义千问
model="qwen-turbo",
# 对话消息列表,遵循标准OpenAI消息格式
messages=[
{
"role": "user", # 消息角色:user 用户提问
"content": "写一首自由小诗" # 用户输入的提示词
}
],
# 温度参数,控制生成随机性/创意度,范围0~1
# 值越高随机性越强、创意更丰富;0.8适合诗歌、文案创作
temperature=0.8,
# 单次生成最大输出token数量,限制回复长度
max_tokens=300,
# 核采样阈值,控制候选词筛选范围,0.9兼顾流畅与多样性
top_p=0.9
)
# 从返回结果中取出模型生成的文本并打印输出
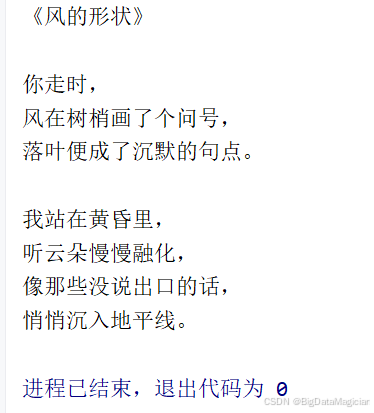
print(response.output.text)
2. 多模态能力:图片理解(图文问答)
使用qwen-vl模型,实现图片识别、图文提问、画面描述
import dashscope
from dashscope import MultiModalConversation
dashscope.api_key = "api_key"
# 构造多模态对话请求参数
# messages: 多轮对话消息列表,多模态场景固定使用该参数,支持文本+图片混合输入
messages = [
{
# 角色为用户user,代表客户端输入的提问内容
"role": "user",
# content: 多模态内容数组,可同时传入文本、图片资源(多模态核心特性)
"content": [
# 传入本地图片文件
# Windows路径注意:原生反斜杠\\需要转义为\\\\,避免代码报错
# 图片为丽江市全年夜间风力分布统计图,用于模型识图分析
{"image": "D:\\\\ProjectCode\\\\yunnan-weather-data-analysis\\\\static\\\\丽江市全部年全部月夜间风力分布.png"},
# 给模型的提问指令:要求模型识别并描述图片完整内容
{"text": "描述这张图片的内容"}
]
}
]
# 调用通义千问多模态模型同步接口
# model: 指定使用qwen-vl-plus高精度视觉多模态模型,适合图表、数据分析
# call(): 同步阻塞接口,一次性返回完整识别结果,适合单张图片离线分析
response = MultiModalConversation.call(model="qwen-vl-plus", messages=messages)
# 解析并打印模型返回结果
# choices[0].message.content:获取多模态模型结构化返回的回答文本(多轮对话标准取值方式)
print(response.output.choices[0].message.content)
[{'text': '这张图片展示了一张柱状图,标题为“丽江市全部年全部月夜间风力分布”。图表的横轴表示夜间风力的分类,纵轴表示风力的次数(单位:次)。具体描述如下:\\n\\n### 1. 图表标题\\n- **标题**:丽江市全部年全部月夜间风力分布\\n- **位置**:位于图表的顶部中央\\n- **字体**:黑色,清晰可见\\n\\n### 2. 横轴(X轴)\\n- **标签**:夜间风力\\n- **分类**:\\n – 弱风\\n – 中风\\n – 大风\\n – 强风\\n- **颜色**:\\n – 弱风:绿色\\n – 中风:橙色\\n – 大风:浅粉色\\n – 强风:紫色\\n\\n### 3. 纵轴(Y轴)\\n- **标签**:次数(次)\\n- **刻度**:从0到3000,每隔500次有一个刻度标记\\n- **颜色**:灰色线条和数字\\n\\n### 4. 数据柱状图\\n- **弱风**:\\n – 颜色:绿色\\n – 高度:接近3000次\\n – 数值:2943次\\n- **中风**:\\n – 颜色:橙色\\n – 高度:约为1200次\\n – 数值:1221次\\n- **大风**:\\n – 颜色:浅粉色\\n – 高度:非常低,几乎接近0\\n – 数值:1次\\n- **强风**:\\n – 颜色:紫色\\n – 高度:极低,几乎不可见\\n – 数值:7次\\n\\n### 5. 整体分析\\n- **风力分布**:\\n – **弱风**是最常见的夜间风力类型,占据了绝大多数的记录(2943次),表明在丽江市的夜间,大多数时间风力较弱。\\n – **中风**次之,有1221次,虽然比弱风少,但仍然是一个显著的类别。\\n – **大风**和**强风**出现的频率极低,分别只有1次和7次,说明在丽江市的夜间,大风和强风是非常罕见的现象。\\n\\n### 6. 视觉特点\\n- **颜色对比**:不同风力类型的柱状图使用了不同的颜色,使得分类一目了然。\\n- **数值标注**:每个柱状图上方都标注了具体的数值,方便读者快速获取数据。\\n- **简洁明了**:图表设计简洁,没有多余的装饰,专注于数据的展示。\\n\\n### 7. 结论\\n这张图表清晰地展示了丽江市夜间风力的分布情况,弱风是主导因素,而大风和强风极为罕见。这对于了解丽江市的气候特征和制定相关计划(如户外活动安排、能源管理等)具有重要意义。'}]
3. 结构化输出(JSON格式,适配业务开发)
强制模型返回JSON格式数据,方便后端解析、入库、对接业务
import dashscope
from dashscope import Generation
dashscope.api_key = "api_key"
prompt = "帮我生成3个学生信息,包含姓名、年龄、特长,严格返回JSON格式,不要多余文字"
response = Generation.call(
model="qwen-plus",
messages=[{"role": "user", "content": prompt}],
result_format="json",
temperature=0.2,
)
print(response.output.choices[0].message.content)
六、实战小项目
零基础可落地项目:轻量化AI聊天机器人(带上下文+流式输出)
import dashscope
from dashscope import Generation
dashscope.api_key = "api_key"
def ai_chat():
"""
通义千问多轮流式对话函数
功能:支持连续上下文对话、实时打字机流式输出、记忆历史对话
"""
# 初始化对话列表:system角色用于定义AI全局人设与回答规范
messages = [{"role": "system", "content": "你是专业、耐心的AI助手,回答简洁清晰"}]
# 程序启动提示
print("AI助手已启动,输入exit退出对话")
# 循环对话,实现持续人机交互
while True:
# 获取用户输入内容
user_input = input("我:")
# 退出逻辑:输入exit(不区分大小写)结束对话
if user_input.lower() == "exit":
print("对话结束")
break
# 将用户本轮提问加入对话上下文,实现多轮记忆
messages.append({"role": "user", "content": user_input})
# 调用通义千问文本大模型 同步流式接口
response = Generation.call(
model="qwen-turbo", # 指定调用模型:轻量高效的通义千问turbo模型
messages=messages, # 传入完整对话历史,维持上下文连贯性
stream=True, # 开启流式输出:分片返回结果,实现实时打字效果
incremental_output=True # 核心修复参数:开启增量输出,每个分片只返回【新增内容】,解决文本重复打印bug
)
# 打印AI开头标识,不自动换行
print("AI:", end="")
# 定义变量,用于拼接完整AI回复,存入上下文
full_reply = ""
# 遍历流式迭代器,逐段接收模型输出内容
for chunk in response:
# 取出当前分片的新增文本内容
text = chunk.output.text
# 累加分片内容,拼接成完整回答
full_reply += text
# 实时逐字打印,flush=True强制刷新缓冲区,实现无缝打字机效果
print(text, end="", flush=True)
# 单轮对话结束,换行分隔下一轮对话
print()
# 将AI完整回复加入上下文列表
# 关键:必须存储assistant回复,否则模型遗忘历史,无法多轮对话
messages.append({"role": "assistant", "content": full_reply})
# 程序入口
if __name__ == "__main__":
ai_chat()
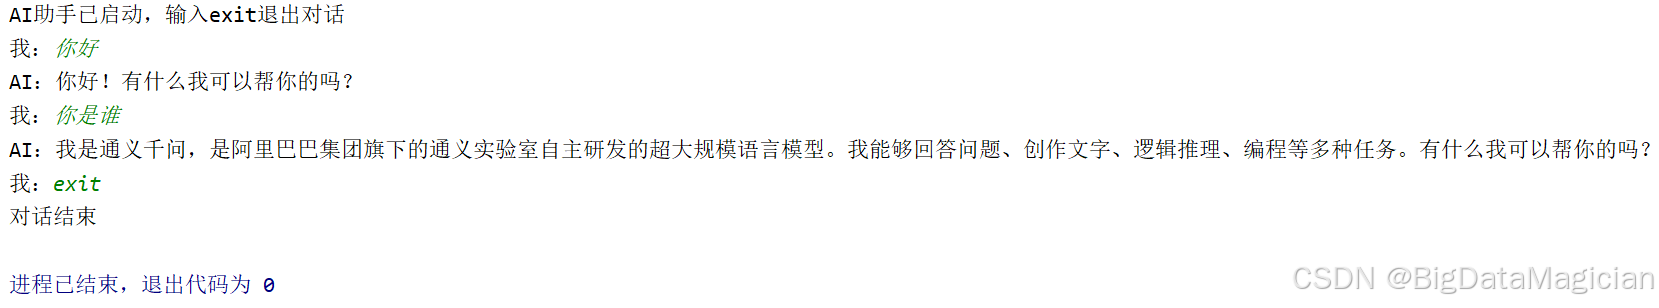
项目效果:实现连续对话、实时流式输出,完整复刻基础聊天机器人能力。
七、常见报错与避坑指南(新手必备)
-
报错401:API-Key错误/过期/未配置,重新核对密钥、重启环境变量
-
报错429:调用频次超限,降低调用速度或申请额度提升
-
无输出内容:网络代理问题,关闭科学上网工具重试
-
上下文失效:未保存assistant回复,多轮对话必须完整追加上下文
-
扣费异常:优先使用turbo模型测试,避免高频调用max旗舰模型
八、进阶学习方向(学完入门后的提升路线)
智能体开发:学习DashScope Agent,实现自动规划、工具调用、联网搜索
知识库问答:对接私有文档,实现企业专属AI问答机器人
微调模型:基于自有数据微调通义千问,适配专属业务场景
批量任务开发:批量文本分类、摘要、翻译自动化处理
Web部署:结合FastAPI/Flask搭建接口服务,对接前端页面