Pipeline Parallel 深入解析:模型装下了,为什么 GPU 还在等
TL;DR
- 场景:模型按层切到多张 GPU,服务能起,监控里部分 GPU 仍长时间空闲。
- 结论:按层切分只解决容量,不解决顺序依赖。请求仍要依次穿过各 PP 阶段,首个结果仍是各阶段耗时之和;只有当多个独立工作单元都已就绪,流水线才能让多个阶段同时忙起来。在线自回归 Decode 下,同一序列的未来 Token 未知,不存在可重叠的工作,必须借助其他已满足依赖的请求。气泡是阶段时间槽的空闲比例(p=4,m=4 时 12/28 ≈ 43%),不是 nvidia-smi 的 GPU 利用率。三类等待对应不同动作:任务供给 / 阶段不均衡 / 边界传输;任何重分区或加并发前都要回答"是哪一类"。节点内 TP×跨节点 PP 是 vLLM 文档给出的常见做法,但参数不能证明 Rank→Stage→节点→GPU 映射与通信路径实际正确。
- 产出:4 阶段一次前向 20 ms 的顺序依赖 + 4 微批次整批 35 ms 气泡 12/28≈43% 的理想算例 + GPipe Figure 2© 与本文纯前向算例的对照 + 三类等待的诊断与动作对应表 + TP×PP 拓扑放置核对清单。
版本矩阵
| vLLM main 分支 Llama 实现可访问 | ✅ 已验证 | https://github.com/vllm-project/vllm/blob/main/vllm/model_executor/models/llama.py 返回 HTTP 200 |
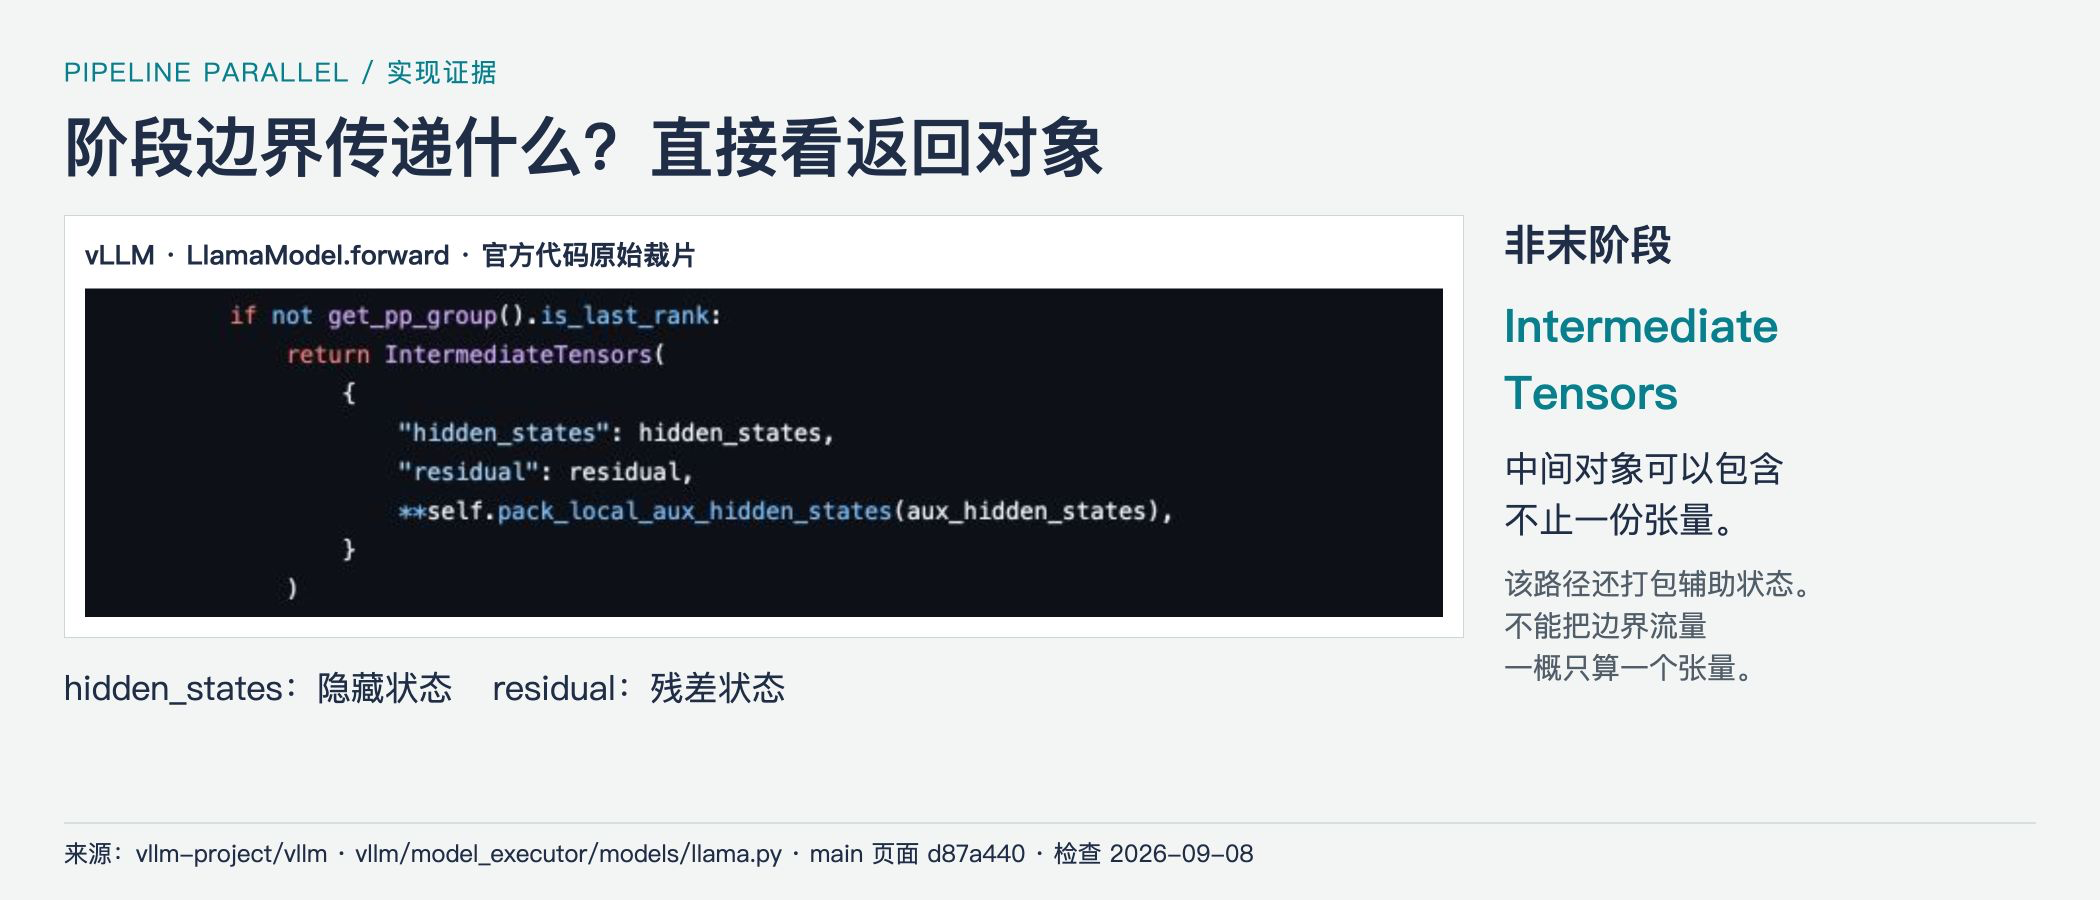
| LlamaModel.forward 非末阶段返回 IntermediateTensors | ✅ 已验证 | 贴图忠实摘录官方代码原始截片 |
| IntermediateTensors 包含 hidden_states + residual | ✅ 已验证 | 贴图忠实摘录 |
| 某些路径打包辅助状态(pack_local_aux_hidden_states) | ✅ 已验证 | 贴图忠实摘录 |
| 末阶段单独做最终归一化 | ✅ 已引用 | vLLM 实现中末阶段创建输出头 |
| GPipe 论文 arxiv 1811.06965v5 可访问 | ✅ 已验证 | https://arxiv.org/html/1811.06965v5 返回 HTTP 200 |
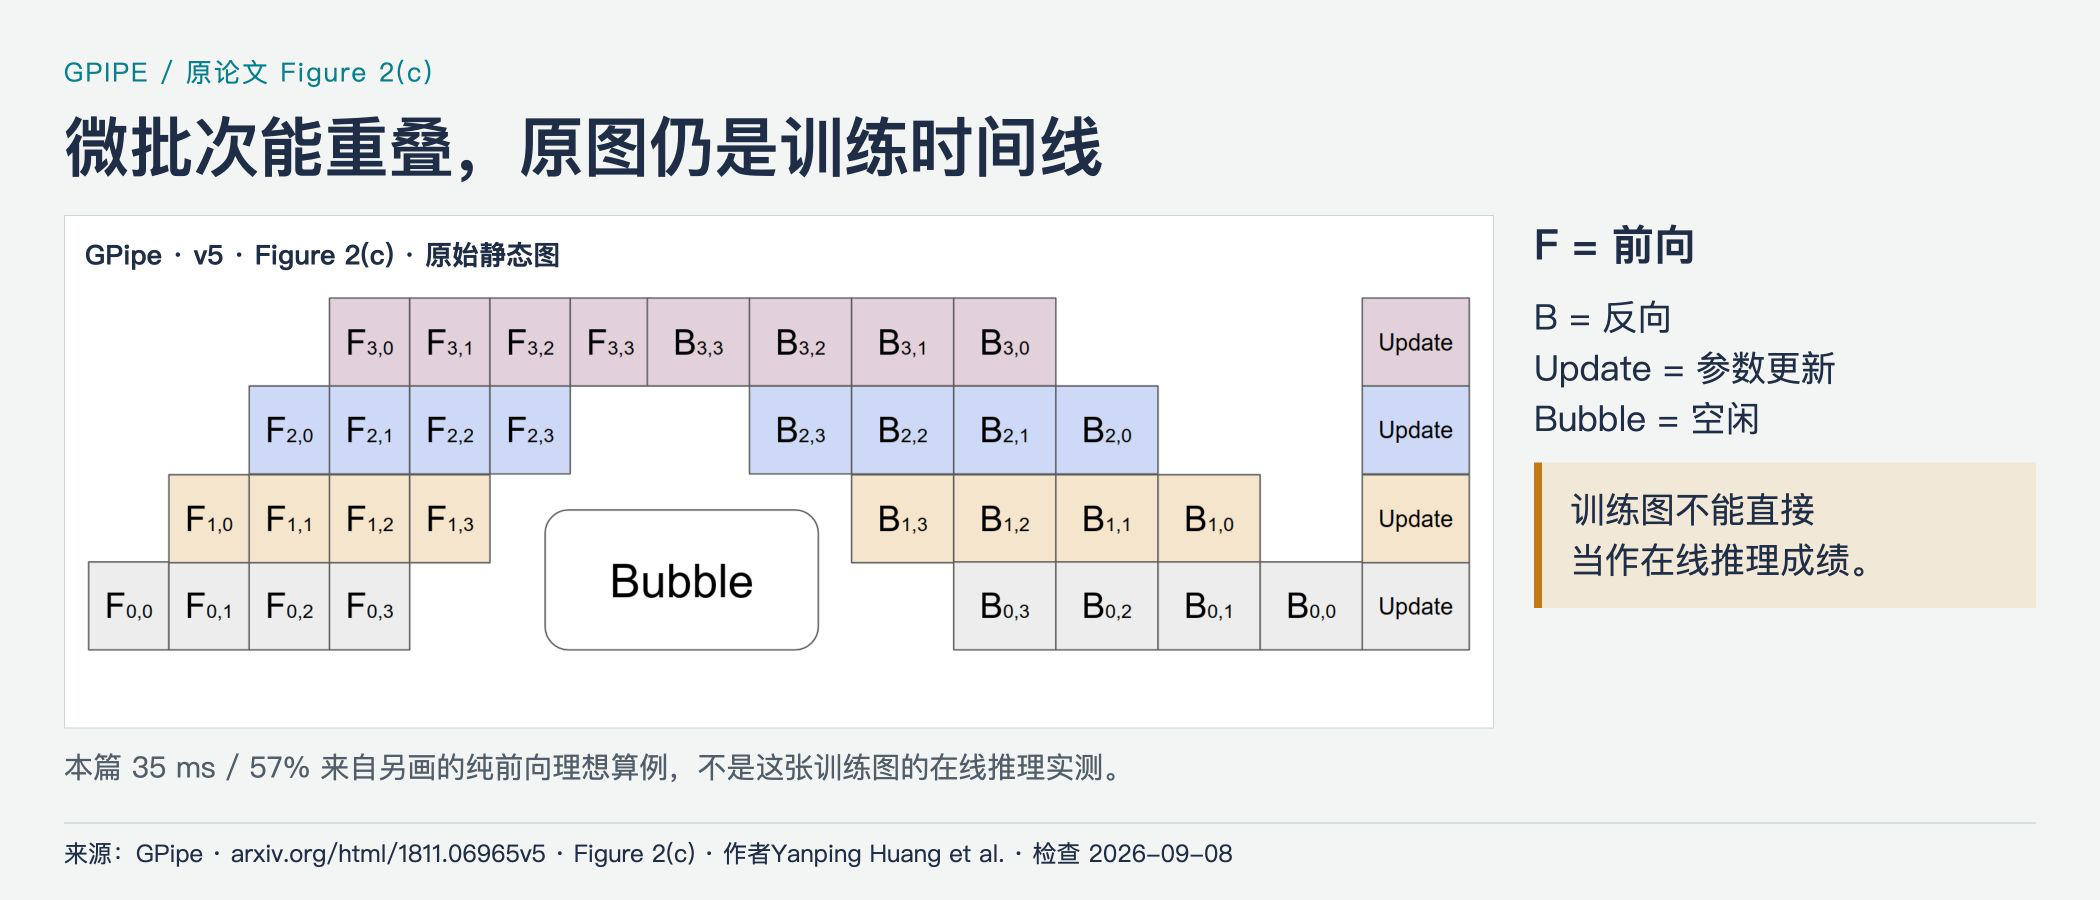
| GPipe Figure 2© 按阶段切分与微批次流水 | ✅ 已引用 | 论文第 2.3 节与 Figure 2;含反向与参数更新 |
| PyTorch Pipeline Schedules 2.14 可访问 | ✅ 已验证 | https://docs.pytorch.org/docs/2.14/distributed.pipelining.html#pipeline-schedules 返回 HTTP 200 |
| Stage 与 Schedule 分开 | ✅ 已引用 | PyTorch 文档结构 |
| 1F1B / GPipe 等含反向策略不能直接搬入纯推理 | ✅ 已引用 | 文档说明 |
| vLLM Parallelism and Scaling 文档可访问 | ✅ 已验证 | https://docs.vllm.ai/en/stable/serving/parallelism_scaling/ 返回 HTTP 200 |
| 节点内 TP、跨节点 PP 的常见做法 | ✅ 已验证 | 贴图忠实摘录官方段落 |
| 4 阶段 5 ms 一次前向 20 ms 算例 | ✅ 已设计 | 作者手算示例;不是 GPU 实测 |
| 4 微批次整批 35 ms 气泡 43% 算例 | ✅ 已设计 | 等速阶段、忽略通信与调度、非同一请求的未来 Token |
| (m+p-1)×t 与 (p-1)/(m+p-1) 公式 | ✅ 已引用 | 纯前向填充与排空模型;成立条件明确 |
| 阶段不均衡 4/11/5 ms 间隔 11 ms | ✅ 已设计 | 确定性模型瓶颈判断;非吞吐估算 |
| 边界传输 4096×8192×2 = 64 MiB | ✅ 已设计 | 单张量字节数,非网络实测 |
| 三类等待诊断表(输入稀疏 / 某段更慢 / 收发事件) | ✅ 已设计 | 观察 / 核对证据 / 下一步候选 |
| 2 节点 × 每节点 4 卡 TP=4、PP=2 拓扑 | ✅ 已设计 | 一个模型副本用 8 卡;非部署实测 |
| 7 张配图 URL 全部可访问 | ✅ 已验证 | i-blog.csdnimg.cn/img_convert/… 全部 200 |
| 资料复核日期 2026-09-08 | ✅ 已标注 | 图上保留"检查 2026-09-08"标签 |
| PP 把等待时间变短 | ❌ 已驳斥 | PP 加速的是连续完成,不是取消先后依赖;首个结果仍是各阶段耗时之和 |
| PP 缓解首 Token 延迟 | ❌ 已驳斥 | 同一序列未来 Token 未知,PP 不直接降低逐 Token 等待 |
| 气泡 = GPU 利用率 | ❌ 已驳斥 | 气泡是阶段时间槽空闲比例,不是 nvidia-smi 显示值 |
| Prefill 长 = 自然填满流水线 | ❌ 已驳斥 | 引擎能否切块、调度与依赖关系决定能否重叠 |
| 4 阶段 ÷ 4 任务 = 25% 等待 | ❌ 已驳斥 | 理想算例空闲槽比例 (p-1)/(m+p-1)=3/7≈43% |
| 一次前向 = 客户端首 Token 延迟 | ❌ 已驳斥 | 首 Token 还含排队、输入处理、采样、返回路径 |
| 边界只有一个张量 | ❌ 已驳斥 | IntermediateTensors 还含 residual 与辅助状态 |
| 60% GPU 利用率 = 服务快 | ❌ 已驳斥 | 平均利用率不替代时间线 |
| 平均阶段耗时即完成间隔 | ❌ 已驳斥 | 间隔受最慢阶段限制 |
| 离线批处理吞吐 = 在线晚间吞吐 | ❌ 已驳斥 | 任务供给不同;不能借批处理成绩 |
| 投机解码可填普通路径 | ❌ 已驳斥 | 投机解码是特殊路径,需单独分析 |
| TP×PP 总进程数 = TP × PP | ❌ 已驳斥 | 混合并行时不要把 TP×PP 当作所有辅助进程的数量公式 |
| 看到 GPU 空闲就加并发 | ❌ 已驳斥 | 可能把设备等待变成用户排队 |
| 传输慢 = 加大阶段切分 | ❌ 已驳斥 | 切分增多可能拉低流水线负载、放大填充等待 |
| 重分区前只看平均利用率 | ❌ 已驳斥 | 必须按目标负载做阶段剖析 |
| 首尾阶段负担轻 | ❌ 已驳斥 | 首尾可能多出 Embedding、最终归一化、输出头;权重绑定等条件 |
文章正文
模型已经按层分到多张 GPU 上,服务也能启动,监控里却仍有卡长时间空闲。多张 GPU 分摊同一层计算时,要付出归约和同步的代价。如果高频通信跨过了较慢的连接,把整段层放到同一组 GPU,再把中间结果传给下一组,能不能更划算?
这就是 Pipeline Parallel(流水线并行,简称 PP)值得比较的原因。但"按层切开后能启动"只回答了容量问题。一个请求仍要依次穿过各段模型,后面的 GPU 可能在等输入,前面的 GPU 也可能在等下一轮生成。通信少了,等待未必少。
本文沿着一个请求的时间线,解释 PP 的并行收益从哪里来,再把同样的等待拆成三类:暂时没有可推进的任务、某个阶段算得慢、阶段边界传得慢。文中的毫秒与字节数都是明确假设下的手算,没有 GPU 跑分,也不代表某个某个引擎的实测表现。
模型分成四段,一个请求仍要走完四段
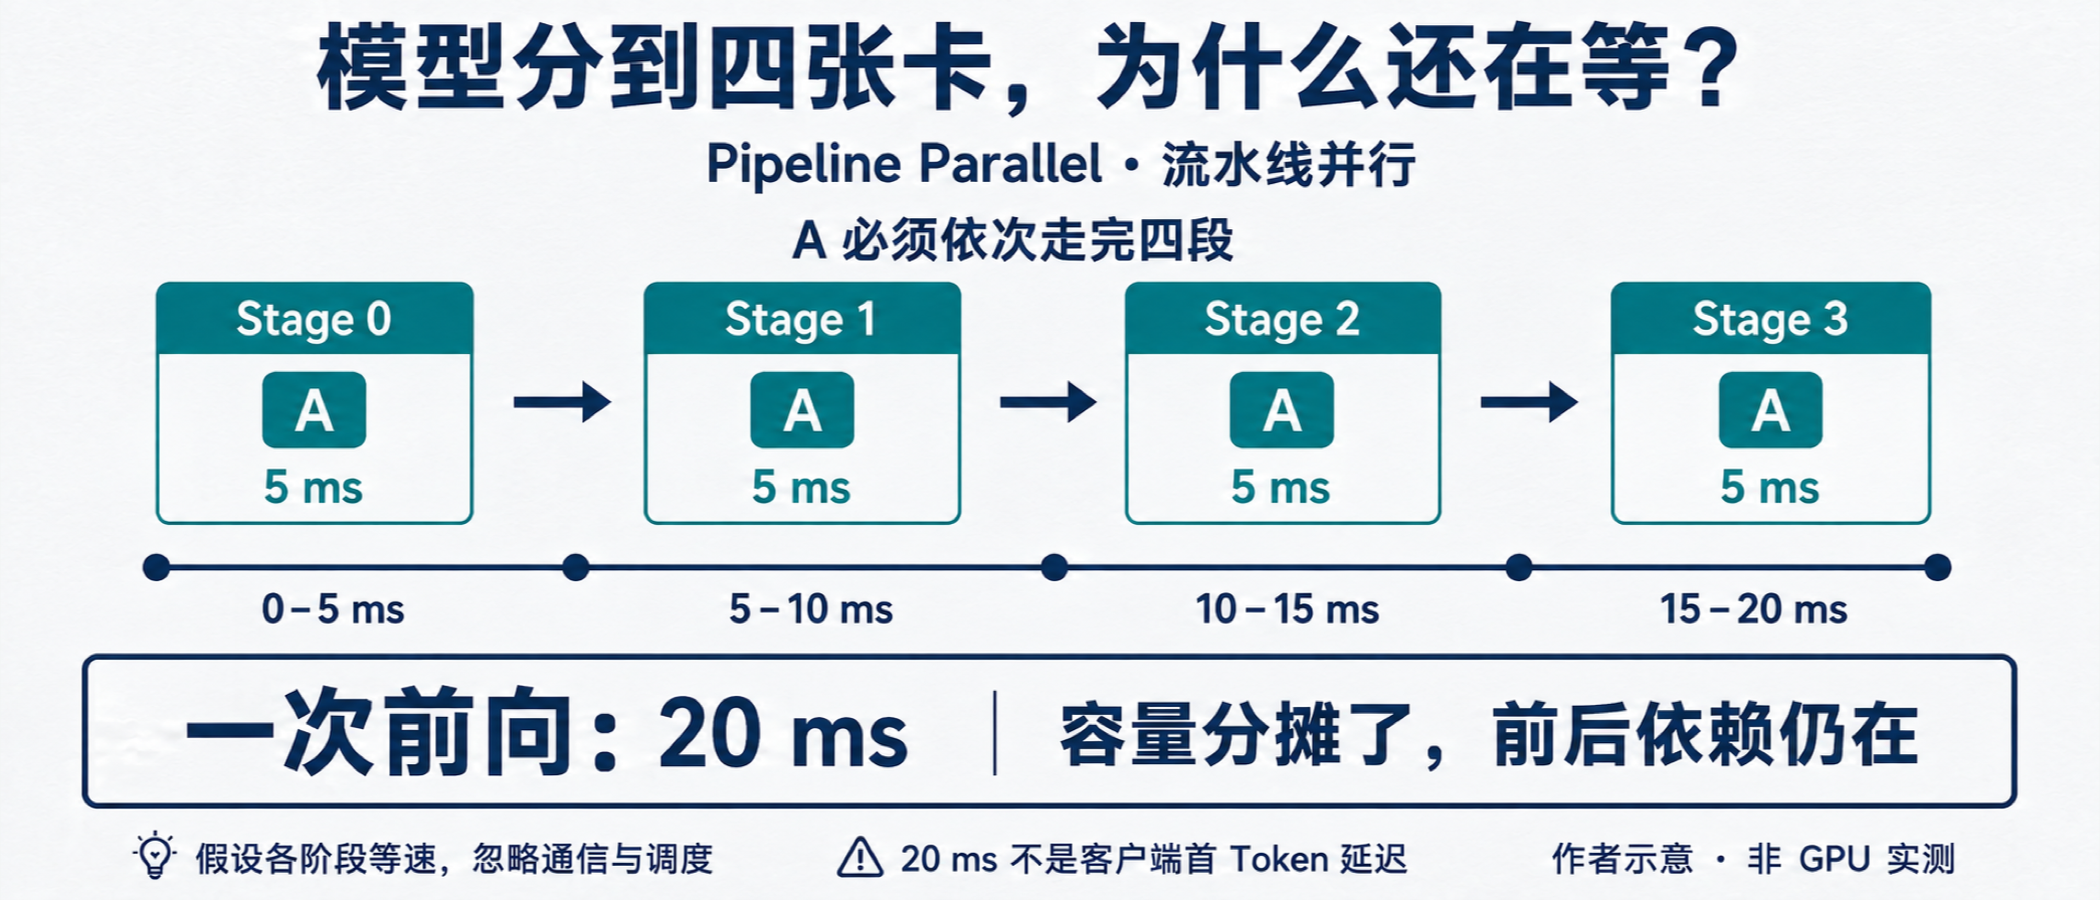
先假设一个只有顺序解码层的模型共有 40 层,把它切成四个 Stage(阶段)。这里暂不讨论复杂的跨层连接,也不把层数当作真实分区建议。
Stage 0:Embedding + Layer 0–9
Stage 1:Layer 10–19
Stage 2:Layer 20–29
Stage 3:Layer 30–39 + 最终归一化 / 输出头
一次前向:输入 → Stage 0 → Stage 1 → Stage 2 → Stage 3 → 输出
每个阶段主要持有自己负责的模型部分。阶段边界传递的是后续计算需要的中间张量,并非把整个模型或全部历史 KV Cache 再传一遍。普通按层切分的解码器中,某一层的 KV Cache 也由执行这一层的阶段管理。
这不是说边界上永远只有一个张量。当前 vLLM 的 Llama 实现中,非末阶段会返回 IntermediateTensors,其中包含 hidden_states 和 residual,某些路径还带辅助状态。代码按 start_layer、end_layer 执行本阶段的层,末阶段再做最终归一化。这些具体对象比"上一张卡把结果发给下一张卡"更接近真实实现。vLLM Llama 实现
如果这次前向在四个阶段各花 5 ms,先忽略通信与调度,那么结果要在 20 ms 后才能出来。Stage 0 算完以后,不能替 Stage 3 提前完成最后几层。四张卡的容量相加,不意味着这一次前向的延迟自动变成四分之一。
这里的 20 ms 是该假设下的一次前向时间,既不是完整请求耗时,也不是客户端首 Token 延迟。真实首 Token 等待还包含排队、输入处理、Prefill、采样和返回路径。先分清测量边界,后面看到"GPU 在等"时,才不会把所有等待都归因给流水线。
流水线加快的是连续完成,不是取消先后依赖
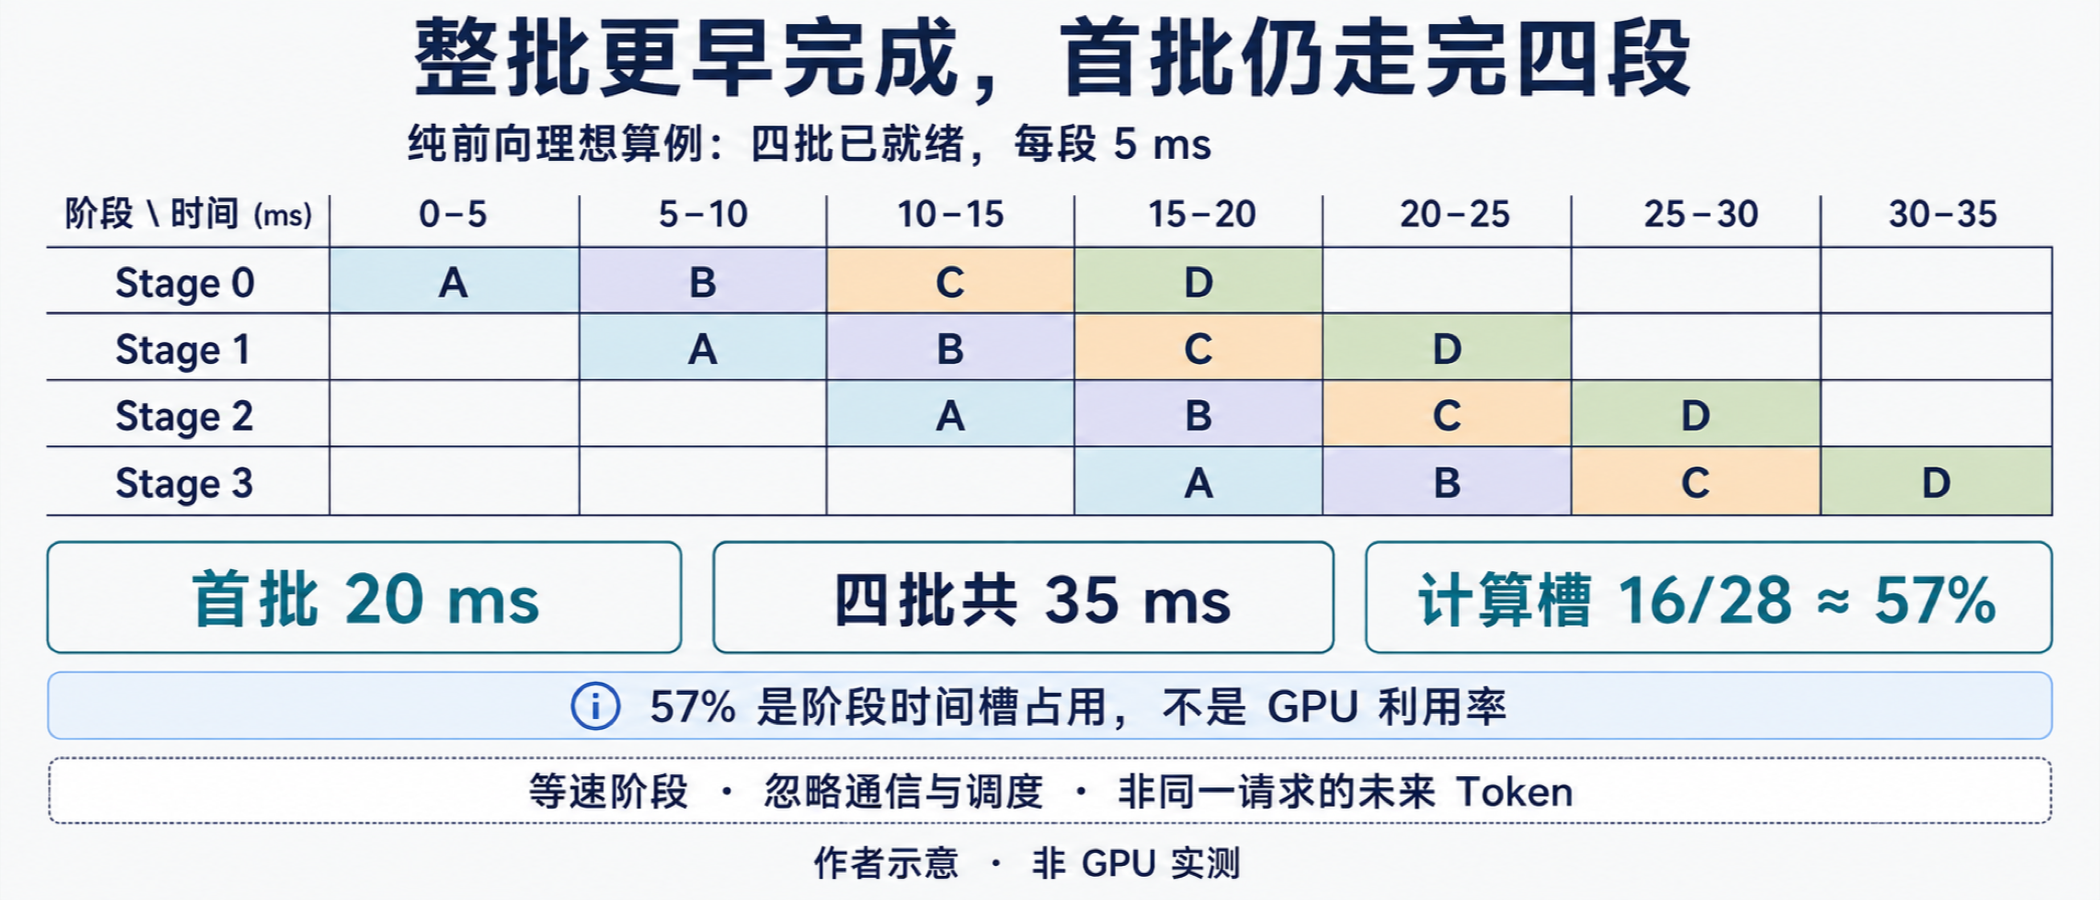
只有一个任务时,阶段轮流工作。要让四个阶段同时忙起来,需要有多个可独立推进的工作单元。为方便手算,假设调度器已经准备好 A、B、C、D 四个等大小微批次,每个阶段处理一个微批次都恰好需要 5 ms。这里的微批次是一次前向的工作单元,不是同一个请求尚未生成的四个未来 Token。
| 0–5 ms | A | 空闲 | 空闲 | 空闲 |
| 5–10 ms | B | A | 空闲 | 空闲 |
| 10–15 ms | C | B | A | 空闲 |
| 15–20 ms | D | C | B | A |
| 20–25 ms | 空闲 | D | C | B |
| 25–30 ms | 空闲 | 空闲 | D | C |
| 30–35 ms | 空闲 | 空闲 | 空闲 | D |
第一个结果仍在 20 ms 出现,后面三个结果每隔 5 ms 完成一个。四个工作单元全部完成需要 35 ms,而不是将每个 20 ms 的前向完全串行执行所需的 80 ms。缩短的是这一组任务的总完成时间,第一个任务并没有因此跳过任何阶段。
这个理想模型共有 4×7=28 个"阶段×时间槽",实际计算占 4×4=16 个,平均计算占用为 16/28,约 57%。其余时间槽就是这里所说的气泡。它不是 nvidia-smi 的 GPU 利用率预测:真实内核、通信重叠和采样周期都不在模型里。
推广到 p 个等速阶段、m 个同时准备好的等大小微批次,每阶段耗时 t,纯前向的填充与排空模型给出:
总完成时间 = (m + p – 1) × t
平均计算占用 = m / (m + p – 1)
空闲槽比例 = (p – 1) / (m + p – 1)
成立条件包括:阶段等速、任务充足、通信可忽略、每阶段只处理一个微批次,以及没有额外资源争用。GPipe 原论文 Figure 2 展示了按阶段切分与微批次流水,讨论气泡和分区均衡。不过论文讨论的是训练,还包含反向传播与梯度更新。这里单独画出纯前向算例,不能把论文训练效率直接当作在线推理性能。GPipe Figure 2 与第 2.3 节
在线生成最难补齐的,是下一份可运行的工作
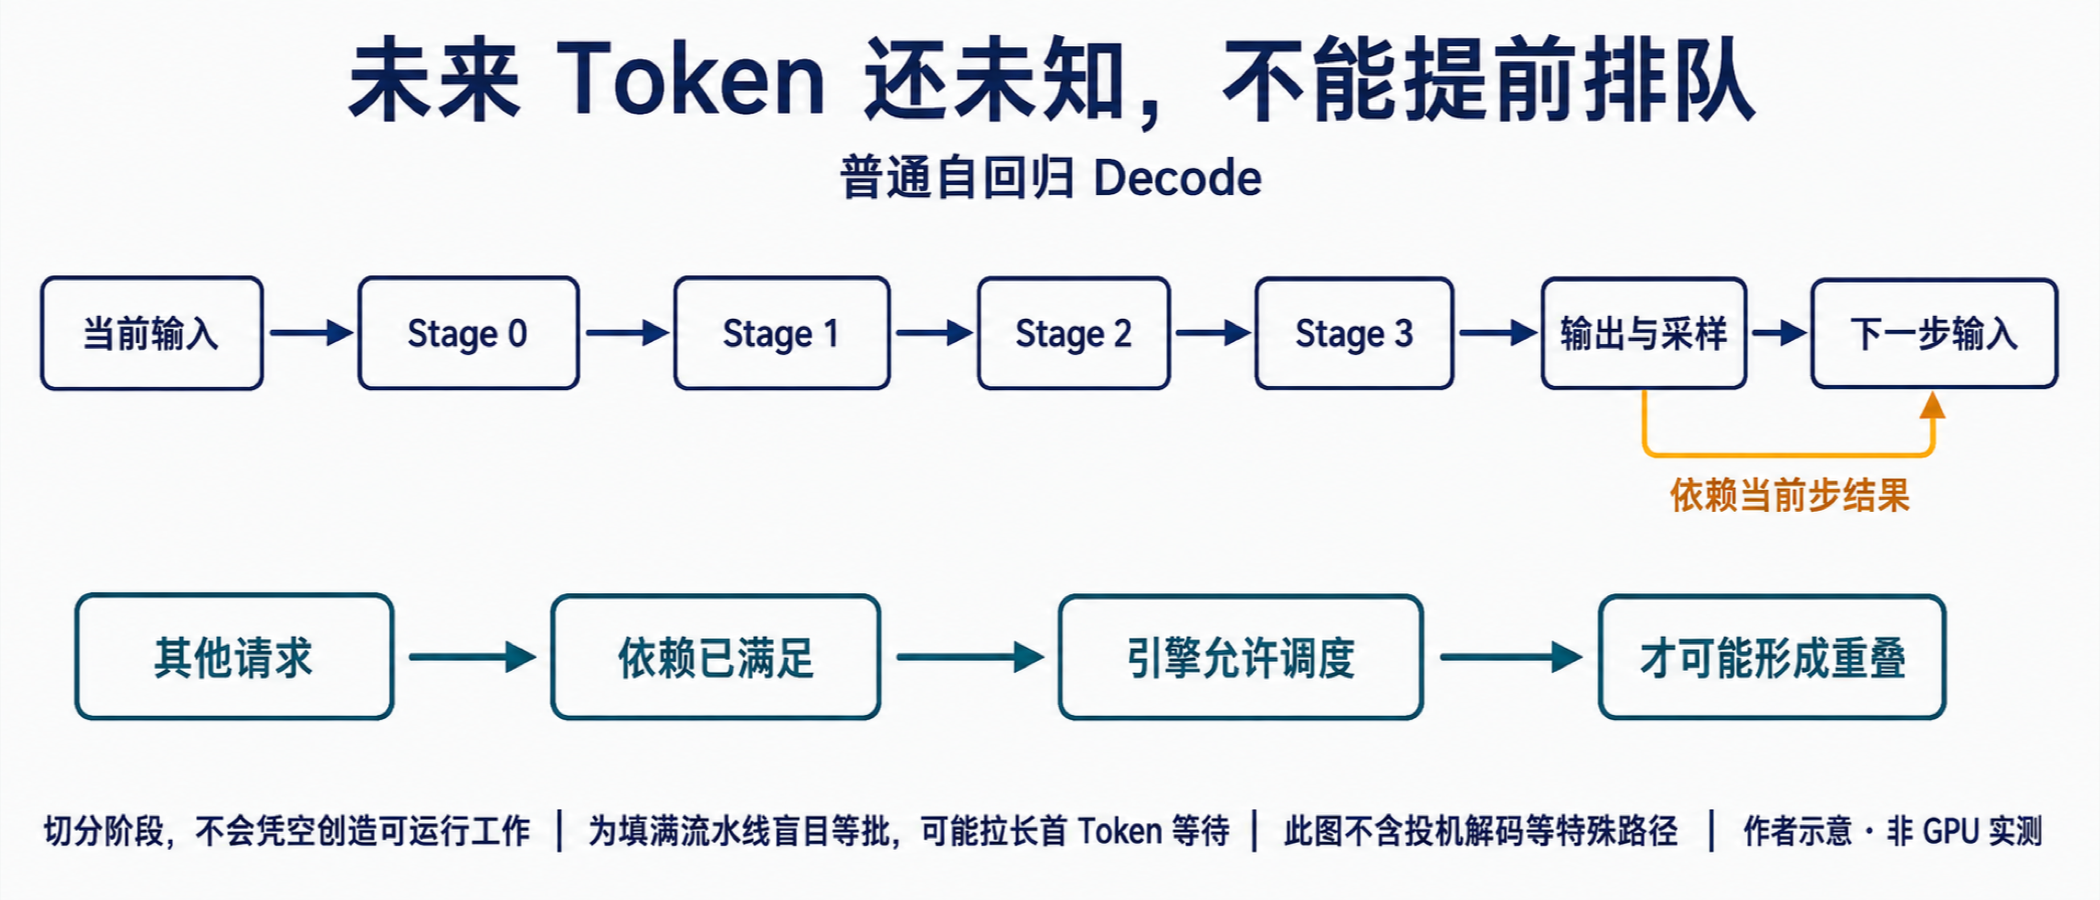
在普通自回归 Decode 中,同一序列的下一个输入 Token 取决于当前步的输出与采样结果。不能把还不知道内容的后续 Token,当成表里的 B、C、D 预先送进 Stage 0。投机解码等机制改变了工作组织方式,也需要单独分析,不能混入这个普通路径。
因此,只有一个低并发请求时,四个阶段可能在同一序列上轮流执行。增加阶段能让模型装下,但未必能降低逐 Token 的等待。已经处在系统里的多个请求,只有在依赖满足且引擎允许对应批次推进时,才可能提供可重叠的工作。
Prefill 也不能简单理解成"提示词长,所以自然填满"。引擎能否切块、怎样安排不同块与其他序列、是否支持多个在途批次,都属于调度实现。层与 Token 之间的依赖没有因为切块而消失。PyTorch 的流水线接口把 Stage 和 Schedule 分开,也分别列出 GPipe、1F1B 等调度。其中涉及反向计算的策略不能直接搬进纯推理服务。PyTorch Pipeline Schedules
这带来一个实际取舍:为了积攒足够任务而等待更久,可能提高设备忙碌程度,却恶化用户看到的首 Token 延迟。上线服务要优化的是满足等待目标的成功完成量,不是把所有卡的曲线都拉到高位。
例如同一个 PP 配置,离线批处理可以提前准备大量输入,晚间稀疏的交互请求却没有同样的任务供给。前者测得的稳定吞吐,不能证明后者不会出现长时间空闲。判断"气泡太多"之前,先检查是否真的有已满足依赖、可被调度的工作。
看起来都是空闲,处理方法却可能相反
即使请求足够,流水线也可能填不满。此时继续加并发,容易让问题从设备等待变成用户排队。
第一种情况是阶段计算不均衡。假设三个阶段处理同样一个工作单元分别需要 4、11、5 ms,忽略通信且允许必要缓冲。足够长的稳态下,完成间隔不可能快过最慢阶段的 11 ms。前后两个阶段的等待,不能通过单纯增加输入消除。这里是确定性模型的瓶颈判断,不是实际吞吐估算。
为什么层数相同还会不均衡?首尾阶段可能多出 Embedding、最终归一化或输出头。vLLM 的这份 Llama 实现就明确在末阶段创建输出头,Embedding 的放置还有权重绑定等条件。真实显存与计算成本要按模型实现看,不能只在纸上把"40 层"除以四。vLLM Llama 模块放置
此外,Prefill 与 Decode 下同一分区未必同样均衡。层形态、批量、上下文、量化内核都会影响成本。重分层的依据应是目标负载下的阶段剖析,而不是一次平均 GPU 利用率。把层从慢阶段移出去之前,还要确认接收方的权重、KV、激活和通信缓冲都能装下。
第二种情况是边界传输拖慢。假设一个边界只发送形状为 [B, H] 的稠密激活,B 表示本次前向的 Token 行数,H 为隐藏维度,元素占 a 字节,那么这一份张量的大小是 B×H×a。以 B=4096、H=8192、a=2 为例,结果是 67,108,864 字节,即 64 MiB。
这是单张量字节数,不是网络实测。若实现还要发送残差、做聚合或携带其他中间状态,实际载荷需要另算。传输时间还包括消息启动、同步及实际链路带宽的影响。小 Decode 批次未必受总字节数支配,大 Prefill 批次也不等于网络可以忽略。
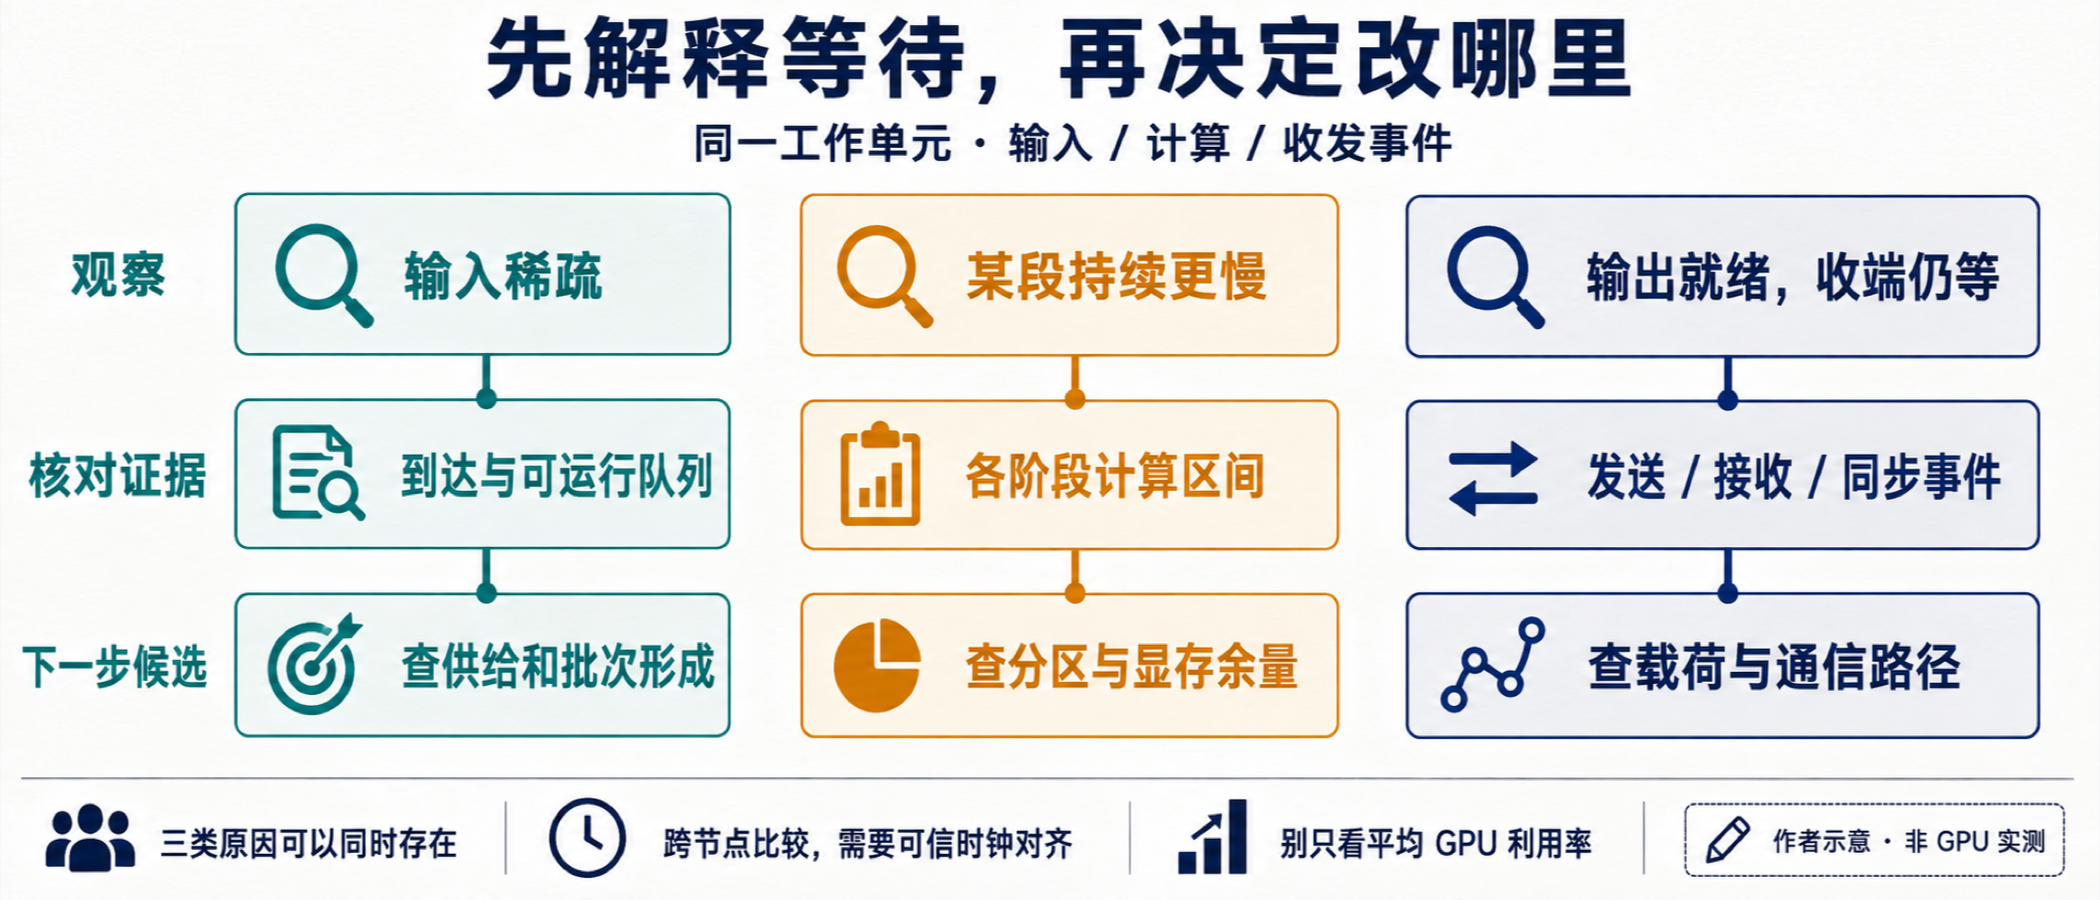
第三种情况才是任务供给或调度等待:阶段没有拿到可执行输入,却没有持续卡在某个重计算阶段或传输边界。此时应观察请求到达、批次形成和调度时间线。用重分层解决请求不足,或用增加请求解决慢链路,都可能适得其反。
| 输入稀疏,空闲随到达间隔变化 | 到达、可运行队列、批次形成时间 | 比较交互与批处理策略,不为填满流水线盲目等批 |
| 某阶段持续计算更久,其他阶段等它 | 相同工作单元的各阶段计算区间 | 剖析层与额外模块,检查重分区后的显存 |
| 发端输出已就绪,收端迟迟不能启动 | 发送、接收完成、同步事件与链路流量 | 检查载荷、通信路径和重叠策略 |
这些现象是诊断线索,不是互斥的自动分类器。计算不均衡、通信阻塞和调度问题可以同时存在。跨节点事件还要有可信的时钟对齐,不能直接相减两台机器未校准的日志时间戳。至少保留同一次迭代或微批次的关联标识,让等待能沿阶段追踪。
把慢连接放在阶段边界,仍需拿时间线验证
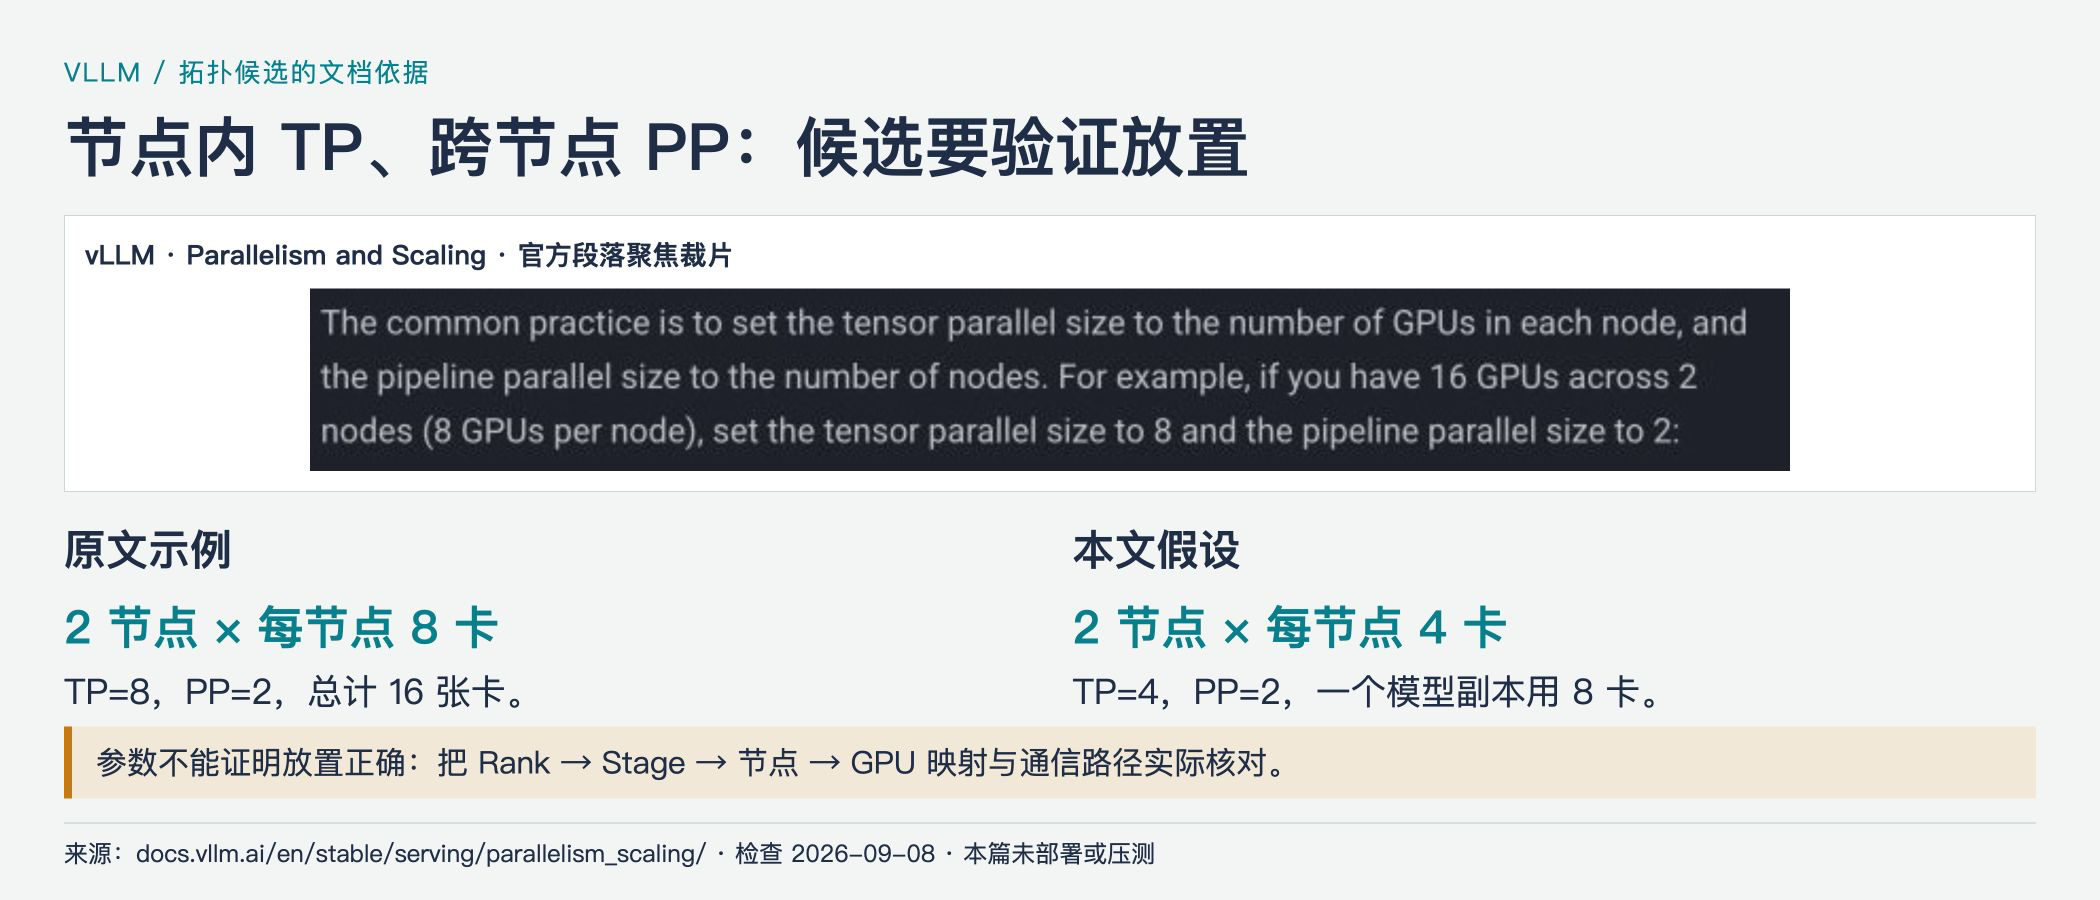
回到开头的问题。假设两台节点各有四张 GPU,而且已确认节点内互联比节点间更适合高频集合通信,可以将每个节点作为一个 PP 阶段,阶段内部使用 TP=4,总体为 TP=4、PP=2。
节点 A:Stage 0,四卡 TP 组 → 中间状态 → 节点 B:Stage 1,四卡 TP 组
一个模型副本,总共八张 GPU
PP 改变了跨节点通信的位置,阶段内部的 TP 集合通信仍然存在。GPU 型号、节点数量和启动参数本身,都不能证明进程最终被放在了预期节点上。要把执行 Rank、阶段分区、GPU UUID 和通信路径对应起来检查。
vLLM 当前扩展文档给出了节点内 TP、跨节点 PP 的组合方式,也将无 NVLink 或切分不均列为考虑 PP 的场景。它支持用 –pipeline-parallel-size 配置阶段数。下面只是参数关系示例,不是已经启动并验证的部署命令:vLLM Parallelism and Scaling
vllm serve /path/to/local-model \\
–tensor-parallel-size 4 \\
–pipeline-parallel-size 2
执行前仍要核对模型与后端的 PP 支持、多节点运行环境、可见 GPU 和放置结果。若使用混合并行或特殊模型,不要把 TP×PP 当作所有辅助进程的数量公式。
比较候选布局时,可以保留 TP-only 与 TP×PP 两条路径,但只比较都满足容量、模型支持和部署约束的方案。用低并发请求观察单次前向与逐 Token 等待,再用目标业务到达分布观察阶段重叠。相同 GPU 预算和请求集下,同时记录首 Token 延迟、逐请求平均 TPOT、超时、失败及满足预先约定两项延迟上限的成功完成量。TPOT 是首 Token 之后的平均每 Token 时间,输出不足两个 Token 的样本单列。
本篇新增的观测重点,是把总延迟拆回各阶段。每次记录应能回答:哪段在算,哪段已经准备好却在等,等待能否对应到传输或调度事件?资源统计中的平均值,不能代替这条时间线。
模型 / 引擎版本、请求或迭代标识:待记录
TP×PP、Rank→Stage→节点→GPU 映射:待记录
各阶段层范围与额外模块:待记录
同一工作单元的输入就绪、计算、发送/接收区间:未测
各阶段权重 / KV / 激活与缓冲的容量证据:未测
首 Token 与后续 Token 等待、失败和未完成请求:未测
改变一个分区或通信边界后的对照结果:未测
还要把完整 PP 链当作服务依赖来验收。缺少一个必要阶段,在途请求就无法正常走完前向。采用单 Worker 重启、重建通信组还是重建整个副本,取决于引擎与编排的恢复能力,不能一概写成"必然全部重启"。真正要验证的是:恢复后各阶段版本一致、通信恢复、请求能够完成,服务才重新具备接流量的条件。
PP 把模型容量摊到多个阶段,也把请求的完成过程展开成了一条串行依赖链。判断它是否值得使用,要看节省的通信代价能否覆盖阶段串行、填充不足和不均衡带来的等待。模型装下只是起点。能解释每一段为什么等,才有依据决定下一次应该移动层、调整调度,还是改变通信边界。
参考资料
- vLLM Llama 实现(含 IntermediateTensors 与 LlamaModel.forward)
- GPipe Figure 2 与第 2.3 节(含反向传播的训练时间线)
- PyTorch Pipeline Schedules(Stage 与 Schedule 分开,含 GPipe/1F1B)
- vLLM Parallelism and Scaling(节点内 TP、跨节点 PP)
资料复核于 2026-09-08。官方链接支撑非末阶段返回 IntermediateTensors、GPipe 阶段切分与微批次流水、PyTorch Stage/Schedule 分开、vLLM 节点内 TP/跨节点 PP 的方向;毫秒数(5/20/35 ms)、阶段配比(4/11/5 ms)、边界字节数(4096×8192×2=64 MiB)、TP×PP=4×2 拓扑均为作者教学假设,未执行多 GPU 部署、压测或故障恢复实验。
配图保持方法示意与官方原文摘片的区别;图上"2026-09-08 核验"标签保留。
错误速查卡
| PP 把等待时间变短 | PP 加速的是连续完成,不是取消先后依赖;首个结果仍是各阶段耗时之和 | 看 4 阶段 5 ms 一次前向 20 ms 算例 | 把首个结果延迟与整批延迟分开优化 |
| PP 缓解首 Token 延迟 | 同一序列未来 Token 未知 | 看 LlamaModel.forward 边界返回 | 借助其他已满足依赖的请求,投机解码另算 |
| 气泡 = GPU 利用率 | 气泡是阶段时间槽空闲比例 | 看 nvidia-smi 实际值与算例对比 | 区分时间槽占用与设备利用率 |
| Prefill 长 = 自然填满流水线 | 引擎能否切块、调度与依赖关系决定能否重叠 | 看 PyTorch Pipeline Schedules 与引擎实现 | 按调度策略单独判断 |
| 4 阶段 ÷ 4 任务 = 25% 等待 | 理想算例空闲槽比例 (p-1)/(m+p-1) | 套公式 | 区分理论空闲与实际等待 |
| 一次前向 = 客户端首 Token 延迟 | 首 Token 还含排队、输入处理、采样、返回路径 | 分层计时 | 沿客户端、服务端、采样返回分别计时 |
| 边界只有一个张量 | IntermediateTensors 含 residual 与辅助状态 | 看非末阶段 forward 返回 | 按实际 IntermediateTensors 载荷估算 |
| 60% GPU 利用率 = 服务快 | 平均利用率不替代时间线 | 沿阶段画时间线 | 区分忙碌时间槽与平均指标 |
| 平均阶段耗时即完成间隔 | 完成间隔受最慢阶段限制 | 看相同工作单元各阶段计算区间 | 用最慢阶段定下界 |
| 离线批处理吞吐 = 在线晚间吞吐 | 任务供给不同 | 比较交互与批处理策略 | 离线成绩不能证明在线表现 |
| 投机解码可填普通路径 | 投机解码是特殊路径 | 看引擎是否声明投机解码 | 单独分析,不混入普通路径 |
| TP×PP 总进程数 = TP × PP | 混合并行时数量公式不固定 | 看引擎 PP 支持与放置结果 | 不把 TP×PP 当作所有辅助进程数 |
| 看到 GPU 空闲就加并发 | 可能把设备等待变成用户排队 | 看请求到达与排队 | 按任务供给判断能否加并发 |
| 传输慢 = 加大阶段切分 | 切分增多可能拉低流水线负载 | 看完成间隔与负载变化 | 按完成间隔与负载重新分区 |
| 重分区前只看平均利用率 | 平均值不替代阶段剖析 | 看各阶段相同工作单元计算区间 | 按目标负载做阶段剖析 |
| 首尾阶段负担轻 | 首尾可能多出 Embedding、最终归一化、输出头;权重绑定等条件 | 看 Llama 实现模块放置 | 按模型实现确认额外模块 |
作者:武子康的个人博客 发布日期:2026-09-14(资料复核 2026-09-08)