位置编码(Rotary Position Embedding)原理与代码逐行详解
旋转位置编码(RoPE, Rotary Positional Embedding),是一种相比绝对/相对位置编码更高效、可泛化性更强的方案,最早用于 GPT-NeoX、GLM、ChatGLM 等模型中。
1.代码实现
原理实现代码如下:
class RotaryEmbedding(nn.Module):
def __init__(self, dim, max_position_embeddings=2048, base=10000, device=None):
""" 旋转位置编码
– dim (int): 旋转嵌入的维度大小。
– max_position_embeddings (int): 预计算的最大位置嵌入数,默认为2048。
– base (int): 用于计算逆频率的基本频率,默认为10000。
"""
super().__init__()
self.dim = dim
self.max_position_embeddings = max_position_embeddings
self.base = base
# 计算逆频率值,并将其注册为模型的缓冲区,保证它在保存和加载模型时不被更新
# torch.arange(start, end, step)
inv_freq = 1.0 / (self.base ** (torch.arange(0, self.dim, 2, dtype=torch.int64).float().to(device) / self.dim))
self.register_buffer("inv_freq", inv_freq, persistent=False)
# 为了支持`torch.jit.trace`功能,立即计算预存储的余弦和正弦缓存
self._set_cos_sin_cache(
seq_len=max_position_embeddings, device=self.inv_freq.device, dtype=torch.get_default_dtype()
)
def _set_cos_sin_cache(self, seq_len, device, dtype):
""" 预计算的余弦和正弦缓存
"""
self.max_seq_len_cached = seq_len
# 创建一个从0到最大序列长度-1的整数张量,与 inv_freq 具有相同的设备和数据类型
t = torch.arange(self.max_seq_len_cached, device=device, dtype=torch.int64).type_as(self.inv_freq)
# 计算每个位置与每个维度的频率,形成频谱矩阵
# sin(wt),cos(wt)
# t表示不同token,也就是seq_len侧
freqs = torch.outer(t, self.inv_freq) # torch.outer计算矩阵外积,其实就是矩阵乘法
# 不同于论文中的实现,这里采用了不同的排列方式以获得相同的计算结果
emb = torch.cat((freqs, freqs), dim=–1)
self.register_buffer("cos_cached", emb.cos().to(dtype), persistent=False)
self.register_buffer("sin_cached", emb.sin().to(dtype), persistent=False)
def forward(self, x, seq_len=None):
# x: [bs, num_attention_heads, seq_len, head_size]
# 序列太长就重新计算
if seq_len > self.max_seq_len_cached:
self._set_cos_sin_cache(seq_len=seq_len, device=x.device, dtype=x.dtype)
return (
self.cos_cached[:seq_len].to(dtype=x.dtype),
self.sin_cached[:seq_len].to(dtype=x.dtype),
)
def rotate_half(x):
"""
将向量后一半负号后移至前一半,实现 RoPE 所需的旋转操作
旋转输入一半的 hidden dim
"""
x1 = x[..., : x.shape[–1] // 2]#batch_size, seq_len, num_heads, head_dim//2
x2 = x[..., x.shape[–1] // 2 :]
return torch.cat((–x2, x1), dim=–1)
使用方法:
def apply_rotary_pos_emb(q, k, cos, sin, position_ids, unsqueeze_dim=1):
""" 在 qk 应用旋转位置编码
Args:
q (`torch.Tensor`): q
k (`torch.Tensor`): k
cos (`torch.Tensor`): 旋转位置嵌入的余弦部分
sin (`torch.Tensor`): 旋转位置嵌入的正弦部分
position_ids (`torch.Tensor`): 与q和k对应位置的标记索引。例如,在处理KV缓存时,可以使用偏移过的位置ID。
unsqueeze_dim (`int`, *optional*, defaults to 1): 'unsqueeze_dim' 参数指定了沿哪个维度对 cos[position_ids]
和 sin[position_ids] 进行扩展,以便它们能够适当地广播到 q 和 k 的维度上。
例如,注意 cos[position_ids] 和 sin[position_ids] 具有形状 [batch_size, seq_len, head_dim]。
那么,如果 q 和 k 的形状分别为 [batch_size, heads, seq_len, head_dim],
则设置 unsqueeze_dim=1 可使 cos[position_ids] 和 sin[position_ids] 可以广播到 q 和 k 的形状上。
同样地,如果 q 和 k 的形状为 [batch_size, seq_len, heads, head_dim],则应将 unsqueeze_dim 设置为 2
Returns:
包含使用旋转位置嵌入变换后的q和k张量的 `tuple(torch.Tensor)`。
"""
# 广播 cos[position_ids] 到 q/k 的sin cos形状
cos = cos[position_ids].unsqueeze(unsqueeze_dim) # shape [batch, seq_len, dim] 10*6 max_seq_len*head_dim 2*4 batch_size*seq_len
sin = sin[position_ids].unsqueeze(unsqueeze_dim) # shape [batch, seq_len, dim]
# 应用 RoPE 公式
q_embed = (q * cos) + (rotate_half(q) * sin)
k_embed = (k * cos) + (rotate_half(k) * sin)
return q_embed, k_embed
2.原理
2.1 为什么 Transformer 需要位置编码
这一部分的原理可以简述为:
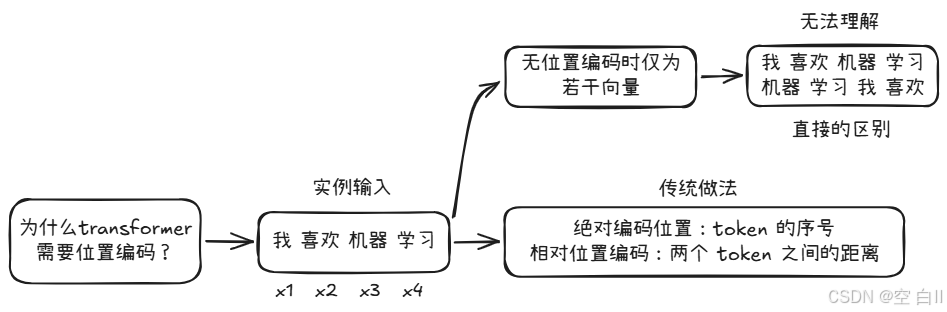
位置编码的理由
Transformer 的 Self-Attention 本身并不知道 token 的顺序。
假设输入序列为:
我 喜欢 机器 学习
如果只考虑 token embedding,那么 Self-Attention 接收到的本质上只是若干向量:
x1,x2,x3,x4
x_1,x_2,x_3,x_4
x1,x2,x3,x4
注意力计算:
Attention(Q,K,V)=softmax(QK⊤d)V
\\mathrm{Attention}(Q,K,V)=
\\mathrm{softmax}
\\left(
\\frac{QK^\\top}{\\sqrt{d}}
\\right)V
Attention(Q,K,V)=softmax(dQK⊤)V
其中:
Q=XWQ,K=XWK,V=XWV
Q=XW_Q,\\qquad K=XW_K,\\qquad V=XW_V
Q=XWQ,K=XWK,V=XWV
如果没有额外的位置信息,那么模型并不能天然区分:
我 喜欢 机器 学习
和
机器 学习 喜欢 我
因此需要显式地向模型注入 token 的位置信息。
传统做法通常有两类:
RoPE 比较特殊。
它表面上使用的是每个 token 的绝对位置 (m),但经过旋转之后,在 (QK^\\top) 中自然得到的是相对位置 (m-n)。
这也是 RoPE 最重要的数学性质。
2.2 从二维旋转开始理解 RoPE
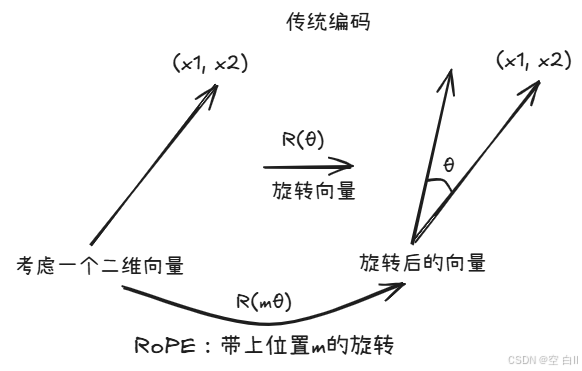
二维旋转示意图
先暂时不考虑高维向量,只考虑一个二维向量:
x=[x1x2]
x=
\\begin{bmatrix}
x_1\\\\
x_2
\\end{bmatrix}
x=[x1x2]
如果将这个二维向量逆时针旋转角度 (\\theta),在线性代数中可以使用旋转矩阵:
R(θ)=[cosθ−sinθsinθcosθ]
R(\\theta)=
\\begin{bmatrix}
\\cos\\theta & -\\sin\\theta\\\\
\\sin\\theta & \\cos\\theta
\\end{bmatrix}
R(θ)=[cosθsinθ−sinθcosθ]
于是旋转后的向量为:
R(θ)x=[x1cosθ−x2sinθx1sinθ+x2cosθ]
R(\\theta)x=
\\begin{bmatrix}
x_1\\cos\\theta-x_2\\sin\\theta\\\\
x_1\\sin\\theta+x_2\\cos\\theta
\\end{bmatrix}
R(θ)x=[x1cosθ−x2sinθx1sinθ+x2cosθ]
这就是 RoPE 最核心的操作。
也就是说:
RoPE 本质上就是根据 token 的位置,让 Query 和 Key 在不同二维子空间中旋转不同角度。
假设 token 位于位置 (m),那么旋转角度可以写成:
mθ
m\\theta
mθ
于是:
R(mθ)=[cos(mθ)−sin(mθ)sin(mθ)cos(mθ)]
R(m\\theta)=
\\begin{bmatrix}
\\cos(m\\theta) & -\\sin(m\\theta)\\\\
\\sin(m\\theta) & \\cos(m\\theta)
\\end{bmatrix}
R(mθ)=[cos(mθ)sin(mθ)−sin(mθ)cos(mθ)]
位置越靠后,旋转角度越大。
2.3 为什么要把 hidden dimension 两两分组
真实 Transformer 中的一个 attention head 通常不是二维,而是:
d=64, 128, 256,…
d=64,\\ 128,\\ 256,\\dots
d=64, 128, 256,…
例如:
q=[q0,q1,q2,q3,…,qd−1]
q=
[q_0,q_1,q_2,q_3,\\dots,q_{d-1}]
q=[q0,q1,q2,q3,…,qd−1]
RoPE 的基本思想是:
将高维向量拆分成很多二维子空间,然后在每个二维子空间中分别做旋转。
从论文最直观的形式看,可以理解为:
(q0,q1),(q2,q3),(q4,q5),⋯
(q_0,q_1),
(q_2,q_3),
(q_4,q_5),
\\cdots
(q0,q1),(q2,q3),(q4,q5),⋯
每一对维度对应一个旋转频率。
如果 head dimension 为 (d),那么一共应该有:
d2
\\frac d2
2d
组二维旋转。
对应的旋转矩阵可以写成一个 block diagonal matrix:
RΘ,md=[R(mθ0)0⋯00R(mθ1)⋯0⋮⋮⋱⋮00⋯R(mθd/2−1)]
R_{\\Theta,m}^d=
\\begin{bmatrix}
R(m\\theta_0) & 0 & \\cdots & 0\\\\
0 & R(m\\theta_1) & \\cdots & 0\\\\
\\vdots & \\vdots & \\ddots & \\vdots\\\\
0 & 0 & \\cdots & R(m\\theta_{d/2-1})
\\end{bmatrix}
RΘ,md=R(mθ0)0⋮00R(mθ1)⋮0⋯⋯⋱⋯00⋮R(mθd/2−1)
其中:
R(mθi)=[cos(mθi)−sin(mθi)sin(mθi)cos(mθi)]
R(m\\theta_i)=\\begin{bmatrix}
\\cos(m\\theta_i) & -\\sin(m\\theta_i)\\\\
\\sin(m\\theta_i) & \\cos(m\\theta_i)
\\end{bmatrix}
R(mθi)=[cos(mθi)sin(mθi)−sin(mθi)cos(mθi)]
因此不同维度对会以不同速度旋转。
2.4 为什么不同维度要使用不同频率
如果所有维度都使用相同的旋转角速度,那么模型只能得到一种周期尺度。
因此 RoPE 会让不同二维子空间使用不同频率:
θi=10000−2id
\\theta_i=
10000^{-\\frac{2i}{d}}
θi=10000−d2i
其中:
i=0,1,…,d2−1
i=0,1,\\dots,\\frac d2-1
i=0,1,…,2d−1
代码中:
inv_freq = 1.0 / (
base ** (
torch.arange(0, dim, 2).float() / dim
)
)
实际上计算的正是:
θi=1100002i/d
\\theta_i=
\\frac{1}
{10000^{2i/d}}
θi=100002i/d1
注意:
torch.arange(0, dim, 2)
得到:
0, 2, 4, 6, …
因此:
0d,2d,4d,…
\\frac{0}{d},
\\frac{2}{d},
\\frac{4}{d},
\\dots
d0,d2,d4,…
正好对应公式中的:
2id
\\frac{2i}{d}
d2i
所以:
inv_freq
并不是位置,而是每组二维旋转所对应的角频率。
例如:
dim = 8
base = 10000
则近似有:
inv_freq =
[
1,
0.1,
0.01,
0.001
]
不同频率具有不同的周期:
- 高频维度变化快,更敏感于短距离位置关系;
- 低频维度变化慢,可以描述更长距离的位置变化。
这种设计和经典 Transformer 的 sinusoidal positional encoding 非常类似。
2.5 torch.outer(t, inv_freq) 到底在计算什么
代码中有:
t = torch.arange(seq_len)
freqs = torch.outer(t, inv_freq)
假设:
seq_len = 4
dim = 8
则:
t.shape = [4]
inv_freq.shape = [4]
外积以后:
freqs.shape = [4, 4]
数学上:
freqsm,i=mθi
\\text{freqs}_{m,i}=m\\theta_i
freqsm,i=mθi
例如:
t=[0123]
t=
\\begin{bmatrix}
0\\\\
1\\\\
2\\\\
3
\\end{bmatrix}
t=0123
而:
inv_freq[θ0θ1θ2θ3]
\\text{inv\\_freq}
\\begin{bmatrix}
\\theta_0 &
\\theta_1 &
\\theta_2 &
\\theta_3
\\end{bmatrix}
inv_freq[θ0θ1θ2θ3]
那么:
freqs=[0θ00θ10θ20θ31θ01θ11θ21θ32θ02θ12θ22θ33θ03θ13θ23θ3]
\\text{freqs}=
\\begin{bmatrix}
0\\theta_0 & 0\\theta_1 & 0\\theta_2 & 0\\theta_3\\\\
1\\theta_0 & 1\\theta_1 & 1\\theta_2 & 1\\theta_3\\\\
2\\theta_0 & 2\\theta_1 & 2\\theta_2 & 2\\theta_3\\\\
3\\theta_0 & 3\\theta_1 & 3\\theta_2 & 3\\theta_3
\\end{bmatrix}
freqs=0θ01θ02θ03θ00θ11θ12θ13θ10θ21θ22θ23θ20θ31θ32θ33θ3
所以这一句代码:
freqs = torch.outer(t, self.inv_freq)
本质上是在计算:
每一个 token 位置,在每一种旋转频率下应该旋转多少角度。
需要注意的是:
torch.outer
严格来说计算的是向量外积,并不能简单理解为一般意义上的矩阵乘法。
2.6 为什么要执行 torch.cat((freqs, freqs), dim=-1)
代码:
emb = torch.cat((freqs, freqs), dim=–1)
假设:
freqs.shape = [seq_len, dim // 2]
拼接后:
emb.shape = [seq_len, dim]
例如:
freqs =
[a, b, c, d]
拼接以后:
emb =
[a, b, c, d, a, b, c, d]
随后:
cos_cached = emb.cos()
sin_cached = emb.sin()
得到:
cos =
[cos(a), cos(b), cos(c), cos(d),
cos(a), cos(b), cos(c), cos(d)]
和:
sin =
[sin(a), sin(b), sin(c), sin(d),
sin(a), sin(b), sin(c), sin(d)]
这里之所以采用这种排列方式,是因为当前代码的:
rotate_half(x)
采用的是“前半维度 / 后半维度”配对方式,而不是直观的:
(0,1), (2,3), (4,5), …
配对。
也就是说,这种实现中更适合理解成:
(x0, x4)
(x1, x5)
(x2, x6)
(x3, x7)
因此 freqs 复制两次之后,前后两半恰好共享相同频率。
这是很多 Hugging Face 模型实现中常见的写法。
需要特别注意:
RoPE 的二维维度如何排列可以有不同实现,只要 cos/sin 的排列方式和 rotate_half 的维度配对方式保持一致,最终数学效果就是等价的。
2.7 rotate_half(x) 为什么可以实现旋转
代码:
def rotate_half(x):
x1 = x[..., : x.shape[–1] // 2]
x2 = x[..., x.shape[–1] // 2 :]
return torch.cat((–x2, x1), dim=–1)
假设:
x=[x1,x2]
x=
[x_1,x_2]
x=[x1,x2]
为了便于理解,先从真正二维的情况看。
旋转公式:
R(θ)x=[x1cosθ−x2sinθx1sinθ+x2cosθ]
R(\\theta)x = \\begin{bmatrix}
x_1\\cos\\theta-x_2\\sin\\theta\\\\
x_1\\sin\\theta+x_2\\cos\\theta
\\end{bmatrix}
R(θ)x=[x1cosθ−x2sinθx1sinθ+x2cosθ]
可以拆成:
R(θ)x=[x1cosθx2cosθ]+[−x2sinθx1sinθ]
R(\\theta)x = \\begin{bmatrix}
x_1\\cos\\theta\\\\
x_2\\cos\\theta
\\end{bmatrix}
+
\\begin{bmatrix}
-x_2\\sin\\theta\\\\
x_1\\sin\\theta
\\end{bmatrix}
R(θ)x=[x1cosθx2cosθ]+[−x2sinθx1sinθ]
也就是:
R(θ)x=xcosθ+[−x2x1]sinθ
R(\\theta)x = x\\cos\\theta
+
\\begin{bmatrix}
-x_2\\\\
x_1
\\end{bmatrix}
\\sin\\theta
R(θ)x=xcosθ+[−x2x1]sinθ
定义:
rotate(x)=[−x2x1]
\\operatorname{rotate}(x)=
\\begin{bmatrix}
-x_2\\\\
x_1
\\end{bmatrix}
rotate(x)=[−x2x1]
那么:
R(θ)x=xcosθ+rotate(x)sinθ
R(\\theta)x = x\\cos\\theta
+
\\operatorname{rotate}(x)\\sin\\theta
R(θ)x=xcosθ+rotate(x)sinθ
这正是代码:
q_embed = q * cos + rotate_half(q) * sin
背后的数学原理。
因此:
rotate_half(x)
本身并没有完成完整旋转。
它只完成了旋转矩阵中的:
[−x2,x1]
[-x_2,x_1]
[−x2,x1]
这一部分。
真正完整的旋转是:
x * cos + rotate_half(x) * sin
2.8 用一个具体数值例子理解旋转
假设二维向量:
x=[10]
x=
\\begin{bmatrix}
1\\\\
0
\\end{bmatrix}
x=[10]
旋转角度:
θ=π2
\\theta=\\frac{\\pi}{2}
θ=2π
那么:
cosθ=0
\\cos\\theta=0
cosθ=0
sinθ=1
\\sin\\theta=1
sinθ=1
同时:
rotate(x)=[01]
\\operatorname{rotate}(x) = \\begin{bmatrix}
0\\\\
1
\\end{bmatrix}
rotate(x)=[01]
因此:
x′=xcosθ+rotate(x)sinθ
x'=x\\cos\\theta
+
\\operatorname{rotate}(x)\\sin\\theta
x′=xcosθ+rotate(x)sinθ
即:
x′=[10]⋅0+[01]⋅1
x'=\\begin{bmatrix}
1\\\\
0
\\end{bmatrix}
\\cdot0
+
\\begin{bmatrix}
0\\\\
1
\\end{bmatrix}
\\cdot1
x′=[10]⋅0+[01]⋅1
得到:
x′=[01]
x'=\\begin{bmatrix}
0\\\\
1
\\end{bmatrix}
x′=[01]
这正好表示向量:
(1, 0)
逆时针旋转 (90^\\circ) 后变成:
(0, 1)
2.9 RoPE 如何把“绝对位置”转换成“相对位置”
这是整个 RoPE 最关键的一步。
假设 Query 位于位置 (m),Key 位于位置 (n)。
经过 RoPE 后:
qm′=R(mθ)qm
q_m'=R(m\\theta)q_m
qm′=R(mθ)qm
kn′=R(nθ)kn
k_n'=R(n\\theta)k_n
kn′=R(nθ)kn
注意力分数需要计算:
(qm′)⊤kn′
(q_m')^\\top k_n'
(qm′)⊤kn′
代入:
(qm′)⊤kn′=(R(mθ)qm)⊤(R(nθ)kn)
(q_m')^\\top k_n' = (R(m\\theta)q_m)^\\top
(R(n\\theta)k_n)
(qm′)⊤kn′=(R(mθ)qm)⊤(R(nθ)kn)
根据矩阵转置:
上式=qm⊤R(mθ)⊤R(nθ)kn
\\text{上式}=q_m^\\top
R(m\\theta)^\\top
R(n\\theta)
k_n
上式=qm⊤R(mθ)⊤R(nθ)kn
旋转矩阵满足:
R(θ)⊤=R(−θ)
R(\\theta)^\\top=R(-\\theta)
R(θ)⊤=R(−θ)
因此:
R(mθ)⊤=R(−mθ)
R(m\\theta)^\\top = R(-m\\theta)
R(mθ)⊤=R(−mθ)
于是:
(qm′)⊤kn′=qm⊤R(−mθ)R(nθ)kn
(q_m')^\\top k_n'=
q_m^\\top
R(-m\\theta)
R(n\\theta)
k_n
(qm′)⊤kn′=qm⊤R(−mθ)R(nθ)kn
旋转矩阵还满足:
R(α)R(β)=R(α+β)
R(\\alpha)R(\\beta) = R(\\alpha+\\beta)
R(α)R(β)=R(α+β)
所以:
R(−mθ)R(nθ)=R((n−m)θ)
R(-m\\theta)R(n\\theta)=R((n-m)\\theta)
R(−mθ)R(nθ)=R((n−m)θ)
最终:
(qm′)⊤kn′=qm⊤R((n−m)θ)kn
\\boxed{
(q_m')^\\top k_n' = q_m^\\top
R((n-m)\\theta)
k_n
}
(qm′)⊤kn′=qm⊤R((n−m)θ)kn
可以看到:
最终的 attention score 不再单独依赖 (m) 或 (n),而是依赖位置差 (n-m)。
也就是说:
f(qm,kn,m,n)=g(qm,kn,n−m)
f(q_m, k_n, m, n) = g(q_m,k_n,n-m)
f(qm,kn,m,n)=g(qm,kn,n−m)
这就是 RoPE 能够自然编码相对位置的根本原因。
2.10 为什么只对 Q 和 K 做 RoPE,而通常不对 V 做
Self-Attention:
Attention(Q,K,V)=softmax(QK⊤d)V
\\mathrm{Attention}(Q,K,V) =
\\mathrm{softmax}
\\left(
\\frac{QK^\\top}{\\sqrt d}
\\right)V
Attention(Q,K,V)=softmax(dQK⊤)V
其中:
- QQQ 和 KKK 决定“应该关注谁”;
- VVV 决定“真正取回什么信息”。
RoPE 的目标是让注意力权重具有位置感知能力。
因此只需要改变:
QK⊤
QK^\\top
QK⊤
也就是说,对:
Q
K
施加位置旋转即可。
而 Value 并不直接参与 attention score 的计算,所以一般不需要对 (V) 使用 RoPE。
2.11 position_ids 的作用
代码:
cos = cos[position_ids].unsqueeze(unsqueeze_dim)
sin = sin[position_ids].unsqueeze(unsqueeze_dim)
假设:
position_ids =
[
[0, 1, 2, 3]
]
那么:
cos[position_ids]
就是从预先计算好的:
cos_cached
中取出位置:
0
1
2
3
对应的旋转角度。
普通训练时:
position_ids = [0, 1, 2, …, seq_len – 1]
即可。
但是在大模型推理阶段通常会使用 KV Cache。
例如之前已经缓存了 100 个 token:
0 ~ 99
现在新生成第 101 个 token。
此时新的 token 的位置不能重新从 0 开始,而应该是:
100
因此:
position_ids
允许显式指定实际位置。
例如:
position_ids = torch.tensor([[100]])
这样即使当前输入张量的:
seq_len = 1
RoPE 仍然知道这个 token 的真实绝对位置是 100。
2.12 unsqueeze_dim 为什么是 1
假设:
q.shape
为:
[batch_size, num_heads, seq_len, head_dim]
例如:
[2, 32, 128, 128]
而:
cos[position_ids].shape
为:
[batch_size, seq_len, head_dim]
即:
[2, 128, 128]
此时不能直接和 q 相乘。
需要插入一个 head 维度:
cos = cos[position_ids].unsqueeze(1)
变为:
[2, 1, 128, 128]
此时根据 PyTorch broadcasting:
q : [2, 32, 128, 128]
cos : [2, 1, 128, 128]
第二维:
1 -> 32
自动广播。
于是每一个 attention head 都使用相同的位置旋转角度。
如果 q 的布局是:
[batch_size, seq_len, num_heads, head_dim]
那么就应该:
unsqueeze_dim = 2
得到:
[batch_size, seq_len, 1, head_dim]
这样才能正确广播。
2.13 从 shape 角度完整走一遍 RoPE
假设:
batch_size = 2
num_heads = 4
seq_len = 6
head_dim = 8
那么:
q.shape
为:
[2, 4, 6, 8]
第一步:生成频率
inv_freq.shape
为:
[4]
因为:
head_dim/2=4
head\\_dim/2=4
head_dim/2=4
第二步:生成位置
t.shape
为:
[6]
内容:
[0, 1, 2, 3, 4, 5]
第三步:计算每个位置对应的旋转角度
freqs = torch.outer(t, inv_freq)
得到:
freqs.shape = [6, 4]
第四步:复制频率
emb = torch.cat((freqs, freqs), dim=–1)
得到:
emb.shape = [6, 8]
第五步:计算 sin/cos
cos.shape = [6, 8]
sin.shape = [6, 8]
第六步:使用 position_ids 取出 batch 对应位置
假设:
position_ids.shape
为:
[2, 6]
那么:
cos[position_ids].shape
为:
[2, 6, 8]
第七步:插入 head 维度
cos = cos[position_ids].unsqueeze(1)
得到:
[2, 1, 6, 8]
同理:
sin.shape = [2, 1, 6, 8]
第八步:广播到所有 heads
q : [2, 4, 6, 8]
cos : [2, 1, 6, 8]
rotate_half(q) : [2, 4, 6, 8]
sin : [2, 1, 6, 8]
最终:
q_embed = q * cos + rotate_half(q) * sin
得到:
q_embed.shape = [2, 4, 6, 8]
维度完全不变。
这也是 RoPE 的一个工程优势:
位置编码不会增加 Q/K 的维度,也不会额外拼接位置向量。
2.14 用复数形式理解 RoPE
RoPE 还有一种非常漂亮的理解方式:复数乘法。
把二维向量:
(x1,x2)
(x_1,x_2)
(x1,x2)
表示成复数:
z=x1+ix2
z=x_1+ix_2
z=x1+ix2
根据欧拉公式:
eiθ=cosθ+isinθ
e^{i\\theta}=
\\cos\\theta+i\\sin\\theta
eiθ=cosθ+isinθ
那么复数乘法:
zeiθ
ze^{i\\theta}
zeiθ
等价于把二维向量旋转 θ\\thetaθ。
展开:
(x1+ix2)(cosθ+isinθ)
(x_1+ix_2)(\\cos\\theta+i\\sin\\theta)
(x1+ix2)(cosθ+isinθ)
得到:
(x1cosθ−x2sinθ)+i(x1sinθ+x2cosθ)
(x_1\\cos\\theta-x_2\\sin\\theta)
+
i(x_1\\sin\\theta+x_2\\cos\\theta)
(x1cosθ−x2sinθ)+i(x1sinθ+x2cosθ)
其实就是前面的二维旋转公式。
因此 RoPE 也可以理解成:
qm→qmeimθ
q_m
\\rightarrow
q_m e^{im\\theta}
qm→qmeimθ
kn→kneinθ
k_n
\\rightarrow
k_n e^{in\\theta}
kn→kneinθ
二者计算内积时,位置部分形成:
ei(n−m)θ
e^{i(n-m)\\theta}
ei(n−m)θ
所以自然只和:
n−m
n-m
n−m
有关。
一些模型实现也确实会直接使用复数形式完成 RoPE。
2.15 RoPE 和绝对位置编码有什么区别
传统 sinusoidal absolute positional encoding 的方式是:
xm′=xm+pm
x_m'=x_m+p_m
xm′=xm+pm
也就是说:
token embedding
+
position embedding
位置向量直接加到 hidden state 上。
RoPE 则是:
qm′=Rmqm
q_m'=R_mq_m
qm′=Rmqm
km′=Rmkm
k_m'=R_mk_m
km′=Rmkm
它不修改 token embedding 本身,而是在 Attention 中对 Query 和 Key 做旋转。
因此二者的区别可以概括为:
| 绝对位置编码 | 与 token embedding 相加 | 间接 | 较弱 |
| Learned Position Embedding | 学习一个位置向量并相加 | 间接 | 较弱 |
| Relative Position Bias | attention score 中加入 bias | 直接 | 是 |
| RoPE | 旋转 Q/K | 直接 | 是 |
RoPE 的特殊之处在于:
它通过一个绝对位置相关的旋转操作,让 QK 内积天然表现为相对位置函数。
2.16 为什么 RoPE 适合长序列
RoPE 不需要为每一个位置单独学习一个 embedding 参数。
位置 mmm 对应的旋转角度直接由:
mθi
m\\theta_i
mθi
计算得到。
因此从形式上来说,即使训练时只见过:
0 ~ 2047
推理时也仍然可以计算:
2048
2049
…
对应的 sin/cos。
这意味着 RoPE 在结构上具备一定的长度外推能力。
但是需要注意:
“能够计算更长的位置”并不等价于“模型一定能够无损理解任意更长上下文”。
因为训练阶段模型学习到的 attention pattern 仍然受到训练上下文长度限制。
直接把 position index 从 2048 扩展到几十万时,旋转相位分布可能已经显著偏离训练期间见过的区域。
因此现代长上下文模型还会配合一些 RoPE scaling 技术,例如:
- Position Interpolation;
- Linear Scaling;
- NTK-aware Scaling;
- Dynamic NTK Scaling;
- YaRN;
- LongRoPE。
这些方法本质上都在解决一个问题:
如何修改 RoPE 的频率或位置尺度,使模型在更长 context 中仍然处于相对合理的频率分布范围。
2.17 base=10000 到底控制什么
代码:
base = 10000
对应:
θi=base−2i/d
\\theta_i=base^{-2i/d}
θi=base−2i/d
因此 base 控制了各个维度的频率分布。
base 越大:
- 低频成分通常会更低;
- 一些维度的旋转速度更慢;
- 对长距离位置的变化更加平缓。
base 越小:
- 整体旋转频率更高;
- 位置变化更快;
- 相位更容易在较短距离内发生明显变化。
所以很多长上下文模型会调整:
rope_theta
也就是这里的:
base
例如,从经典的:
10000
调整到更大的值。
但不能简单理解成:
base 越大,context window 就一定越长。
因为真正的长上下文性能仍然依赖:
- 训练长度;
- 训练数据;
- RoPE scaling 策略;
- attention 分布;
- 模型参数;
- 推理阶段的位置处理方式。
2.18 为什么需要缓存 cos_cached 和 sin_cached
理论上每次 forward 都可以重新计算:
cos
sin
但是这些值只依赖:
position
head_dim
base
通常和输入 token 内容无关。
所以完全可以提前计算。
代码:
self._set_cos_sin_cache(
seq_len=max_position_embeddings,
...
)
预先生成:
[0, 1, 2, …, max_position_embeddings – 1]
所有位置的:
cos
sin
后续 forward 直接切片:
self.cos_cached[:seq_len]
self.sin_cached[:seq_len]
即可。
这样可以避免每一层、每一步生成 token 时重复执行三角函数计算。
2.19 register_buffer(…, persistent=False) 的含义
代码:
self.register_buffer(
"inv_freq",
inv_freq,
persistent=False
)
register_buffer 表示:
这个 Tensor 属于模型状态的一部分,但不是可训练参数。
因此:
model.to("cuda")
时,它会自动被移动到 GPU。
但是:
optimizer = Adam(model.parameters())
时,它不会出现在优化器参数中。
因为:
inv_freq
cos_cached
sin_cached
都不需要通过梯度下降学习。
persistent=False 表示:
不把这个 buffer 写入 state_dict。
这是因为这些值都可以根据:
dim
base
max_position_embeddings
重新计算,没有必要增加 checkpoint 的存储体积。
2.20 RoPE 在完整 Attention 中处于什么位置
一个典型 Multi-Head Self-Attention 的执行流程是:
hidden_states
│
├── Wq ──> Q
│
├── Wk ──> K
│
└── Wv ──> V
│
│
┌───────┴────────┐
│ │
RoPE(Q) RoPE(K)
│ │
└───────┬────────┘
│
QK^T
│
/ sqrt(head_dim)
│
softmax
│
V
│
Attention Output
也就是说 RoPE 一般发生在:
Q/K projection 之后
和:
QK^T attention score 计算之前
数学形式为:
Q=XWQ
Q=XW_Q
Q=XWQ
K=XWK
K=XW_K
K=XWK
然后:
Q′=R(Q)
Q'=R(Q)
Q′=R(Q)
K′=R(K)
K'=R(K)
K′=R(K)
最后:
A=softmax(Q′K′⊤d)
A=\\operatorname{softmax}
\\left(
\\frac{Q'K'^\\top}{\\sqrt{d}}
\\right)
A=softmax(dQ′K′⊤)
2.21 把代码和数学公式一一对应起来
现在重新看代码。
1. 生成每一组二维空间的旋转频率
inv_freq = 1.0 / (
base ** (
torch.arange(0, dim, 2).float() / dim
)
)
对应:
θi=base−2i/d
\\theta_i = base^{-2i/d}
θi=base−2i/d
2. 获取位置
t = torch.arange(seq_len)
对应:
m=0,1,2,…,L−1
m=0,1,2,\\dots,L-1
m=0,1,2,…,L−1
3. 计算位置乘频率
freqs = torch.outer(t, inv_freq)
对应:
mθi
m\\theta_i
mθi
4. 扩展到完整 hidden dimension
emb = torch.cat((freqs, freqs), dim=–1)
使 cos/sin 能够和当前 rotate_half 的向量布局匹配。
5. 计算旋转矩阵中的 cos 和 sin
cos = emb.cos()
sin = emb.sin()
对应:
cos(mθi)
\\cos(m\\theta_i)
cos(mθi)
和:
sin(mθi)
\\sin(m\\theta_i)
sin(mθi)
6. 实现旋转矩阵中的交叉项
rotate_half(q)
对应二维情况下的:
[−q2,q1]
[-q_2,q_1]
[−q2,q1]
7. 完整执行旋转
q_embed = q * cos + rotate_half(q) * sin
对应:
R(mθ)q
R(m\\theta)q
R(mθ)q
同理:
k_embed = k * cos + rotate_half(k) * sin
对应:
R(nθ)k
R(n\\theta)k
R(nθ)k
8. 最终 Attention 内积
虽然没有写在这段代码里,但后续会计算:
attention_scores = q_embed @ k_embed.transpose(–1, –2)
于是:
⟨Rmq,Rnk⟩
\\langle R_mq,R_nk\\rangle
⟨Rmq,Rnk⟩
可以化简为:
⟨q,Rn−mk⟩
\\langle q,R_{n-m}k\\rangle
⟨q,Rn−mk⟩
因此 attention score 自然获得相对位置信息。
2.22 一个简化版 RoPE 实现
如果只是为了理解数学原理,可以写一个更简化的版本:
import torch
def rotate_half(x):
x1, x2 = x.chunk(2, dim=–1)
return torch.cat((–x2, x1), dim=–1)
def rope(x, position_ids, base=10000):
"""
x: [batch, heads, seq_len, head_dim]
"""
head_dim = x.shape[–1]
inv_freq = 1.0 / (
base ** (
torch.arange(
0,
head_dim,
2,
device=x.device
).float()
/ head_dim
)
)
# position_ids:
# [batch, seq_len]
freqs = position_ids[..., None] * inv_freq
# [batch, seq_len, head_dim]
emb = torch.cat([freqs, freqs], dim=–1)
# [batch, 1, seq_len, head_dim]
cos = emb.cos().unsqueeze(1)
sin = emb.sin().unsqueeze(1)
return x * cos + rotate_half(x) * sin
本质上仍然只有一句:
x_rotated = x * cos + rotate_half(x) * sin
这就是二维旋转矩阵的向量化实现。
2.23 RoPE 的核心可以压缩成三句话
理解 RoPE 时,可以只记住下面三点。
第一:
将 attention head 的特征维度拆成若干二维子空间。
第二:
token 位于位置 (m) 时,在第 (i) 个二维子空间中旋转 (m\\theta_i)。
第三:
因为旋转矩阵满足
(R(m)^\\top R(n)=R(n-m)),
所以 Query 和 Key 的内积天然只依赖相对位置 (n-m)。
最终可以把 RoPE 写成:
[
\\boxed{
\\operatorname{RoPE}(x,m)
R_mx
}
]
而注意力分数满足:
⟨Rmq,Rnk⟩=⟨q,Rn−mk⟩
\\boxed{
\\langle R_mq, R_nk\\rangle=
\\langle q,R_{n-m}k\\rangle
}
⟨Rmq,Rnk⟩=⟨q,Rn−mk⟩
这两个公式基本就是 RoPE 的全部核心。
3. 总结
RoPE 并不是“给 token 加一个位置向量”,而是:
根据 token 的位置
↓
计算旋转角度
↓
旋转 Query / Key
↓
计算 QK^T
↓
利用旋转矩阵性质
↓
自然得到相对位置 n – m
对应到代码:
inv_freq
负责定义不同维度的旋转频率;
freqs = torch.outer(t, inv_freq)
负责计算每个位置对应的旋转角度;
cos
sin
表示二维旋转矩阵中的三角函数项;
rotate_half(x)
负责构造:
[−x2,x1]
[-x_2,x_1]
[−x2,x1]
这样的交叉项;
最终:
x * cos + rotate_half(x) * sin
完成真正的二维旋转。
而 RoPE 最关键的数学性质:
R(mθ)⊤R(nθ)=R((n−m)θ)
R(m\\theta)^\\top R(n\\theta)=
R((n-m)\\theta)
R(mθ)⊤R(nθ)=R((n−m)θ)
使得 Transformer 在使用绝对 position id 对 Q/K 做旋转以后,Attention score 却天然具有相对位置编码的效果。
这也是 RoPE 能够成为当前大语言模型中最常见的位置编码方案之一的主要原因。