大家好,我是搬砖工呀。
性能改进是每种语言,每个运行时永恒不变的追求,.Net当然也不例外。
每次新版本的.Net发布。Stephen Toub都发布一篇长篇大制作。介绍最新版本的性能改进。昨天晚上.Net11的性能改进发布了。文章很长,20多个章节,估计可以打印成一本几百页的pdf。
文章内容大体分布如下:
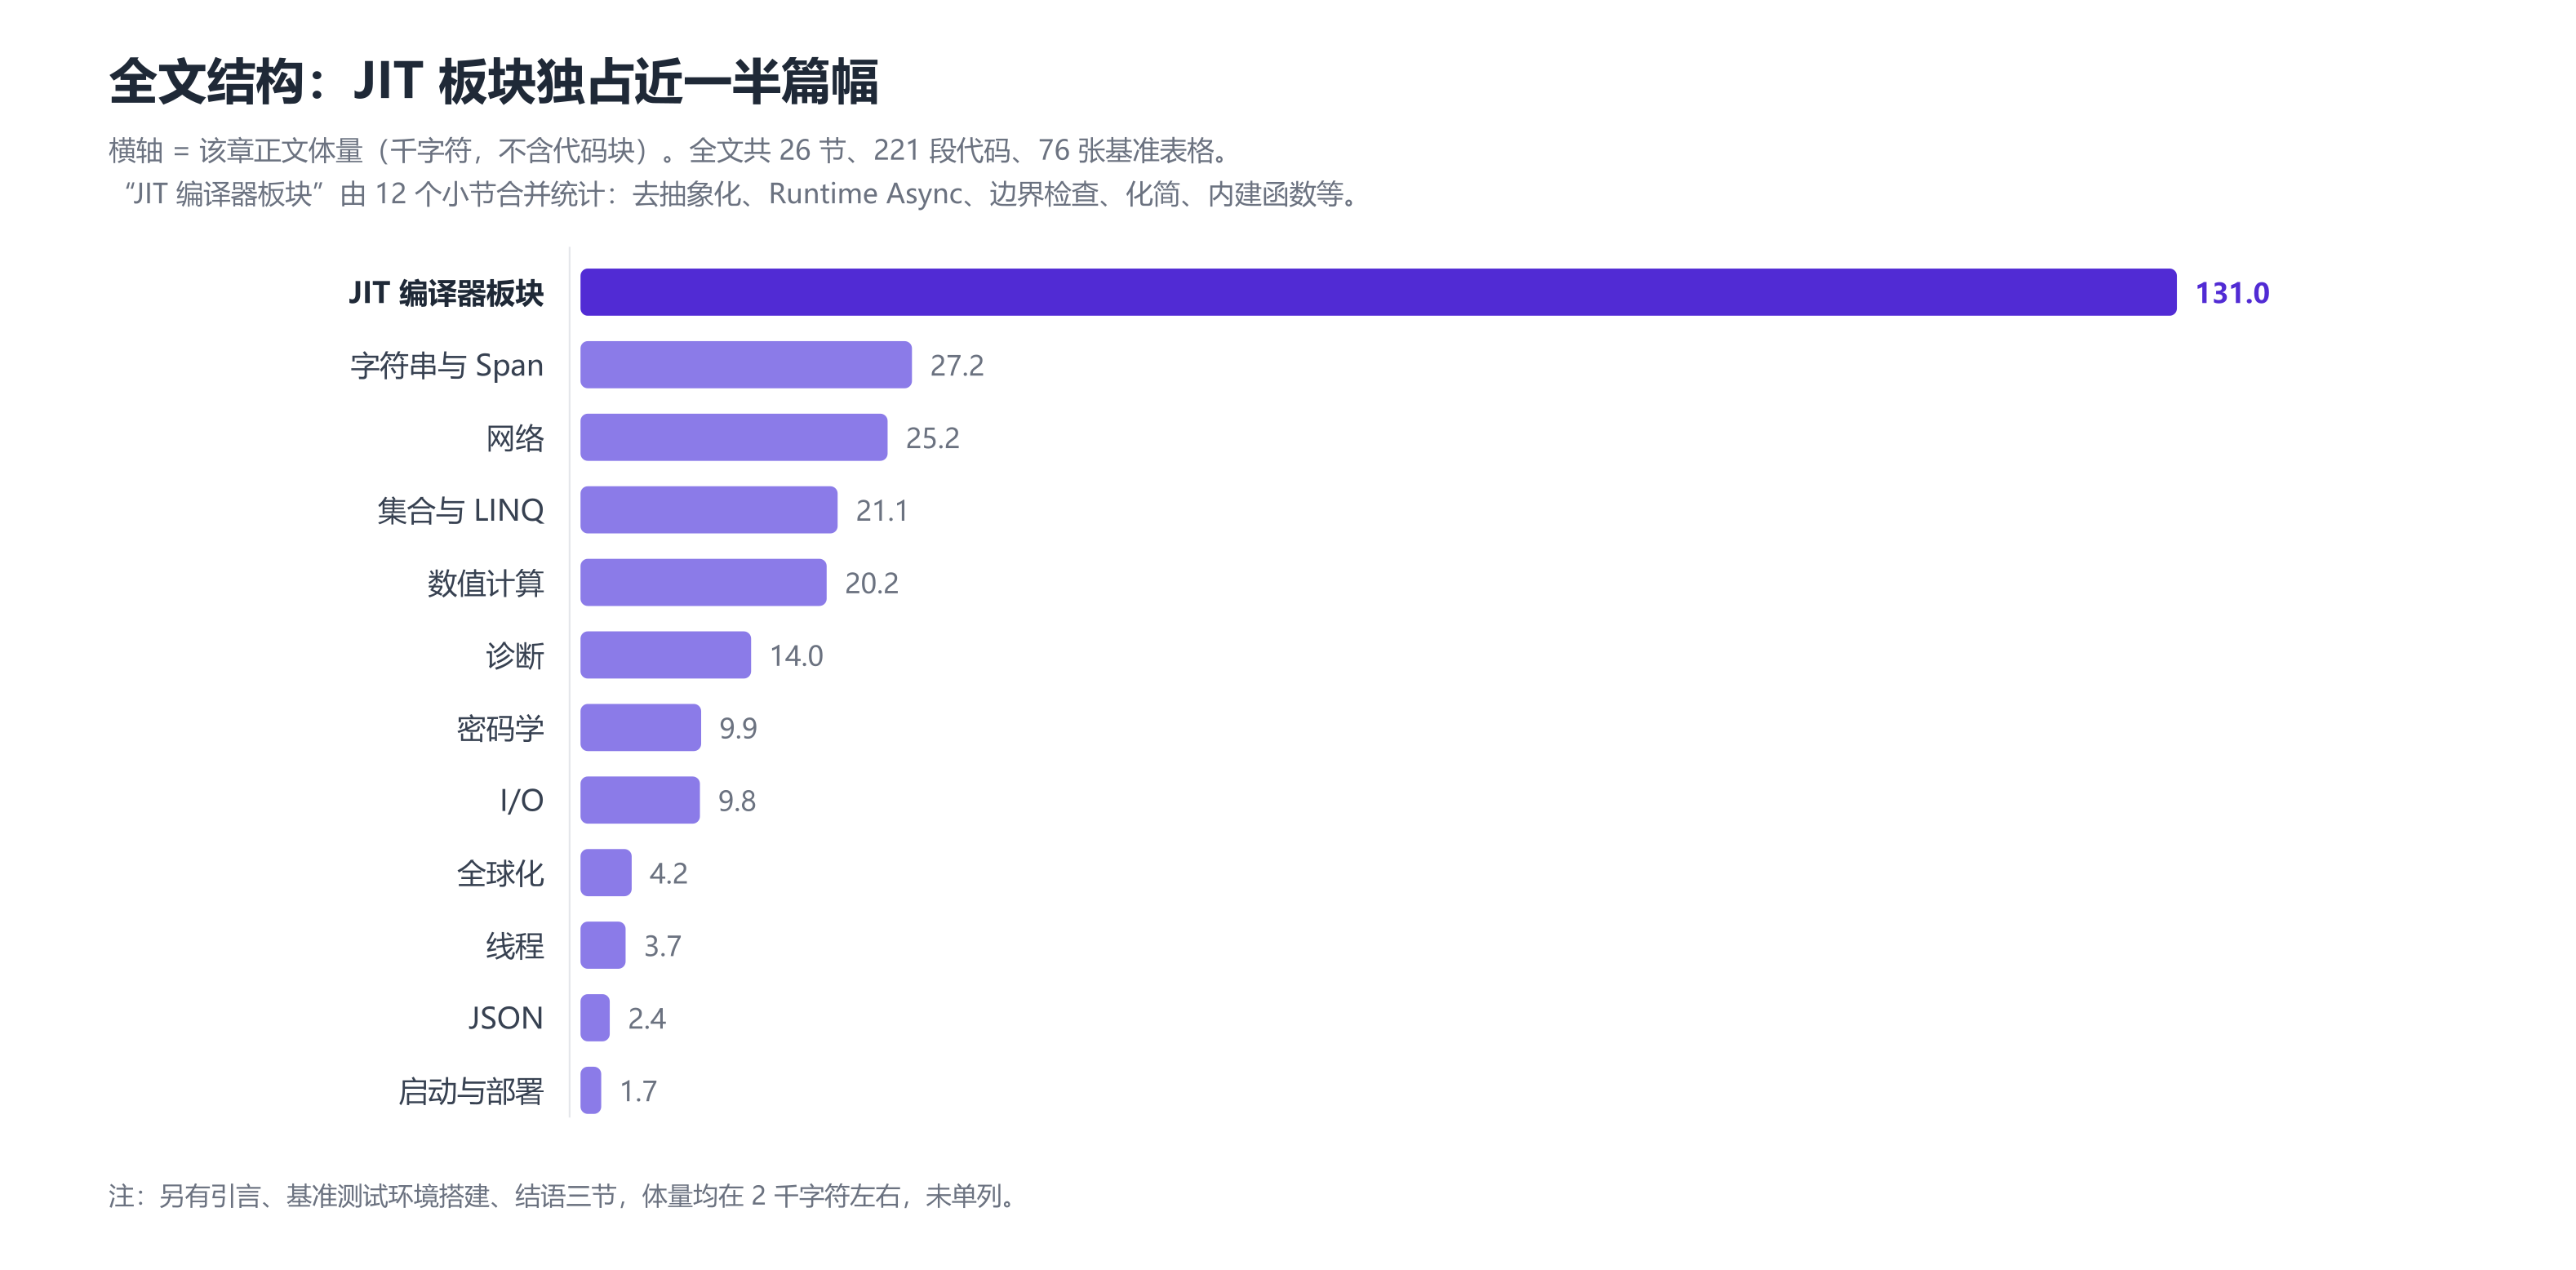
改进涉及到方方面面。既有基础库的,Jit配合的,NativeAot的,零零总总,五花八门。
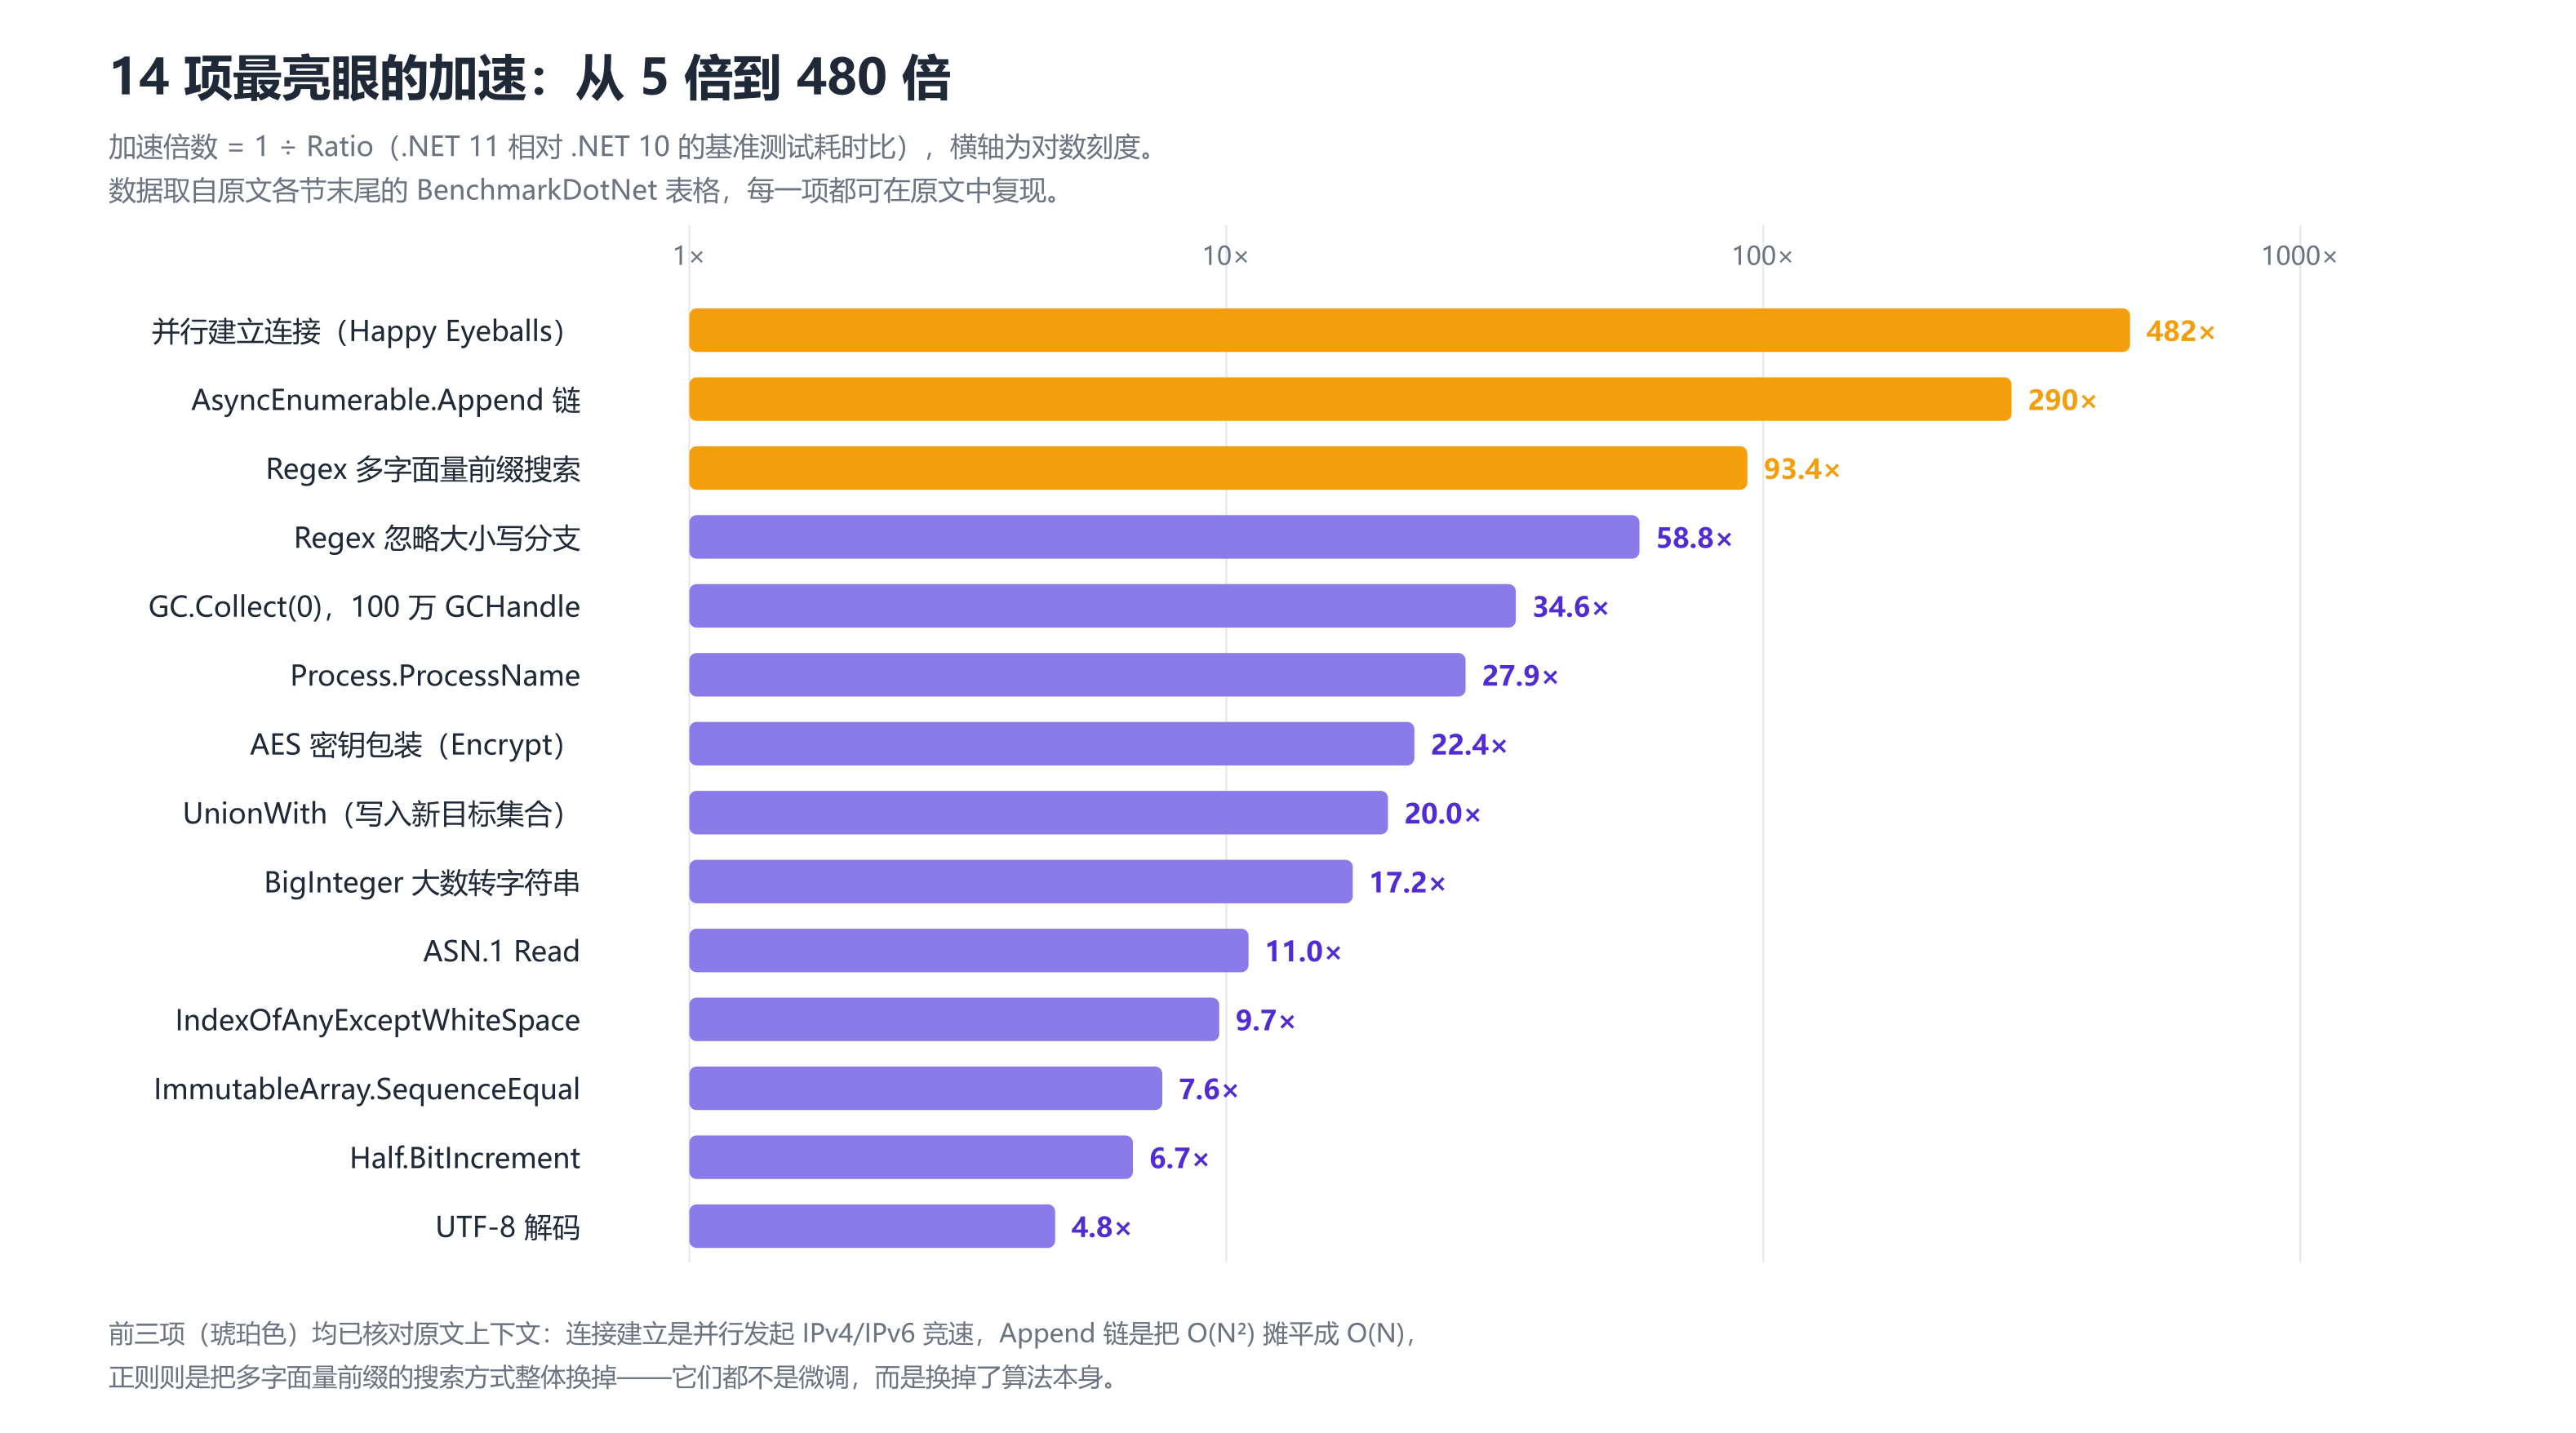
性能干你最亮眼的地方:
我们就看我个人最感兴趣的RuntimeAsync。
RuntimeAsync
Async差不多时.Net平台最早开始的了。我们在C#5.0中引入这个异步编程关键字。之前我们都是Beginxx,Endxx.说起来那都是历史的眼泪了。
Async是个状态机的语法糖。大家都知道。
static async Task<int> ReadLengthAsync(Stream stream, CancellationToken cancellationToken)
{
var buffer = new byte[4096];
int bytesRead = await stream.ReadAsync(buffer, 0, buffer.Length, cancellationToken);
return bytesRead;
}
在编译器帮助下,实际会生成这样代码
[AsyncStateMachine(typeof(<ReadLengthAsync>d__0))]
static Task<int> ReadLengthAsync(Stream stream, CancellationToken cancellationToken)
{
<ReadLengthAsync>d__0 stateMachine = default;
stateMachine.builder = AsyncTaskMethodBuilder<int>.Create();
stateMachine.state = –1;
stateMachine.stream = stream;
stateMachine.cancellationToken = cancellationToken;
stateMachine.builder.Start(ref stateMachine);
return stateMachine.builder.Task;
}
struct <ReadLengthAsync>d__0 : IAsyncStateMachine
{
public int state;
public AsyncTaskMethodBuilder<int> builder;
public Stream stream;
public CancellationToken cancellationToken;
private TaskAwaiter<int> awaiter;
public void MoveNext()
{
int result;
try
{
TaskAwaiter<int> localAwaiter;
if (state != 0)
{
byte[] buffer = new byte[4096];
localAwaiter = stream.ReadAsync(buffer, 0, buffer.Length, cancellationToken).GetAwaiter();
if (!localAwaiter.IsCompleted)
{
state = 0;
awaiter = localAwaiter;
builder.AwaitUnsafeOnCompleted(ref localAwaiter, ref this);
return;
}
}
else
{
localAwaiter = awaiter;
awaiter = default;
state = –1;
}
result = localAwaiter.GetResult();
}
catch (Exception e)
{
state = –2;
builder.SetException(e);
return;
}
state = –2;
builder.SetResult(result);
}
}
生成代码的核心问题在于,编译器会为每个 async 方法生成一个独立的状态机结构体,这在某些场景下会带来显著开销。
-
内存与 GC 开销:每个异步方法调用都会在堆上分配一个状态机对象和一个 Task 对象(约 100-200 字节)。在高频调用或递归场景下(如 FibAsync),这会导致数百万次分配,给 GC 带来巨大压力,可能使性能下降 20-50%。
-
调试与诊断困难:编译器生成的状态机代码会污染调用栈,产生大量 MoveNext() 等难以理解的帧,导致堆栈跟踪信息碎片化,断点绑定异常,极大地增加了调试难度。
-
动态场景瓶颈:对于递归或动态展开的异步调用,await 点的数量无法在编译时预测,静态生成的状态机无法进行有效优化,导致“分配爆炸”。
还有经典问题:async void 方法中的异常无法被常规的 try/catch 捕获,会直接传播到 AppDomain,导致进程崩溃。此外,与 SynchronizationContext 和 AsyncLocal 交互时,也可能出现微妙的上下文传递与行为变化问题。
.Net团队这些年当然并没有闲着,一直在改进这个问题。最早的ValueTask,IValueTaskSource,还有自定义AsyncMethodBuilder.各种优化真的很多。多到都快不会用了。
这些方案,一直都治标不治本,只能解决一部分问题。为此他们甚至尝试实验过Go的Green Thread,最后结论对Asp.net core性能影响很大,还是不合适,于是放弃。
经历很久的讨论,论证。实验,最终最终的方案,也是最难的方案。直接运行时生成。就是我们现在的RuntimAsync.
这个方案叫Async2.相信关注dotnet生态的应该听说过。最终官方名字就是我们现在的RuntimAsync
在.Net10这个特性已经在预览了。目前到11应该说正常开始使用了。基础库应该都切换过来了。
如何启用
.Net11下直接修改项目文件
<Project Sdk="Microsoft.NET.Sdk">
<PropertyGroup>
<TargetFramework>net11.0</TargetFramework>
<Features>$(Features);runtime-async=on</Features>
</PropertyGroup>
</Project>
其他地方都不用修改。所有async代码就自动切换到新的实现。瞧瞧。微软的兼容性(当然,极少情况可能会有不一样,官方有说明)。微软.Net团队,一直是务实的。真的时带着脚镣在跳舞,太不容易了。让我们为他们鼓鼓掌吧。
工作原理
编译器不再生成完整的状态机类,而只生成带有 MethodImplOptions.Async 标记的轻量级方法。运行时(CLR/JIT)负责动态管理异步的挂起与恢复。
看看例子:
async Task Test()
{
await Test();
}
编译后
.method public hidebysig
instance class [System.Runtime]System.Threading.Tasks.Task Test() cil managed async
{
ldarg.0
call instance class [System.Runtime]System.Threading.Tasks.Task Program::Test()
call void [System.Runtime]System.Runtime.CompilerServices.AsyncHelpers::Await(class [System.Runtime]System.Threading.Tasks.Task)
ret
}
一个AsyncHelpers.多么简洁。
调试体验革新:最直观的改善是堆栈跟踪变得极其清晰。一个三层嵌套的异步调用,其堆栈帧从 13 个减少到 5 个,消除了所有编译器生成的基础设施帧,使调试回归到同步代码般的直观。
带来了更好的 Native AOT 支持:运行时管理的模型更利于 Native AOT 编译,能减小应用程序体积并提升启动性能。
性能比较
我们从多个方面比较性能。不是跑的快才叫性能改进,当然这个可能最重要。
生成大小
现在的dotnet支持单文件,像脚本一样。以下代码就能运行
Console.WriteLine(await Benchmarks.Layer0());
public class Benchmarks
{
public static async Task<int> Layer0() => await Layer1();
private static async Task<int> Layer1() => await Layer2();
private static async Task<int> Layer2() => await Layer3();
private static async Task<int> Layer3() => await Layer4();
private static async Task<int> Layer4() => await Layer5();
private static async Task<int> Layer5() => await Layer6();
private static async Task<int> Layer6() => await Layer7();
private static async Task<int> Layer7() => await Layer8();
private static async Task<int> Layer8() => await Layer9();
private static async Task<int> Layer9()
{
await Task.Yield();
return 42;
}
}
性能比较:
| Async | 10,752 字节 | 1.00 |
| RuntimeAsync | 5,632 字节 | 0.52 |
生成的dll文件小了将近一半,优秀。
内存分配
测试代码如下:
// dotnet run -c Release -f net11.0 –filter "*"
// The project also needs the `runtime-async=on` feature switch set.
using BenchmarkDotNet.Attributes;
using BenchmarkDotNet.Configs;
using BenchmarkDotNet.Running;
using System.Runtime.CompilerServices;
BenchmarkSwitcher.FromAssembly(typeof(Benchmarks).Assembly).Run(args);
[MemoryDiagnoser(false)]
[GroupBenchmarksBy(BenchmarkLogicalGroupRule.ByCategory)]
[HideColumns("Job", "Error", "StdDev", "Median", "RatioSD")]
public class Benchmarks
{
private static readonly Task<int> s_completed = Task.FromResult(42);
[Benchmark(Baseline = true), BenchmarkCategory("Completed")]
public Task<int> ClassicCompleted() => ClassicCompletedOuter();
[Benchmark, BenchmarkCategory("Completed")]
public Task<int> RuntimeCompleted() => RuntimeCompletedOuter();
[Benchmark(Baseline = true), BenchmarkCategory("Yielding")]
public Task<int> ClassicYielding() => ClassicYieldingOuter();
[Benchmark, BenchmarkCategory("Yielding")]
public Task<int> RuntimeYielding() => RuntimeYieldingOuter();
[RuntimeAsyncMethodGeneration(false)]
private static async Task<int> ClassicCompletedOuter() => await ClassicCompletedInner();
[RuntimeAsyncMethodGeneration(false)]
private static async Task<int> ClassicCompletedInner() => await s_completed;
private static async Task<int> RuntimeCompletedOuter() => await RuntimeCompletedInner();
private static async Task<int> RuntimeCompletedInner() => await s_completed;
[RuntimeAsyncMethodGeneration(false)]
private static async Task<int> ClassicYieldingOuter() => await ClassicYieldingInner();
[RuntimeAsyncMethodGeneration(false)]
private static async Task<int> ClassicYieldingInner()
{
await Task.Yield();
return 42;
}
private static async Task<int> RuntimeYieldingOuter() => await RuntimeYieldingInner();
private static async Task<int> RuntimeYieldingInner()
{
await Task.Yield();
return 42;
}
}
namespace System.Runtime.CompilerServices
{
[AttributeUsage(AttributeTargets.Method)]
internal sealed class RuntimeAsyncMethodGenerationAttribute(bool runtimeAsync) : Attribute
{
public bool RuntimeAsync => runtimeAsync;
}
}
内存占用比较:
| ClassicCompleted | 21.221 ns | 1.00 | 144 B | 1.00 |
| RuntimeCompleted | 6.151 ns | 0.29 | 0 B | 0.00 |
| ClassicYielding | 254.139 ns | 1.00 | 248 B | 1.00 |
| RuntimeYielding | 116.927 ns | 0.46 | 168 B | 0.68 |
性能快了最少1倍,内存占用少了最多可以不分配内存。
多层嵌套
我们模拟最多30层的嵌套async调用。
// dotnet run -c Release -f net11.0 –filter "*"
// The project also needs the `runtime-async=on` feature switch set.
using BenchmarkDotNet.Attributes;
using BenchmarkDotNet.Running;
using System.Runtime.CompilerServices;
BenchmarkSwitcher.FromAssembly(typeof(Benchmarks).Assembly).Run(args);
[MemoryDiagnoser(false), HideColumns("Job", "Error", "StdDev", "Median", "RatioSD")]
public class Benchmarks
{
[Params(1, 10, 30)]
public int Depth;
[Params(false, true)]
public bool Yield;
[Benchmark(Baseline = true)]
public int Classic() => Invoke(ClassicThrowAsync(Depth));
[Benchmark]
public int Runtime() => Invoke(RuntimeThrowAsync(Depth));
private static int Invoke(Task<int> task)
{
try
{
return task.GetAwaiter().GetResult();
}
catch (InvalidOperationException)
{
return –1;
}
}
[RuntimeAsyncMethodGeneration(false)]
private async Task<int> ClassicThrowAsync(int depth)
{
if (depth == 0)
{
if (Yield) await Task.Yield();
throw new InvalidOperationException("uh oh");
}
return await ClassicThrowAsync(depth – 1);
}
private async Task<int> RuntimeThrowAsync(int depth)
{
if (depth == 0)
{
if (Yield) await Task.Yield();
throw new InvalidOperationException("uh oh");
}
return await RuntimeThrowAsync(depth – 1);
}
}
namespace System.Runtime.CompilerServices
{
[AttributeUsage(AttributeTargets.Method)]
internal sealed class RuntimeAsyncMethodGenerationAttribute(bool runtimeAsync) : Attribute
{
public bool RuntimeAsync => runtimeAsync;
}
}
最终结果喜人:
| 1 | False | Classic | 4.727 μs | 1.00 | 1.6 KB | 1.00 |
| 1 | False | Runtime | 3.558 μs | 0.75 | 1.16 KB | 0.72 |
| 1 | True | Classic | 6.308 μs | 1.00 | 1.68 KB | 1.00 |
| 1 | True | Runtime | 8.211 μs | 1.30 | 1.42 KB | 0.85 |
| 10 | False | Classic | 19.469 μs | 1.00 | 15.13 KB | 1.00 |
| 10 | False | Runtime | 5.885 μs | 0.30 | 2.13 KB | 0.14 |
| 10 | True | Classic | 24.923 μs | 1.00 | 15.63 KB | 1.00 |
| 10 | True | Runtime | 6.122 μs | 0.25 | 2.88 KB | 0.18 |
| 30 | False | Classic | 51.302 μs | 1.00 | 84.2 KB | 1.00 |
| 30 | False | Runtime | 10.721 μs | 0.21 | 5.71 KB | 0.07 |
| 30 | True | Classic | 65.974 μs | 1.00 | 85.53 KB | 1.00 |
| 30 | True | Runtime | 11.254 μs | 0.17 | 7.72 KB | 0.09 |
可以看到。嵌套层数越多。对比越明显。性能差距当然也就越大。真的🐂
总结以下就是:
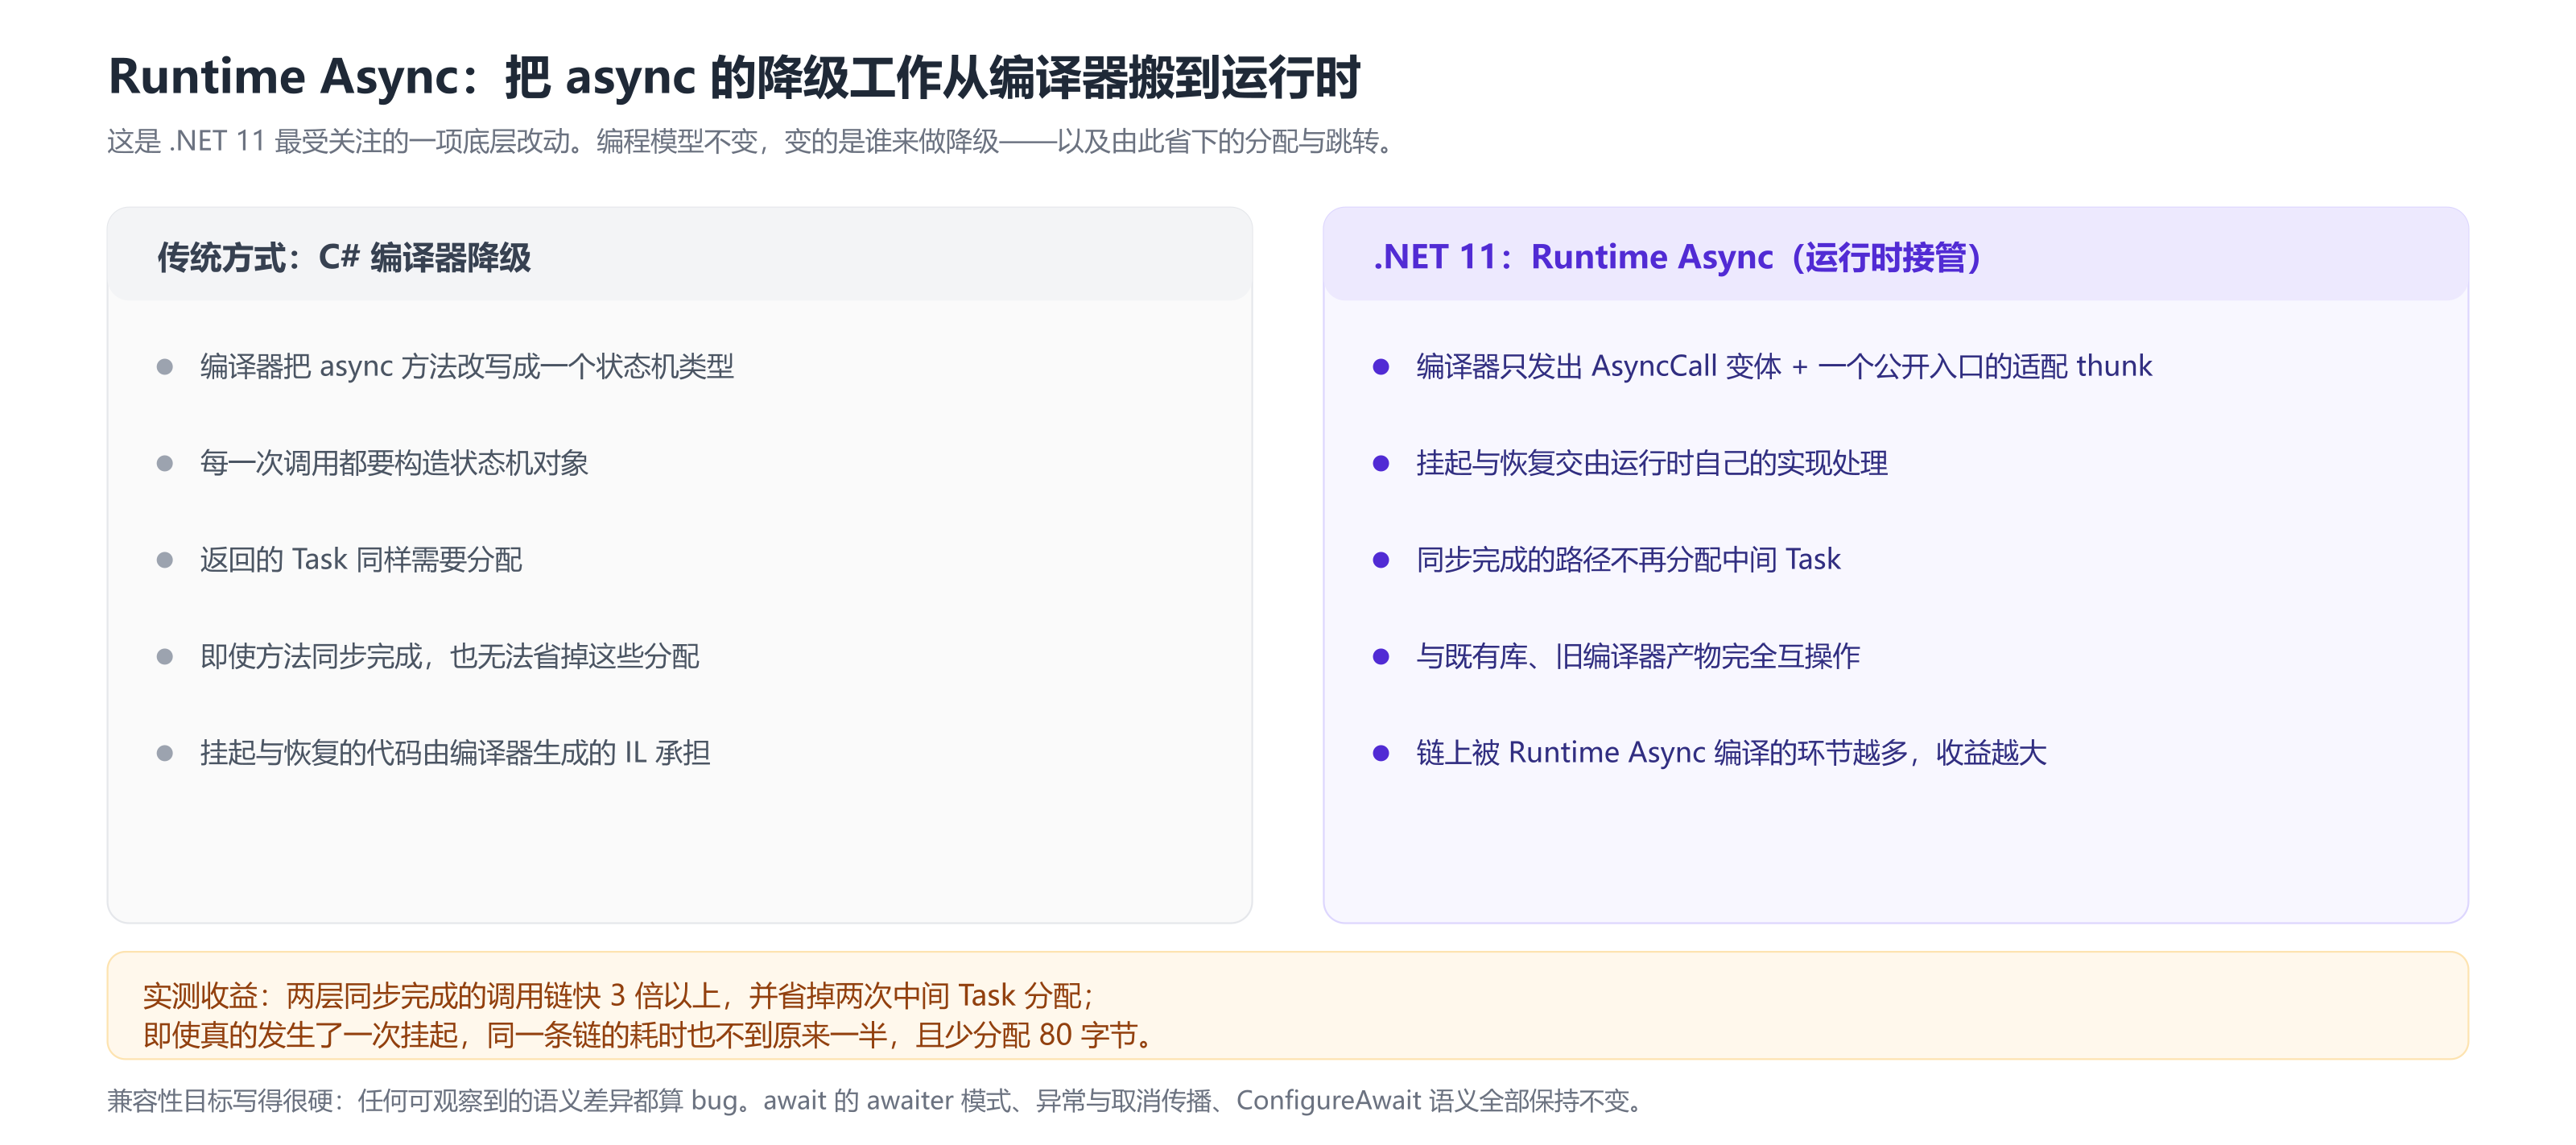
RuntimeAsync从实验走到正式,团队投入了巨大精力和时间。以下引用Toub原文
走到今天这一步,所投入的工作量极为庞大。我在 2026 年 9 月 14 日对 runtime async 跟踪标签 做了一次 GitHub 搜索,返回了 235 个 pull request,多到没法逐个列举。所以我就不尝试了;你若有空可以自己去翻翻那个标签。这项工作也不仅是直接的性能改进,还包括对诊断工具与性能工具链的改进,帮助你更好地在自己的代码里用好 async。
作为一名开发者,在有了 runtime async 之后,你应该做出哪些不同的改变?大体上,什么都不用改。继续按你想要的可读性来写异步代码,当一个大操作可以被拆成辅助方法、且那样能让代码更清晰时,就把它拆开。默认使用 Task,而在 ValueTask 的 API 与用法权衡确实契合的地方才选用 ValueTask。也不要仅仅因为今天的实现可能会分配一个中间的 Task,就去扭曲源代码、删掉一个干净的 await。降级策略应该作为一个实现细节"just work",既保留行为,又让既有源代码随着运行时改进而变得更好。
感谢微软.Net团队的坚韧不拔的努力,持续多年的迭代。总算解决了一个.Net平台的一个巨大性能问题。
说句题外话,其实Toub现在工作重心应该没有放在.Net平台上,我以为这篇文章可能有别人来发呢,看到这篇文章其实还有有一点点感动呢,就像时过年的年夜饭,少了它,总感觉似乎.Net没发布新版本呢。
今天文章就到这里,我是搬砖工。大家多多关注点赞,期待大家在留言区留下自己最真实的看法。