星火 X2.5 到底是个什么模型?官方说的能力,我逐条测了一遍
Spark-X2.5 能力实测 第 10 期 · 本该是第 1 期的一篇机器:R9-7900 + RTX 3070 8G + 64G | 引擎:llama.cpp(XHToken fork)| 跑的是 Q4_K_M 量化版这篇不测新东西,只补一件早该做的事:说清楚 X2.5 是什么、官方说它能干什么、以及——我这 9 期测下来,官方说的兑现了多少。
一、先说一件后悔的事
这个系列我已经写了 9 期:从编译、到四档速度、到写作、到真 Agent、到长输入、到量化、到选型。
但我一直没写过一篇"星火 X2.5 到底是什么"。
二、X2.5 家族:三个成员,两种命
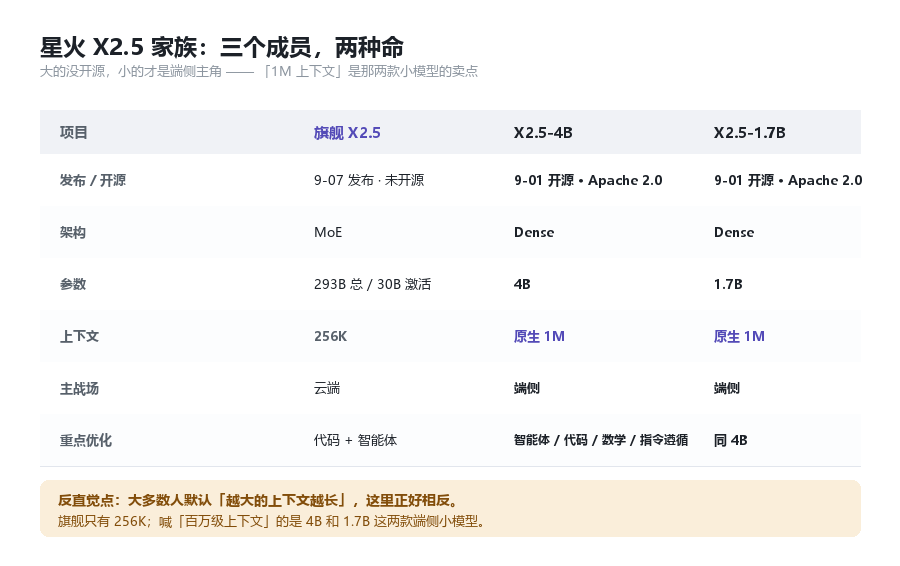
星火 X2.5 不是"一个模型",是一个家族,而且三个成员的定位完全不同:
|
发布 |
2026-09-07 |
2026-09-01 开源 |
2026-09-01 开源 |
|
架构 |
MoE |
Dense |
Dense |
|
参数 |
293B 总 / 30B 激活 |
4B |
1.7B |
|
上下文 |
256K |
原生 1M |
原生 1M |
|
主战场 |
云端 |
端侧 |
端侧 |
|
开源 |
❌ 未开源(只上 API) |
✅ Apache 2.0 |
✅ Apache 2.0 |
这里就有一个大多数人会搞反的点:
"1M 上下文"是那两款小模型的卖点,不是旗舰的。旗舰 293B 官方口径只有 256K;真正喊"百万级上下文"的,是 4B 和 1.7B。
我一开始也默认"大的那个上下文最长",翻了官方模型卡才发现反了。
还有一层:它是讯飞全资子公司"词元星火"做的,权重和代码放在 Hugging Face / GitHub,Apache 2.0——这是能直接下载到自己电脑上跑的,不是只能调 API 的闭源模型。我这 9 期的所有测试,跑的就是这两个开源档。
三、官方说它能干什么(我尽量照原文列)
3.1 端侧两款的官方定位
官方给 4B/1.7B 的原话大意是:
"4B 级端侧通用语言 Dense 模型,采用混合注意力架构,原生支持最长 1M token 上下文,并支持 200 多种语言,在语言理解、文本创作、数学推理、编程、工具调用和智能体工作流等广泛的日常任务中表现优异,领先同尺寸开源模型。"
翻译成大白话,官方声称的卖点有四个:
端侧首个原生支持 100 万 token 上下文——「不用再把长文档切几段分别问」
混合注意力架构——省显存,让小设备也能吃长上下文
围绕四个能力优化:智能体、代码、数学、指令遵循
约 20 万亿 token 预训练,全国产算力平台完成训练
3.2 官方贴的四类场景
|
个人办公 |
数据处理、文档生成、文档翻译;4B 能"从销售数据汇总到中英文双语报告交付"全流程 |
|
代码开发 |
4B 在算法实现、代码补全等任务上"对标参数规模大 2 至 3 倍的云端模型" |
|
智能家居 |
1.7B 在家居控制测试集 Domux 上,指令端到端执行正确率 90.3%,平均响应 0.85 秒 |
|
机器人 |
支持操作控制、目标追踪、导航决策,可部署在机器人本体或边缘设备 |
3.3 官方基准成绩(4B,摘关键项)
官方 GitHub 给了完整评测表(thinking 模式、温度 1.0、top_p 0.95——和我实测用的参数一致):
|
BFCL-V4 |
Agent 工具调用 |
65.1 |
|
τ³-bench |
长时程智能体任务 |
30.4(官方表内第一) |
|
SWE-Bench Pro |
真实工程代码修复 |
44.4(第一) |
|
SWE-Bench Verified |
同上(经典版) |
41.6 |
|
AIME 2026 |
数学竞赛 |
90.7(第一) |
|
GPQA |
研究生级科学问答 |
67.4 |
|
IFEval |
指令遵循 |
93.0 |
官方称 4B 在12 项基准上为表内最高,部分项超过 Gemma4-12B 这类更大的模型。
⚠️ 但必须说清楚:以上全部是官方自报数据,截至我写这篇时未经过第三方独立复测。 4B 是发布仅一天就出的表——这类成绩单,最有意思的问题恰恰是"有多少能扛住独立评测"。
3.4 生态:它想让你怎么用它
官方从一开始就把 4B 定位成**"工具使用模型",不是聊天机器人**——这点很关键:
-
集成 Codex / Claude Code / OpenClaw / Hermes 等主流 Agent 工具
-
兼容 vLLM / SGLang / llama.cpp,能通过 Ollama / LM Studio 快速部署
-
支持英伟达、华为、海光、后摩等硬件
-
默认开启思考(可用 enable_thinking 关掉)
我这 9 期就是用llama.cpp这条路跑的——官方说的"可以本地部署"这句话,我实测确认是真的。
四、官方说的,我测到了多少
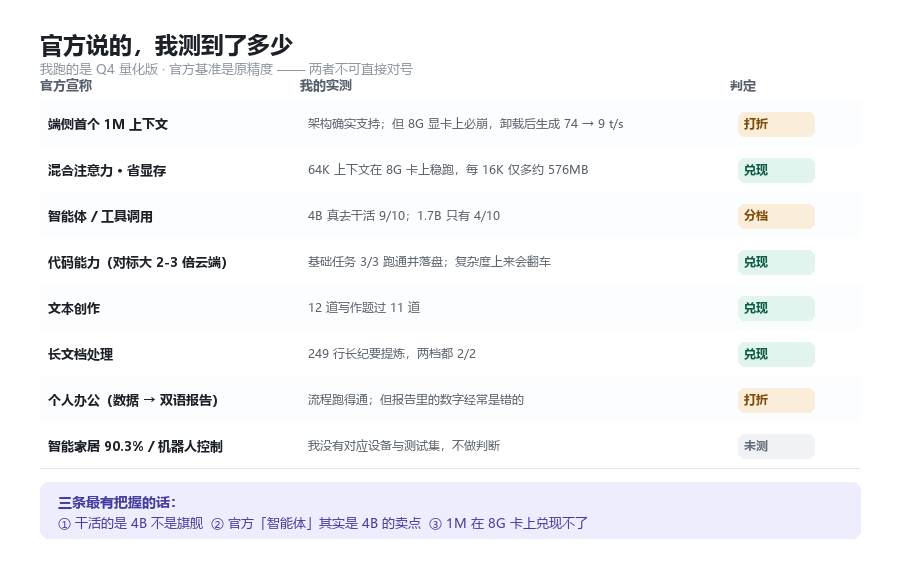
这是这篇最该有的部分。我跑的是 Q4 量化版(原精度在 8G 显存上跑不动),这一点差异要先摆在明面上。
|
端侧首个 1M 上下文 |
架构上确实是(元数据 n_ctx_train = 1048576)。但在 8G 显卡上开 1M 必崩——KV 缓存要 34GB;卸到内存能跑,但长文本生成速度从 74 t/s 塌到 9 t/s |
⚠️ 技术上做到了,消费级硬件上"能开不能用" |
|
混合注意力省显存 |
属实。64K 上下文在 8G 卡上稳跑(每 16K 只多约 576MB) |
✅ 兑现 |
|
智能体 / 工具调用 |
4B 真去调工具干活:10 题过 9 题;1.7B 只有 4/10 |
✅ 4B 兑现;⚠️ 1.7B 明显打折 |
|
代码能力"对标大 2-3 倍的云端模型" |
4B 的基础代码任务(写脚本算数、改 bug、批量改名)3/3 全过,且真的跑通、落盘 |
✅ 基础任务兑现;⚠️ "对标云端"要看任务复杂度 |
|
文本创作 |
换成对话接口后,4B 在 12 道写作题上 11/12 |
✅ 兑现 |
|
长文档处理 |
249 行长纪要提炼:两档都 2/2,1.7B 只用 97 秒 |
✅ 兑现 |
|
个人办公"数据→双语报告全流程" |
能读、能写、能出报告;但报告里的数字经常是错的,必须自己核 |
⚠️ 流程通,数字不可信 |
|
智能家居 90.3% |
我没测——手上没有对应的家居设备与测试集 |
⏸️ 不做判断 |
|
机器人控制 / 导航 |
我没测 |
⏸️ 不做判断 |
|
约 20 万亿 token 训练 |
无法从外部验证 |
⏸️ 不做判断 |
三条我最有把握的话:
"能干活的"那一档是 4B,不是那个更大的 293B——在本地这个场景里,4B 就是主力。
官方的"智能体能力",实际是 4B 的卖点。1.7B 你按"聊天 + 写作"用它很香,按"智能体"用它必翻车。
1M 上下文这个招牌,在 8G 消费级显卡上兑现不了——不是模型的错,是硬件的账。
五、结论:端侧这两款,分别到底能干什么实际工作
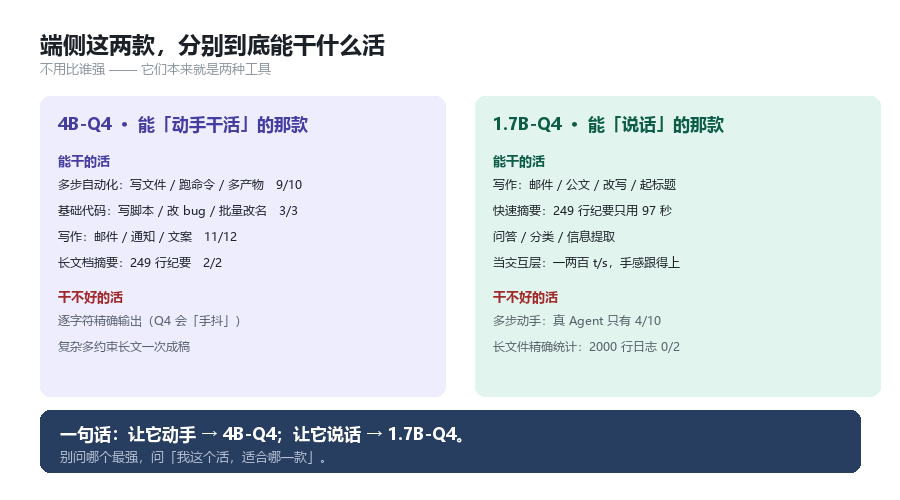
把所有测试摊开,这两款的分工其实非常清楚。你要做的只是"对号入座"。
5.1 4B-Q4 —— 能"动手干活"的那一款
|
多步自动化:写文件、跑命令、生成多个产物 |
真 Agent 10 题 9/10 |
|
基础代码:写脚本算数、改 bug、批量改名 |
代码题 3/3,且真的跑通落盘 |
|
数据处理:读长日志定位问题(配合代码统计) |
长日志题 1/2(用对方法时 115 秒过) |
|
写作:邮件、通知、文案 |
写作子集 11/12 |
|
长文档摘要:会议纪要、资料提炼 |
249 行纪要 2/2 |
它干不好的活:
-
逐字符精确输出(生成 diff、严格对齐格式)——会"手抖",丢字符、前缀粘连。这是 Q4 量化的锅,换 F16 能修好(diff 题 Q4 1/3 → F16 2/2)——但 4B-F16 在 8G 卡上慢到跑不动。
-
复杂多约束长文一次成稿——这类题连云端 293B 旗舰都做不出。
一句话:如果你的活是"让它替你动手",选 4B-Q4。8G 卡上只装一个档的话,就是它。
5.2 1.7B-Q4 —— 能"说话"的那一款
|
写作:邮件、公文、改写、起标题 |
出活快、套路文稳 |
|
快速摘要:长文档提炼 |
249 行纪要 2/2,只用 97 秒,比 4B 还快 |
|
问答 / 分类 / 提取 |
单轮问答类表现不差 |
|
当交互层:快 |
生成速度一两百 t/s,手感跟得上 |
它干不好的活:
-
多步动手:统计数错、多产物不落盘、长路径拼错——真 Agent 只有 4/10
-
长文件精确统计:2000 行日志里数某个错误出现几次,0/2
-
需要"自己动手数"的任何事
一句话:如果你的活是"让它替你说",选 1.7B-Q4——它更快、写作更顺、还更省显存。别让它干活。
5.3 一张分工表
|
让它自己动手:写文件、跑命令、多步任务 |
4B-Q4 |
|
写邮件 / 公文 / 改写 / 起标题 / 快速摘要 |
1.7B-Q4 |
|
要逐字符精确(生成 diff、严格格式) |
F16——但 4B-F16 在 8G 上慢到用不了 |
|
长文档一次性读进来(真·1M) |
两款都别想,8G 卡上开不起来 |
别问"哪个模型最强",问"我这个活,适合哪一款"。 这是这个系列 9 期测下来,我最想留下的一句话。
六、诚实说明
写评测最容易被挑的,是"你到底怎么测的"。这几条我摆在明面上:
-
我测的是 Q4 量化版,在 8G 消费级显卡上跑。官方基准是原精度、跑在云端/更大设备上——两者不是一回事,别直接对号。
-
判分只看落盘产物,不采信模型嘴上说的;多轮跑、取多数决(3 轮至少过 2 轮)。
-
统计口径:短任务每档 30 次运行、长输入 6 次、量化抽测 8 次,共 88 次有效运行。
-
官方数据全部是官方自报,截至发稿未经第三方复测——包括那张"12 项第一"的基准表。
-
我没测的:智能家居、机器人控制。 这两块是官方的重点场景,但我手上没有对应设备,不做判断,也不替它背书。
七、这个系列接下来
-
这个系列的四档实测,到这里基本收口(选型结论见第 9 期)。
-
还欠读者一期:1M 上下文的代价,我会专门做一篇,补上 4B 档的数据。
-
接下来会换一个模型家族继续测(已经把权重下好了),用同一套题、同一套判分,做跨家族对照——这样你看到的才不是"某一个模型的孤证"。
测试环境:R9-7900 12C/24T · RTX 3070 8G · 64G · Windows · CUDA 13.3.1 · llama.cpp XHToken fork · Spark-X2.5-4B/1.7B Q4_K_M全系列数据来自本机运行日志,可复现。官方规格与基准引自讯飞星辰 MaaS 模型卡与官方 GitHub,均为官方口径。
