Python ETL 卡住别先重启:保留堆栈、进度状态和可重放输入
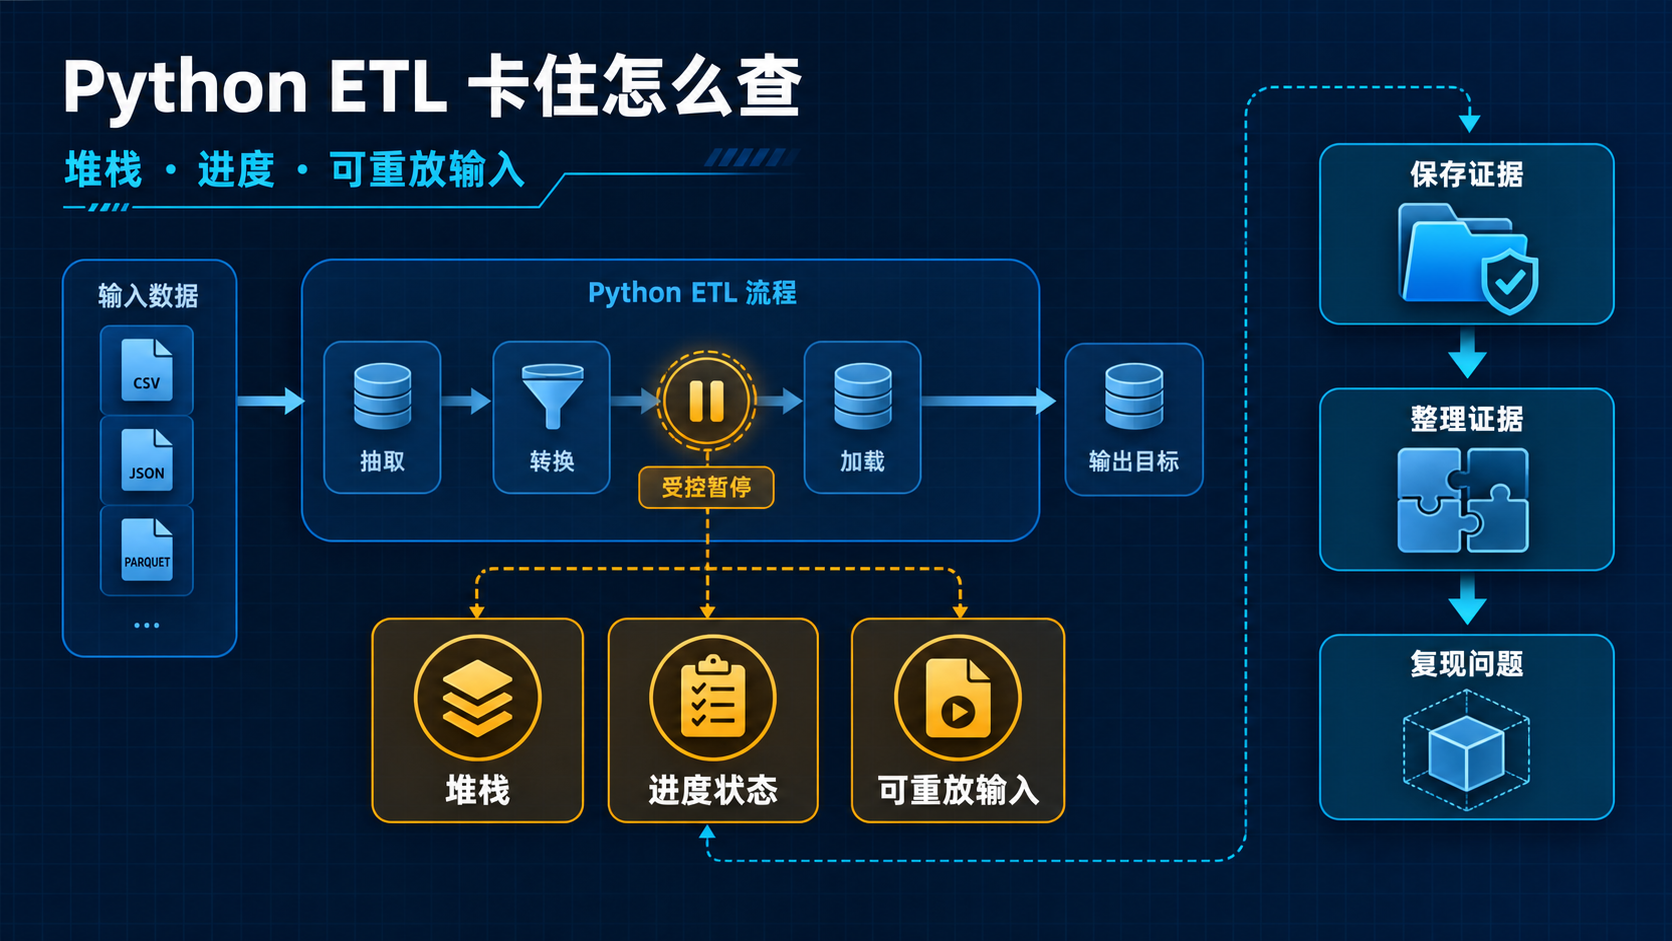
ETL 进度停住且内存上涨时,先不要马上重启 Worker。保留进程树、线程栈、内存映射、当前批次编号和最后一次提交位置,之后才有机会区分死锁、积压和单批数据过大。
恢复方案也要能重放:输入有稳定标识,输出幂等,检查点只在批次完整提交后推进。报告应保留这些状态以及内存采样窗口,便于复现和核对。
1. 数据管线批处理卡死与内存超限定位分析
在基于 Celery + Redis 构建的 Python 批处理数据管线中,Worker 节点常采用多进程(Multiprocessing)与 asyncio 混合并发模型,负责日志抓取、正则表达式解析、数据清洗及批量写入 ClickHouse。
当管线出现卡顿与内存上升时,可通过以下步骤提取诊断证据:
# 1. 打印 Worker 进程树与状态,确认进程运行状态
ps -ef | grep "python -m celery"
# 2. 向卡死的 Python 进程发送 SIGUSR1 信号,触发 faulthandler 打印 C 层面与 Python 层面完整的线程堆栈
kill -SIGUSR1 28912
# 3. 抓取该进程的内存映射快照 (pmap)
pmap -x 28912 | tail -n 10
根据 faulthandler 工具输出的线程堆栈快照,分析现场日志:
# faulthandler 打印的死锁现场证据
Thread 0x00007f92b10a1700 (idle worker):
File "/usr/lib/python3.10/asyncio/locks.py", line 214 in acquire
await fut
File "/app/pipeline/cleaner.py", line 88 in process_batch
self.lock.acquire() # <– 协程锁在异常分支下未释放
File "/app/pipeline/worker.py", line 142 in run
asyncio.run(process_batch(data))
分析表明:在 cleaner.py 中直接调用 self.lock.acquire() 时,如果处理畸形数据触发异常,异常处理分支未能执行 lock.release()。
这导致 Worker 进程永久持有锁,后续批处理任务挂起排队。而 Celery 的 Prefetch 预取机制持续从队列中拉取新任务放入内存,导致节点内存迅速升高。
2. 故障诊断证据链分析
通过 OpenTelemetry 追踪机制,按 trace_id 串联相关组件的日志快照,可以还原完整故障演进链路:
根据证据链分析,工程中存在以下核心问题:
3. 防死锁与自动化恢复数据管线代码实现
针对上述缺陷,对 Python 数据管线的核心处理逻辑进行重构。
引入基于 asyncio.Lock 的 ContextManager(async with),并加入后台内存监控与自动平滑重启机制:
import asyncio
import logging
import os
import psutil
import sys
import traceback
from typing import List, Dict, Any
# 配置带 TraceID 的结构化日志
logging.basicConfig(
format="[%(asctime)s] [%(levelname)s] [TraceID: %(threadName)s] %(message)s",
level=logging.INFO
)
class PipeLineMemoryExceededError(Exception):
"""内存超限自定义异常"""
pass
class RobustDataPipelineWorker:
"""带超时、内存检查和诊断记录的数据管线 Worker 示例。"""
def __init__(self, max_memory_mb: int = 2048):
self.lock = asyncio.Lock()
self.max_memory_mb = max_memory_mb
self.process = psutil.Process(os.getpid())
def _check_memory_safety(self):
"""确定性内存闸门:超过上限强制抛异常触发平滑回收,避免无限制占用内存"""
mem_rss_mb = self.process.memory_info().rss / (1024 * 1024)
if mem_rss_mb > self.max_memory_mb:
logging.error(f"[MEMORY_ALERT] 当前进程内存占用 ({mem_rss_mb:.2f} MB) 突破阈值 ({self.max_memory_mb} MB)!")
raise PipeLineMemoryExceededError(f"Worker 内存膨胀至 {mem_rss_mb:.2f} MB,触发保护机制")
async def process_batch_safe(self, batch_data: List[Dict[str, Any]], trace_id: str):
"""批处理入口:使用上下文管理器确保正常与异常路径都执行锁释放。"""
self._check_memory_safety()
# 使用上下文管理器,避免因为异常导致锁未释放的问题
async with self.lock:
logging.info(f"开始处理批处理任务,记录数: {len(batch_data)}", extra={"trace_id": trace_id})
for index, item in enumerate(batch_data):
try:
# 模拟日志清洗与解析逻辑
await self._clean_single_item(item)
except Exception as ex:
# 捕获具体的畸形数据行,输出可追溯的故障证据链
error_dump = {
"trace_id": trace_id,
"failed_index": index,
"bad_payload": str(item),
"exception_stack": traceback.format_exc()
}
logging.error(f"[DATA_CORRUPT_EVIDENCE] 发现畸形数据: {error_dump}")
# 将数据隔离至死信队列 (Dead Letter Queue),避免影响主管线
await self._send_to_dlq(item, error_dump)
async def _clean_single_item(self, item: Dict[str, Any]):
# 模拟解析异常
if item.get("raw_bytes") == b"BAD_DATA":
raise ValueError("遇到非法的日志字节流")
await asyncio.sleep(0.01)
async def _send_to_dlq(self, bad_item: Dict[str, Any], evidence: Dict[str, Any]):
"""隔离坏数据至死信队列"""
await asyncio.sleep(0.005)
logging.warning("数据已隔离入 DLQ,证据链已保存。")
async def main():
worker = RobustDataPipelineWorker(max_memory_mb=512)
# 模拟正常批次与畸形数据批次
test_batch = [
{"id": 1, "raw_bytes": b"GOOD_DATA"},
{"id": 2, "raw_bytes": b"BAD_DATA"}, # 会抛异常的坏数据
{"id": 3, "raw_bytes": b"GOOD_DATA"}
]
try:
await worker.process_batch_safe(test_batch, trace_id="req-trace-88912a")
except PipeLineMemoryExceededError:
logging.critical("Worker 即将平滑重启以回收内存…")
sys.exit(1)
if __name__ == "__main__":
asyncio.run(main())
通过确定性的代码控制与死信队列存证,可建立稳定的数据处理管线。
5. 复盘要还原数据状态,而不只是还原异常
处理失败后,先确认源数据是否被消费、目标是否已经写入、重试是否可能产生重复结果。死信消息保存原始输入摘要、失败阶段和处理版本,但不得包含密钥或无关敏感字段。修复逻辑后通过受控重放恢复,而不是直接把整批消息塞回主队列。重放完成再核对输入数、成功数和去重数,避免故障恢复本身制造第二次数据问题。
6. 用恢复演练确认规则真的可用
选取一小批脱敏任务模拟依赖超时和格式错误,确认消息进入死信队列、修复后可按原顺序或明确的幂等规则重放。演练结束记录恢复耗时、人工介入点和仍无法自动处理的样本。下一次改动 SDK、队列或数据模型时复跑同一场景,才能知道复盘建立的防线没有在升级中失效。
无法自动恢复的任务应有清晰的人工交接入口。
交接完成后再记录最终处理状态与原因。
处理记录保留必要的输入摘要,供后续核对。