面向逻辑思维的程序设计方法——类脑大模型小脑听觉处理设计
冯胤清
(河南 三门峡 472000)
摘要:听觉在类脑大模型中既要服务于\”听清语义、听懂情感\”的认知需求,也要服务于\”听出方位、听出危机、听得及时\”的执行与生存需求,后者要求毫秒级的快环处理,超出大脑语义链路的时标范围。本文基于面向逻辑思维的程序设计方法(LOPD)双脑架构,提出类脑大模型小脑听觉处理设计:以快环流水线(5-100 ms)承担听觉的空间、危机与快速转写职能——听觉空间处理经双耳线索与波束成形实现声源定位与声学场景识别;语音快环预处理经语音活动检测、流式识别与语句快速补全,把语音转为文字并补充为语句原语,供大脑五个子网联合处理;危险声检测识别尖叫、警报等声学事件并以应激触发机制直达生存层(如尖叫触发应激响应);音乐与情感快触发以节奏、能量与调式快检激发情感子网与感知理解子网(如舒缓音乐激发舒畅情感、激昂音乐激发振奋状态)[11-19]。文中给出小脑听觉与大脑听觉处理的分工接口(快触发-深分析)、与小脑部位模型的协作、训练方案与听觉处理质量评估体系,为类脑大模型\”听声辨位、闻警即动、听乐知感、快语入脑\”提供执行侧的听觉底座[11-19]。
关键词:类脑大模型;小脑听觉处理;声源定位;语音快转写;应激触发;声音情感触发;快环感知;七层认知模型
中图分类号:TP18;TP391 文献标志码:A
1 引言
1.1 听觉的小脑侧需求
听觉对类脑大模型的价值不止于\”听懂语言、感受音乐\”——它还承担着空间定向、危险预警与快速响应等执行侧职能[11,13]。听到身后有车驶来要立即避让,听到玻璃破碎声要瞬间警觉,听到主人叫自己的名字要立刻转头——这些响应发生在数十毫秒的时间尺度上,远快于大脑对话义、情感的深度加工(秒级)[11-13]。生物脑的听觉处理同样存在分工:听皮层负责语义与音乐的精细加工,而上橄榄核、下丘与外侧丘系等皮层下结构在数十毫秒内完成双耳线索提取与声源定位[1-2];杏仁核经\”低通路\”在丘脑水平直接接收声音信号,无需皮层加工即可触发恐惧与应激反应[7]。听觉的\”快通路\”与\”慢通路\”分工,是类脑听觉设计必须遵循的生物学格局[7,11-13]。从工程时标看,大脑语义链路的端到端时延通常在秒级(语音成句、语义化、推理都需要时间),而头部转向声源、避开危险、名字呼叫响应等行为如果等待秒级的语义分析将失去意义——这些行为需要的不是\”理解\”,而是\”及时\”。因此,类脑大模型的听觉系统需要一条独立于语义慢环的快环通路,在毫秒-百毫秒时标内完成空间定位、危机检测与快速转写,这正是本文的设计对象[7,11-13,19]。
本系列已为类脑大模型设计了听觉的大脑侧处理——《大脑听觉处理设计》以语音、音乐双通道完成\”听见→转字→成句→分析\”与\”听乐→知乐→感乐\”的深度加工,服务认知推理与情感评估[13]。但大脑听觉处理的设计定位在语义与情感(秒级慢环),听觉的空间定位(声音在哪)、危机检测(是否危险)与快速响应(要不要立即行动)属于另一条时间尺度——这正是小脑侧听觉处理的设计空间[11-13,19]。正如视觉既有《小脑视觉预处理》(毫秒级空间与执行[19])也有大脑五子网的语义加工,听觉同样需要小脑侧的快环听觉前端[13,19]。
1.2 小脑听觉处理的概念与定位
小脑听觉处理指位于感知门户与大脑听觉处理之间、以快环(5-100 ms)为时标、以空间与危机为重心、并向大脑供数听觉原语的听觉专用处理层[11-13,19]。其职能可概括为\”三听\”[11-13]:
听方位——声音从哪里来。经双耳线索(时间差、强度差)与麦克风阵列波束成形实现声源定位与声学场景识别,支撑\”转头看声源、循声找目标\”的空间行为[1-2,11,24-25]。
听危机——这声音危险吗。检测尖叫、警报、玻璃破碎等危险声学事件,触发应激机制直达生存层,实现\”闻警即动\”的毫秒级安全响应[6-9,11]。
听快语——他说了什么(快)。以语音活动检测、流式识别与语句快速补全,把语音转为文字并补充为语句原语,供大脑五个子网联合处理——小脑负责\”快转写\”,大脑负责\”深理解\”[13,15,20-23]。
此外,小脑听觉还承担\”听乐感\”的快触发职能:以节奏、能量与调式的快速检测,对音乐的愉悦与唤醒水平作出初判,触发情感子网与感知理解子网(舒缓音乐→舒畅、激昂音乐→激发),大脑侧再作深度音乐情感分析[10,13,17]。
需要说明\”小脑听觉\”的命名依据[11,19,27]:生物小脑虽不直接完成听觉语义加工,但前庭-小脑系统与听觉共享内耳与前庭神经核,小脑接受经脑干中继的听觉-前庭信息,参与声源定位中的头动补偿与听觉-运动协调[27];本设计取\”小脑\”之名,取其在本架构中的职能对应——与《小脑视觉预处理》一致,指位于L3门户与L4之间、以快环时标服务空间与执行的\”小脑侧感知层\”,而非生物小脑组织的直接仿真[11,19,27]。
1.3 本文的定位与贡献
本文是小脑侧感知设计的第二篇(继小脑视觉预处理之后),与大脑听觉处理设计构成听觉的\”快-慢\”双轨[11-13,19]。具体贡献包括:
①提出小脑听觉处理的三层功能架构(空间层-事件层-原语层)与快环流水线,确立\”听方位、听危机、听快语、感乐快触发\”的职能边界[11-13];②设计听觉空间处理机制——双耳线索提取(ITD/ILD)、波束成形声源定位与声学场景识别,支撑听觉引导的空间行为[1-2,24-25];③设计语音快环预处理流水线——语音活动检测、流式识别与语句快速补全,输出\”听觉语句原语\”供大脑五子网联合处理(与小脑视觉的Object3D对偶)[19-23];④设计危险声检测与应激触发机制——以尖叫粗糙度等声学特征检测危险事件,经生存层快通路实现应激响应[6-9,11];⑤设计音乐与情感快触发机制——以节奏能量快检激发情感子网与感知理解子网[10,13,17];⑥给出小脑听觉与大脑听觉处理的分工接口(快触发-深分析)、与大脑五子网及小脑部位模型的协作设计、训练方案与质量评估体系[11-19]。
1.4 论文结构
全文共10章:第2章阐述理论基础(听觉生理、双耳定位、鸡尾酒会、声音应激、音乐唤起、流式语音、前庭-小脑);第3章给出小脑听觉处理总体架构;第4章设计听觉空间处理(声源定位与场景);第5章设计语音快环预处理(语音→文字→成句);第6章设计危险声检测与应激触发;第7章设计音乐与情感快触发;第8章讨论与大脑五子网及小脑部位的协作;第9章给出训练、评估与应用;第10章总结展望。
1.5 小脑听觉处理在双脑架构中的位置
在LOPD双脑架构中[11-12],小脑听觉处理位于L3感知门户(听觉通道+前庭通道)与L4小脑执行层之间[11-12]:输入侧——感知门户的麦克风阵列信号与前庭通道的IMU信号(听觉与前庭在生物上共享内耳,工程上共享头部传感单元[27-28]);处理侧——快环听觉专用处理(空间/危机/快转写);输出侧——听觉原语消息供大脑子网与小脑部位模型使用[11-13]。这一位置与小脑视觉预处理(L3门户与L4小脑之间)完全对偶,两者共同构成类脑大模型的\”小脑快环感知层\”[11,19]。
1.6 小脑听觉处理与执行闭环
听觉直接参与执行的场景要求快环处理[11,19]:头部转向声源(听到说话→转头注视)、危险回避(听到警报→立即停止当前动作)、手部操作中的听觉反馈(听到物体滑落声→调整抓取)。小脑听觉处理嵌入\”感知-执行\”闭环:听觉检测结果直接驱动小脑部位模型的运动指令(转头、避让、抓取调整),无需等待大脑的语义分析[11,19]。闭环的时标预算:声源定位结果在20-50 ms内可用,危险事件检测在30-100 ms内触发应激,语音语句原语在200-500 ms内产出(供大脑慢环)[11,13,19]。执行闭环中听觉与视觉的角色差异[11,19]:视觉是\”持续的空间背景\”(连续提供物体与场景信息),听觉是\”事件触发的空间前景\”(新的声音事件驱动注意与行为切换)——听到门铃声、警报声、呼唤声都是打断当前行为并触发新行为的听觉事件,小脑听觉因此天然是\”事件驱动型\”处理器[11,19]。
1.7 小脑听觉处理与大脑听觉处理的区分
小脑听觉处理与大脑听觉处理的分工可归纳为\”四个对\”[11-13]:空间对语义——小脑听\”声音在哪\”(方位、距离、场景),大脑听\”说了什么、什么情感\”(语义、情感)[1-2,13];危机对审美——小脑对危险声(尖叫、警报)作应激响应,大脑对音乐作审美与情感加工[6-10,13];快对慢——小脑快环毫秒级输出(定位、危机、语句原语),大脑慢环秒级输出(完整语句、深度情感)[11,13];触发对分析——小脑\”快触发\”(先响应再细究:先应激后分析是否误报、先舒畅后深品音乐),大脑\”深分析\”(触发之后的理解确认与精细加工)[7,13]。两级的协作接口在第3.6节详述:小脑快触发结果作为大脑分析的\”先行线索\”,大脑分析结果作为小脑触发的\”确认与校正\”[11-13]。
2 理论基础
2.1 听觉系统的工作原理
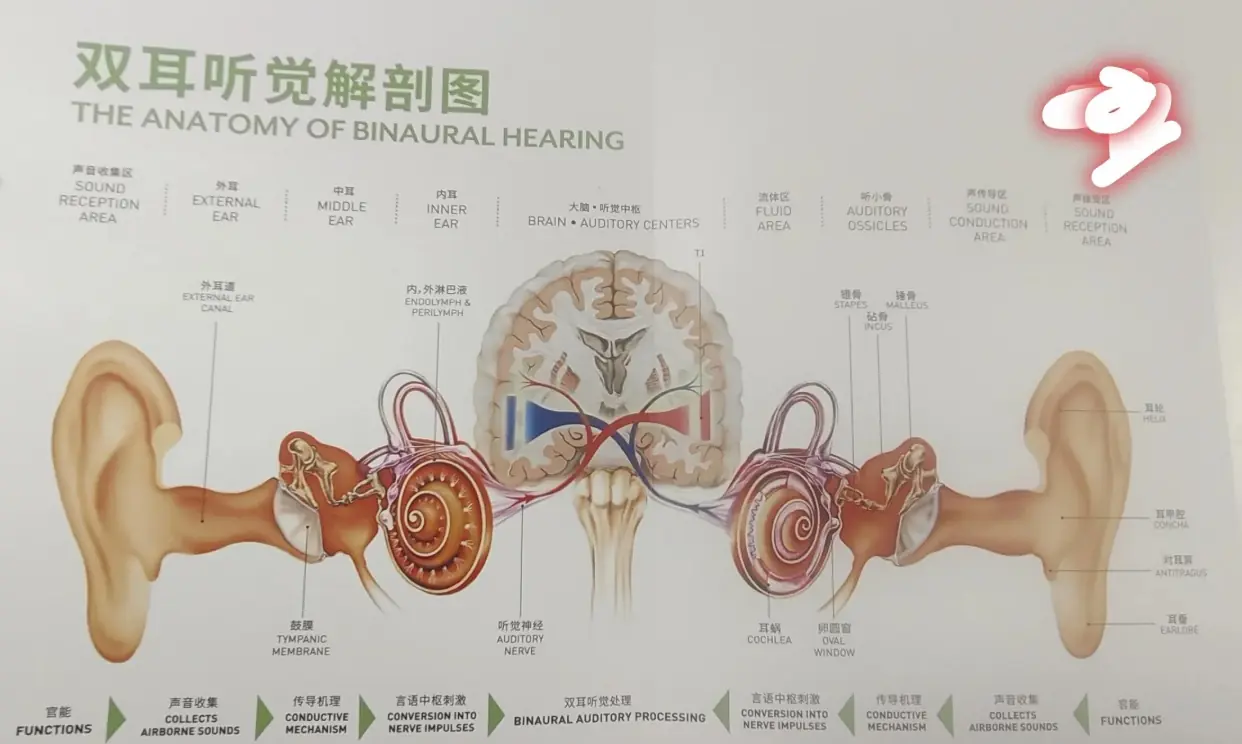
人耳听觉系统是多级信号处理链[28-29]:声波→外耳道→鼓膜振动→听小骨杠杆放大(阻抗匹配)→卵圆窗驱动内耳液体波动→基底膜频率部位编码(蜗底高频、蜗顶低频)→毛细胞机械-电转换(内毛细胞输出信号、外毛细胞主动放大)→听神经动作电位[28]。工程对应:麦克风(声电转换)→前端放大(增益)→滤波器组(基底膜的频率分解)→特征提取(毛细胞编码)[28]。
听觉的关键特性对快环设计的启示[2,28-29]:频率编码的\”部位机制\”使频谱分析成为听觉处理的天然第一级[28];动态范围压缩(毛细胞增益调节)提示前端须有自动增益控制[28];双耳协同以时间差、强度差、相位差三大神经运算实现响度叠加、噪声抑制与听觉平衡[2,28]——这是双耳声源定位的生理基础;语音主要能量集中在300-3400 Hz(电话带宽)、音乐需要20-20000 Hz宽频带,快环前端须按用途分配带宽[29]。此外,噪声暴露(85 dB以上长期)会不可逆损伤外毛细胞[28]——工程听觉系统同样需要\”听力保护\”式的过载保护设计。语音与音乐对听觉前端的要求不同:语音主要能量集中在中频段(300-3400 Hz),处理链可作频带裁剪以省算力;音乐需要保留完整宽频(20-20000 Hz)以维持音色与情感信息[29]。工程前端据此采用\”按用途分带宽\”的策略:语音支路只处理语音频带,音乐与事件支路处理宽频——各支路的滤波器组与采样率按需配置,降低整体算力消耗[11,29]。
2.2 双耳听觉与声源定位
声源定位依赖双耳线索[1-2]:耳间时间差(ITD)——声波到达两耳的时差,对低频连续声与高频瞬态声均有效;耳间声级差(ILD)——头部声影造成的高频强度差;频谱线索(HRTF)——头部、耳廓对声音的滤波提供仰角与前后消解线索[2]。Jeffress提出\”延迟线+符合检测器\”模型解释ITD编码:神经元作为符合检测器,对不同延迟的输入产生最大响应,形成声源方位的地形图[1];现代研究在哺乳动物脑干上橄榄核(内侧上橄榄核编码ITD、外侧上橄榄核编码ILD)证实并修正了这一模型[2]。工程对应:双耳式麦克风(人形机器人左右耳)采集ITD/ILD[11];头部相关传递函数(HRTF)建模提供方位依赖的频谱模板[2,11]。双耳声事件定位与检测(如BiSELD)以双耳时频特征(ITD-map、ILD-map等)驱动神经网络,同时完成声事件的检测与定位[2,11]。
2.3 鸡尾酒会问题与计算听觉场景分析
鸡尾酒会问题(多说话人混合环境中聚焦目标语音)是听觉前端的基本挑战[3-5]。Cherry的开创性实验确立了选择性听觉注意的研究范式[3];计算听觉场景分析(CASA)提出\”分割-分组-流组织\”的计算框架——把混合声音按声源分组为听觉流,再选择目标流[4];中文综述系统梳理了鸡尾酒会问题的听觉机理、多说话人分离与听觉注意建模的进展[5]。近年工作表明,听觉注意可从脑电中解码(听者在多人环境中\”在听谁\”可被单次试验EEG解码),为\”注意引导的声源选择\”提供了神经接口层面的支撑[26]。
快环听觉的工程含义[3-5,26]:小脑听觉处理须具备\”聚焦\”能力——在多人环境中锁定目标说话人(视觉注意辅助:看着谁就听谁)、抑制干扰声源,并把聚焦结果随语句原语一并供大脑(“这是对张先生说的话的转写”)[5,13,26]。聚焦的实现分层[4-5,11]:声源分离层(把混合语音分离为单说话人流)与声源选择层(按注意线索选择目标流——唤醒词方位、视觉注视方向、声学显著性),分离与选择都须在快环时标内完成,因此采用轻量分离模型+线索驱动的选择策略,而非离线级别的全分离[4-5,11,26]。
2.4 声音与应激:恐惧条件反射与尖叫检测
声音是触发应激反应的高效刺激[6-9]。Davis的恐惧增强惊跳范式证明:与恐惧条件配对的声音(如尖叫声)能显著增强惊跳反射幅度,其神经通路经杏仁核中央核投射至脑干[6]。LeDoux的情绪通路模型区分两条加工路径:低通路(丘脑→杏仁核,快速、粗糙、无需皮层——“先反应后细想”)与高通路(丘脑→皮层→杏仁核,精细但缓慢)[7]。人声研究进一步发现:人类尖叫具有独特的\”粗糙度\”声学纹络(约30-150 Hz的调幅包络),能优先激活杏仁核等恐惧网络[8];恐惧类人声可被快速自动检测,早于精细情绪加工(ERP证据)[9]。
工程映射[6-9,11]:小脑听觉处理需要一条\”低通路\”——危险声学特征(尖叫粗糙度、警报频率模式)经轻量检测器直接触发应激,不经大脑语义分析,对应LeDoux低通路[7-8];应激触发后大脑再执行\”高通路\”确认(这是真尖叫还是广播声?)并校正响应强度[7,11]。尖叫粗糙度特征(30-150 Hz调幅包络)是工程检测尖叫的关键声学线索[8]。快慢两路的工程对照:低通路对应轻量特征检测器(常驻、毫秒级、粗糙但快),高通路对应大脑语义分析(按需、秒级、精细但慢)——与双脑架构的快慢环分层一一对应,这为\”危机声音先响应后理解\”提供了神经科学级别的设计依据[7,11]。
2.5 音乐节奏与情绪唤起
音乐对情绪的影响部分经由节奏与生理唤醒实现[10,13]。实验研究表明:快节奏音乐显著提高心率与皮电等生理唤醒并诱发高唤醒情绪,慢节奏(舒缓)音乐降低唤醒、对应平静舒畅情绪[10]。音乐情绪的维度模型(效价-唤醒)为\”快触发\”提供了低维判据:快触发只需估计唤醒(快慢节奏)与效价(调式明暗)的粗略水平,即可先行激发情感子网,无需完整音乐情感识别(大脑侧深加工)[10,13]。语音情感识别综述系统梳理了语音韵律承载情感的声学线索(语调、语速、能量)与识别方法[30]——小脑听觉对语音情感的\”快判\”(语气急促→焦虑初判)可复用其中的韵律特征,细粒度语音情感分析则由大脑完成[13,30]。类脑大模型的八维情感空间为触发结果提供了映射目标(舒畅→乐、激发→喜/乐的高唤醒侧)[13,17]。音乐情感快触发的神经锚点:恐惧类人声可在精细情绪加工之前被快速自动检测(ERP证据[9]),提示声音情感存在\”粗快\”与\”细慢\”两条加工时标——音乐情绪的快触发正是利用这一\”粗快\”通道:先以节奏能量判唤醒水平(生理唤醒的证据[10]),后由大脑音乐通道细加工效价与情感类别[9-10,13]。
2.6 语音识别与流式处理基础
语音快转写依赖流式语音识别技术[20-23]。Whisper以68万小时弱监督数据训练,在噪声与多语言场景表现突出,但属整段处理(离线)[20];流式识别以增量方式实现\”边说边转\”:RNN-T(循环神经网络转换器)是流式端到端ASR的模型源头[21],带单调注意力约束的流式RNN-T支持设备端低延迟识别[22];端到端ASR综述系统比较了流