YOLO金融K线图技术形态目标检测数据集
大规模头肩底检测:YOLO26 训练与评估
📊 数据集基本信息
- 目标类别: [‘Head and shoulders bottom’, ‘Head and shoulders top’, ‘M_Head’, ‘StockLine’, ‘Triangle’, ‘W_Bottom’]
- 中文类别:[‘头肩底’, ‘头肩顶’, ‘M型头部’, ‘股票线’, ‘三角形’, ‘W型底部’]
- 训练集:9568 张
- 验证集:869 张
- 测试集:449 张
- 总计:10886 张
📄 data.yaml 配置信息
该数据集提供了data.yaml文件,内容如下:
train: ../train/images
val: ../valid/images
test: ../test/images
nc: 6
names: ['Head and shoulders bottom', 'Head and shoulders top', 'M_Head', 'StockLine', 'Triangle', 'W_Bottom']
🖼️ 标注可视化
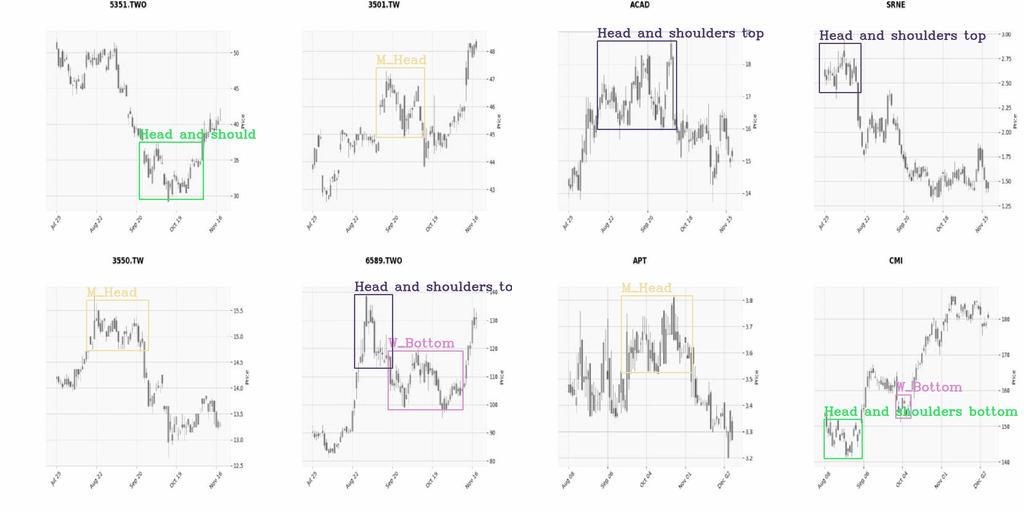
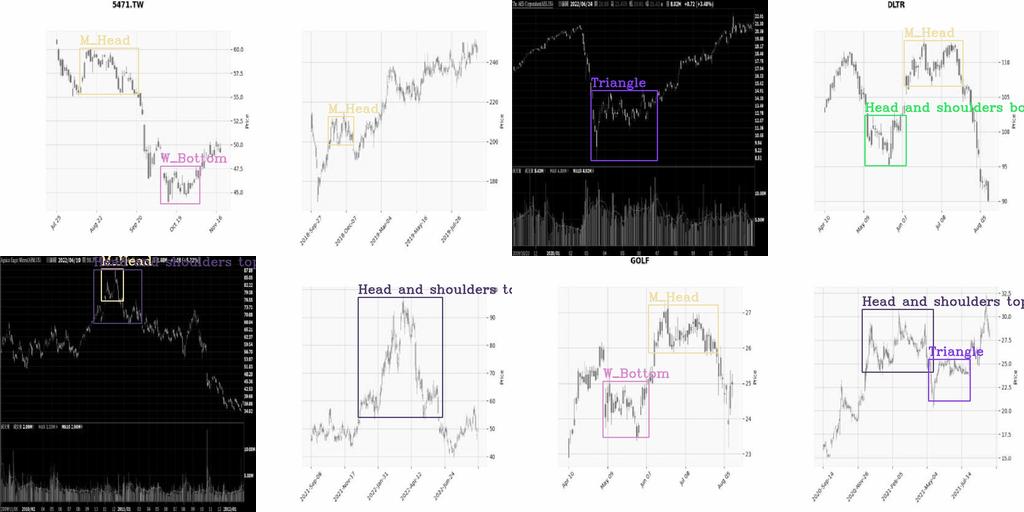
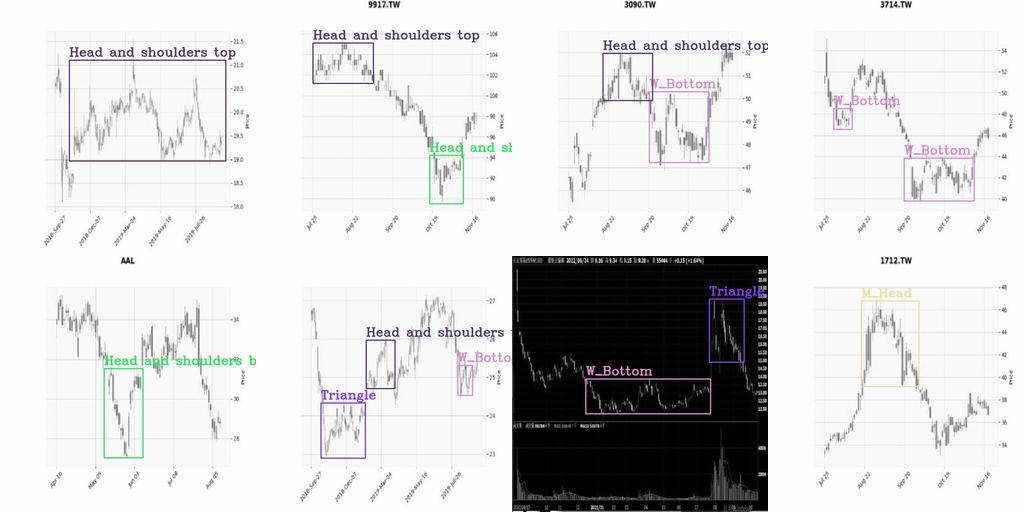
📦 数据集下载
🚀 👉 立即下载完整数据集 👈
✅ 包含全部 train / val / test 图像与 YOLO 标签,可直接训练。
数据集详细介绍
YOLO金融K线图技术形态目标检测数据集专为金融领域的技术分析与自动化交易系统设计,旨在通过图像识别技术对股票、期货等金融产品的K线图进行形态识别。该数据集的名称已明确指向其核心用途——利用目标检测模型(如YOLO系列)识别K线图中的关键技术形态,例如头肩顶、双底、三角形突破等。这些形态在技术分析中具有重要价值,常被用于预测价格走势和辅助交易决策。因此,该数据集适用于金融数据分析、量化交易算法开发以及智能投顾系统的构建。
数据集包含10886张高质量的K线图图像,涵盖6种不同的技术形态类别。虽然具体中文类别名称未提供,但根据常见金融技术分析术语推断,可能包括头肩顶、双底、三角形、矩形、上升旗形和下降旗形等典型形态。这些类别覆盖了金融市场中较为常见的趋势判断工具,有助于训练模型在复杂市场环境中准确识别不同形态。数据的多样性与代表性为模型的泛化能力提供了良好基础,尤其适合需要高精度检测的应用场景。
在标注规范方面,该数据集采用标准的目标检测标注方式,每张图片均配有边界框坐标与类别标签,确保模型能够学习到清晰的形态特征。这种结构化的标注方式不仅提升了模型训练效率,也增强了数据的可解释性与实用性。对于研究者而言,该数据集为深入探索金融图像特征提取、形态识别与模式匹配提供了可靠的数据支持,同时为实际业务场景中的模型部署奠定了坚实基础。
该数据集的典型应用方向包括金融图表自动分析、技术指标识别、交易信号生成以及智能风控系统的开发。在实际落地过程中,建议结合具体的业务需求对模型进行微调,以适应不同市场的K线图风格与波动特性。此外,可进一步扩展数据集的覆盖范围,增加更多市场类型或时间周期的数据,以提升模型的适用性与鲁棒性。
YOLO26 目标检测算法原理
很多人问 YOLO26 和 YOLO11 到底差在哪。最直观的回答是:YOLO26 的 ONNX 模型在 CPU 上跑得比 YOLO11 快 43%,而且不用写一行 NMS 代码。
端到端无 NMS 推理:传统 YOLO 模型在推理后需要执行非极大值抑制(NMS)来去除冗余检测框,这增加了后处理延迟和部署复杂度。YOLO26 默认采用一对一(one-to-one)检测头,直接输出每张图像最多 300 个检测结果 (N, 300, 6),完全省去 NMS 步骤,推理流水线大幅简化。在 CPU 上的 ONNX 推理速度相比 YOLO11n 提升高达 43%。
无 DFL 回归:YOLO26 移除了分布焦点损失(Distribution Focal Loss, DFL)结构,检测头更加轻量。边界框回归不再受限于预设的离散区间,既降低了模型复杂度又保持了同等甚至更优的回归精度。
Progressive Loss 与 STAL:训练过程中通过渐进损失(Progressive Loss)将监督信号逐步从辅助头部转移到推理阶段的主头部。小目标感知标签分配(STAL)策略特别提升小目标的正样本标签覆盖率,改善小物体检测性能。
MuSGD 混合优化器:创新性地将大语言模型常用的 Muon 优化器与 SGD 结合,实现更稳定高效的训练收敛。相比纯 SGD,MuSGD 在大 batch 训练时收敛更快且不易震荡。
模型尺度与 COCO 性能:YOLO26 提供 N/S/M/L/X 五种尺度:
| YOLO26n | 40.9 | 38.9 | 1.7 | 2.4M |
| YOLO26s | 48.6 | 87.2 | 2.5 | 9.5M |
| YOLO26m | 53.1 | 220.0 | 4.7 | 20.4M |
| YOLO26l | 55.0 | 286.2 | 6.2 | 24.8M |
| YOLO26x | 57.5 | 525.8 | 11.8 | 55.7M |
Nano 版本参数量仅 2.4M,CPU 推理速度比 YOLO11n 快 43%,适合边缘设备和小数据集;X 版本 mAP 达 57.5,适用于对准确率要求极高的场景。
双头架构设计:YOLO26 检测模型内置两个检测头——一对一(默认,无 NMS,输出 300 个检测框)和一对多(需 NMS,输出 8400 个候选框)。训练时一对多头作为辅助监督信号加速收敛,推理时默认使用一对一头实现端到端输出。
YOLO26 支持全部七大视觉任务:检测、实例分割、语义分割、深度估计、分类、姿态估计和定向边界框检测(OBB),一个框架覆盖从 2D 检测到 3D 感知的完整需求。
关键训练参数配置详解
如果你只有一张 GPU 显存不大,batch 和 imgsz 就是两个需要反复权衡的参数。建议先定 imgsz,再往显存里塞最大的 batch。
| model | – | yolo26n.pt | 预训练权重,n/s/m/l/x 五种尺度 |
| epochs | 100 | 150 | 训练总轮数 |
| imgsz | 640 | 416 | 输入图像尺寸 |
| batch | 16 | 64 | 批次大小,根据显存调整 |
| lr0 | 0.01 | 0.02 | 初始学习率 |
| lrf | 0.01 | 0.01 | 最终学习率因子(lr0 × lrf) |
| momentum | 0.937 | 0.937 | SGD 动量 |
| weight_decay | 0.0005 | 0.0005 | 权重衰减(L2 正则化) |
| warmup_epochs | 3.0 | 3.0 | 预热轮数 |
| warmup_momentum | 0.8 | 0.8 | 预热期间动量初始值 |
| box | 7.5 | 7.5 | 边界框回归损失权重 |
| cls | 0.5 | 0.5 | 分类损失权重 |
| dfl | 1.5 | 1.5 | DFL 损失权重(YOLO26 可置 0) |
| patience | 100 | -1 | 早停轮数 |
| cos_lr | False | True | 余弦学习率衰减 |
| close_mosaic | 10 | 10 | 最后 N 轮关闭 Mosaic 增强 |
| optimizer | auto | SGD | 优化器选择 |
| amp | True | True | 自动混合精度训练 |
| freeze | None | 0 | 冻结前 N 层骨干网络参数 |
| dropout | 0.0 | 0.1 | 分类头 Dropout 率,防过拟合 |
YOLO26 训练时 loss 曲线的下降速度和最终值受 lr0 和 weight_decay 影响最大。如果 loss 从一开始就降得很慢,大概率是 lr0 设低了。
学习率调参经验:
- 训练初期 loss 不下降 → 调大 lr0 或增加 warmup_epochs
- 训练后期 loss 震荡 → 降低 lr0,增大 weight_decay
- 验证集 loss 先降后升(过拟合)→ 增大 dropout、weight_decay 或减小 epochs
- 小数据集(<100张)→ lr0=0.001, weight_decay=5e-4, dropout=0.2
- 大数据集(>1000张)→ lr0=0.01, weight_decay=5e-4, batch=32+
训练可视化与TensorBoard:YOLO26 默认开启 TensorBoard 日志记录,训练过程中可实时查看 loss 曲线和指标变化。在命令行执行 tensorboard –logdir runs/detect/train 即可打开 Web 看板,每轮训练完成后自动刷新。训练结束后 results.png 生成的六合一曲线图是最直观的诊断工具——一眼就能看出是否过拟合、是否收敛、哪个 loss 在震荡。
断点续训机制:如果训练意外中断(断电、OOM 等),不用从头开始。YOLO 每轮保存 last.pt,恢复训练时指定 model=last.pt 并设置 resume=True,学习率和优化器状态都会从断点恢复,训练曲线也和连续训练一样平滑。
模型评估指标解读
看懂 YOLO 的评估输出不需要统计学位——mAP 衡量整体、PR 曲线看细节、混淆矩阵找弱类。三个工具配合使用就够了。
训练完成后,YOLO26 训练器自动输出以下指标:
mAP50(mAP@0.5):IoU 阈值为 0.5 时的平均精度均值,反映模型粗粒度定位能力。mAP50 ≥ 0.90 表示定位效果很好。
mAP50-95(mAP@0.5:0.95):IoU 从 0.5 到 0.95 共 10 个阈值上取平均。更严苛,反映精确定位能力,是更具代表性的综合评价指标。
Precision(精确率):检测结果中正确检测的比例。高 Precision 意味着虚警少。
Recall(召回率):真实目标中被成功检测到的比例。高 Recall 意味着漏检少。
F1 Score:Precision 和 Recall 的调和平均数 = 2×P×R/(P+R),综合衡量模型平衡性。
Confusion Matrix(混淆矩阵):N×N 矩阵,对角线为正确分类,非对角线为误分类,可定位类别间混淆情况。
训练曲线分析:
- train/box_loss 单调下降 → 边界框回归正常收敛
- val/box_loss 先降后升 → 过拟合风险,应增大数据增强或减小模型
- metrics/mAP50(B) 增长放缓趋于平稳 → 模型接近收敛上限
- train 持续降、val 持续升 → 严重过拟合,建议减小模型或增大 dropout
指标使用场景:
- 安全生产场景(如安全帽检测)→ 优先保证 Recall,宁可多报不能漏报
- 质检场景(如缺陷检测)→ 优先保证 Precision,降低误检率减少人工复核量
- 通用检测 → 均衡优化,关注 mAP50-95 和 F1 Score
如果 PR 曲线在中段(Recall 0.5-0.7)出现明显凹陷,通常意味着模型对某些难例的置信度摇摆不定。这种情况加 hard negative mining 或调高 conf 阈值缓解不了,需要扩充难例样本。
YOLO 系列算法演进史
不了解 YOLO 历史也能直接用 YOLO26,但知道每代解决了什么问题对调试和选型很有帮助。比如知道 v8 统一了分类/检测/分割接口,就知道 YOLO26 继承了这套 API。
YOLOv1 (2015):将检测问题建模为单一回归问题,直接在输出层预测边界框和类别概率。速度极快但定位精度较差。
YOLOv2/YOLOv3 (2016-2018):引入 anchor box 机制、特征金字塔(FPN)和多尺度训练。YOLOv3 的 Darknet-53 骨干网络成为经典架构,至今仍被广泛使用。
YOLOv5 (2020):Ultralytics 在 PyTorch 上的实现,带来了完善的训练框架、自动锚框聚类和数据增强 pipeline,大幅降低了使用门槛。
YOLOv8 (2023):统一了检测、分割、分类和关键点任务的框架,引入 C2f 模块和无锚框(anchor-free)检测头。
YOLOv9 (2024):提出 GELAN(通用高效层聚合网络)和 PGI(可编程梯度信息),同等参数量下精度提升显著。
YOLOv10/YOLOv11 (2024):YOLOv10 首次提出无 NMS 端到端检测。YOLOv11 进一步优化骨干网络和训练策略,在速度和精度之间取得新平衡。
YOLO26 (2026):集历代之大成,核心创新包括:① 端到端无 NMS 一对一检测头 ② 无 DFL 的简化回归头 ③ Progressive Loss 渐进式监督转移 ④ STAL 小目标感知标签分配 ⑤ MuSGD 混合优化器。
关键设计演进总结:
- Anchor-based → Anchor-free(v8 起)
- C3 → C2f → C3k2(骨干模块持续优化)
- 多任务统一框架(v8 起)
- NMS 后处理 → 无 NMS 端到端(v10/v26)
- 单一损失函数 → 多任务联合损失(Box + Cls + DFL,v26 可去 DFL)
YOLO26 训练步骤详解
拿到一个标注好的数据集后,训练就三件事:配置 data.yaml、选模型权重、跑 train 命令。每一步都很短。
环境准备:
pip install ultralytics
yolo checks
python -c "import torch; print(torch.cuda.is_available())"
命令行训练:
yolo detect train data=data.yaml model=yolo26n.pt epochs=150 imgsz=416 batch=64 device=0 lr0=0.02 patience=-1 cos_lr=True close_mosaic=10
Python API 训练:
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
results = model.train(
data="data.yaml",
epochs=150,
imgsz=416,
batch=64,
device=0,
lr0=0.02,
patience=–1,
cos_lr=True,
close_mosaic=10,
augment=True,
amp=True,
workers=8,
)
训练输出文件:
- runs/detect/train/weights/best.pt:验证集上 mAP 最高的权重
- runs/detect/train/weights/last.pt:最后一轮保存的权重
- runs/detect/train/results.csv:每轮 loss 和指标数据
- runs/detect/train/confusion_matrix.png:混淆矩阵图
- runs/detect/train/results.png:训练曲线图
- runs/detect/train/val_batch*_pred.jpg:验证集预测效果图
单张推理测试:
model = YOLO("runs/detect/train/weights/best.pt")
results = model("test_image.jpg")
results[0].show()
多 GPU 分布式训练:
yolo detect train data=data.yaml model=yolo26n.pt device=0,1 epochs=100
恢复中断的训练:
yolo detect train model=path/to/last.pt data=data.yaml resume=True
部署与应用建议
大规模生产部署:10886 张训练数据 + YOLO26,精度基础已经很好。重点是推理吞吐和稳定性。
model.export(format="engine", imgsz=416, half=True, batch=32)
# TensorRT FP16 + 大 batch → 单 GPU 轻松 500+ FPS
生产环境 checklist:① 导出时指定 opset=12(ONNX)/ workspace=4GB(TensorRT)② 做一轮 int8 量化对比,确认精度损失可控 ③ 压测时同时测 1/4/8/16/32 的 batch 吞吐,找到最优配置 ④ 设置 P99 < 50ms 的监控告警。
通用训练经验:10886 张图训练目标检测模型,遇到的问题是典型的——数据不多不少,精度不上不下。
这种规模的数据集,调参的边际收益其实很高。几个值得优先尝试的方向:
一是学习率的余弦退火。默认 YOLO26 用的是 cos_lr 衰减,但周期很关键。如果训练 80 轮,lr0=0.01 搭配 cos_lr=True,学习率会从 0.01 平滑降到接近 0。这个曲线比阶梯式衰减更适合中等数据集,收敛更稳定。
二是 mosaic=1.0 时最后 10 轮关闭(close_mosaic=10)。这个设置让模型在训练末期接触真实数据分布,对部署时的精度很重要。很多人忽视这个参数,训完发现部署精度掉了一大截。
三是关注训练过程中的 val_box_loss 拐点。通常 30-40 轮附近会出现一个平台期,如果 50 轮后仍无明显下降,基本可以判断当前参数组合不够理想。
持续优化的四个方向:模型训好后不是终点,以下方向可以持续提升效果。
一是增量训练策略。如果后续有新标注数据进来,别从头训,而是在 best.pt 基础上用低学习率(lr0=0.001)再跑 20-30 轮,这叫 incremental learning,既省时又能保持原有能力。
二是模型蒸馏。如果部署时需要小模型但精度不够,先用 yolo26x 训一个大模型,再用它作为教师指导 yolo26n 训练。蒸馏代码 YOLO26 原生支持,参数 teacher=teacher_model.pt 一行配置即可。
三是数据飞轮。把模型部署到生产线后,收集检测置信度在 0.3-0.6 之间的"不确定"检测结果,人工复核后加入训练集。这种主动学习(active learning)策略能用最少的标注成本换取最大的精度提升。
四是量化部署。导出 TFLite 或 TensorRT 时开启 int8 量化,模型体积缩至四分之一,推理速度快 2-3 倍,精度损失通常在一个 mAP 点以内。但量化前务必在目标硬件上用验证集重新评估精度,不同芯片的量化误差表现不同。