KV Cache 与缓存命中:搞懂大模型推理为什么快、缓存为什么便宜
调用大模型 API 时,输入 token 会分成两类计价:缓存命中和缓存未命中,两者的价差通常在一个数量级以上。很多人知道"要提升命中率",却说不清到底命中了什么、为什么它就能便宜这么多。
这篇文章解决一件事:把 KV Cache 和缓存命中这两件事讲透。覆盖 KV Cache 是什么、为什么只缓存 K/V 而不缓存 Q、Prefill 与 Decode 两阶段的分工、缓存命中的匹配规则,以及怎么让自己的 prompt 更容易命中。价格只作为引入话题的引子,机制才是重点。
一、先厘清:缓存命中,命中的到底是什么
先说结论:所谓"缓存命中",命中的是历史请求已经算好的 KV Cache。 新请求的前缀如果和之前某个请求完全一致,这部分结果就不必重算,直接复用——所以它既便宜又快。
1.1 一个引子
2026 年 8 月 17 日,DeepSeek API 执行新的价格:同样是输入 100 万 token,命中缓存收 0.05 元,未命中收 1.50 元。
同一份输入,30 倍价差。(调价前这个差距是 50 倍——这次调整把相对差距收窄了,但绝对金额的差距反而更大。)
这个价差本身就是个信号:被命中的那部分工作,几乎不消耗算力。要理解它为什么近乎免费,得先搞懂三件事——KV Cache 是什么、它缓存了什么、推理的两个阶段各自在干什么。
价格以官方定价页的实时口径为准。本文以机制为主,账单细节不再展开。
1.2 本文的知识地图
| KV Cache 是什么、解决什么问题 | 第二章 |
| 为什么只缓存 K、V,不缓存 Q | 第三章 |
| 推理为什么分两阶段、哪一段更贵 | 第四章 |
| 缓存命中怎么判定、怎么用 | 第五章 |
| 怎么让自己的 prompt 更容易命中 | 第六章 |
二、KV Cache:算过的不重算
2.1 自回归生成,本质上是一个循环
LLM 生成文本是逐 token 进行的:给定前文,预测下一个 token,把它拼回输入末尾,再预测下一个,如此循环。
这个循环里,每一步都要做一次完整的 Transformer 前向——包括一次完整的注意力计算。
2.2 没有缓存的世界:O(t²) 的重复计算
注意力机制里,每个 token 都会算出三个向量:Query(Q)、Key(K)、Value(V)。生成新 token 时,当前 token 要拿自己的 Q 和之前所有 token 的 K、V 做注意力计算。
关键在于:历史那些 token 的 K 和 V 上一步已经算过了,只要上下文没变,结果就不会变。
如果每生成一个 token 就把整段序列重算一遍,会是这样:
| 第 1 个 | 1 个 token |
| 第 2 个 | 2 个 token |
| 第 N 个 | N 个 token |
累加起来是 O(t²) 的重复计算。生成 1000 个 token 的回复,前面 999 个 token 的 K、V 会被反复算近千次。
而且成本是累积的:越往后,每一步要重算的历史越长。这就是"越用越卡"的由来。
2.3 缓存下来:KV Cache 的定义
解法很朴素:算过的不重算。
推理引擎把历史 token 的 K、V 张量缓存在显存里,下一步直接读取复用,只计算新 token 的那一份。这份被缓存的键值张量,就叫 KV Cache。
一个直观的类比:让一个人读一本 100 页的文档回答问题。第一次他得读完才能答;第二次换个问题,如果内容还记得,就不必重读那 100 页——但答案仍然是现场组织出来的,不是把上次的答案复制一遍。KV Cache 就是这个"记住的文档"。
🔴 重点:KV Cache 缓存的是输入侧的中间结果,不影响输出的生成方式。即使命中了缓存,答案依然是通过推理生成出来的,temperature 等参数的随机性照常存在。
一句话总结:KV Cache 是"算过的不重算"——把历史 token 的 K/V 存下来复用,把 O(t²) 的重复计算压回线性。
三、为什么只缓存 K、V,不缓存 Q
这是理解 KV Cache 时最容易被带偏的一环。
3.1 注意力机制里的三个向量
每个 token 经过投影,都会产生 Q、K、V 三个向量。用搜索引擎打个比方:
| Query(Q) | 当前 token 的"检索请求" | 用户输入的查询词 |
| Key(K) | 每个 token 的"索引标签" | 网页标题 |
| Value(V) | 每个 token 的"内容本体" | 网页正文 |
注意力计算的过程,就是拿当前 token 的 Q 去和所有历史 token 的 K 做匹配,算出该关注谁(注意力权重),再用这些权重对历史 token 的 V 做加权求和。
3.2 三个向量各自的下场
三者的复用次数天差地别:
- Q 用完即弃。它只服务于"当前这一个 token 该关注谁"这一件事,算完就结束了。下一个 token 会有自己的新 Q。复用次数:1。
- K 要反复读取。后续每一个新 token 都要拿自己的 Q 和它做匹配。复用次数:N。
- V 同样要反复读取。注意力权重算完之后,每一轮都要用它做加权求和。复用次数:N。
数学上也能验证。注意力分数矩阵 S = KᵀQ 展开后,第 n 列只依赖 K₁:ₙ 和 Qₙ——前面那些列的 Q 会被直接丢掉,一个都不影响结果(推导见参考资源里 Lior Sinai 那篇解析)。
所以:K 和 V 是资产,Q 是一次性用品。
3.3 两个流行说法的辨析
关于"为什么不缓存 Q",有两种说法流传很广,但都站不住:
❌ 说法一:因为 Q 的体积小
因果颠倒。Q 不缓存不是因为它小——它和 K、V 同量级,一样占显存——而是因为它用不上。体积从来不是判断依据。
❌ 说法二:因为 Q 不重要
这是硬错。Q 决定当前 token 关注谁,是注意力的入口,少了它整个机制就废了。一次性的东西,不等于不重要的东西。
✅ 正确的理解分三层:
3.4 一点延伸:这个判断标准不只用于 KV Cache
第三层才是真正有价值的部分。把它抽象出来,就是缓存设计的一般原则:
值得缓存的价值 = 单次计算成本 × 复用次数 − 存储与查找成本
按这个式子看,Q 的复用次数是 1,收益直接归零——所以不管它多重要,都不值得缓存。反过来,一个看起来不起眼的中间结果,如果复用次数足够高,就值得存下来。
🔴 重点:"重要"是价值判断,"复用次数"是工程判断。做缓存时只认后者。
一句话总结:K/V 被复用 N 次所以必须缓存,Q 只用一次所以不缓存;判断标准是复用次数,不是重要性。
四、Prefill 与 Decode:推理的两个阶段
KV Cache 解释了"为什么可以复用",接下来要解释"复用掉的那部分工作有多贵"。答案是:推理按阶段分,最贵的那一段恰好可以被缓存跳过。
4.1 两个阶段在做什么
| Prefill(预填充) | 一次性处理整个输入 prompt,建立 KV Cache | 整个 prompt,几百到几万 token | ✅ 全部 token 并行 |
| Decode(解码) | 逐个生成新 token,每步读一次 KV Cache | 每次 1 个 token | ❌ 严格串行 |
Prefill 是"读懂你说了什么",Decode 是"一个字一个字往外写"。
4.2 两种完全不同的瓶颈
vLLM 官方博客的表述很直接:
- Prefill 阶段是 compute-bound(算力受限):prompt 里成百上千个 token 一起进矩阵乘法,能把 GPU 的 Tensor Core 塞满,纯拼算力。
- Decode 阶段是 memory-bandwidth-bound(显存带宽受限):一次只算一个 token,矩阵乘法小得可怜,但仍然要把全部模型权重和 KV Cache 从显存读一遍。核心大部分时间在等数据搬运。
这就是为什么同一张卡跑 Prefill 和跑 Decode,表现完全是两回事:
| Prefill | 算力(TFLOPs) | 换算力更强的卡 |
| Decode | 显存带宽(TB/s) | 换带宽更高的卡、优化 KV 读取 |
一个实用的诊断经验:首 token 慢 = Prefill 瓶颈,字间延迟慢 = Decode 瓶颈。 A100 的 2.0 TB/s 对上 H100 的 3.35 TB/s,差的就是 Decode 这一段。
4.3 两个延迟指标
这两个阶段各自对应一个用户能感知的指标:
- TTFT(Time to First Token,首 token 延迟):从发出请求到收到第一个 token 的时间,由 Prefill 决定。你贴进去一篇十万字的文档问"总结一下",等的那几秒就是它在跑。
- ITL(Inter-Token Latency,字间延迟):相邻两个 token 之间的间隔,由 Decode 决定,也就是打字机效果的速度。上下文越长,KV Cache 越大,要搬的数据越多,这一段越慢。
4.4 为什么 Prefill 是"最贵"的那一段
从成本结构上看:
- Prefill 的计算量随 prompt 长度线性增长,而且是真正的浮点运算密集负载,烧的是 GPU 最贵的资源;
- Decode 的浮点运算量极小,瓶颈在数据搬运,而搬运成本还能通过批处理摊薄。
于是对一个固定前缀(比如 5000 token 的 system prompt + 工具定义):
- 第一次请求:必须完整跑一遍 Prefill,实打实烧算力;
- 第 1000 次请求:如果前缀完全一样,这段 Prefill 的结果本来可以被复用——但没有缓存的话,就得从头再算第 1000 遍。
这就是缓存命中要解决的浪费。
📌 一个量级参考:官方曾公布过一组数据(DeepSeek-V2 时代),一个 128K 的长 prompt,首 token 延迟从 13 秒降到 500 毫秒。降下来的那 12.5 秒,全是被跳过的 Prefill。
一句话总结:Prefill 吃算力、决定 TTFT,Decode 吃显存带宽、决定 ITL;Prefill 是算力大头,而它恰好是可以被缓存跳过的那一段。
五、缓存命中:复用 Prefill 的结果
5.1 机制:硬盘缓存,默认开启
DeepSeek 的 Context Caching on Disk 对所有用户默认开启,不需要改任何业务代码。每次请求都会触发构建硬盘缓存;后续请求如果和前面的请求有重叠前缀,重叠部分就直接从缓存中读取——这部分计为 cache hit。
这里的关键词是硬盘缓存,不是内存。这是 DeepSeek 与多数厂商不同的地方:硬盘便宜、容量大,所以缓存能留得住(官方口径:几小时到几天)。
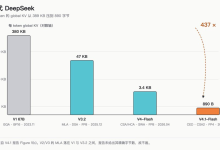
而这件事之所以可行,是因为 DeepSeek 用 MLA 把 KV Cache 压得足够小——每 token 每层只需 576 个元素,比标准 MHA 少两个数量级,小到能经济地放进磁盘。架构层面的压缩和 API 侧的计费,在这里合上了。(压缩手段本身属于推理优化,见[推理篇 02])
5.2 匹配规则:整段前缀完全匹配
这是最容易踩坑的地方。官方文档写得很明确:
A subsequent request can only hit the cache if it fully matches a cache prefix unit.
命中要求完整匹配一个"缓存前缀单元"(cache prefix unit)。每个单元是独立、完整的单位——不是前缀有一部分一样就能命中,得整体对上。
缓存前缀单元在三种时机产生:
| 请求边界 | 每个请求会在用户输入末尾和模型输出末尾各产生一个单元 |
| 公共前缀检测 | 系统检测到多个请求共享一个前缀时,把它持久化为独立单元 |
| 固定 token 间隔 | 长输入 / 长输出按固定间隔切分单元,避免超长前缀因为到不了"边界"而完全无法缓存 |
⚠️ 一个硬约束:匹配从第 0 个 token 开始。官方发布公告里说得很直白——只有前缀完全相同(从第 0 个 token 起)的请求才算重复,输入中间某一段相同不会触发命中。
中间相同没用,相似更没用。
另外三条性质要记住:
- 尽力而为:官方明确不保证 100% 命中率;
- 只匹配输入:命中的是输入前缀,输出仍完整推理生成;
- 会自动清理:缓存不再使用后,通常几小时到几天内清除。
5.3 两个典型例子
例一:多轮对话(能命中)
第一轮请求是 system + 用户问题A。第二轮在末尾追加上 助手回答A + 用户问题B。
第二轮能完整匹配上第一轮在"用户输入末尾"产生的缓存前缀单元 → 命中 system + 问题A 这一整段。
这就是多轮对话天然适合缓存的原因:每一轮都在上一轮的完整前缀之上追加,前缀从不被改写。
例二:长文档问答(要预热才能命中)
第一轮:system + 长文档 + 问题一
第二轮:system + 长文档 + 问题二
这两轮都不会命中——因为两轮的"用户输入末尾"不一样(问题不同),没有现成的缓存前缀单元能完整匹配。
但在第二轮结束后,系统检测到前两轮共享了 system + 长文档 这个公共前缀,把它持久化为独立的缓存前缀单元。于是第三轮(system + 长文档 + 问题三)就能完整匹配上,命中前面这一大段。
两个例子合起来说明一件事:缓存的生效有一个"预热"过程。第一轮不命中是正常的,关键在于从第二轮、第三轮开始能不能稳定命中——而能不能稳定命中,取决于你的 prompt 前缀是否被设计得足够稳定。
5.4 怎么观测命中情况
不要靠感觉判断有没有命中,看响应里的 usage 字段:
{
"usage": {
"prompt_cache_hit_tokens": 4864,
"prompt_cache_miss_tokens": 260,
"prompt_tokens": 5124
}
}
| prompt_cache_hit_tokens | 本次输入中命中缓存的 token 数 |
| prompt_cache_miss_tokens | 本次输入中未命中的 token 数 |
| prompt_tokens | 等于前两者之和 |
命中率 = hit / (hit + miss)。这个数字就是你 prompt 结构的体检报告——低于预期,说明前缀里有东西在变。
一句话总结:缓存命中要求从第 0 个 token 起完整匹配一个缓存前缀单元,中间相同不算;命中率可以直接从 usage 字段读出来。
六、工程实践:让 prompt 前缀稳定下来
理解了规则,剩下的就是照着规则把 prompt 结构理顺。
6.1 一条原则:固定在前,动态在后
按"稳定性"给 prompt 排序,稳定的往前放:
| 1 | system prompt(角色、规则、输出格式约束) | 几乎不变 |
| 2 | 工具定义 / Function Calling schema | 很少变 |
| 3 | few-shot 示例 | 很少变 |
| 4 | RAG 检索到的固定知识库内容 | 随文档变,一般不频繁 |
| 5 | 多轮对话历史 | 逐轮追加(天然可缓存) |
| 6 | 用户当前提问 | 每次都变 |
只要 1–4 这一段被稳定缓存住,绝大部分输入 token 走的都是命中路径。
🔴 重点:前缀越长、越稳定,收益越大。 缓存的价值与命中长度成正比,所以把长内容往前放,不只是结构美观问题。
6.2 六种"悄悄毁掉缓存"的写法
每一条都对着"必须从第 0 个 token 起完整匹配"这条铁律。
① 把时间戳写进 system prompt
# ❌ 每次都变,前缀永远无法匹配
system = f"当前时间:{datetime.now()}。你是一个客服助手……"
当前时间 放在第一位,等于把整个前缀的有效期压缩到一秒钟。挪到用户消息里,或者干脆去掉——模型不需要知道现在几点,除非业务真的依赖。
② 动态 ID 拼在开头
# ❌ 用户 ID 一换,整段前缀作废
system = f"用户ID:{user_id}。你是一个……"
③ few-shot 示例顺序随机
示例如果是 random.sample 出来的,每轮顺序不同,前缀就不同。要么固定顺序,要么把示例挪到更靠后的位置。
④ RAG 检索片段顺序不稳定
这条最隐蔽。检索回来的 top-k 片段如果按相似度浮点值排序,分数抖动会导致顺序抖动,几千 token 的上下文全部作废。对策是给排序加一个稳定的 tie-breaker(比如片段 ID),或者对片段 ID 做一次固定顺序的重排。
⑤ 工具定义序列化顺序不稳定
把工具 schema 从字典序列化成 JSON 时,如果用的库不保证 key 顺序,每次生成的字符串就不一样。用 json.dumps(…, sort_keys=True),或者直接固化一份预序列化的字符串常量。
⑥ 多轮对话里"反复重写历史"
每轮把历史消息做一次摘要压缩,会导致前缀被改写——改写点之后的内容全部失效。要做摘要压缩,就把压缩后的结果当作新一轮的起点重新累积,别每轮都重压一次。
这六条的共同点:前缀的稳定性不是自动的,是被设计出来的。
6.3 一段最小验证脚本
from openai import OpenAI
client = OpenAI(
api_key="sk-xxx",
base_url="https://api.deepseek.com",
)
# 固定的长前缀:放前面,绝不掺动态内容
SYSTEM = "你是一名资深财务分析师……(此处省略 5000 字分析规范与输出模板)"
def ask(question: str):
resp = client.chat.completions.create(
model="deepseek-flash",
messages=[
{"role": "system", "content": SYSTEM}, # 固定,前置
{"role": "user", "content": question}, # 动态,后置
],
)
u = resp.usage
hit = getattr(u, "prompt_cache_hit_tokens", 0)
miss = getattr(u, "prompt_cache_miss_tokens", 0)
total = hit + miss
rate = hit / total if total else 0
print(f"命中 {hit} / 未命中 {miss} / 总计 {total} = 命中率 {rate:.1%}")
return resp.choices[0].message.content
for q in ["营收结构拆一下", "盈利能力怎么样", "费用率是否合理"]:
ask(q)
✅ 预期现象:第一次命中率接近 0,从第二次起跳上去。如果三次都接近 0,说明 SYSTEM 里混进了每次都在变的东西——回到 6.2 逐条排查。
⚠️ 顺带提醒 model 参数:官方现在推荐的模型名是 deepseek-flash(对应 DeepSeek-V4.1-Flash)。旧的 deepseek-v4-flash 虽然还能传,但会被路由到新模型并按 Flash 计价。别在两个脚本里写两个不同的名字,还以为在用两个模型。
一句话总结:固定内容前置、动态内容后置,避开六种破坏前缀稳定性的写法,命中率自然就上去了。
七、总结:你真正需要记住的 N 件事
验证清单
- 能用自己的话说清"KV Cache 缓存了什么、为什么 Q 不缓存"
- 能区分 Prefill 与 Decode 的瓶颈各是什么,以及它们分别对应哪个延迟指标
- 连续发起两次同前缀请求,确认第二次的 prompt_cache_hit_tokens 明显大于 0
- 按业务链路分别统计命中率 = hit / (hit + miss),定位命中最差的那条链路
- 检查 system prompt 里有没有时间戳、动态 ID、随机数等每次都变的内容
- 检查工具定义 / JSON schema 的序列化是否固定了 key 顺序
- 检查 RAG 检索片段的排序是否稳定(有没有 tie-breaker)
参考资源
- DeepSeek Context Caching 官方文档:https://api-docs.deepseek.com/guides/kv_cache
- DeepSeek 上下文硬盘缓存发布公告:https://api-docs.deepseek.com/news/news0802/
- DeepSeek 模型与定价:https://api-docs.deepseek.com/quick_start/pricing
- vLLM 官方博客(Prefill / Decode 瓶颈划分):https://blog.vllm.ai/
- Lior Sinai《DeepSeek’s Multi-Head Latent Attention》(K/V 复用性的数学推导):https://liorsinai.github.io/machine-learning/2025/02/22/mla.html
- KV Cache 的显存占用与压缩手段,见本系列《推理篇 02:vLLM 部署与推理优化实战》