一、理解磁盘基本结构
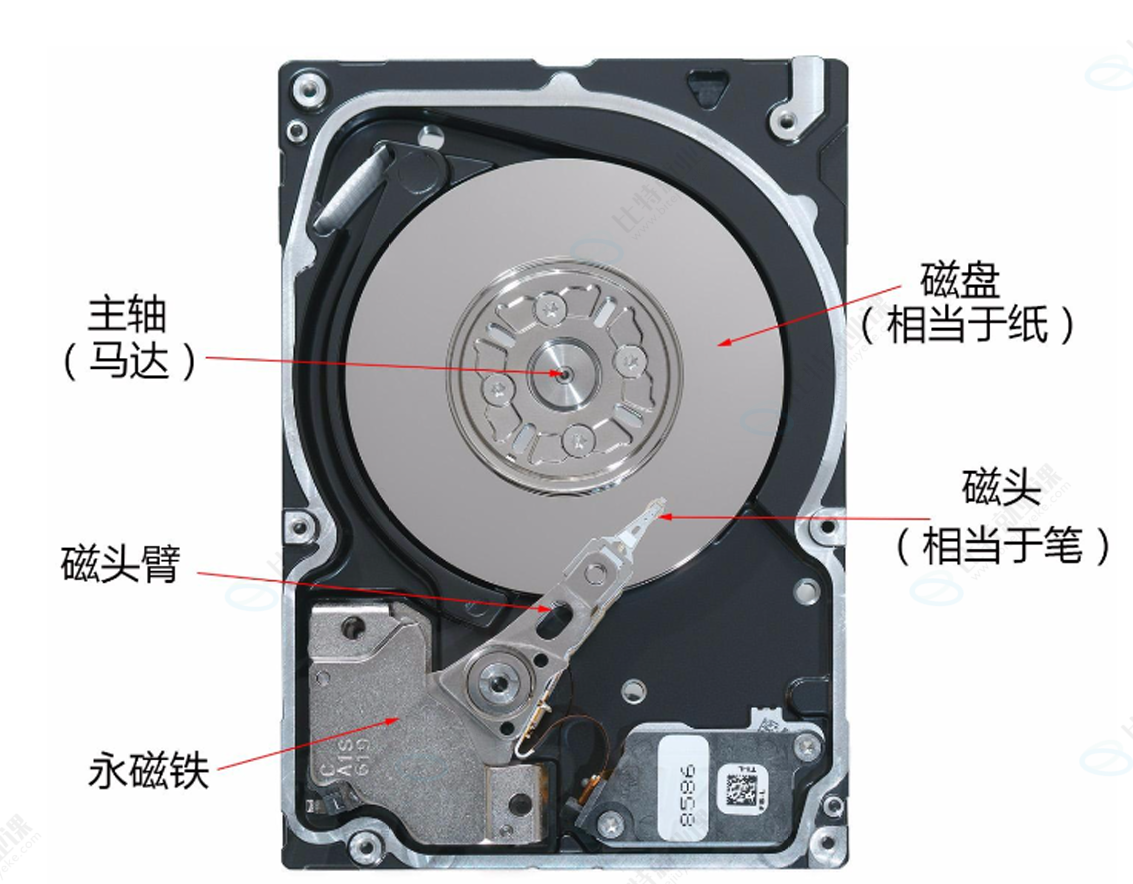
1.1磁盘的结构
我这里的是机械磁盘(HDD),我们现在笔记本的磁盘是SSD固态磁盘
学习机械磁盘的结构有利于我们理解文件系统的一些设计的原因
1.2存储的结构
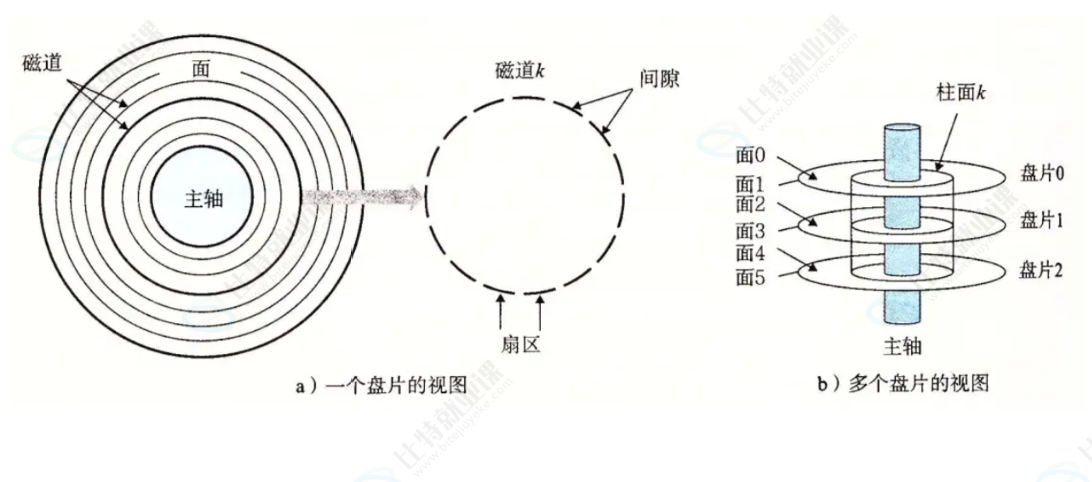
它一个磁盘的一个盘面面是由一个个同心圆组成的,一个环是叫做磁道,磁道又是由一个个扇区组成的,一个磁盘中是有多个面的,如图就是6个面(反面也能储存),一个扇区是512字节存储,最后数据转化到扇区都是01的机器码
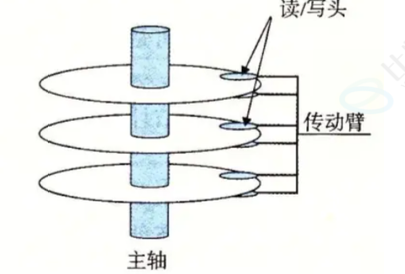
每个面都有磁头臂,并且每个同时磁头臂转动也就是说不同面的磁头臂对应磁头指到的磁道都是一样的,磁头是共进退的
1.3CHS寻址
C:柱面,因为每个面磁头都是共进退的,所以俯视图看每个磁头对应的磁道所组成的就像个柱面
H:磁头,磁头的左右摆动就能定位到不同磁道
S:磁道上的扇区
对早期的磁盘⾮常有效,知道⽤哪个磁头,读取哪个柱⾯上的第⼏扇区就可以读到数据了。
1.4把磁盘结构数据结构化看待
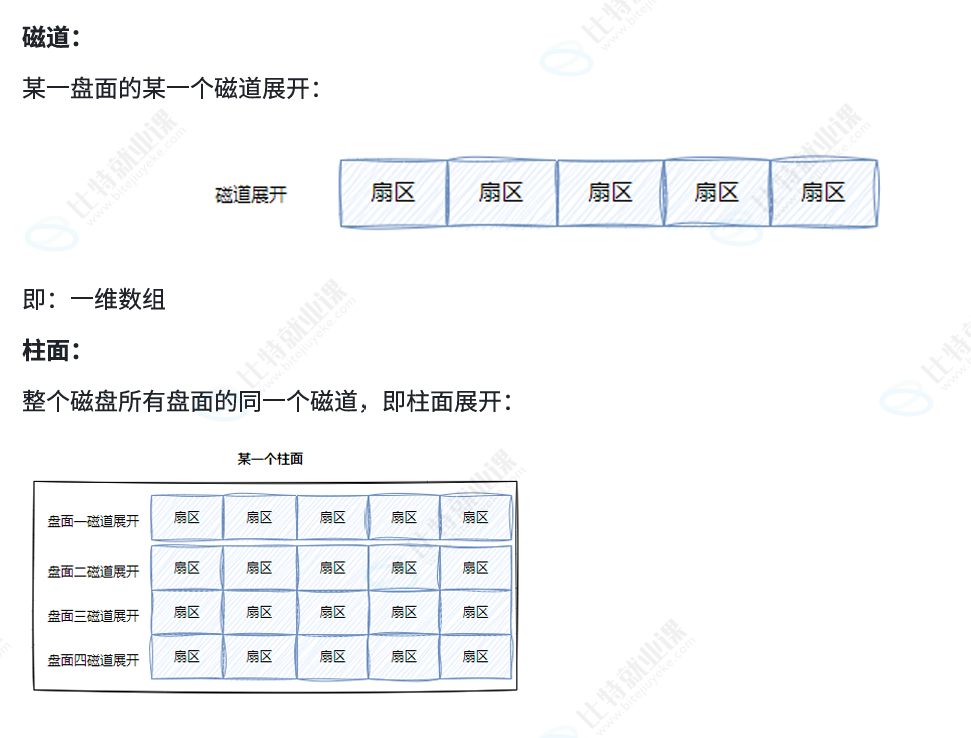
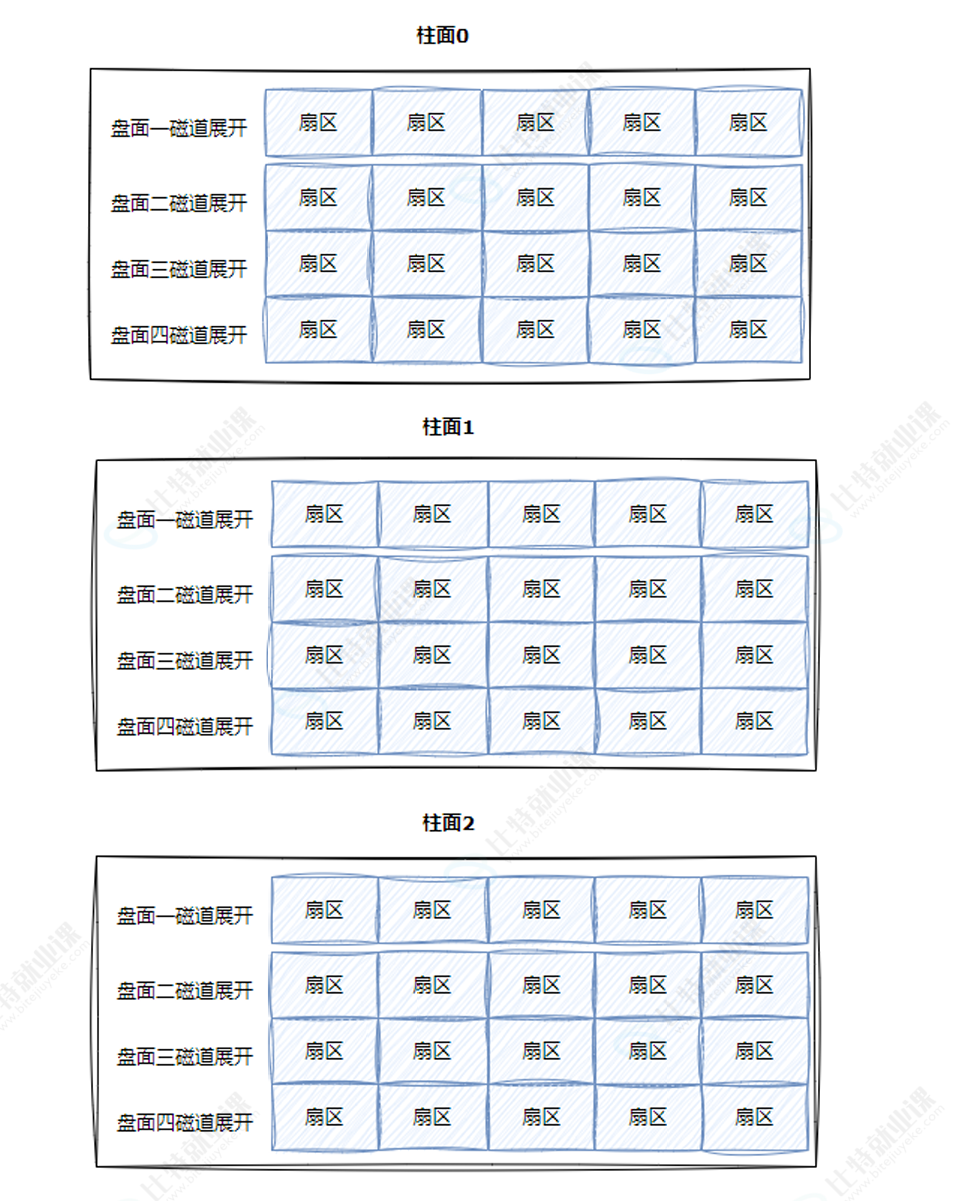
如图所示,我们可以把柱面、磁道和扇区看作三维数组,但我们学过不管几维数组在物理结构都是一维的线性数组
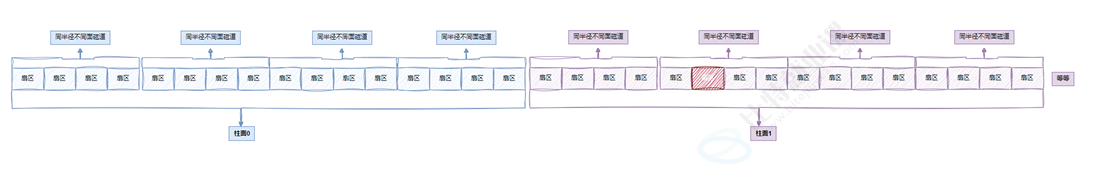
1.5LBA地址
他就是某个扇区的下标,因为在物理结构上是个线性的数组的话那肯定可以用下标表示,但是需要把LBA转化为CHS地址,因为只是知道扇区的位置不知道在哪个柱面哪个磁头上,但在软件的角度OS只需要LBA地址就行,LBA转化CHS地址是磁盘硬件自己做(它里面也有对应的逻辑电路和伺服系统等)
1.6转化的方法
CHS转成LBA:
• 磁头数每磁道扇区数=单个柱⾯的扇区总数
• LBA=柱⾯号C单个柱⾯的扇区总数+磁头号H每磁道扇区数+扇区号S-1
• 即:LBA=柱⾯号C(磁头数每磁道扇区数)+磁头号H每磁道扇区数+扇区号S-1
• 扇区号通常是从1开始的,⽽在LBA中,地址是从0开始的
• 柱⾯和磁道都是从0开始编号的
• 总柱⾯,磁道个数,扇区总数等信息,在磁盘内部会⾃动维护,上层开机的时候,会获取到这些参数。
LBA转成CHS:
• 柱⾯号C=LBA//(磁头数x每磁道扇区数)【就是单个柱⾯的扇区总数】
• 磁头号H=(LBA%(磁头数*每磁道扇区数))//每磁道扇区数
• 扇区号S=(LBA%每磁道扇区数)+1
• “//”: 表⽰除取整所以:从此往后,在磁盘使⽤者看来,根本就不关⼼CHS地址,⽽是直接使⽤LBA地址,磁盘内部⾃⼰转换。所以:从现在开始,磁盘就是⼀个元素为扇区的⼀维数组,数组的下标就是每⼀个扇区的LBA地址。OS使⽤磁盘,就可以⽤⼀个数字访问磁盘扇区了。
了解即可其实我过一段时间也会忘掉,但思路先找到在哪个柱面,在找到在哪个磁头,然后再找到在哪个扇区.
二、引入文件系统
2.1引入"块"的概念
我们一个磁盘的扇区512字节,如果访问是一个个扇区访问效率太低了,所以我们一次访问就访问4kB数据,如果是一个扇区是512字节那就是访问八个扇区
2.2引入分区与分组
分区
即便你的磁盘分为一个个块但是几百GB的磁盘还是太大了查找定位扇区也是效率低,那我们可以把磁盘分为几十上百GB作为一个个分区,由一个个分区组成我们的整个磁盘,查找定位数据在分区内查效率高点
分组
但是你分个区还是有几十上百GB还是太大了,所以在每个分区内就分为一个个在此分区内大小相等的组,然后查找数据在一个组里面查找效率又会提高
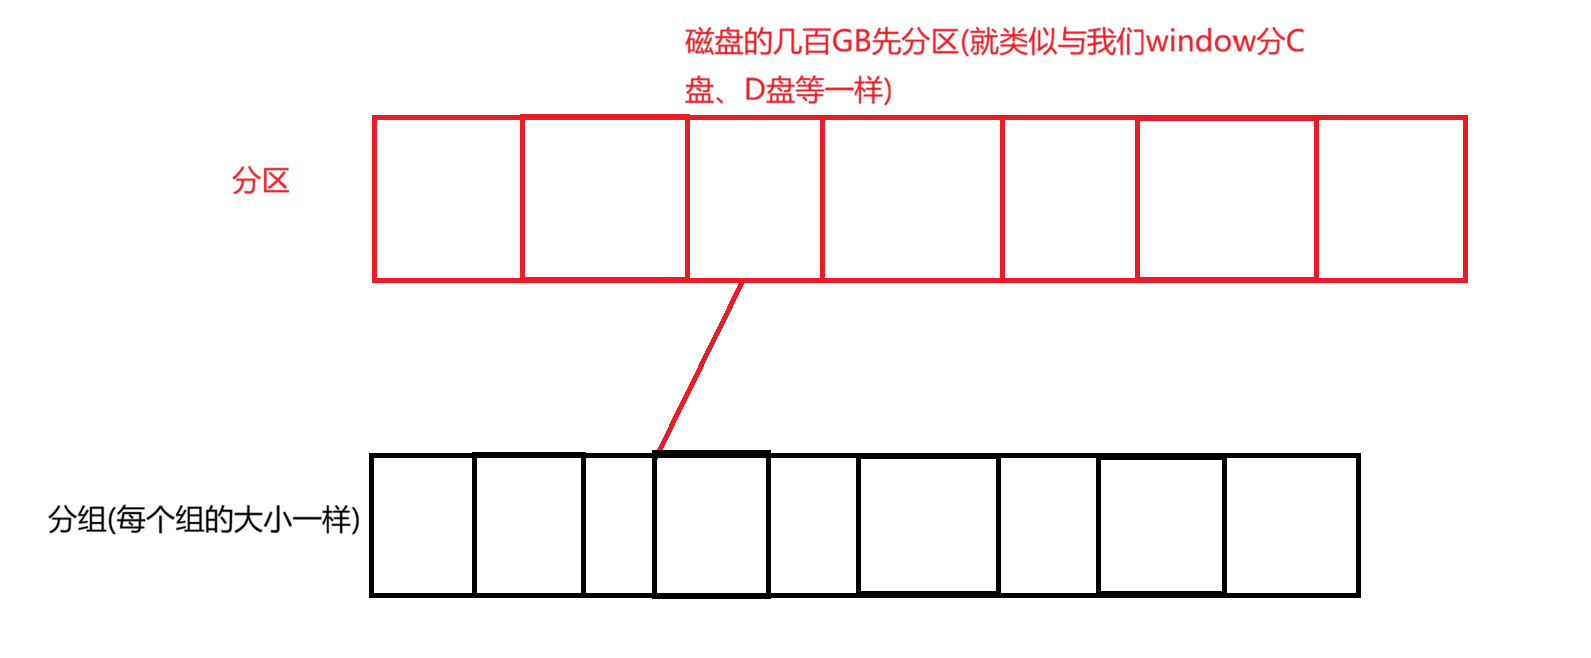
然而我们的组是需要被管理的,谁管理?文件系统!!!我们一个个分区对应都有自己的文件系统,只要把一个给管好其他的都是一样的方法管理
2.3引入"inode"的概念
每个文件都有自己唯一的inode,它是磁盘上的文件的编号,我们呢文件系统是能通过结构体保存的,我们知道文件=内容+属性,inode也算是属性我们ls -l -i能查看到
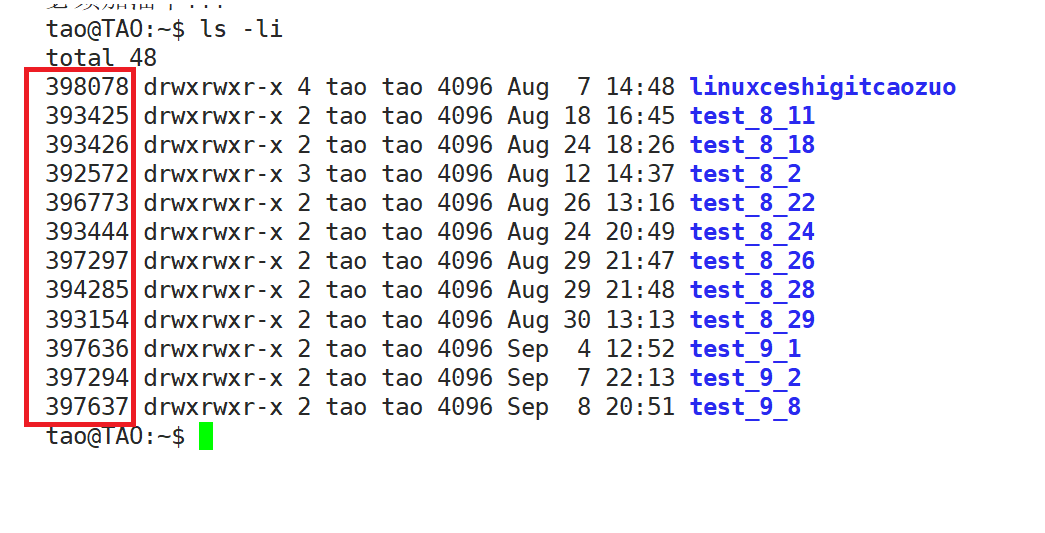
但inode的作用还有什么那就要把一个组的结构学习后才能清楚
三、ext2文件系统
我们要了解具体文件的属性和内容怎么储存在哪里的话就要学习文件系统了,但又因为文件系统是管理一个分区内所有的组的所以先了解组结构
3.1组的结构
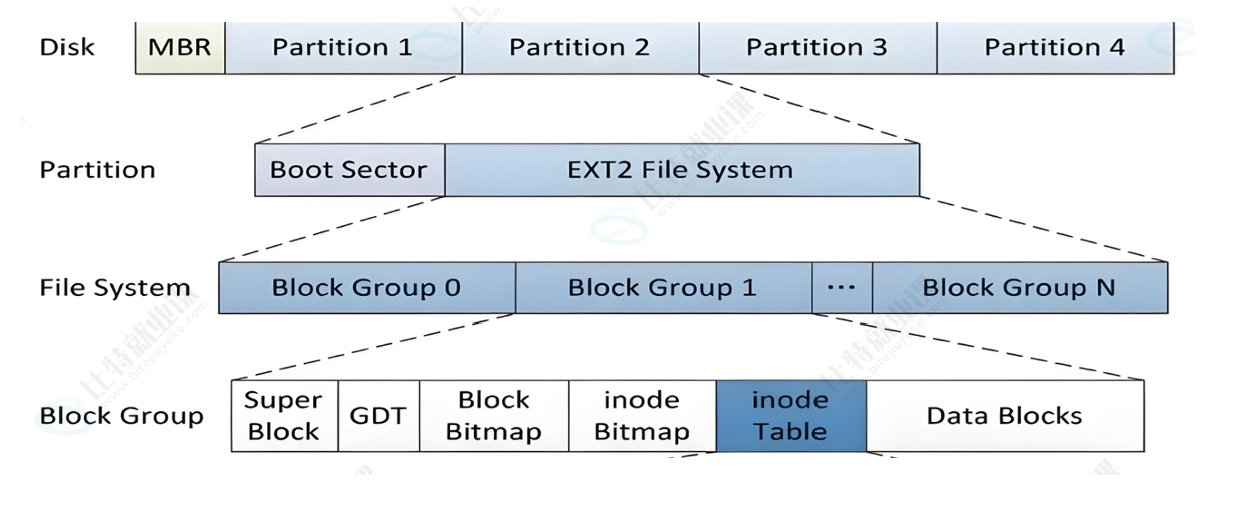
这里的block group就是组里的结构,这里的每个结构都是多个块组成的,
inode table
它是保存文件的属性的,一个文件的属性,但也是按一个块4KB这样的储存的,一个文件属性是128字节,所以一个块可以储存32个文件
Data Blocks
储存文件的内容的,也是一个块这样的储存,一个文件对应一个数据块,如果写入的数据不足4KB,下个文件的数据也只能用一块新的没有数据的块来存储,如果数据大于4KB,那就也占用一块新的没有数据的块写入
block bitmap和inode bitmap
他们是位图,
block bitmap:一个bit位对应 data block的某一个数据块是否存在
inode bitmap:一个bit位对应某一个文件的属性是否存在
作用:去寻找某个文件属性和文件的数据块增删查改不用线性遍历查找只需要用位图与inode table和 data block对应位图与他们的映射关系就能快速的找到对其做相应的操作
为什么删除文件很快,下载文件很慢?
那是因为删除文件只需要把对应组里面的位图上对应的文件的映射的bit位置为0就代表文件属性和内容删除,下次有新的文件映射关系刚好是这个的话直接覆盖内容就行,下载文件是真的要磁盘与文件做写入操作,不仅要改变位图,还要找到映射关系还需要把数据写入到对应的数据块
GDT和super block
GDT:它是管理它所在组的对应 inode table 、data block、block bitmap、indoe bitmap对应的块是从哪里开始的是inode table,从哪开始是data block等,有多少空闲的数据块和inode等,每个块都有对应的GDT来对该组做管理
super block:它存放的是当前分区的文件系统的信息,包括当前分区有多少个空闲的block和inode,每个block和indoe的大小等
(这两个详细的可以问ai)
为什么使用inode就一定是这个区并且找到是这个组的呢
因为在一个区里文件系统的所有组大小和块的大小都是固定好的!inode和数据块大小也是提前设计好的,所以我们知道一个分区有多少组通过除法和取余救能算到自己在哪个分区和哪个组里
所以也就是inode和块号是整个分区有效,它不可以跨分区的!
3.2inode与文件和目录的关系
目录和文件一样也是内容+属性,所以目录也是有自己的inode的,那我们打开文件本质是知道对应的inode然后去文件系统里找对应的内容和属性
那我们打开文件不是用的文件名吗?文件名与inode是什么关系
首先说明:文件名不是文件的属性,我们 ls -l 等指令都是命令加文件名这是我们经常的操作.
目录的属性和普通文件的属性没差别,但目录的内容里存的是目录下的文件与inode的映射关系表,也就是说你对用文件名能打开和操作对应文件是因为你先知道当前文件的目录的inode,然后拿目录的inode去找它的 data block找到对应的数据块,数据块中就能找到对应文件名与它的indoe映射值,然后再拿文件的inode去找到对应的块去做相应的操作
我们这也能理解了为什么目录没有w权限不能添加和删除文件是因为添加删除会增加目录的内容,因为要生成对应文件名与inode的映射关系
3.3路径解析和路径缓存
我们上面知道目录的inode就能知道目录里的文件的文件名与inode映射关系,但是目录也是文件,它的inode怎么知道,那就是它所在的目录的内容里存的文件名与inode的映射关系,那它所在的目录的inode怎么获取,那就是它的上级目录里有…以此类推,这个过程就是路径的解析打开一个文件本质看来好像要递归寻找目录的inode最终找到/根目录,根目录的inode是你打开操作系统就知道的
所以你的open等系统调用函数,给个文件名就能打开对应的文件,本质也是先做路径解析,所以我们访问任何文件都需要找到对应的路径
但你没发现如果每访问一个文件需要递归式的找到根目录然后一步步把对应的数据块从磁盘加载到内存之间的频繁IO不会效率有点低?
所以有了接下来的路径缓存:
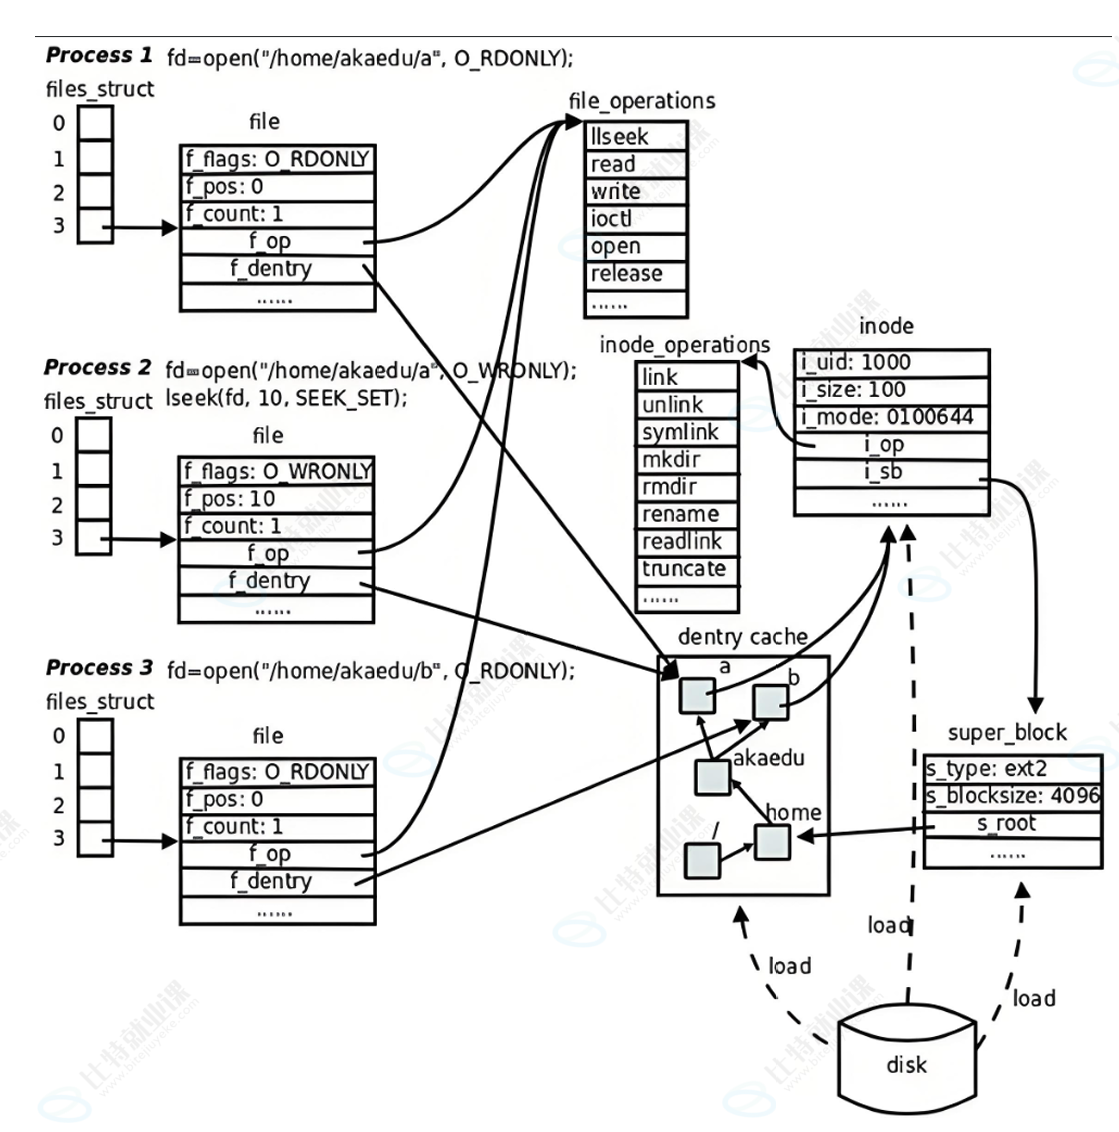
它会把你的最近访问的解析路径放到内存里,然后你再次访问时,就不用去磁盘里先载入内存再去操作,可以直接向内存里拿就效率很高,那对应的路径怎么管理起来,先描述,再组织!!!所以Linux中,在内核中维护树状路径结构的内核结构体叫做:
struct dentry
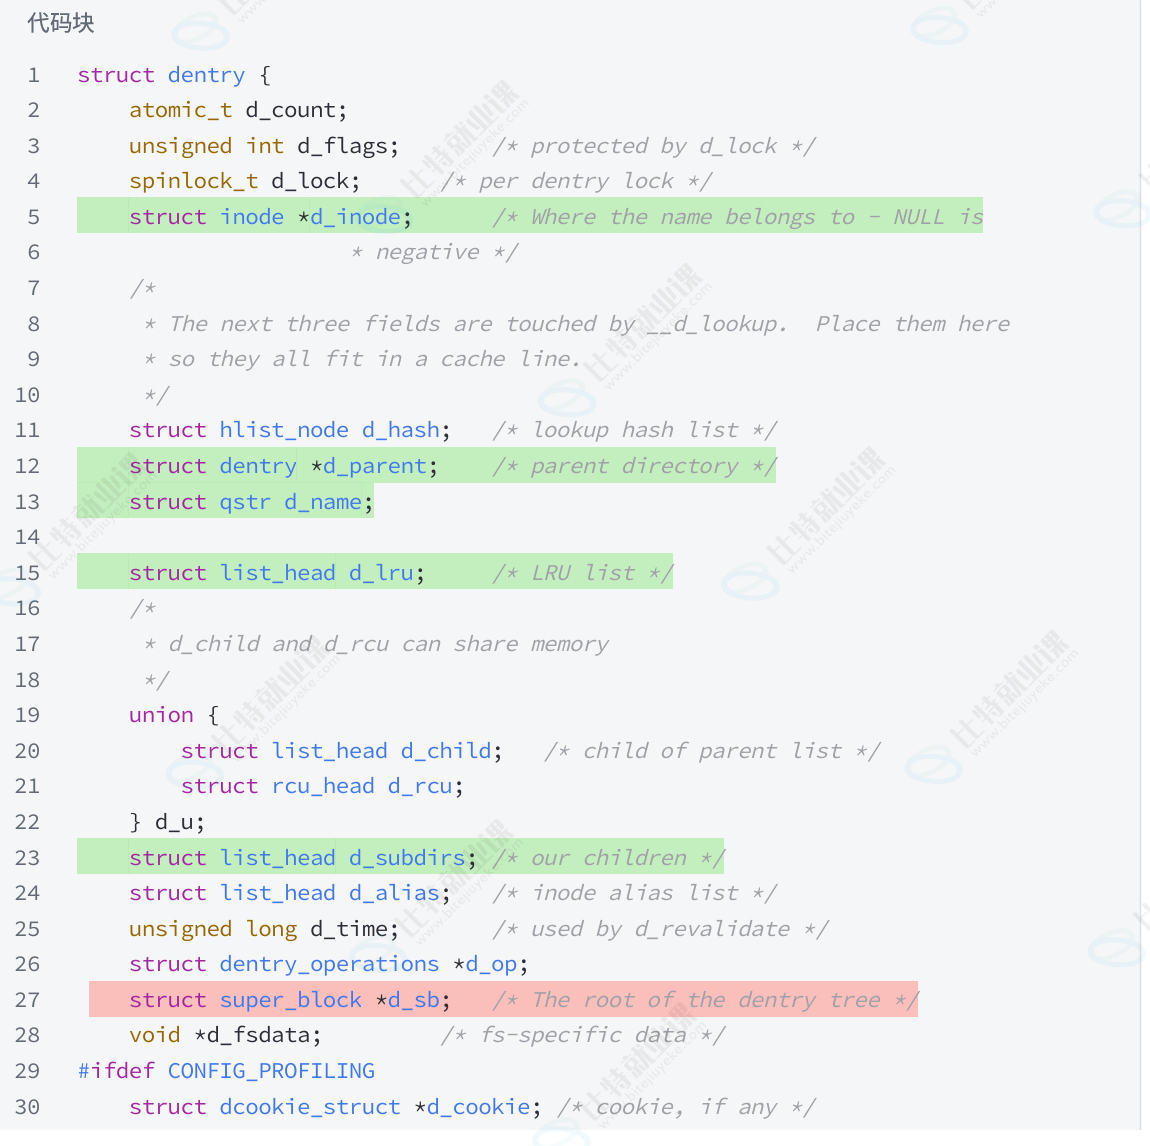
• 每个⽂件其实都要有对应的dentry结构,包括普通⽂件。这样所有被打开的⽂件,就可以在内存中形成整个树形结构
• 整个树形节点也同时会⾪属于LRU(LeastRecentlyUsed,最近最少使⽤)结构中,进⾏节点淘汰
• 整个树形节点也同时会⾪属于Hash,⽅便快速查找
• 更重要的是,这个树形结构,整体构成了Linux的路径缓存结构,打开访问任何⽂件,都在先在这棵树下根据路径进⾏查找,找到就返回属性inode和内容,没找到就从磁盘加载路径,添加dentry结构,缓存新路径
我们知道Linux本质是一个目录树,从根目录开始有一个个分支,那这路径缓存数dentrt不就是目录树的一个子树,所以我们打开操作系统可以不用加载整个目录树,可以把经常用的文件先路径缓存,查找文件先从缓存树找,没找到再去目录树找,然后再把对应文件构成dentry再加入到缓存树里,这样能大大加快查找效率
3.4重谈inode的结构
如何存大文件?

这是一个inode里的数据块只有最多15块也就是60KB,那我一个文件存几GB几百GB该怎么存?
inode结构体的简单展示
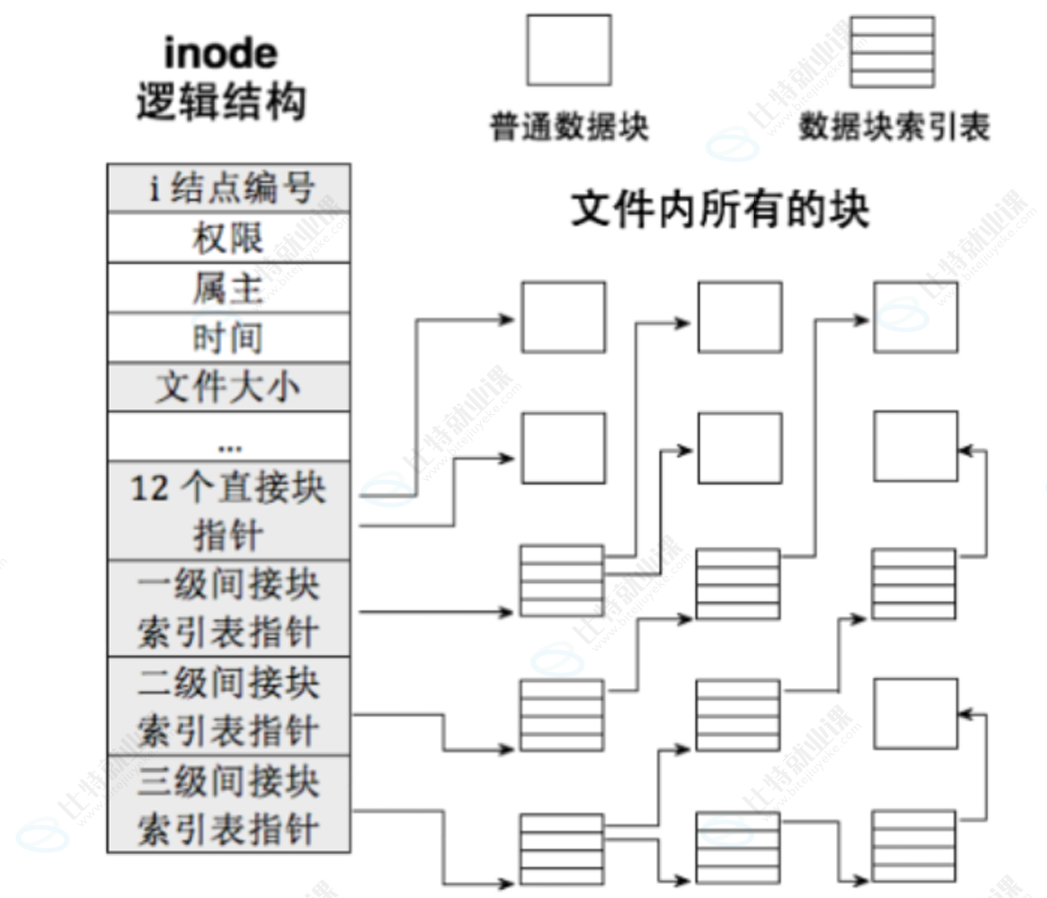
如图也就是 i_block[EXT2_N_BLOCKS]数组0~12的下标储存的就是具体的data block里的块号;
一级间接块索引表指针:储存的是4KB的data block里空闲的块号的索引,一个4kB能保存4MB的数据块,
二级间接块索引表指针:储存的是4KB的一级间接块索引表指针里空闲的索引,整体一个4KB能保存4G的数据块
以此类推三级间接索引表指针就是二级的指针的索引,一个4KB块能保存几个T的数据块
我们知道在一个分区内整个数据块的块号可以在任意组里面的data block里存储数据,所以这几个指针的数据块有些可能不是本组里的数据块,可能是其他组的空闲的数据块,因为可以通过块号映射找到对应组,不同分区内的数据块独立,也就是不同的文件系统管理的数据是独立的
如果该分区储存不了这个大文件那就没办法了但一般这种情况不会发生
3.5挂载分区
由上面的inode结构的怎么储存大文件的简单原理分析后
那我们如何知道自己在哪个分区呢?
我们知道,一个新的磁盘或者初始化电脑要能存文件的过程是磁盘->分区->格式化(建立文件系统)
格式化就是把该分区的管理信息建立好(super block 、GDT等)和把对应的数据块和属性块清空(可能是把对应的位图置为0),那格式化后的分区能不能储存文件呢?不能!
分区写⼊⽂件系统,⽆法直接使⽤,需要和指定的⽬录关联,进⾏挂载才能使⽤。
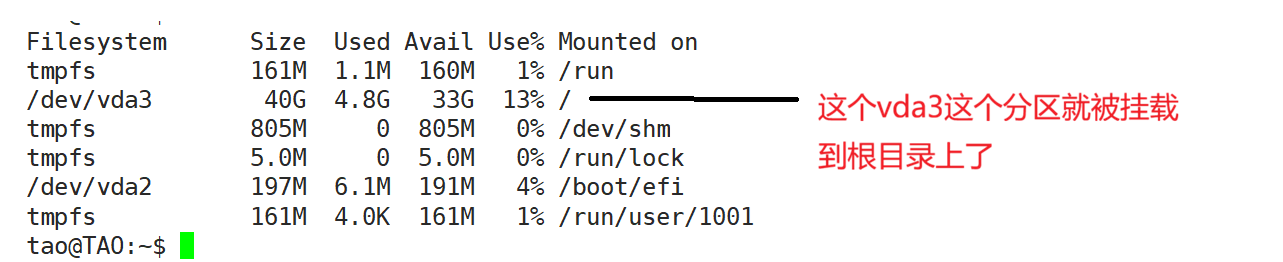
• 所以,可以根据访问⽬标⽂件的"路径前缀"准确判断我在哪⼀个分区。(理解到这个层⾯)
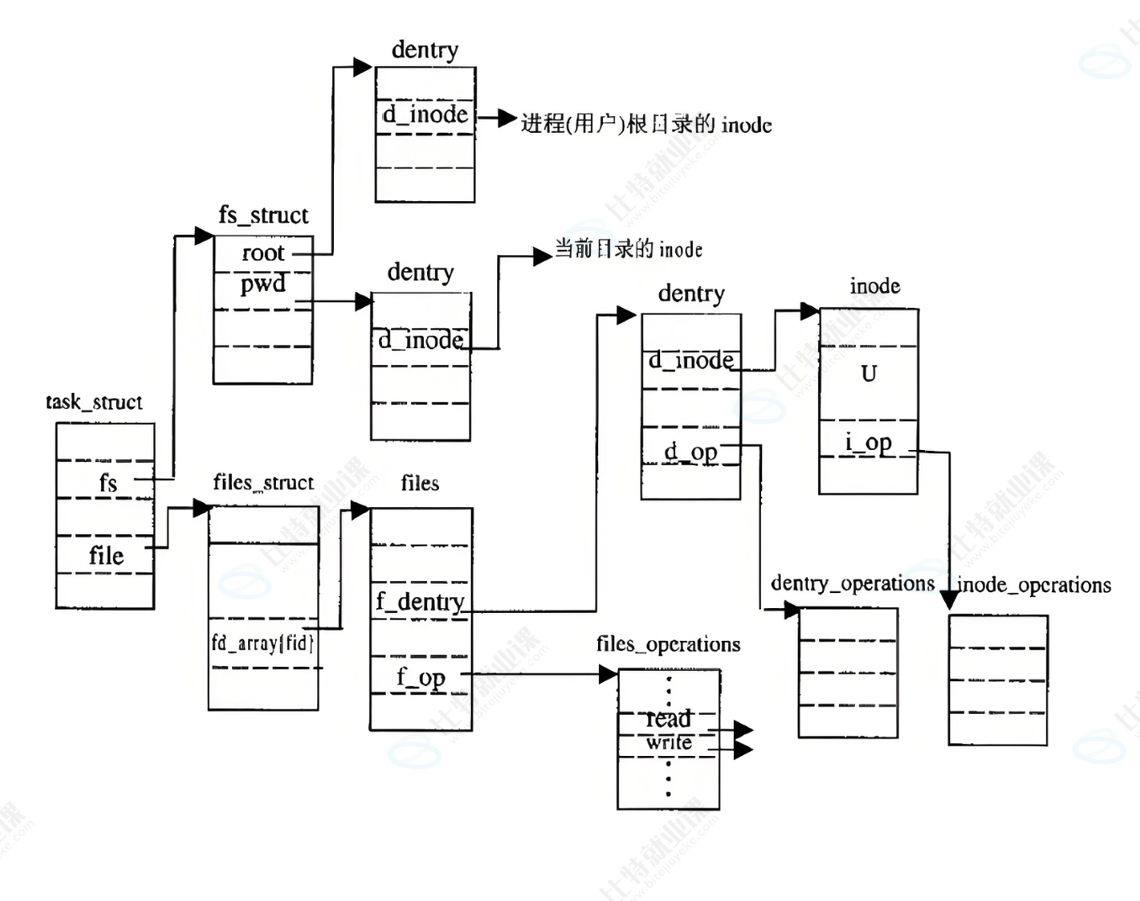
3.6文件系统总结图
这是网上的一些流程图
四、软硬链接
4.1硬链接
我们知道实际上我们用文件名找到对应文件的内容和属性其实本质就是通过文件名找到对应的映射的inode再找到对应数据块并操作,但是我们的linux里的inode可以让多个文件名映射同一个inode
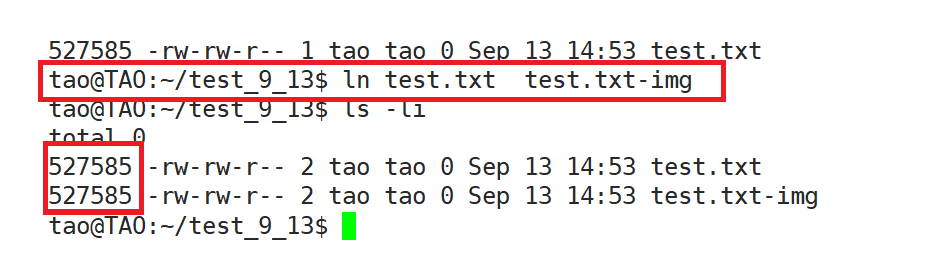
原理上很像我们的c++里的引用test.txt-img是test.txt的别名,也就是新的文件名可以与目标文件名的inode也形成对应的映射关系
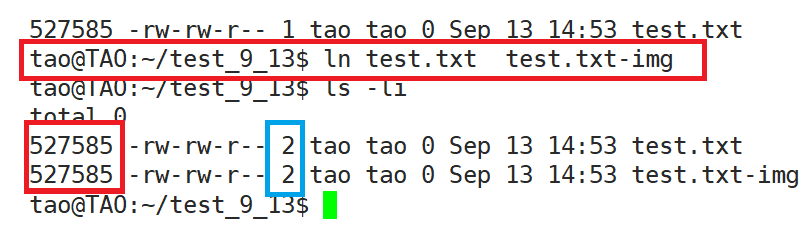
这个2就是硬链接数(也可以把它看作计数器),有点像c++中的智能指针里的引用计数,这里的意思就是该inode有两个文件指向它,当你删除其中一个文件时,它不会清空数据块而是硬链接数减一
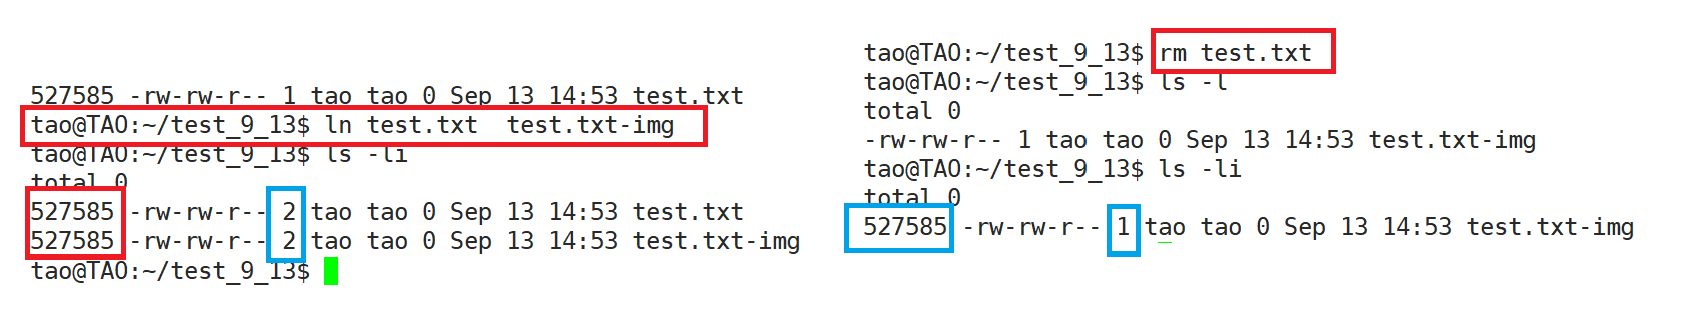
应用场景:当你想备份大型文件时可以直接增加硬链接当你不小心删除时也不会直接把数据删除,就省的去拷贝数据(cp)到另外一个目录
特殊的硬链接
目录的隐藏文件.和..你会发现你创建一个目录的硬链接数为2,那就是因为创建目录自动会在该目录下创建个当前目录和上级目录,它们的本质就是硬链接
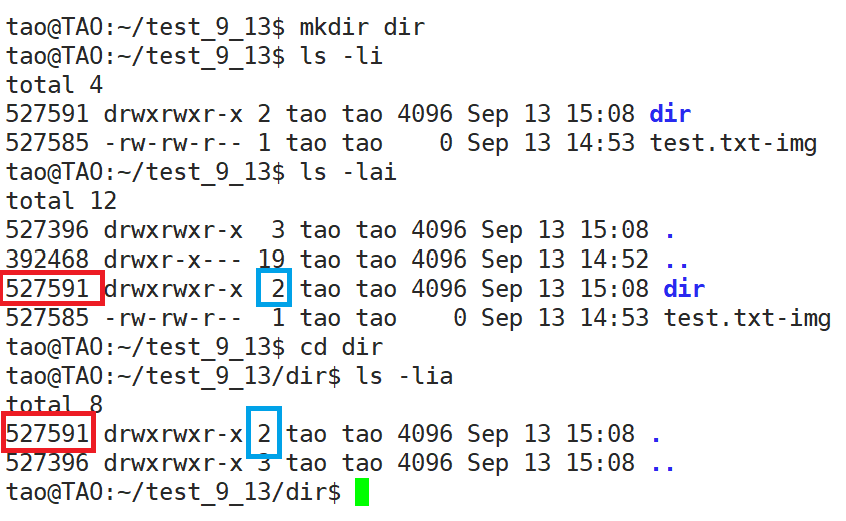
你看上级目录是test_9_13这个目录的inode,也就是每创建一个目录都会保存当前所在的目录硬链接和上一级目录的硬链接数,那就可以通过目录的硬链接数来简单计算当前目录下有几个目录,当前目录默认就是2(自己和.当前目录硬链接),那就是当前目录下的目录数=当前目录的硬链接数-2
4.2软链接
那就是与硬链接相反它是一个独立的文件,也就是它有自己的inode,但是它里面的内容是目标文件的绝对路径
可以类似于我们windows电脑的桌面的快捷方式

运行hello本质就是在运行myexe
应用场景:就是当在项目中可执行程序在多个目录下时,每次运行程序要带绝对路径很麻烦所以可以用软链接简短输出