一套集群,同时承载块存储、文件存储与对象存储;无单点元数据、自动平衡、自动自愈——这是 Ceph 在海量数据时代立足的根本。本文从存储角色与架构原理讲起,完整走通 cephadm 部署全流程,最后深入集群配置、Monitor 管理与 Cephx 认证,是一份可以直接照着做的 Ceph 实践手册。
文章目录
-
- 一、 Ceph 分布式存储:从概念到架构
-
- 1. 存储中的用户角色
-
- (1) 云存储环境下的角色划分
- (2) 组织中的角色落地
- 2. Ceph 是什么
-
- (1) 基本定义
- (2) 技术优势
- (3) 典型使用场景
- (4) 发展历史
- (5) 上游版本演进
- (6) 企业版 Ceph 存储
- 3. Ceph 架构总览
-
- (1) 集群架构的两层结构
- (2) 四种访问方式
- (3) 后端组件一览
- 4. 后端组件详解
-
- (1) RADOS:一切数据的落点
- (2) 监视器(MON)
- (3) 对象存储设备(OSD)
- (4) 管理器(MGR)
- (5) 元数据服务器(MDS)
- 5. 集群映射(Cluster Map)
- 二、 Ceph 分布式存储:部署
-
- 1. 安装方式选型
- 2. 最小硬件规格
- 3. 服务端口清单
- 4. cephadm 简介
- 5. 管理接口
-
- (1) Ceph CLI 接口
- (2) Ceph Dashboard 接口
- 6. 实验环境规划
- 7. 准备虚拟机模板
- 8. 准备集群节点
- 9. 集群初始化
-
- (1) 输出信息解读
- 10. 添加节点
- 11. 部署 mon 和 mgr
- 12. 部署 OSD
- 13. 部署验证
-
- (1) 查看集群中部署的服务
- (2) 查看集群状态
- (3) 查看集群 osd 结构
- (4) 查看集群组件
- 14. 集群组件管理
-
- (1) ceph orch 命令体系
- (2) 禁用服务自动扩展
- (3) 删除服务
- (4) 部署服务
- 15. 删除 OSD
-
- (1) 确定 OSD 和设备关系
- (2) 脚本实现
- (3) 推荐路径:编排删除
- (4) 不推荐路径:手动删除
- 16. 删除主机
- 三、 Ceph 分布式存储:集群配置
-
- 1. 管理集群配置
-
- Ceph 集群配置概述
- 修改集群配置文件
-
- 配置部分
- 实例设置
- 元变量
- 使用集群配置数据库
-
- ceph config ls
- ceph config help \\<key\\>
- ceph config dump
- ceph config show
t
y
p
e
.
type.
type.id [ \\<key\\> ] - ceph config show-with-defaults
t
y
p
e
.
type.
type.id - ceph config get
t
y
p
e
.
type.
type.id [ \\<key\\> ] - ceph config set
t
y
p
e
.
type.
type.id \\<key\\> \\<value\\> - ceph config rm
t
y
p
e
.
type.
type.id [ \\<key\\> ] - ceph config log [\\<num:int\\>]
- ceph config reset [\\<num:int\\>]
- 集群引导选项
- 在运行时覆盖配置设置
-
- ceph tell 命令
- ceph config set 与 ceph tell 对比
- ceph daemon 命令
- Web UI 更改
- 2. 配置集群监控器(Monitor)
-
- 配置 Ceph 监控器
- 查看监控器仲裁
- 分析监控器映射
-
- 查看当前的 MON 映射
- 3. 管理集中配置数据库
- 4. 集群验证
- 5. 使用 ceph auth 管理集群认证
- 总结
一、 Ceph 分布式存储:从概念到架构
在动手部署任何一套存储系统之前,先厘清两件事往往能省下大量返工成本:谁在用这套存储,以及这套存储究竟由哪些部件构成。本章就按这个顺序展开——先看云存储环境中的角色分工,再回到 Ceph 本身:它是什么、从哪里来、提供哪几种访问方式,最后拆解 MON / OSD / MGR / MDS 与集群映射这些支撑其"自愈、无单点"口碑的核心机制。
1. 存储中的用户角色
(1) 云存储环境下的角色划分
在一个规模较大的云存储环境中,存储侧的用户往往按职责分化为若干角色,其中最主要的是存储管理员与存储操作员。
存储管理员是整套体系的主责角色,承担的任务包括:
- 安装、配置和维护 Ceph 存储集群;
- 对基础架构架构师进行 Ceph 功能与特性的培训;
- 向用户说明 Ceph 的数据表示形式与访问方法,作为其数据应用选型的依据;
- 提供弹性与恢复能力,例如副本、备份与灾难恢复方案;
- 通过"基础架构即代码"实现自动化与集成;
- 提供面向数据分析与高级海量数据挖掘的访问入口。
存储操作员协助存储集群的日常运行,经验通常不及存储管理员深厚:
- 主要使用 Ceph Dashboard 图形界面查看并响应集群告警与统计信息;
- 负责日常存储运维事务,例如更换故障存储设备。
除这两个核心角色之外,还有一批会与 Ceph 直接打交道的周边角色。明确这些关系,有助于界定存储管理员的职责范围与工作边界:
| 云操作员 | 管理组织内的云资源,如 OpenStack、OpenShift 基础设施 | 与存储管理员密切协作,共同维护 Ceph 集群 |
| 自动化工程师 | 为常见重复任务编写执行剧本 | 依赖存储管理员提供的接口与能力边界 |
| 应用程序开发人员(DevOps 开发) | 原始代码开发者、维护人员,或负责应用正确部署与行为的云用户 | 存储管理员与其协调,确保存储资源可用、设置配额并保护应用存储 |
| 服务管理员 | 管理最终用户服务(区别于操作系统服务),职能近似项目经理,但面向已上线的生产服务 | 由存储管理员提供存储侧支撑 |
| 部署工程师(DevOps 工程师) | 在较大规模环境中专职执行、管理和调整应用部署 | 与存储管理员、应用开发人员协同工作 |
| 应用架构师 | 在 Ceph 基础架构布局与资源可用性、扩展性、延迟之间建立关联 | 其架构专业知识帮助存储管理员高效设计复杂应用部署;反过来,存储管理员也必须同样理解资源可用性、扩展性与延迟 |
| 基础架构架构师 | 决定集群的架构布局 | 是存储管理员的主要信息来源,可能是云服务提供商员工,也可能是供应商的解决方案架构师或顾问;存储管理员必须掌握该布局,才能管理资源位置、容量与延迟 |
| 数据中心操作员 | 位于 Ceph 存储基础设施的较低层,负责数据供应 | 通常受雇于公共云服务商,或私有数据中心组织的内部 IT 团队 |
(2) 组织中的角色落地
不同组织在人员配备、技能结构、安全要求和规模上差异明显,角色的实际落地方式也因此各不相同。角色并不总是一一对应到具体个人,同一个人常常因工作职责而同时承担多个角色:
- 电信服务商与云服务提供商:常见角色是云操作员、存储操作员、基础架构架构师和云服务开发人员,他们通常只消费存储而不负责维护。
- 银行、金融等对安全性、私有性、专用性有强要求的组织:所有角色均由内部人员担任,存储管理员、云操作员和基础架构架构师实质上扮演"服务提供商",支撑其余所有角色。
- 高校及规模较小的实施场景:技术支持人员可能一人身兼数职,同时承担存储管理员、基础架构架构师和云操作员的角色。
2. Ceph 是什么
(1) 基本定义
Ceph 是一款开源、分布式、软件定义的存储(Software-Defined Storage,SDS),具备极高的可用性、扩展性和易用性,用于存储海量数据。
它对硬件没有特殊要求,可以直接部署在通用服务器上:CPU 既可以是 x86 架构,也可以是 ARM 架构,并且支持同一集群内 x86 主机与 ARM 主机混布。这一点对当下国产化与多元算力的存储选型尤其友好。
(2) 技术优势
Ceph 的架构选择决定了它的三项核心优势:
- 统一对象底座:采用 RADOS 系统,把所有数据一律作为对象存储在存储池中,块、文件、对象三种形态共享同一套底层。
- 去中心化:客户端依据 CRUSH 算法自行计算出对象的存储位置,然后直接读写数据,不存在需要逐次查询的中心元数据节点。
- 自动化运维:集群可自动完成扩容、数据再平衡与数据恢复等操作。
(3) 典型使用场景
正因为底座统一、访问方式多样,Ceph 常被用于对象存储、虚拟化块存储、共享文件系统、备份归档、镜像与媒体存储等混合负载场景——同一套集群同时服务多种业务形态,而不必为每类协议单独建设存储系统。 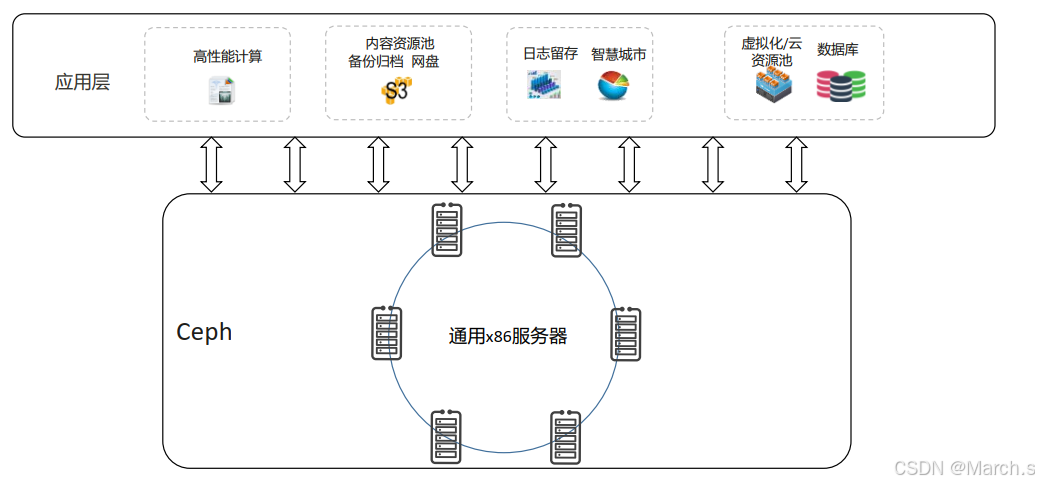
(4) 发展历史
Ceph 由加州大学圣克鲁兹分校的 Sage Weil 于 2003 年开发,最初是其博士学位项目的一部分。项目原型是一个约 40000 行 C++ 代码的 Ceph 文件系统,于 2006 年以 LGPL(Lesser GNU Public License)协议开源。Ceph 没有采用双重许可模式,因此也不存在"仅企业版才有"的特性。
关键时间节点:
| 2003—2007 | 研究开发期,核心组件逐步形成,社区贡献开始显著增长 |
| 2007 年末 | 项目日趋成熟,进入孵化阶段 |
| 2012 年 4 月 | Sage Weil 在 DreamHost 资助下成立 Inktank 公司,提供 Ceph 专业服务与技术支持 |
| 2014 年 4 月 | Inktank 并入红帽,Inktank Ceph Enterprise 变为 Ceph 存储 |
此外,Ceph 还与 Linux 内核、SUSE、OpenStack、CloudStack 等项目完成了整合;也有厂商把 Ceph 作为存储设备的核心,例如富士通的 CD10000 项目和 SanDisk 的 InfiniFlash。
(5) 上游版本演进
上游发布的完整记录见官方页面:https://docs.ceph.com/en/latest/releases/(下表统计时间为 2025-05)。 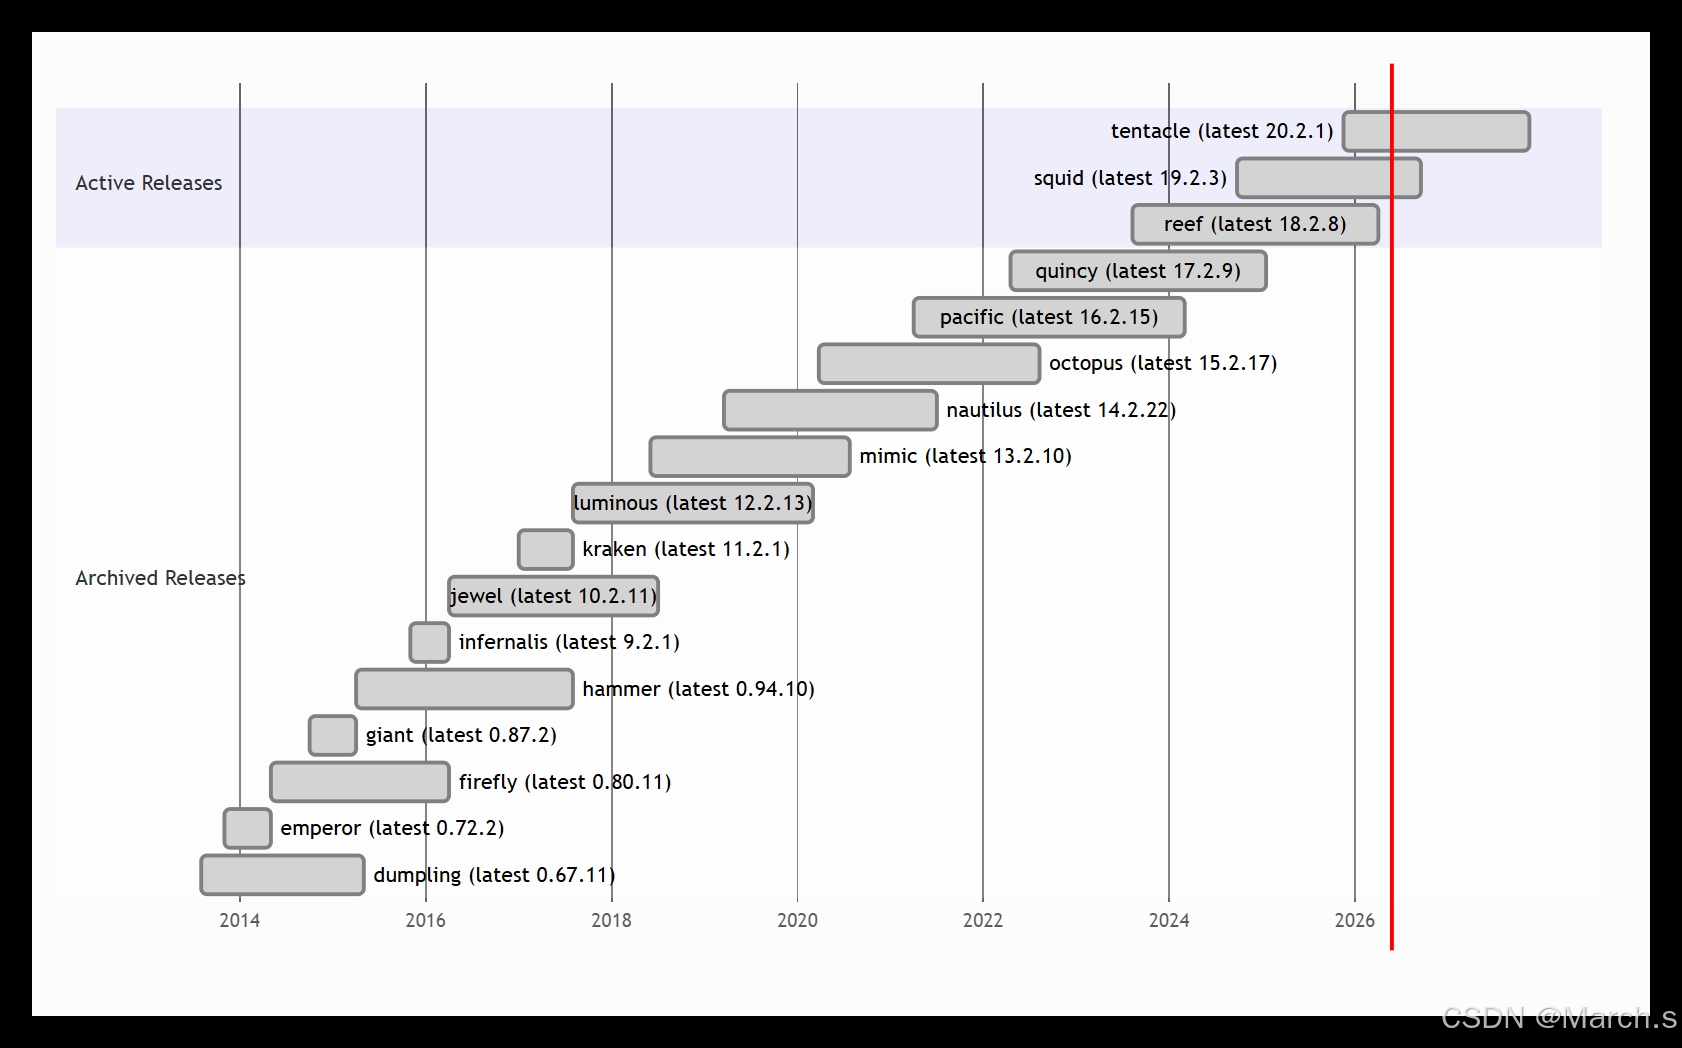
| Argonaut | 0.48.x | — | July 2012 | retired |
| Bobtail | 0.56.x | — | January 2013 | retired |
| Cuttlefish | 0.61.x | — | May 2013 | retired |
| Dumpling | 0.67.x | Yes | August 2013 | May 2015 |
| Emperor | 0.72.x | — | November 2013 | May 2014 |
| Firefly | 0.80.x | Yes | May 2014 | December 2015 |
| Giant | 0.87.x | — | October 2014 | May 2015 |
| Hammer | 0.94.x | Yes | April 2015 | August 2017 |
| Infernalis | 9.2.x | — | November 2015 | April 2016 |
| Jewel | 10.2.x | Yes | April 2016 | June 2018 |
| Kraken | 11.2.x | — | January 2017 | August 2017 |
| Luminous | 12.2.x | Yes | August 2017 | January 2020 |
| Mimic | 13.2.x | Yes | June 2018 | April 2020 |
| Nautilus | 14.2.x | Yes | March 2019 | June 2021 |
| Octopus | 15.2.x | Yes | 2020-03-23 | 2022-06-01 |
| Pacific | 16.2.x | Yes | 2021-03-31 | 2023-06-01 |
| Quincy | 17.2.x | Yes | 2022-04-19 | 2024-06-01 |
| Reef | 18.2.x | Yes | 2023-08-07 | 2025-08-01 |
| Squid | 19.2.x | Yes | 2024-09-26 | 2026-09-19 |
版本策略本身也经历过几次调整,理解这条线索有助于判断"该跟哪个版本":
- 自 Infernalis 起,上游采用新的编号方案:每个稳定发行版的主版本号递增 1。
- 2017 年底之前,上游每年发布两个稳定版本。
- 截至 Luminous,上游交替发布开发版本与长期支持(LTS)版本;稳定版发布后,对应的开发版本即停止更新。红帽的 RHCS 产品与社区 LTS 版本的生命周期保持一致。
- 自 Nautilus(14.2.0)起,改为每年 3 月 1 日发布一个稳定版本,稳定周期约 2 年。
版本号 x.y.z 的含义:
- x:发布周期标识(例如 Mimic 为 13);
- y:发布类型——x.0.z 为开发版本(供早期测试者使用)、x.1.z 为候选发布版本(可用于测试集群)、x.2.z 为稳定/缺陷修复版本(面向生产用户);
- z:该类型下的发布序号。
(6) 企业版 Ceph 存储
Ceph 存储是企业级的、软件定义的分布式数据对象存储,支持数千客户端、EB 级存储容量,并提供统一存储能力(对象、块和文件)。
它与社区 Ceph 项目的关系,类似于 RHEL 与 Fedora:红帽定期将上游的最新变化整合进企业版并提供专业支持,同时对 Ceph 存储所做的改进也会以开源形式回馈上游。区别在于支持时长——红帽为企业版 Ceph 存储提供 36 个月支持,比上游多一年。
3. Ceph 架构总览
(1) 集群架构的两层结构
Ceph 存储是一种分布式数据对象存储,属于企业级软件定义存储方案,可扩展至数千客户端、艾字节(EB)以上的数据访问量,目标是同时提供出色的性能、可靠性与可扩展性。
其架构是模块化分布式的,可以拆成上下两层来理解:
- 对象存储后端:RADOS(Reliable, Autonomic Distributed Object Store,可靠的自主分布式对象存储)。它是一种自我修复、自我管理、基于软件的对象存储,是整栋大厦的地基。
- 与 RADOS 交互的多种访问方式:在 RADOS 之上封装出面向不同使用习惯的接口层。
Ceph 使用 RADOS 提供对象存储,再通过 librados 封装库派生出多种存储形态,最外层由三类接口把数据写入底层:RGW 提供对象语义,拥有原生 API 并兼容 Swift 与 S3 接口,适合单客户端场景;RBD 提供块语义,支持精简配置、快照与克隆,适合需要多客户端挂载的目录结构化场景;CephFS 提供文件语义,走 POSIX 接口并支持快照,适合更新变动较少的数据。
(2) 四种访问方式
Ceph 提供以下四种访问集群的方式:
| Ceph 原生 API | librados | 对象(直连底层) |
| Ceph 块设备(RBD) | librbd | 块(RADOS 块设备镜像) |
| Ceph 对象网关(RADOSGW / RGW) | librgw | 对象(RESTful 网关) |
| Ceph 文件系统(CephFS) | libcephfs | 文件(POSIX) |
Ceph 原生 API(librados)
librados 是实现 Ceph 块设备、Ceph 对象网关等其他接口的基础库。它是原生 C 语言库,让应用直接与 RADOS 协作来访问集群中的对象;针对 C++、Java、Python、Ruby、Erlang 和 PHP 也有同类绑定。
追求极致性能时,应当编写直接对接 librados 的软件——这是在 Ceph 环境中提升存储性能的最佳路径。若更看重接入简便,则改用更高层的访问方式:Ceph 块设备、Ceph 对象网关或 CephFS。
Ceph 块设备(RBD / librbd)
RBD(RADOS Block Device)通过 RBD 镜像在集群内提供块存储。一个 RBD 镜像由许多独立对象构成,这些对象被打散分布在集群不同的 OSD 上;正因如此,对块设备的访问天然就是并行处理的。
RBD 提供以下能力:
- Ceph 集群中虚拟磁盘的存储;
- Linux 内核中的挂载支持;
- QEMU、KVM 与 OpenStack Cinder 的启动盘支持。
Ceph 对象网关(RADOSGW / librgw)
对象网关是基于 librados 构建的对象存储接口:它用该库与集群通信并直接写入 OSD 进程,对外通过 RESTful API 提供网关能力,同时支持 Amazon S3 与 OpenStack Swift 两种接口。
它具备良好的横向扩展性——不限制部署的网关数量,并且兼容标准 HTTP 负载均衡器。典型用例包括:
- 镜像存储(例如 SmugMug、Tumblr);
- 备份服务;
- 文件存储与共享(例如 Dropbox)。
Ceph 文件系统(CephFS / libcephfs)
CephFS 是一种并行文件系统,提供可扩展的单层级结构共享磁盘。红帽 Ceph 存储为 CephFS 提供生产环境支持,其中包括快照支持。Ceph 元数据服务器(MDS)管理与 CephFS 中文件相关联的元数据,包括文件所有权、访问与更改的时间戳。
如何选择
为最大限度提高性能,应让用户的应用直接使用 librados;若希望简化对 Ceph 存储的访问,则使用另外三种高层访问方式。
(3) 后端组件一览
| 监控器(MON) | 维护集群状态映射,帮助其他守护进程相互协调 |
| 对象存储设备(OSD) | 存储数据,并处理数据复制、恢复与重新平衡 |
| 管理器(MGR) | 通过浏览器仪表板和 REST API 跟踪运行时指标、公开集群信息 |
| 元数据服务器(MDS) | 存储 CephFS 使用的元数据(不涉及对象存储与块存储),使客户端能高效执行 POSIX 命令 |
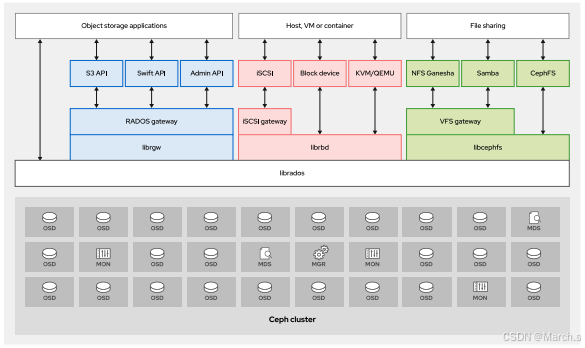
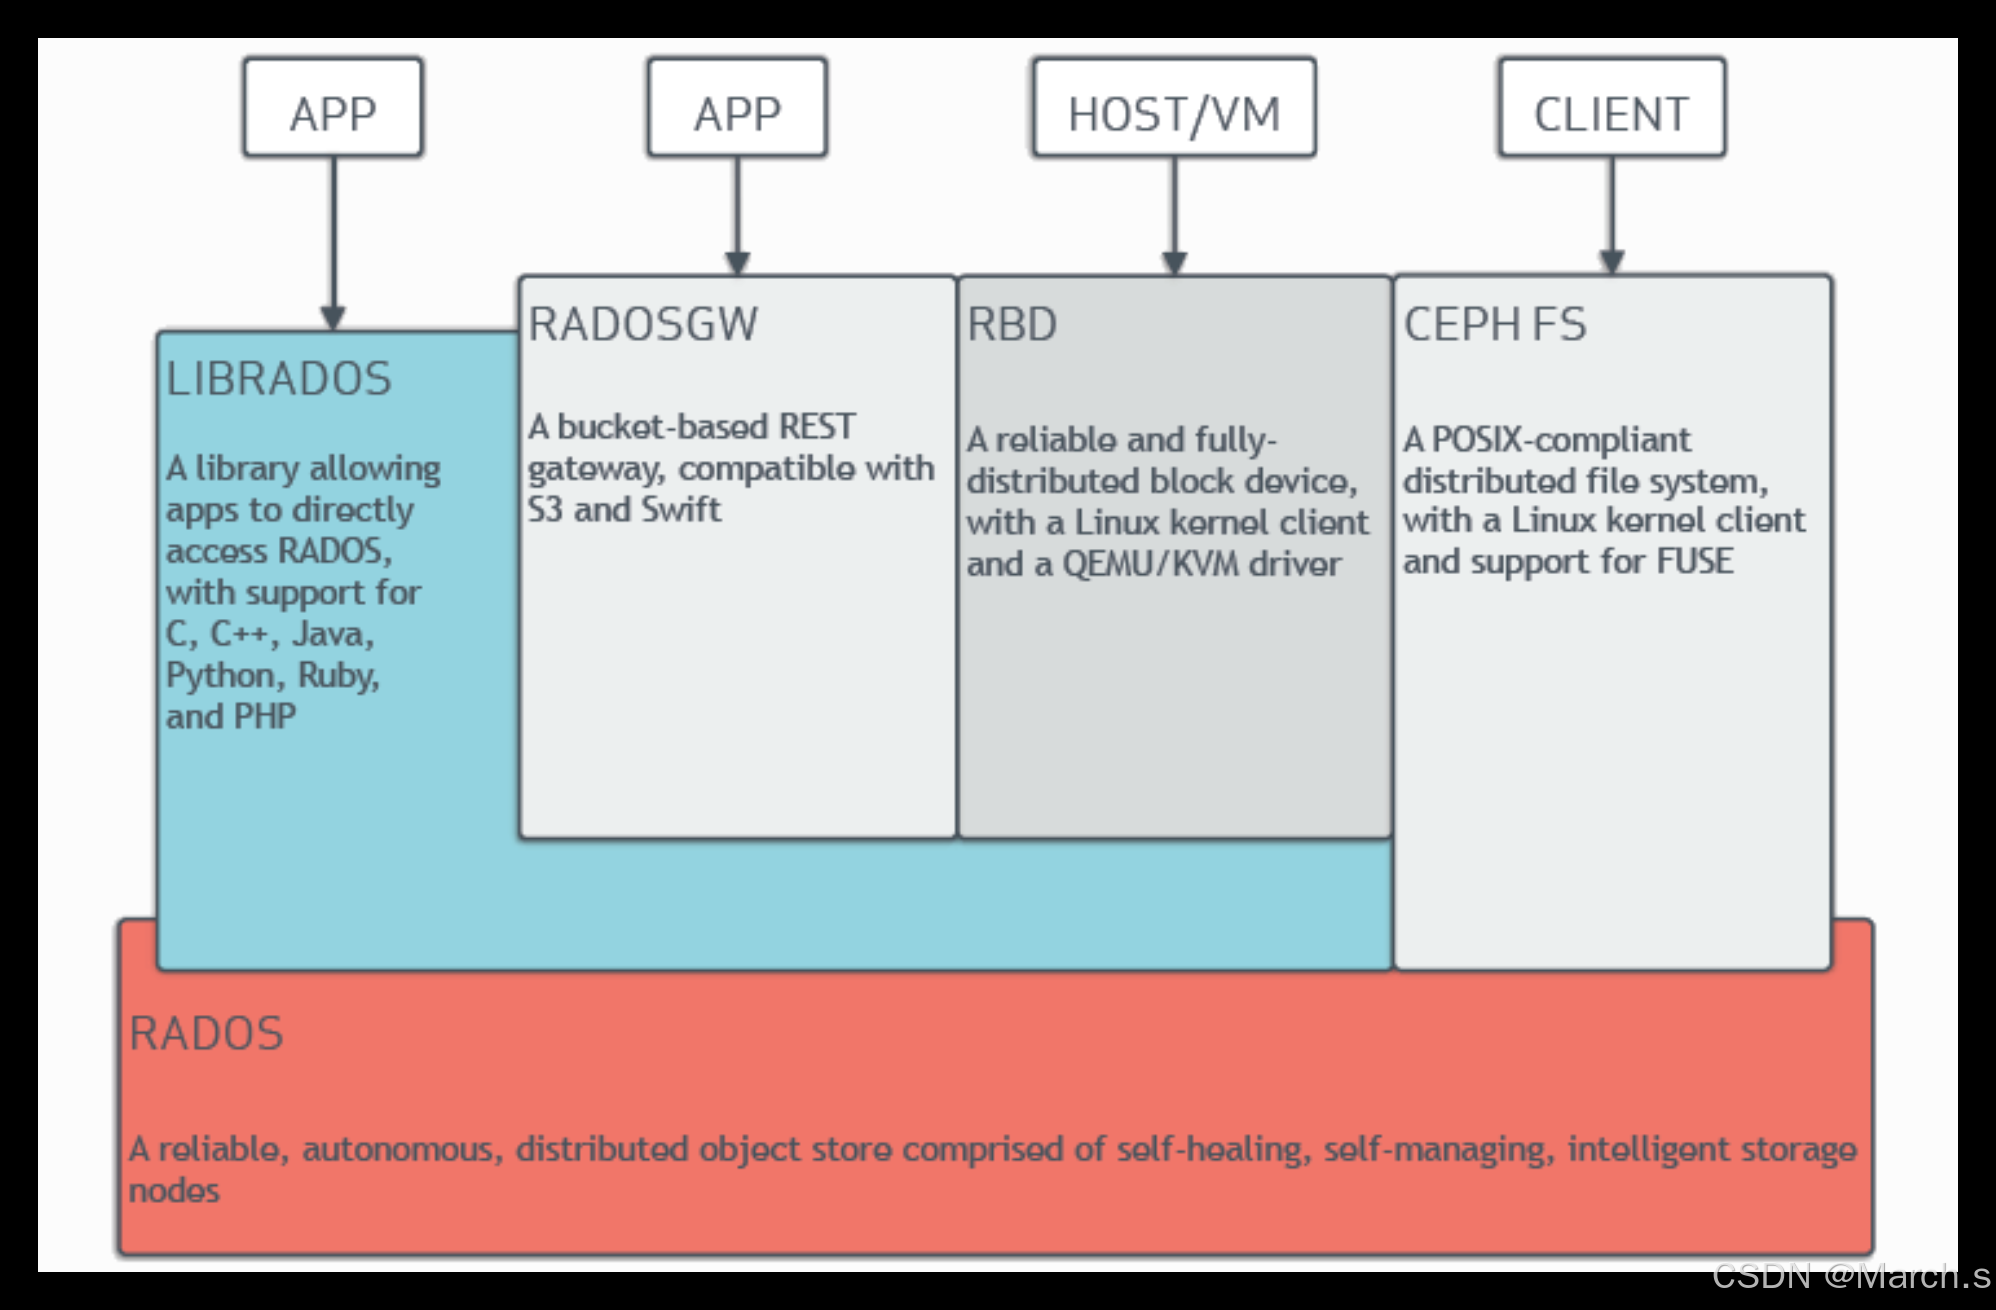
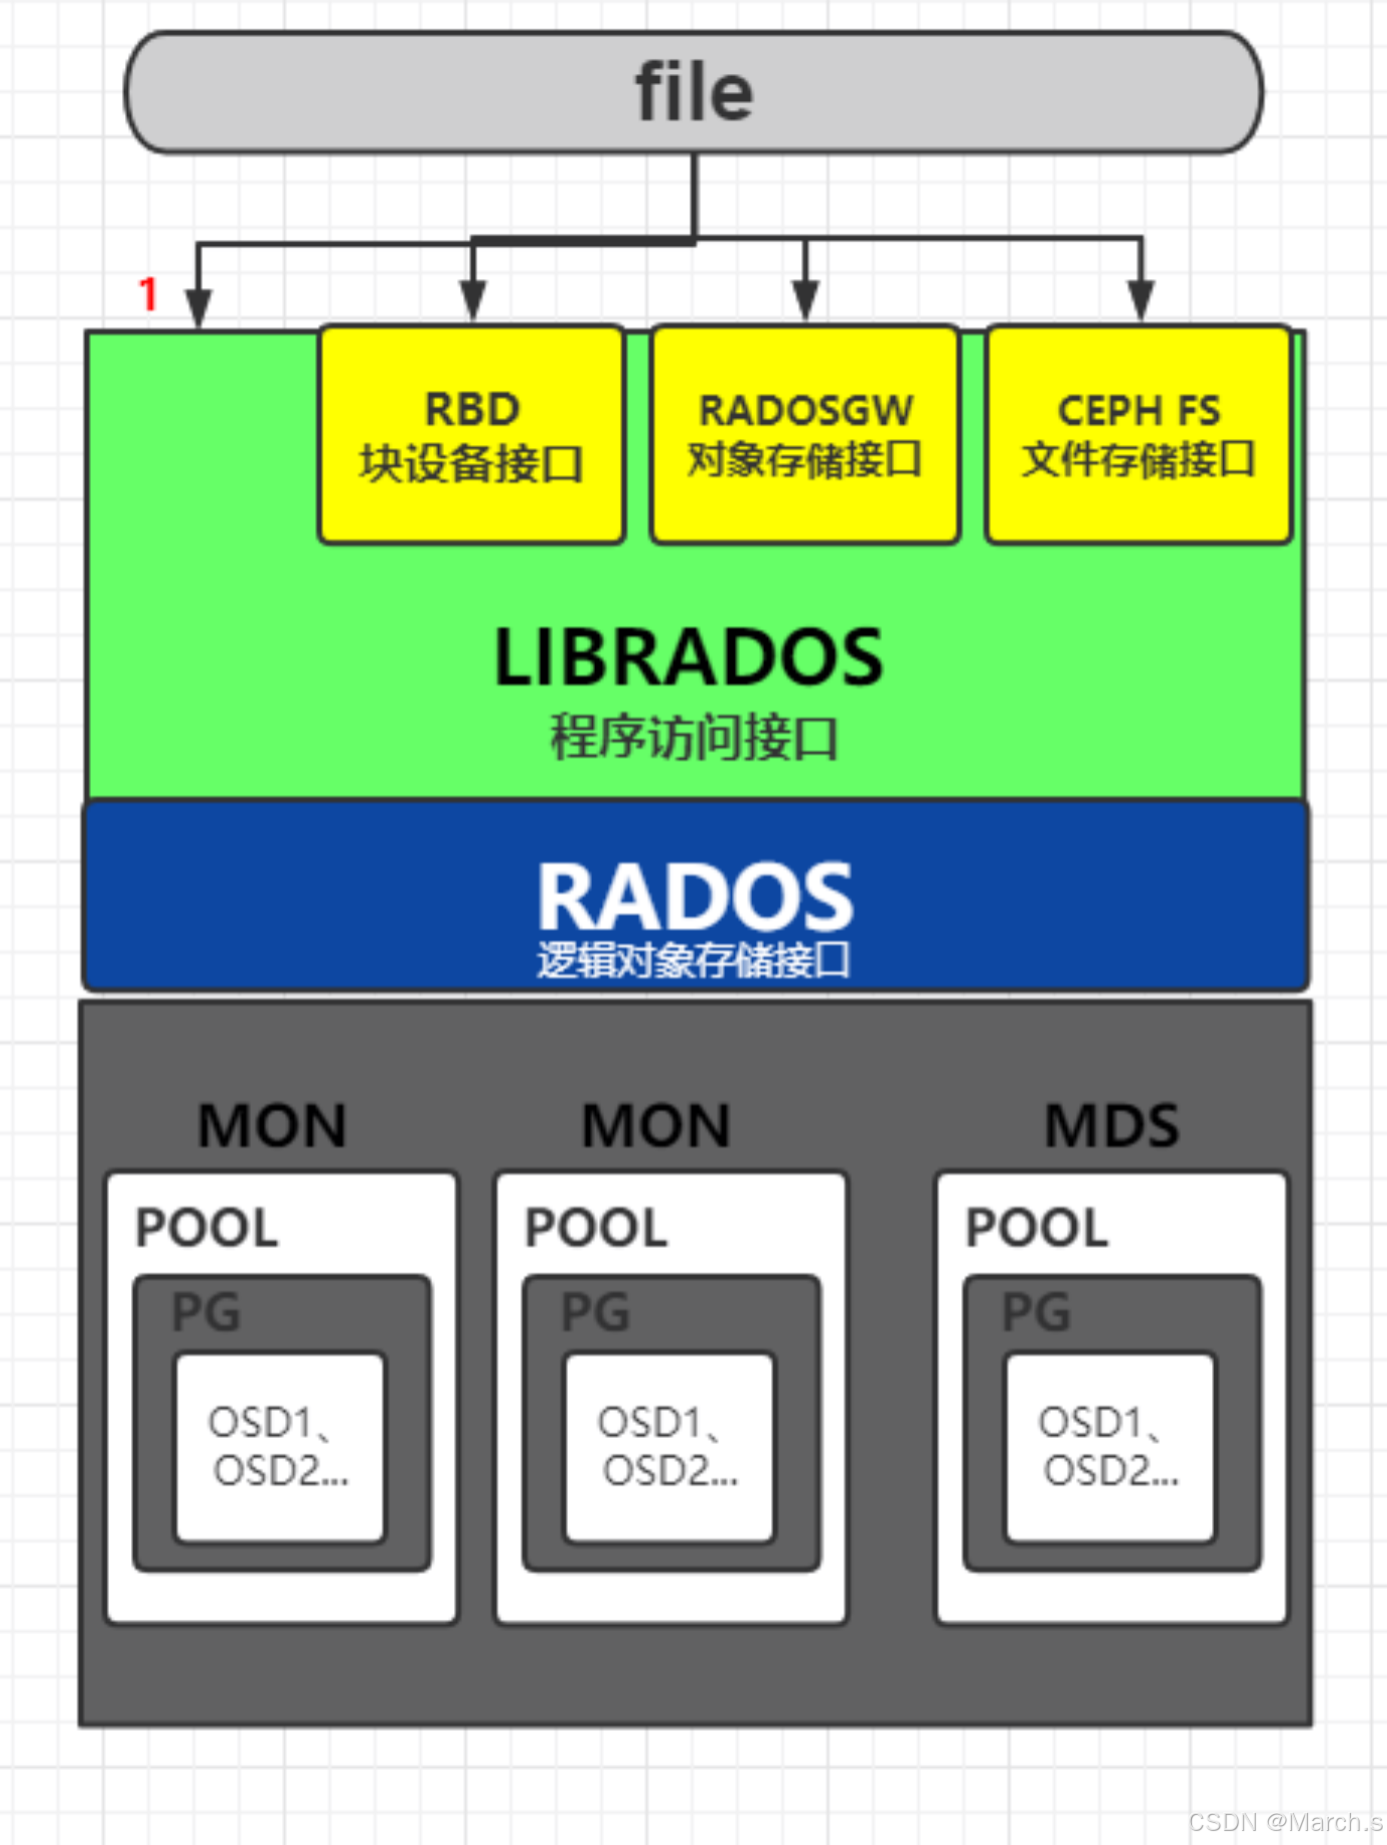
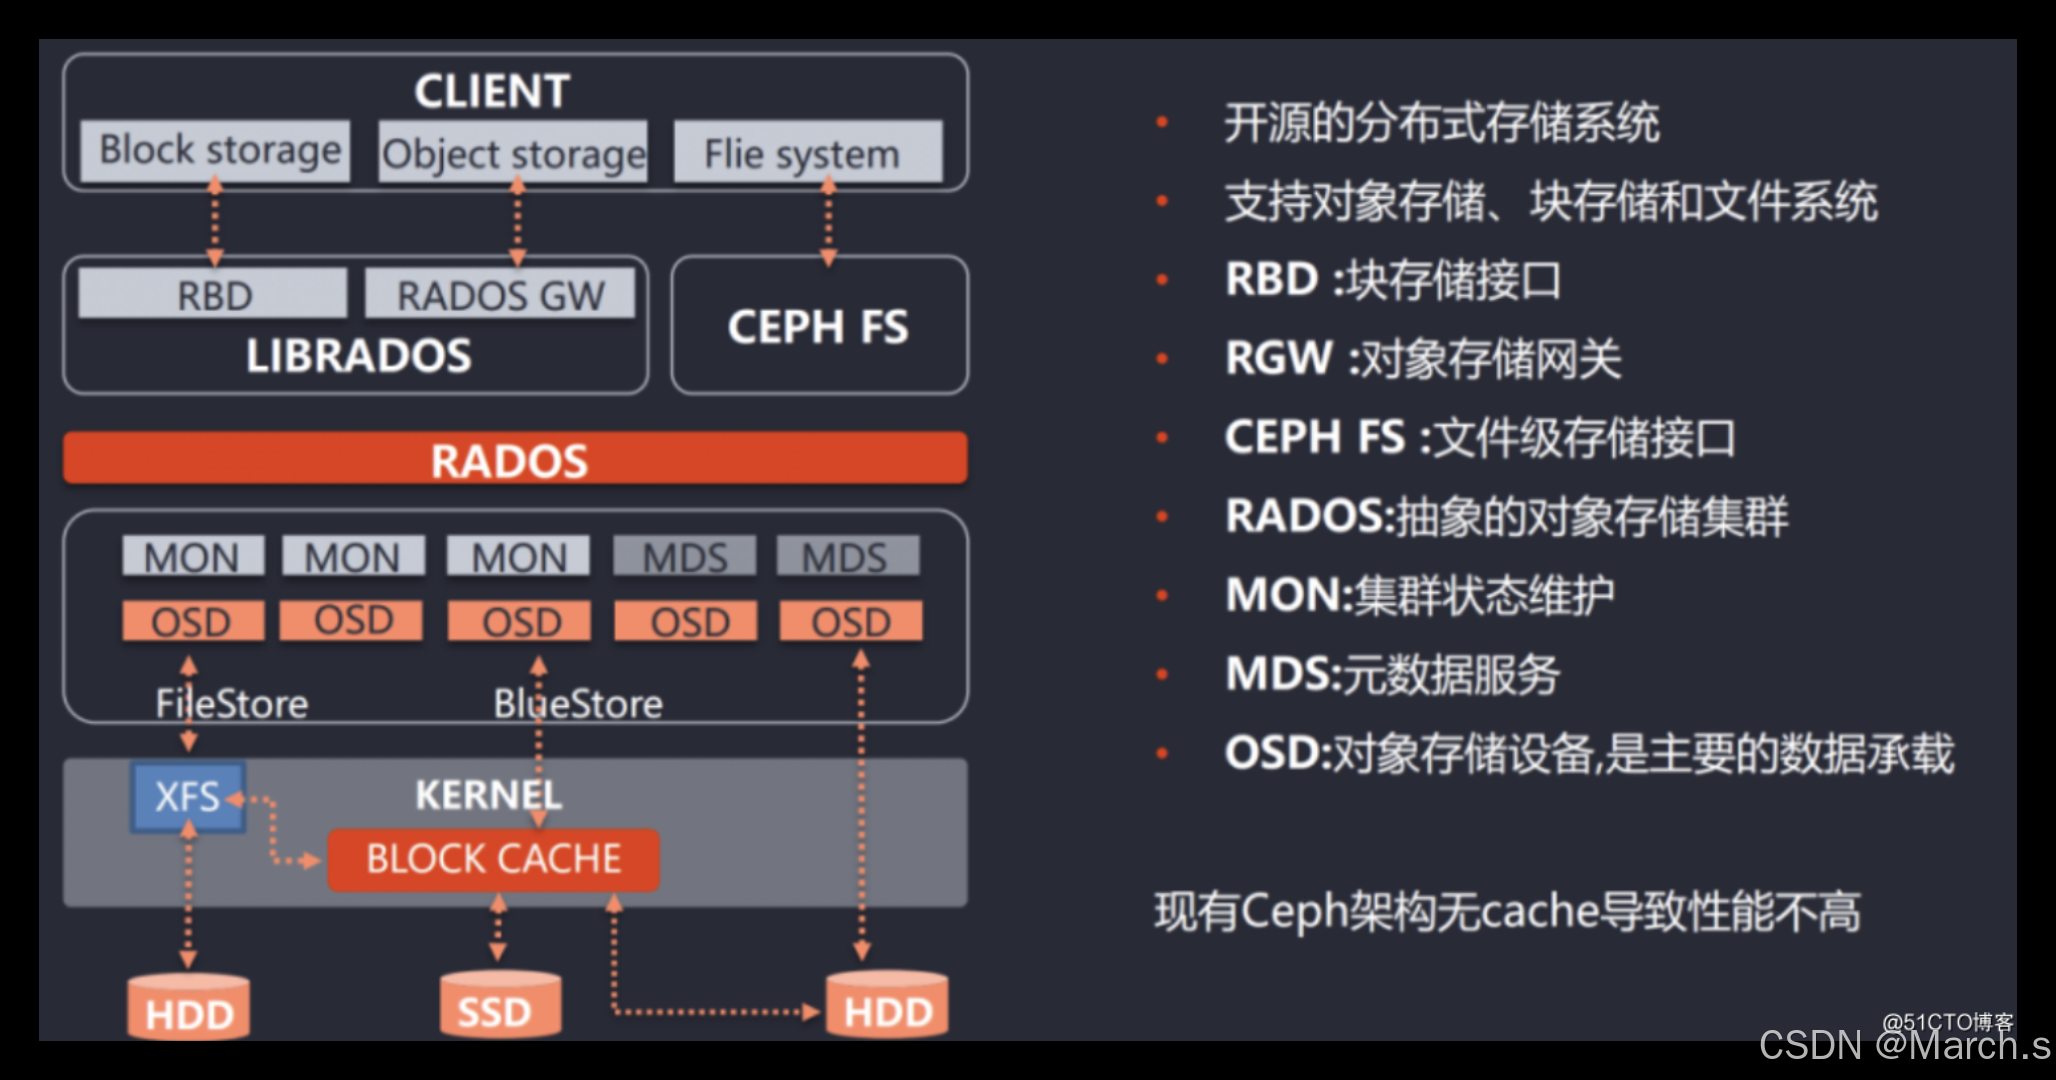
这些守护进程都可以按需扩展,以满足所部署存储集群的要求。
4. 后端组件详解
(1) RADOS:一切数据的落点
RADOS(Reliable, Autonomic, Distributed Object Store,可靠的、自主的、分布式的对象存储)是 Ceph 存储系统的核心。Ceph 的各项优秀特性都由 RADOS 提供:分布式对象存储、高可用、高可靠、无单点故障、自我修复与自我管理。
关键在于"Ceph 中的一切数据都以对象形式存储",RADOS 负责存储这些对象,且不关心它们原本是什么数据类型。
(2) 监视器(MON)
MON 必须就集群状态达成共识,才能对外提供服务。由此引出三条运维铁律:
- Ceph 集群配置奇数个监视器,以确保对集群状态投票时能够建立法定人数;
- 要使集群正常运行并可访问,必须有超过一半的已配置监视器处于正常工作状态;
- MON 是维护集群映射的守护进程。集群映射是多个映射的集合,包含集群状态及其配置信息。Ceph 处理每一个集群事件时都会更新相应映射,并把更新后的映射副本同步到每个 MON 守护进程。
(3) 对象存储设备(OSD)
OSD 将物理存储设备接入 Ceph 存储集群。单台存储服务器可以运行多个 OSD 守护进程,为集群提供多个 OSD。
Ceph 客户端与 OSD 守护进程使用可扩展哈希下的受控复制(CRUSH)算法来高效计算对象的位置信息,而不是依赖中央查找表——这正是 Ceph 去中心化的技术支点。
CRUSH 映射
CRUSH 先把每个对象分配给一个放置组(PG,单个哈希存储桶),再由 PG 把对象映射到多个 OSD。PG 因此充当了对象(应用层)与 OSD(物理层)之间的抽象层。CRUSH 使用伪随机放置算法将对象分布在各个 PG 之间,并用规则确定 PG 到 OSD 的映射。发生故障时,Ceph 会将 PG 重新映射到不同的物理设备(OSD),并同步其内容以匹配配置的数据保护规则。 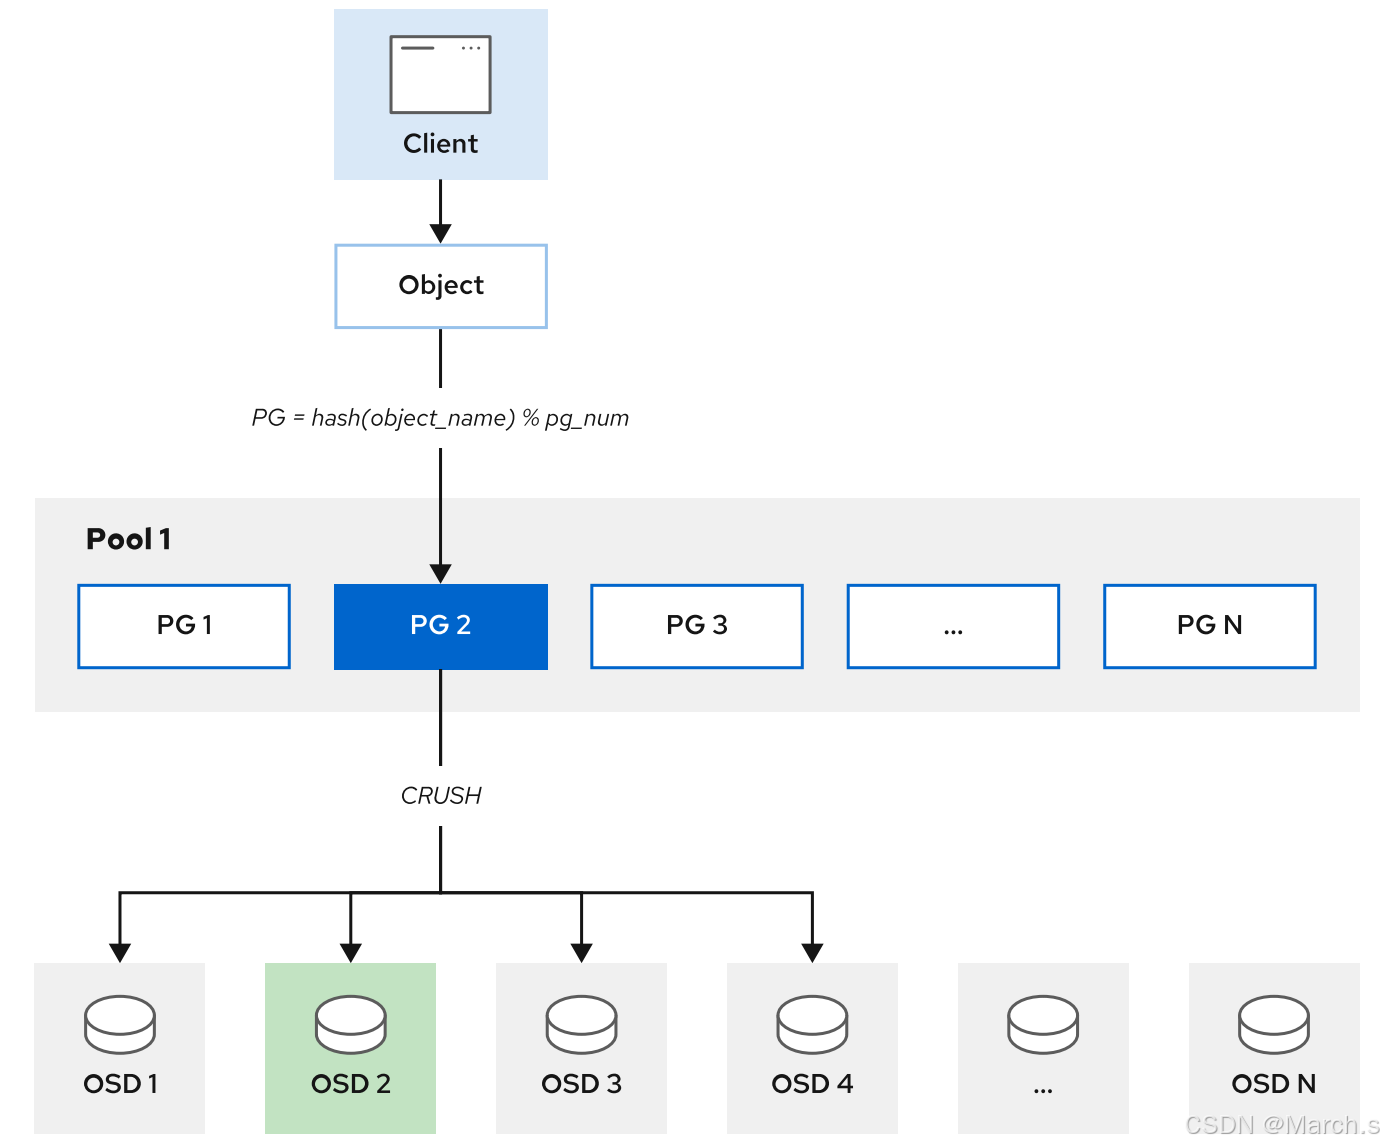
主 OSD 与次要 OSD
在与某个对象关联的多个 OSD 中,一个是该对象归置组的主 OSD——Ceph 客户端读取或写入数据时总是联系主 OSD;其余为次要 OSD,用于在集群故障时保障数据的弹性与可靠。
| 主 OSD | 服务所有 I/O 请求;副本和保护数据;检查数据一致性;重新平衡数据;恢复数据 |
| 次要 OSD | 始终在主 OSD 的控制下行动;必要时可以变为主 OSD |
Warning 运行 OSD 的主机不得使用基于内核的客户端挂载 Ceph RBD 映像或 CephFS 文件系统。由于内存死锁或此前会话上挂起的阻塞 I/O,被挂载的资源可能变得无响应。
部署密度与文件系统
典型的 Ceph 集群部署方案是为每个物理磁盘创建一个 OSD 守护进程;同时 OSD 也支持更灵活的方式,例如按每个磁盘、每个主机或每个 RAID 卷创建一个 OSD 守护进程。
以一个由 3 个 Monitor 与多台 OSD 服务器组成的集群为例:其中一台 OSD 服务器可提供 5 个 OSD,每个 OSD 守护进程对应一个存储设备。各存储设备使用文件系统格式化,目前仅支持 XFS。XFS 默认启用扩展属性,用于存储内部对象状态、快照元数据以及 Ceph RADOS 网关 ACL 的信息。 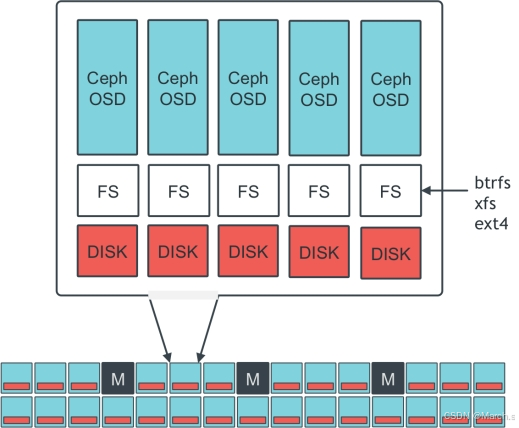
OSD 日志
每个 OSD 都有自己的 OSD 日志。它与文件系统日志无关,作用是提升 OSD 的写性能:客户端的写请求通常是随机的,而 OSD 进程会按顺序把请求写入日志,这给了主机文件系统更多时间来合并写操作,从而提高写效率。当所有 OSD 日志都记录了写请求之后,Ceph 集群才通知客户端"写入完成",随后再把 OSD 日志的内容应用到后端文件系统;应用完成后回收已提交的日志请求,以释放日志设备上的空间。
当 OSD 或存储服务器故障时:若日志尚未应用到文件系统,则依据日志将数据 replay 到文件系统;若已经应用到后端文件系统,则依据副本恢复。
由于日志的写入频率极高,OSD 日志最好配置在独立的、速度快的磁盘上(例如 SSD),以获得更好的性能与写效率。
(4) 管理器(MGR)
Ceph Manager 负责集群大部分数据的统计。
集群中没有 MGR 并不会影响客户端的 I/O 操作,但将无法查询集群统计数据。为避免这种情形,建议每个集群至少部署两个 Ceph Manager,且每个 Manager 运行在独立的失败域中。
MGR 守护进程提供对集群收集数据的集中访问,并为存储管理员提供一个简易的 Web 仪表板;它还可以把状态信息导出到外部监控系统,例如 Zabbix。
(5) 元数据服务器(MDS)
MDS 管理 Ceph 文件系统(CephFS)的元数据,要点有四:
- 提供符合 POSIX 的共享文件系统元数据管理,包括所有权、时间戳和模式;
- 使用 RADOS 存储元数据,将文件 inode 映射到对象以及 Ceph 在树中存储数据的位置;
- 访问 CephFS 的客户端首先向 MDS 发送请求;
- MDS 返回客户端获取文件内容所需的信息,客户端再据此从正确的 OSD 取得文件内容。
也就是说,MDS 只负责"找到数据在哪",数据本身的读写仍然由客户端直连 OSD 完成,元数据服务器不会成为吞吐瓶颈。
5. 集群映射(Cluster Map)
前文提到 MON 维护集群映射。真正使用数据时,是 Ceph 客户端与 OSD 通过集群映射来确定数据存储位置。
五个映射共同描述集群拓扑,统称集群映射,由 Ceph 监控器守护进程维护;MON 集群则在监控器守护进程故障时保障其高可用。
| 监视器映射(Monitor Map) | 集群的 fs id;每个 monitor 的位置、名称、地址与端口;映射时间戳。fsid 是唯一且自动生成的标识符(UUID),用于标识 Ceph 集群 | ceph mon dump |
| OSD 映射(OSD Map) | 集群的 fs id、池列表、副本大小、归置组编号、OSD 列表及其状态、映射时间戳 | ceph osd dump |
| 放置组映射(PG Map) | PG 版本、使用百分比、每个归置组的详细信息(PG ID、Up Set、Acting Set、PG 状态、每个池的数据使用统计)、映射时间戳 | ceph pg dump |
| CRUSH 映射(CRUSH Map) | 存储设备列表、故障域层次结构(设备、主机、机架、行、房间)以及存储数据时遍历该层次的规则 | ceph osd crush dump |
| 元数据服务器映射(MDS Map) | 用于存储元数据的池、元数据服务器列表 | ceph fs dump |
把这五张图放在一起看,Ceph 的工作方式就完整闭合了:MON 掌握全局状态并下发映射,客户端凭映射与 CRUSH 算法自行定位 PG 与 OSD,OSD 用日志与副本保证写入性能和数据安全,MGR 汇总运行指标,MDS 只在 CephFS 场景下补充元数据导航。整个链路里没有中心转发节点,也没有单点故障。
二、 Ceph 分布式存储:部署
理论认知建立之后,本章进入实操:从零引导一个 Ceph 集群,并掌握日常运维中最常用的组件管理动作——增删节点、扩缩服务、替换或下线 OSD。全文命令均在 CentOS Stream 8 + cephadm(Ceph Pacific 16.2.x)环境下验证。
1. 安装方式选型
官方推荐的部署方式有两种:
- cephadm:基于容器部署,支持 Octopus 及以后版本。部署完成后可通过命令行和图形界面管理 ceph 集群。
- Rook:基于 Kubernetes 部署,支持 Nautilus 及以后版本。除命令行与图形界面外,还能借助 Kubernetes 管理组件所在的 Pod。
其他部署方式(了解即可):
| ceph-ansible | 通过 Ansible 进行 ceph 部署 |
| ceph-deploy | 已不再维护,不建议使用 |
| DeepSea | 通过 Salt 进行 ceph 部署 |
| 手动部署 | 逐个守护进程手工配置,成本高 |
生产落地几乎一律选 cephadm:容器化消除了包依赖地狱,且自带编排能力,后续章节的运维操作全部围绕它展开。
2. 最小硬件规格
下表给出的是生产环境的最小规格,实验手册中的虚拟机会明显低于此标准。 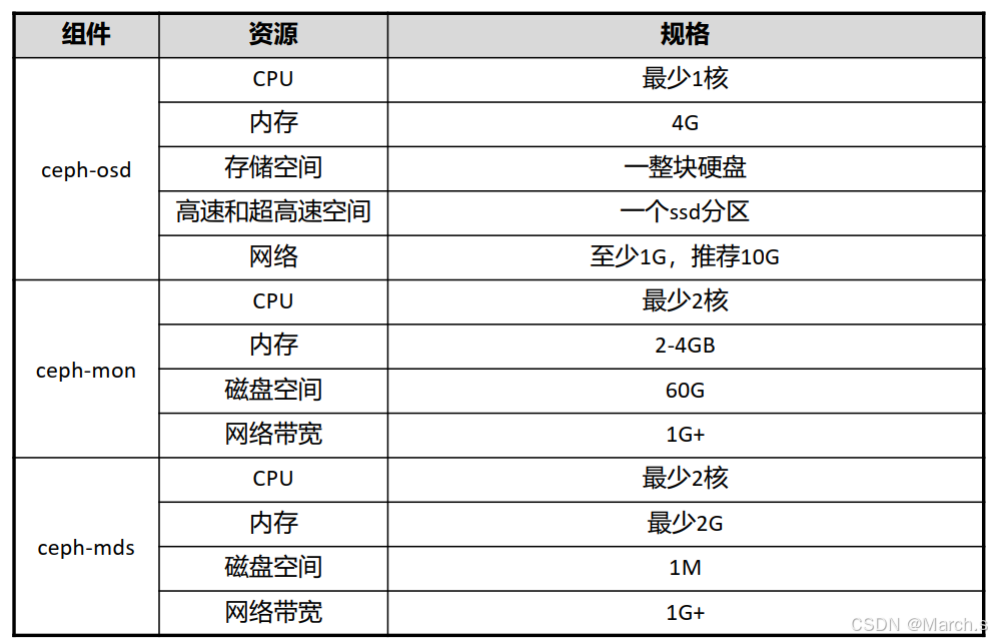
关于 OSD 的资源需要特别注意:
- 每增加一个 osd 服务,就需要增加表中列出的资源。
- OSD 的 CPU 最少 1 核,后续按带宽和 IOPS 调整:每 200–500 MB/s 增加一核,或者每 1000–3000 IOPS 增加一核。
- OSD 内存选择 2G–4G 可以跑通基本功能,但会出现卡顿。
3. 服务端口清单
部署前务必放通下列端口,全部为 TCP 协议。
| MON | 6789、3300 | 用于 Ceph 集群内部通信端口 |
| OSD | 6800–7300 | 每个 osd 占用四个端口,分别用于通过 public 网络与客户端和 MON 通信、通过 cluster 网络或 public 网络与其他 OSD 数据通信、通过 cluster 网络或 public 进行心跳数据包交换,其中用于心跳通信的端口需两个 |
| MDS | 6800–7300 | 用于与元数据服务器通信 |
| MGR | 8443 | 用于以 SSL 的方式登录 ceph 的图形化页面 |
| RESTful 管理模块 | 8003 | 用于以 SSL 的方式与 RESTful 管理模块通信 |
| Prometheus 管理模块 | 9283 | 用于与 ceph 的 Prometheus 插件通信 |
| Prometheus 告警管理 | 9093 | 用于与 Prometheus 的告警管理服务通信 |
| Prometheus 节点导出器 | 9100 | 用于与 Prometheus 节点导出器进程通信 |
| Grafana 服务器 | 3000 | 用于与 Grafana 服务通信 |
| RGW | 80 | 用于 RADOSGW 通信,如果 client.rgw 的配置为空,cephadm 就使用默认的 80 端口 |
| Ceph iSCSI 网关 | 9287 | 用于与 ceph iSCSI 网关通信 |
补充两点:
4. cephadm 简介
Cephadm 是一个 ceph 全生命周期管理工具,通过"引导(bootstrapping)"可创建一个包含一个 MON 和一个 MGR 的单节点集群,后续可通过自带的编排接口进行集群的扩容、主机添加、服务部署。
Cephadm 使用容器部署 Ceph,大大降低了部署 Ceph 集群的复杂性和包依赖性。
cephadm 软件包安装在集群第一个节点中,该节点充当引导节点。Cephadm 是部署新集群时启动的第一个守护程序,同时也是管理器守护程序(MGR)中的一个模块。
与其他服务的交互方式: 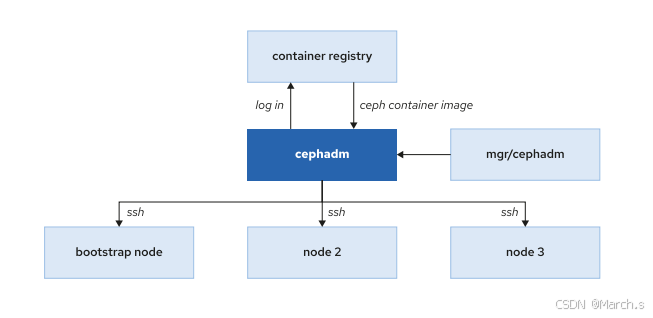
- Cephadm 登录容器镜像仓库来拉取 Ceph 镜像并在使用该镜像的节点上部署服务。
- Cephadm 使用 SSH 连接,向集群添加新主机、添加存储或监控这些主机。
5. 管理接口
Ceph 使用容器化部署,首先创建一个最小的集群,只有一个主机(引导节点)和两个守护进程(监视器和管理器守护进程)。 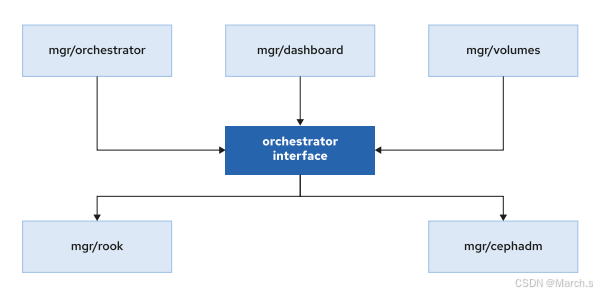
Ceph 提供两个管理接口:Ceph CLI 和 Dashboard GUI,用于配置 Ceph 守护进程和服务以及扩展或收缩集群。cephadm 工具与 Ceph Manager 编排模块交互,Ceph Manager Orchestrator 再与其他组件交互。
(1) Ceph CLI 接口
cephadm shell 命令启动一个容器化版本的 shell,容器中安装了所有必需的 Ceph 包。该命令应该只在引导节点中运行,因为在引导集群时只有该节点可以访问 /etc/ceph 中的管理密钥环。实际情况,在集群中其他节点也可以执行,例如 ceph1。
[root@ceph1 ~]# cephadm shell
Inferring fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
Using recent ceph image
quay.io/ceph/ceph@sha256:f15b41add2c01a65229b0db515d2dd57925636ea39678ccc682a49e2e9713d98
[ceph: root@ceph1 /]#
还可以通过容器化的 shell 直接运行命令:cephadm shell — command。
[root@ceph1 ~]# cephadm shell — ceph status
Inferring fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
Using recent ceph image
quay.io/ceph/ceph@sha256:f15b41add2c01a65229b0db515d2dd57925636ea39678cc682a49e2e9713d98
cluster:
id: 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
health: HEALTH_OK
services:
mon: 3 daemons, quorum ceph1.laogao.cloud,ceph2,ceph3 (age 12m)
mgr: ceph2.oetbal(active, since 11m), standbys: ceph1.laogao.cloud.zoqmbt, ceph3.npaxvt
osd: 9 osds: 9 up (since 12m), 9 in (since 3w)
data:
pools: 1 pools, 1 pgs
objects: 0 objects, 0 B
usage: 2.6 GiB used, 177 GiB / 180 GiB avail
pgs: 1 active+clean
为了操作方便,可以直接在物理主机执行 ceph 命令,需要安装 ceph-common 软件包。
[root@ceph1 ~]# dnf install -y ceph-common
[root@ceph1 ~]# ceph status
(2) Ceph Dashboard 接口
Ceph Dashboard GUI 是一个基于 Web 的应用程序,用于监视和管理集群。Ceph Dashboard GUI 得到了增强,可通过此界面执行许多集群任务,比 Ceph CLI 更直观的方式提供集群信息。
与 Ceph CLI 一样,Dashboard GUI Web 是 ceph-mgr 守护进程的一个模块。默认情况下,Ceph 在创建集群时将 Dashboard GUI 部署在引导节点,并使用 TCP 端口 8443。
Ceph Dashboard GUI 提供以下基础能力:
- 用户和角色管理:用户可以创建具有多个权限和角色的不同用户帐户。
- 单点登录:仪表板 GUI 允许通过外部身份提供者进行身份验证。
- 审计:用户可以将仪表板配置为记录所有 REST API 请求。
- 安全:默认情况下,仪表板使用 SSL/TLS 来保护所有 HTTP 连接。
在此之上还实现了两类集群操作能力:
| 管理功能 | 使用 CRUSH 地图查看集群层次结构;启用、编辑和禁用管理器模块;创建、删除和管理 OSD;管理 iSCSI;管理池 |
| 监控功能 | 检查整体集群健康状况;查看集群中的主机及其服务;查看日志;查看集群警报;检查集群容量 |
仪表板的状态屏幕可以快速查看一些重要的集群参数,例如集群状态、集群中的主机数量或 OSD 数量。 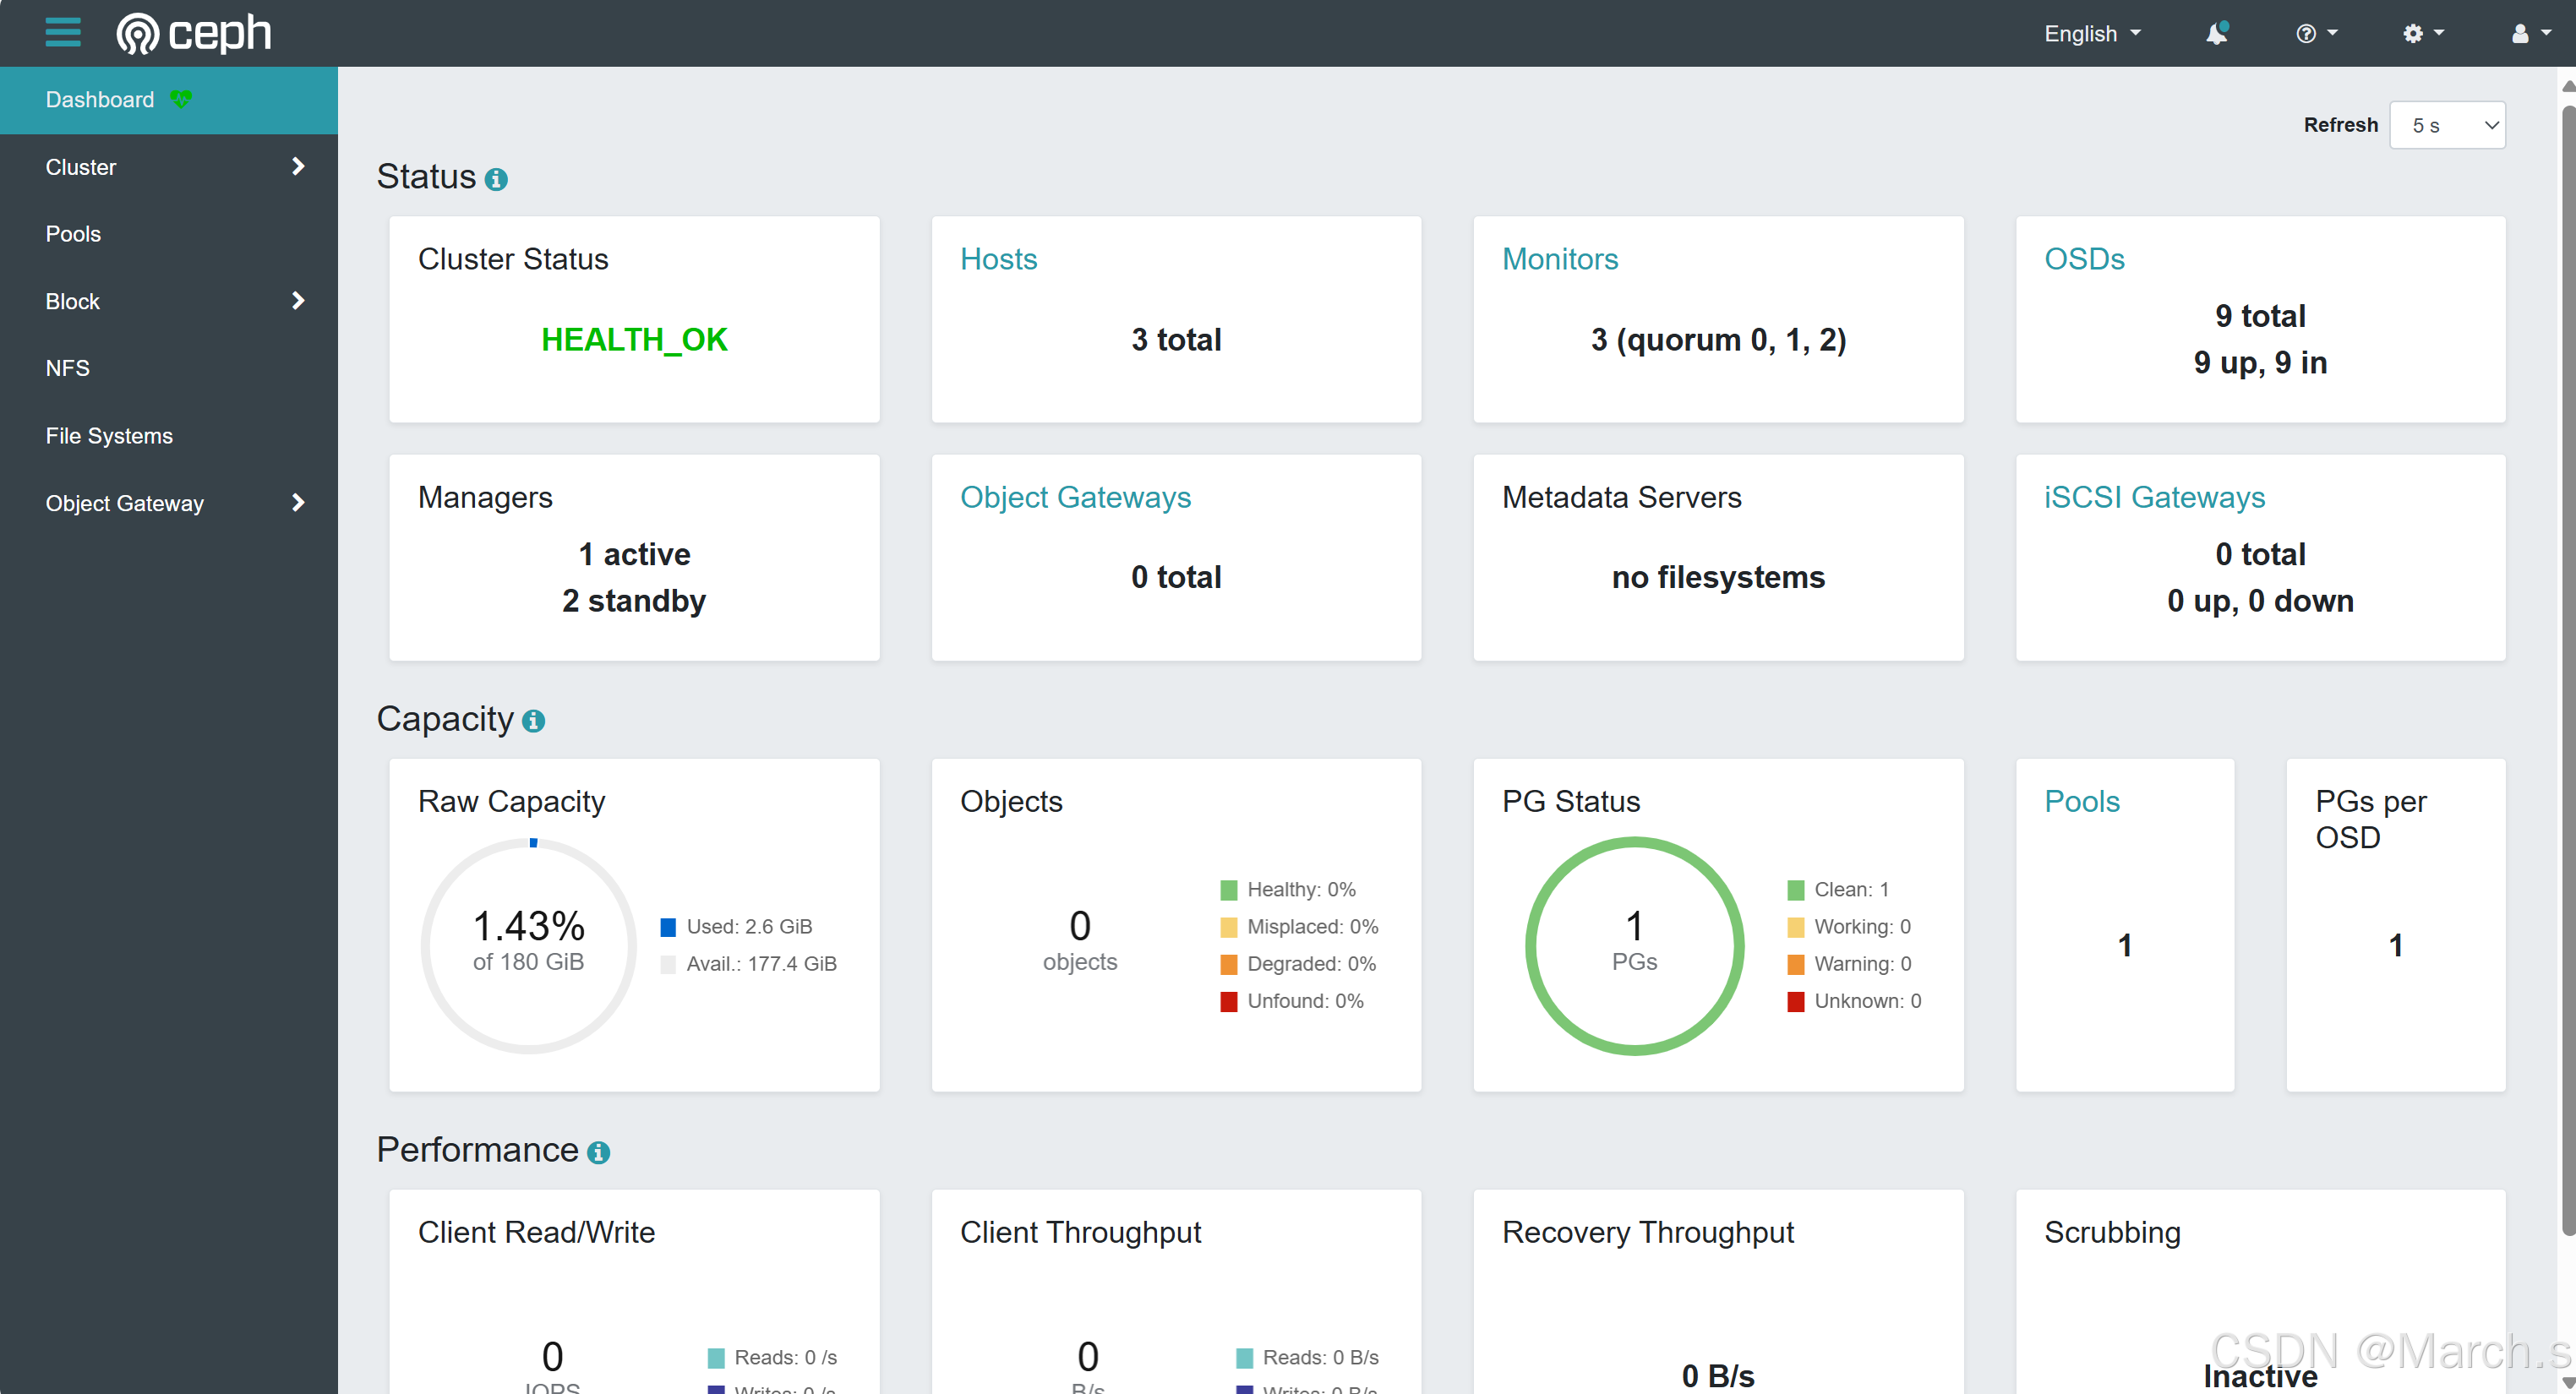
6. 实验环境规划
本教材共使用 7 台虚拟机,部署方法与基础条件如下:
- 部署方法:cephadm
- 操作系统:CentOS Stream 8(最小化安装)
- 硬件配置:2 cpu、8G memory、1 个系统盘 + 3 个 20G 数据盘
- 节点划分:客户端 client;主集群 ceph1、ceph2、ceph3;备集群 ceph4、ceph5、ceph6
| client.laogao.cloud | 192.168.108.10 | 客户端节点 |
| ceph1.laogao.cloud | 192.168.108.11 | 主集群-ceph 节点 |
| ceph2.laogao.cloud | 192.168.108.12 | 主集群-ceph 节点 |
| ceph3.laogao.cloud | 192.168.108.13 | 主集群-ceph 节点 |
| ceph4.laogao.cloud | 192.168.108.14 | 备集群-ceph 节点 |
| ceph5.laogao.cloud | 192.168.108.15 | 备集群-ceph 节点 |
| ceph6.laogao.cloud | 192.168.108.16 | 备集群-ceph 节点 |
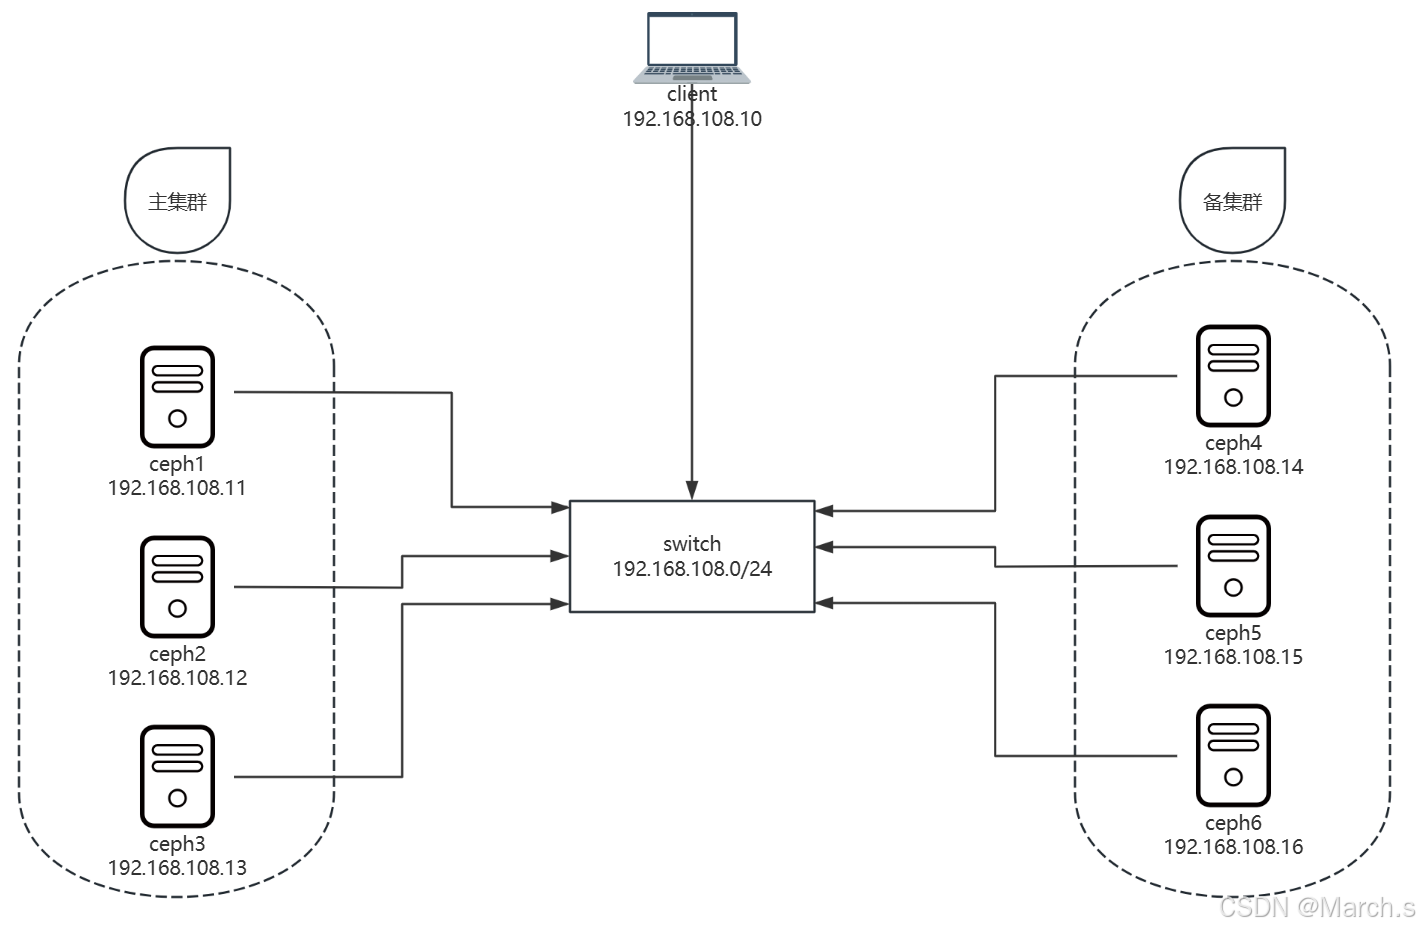
网络拓扑上,7 台虚拟机处于同一二层网段 192.168.108.0/24,网关与 DNS 均指向 192.168.108.2;client 作为纯客户端节点不承载任何 ceph 守护进程,ceph1 同时充当引导节点。
7. 准备虚拟机模板
基于 CentOS-Stream-8-template 模板克隆出 ceph-template,并根据实验硬件要求更改 ceph-template 硬件配置:内存 8GB、处理器 4、添加 3 块 20G SCSI 新硬盘。
随后在模板机上完成主机名解析、安全策略、yum 仓库、时间同步与 cephadm 的安装。
# 1 配置主机名解析
[root@localhost ~]# cat >> /etc/hosts << EOF
###### ceph ######
192.168.108.10 client.laogao.cloud client
192.168.108.11 ceph1.laogao.cloud ceph1
192.168.108.12 ceph2.laogao.cloud ceph2
192.168.108.13 ceph3.laogao.cloud ceph3
192.168.108.14 ceph4.laogao.cloud ceph4
192.168.108.15 ceph5.laogao.cloud ceph5
192.168.108.16 ceph6.laogao.cloud ceph6
EOF
# 2 关闭 SELinux
[root@localhost ~]# sed -ri 's/^SELINUX=.*/SELINUX=disabled/g' /etc/selinux/config
# 3 关闭防火墙
[root@localhost ~]# systemctl disable firewalld –now
# 4 配置yum仓库
[root@localhost ~]# cat << 'EOF' > /etc/yum.repos.d/ceph.repo
[Ceph]
name=Ceph
baseurl=https://mirrors.aliyun.com/centos-vault/8-stream/storage/x86_64/ceph-pacific
enabled=1
gpgcheck=0
EOF
# 5 安装基础软件包
[root@localhost ~]# dnf install -y bash-completion vim lrzsz unzip rsync sshpass tar
# 6 配置时间同步
[root@localhost ~]# dnf install -y chrony
[root@localhost ~]# systemctl enable chronyd –now
# 7 安装 cephadm
[root@localhost ~]# dnf install -y cephadm
[root@localhost ~]# cephadm –help
usage: cephadm [-h] [–image IMAGE] [–docker] [–data-dir DATA_DIR] [–log-dir LOG_DIR]
[–logrotate-dir LOGROTATE_DIR] [–sysctl-dir SYSCTL_DIR] [–unit-dir UNIT_DIR]
[–verbose] [–timeout TIMEOUT] [–retry RETRY] [–env ENV] [–no-container-init]
{version,pull,inspect-image,ls,list-networks,adopt,rm-daemon,rm-cluster,run,shell,enter,ceph-volume,zap-osds,unit,logs,bootstrap,deploy,check-host,prepare-host,add-repo,rm-repo,install,registry-login,gather-facts,exporter,host-maintenance,disk-rescan}
...
Bootstrap Ceph daemons with systemd and containers.
positional arguments:
{version,pull,inspect-image,ls,list-networks,adopt,rm-daemon,rm-cluster,run,shell,enter,ceph-volume,zap-osds,unit,logs,bootstrap,deploy,check-host,prepare-host,add-repo,rm-repo,install,registry-login,gather-facts,exporter,host-maintenance,disk-rescan}
sub-command
version get ceph version from container
pull pull the default container image
inspect-image inspect local container image
ls list daemon instances on this host
......
安装 cephadm 的时候,会自动安装官方推荐的容器引擎 podman。
# 安装 cephadm 的时候,会自动安装官方推荐的容器引擎 podman
[root@localhost ~]# rpm -q podman
podman-4.9.4-0.1.module_el8+971+3d3df00d.x86_64
提前把后续会用到的镜像全部拉下来,避免集群初始化时因网络抖动反复重试。
# 8 提前下载镜像
[root@localhost ~]# podman pull quay.io/ceph/ceph:v16
[root@localhost ~]# podman pull quay.io/ceph/ceph-grafana:8.3.5
[root@localhost ~]# podman pull quay.io/prometheus/node-exporter:v1.3.1
[root@localhost ~]# podman pull quay.io/prometheus/alertmanager:v0.23.0
[root@localhost ~]# podman pull quay.io/prometheus/prometheus:v2.33.4
为避免逐台手工改主机名和 IP,写一个 sethost 脚本,用序号参数一次性完成设置。
# 准备配置主机脚本
[root@localhost ~]# cat > /usr/local/bin/sethost <<'EOF'
#!/bin/bash
hostnamectl set-hostname ceph$1.laogao.cloud
nmcli connection modify ens160 ipv4.method manual ipv4.addresses 192.168.108.1$1/24 ipv4.gateway 192.168.108.2 ipv4.dns 192.168.108.2
init 0
EOF
[root@localhost ~]# chmod +x /usr/local/bin/sethost
关机虚拟机,并打快照。
8. 准备集群节点
使用完全克隆方式,克隆出其他虚拟机,并配置主机名和 IP 地址。
#ceph1到ceph6按以下修改
[root@localhost ~]# sethost 1 #ceph1用1,ceph2到ceph6分别为2-6
#client使用CentOS-Stream-8-template克隆,做以下修改
[root@localhost ~]# hostnamectl set-hostname client.laogao.cloud
[root@localhost ~]# nmcli connection modify ens160 ipv4.method manual ipv4.addresses 192.168.108.10/24 ipv4.gateway 192.168.108.2 ipv4.dns 192.168.108.2
[root@localhost ~]#
9. 集群初始化
一切就绪后,在 ceph1 上执行 bootstrap。这一步会拉起第一个 MON 与 MGR,生成集群 FSID、认证密钥与配置文件,并把 Dashboard、监控栈一并部署好。
[root@ceph1 ~]# cephadm bootstrap –mon-ip 192.168.108.11 –allow-fqdn-hostname –initial-dashboard-user admin –initial-dashboard-password laogao@123 –dashboard-password-noupdate
选项说明:
- –mon-ip 192.168.108.11,指定 monitor ip。
- –allow-fqdn-hostname,指定允许使用长名称。当主机名是长名称时,初始化时必须使用该参数。
- –initial-dashboard-user admin,指定 Web UI 登录的管理员账户。
- –initial-dashboard-password laogao@123,指定 Web UI 登录的管理员账户对应密码。
- –dashboard-password-noupdate,指定不要更新 Web UI 登录密码。
输出信息如下:
Verifying podman|docker is present...
Verifying lvm2 is present...
Verifying time synchronization is in place...
Unit chronyd.service is enabled and running
Repeating the final host check...
podman (/usr/bin/podman) version 4.9.4 is present
systemctl is present
lvcreate is present
Unit chronyd.service is enabled and running
Host looks OK
Cluster fsid: 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
Verifying IP 192.168.108.11 port 3300 ...
Verifying IP 192.168.108.11 port 6789 ...
Mon IP `192.168.108.11` is in CIDR network `192.168.108.0/24`
Mon IP `192.168.108.11` is in CIDR network `192.168.108.0/24`
Internal network (–cluster-network) has not been provided, OSD replication will default to the public_network
Pulling container image quay.io/ceph/ceph:v16...
Ceph version: ceph version 16.2.15 (618f440892089921c3e944a991122ddc44e60516) pacific (stable)
Extracting ceph user uid/gid from container image...
Creating initial keys...
Creating initial monmap...
Creating mon...
Waiting for mon to start...
Waiting for mon...
mon is available
Assimilating anything we can from ceph.conf...
Generating new minimal ceph.conf...
Restarting the monitor...
Setting public_network to 192.168.108.0/24 in mon config section
Wrote config to /etc/ceph/ceph.conf
Wrote keyring to /etc/ceph/ceph.client.admin.keyring
Creating mgr...
Verifying port 9283 ...
Waiting for mgr to start...
Waiting for mgr...
mgr not available, waiting (1/15)...
mgr not available, waiting (2/15)...
mgr not available, waiting (3/15)...
mgr is available
Enabling cephadm module...
Waiting for the mgr to restart...
Waiting for mgr epoch 5...
mgr epoch 5 is available
Setting orchestrator backend to cephadm...
Generating ssh key...
Wrote public SSH key to /etc/ceph/ceph.pub
Adding key to root@localhost authorized_keys...
Adding host ceph1.laogao.cloud...
Deploying mon service with default placement...
Deploying mgr service with default placement...
Deploying crash service with default placement...
Deploying prometheus service with default placement...
Deploying grafana service with default placement...
Deploying node-exporter service with default placement...
Deploying alertmanager service with default placement...
Enabling the dashboard module...
Waiting for the mgr to restart...
Waiting for mgr epoch 9...
mgr epoch 9 is available
Generating a dashboard self-signed certificate...
Creating initial admin user...
Fetching dashboard port number...
Ceph Dashboard is now available at:
URL: https://ceph1.laogao.cloud:8443/
User: admin
Password: laogao@123
Enabling client.admin keyring and conf on hosts with "admin" label
Enabling autotune for osd_memory_target
You can access the Ceph CLI as following in case of multi-cluster or non-default config:
sudo /usr/sbin/cephadm shell –fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e -c /etc/ceph/ceph.conf -k /etc/ceph/ceph.client.admin.keyring
Or, if you are only running a single cluster on this host:
sudo /usr/sbin/cephadm shell
Please consider enabling telemetry to help improve Ceph:
ceph telemetry on
For more information see:
https://docs.ceph.com/en/pacific/mgr/telemetry/
Bootstrap complete.
(1) 输出信息解读
Dashboard 登录信息。 引导完成后,Web 入口、账号与口令直接打印在末尾,妥善保存。
Ceph Dashboard is now available at:
URL: https://ceph1.laogao.cloud:8443/
User: admin
Password: laogao@123
客户端访问方法。 带有 admin 标签的主机会自动分发 ceph.conf 与 client.admin 密钥环,因此无需手工拷贝配置即可在本机执行 ceph 命令;多集群或非默认配置场景需要显式指定 fsid、配置文件与密钥环。
Enabling client.admin keyring and conf on hosts with "admin" label
Enabling autotune for osd_memory_target
You can access the Ceph CLI as following in case of multi-cluster or non-default config:
sudo /usr/sbin/cephadm shell –fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e -c /etc/ceph/ceph.conf -k /etc/ceph/ceph.client.admin.keyring
Or, if you are only running a single cluster on this host:
sudo /usr/sbin/cephadm shell
启用遥测。 发送匿名数据给社区,以改善 Ceph。
Please consider enabling telemetry to help improve Ceph:
ceph telemetry on
访问 dashboard。 浏览器打开上述 URL 并登录即可。
10. 添加节点
添加节点过程:
# 为了配置方便,我们在ceph1上安装ceph客户端工具 ceph-common
[root@ceph1 ~]# dnf install -y ceph-common
# 获取集群公钥
[root@ceph1 ~]# ceph cephadm get-pub-key > ~/ceph.pub
# 推送公钥到其他节点
[root@ceph1 ~]# ssh-copy-id -f -i ~/ceph.pub root@ceph2.laogao.cloud
[root@ceph1 ~]# ssh-copy-id -f -i ~/ceph.pub root@ceph3.laogao.cloud
# 添加节点
[root@ceph1 ~]# ceph orch host add ceph2.laogao.cloud
Added host 'ceph2.laogao.cloud' with addr '192.168.108.12'
[root@ceph1 ~]# ceph orch host add ceph3.laogao.cloud
Added host 'ceph3.laogao.cloud' with addr '192.168.108.13'
[root@ceph1 ~]# ceph orch host ls
HOST ADDR LABELS STATUS
ceph1.laogao.cloud 192.168.108.11 _admin
ceph2.laogao.cloud 192.168.108.12
ceph3.laogao.cloud 192.168.108.13
3 hosts in cluster
# 等待自动部署服务到其他节点,部署完成后效果如下:
[root@ceph1 ~]# ceph orch ls
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
alertmanager ?:9093,9094 1/1 8m ago 9m count:1
crash 3/3 8m ago 9m *
grafana ?:3000 1/1 8m ago 9m count:1
mgr 2/2 8m ago 9m count:2
mon 3/5 8m ago 9m count:5
node-exporter ?:9100 3/3 8m ago 9m *
prometheus ?:9095 1/1 8m ago 9m count:1
# crash 3/3个
# mgr 2/2个
# mon 3/5个
# node-exporter 3/3个
11. 部署 mon 和 mgr
新加入的主机不会自动承担核心服务。这里先关闭 mon/mgr 的自动扩展,再通过 _admin 标签把它们精确落到三台主集群节点上——这是让"部署位置由人决定"的标准手法。
# 禁用 mon 和 mgr 服务的自动扩展功能
[root@ceph1 ~]# ceph orch apply mon –unmanaged=true
[root@ceph1 ~]# ceph orch apply mgr –unmanaged=true
[root@ceph1 ~]# ceph orch ls
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
alertmanager ?:9093,9094 1/1 56s ago 12m count:1
crash 3/3 57s ago 12m *
grafana ?:3000 1/1 56s ago 12m count:1
mgr 2/2 57s ago 3s <unmanaged>
mon 3/5 57s ago 8s <unmanaged>
node-exporter ?:9100 3/3 57s ago 12m *
prometheus ?:9095 1/1 56s ago 12m count:1
# mon 和 mgr 的 PLACEMENT 状态为 <unmanaged>
# 配置主机标签,ceph2 和 ceph3 添加标签"_admin"
[root@ceph1 ~]# ceph orch host label add ceph2.laogao.cloud _admin
Added label _admin to host ceph2.laogao.cloud
[root@ceph1 ~]# ceph orch host label add ceph3.laogao.cloud _admin
Added label _admin to host ceph3.laogao.cloud
[root@ceph1 ~]# ceph orch host ls
HOST ADDR LABELS STATUS
ceph1.laogao.cloud 192.168.108.11 _admin
ceph2.laogao.cloud 192.168.108.12 _admin
ceph3.laogao.cloud 192.168.108.13 _admin
3 hosts in cluster
# 将 mon 和 mgr 组件部署到具有_admin标签的节点上
[root@ceph1 ~]# ceph orch apply mon –placement="label:_admin"
Scheduled mon update...
[root@ceph1 ~]# ceph orch apply mgr –placement="label:_admin"
Scheduled mgr update...
#观察现象
[root@ceph1 ~]# ceph orch ls | egrep 'mon|mgr'
mgr 3/3 2m ago 14s label:_admin
mon 3/3 2m ago 28s label:_admin
[root@ceph1 ~]# ceph orch ps | egrep 'mon|mgr'

12. 部署 OSD
OSD 是最省事的一环:一条命令把所有空闲磁盘收编为 OSD。
# 将所有主机上闲置的硬盘添加为 OSD
[root@ceph1 ~]# ceph orch apply osd –all-available-devices
Scheduled osd.all-available-devices update...
13. 部署验证
(1) 查看集群中部署的服务
[root@ceph1 ~]# ceph orch ls
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
alertmanager ?:9093,9094 1/1 3s ago 15m count:1
crash 3/3 4s ago 15m *
grafana ?:3000 1/1 3s ago 15m count:1
mgr 3/3 4s ago 2m label:_admin
mon 3/3 4s ago 2m label:_admin
node-exporter ?:9100 3/3 4s ago 15m *
osd.all-available-devices 9 4s ago 25s *
prometheus ?:9095 1/1 3s ago 15m count:1
部分输出说明:
- RUNNING:服务的运行状态,前一个数字表示当前运行的服务数量,后一个数字表示系统根据策略或配置推荐的服务部署数量。
- PLACEMENT:为服务编排器部署服务时提供的参数,编排器可根据该参数判断服务所部署的节点,常见的 placement 包括:
- 具体节点名称,例如:–placement=ceph2
- 标签,例如:–placement="label:mylabel"
- 数量,例如:–placement="3 host1 host2 host3"
- unmanaged,表示服务不自动部署。通过设置 –unmanaged 为 true 打开该功能,设置为 false 关闭该功能。
(2) 查看集群状态
[root@ceph1 ~]# ceph -s
cluster:
id: 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
health: HEALTH_OK
services:
mon: 3 daemons, quorum ceph1.laogao.cloud,ceph2,ceph3 (age 6m)
mgr: ceph1.laogao.cloud.zoqmbt(active, since 15m), standbys: ceph2.oetbal, ceph3.npaxvt
osd: 9 osds: 9 up (since 30s), 9 in (since 45s)
data:
pools: 1 pools, 1 pgs
objects: 0 objects, 0 B
usage: 2.6 GiB used, 177 GiB / 180 GiB avail
pgs: 1 active+clean
命令 ceph -s 对应的长命令为 ceph –status。输出包含 MON、MGR 及 OSD 的状态,包括数量、位置及运行时间。集群的健康状态可分为:
- HEALTH_OK:表示健康状态良好
- HEALTH_WARN:表示集群存在告警,需进行排查处理后,可转为 HEALTH_OK
- HEALTH_ERR:表示集群存在比较严重的错误,需要立即处理
(3) 查看集群 osd 结构
[root@ceph1 ~]# ceph osd tree
ID CLASS WEIGHT TYPE NAME STATUS REWEIGHT PRI-AFF
-1 0.17537 root default
-3 0.05846 host ceph1
0 hdd 0.01949 osd.0 up 1.00000 1.00000
3 hdd 0.01949 osd.3 up 1.00000 1.00000
6 hdd 0.01949 osd.6 up 1.00000 1.00000
-5 0.05846 host ceph2
2 hdd 0.01949 osd.2 up 1.00000 1.00000
4 hdd 0.01949 osd.4 up 1.00000 1.00000
7 hdd 0.01949 osd.7 up 1.00000 1.00000
-7 0.05846 host ceph3
1 hdd 0.01949 osd.1 up 1.00000 1.00000
5 hdd 0.01949 osd.5 up 1.00000 1.00000
8 hdd 0.01949 osd.8 up 1.00000 1.00000
(4) 查看集群组件
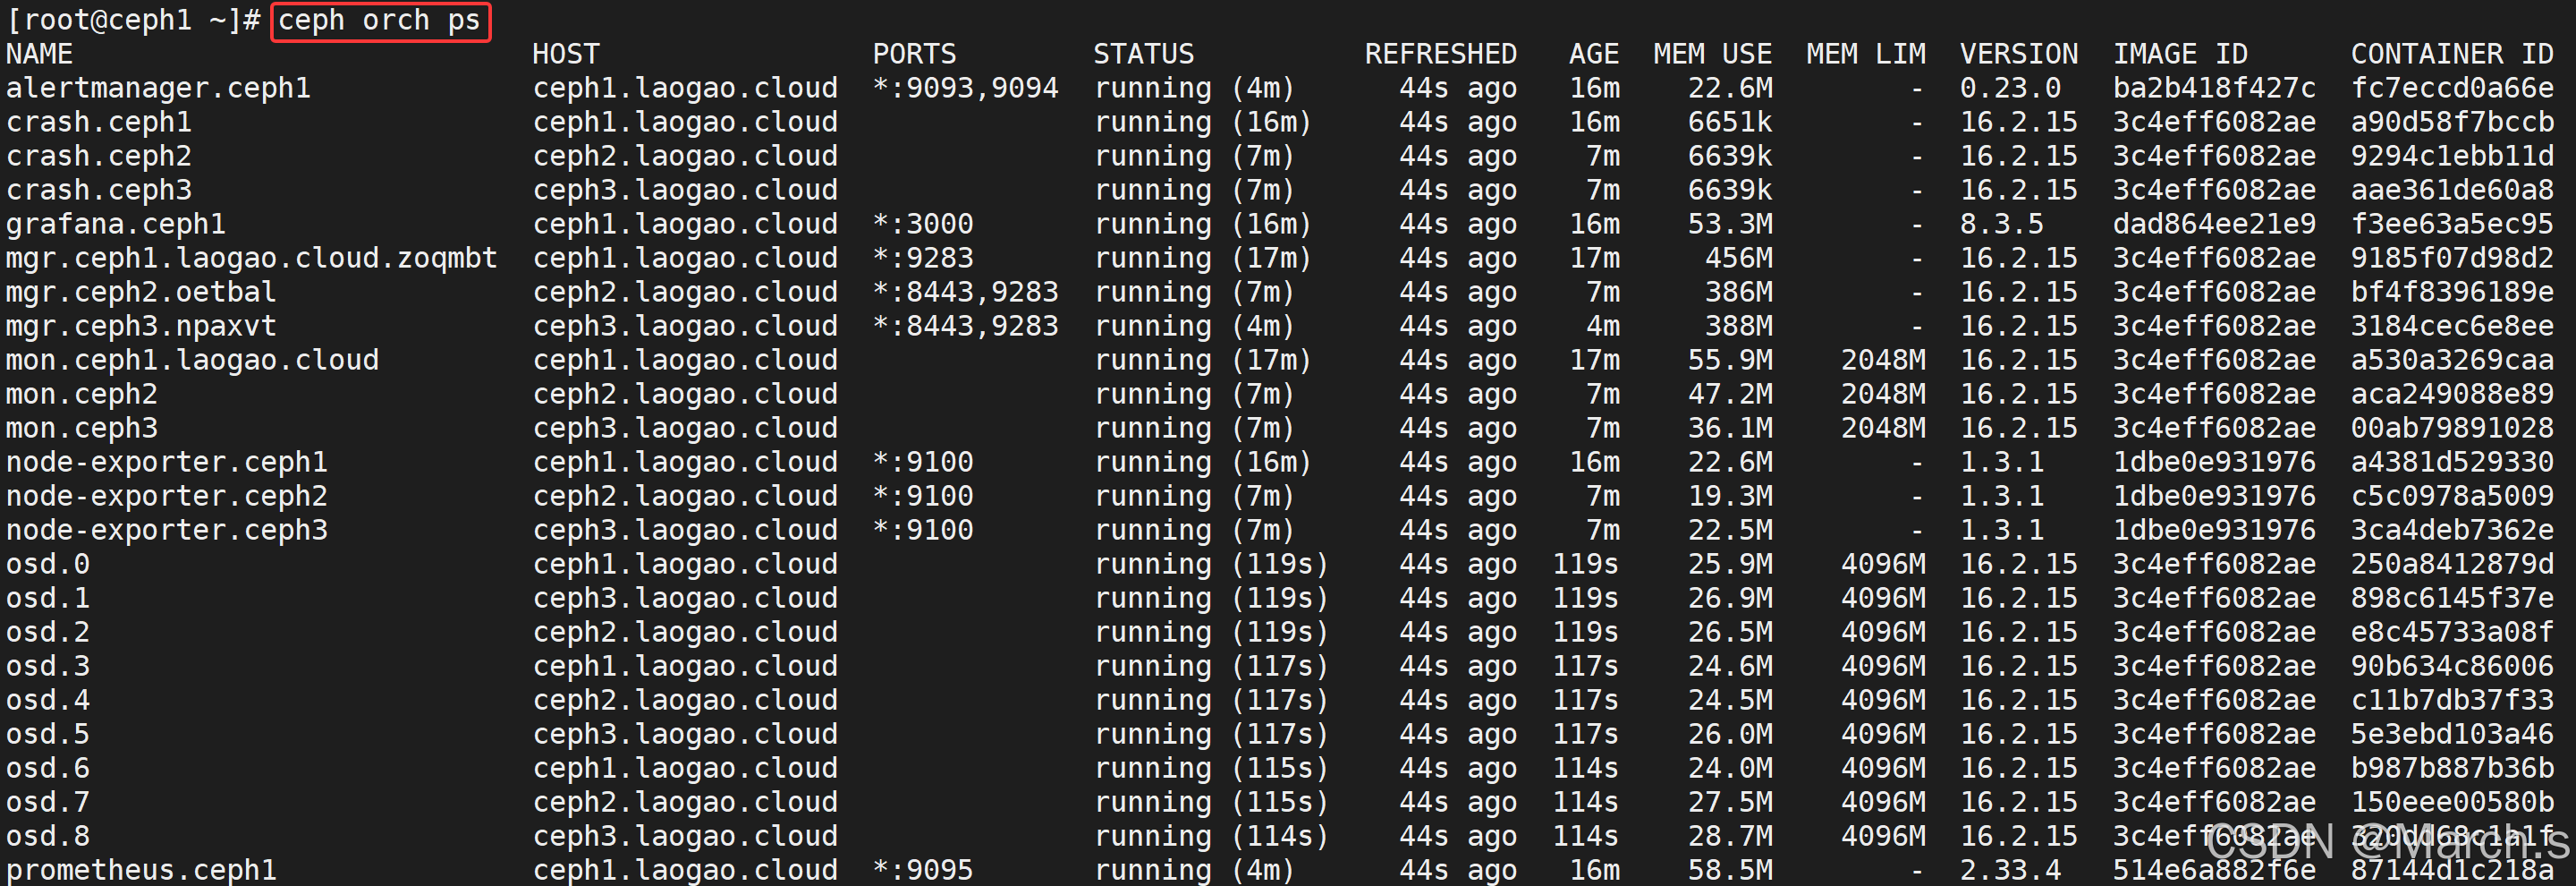
集群中运行的主要组件:
- mgr,ceph 管理程序
- monitor,ceph 监视器
- osd,ceph 对象存储进程
- rgw,ceph 对象存储网关
其他组件:
- crash,崩溃数据收集模块
- prometheus,监控组件
- grafana,监控数据展示 dashboard
- alertmanager,prometheus 告警组件
- node_exporter,prometheus 节点数据收集组件
查询出服务的具体情况后,可对指定服务进一步操作:
ceph orch daemon start|stop|restart|redeploy|reconfig <service_name>
对指定服务进行启动、停止、重启等操作。
ceph orch daemon rm <service_name> [–force]
可删除指定服务。
Tip:这时关闭所有 ceph 存储节点。并打快照,便于后续做实验。
14. 集群组件管理
(1) ceph orch 命令体系
ceph orch 命令与编排器模块交互,编排器模块是 ceph-mgr 的插件,与外部编排服务交互。ceph orch 命令支持多个外部编排器。其管理的对象分为三层:
| host | 物理节点 |
| Service | 逻辑服务(service type 指服务类型,如 nfs、mds、osd、mon、rgw、mgr、iscsi) |
| Daemon | 进程 |
cephadm 使用的特殊标签:
- _no_schedule:不在此类标签的节点上部署或调度任何服务。
- _no_autotune_memory:不对此类标签的节点进行内存调优。
- _admin:自动将 ceph.conf 和 ceph.client.admin.keyring 发送到此类标签的节点上。
(2) 禁用服务自动扩展
Ceph 集群服务自动扩展功能,会自动部署 ceph 组件到存储节点。如果想手动管理 ceph 服务,则需要禁用 ceph 服务自动扩展功能。
# 查看 mon 服务
[root@ceph1 ~]# ceph orch ls mon
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
mon 3/3 90s ago 8m label:_admin
# 禁用 mon 服务自动扩展
[root@ceph1 ~]# ceph orch apply mon –unmanaged=true
[root@ceph1 ~]# ceph orch ls mon
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
mon 3/5 118s ago 4s <unmanaged>
# 启用 mon 服务自动扩展
[root@ceph1 ~]# ceph orch apply mon –unmanaged=false
[root@ceph1 ~]# ceph orch ls mon
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
mon 3/5 2m ago 4s count:5
# 通过标签部署 mon 服务
[root@ceph1 ~]# ceph orch apply mon –placement="label:_admin"
Scheduled mon update...
[root@ceph1 ~]# ceph orch ls mon
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
mon 3/3 3m ago 15s label:_admin
(3) 删除服务
以 crash 服务为例。删除单个实例与删除整个服务的命令不同,且删除服务前必须先解除自动扩展,否则会被编排器立刻补回来。
# 禁用服务自动扩展
[root@ceph1 ~]# ceph orch apply crash –unmanaged=true
[root@ceph1 ~]# ceph orch ls crash
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
crash 3/3 3m ago 5s <unmanaged>
# 查看服务中实例
[root@ceph1 ~]# ceph orch ps | grep crash
crash.ceph1 ceph1.laogao.cloud running (5m) 4m ago 24m 6639k – 16.2.15 3c4eff6082ae 5aea4634442b
crash.ceph2 ceph2.laogao.cloud running (5m) 4m ago 15m 6639k – 16.2.15 3c4eff6082ae 51d5f1e1d75c
crash.ceph3 ceph3.laogao.cloud running (4m) 4m ago 15m 6647k – 16.2.15 3c4eff6082ae 406b2a7b9d93
# 删除特定实例
[root@ceph1 ~]# ceph orch daemon rm crash.ceph1
Removed crash.ceph1 from host 'ceph1.laogao.cloud'
[root@ceph1 ~]# ceph orch ps | grep crash
crash.ceph2 ceph2.laogao.cloud running (9m) 8m ago 19m 6639k – 16.2.15 3c4eff6082ae 51d5f1e1d75c
crash.ceph3 ceph3.laogao.cloud running (8m) 8m ago 19m 6647k – 16.2.15 3c4eff6082ae 406b2a7b9d93
# 删除服务
[root@ceph1 ~]# ceph orch rm crash
Removed service crash
[root@ceph1 ~]# ceph orch ls crash #这里需要快点查看
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
crash 1/3 <deleting> 50s <unmanaged>
[root@ceph1 ~]# ceph orch ls crash
No services reported
(4) 部署服务
使用 ceph 的编排器部署服务,有两种方式:
apply 方式:定义了服务状态,由编排器根据参数自动寻找合适的节点进行服务部署。
ceph orch apply <service_type> [–placement=<placement_string>] [–unmanaged]
例如:
ceph orch apply crash
ceph orch apply mon –placement="label:_admin"
daemon add 方式:根据命令中的参数,直接进行服务部署。
ceph orch daemon add <daemon_type> <placement>
命令 orch apply osd [–all-available-devices] 将节点上的所有可用设备配置为 OSD。
[root@ceph1 ~]# ceph orch apply crash
Scheduled crash update...
# 刚删除的服务,又部署回来了
[root@ceph1 ~]# ceph orch ls
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
alertmanager ?:9093,9094 1/1 2m ago 18h count:1
crash 3/3 2m ago 2m *
15. 删除 OSD
(1) 确定 OSD 和设备关系
删除 OSD 之前必须先弄清"这个 osd 到底管的是哪块盘",否则 zap 错盘会造成数据损失。ceph osd tree 只能告诉你 osd 属于哪台主机,看不出对应的物理盘。
[root@ceph1 ~]# ceph osd tree
ID CLASS WEIGHT TYPE NAME STATUS REWEIGHT PRI-AFF
-1 0.17537 root default
-3 0.05846 host ceph1 #主机ceph1下的硬盘
0 hdd 0.01949 osd.0 up 1.00000 1.00000 #看不出来osd.0对应哪块磁盘
3 hdd 0.01949 osd.3 up 1.00000 1.00000
6 hdd 0.01949 osd.6 up 1.00000 1.00000
-5 0.05846 host ceph2
2 hdd 0.01949 osd.2 up 1.00000 1.00000
4 hdd 0.01949 osd.4 up 1.00000 1.00000
7 hdd 0.01949 osd.7 up 1.00000 1.00000
-7 0.05846 host ceph3
1 hdd 0.01949 osd.1 up 1.00000 1.00000
5 hdd 0.01949 osd.5 up 1.00000 1.00000
8 hdd 0.01949 osd.8 up 1.00000 1.00000
第一种定位方法:顺着 osd 的 block 软链接反查 LVM 名,再用 lsblk 找到宿主盘。
# 获取集群id
[root@ceph1 ~]# ceph -s | grep id
id: 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
# 登录到ceph1上确认osd.0使用的块设备
[root@ceph1 ~]# ls -l /var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/osd.0/block
lrwxrwxrwx 1 ceph ceph 93 Aug 19 14:01 /var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/osd.0/block –> /dev/ceph-c92942fb-f959-4255-b8e6-751fab70fa79/osd-block-2ed79b2f-d825-4829-b4b0-59879d2ad99c
# 59879d2ad99c是块设备名称最后一串字符
[root@ceph1 ~]# lsblk | grep -B1 59879d2ad99c
sdb 8:16 0 20G 0 disk
└─ceph–c92942fb–f959–4255–b8e6–751fab70fa79-osd–block–2ed79b2f–d825–4829–b4b0–59879d2ad99c 253:4 0 20G 0 lvm
# 确认osd.0对应sdb
第二种定位方法:直接读 OSD 元数据,字段更全,适合脚本化。
# 用下面命令也可以
[root@ceph1 ~]# ceph osd metadata 0 #0是osd编号
{
"id": 0,
"arch": "x86_64",
"back_addr": " [v2:192.168.108.11:6802/914648970,v1:192.168.108.11:6803/914648970]",
"back_iface": "",
"bluefs": "1",
"bluefs_dedicated_db": "0",
"bluefs_dedicated_wal": "0",
"bluefs_single_shared_device": "1",
"bluestore_bdev_access_mode": "blk",
"bluestore_bdev_block_size": "4096",
"bluestore_bdev_dev_node": "/dev/dm-2",
"bluestore_bdev_devices": "sdb",
"bluestore_bdev_driver": "KernelDevice",
"bluestore_bdev_partition_path": "/dev/dm-2",
"bluestore_bdev_rotational": "1",
"bluestore_bdev_size": "21470642176",
"bluestore_bdev_support_discard": "0",
"bluestore_bdev_type": "hdd",
"bluestore_min_alloc_size": "4096",
"ceph_release": "pacific",
"ceph_version": "ceph version 16.2.15 (618f440892089921c3e944a991122ddc44e60516) pacific (stable)",
"ceph_version_short": "16.2.15",
"ceph_version_when_created": "ceph version 16.2.15 (618f440892089921c3e944a991122ddc44e60516) pacific (stable)",
"container_hostname": "ceph1.laogao.cloud",
"container_image": "quay.io/ceph/ceph@sha256:6ba107eb55617994a9e6ed49fb938828c2ed3121aa19ceeffbf8e28608535d94",
"cpu": "Intel(R) Core(TM) Ultra 9 185H",
"created_at": "2026-03-27T06:01:45.491319Z",
"default_device_class": "hdd",
"device_ids": "",
"device_paths": "sdb=/dev/disk/by-path/pci-0000:00:10.0-scsi-0:0:1:0",
"devices": "sdb",
"distro": "centos",
"distro_description": "CentOS Stream 8",
"distro_version": "8",
"front_addr": " [v2:192.168.108.11:6800/914648970,v1:192.168.108.11:6801/914648970]",
"front_iface": "",
"hb_back_addr": " [v2:192.168.108.11:6806/914648970,v1:192.168.108.11:6807/914648970]",
"hb_front_addr": " [v2:192.168.108.11:6804/914648970,v1:192.168.108.11:6805/914648970]",
"hostname": "ceph1.laogao.cloud",
"journal_rotational": "1",
"kernel_description": "#1 SMP Thu May 30 04:13:58 UTC 2024",
"kernel_version": "4.18.0-553.6.1.el8.x86_64",
"mem_swap_kb": "8245244",
"mem_total_kb": "7849664",
"network_numa_unknown_ifaces": "back_iface,front_iface",
"objectstore_numa_unknown_devices": "sdb",
"os": "Linux",
"osd_data": "/var/lib/ceph/osd/ceph-0",
"osd_objectstore": "bluestore",
"osdspec_affinity": "all-available-devices",
"rotational": "1"
}
(2) 脚本实现
手工比对效率低且易错,把上面的定位逻辑固化成一个脚本,在任意 ceph 节点执行即可列出本机全部映射关系。
[root@ceph1 ~]# vim /usr/local/bin/show-osd-device
#!/bin/bash
# author laogao
# date 2025-08-19
# Description 确认 osd 和 device 之间对应关系
# usage 在ceph node 上执行
cluster_id=$(ceph -s|grep id |awk '{print $2}')
cd /var/lib/ceph/${cluster_id}
for osd in osd.*
do
device_id=$(ls -l $osd/block | awk -F '-' '{print $NF}')
device=/dev/$(lsblk |grep -B1 ${device_id} |grep -v ${device_id} | awk '{print $1}')
echo $osd : $device
done
[root@ceph1 ~]# chmod +x /usr/local/bin/show-osd-device
执行效果:
[root@ceph1 ~]# show-osd-device
osd.0 : /dev/sdb
osd.3 : /dev/sdc
osd.6 : /dev/sdd
(3) 推荐路径:编排删除
编排删除做了什么?
示例:删除 osd.0
# 禁用 osd 服务自动扩展
[root@ceph1 ~]# ceph orch apply osd –all-available-devices –unmanaged=true
[root@ceph1 ~]# ceph orch ls osd
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
osd.all-available-devices 9 7m ago 6s <unmanaged>
# 第一种(先标记out,再删除)
[root@ceph1 ~]# ceph osd out osd.0
[root@ceph1 ~]# ceph orch osd rm 0
# 删除device上数据
# 删除前lsblk看下sdb
[root@ceph1 ~]# ceph orch device zap ceph1.laogao.cloud /dev/sdb –force #看osd0管理的是/dev/sdb还是啥
zap successful for /dev/sdb on ceph1.laogao.cloud
# 确认结果
[root@ceph1 ~]# ceph orch device ls
[root@ceph1 ~]# ceph orch device ls | grep ceph1.*sdb
ceph1.laogao.cloud /dev/sdb hdd 20.0G Yes 72s ago
[root@ceph1 ~]# lsblk
[root@ceph1 ~]# lsblk /dev/sdb
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINT
sdb 8:16 0 20G 0 disk
# 第二种 直接删除加格式化磁盘
[root@ceph1 ~]# ceph osd out osd.3
[root@ceph1 ~]# ceph orch osd rm 3 –force –zap
# 添加回来
[root@ceph1 ~]# ceph orch apply osd –all-available-devices
#RUNNING重新变为9
[root@ceph1 ~]# ceph orch ls osd
NAME PORTS RUNNING REFRESHED AGE PLACEMENT
osd.all-available-devices 9 6m ago 29s *
(4) 不推荐路径:手动删除
这是传统方式,在没有 orchestrator 或旧版 Ceph 中常见,在 cephadm 集群中不推荐。
# 将OSD标记为 出群(迁移数据),等待集群数据重平衡完成(ceph -s 看到 active+clean)
[root@ceph1 ~]# ceph osd out osd.0
# 确认osd.0在哪个节点
[root@ceph1 ~]# ceph osd tree
# 手动停服务(登录主机)
[root@ceph1 ~]# systemctl stop ceph-<fsid>@osd.0.service # 或 podman stop …
[root@ceph1 ~]# ceph osd tree
# 从CRUSH地图删除OSD
[root@ceph1 ~]# ceph osd crush remove osd.0
removed item id 0 name 'osd.0' from crush map
[root@ceph1 ~]# ceph osd tree
# 删除OSD认证密钥
[root@ceph1 ~]# ceph auth del osd.0
updated
# 从集群中删除OSD
[root@ceph1 ~]# ceph osd rm 0
removed osd.0
[root@ceph1 ~]# ceph osd tree
# 解除磁盘占用(可选,用于重新使用磁盘)
[root@ceph1 ~]# cephadm shell — ceph-volume lvm zap /dev/sdb –destroy
风险:
- 漏步骤:比如忘了 auth del,导致 OSD ID 无法复用。
- 顺序错误:先删 daemon 再 out,可能引发 PG 异常。
- 磁盘残留:LVM 未清理,新 OSD 无法部署到同一设备。
- Orchestrator 不知情:下次 ceph orch apply osd –all-available-devices 可能报错或忽略该设备。
16. 删除主机
从集群中删除主机流程:
示例:删除 ceph2
首先,禁用集群中所有 ceph 服务自动扩展,禁止自动部署 osd。
[root@ceph1 ~]# for service in $(ceph orch ls |grep -v -e NAME -e osd| awk '{print $1}');do ceph orch apply $service –unmanaged=true;done
[root@ceph1 ~]# ceph orch apply osd –all-available-devices –unmanaged=true
其次,删除主机上运行的服务。
# 查看ceph2上运行的daemon
[root@ceph1 ~]# ceph orch ps |grep ceph2 |awk '{print $1}'
crash.ceph2
mgr.ceph2.oetbal
mon.ceph2
node-exporter.ceph2
osd.2
osd.4
osd.7
# 删除相应 daemon
[root@ceph1 ~]# for daemon in $(ceph orch ps |grep ceph2 |awk '{print $1}');do ceph orch daemon rm $daemon –force;done
# 手动清理crush信息
[root@ceph1 ~]# ceph osd crush rm osd.2
[root@ceph1 ~]# ceph osd crush rm osd.4
[root@ceph1 ~]# ceph osd crush rm osd.7
[root@ceph1 ~]# ceph osd crush rm ceph2
[root@ceph1 ~]# ceph osd rm 2 4 7
# 清理磁盘数据
[root@ceph1 ~]# ceph orch device zap ceph2.laogao.cloud /dev/sdb –force
[root@ceph1 ~]# ceph orch device zap ceph2.laogao.cloud /dev/sdc –force
[root@ceph1 ~]# ceph orch device zap ceph2.laogao.cloud /dev/sdd –force
然后,删除主机。
[root@ceph1 ~]# ceph orch host rm ceph2
[root@ceph1 ~]# ceph orch host ls #查看现象ceph2被移除
HOST ADDR LABELS STATUS
ceph1.laogao.cloud 192.168.108.11 _admin
ceph3.laogao.cloud 192.168.108.13 _admin
2 hosts in cluster
最后,删除 ceph2 中相应 ceph 遗留文件。
[root@ceph2 ~]# rm -rf /var/lib/ceph
[root@ceph2 ~]# rm -rf /etc/ceph /etc/systemd/system/ceph*
[root@ceph2 ~]# rm -rf /var/log/ceph
实验完成后,恢复环境。
恢复环境-还原快照
三、 Ceph 分布式存储:集群配置
1. 管理集群配置
Ceph 集群配置概述
Ceph 的每一个配置选项都有唯一名称,由小写字母与下划线连接而成(部分选项历史上包含短横线或空格)。推荐一律使用下划线命名。
Ceph 守护进程可能从以下六个来源读取配置,优先级由低到高:
| 1 | 编译中的默认值 | 代码内置基线,最低优先级 |
| 2 | 集中配置数据库 | 由 MON 节点统一维护,集群级持久生效 |
| 3 | 本地主机上的配置文件 | 启动时读取,会覆盖中央数据库中的设置 |
| 4 | 环境变量 | 进程启动前注入 |
| 5 | 命令行参数 | 单次启动生效 |
| 6 | 运行时覆盖 | 守护进程运行中被临时改写,重启即失效 |
多来源并存时的生效原则是:较新的设置覆盖较早来源中的设置;配置文件在启动时配置守护进程,且其设置优先于中央数据库中的同名设置;集中配置数据库由监控器(MON)节点统一管理。
完整的生效过程分两步:
注意:Ceph 已优先使用集中配置数据库,ceph.conf 集群配置文件属于被弃用的配置方式,仅在引导和兜底场景保留。
修改集群配置文件
Ceph 会依次在以下位置查找集群配置文件:
- CEPH_CONF 环境变量中包含的路径
- -c path/path:由命令行参数 -c 指定的路径
- ./$cluster.conf
- ~/.ceph/$cluster.conf
- /etc/ceph/$cluster.conf(默认位置)
每个 Ceph 节点都会保存一份本地配置文件,默认位置是 /etc/ceph/ceph.conf。cephadm 工具在引导集群时会用最小选项集创建这份初始配置文件。
配置文件采用 INI 格式,内容涵盖 Ceph 守护进程与客户端配置。每个部分以 [name] 标头定义名称,其下是一个或多个键值对参数:
[name]
parameter1 = value1
parameter2 = value2
使用井号(#)或分号(;)可以禁用某条设置或添加注释。在引导集群时,还可以借助自定义配置文件来调整引导行为:
# cephadm bootstrap –config ceph-config.yaml
配置部分
Ceph 按配置实际应用的守护进程或客户端类型,把配置选项分组存放——决定它是留在配置文件中,还是进入配置数据库。
| [global] | 所有守护进程(含客户端)共有的一般配置;可为单个守护进程或客户端创建专属部分来覆盖 [global] 参数 |
| [mon] | 监控器(MON)的配置 |
| [osd] | OSD 守护进程的配置 |
| [mgr] | 管理器(MGR)的配置 |
| [mds] | 元数据服务器(MDS)的配置 |
| [client] | 应用到所有 Ceph 客户端的配置 |
良好的示例文件参见 /usr/share/doc/ceph/sample.ceph.conf,由 ceph-common 软件包提供。
实例设置
实例设置只作用于特定守护进程,名称格式为 [daemon-type.instance-ID]:
[mon]
# Settings for all mon daemons
[mon.ceph1]
# Settings that apply to the specific MON daemon running on ceph1
同样的命名规则适用于 [osd]、[mgr]、[mds] 和 [client] 部分。其中 OSD 守护进程的实例 ID 始终为数字,例如 [osd.0];客户端的实例 ID 是有效的用户名,例如 [client.operator3]。
元变量
元变量由 Ceph 预先定义,用于简化重复书写的路径与名称:
| $cluster | Ceph 存储集群的名称,默认集群名为 ceph |
| $type | 守护进程类型:mon / osd / mds / mgr / client |
| $id | 守护进程实例 ID。ceph1 上监控器的值为 ceph1,osd.1 的 $id 为 1,客户端应用则为用户名 |
| $name | 守护进程名称与实例 ID,是 $type.$id 的简写 |
| $host | 运行该守护进程的主机名称 |
官方示例文件对这些变量的说明如下:
## Metavariables
# $cluster ; Expands to the Ceph Storage Cluster name. Useful
# ; when running multiple Ceph Storage Clusters
# ; on the same hardware.
# ; Example: /etc/ceph/$cluster.keyring
# ; (Default: ceph)
#
# $type ; Expands to one of mds, osd, or mon, depending on
# ; the type of the instant daemon.
# ; Example: /var/lib/ceph/$type
#
# $id ; Expands to the daemon identifier. For osd.0, this
# ; would be 0; for mds.a, it would be a.
# ; Example: /var/lib/ceph/$type/$cluster-$id
#
# $host ; Expands to the host name of the instant daemon.
#
# $name ; Expands to $type.$id.
# ; Example: /var/run/ceph/$cluster-$name.asok
使用集群配置数据库
集中配置数据库由 MON 节点统一管理,它承担三件事:在守护进程启动之前暂时更改设置;在守护进程运行时更改大部分设置;把永久设置持久存储在数据库中。
数据库默认存放在 MON 节点的 /var/lib/ceph/$fsid/mon.$host/store.db。日常查询与维护都通过 ceph config 命令完成,下面按用途逐一说明。
ceph config ls
列出集群数据库中所有配置条目。
[root@ceph1 ~]# ceph config ls
host
fsid
public_addr
public_addrv
public_bind_addr
cluster_addr
public_network
public_network_interface
cluster_network
cluster_network_interface
......
ceph config help <key>
查看集群数据库中特定配置项的帮助信息,<key> 取自 ceph config ls 列出的条目。
[root@ceph1 ~]# ceph config help host
host – local hostname
(str, basic)
Default:
Can update at runtime: false
Services: [common]
Tags: [network]
if blank, ceph assumes the short hostname (hostname -s)
[root@ceph1 ~]# ceph config help fsid
fsid – cluster fsid (uuid)
(uuid, basic)
Default: 00000000-0000-0000-0000-000000000000
Can update at runtime: false
Services: [common]
Tags: [service]
ceph config dump
显示集群配置数据库设置,输出当前所有生效的配置项(包括默认值和已被修改的值)。需要注意它与 show 的口径差异:dump 展示的是所有被显式设置过(通过 ceph config set 或旧版 ceph.conf)的配置项,不显示纯默认值——即从未被设置、完全使用 Ceph 内置默认的那些项。
[root@ceph1 ~]# ceph config dump
ceph config show
t
y
p
e
.
type.
type.id [ <key> ]
仅显示被显式设置过的配置项,用来回答"用户自定义了哪些配置"。它只列出通过 ceph config set … 设置、或在旧版 ceph.conf 中定义并被加载的项。
[root@ceph1 ~]# ceph config show mon.ceph1.laogao.cloud
[root@ceph1 ~]# ceph config show mon.ceph1.laogao.cloud public_network
192.168.108.0/24
ceph config show-with-defaults
t
y
p
e
.
type.
type.id
显示所有配置项及其当前值(包括默认值),用于查看"完整运行时配置",适合排错或审计。它会列出 Ceph 支持的全部可配置项(数百项),每一项都给出当前生效的值——无论来自默认还是被覆盖。
[root@ceph1 ~]# ceph config show-with-defaults mon.ceph1.laogao.cloud
NAME VALUE
admin_socket $run_dir/$cluster–$name.asok
admin_socket_mode
auth_allow_insecure_global_id_reclaim false
auth_client_required cephx, none
auth_cluster_required cephx
auth_debug false
auth_expose_insecure_global_id_reclaim true
auth_mon_ticket_ttl 259200.000000
auth_service_required cephx
auth_service_ticket_ttl 3600.000000
auth_supported
bdev_aio true
......
ceph config get
t
y
p
e
.
type.
type.id [ <key> ]
精准点查集群数据库中的特定配置设置。
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud
WHO MASK LEVEL OPTION VALUE
RO mon advanced auth_allow_insecure_global_id_reclaim false
global basic container_image
quay.io/ceph/ceph@sha256:6ba107eb55617994a9e6ed49fb938828c2ed3121aa19ceeffbf8e28608535d94 *
mon advanced public_network
192.168.108.0/24
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud public_network
192.168.108.0/24
ceph config set
t
y
p
e
.
type.
type.id <key> <value>
设置集群数据库中的特定配置选项。工作原理有三点:修改 Monitor 维护的集中式配置数据库;所有符合条件的 daemon(如所有 OSD)会自动拉取新配置并应用;配置持久存储在 Monitor 的 KV store 中。
# 设置特定类型所有实例
[root@ceph1 ~]# ceph config set mon mon_allow_pool_delete false
# 设置特定类型特定实例
[root@ceph1 ~]# ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete true
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true
ceph config rm
t
y
p
e
.
type.
type.id [ <key> ]
清除集群数据库中的特定配置选项,相当于删除该参数、让其还原为默认配置。
[root@ceph1 ~]# ceph config rm mon.ceph1.laogao.cloud mon_allow_pool_delete
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
false
ceph config log [<num:int>]
显示集群最近的配置变更历史,默认 10 条,用法类似 Linux 的 history 命令。
[root@ceph1 ~]# ceph config log
— 16 — 2025-08-19T08:08:00.450868+0000 —
– mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
— 15 — 2025-08-19T08:07:01.547157+0000 —
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
— 14 — 2025-08-19T08:05:20.097053+0000 —
+ mon/mon_allow_pool_delete = false
......
# 只显示最近更改的两条记录
[root@ceph1 ~]# ceph config log 2
— 16 — 2025-08-19T08:08:00.450868+0000 —
– mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
— 15 — 2025-08-19T08:07:01.547157+0000 —
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
ceph config reset [<num:int>]
把集群数据库中的配置回滚到 num 指定的历史版本。先构造一个有两次变更的实验环境:
[root@ceph1 ~]# ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete true # 产生 log 20 记录
[root@ceph1 ~]# ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete false # 产生 log 21 记录
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
false # 此刻为 false
[root@ceph1 ~]# ceph config log 2
— 21 — 2025-08-19T08:23:11.722223+0000 —
– mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = false
— 20 — 2025-08-19T08:23:07.709101+0000 —
– mon.ceph1.laogao.cloud/mon_allow_pool_delete = false
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
回滚到 log 20 的版本并验证:
[root@ceph1 ~]# ceph config reset 20
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete # 验证回到 log 20 的 true
true
[root@ceph1 ~]# ceph config log 1
— 22 — 2025-08-19T08:25:27.045753+0000 — reset to 20 — # 从 22 回滚到 20
– mon.ceph1.laogao.cloud/mon_allow_pool_delete = false
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
集群引导选项
集群引导选项提供启动集群所需的信息。MON 读取 mon map 和 ceph.conf 文件,以确定如何与其他 MON 通信并与它们建立仲裁。
mon_ip 选项列出集群监控器,此项必不可少且不能存储在配置数据库中。为避免依赖集群配置文件,Ceph 还支持通过 DNS 服务记录提供 mon_host 列表。
本地集群配置文件 ceph.conf 中还可包含以下选项:
| mon_host_override | 集群监视器的初始列表 |
| mon_dns_serv_name | 用于检查通过 DNS 识别的集群监控器的 DNS SRV 记录的名称 |
| mon_data / osd_data / mds_data / mgr_data | 定义守护进程的本地数据存储目录 |
| keyring / keyfile / key | 使用监控器进行身份验证的凭据 |
在运行时覆盖配置设置
Ceph 支持在守护进程运行时临时更改大部分配置选项,实现手段有两类:跨节点使用的 ceph tell,以及只在守护进程所在本机可用的 ceph daemon。
ceph tell 命令
ceph tell 的语义是向指定 daemon"发消息"。工作原理:直接与指定的运行中 daemon 通信(通过 admin socket 或网络);常用于执行管理命令(如 compact leveldb、flush cache);若用于配置,需通过 injectargs 模拟"启动参数"。
ceph tell $type.$id config 可临时覆盖配置选项,要求所配置的 MON 和目标守护进程都在运行:
- ceph tell $type.$id config show:获取守护进程的所有运行时设置
- ceph tell $type.$id config get:获取守护进程的特定运行时设置
- ceph tell $type.$id config set:设置守护进程的特定运行时设置,守护进程重启后恢复原值
示例——临时改值后,运行时生效但数据库不变:
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
"mon_allow_pool_delete": "true"
}
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config set mon_allow_pool_delete false
{
"success": "mon_allow_pool_delete = 'false' "
}
# 临时更改的值已生效
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
"mon_allow_pool_delete": "false"
}
# 集群数据库中的值仍然为 true
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true
# 重启守护进程,生效的值恢复为数据库中设置的值
[root@ceph1 ~]# ceph orch daemon restart mon.ceph1.laogao.cloud
Scheduled to restart mon.ceph1.laogao.cloud on host 'ceph1.laogao.cloud'
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
"mon_allow_pool_delete": "true"
}
注意:使用此命令更改的设置,在守护进程重启后会恢复为原始设置。
ceph tell $type.$id config 支持通配符,可一次性获取或设置同一类型所有守护进程的值:
[root@ceph1 ~]# ceph tell mon.* config get mon_allow_pool_delete
mon.ceph1.laogao.cloud:
{
"mon_allow_pool_delete": "true"
}
mon.ceph2:
{
"mon_allow_pool_delete": "false"
}
mon.ceph3:
{
"mon_allow_pool_delete": "false"
}
ceph config set 与 ceph tell 对比
| 配置存储位置 | Monitor 配置数据库 | 仅内存(daemon 进程内) |
| 是否持久 | ✅ 是 | ❌ 否 |
| 是否批量生效 | ✅(如 osd 影响所有 OSD) | ❌(必须指定具体实例,如 osd.0) |
| 能否用于非配置操作 | ❌ 仅配置 | ✅(如 compact、flush) |
| 是否被 ceph config get 识别 | ✅ 是 | ❌ 否 |
| 适用场景 | 长期配置、运维策略 | 紧急排错、临时调试 |
使用建议:
- 日常调优、生产配置 → 用 ceph config set
- 紧急排查问题、临时抓日志 → 用 ceph tell osd.0 injectargs –debug_xxx=20
- 执行管理动作(非配置)→ 必须用 ceph tell(如 compact、cache-flush)
ceph daemon 命令
Ceph 支持在集群特定节点上用 ceph daemon $type.$id config 临时覆盖配置选项。该命令不需要连接 MON,只要求对应守护进程在本机运行——因此即使 MON 未运行它仍可发挥作用,很适合故障排除。
# 在 ceph1 上只能查看和设置 ceph1 上运行的相关进程设置
[root@ceph1 ~]# cephadm shell
[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config show
{
"name": "mon.ceph1.laogao.cloud",
"cluster": "ceph",
"admin_socket": "/var/run/ceph/ceph-mon.ceph1.laogao.cloud.asok",
"admin_socket_mode": "",
"auth_allow_insecure_global_id_reclaim": "false",
"auth_client_required": "cephx, none",
"auth_cluster_required": "cephx",
"auth_debug": "false",
"auth_expose_insecure_global_id_reclaim": "true",
"auth_mon_ticket_ttl": "259200.000000",
"auth_service_required": "cephx",
......
}
获取与设置特定运行时配置:
[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
"mon_allow_pool_delete": "true"
}
[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config set mon_allow_pool_delete false
{
"success": "mon_allow_pool_delete = 'false' "
}
[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
"mon_allow_pool_delete": "false"
}
注意:使用此命令更改的设置,在守护进程重启后同样会恢复为原始设置。
[ceph: root@ceph1 /]# ceph orch daemon restart mon.ceph1.laogao.cloud
Scheduled to restart mon.ceph1.laogao.cloud on host 'ceph1.laogao.cloud'
[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
"mon_allow_pool_delete": "true"
}
Web UI 更改
图形化面板提供了第三条改配置的路径,步骤如下:
打开浏览器访问 https://ceph1.laogao.cloud:8443,必要时接受证书警告,输入用户名(admin)和密码登录。
在 Ceph 控制面板中单击 Cluster > Configuration,进入 Configuration Settings 页面。 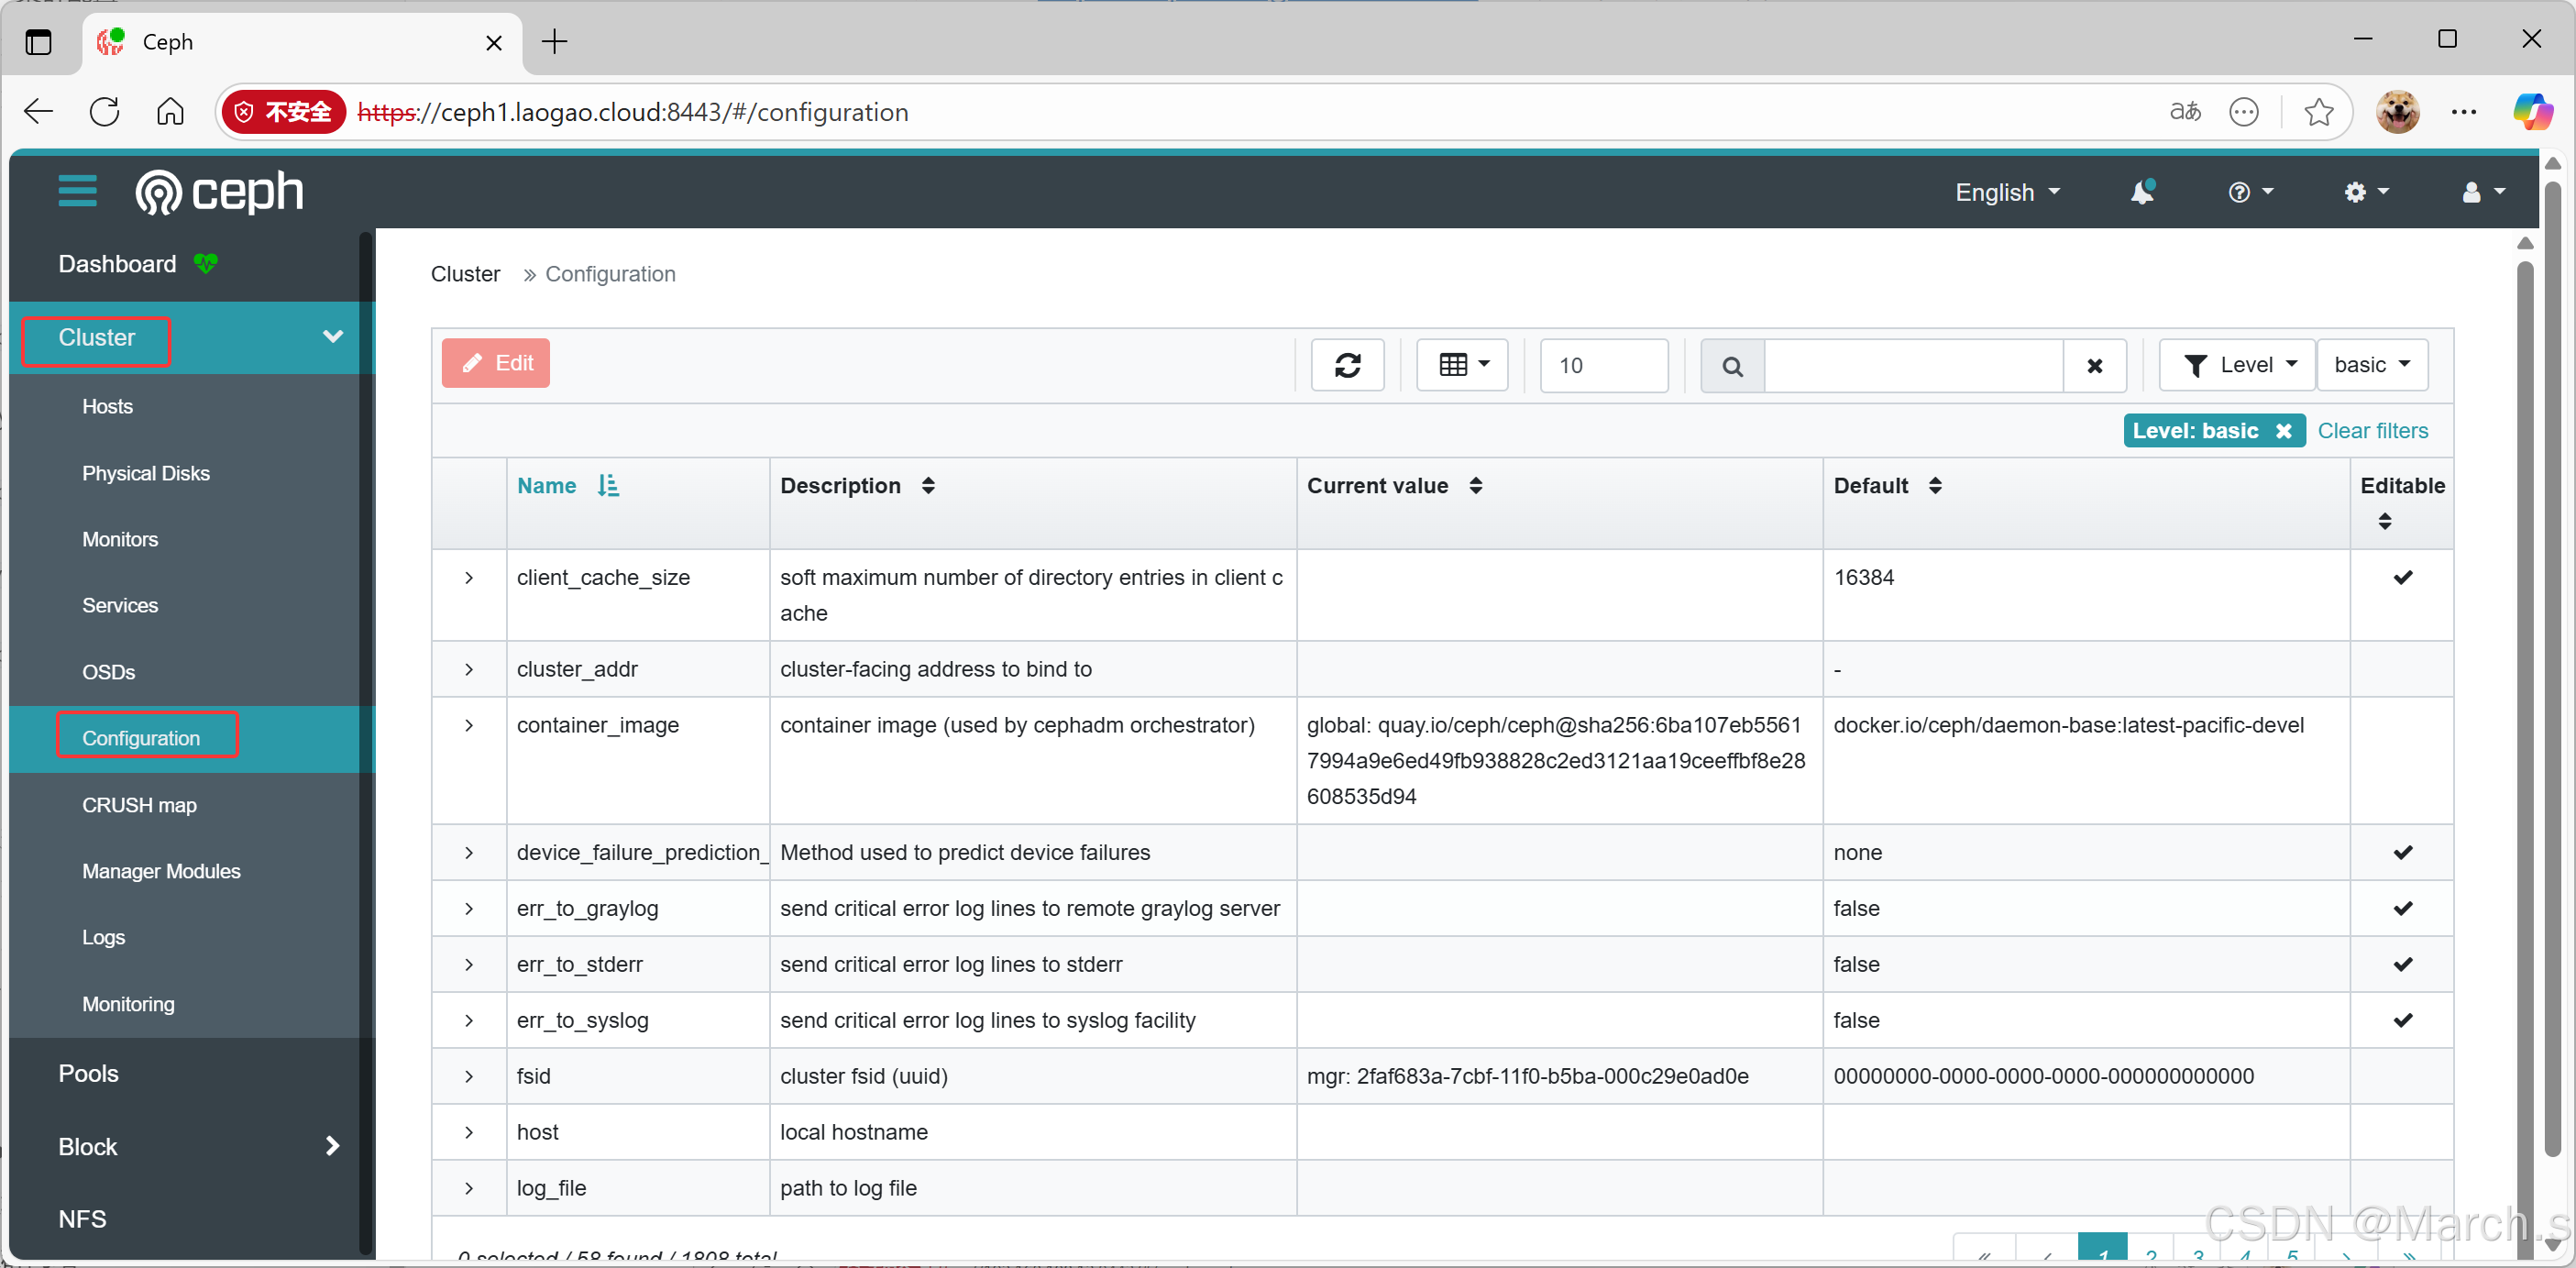
从下拉菜单中选择 advanced 以查看高级配置选项,在搜索栏键入 mon_allow_pool_delete 定位该设置。 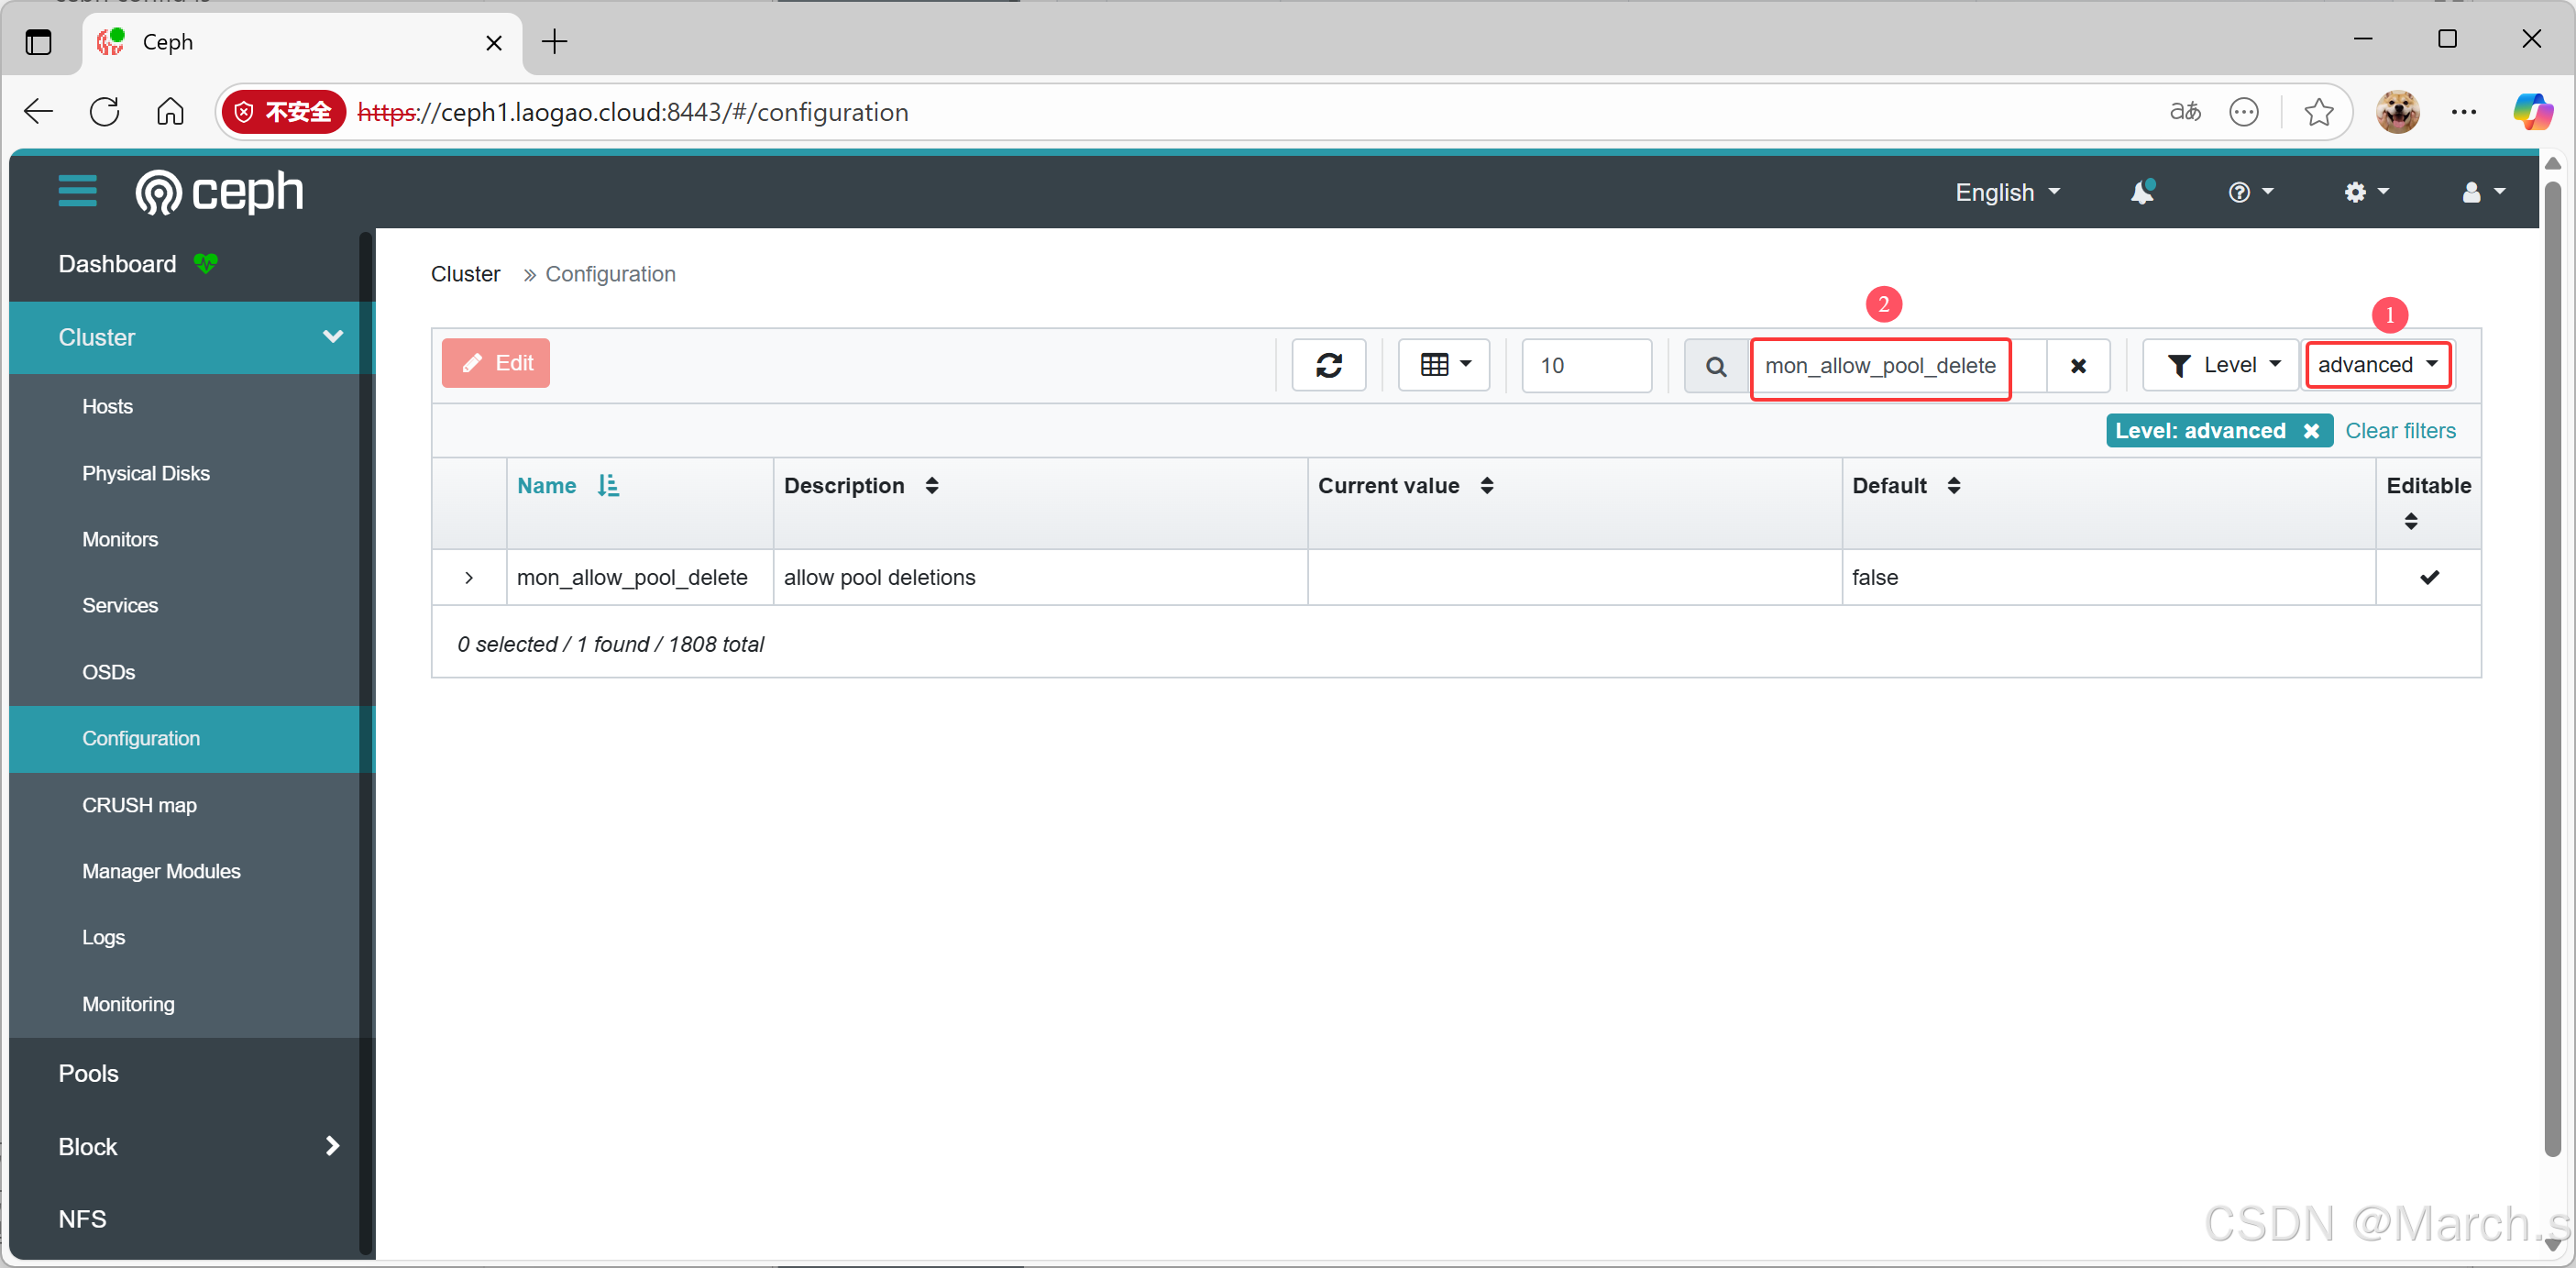
单击 mon_allow_pool_delete,再单击 Edit。 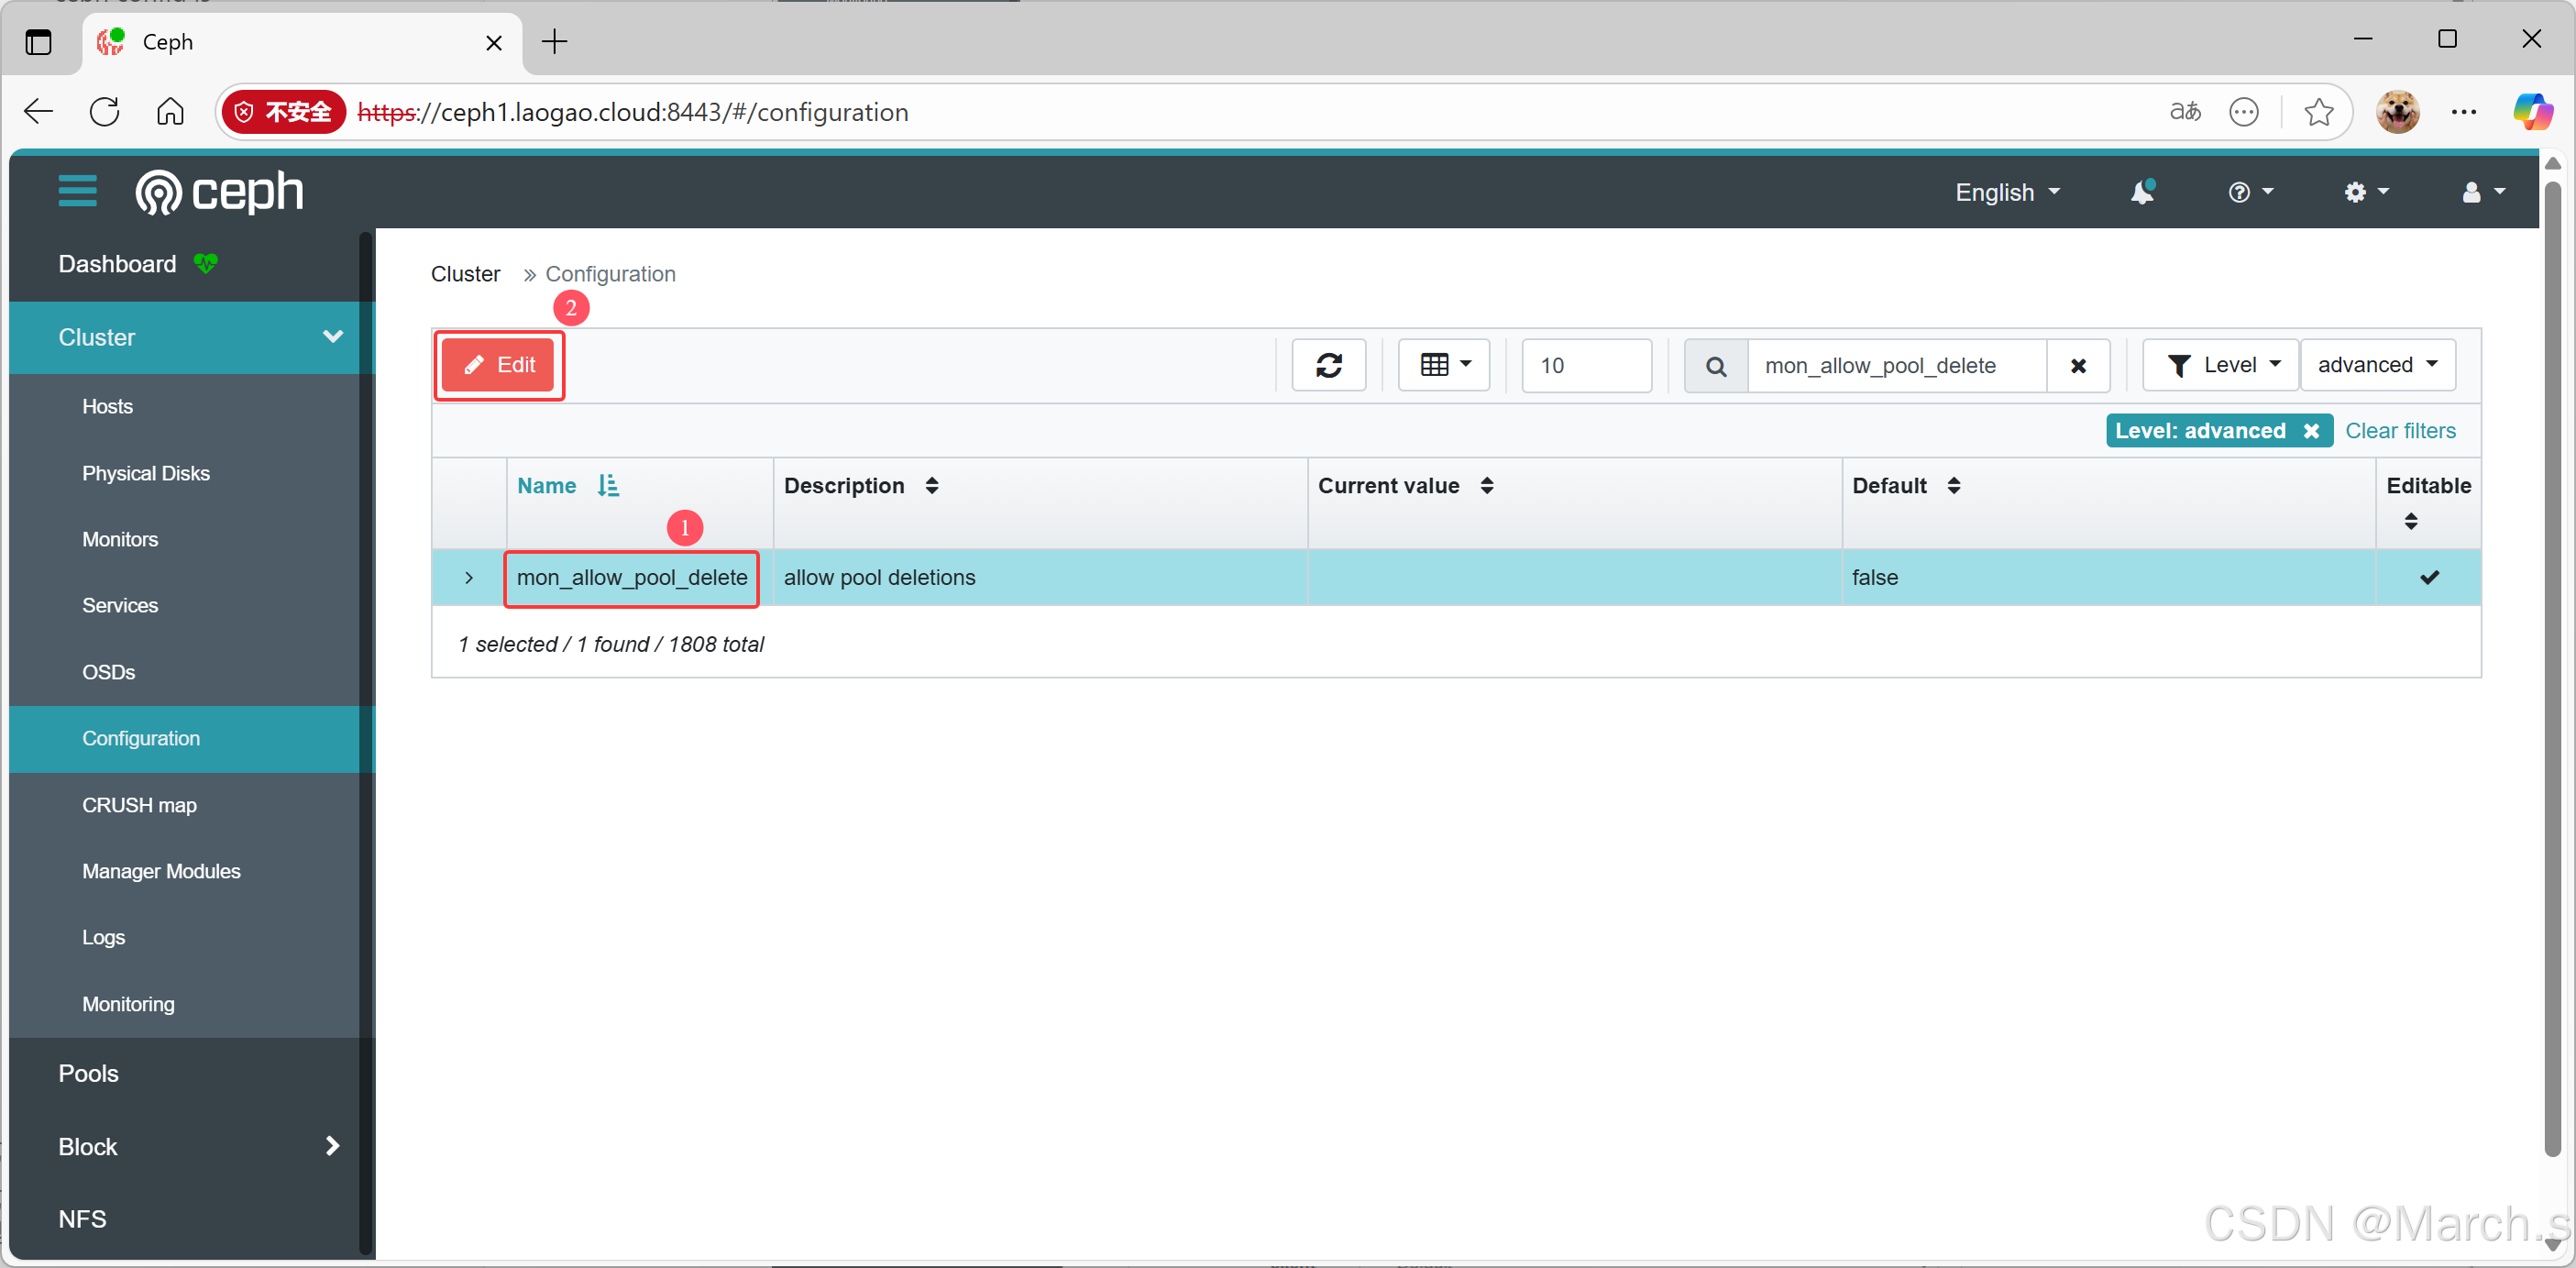
将 global 值改为 true,单击 Update。 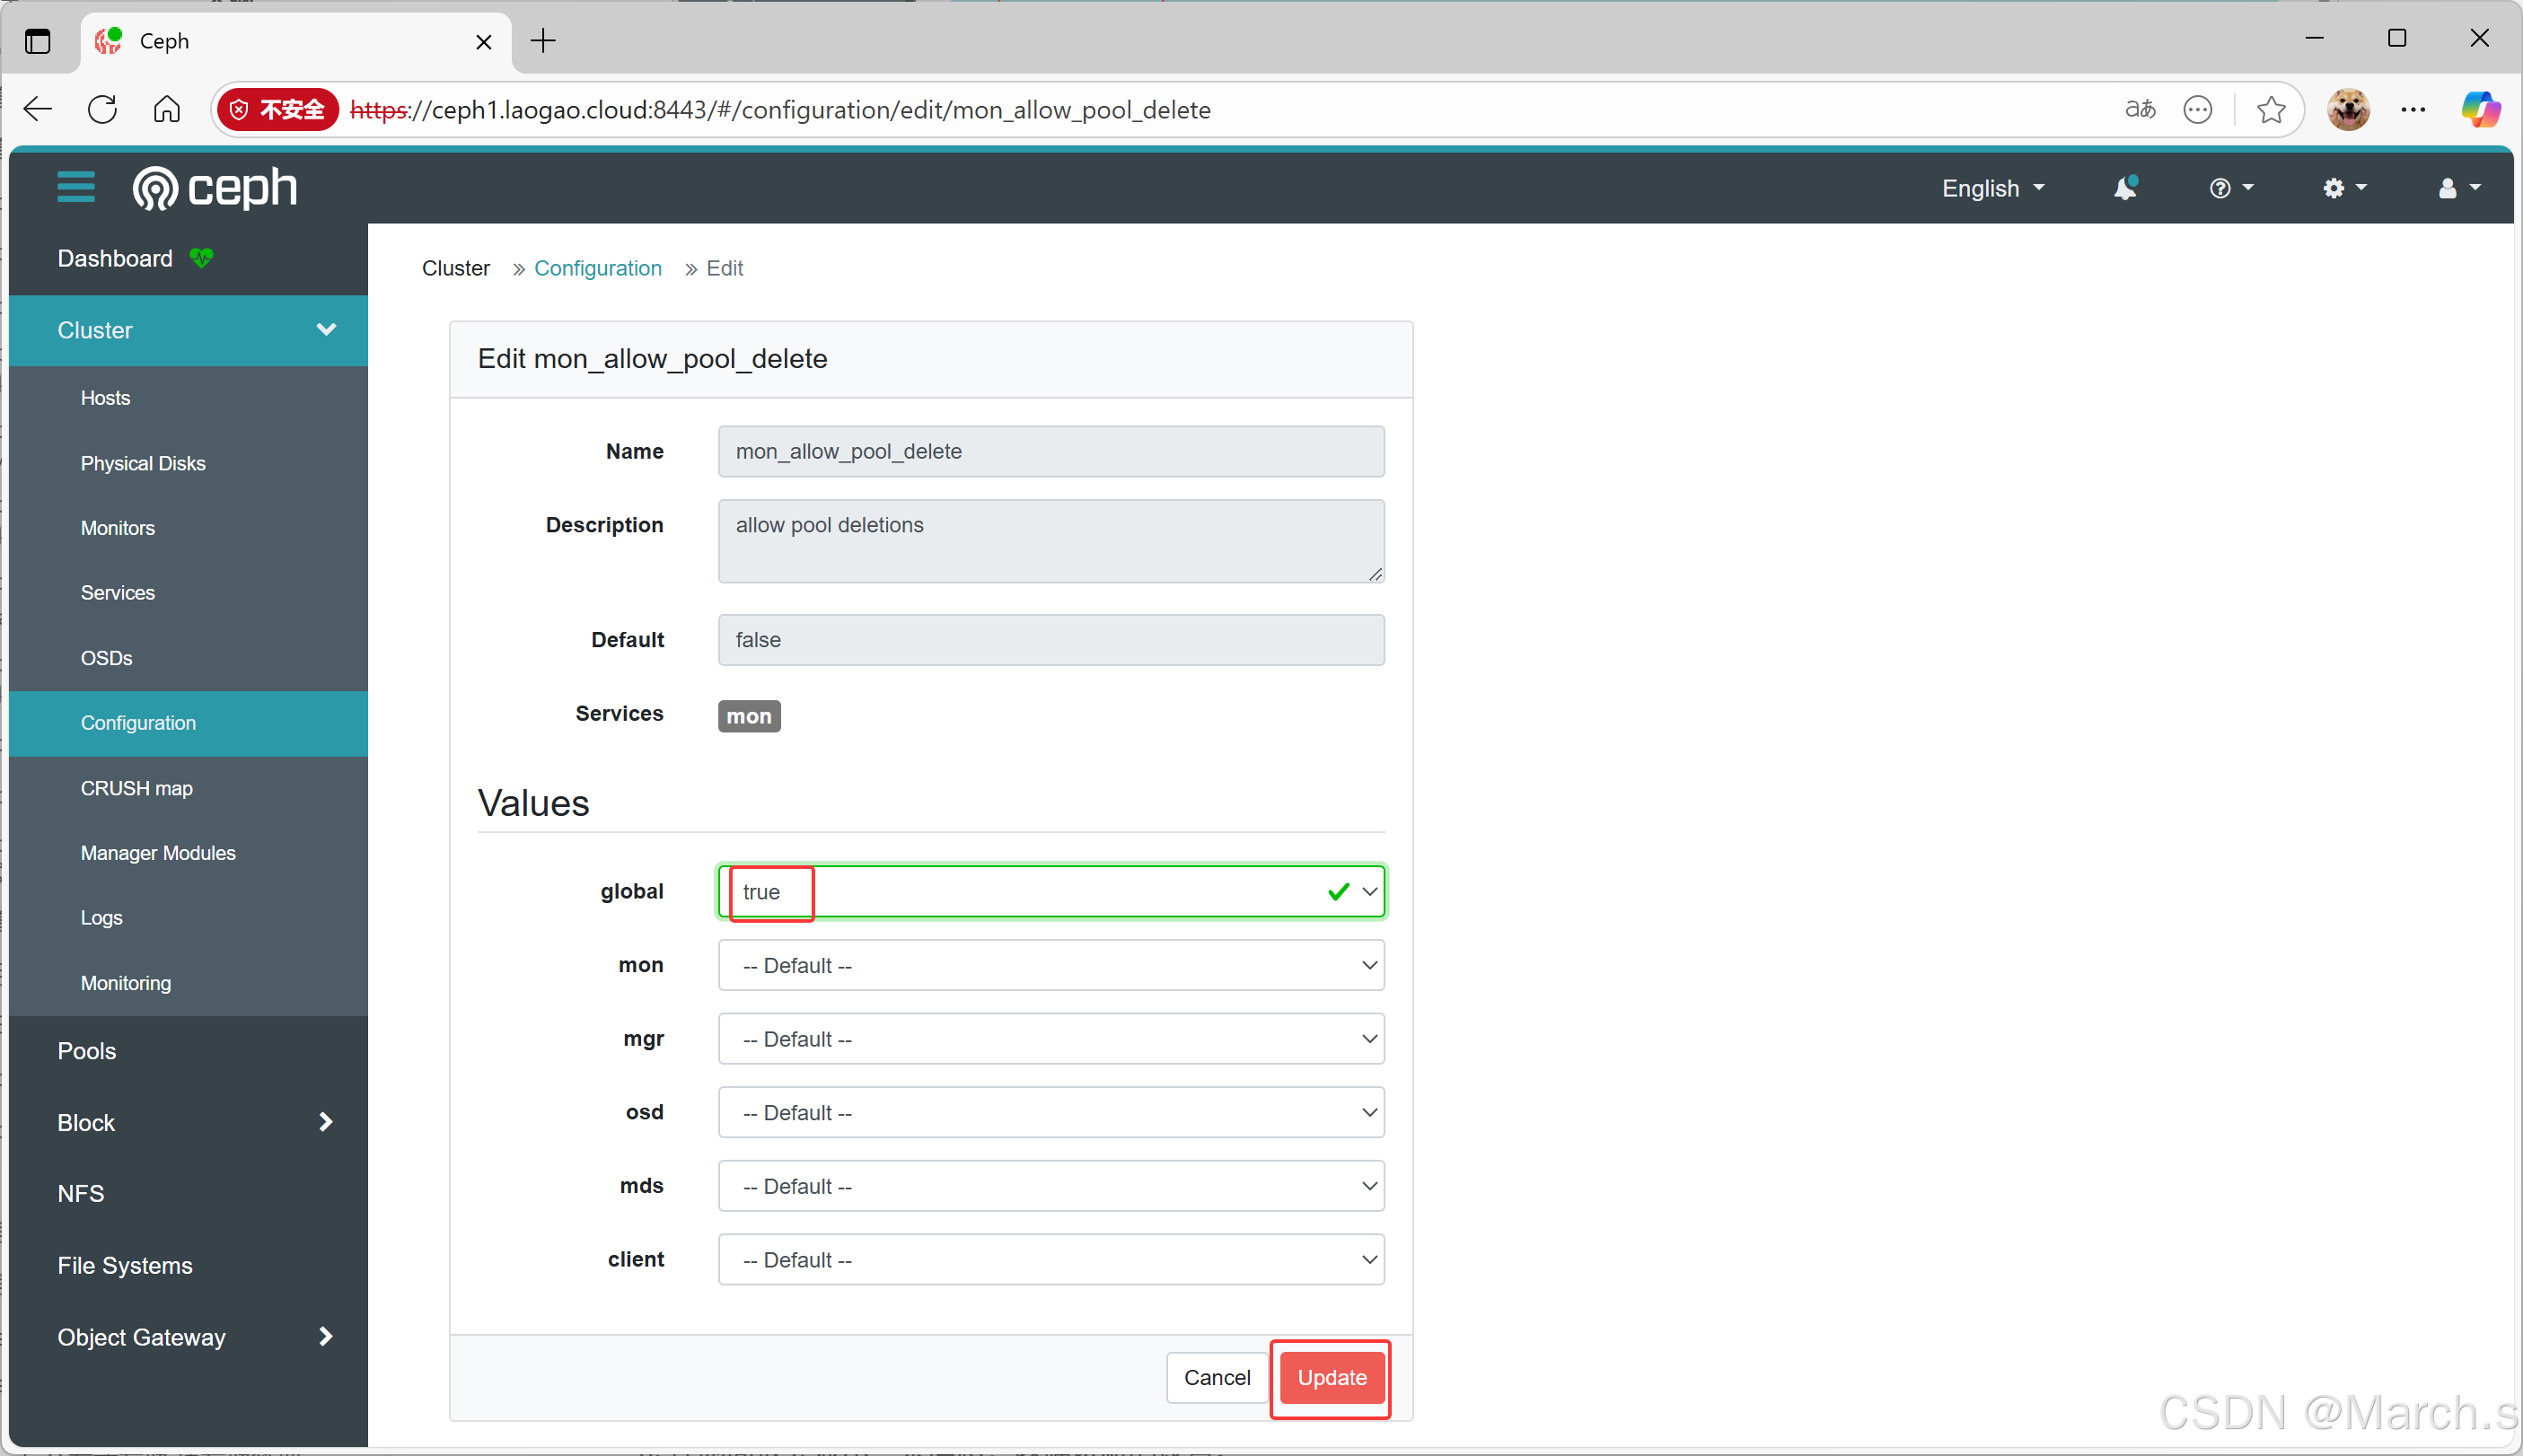
控制面板显示确认消息,新设置写入集中配置数据库。 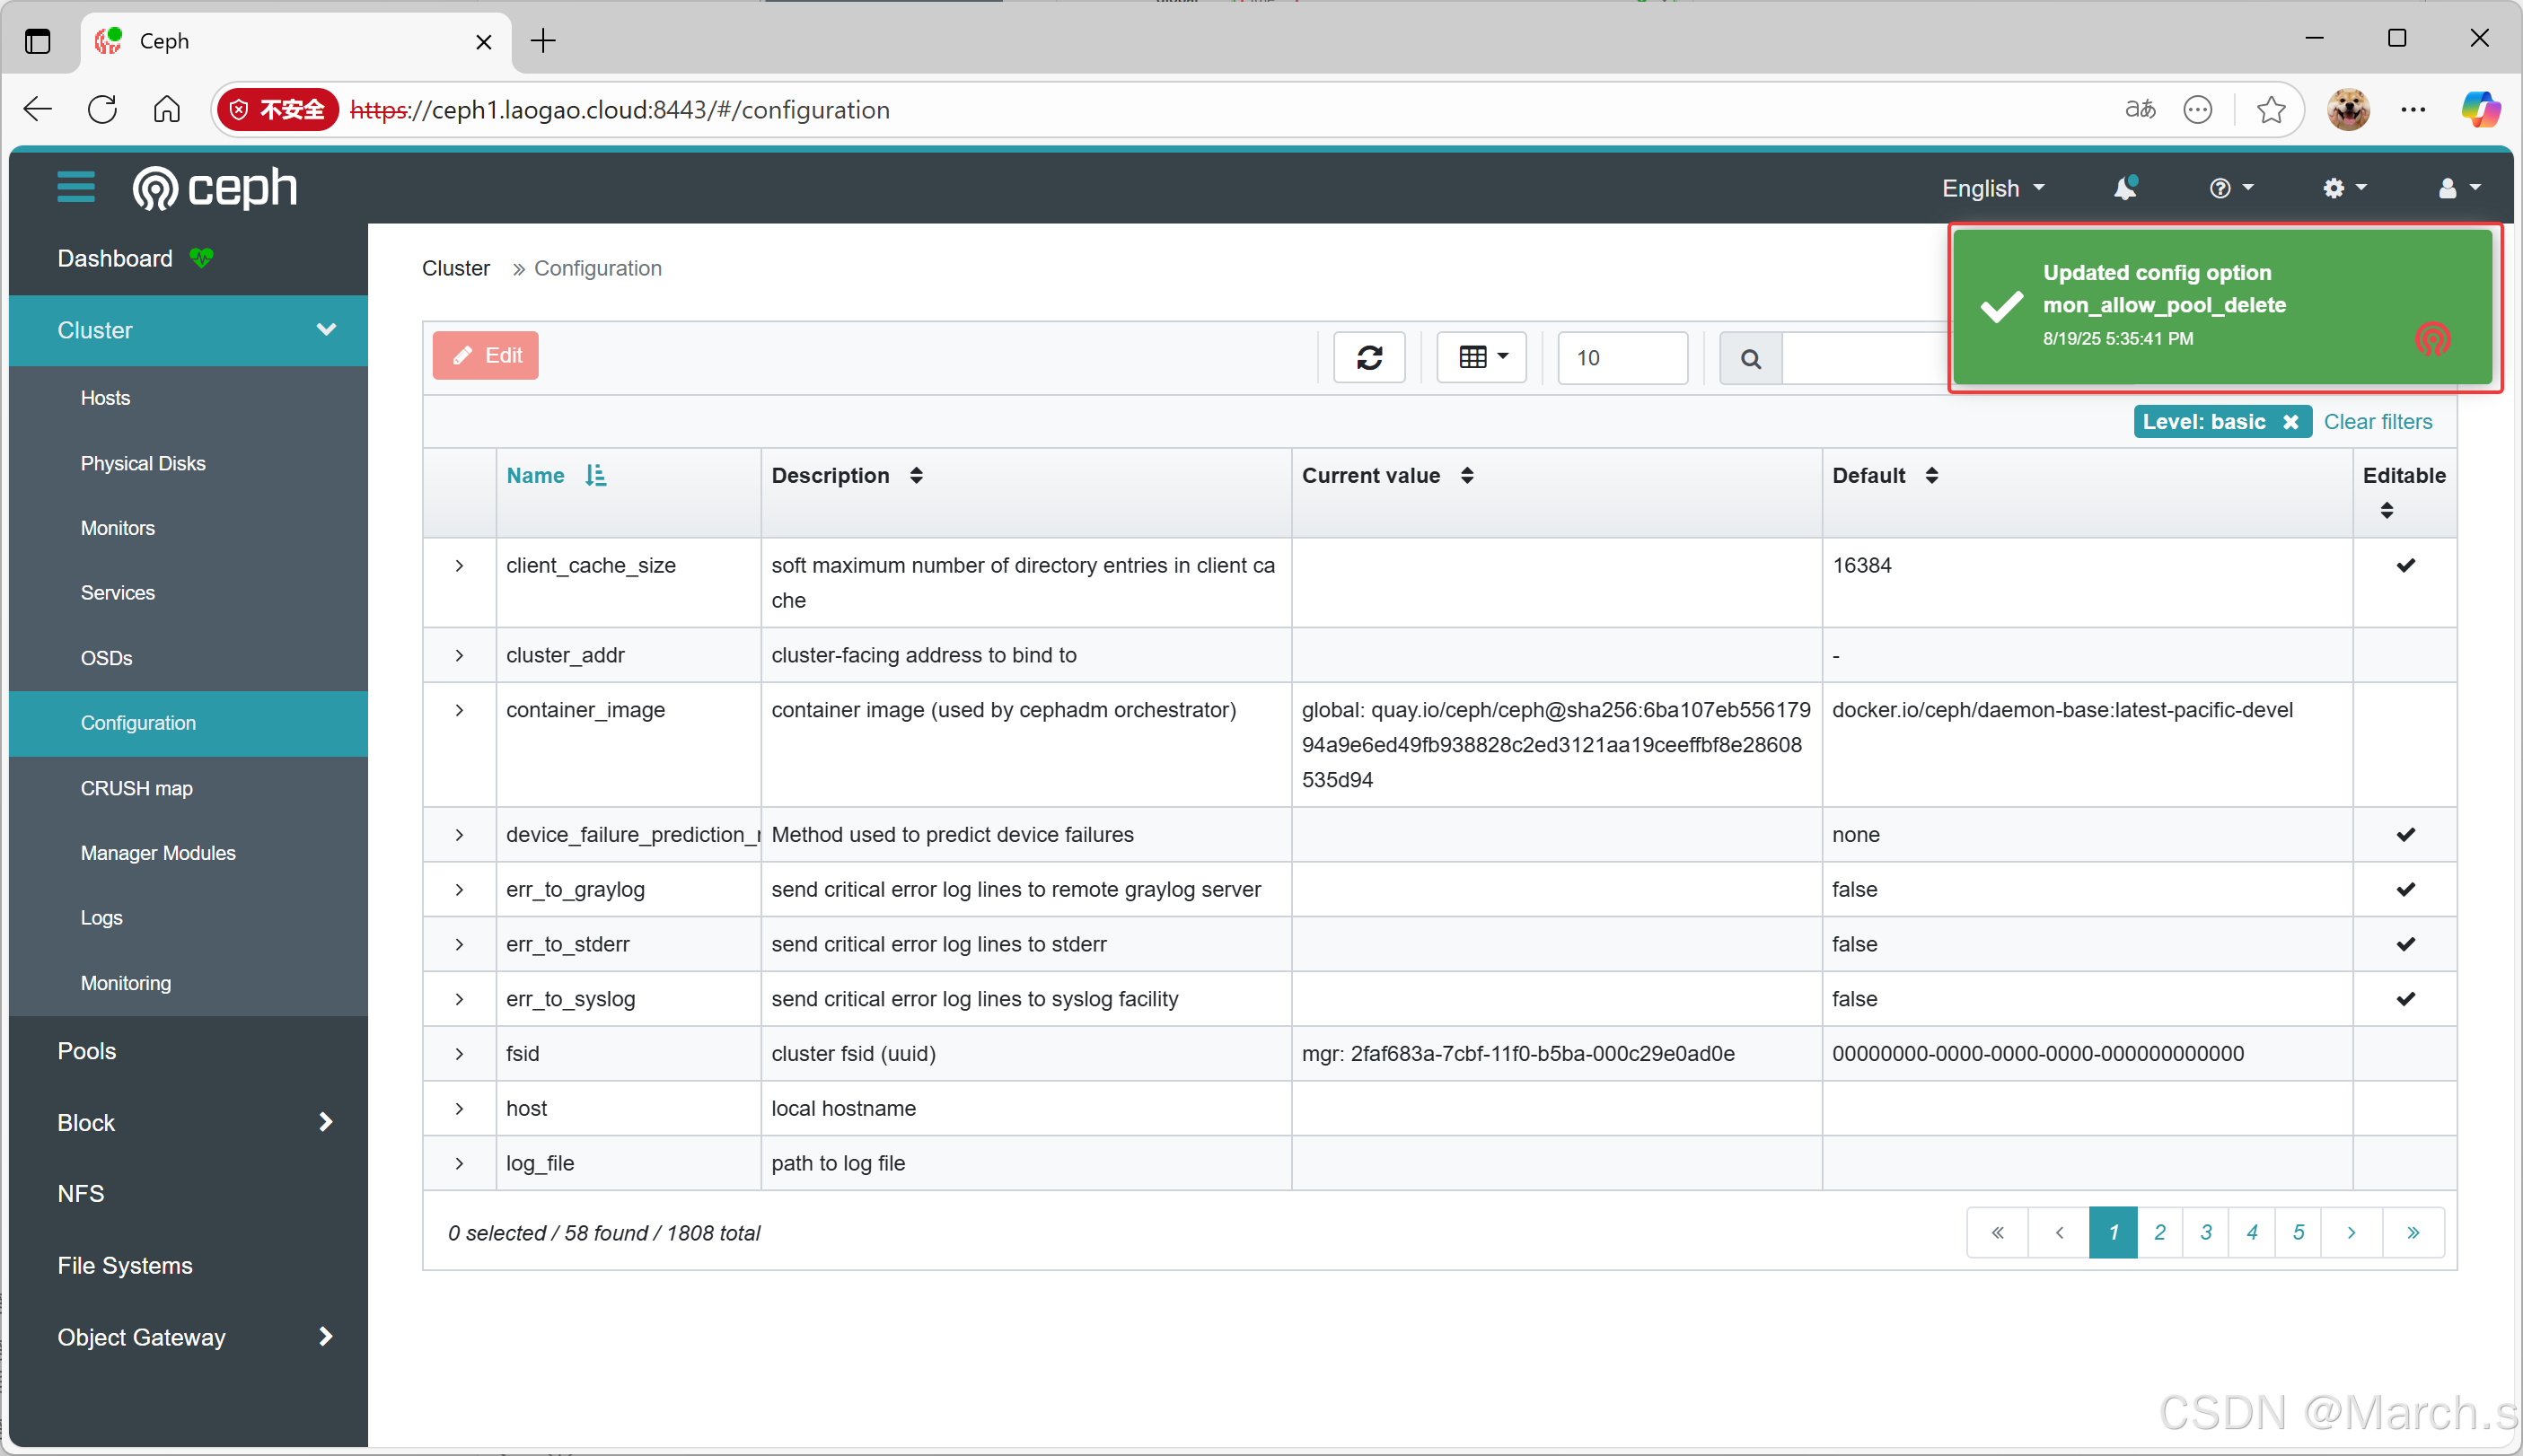
2. 配置集群监控器(Monitor)
配置 Ceph 监控器
Ceph 监控器(MON)存储并维护集群映射,客户端正是靠它找到 MON 与 OSD 节点。客户端必须先连上 MON 取到集群映射,才能向任何 OSD 读写数据——所以正确配置集群 MON 至关重要。
MON 使用一种 Paxos 变体算法选举领导者,在分布式节点集合之间就集群映射达成一致。每个 MON 在任一时刻扮演三种角色之一:
| Leader | 第一个获得集群映射最新版本的 MON |
| Provider | 拥有最新版本集群映射、但不是 Leader 的 MON |
| Requester | 没有最新版本集群映射,必须先与 Provider 同步才能重新加入仲裁的 MON |
一旦有新 MON 加入集群就会触发同步。每个 MON 定期检查相邻监控器是否持有更新版本的集群映射,若有则必须同步并获取相应版本。
集群中的大多数 MON 必须处于运行状态才能建立仲裁。例如部署五个 MON,至少要运行三个才能形成仲裁。生产集群应至少部署三个 MON 节点以保证高可用,Ceph 支持在运行中的集群里添加或删除 MON。
集群配置文件 [mon] 块中的 mon_host 定义 MON 主机的 IP 地址(或 DNS 名称)与端口:
[global]
fsid = 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
mon_host = [v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0]
[v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0]
[v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0]
cephadm 不会主动更新集群配置文件,可以借助 rsync 等第三方工具让配置文件在各集群节点之间保持同步。
重要:在集群部署和运行期间,建议不要更改 MON 节点的 IP 地址。
查看监控器仲裁
用 ceph status 快速确认仲裁成员:
[root@ceph1 ~]# ceph status | grep mon
mon: 3 daemons, quorum ceph1.laogao.cloud,ceph2,ceph3 (age 11m)
用 ceph mon stat 查看更详细的仲裁与选举信息:
[root@ceph1 ceph]# ceph mon stat
e3: 3 mons at {ceph1.laogao.cloud=[v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0],
ceph2=[v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0],
ceph3=[v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0]}
removed_ranks: {}, election epoch 16, leader 0 ceph1.laogao.cloud, quorum 0,1,2 ceph1.laogao.cloud,ceph2,ceph3
用 ceph quorum_status -f json-pretty 得到结构化输出,便于脚本消费:
[root@ceph1 ~]# ceph quorum_status -f json-pretty
{
"election_epoch": 16,
"quorum": [
0, 1, 2
],
"quorum_names": [
"ceph1.laogao.cloud",
"ceph2",
"ceph3"
],
"quorum_leader_name": "ceph1.laogao.cloud",
"quorum_age": 869,
"features": {
"quorum_con": "4540138314316775423",
"quorum_mon": [
"kraken",
"luminous",
"mimic",
"osdmap-prune",
"nautilus",
"octopus",
"pacific",
"elector-pinging"
]
},
"monmap": {
"epoch": 3,
"fsid": "2faf683a-7cbf-11f0-b5ba-000c29e0ad0e",
"modified": "2025-08-19T05:51:46.573105Z",
"created": "2025-08-19T05:41:50.650957Z",
"min_mon_release": 16,
"min_mon_release_name": "pacific",
"election_strategy": 1,
"disallowed_leaders: ": "",
"stretch_mode": false,
"tiebreaker_mon": "",
"removed_ranks: ": "",
"features": {
"persistent": [
"kraken",
"luminous",
"mimic",
"osdmap-prune",
"nautilus",
"octopus",
"pacific",
"elector-pinging"
],
"optional": []
},
"mons": [
{
"rank": 0,
"name": "ceph1.laogao.cloud",
"public_addrs": {
"addrvec": [
{
"type": "v2",
"addr": "192.168.108.11:3300",
"nonce": 0
},
{
"type": "v1",
"addr": "192.168.108.11:6789",
"nonce": 0
}
]
},
"addr": "192.168.108.11:6789/0",
"public_addr": "192.168.108.11:6789/0",
"priority": 0,
"weight": 0,
"crush_location": "{}"
},
{
"rank": 1,
"name": "ceph2",
"public_addrs": {
"addrvec": [
{
"type": "v2",
"addr": "192.168.108.12:3300",
"nonce": 0
},
{
"type": "v1",
"addr": "192.168.108.12:6789",
"nonce": 0
}
]
},
"addr": "192.168.108.12:6789/0",
"public_addr": "192.168.108.12:6789/0",
"priority": 0,
"weight": 0,
"crush_location": "{}"
},
{
"rank": 2,
"name": "ceph3",
"public_addrs": {
"addrvec": [
{
"type": "v2",
"addr": "192.168.108.13:3300",
"nonce": 0
},
{
"type": "v1",
"addr": "192.168.108.13:6789",
"nonce": 0
}
]
},
"addr": "192.168.108.13:6789/0",
"public_addr": "192.168.108.13:6789/0",
"priority": 0,
"weight": 0,
"crush_location": "{}"
}
]
}
}
也可以在控制面板中查看 MON 状态:单击 Cluster > Monitor。 
分析监控器映射
Ceph 集群映射由五类映射构成:
| MON 映射 | 监控器集合与版本 |
| OSD 映射 | 对象存储设备状态 |
| PG 映射 | 归置组分布 |
| MDS 映射 | 元数据服务器状态 |
| CRUSH 映射 | 存储拓扑规则 |
其中 MON 映射包含三类信息:一是集群 fsid(文件系统 ID),一种自动生成的唯一标识符(UUID),用于标识 Ceph 集群;二是各 MON 节点通信所用的名称、IP 地址和网络端口;三是映射版本信息,如 epoch 与最近一次更改时间——MON 节点通过同步更改并就当前版本达成一致来维护映射。
查看当前的 MON 映射
[root@ceph1 ~]# ceph mon dump
epoch 3
fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e # 集群 fsid
last_changed 2025-08-19T05:51:46.573105+0000
created 2025-08-19T05:41:50.650957+0000
min_mon_release 16 (pacific)
election_strategy: 1
0: [v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0] mon.ceph1.laogao.cloud
1: [v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0] mon.ceph2
2: [v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0] mon.ceph3
dumped monmap epoch 3
3. 管理集中配置数据库
MON 节点存储并维护集中配置数据库,数据库文件位于 MON 节点,默认位置是 /var/lib/ceph/$fsid/mon.$host/store.db。
注意:不建议更改数据库的位置。
随着配置变更累积,数据库文件会不断增大,可以采取三项措施:
其一,运行 ceph tell mon.$id compact 整合数据库以提升性能:
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud compact
其二,把 mon_compact_on_start 设为 true,让每次守护进程启动时自动压缩数据库:
[root@ceph1 ~]# ceph config set mon mon_compact_on_start true
其三,设置以下与数据库文件大小相关的阈值,超限时集群健康状态会随之变化:
| mon_data_size_warn | 配置数据库文件大小超过此值时,集群健康变为 HEALTH_WARN | 15 (GB) |
| mon_data_avail_warn | 承载配置数据库的文件系统剩余容量小于等于此百分比时,变为 HEALTH_WARN | 30 (%) |
| mon_data_avail_crit | 承载配置数据库的文件系统剩余容量小于等于此百分比时,变为 HEALTH_ERR | 5 (%) |
4. 集群验证
Ceph 默认使用 Cephx 协议进行加密身份验证,并通过共享密钥完成认证。Cephx 默认处于启用状态;必要时可以禁用,但不建议这样做,因为会削弱集群安全性。
启用或禁用 Cephx 通过 ceph config set 完成,先用 ceph config get 确认当前策略:
[root@ceph1 ~]# ceph config get mon auth_service_required
cephx
[root@ceph1 ~]# ceph config get mon auth_cluster_required
cephx
[root@ceph1 ~]# ceph config get mon auth_client_required
cephx, none
三个参数分别控制不同链路的认证:
| auth_service_required | 客户端与 Ceph services 之间的通信认证 | cephx / none |
| auth_cluster_required | Ceph 集群守护进程之间的通信认证,例如 ceph-mon、ceph-osd、ceph-mds、ceph-mgr | cephx / none |
| auth_client_required | 客户端与 Ceph 集群之间的通信认证 | cephx / none |
官方文档对 auth_client_required 的表述是:If this configuration setting is enabled, then Ceph clients can access Ceph services only if those clients authenticate with the Ceph Storage Cluster. Valid settings are cephx or none.
cephadm 会创建 client.admin 用户,使你能够运行管理命令并创建其他 Ceph 客户端用户账户,用户密钥环存放在 /etc/ceph 目录中:
[root@ceph1 ~]# ls /etc/ceph
ceph.client.admin.keyring ceph.conf ceph.pub rbdmap
各守护进程的数据目录中还包含自己的 Cephx 密钥环文件。对 MON 而言,密钥环文件是 /var/lib/ceph/$fsid/mon.$host/keyring:
[root@ceph1 ~]# ls /var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/mon.ceph1.laogao.cloud/keyring
/var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/mon.ceph1.laogao.cloud/keyring
密钥环文件以纯文本形式存储机密密钥,务必用合适的 Linux 文件权限保护其安全。
5. 使用 ceph auth 管理集群认证
密钥环文件由 ceph-authtool 命令创建。示例:为 MON 节点创建一个密钥环文件。
[root@ceph1 ~]# ceph-authtool –create-keyring /tmp/ceph.mon.keyring –gen-key -n mon. –cap mon 'allow *'
creating /tmp/ceph.mon.keyring
逐段拆解这条命令的含义:
# –create-keyring /tmp/ceph.mon.keyring
# 创建一个新的密钥环文件(Keyring),路径为 /tmp/ceph.mon.keyring
# –gen-key -n mon.
# 生成一个新密钥(–gen-key);-n mon. 指定密钥关联的实体名称(Entity Name),
# 这里是 mon.,表示 Monitor 守护进程
# –cap mon 'allow *'
# 为该密钥分配权限(Capabilities):
# mon 表示权限作用于 Monitor 服务
# 'allow *' 授予所有 Monitor 操作的完全权限(如访问集群状态、修改配置等)
注意:实体名称通常以守护进程类型开头(如 mon.、osd.),后接节点标识符(如 mon.a)。
此外,cephadm 还会在 /etc/ceph 目录中创建 client.admin 用户,让你能够运行管理命令并创建其他 Ceph 客户端用户账户。
总结
Ceph 的价值,不在于它支持多少种协议,而在于它用一套 RADOS 底座把块、文件、对象三种存储统一了起来:CRUSH 算法让客户端无需查询中心元数据就能直接定位数据,MON 以 Paxos 变体维持集群映射仲裁,OSD 承担实际读写与自愈,MGR、Dashboard 与 Prometheus 则把可观测性补齐。本文沿这条主线走完三个阶段——先厘清架构角色与组件职责,再用 cephadm 从零引导集群、扩缩节点、增删 OSD 与主机,最后落到配置优先级、集中配置数据库、Monitor 映射与 Cephx 认证这些日常运维高频操作。值得记住的是:删除类操作优先走编排路径而非手动清理,配置修改优先落库而非运行时覆盖。理解了这些取舍,才真正掌握了 Ceph。