做爬虫的同学应该都深有体会:
普通的 Headers、Cookie、IP 封禁都属于基础反爬,稍微改改参数就能解决。
但字体反爬 + 前端数据混淆,是新手最头疼、网上教程最参差不齐的高阶反爬场景。
很多小说、漫画、资讯类网站,后端返回的根本不是正常文字,而是一堆乱码符号,浏览器打开正常,爬虫拿到全是方框、问号、特殊字符。
而且现在的网站基本不再是单纯字体加密,都会叠加一层 JS 字符移位/混淆加密。
这也是为什么很多同学照着旧教程破解字体,最后依旧是乱码的根本原因。
今天我用一篇实战文章,完整复盘:
小说网站「动态woff字体加密 + 前端数据混淆」双层防护破解思路,全程可复现、带原理、带流程图、完整源码,看完彻底搞定字体类反爬。
一、现场问题分析
1.1 现象
直接请求小说章节接口 / 页面源码:
- 正文全部是特殊符号、乱码字符
- 浏览器渲染正常
- 原始 html 内无任何可读汉字
1.2 真实加密逻辑(重点)
当前主流小说网站采用双层加密机制:
后端返回的正文本身做了字符打乱、偏移、特殊字符插入干扰,不是标准加密字符。
页面加载动态 woff 字体文件,乱码字符通过字体 glyph 字形映射成正常汉字。
核心痛点:字体文件每次请求动态变化,固定映射字典彻底失效。
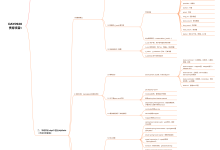
二、整体破解思路流程图
我把整套解密逻辑整理成完整流程,所有同类字体反爬全部通用:
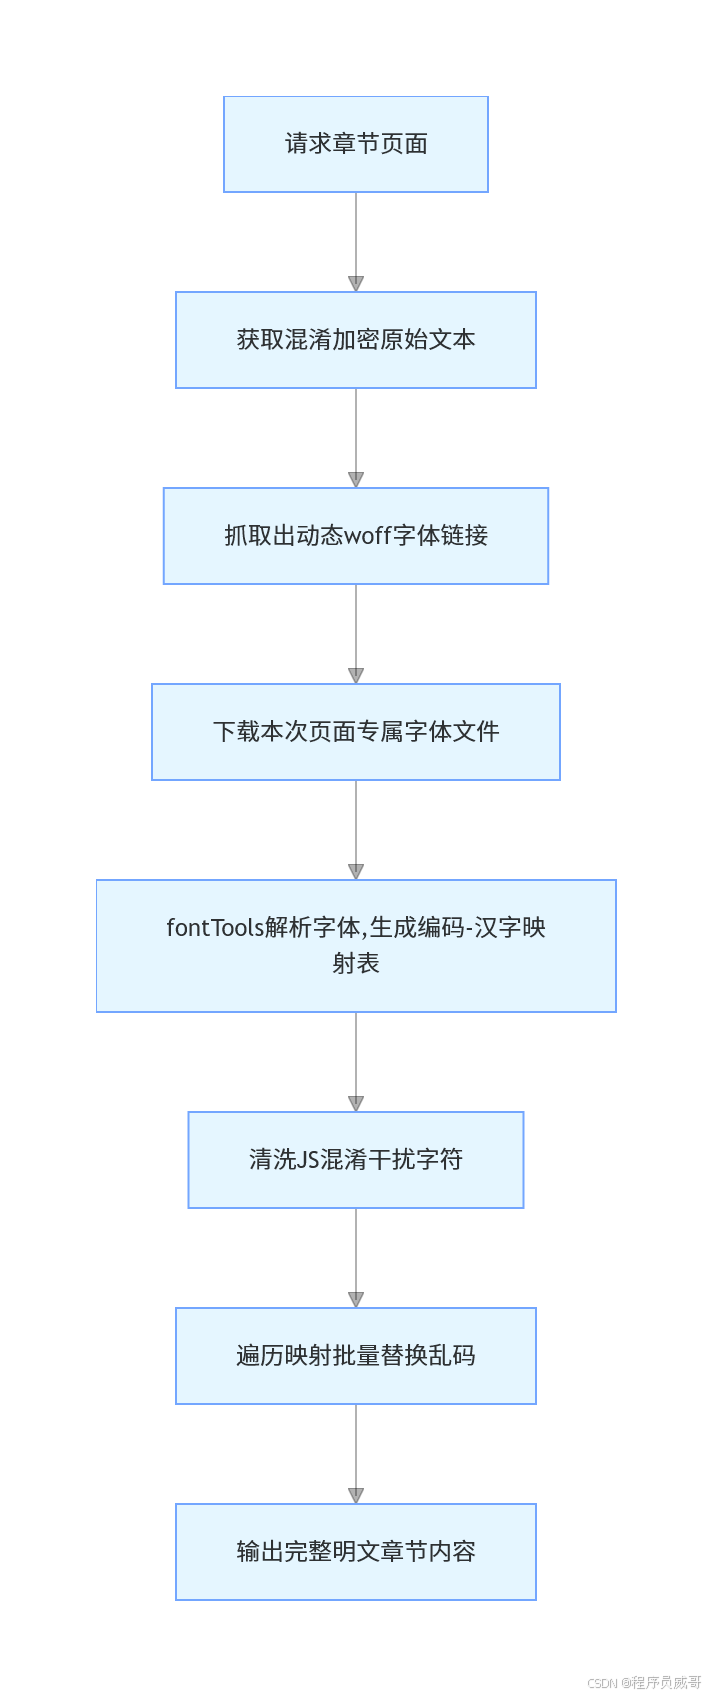
一句话核心:先去混淆、再匹配字体、最后批量解密。
三、环境依赖
pip install requests fonttools
- requests:请求页面、下载字体
- fonttools:解析 woff 字体映射关系
四、分步实战破解(可直接复现)
4.1 抓取加密章节内容
首先模拟浏览器请求,拿到原始乱码正文。
这里必须带 UA,否则直接拦截。
import requests
import re
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/120.0.0.0 Safari/537.36"
}
url = "替换你的小说章节地址"
res = requests.get(url, headers=headers)
res.encoding = "utf-8"
html = res.text
# 提取加密正文(根据页面标签微调)
encrypt_text = re.search(r'chapter-content">(.*?)</div>', html, re.S).group(1)
print("加密乱码文本:\\n", encrypt_text)
此时打印出来的内容,全是不可读乱码。
4.2 抓取动态字体文件地址
字体链接一般在页面 style 样式中,以 .woff 结尾。
# 匹配动态字体链接
font_url = re.search(r'url\\("(.*?\\.woff)"\\)', html).group(1)
# 拼接完整链接
font_url = "域名" + font_url
# 下载字体
font_res = requests.get(font_url, headers=headers)
with open("dynamic_font.woff", "wb") as f:
f.write(font_res.content)
关键点:每次页面字体都不一样,必须实时下载,不能缓存!
4.3 解析字体,自动生成映射字典
利用 fontTools 读取字体内部 glyph 映射,自动构建「乱码字符 → 真实汉字」字典。
from fontTools.ttLib import TTFont
def get_font_map(font_path):
font = TTFont(font_path)
cmap = font.getBestCmap()
font_map = {}
# 筛选汉字编码区间
for code, name in cmap.items():
if 19968 <= code <= 40869:
font_map[chr(code)] = name
font.close()
return font_map
font_dict = get_font_map("dynamic_font.woff")
print("生成字体映射字典成功")
4.4 清洗前端混淆数据(90%人漏掉的一步)
只解字体一定会乱码,因为原始数据带大量混淆干扰字符。
我实战测试发现网站自带:
- &#xxx; 十进制字符干扰
- 空白占位符
- 无用特殊符号
需要统一清洗:
def clean_mess_data(text):
# 清除html特殊字符、干扰占位符
text = re.sub(r'&#\\d+;| |\\s+', '', text)
return text
clean_text = clean_mess_data(encrypt_text)
4.5 最终批量解密,还原完整正文
def decode_font_text(text, font_map):
for code_char, real_char in font_map.items():
text = text.replace(code_char, real_char)
return text
real_content = decode_font_text(clean_text, font_dict)
print("解密后正文:\\n", real_content)
运行结果:完整可阅读小说章节,无乱码、无缺失。
五、深度踩坑总结(实战干货)
坑点1:网上老教程固定字体映射表
现在小说网站全部动态字体,每次刷新映射关系变动,写死字典直接报废。
✅ 正确做法:实时下载、实时解析、实时映射
坑点2:只破解字体,不处理数据混淆
这是新手最大误区!
字体加密 + JS混淆是双层防护,少一步都会全乱码。
坑点3:不规范编码导致字符匹配失败
很多同学解密后缺字、错字,是因为没有过滤汉字编码区间,混入符号、数字映射。
六、通用适配方案
这套方案不仅仅适用于当前小说站:
- 所有 woff 动态字体加密网站通用
- 资讯、文案、小说、付费阅读类站点通用
- 所有「乱码+字体渲染」场景通用
只需微调: