消息从生产者产生,到消费者处理完,中间要经过三段:生产者把消息发到 broker,broker 把消息存下来,消费者取走并处理。可靠性、顺序性、幂等性、一致性这四件事都是围绕这条链路讲的,区别只在于盯的位置不一样。
- 可靠性:消息不可以丢失
- 顺序性:有因果依赖的消息,消费顺序不能倒置
- 幂等性:同一条消息被处理多次,业务结果不变
- 一致性:消息的状态和业务数据的状态对得上
可靠性
消息在哪几段会丢
生产者 → Broker(存储)→ 消费者
三段都有可能丢失消息:
生产者这一段。调用 send() 返回成功,不等于 broker 收到了消息。网络抖动、broker 正在 GC 卡住、连接被中间设备掐断,消息都可能停在半路上。更隐蔽的是超时:broker 其实已经收到了,但客户端的等待时间到了判为失败,重试一次就有两条。所以这一段的不只是"丢",还有"因为重试而重复"。
Broker 这一段。消息收到了,但只写在内存里没落盘,机器一挂就没了。或者是主从架构下 leader 写进本地就给生产者回了 ack,还没同步给 follower 就宕机,follower 升主之后这条消息不存在,而生产者那边已经认为发送成功。
消费者这一段。最常见的是先提交 offset 再处理业务,处理到一半进程被 kill,重启之后 offset 已经往前走了,这条消息永远不会再被消费。还有就是开着 enable.auto.commit=true,业务处理时间超过自动提交间隔,同一批消息处理了一半,offset 就自己提交了。
生产者侧
Kafka 靠 acks 参数控制生产者在什么条件下才认为发送成功:
| acks=0 | 发出去就不管,不等任何确认 | 网络一抖就丢,性能最高 |
| acks=1 | leader 写入本地就算成功 | leader 挂了、follower 还没同步,消息丢 |
| acks=-1(all) | ISR 里所有副本都同步完才算成功 | 基本不丢 |
RabbitMQ 对应的是 confirm 机制,生产者开启 confirm 之后,broker 收到消息会回一个确认,没确认的消息可以重发。另外还有 return 回调,处理"消息到了 broker 但没路由到任何队列"的情况,这种消息默认是直接丢掉的。
Broker 侧
刷盘策略。同步刷盘是写完磁盘再回 ack,一条消息一次 IO,吞吐很低;异步刷盘是写完 page cache 就回 ack,交给操作系统定期落盘,机器掉电会丢掉还在 cache 里的那部分。RocketMQ 提供同步刷盘和异步刷盘两种模式,Kafka 本身是异步刷盘,靠多副本兜底。
多副本。三个参数要一起看:
- replication.factor >= 3:每个分区至少 3 个副本
- min.insync.replicas >= 2:ISR 里至少要剩 2 个副本
- unclean.leader.election.enable = false:禁止落后很多的副本当选 leader
acks=all 的含义是"ISR 里的所有副本都收到了",注意是 ISR 里,不是全部副本。如果 ISR 因为各种原因缩到只剩 leader 一个,acks=all 就退化成了 acks=1。min.insync.replicas 拦的就是这个:ISR 副本数不够时生产者直接收到异常,不允许降级写入。
unclean.leader.election.enable=false 拦的是另一种情况。某个 follower 落后了很多,突然所有能当 leader 的副本都挂了,这时如果允许它升主,它会把缺失的消息当成"本来就没有"补齐给其他副本,丢的数据就永久找不回来了。宁可这个分区暂时不可用,也不能让数据静默丢失
消费者侧
- 关掉自动提交,enable.auto.commit=false,业务处理完再手动提交 offset
- RabbitMQ 关闭 autoAck,channel.basicAck() 放到业务处理成功之后
- 消费失败要有重试和死信队列,不能无限重试把整个队列堵死
可靠性的代价
acks=all 加同步刷盘加 3 副本,意味着每一条消息都要等所有副本落盘才能返回,延迟会明显上去。所以这是一笔权衡账:订单、支付这类核心链路用 acks=all + min.insync.replicas=2,日志、埋点这种丢几条无所谓的用 acks=1 甚至 acks=0。
还有一点,重试是保证不丢的必要手段,但重试一定带来重复,这就是幂等性要解决的问题。
顺序性
什么时候真的需要顺序
不是所有消息都要有序。两条互不相关的日志,谁先谁后都行。真正需要顺序的是有因果依赖的消息:订单创建 → 订单支付 → 订单发货,这三条如果按"支付、创建、发货"的顺序被消费,业务就乱了。
关键在于顺序的粒度:全局有序和局部有序是两件完全不同的事,代价也差着数量级。
消息为什么会乱
四个来源。
生产者重试。这个最容易被忽略。生产者发出 A 和 B 两条消息,A 失败了要重试,B 成功了。重试的 A 后到,broker 里的顺序就成了 B、A。原始顺序在发送阶段就丢了。Kafka 里开了 retries 就必须管这件事,两个做法:把 max.in.flight.requests.per.connection 设为 1,保证同一时间只有一个未确认的请求;或者直接开幂等生产者 enable.idempotence=true,靠 PID + 序列号让 broker 识别并丢弃重复的请求。
多分区。Kafka 的一个 topic 下有多个分区,分区之间是并行的,broker 层面根本没有全局顺序这个概念,只有分区内有序。
消费者并发。同一个消费者组起了多个实例,或者一个实例里开了线程池,谁先处理完谁先提交 offset,处理顺序就散了。
重平衡。消费者组 rebalance 期间,同一个分区的消息可能被不同的消费者接力处理,交接的那一瞬间顺序可能断掉。
怎么办
全局有序:一个 topic 只留一个分区,消费端只起一个线程。代价是吞吐量被单机性能锁死,消息队列的水平扩展能力等于放弃,所以生产环境基本不用,只有配置下发、DDL 变更这种量级极小的场景才考虑。
局部有序:主流做法。把需要保序的那批消息路由到同一个分区,分区内天然有序,不同分区之间互不影响,并行度还在。路由的依据就是业务 key,比如订单 id、用户 id。
| Kafka | 指定消息 key,hash(key) % partitionNum 决定分区 | 一个分区只分配一个消费者线程 |
| RocketMQ | MessageQueueSelector 自己选队列 | MessageListenerOrderly,内部对队列加锁 |
| RabbitMQ | 自定义 exchange 或者路由规则,让同一批消息进同一个队列 | 一个队列只挂一个消费者 |
RocketMQ 的 MessageListenerOrderly 和 MessageListenerConcurrently 别用错,前者会对队列加分布式锁,保证同一时刻只有一个线程在消费它,后者是真并发。
这里有个坑:Kafka 只保证分区内有序,分区数一旦中途增加,hash(key) % partitionNum 的结果就变了,同一个 key 的新消息会落到别的分区去,和新分区里的消息之间没有顺序关系,老消息还在原分区里排着。所以分区数要么一次规划够,要么用自定义分区器把 key 到分区的映射固定下来。
顺序消息的队头阻塞
保序意味着消费失败时不能跳过这条消息。跳过就乱序了,所以只能阻塞重试,后面的消息全部等着,这就是队头阻塞。
所以顺序消息的处理逻辑要额外保证"它不会一直失败":设置最大重试次数,超过就丢进死信队列并告警,让人工介入,而不是让它把队列永久卡住。
幂等性
为什么必然有重复
前面可靠性那一节,为了不丢消息,生产者要重试,消费者要处理完再提交 offset。这些机制组合下来的结果就是:消息至少会被投递一次。
三种投递语义:
| at-most-once | 最多一次 | 发出去不管,收到就 ack | 可能丢,不会重复 |
| at-least-once | 至少一次 | 发送要 ack,消费完再提交 offset | 不会丢,可能重复 |
| exactly-once | 恰好一次 | 需要端到端的分布式事务 | 实际做不到 |
Kafka 宣传的 exactly-once 指的是 Kafka 内部从 topic 到 topic 的流转,靠幂等生产者加事务实现。端到端(包含业务系统那一侧)的 exactly-once 是做不到的,原因很直接:消息系统没法知道消费者那边业务处理成没成。offset 提交和业务事务不在同一个事务里,两者之间总有时间差,这中间任何一刻挂掉,要么是"业务处理了但 offset 没提交"(重复),要么是"offset 提交了但业务没处理"(丢失)。
所以工程上的做法是:在 at-least-once 的基础上让消费端做到幂等,整体效果等价于 exactly-once。
常见手段
| 唯一索引 | 用业务唯一键或消息 id 建唯一索引,重复插入直接报错 | 插入类业务,最可靠 |
| 去重表 | 单独一张表记录处理过的消息 id | 通用,多一次写 |
| Redis | SETNX msgId 1 EX 24h | 性能好,但依赖 Redis 可用性 |
| 状态机 | UPDATE … SET status='paid' WHERE status='unpaid' | 状态流转类业务 |
| 乐观锁 | UPDATE … SET x=? WHERE version=? | 更新类业务 |
一个具体的例子
微信支付的回调可能会重复通知,业务要做的就是更新订单状态、给用户加余额,这两件事得在同一个本地事务里。
UPDATE orders SET status = 'paid' WHERE order_no = ? AND status = 'unpaid';
这一条 UPDATE 自带幂等性。第一次执行影响 1 行,第二次因为 status 已经是 paid 了,影响 0 行。代码里判断受影响行数是 0 就直接返回,后面的加余额逻辑不会重复跑。
这一招的好处是不需要额外的去重表和 Redis,靠数据库的行锁顺便把并发问题也解决了:两个线程同时执行,只有一个能拿到行锁并把状态改掉,另一个等了锁之后发现 status 条件不成立,影响 0 行。
并发重复的情况
上面那个乐观更新能兜住并发,但如果业务逻辑复杂到没法用一条 SQL 表达(比如中间要调外部接口),就得靠唯一索引去挡:
INSERT INTO msg_dedupe (msg_id) VALUES (?);
插入成功才继续处理,插入失败说明别的线程正在处理或者已经处理过了,直接返回。
这里必须是唯一索引,不能是"先 SELECT 查一下,没有就 INSERT"。两个线程同时查到没有,然后都执行插入,重复照样发生。查和插之间的空隙,只有数据库的唯一约束能锁住。
幂等和可靠性的边界
首先要明确:去重记录必须和业务处理在同一个事务里。
如果去重表先写、业务处理失败、事务回滚,那没问题。但如果去重记录提交了、业务处理却失败了,重试的时候会被去重记录挡住,这条消息就永久丢了,可靠性反而被幂等性破坏掉了。
用 Redis 做去重尤其要注意这一点,SETNX 是独立于业务事务的。要么把去重和业务放进同一个本地事务,要么就得接受"去重标记写入成功但业务没处理"这个窗口,再用补偿任务去捞。
一致性(副本一致性)
先把这个词的范围划清楚
"一致性"这个词被用得太宽,在消息队列的语境里,说数据一致性一般就是指副本一致性,也就是同一个分区(队列)的多个副本之间存的数据是不是一样的。
副本一致性和前面可靠性那一节是同一件事的两面:可靠性的目标是消息别丢,而副本之间数据一致才是"不丢"的依据。区别在于前面写的是使用者的角度,怎么配参数;这里写的是副本之间到底怎么同步、怎么算一致。
问题出在哪
多个副本存同一份数据,各自的写入进度不一定一样。leader 挂了要从 follower 里选一个新的上来,选谁就成了问题:
- 选了一个进度落后的副本,它没有的那些消息就永久丢了
- 新旧 leader 各自被写过,两边数据不一样,消费者读到的结果取决于读了哪一边
所以副本一致性要解决的是两件事:写入的时候副本怎么同步跟上,以及 leader 挂掉之后怎么保证新选上来的那个数据是全的。
方案一:多副本 + 同步复制
最简单的思路是让写操作不只落在 leader 上。我们只针对单主复制来讲,其实同步和异步的区别就一句话: 同步复制:主库要等从库确认,才告诉客户端“写成功”;异步复制:主库自己写完就可以先告诉客户端成功,从库慢慢追。
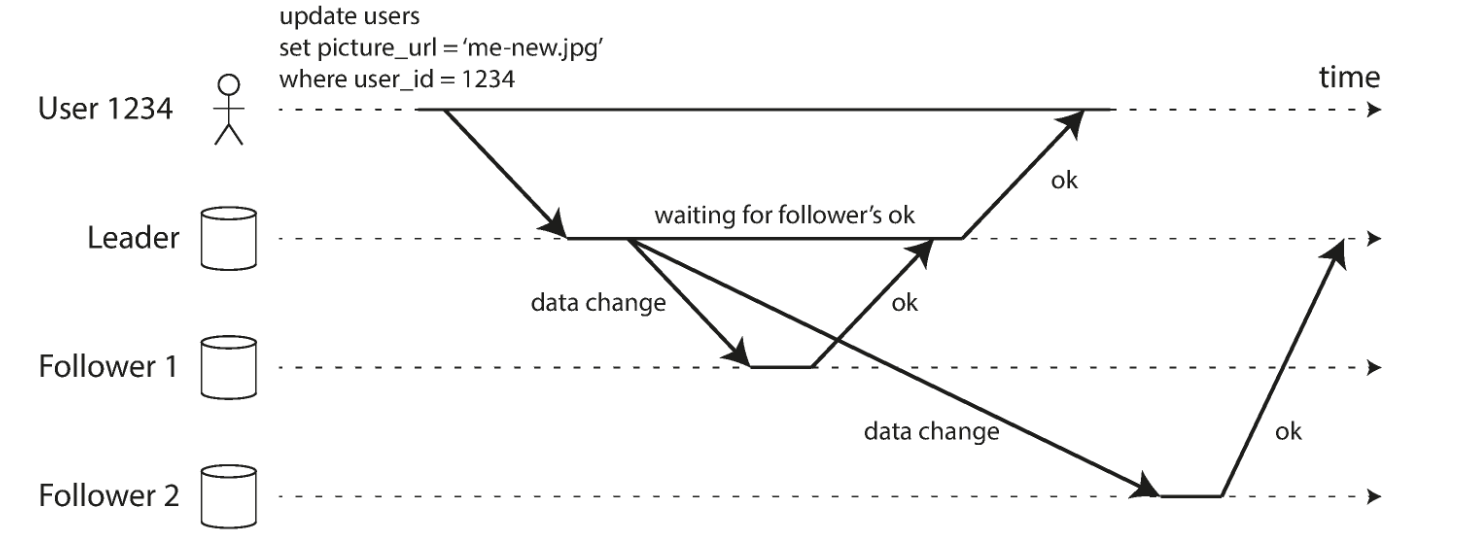
上图很简单就解释清楚了整个过程。随之衍生的问题也很明显:
- 如果全部采用同步复制,从库挂了怎么办?
- 如果全部采用异步复制,效率是上来了,但是异步过程中数据丢了怎么办?
所以说我们进行折中的方案:
实践中,数据库所谓的同步复制,通常是指 一个 追随者同步,其余追随者异步。如果同步追随者不可用或过慢,就把某个异步追随者切换为同步。这样可以保证至少有两个节点持有最新数据:领导者和一个同步追随者。这种配置有时也称为 半同步(semi-synchronous)
RocketMQ 里对应 SYNC_MASTER 和 ASYNC_MASTER,再和刷盘策略叠加,一共四种组合,写得最重的那个组合是 SYNC_MASTER + 同步刷盘。
半同步解决了"数据只在一个节点上"的问题,但留了个新口子:那个"同步的 follower"如果是卡住而不是挂掉,leader 会一直等它,整个分区的写入都被它拖着。
方案二:ISR,只等跟得上的副本
Kafka 的做法是把"全部副本"缩小成"跟得上的副本"。
每个分区有一个 leader 和若干 follower,follower 的工作就是不断向 leader 发 fetch 请求拉数据。ISR( In-Sync Replicas ) 就是当前跟得上 leader 的那批副本,判断标准是 replica.lag.time.max.ms,默认 30 秒,超过这个时间没追上的就被踢出 ISR,追上了再加回来。acks=all 要等的是 ISR 里的副本,不是全部副本,所以一个卡住的副本不会拖住写入,等它追上来自然又回到 ISR 里。
要注意这个参数是按时间算的,不是按落后的消息条数。早期版本确实有一个按条数的 replica.lag.max.messages,后来被去掉了,因为同一个条数阈值在小流量下太宽松、在大流量下又太苛刻。按时间算的好处是把"慢"和"死"在语义上分开了:慢的先踢出去保证写入不被拖住,死了的反正也回不来。
方案三:参数兜底,防止悄悄退化
ISR 是会缩水的,缩水之后 acks=all 就名不副实了:如果 ISR 缩到只剩 leader 一个,acks=all 实际上等于 acks=1,此时 leader 一挂消息就丢。
所以要有两个参数兜底:
- min.insync.replicas:规定 ISR 里至少要剩几个副本,少于这个数,生产者直接收到异常,不允许降级写入
- unclean.leader.election.enable = false:禁止落后很多的副本当选 leader
第二个参数拦的是这种情况:某个 follower 落后了很多,突然所有能当 leader 的副本都挂了,这时候如果允许它升主,它会把缺失的消息当成"本来就没有"补齐给其他副本,丢的数据就永久找不回来了。宁可这个分区暂时不可用,也不能让数据静默丢失。
方案四:Raft,真正的强一致
前面三个方案本质上都是"主从复制 + 参数调优",一致性靠的是主节点别挂、参数别配错。RocketMQ 4.5 之前的架构就是这样,主从是静态配置的,主节点挂了从节点不能自动升主,要么人工介入,要么靠外部组件。
4.5 引入了 DLedger,用 Raft 来做选主和日志复制:写入要多数派确认才算提交,leader 挂了剩下的节点自己投票选出新主,选出来的那个一定持有最新的数据。Kafka 后来的 KRaft 模式也是同一个思路,把原来依赖 ZooKeeper 的选主换成了 Raft。
代价很直接:每次写入都要等多数派确认,延迟和吞吐都要打折。所以消息队列的主流选择仍然是半同步复制,用"极端情况下可能丢一点数据"换吞吐和可用性。