引言:大模型竞争进入“深水区”
2026年,国内AI大模型领域的竞争已从“参数竞赛”全面转向“效率竞赛”与“场景落地”的深水区。百度的文心5.1以业界6%的预训练成本实现同级别效果领先;阿里巴巴的Qwen 3.8-Max以2.4万亿参数刷新了国产模型的规模上限;腾讯混元Hy4 preview的发布让开源模型首次稳居第一梯队;而月之暗面Kimi K3以2.8万亿参数成为全球最大的开源模型。
本文将系统梳理2026年国内主流AI大模型厂商及其核心模型,涵盖互联网巨头、AI独角兽与垂直领域专精者三大阵营,为读者呈现一幅完整的产业图谱。
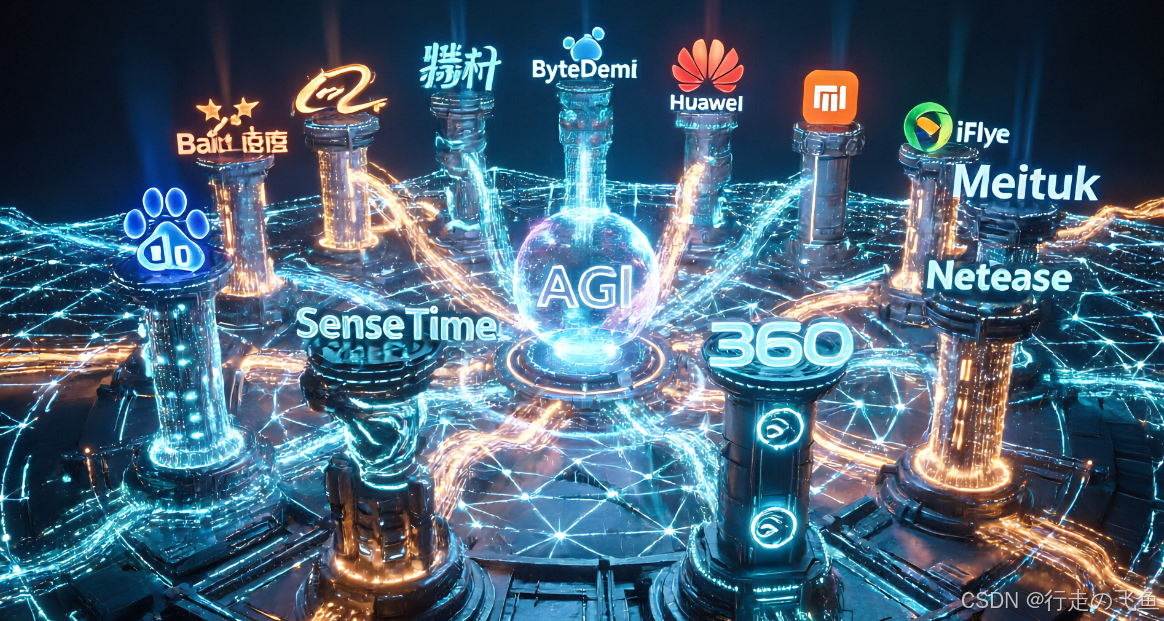
一、互联网与科技巨头:全栈布局,生态为王
1. 百度:文心大模型5.1——“效价比”标杆
2026年5月9日,百度正式发布新一代旗舰大模型文心5.1。不同于行业普遍的“堆参数”路线,文心5.1走的是“极致效率”之路。
核心技术突破:文心5.1基于文心5.0训练,创新性地提出“多维弹性预训练技术”(Once-for-All弹性训练框架)。传统方法需为不同规模模型分别进行预训练,而文心5.0仅在单次预训练中即可通过动态采样机制,同时优化大量参数各异的子模型。模型在三个维度上实现弹性压缩:弹性深度(随机跳过部分Transformer层)、弹性宽度(弹性调控MoE层专家池规模)、弹性稀疏度(通过可变Top‑k路由机制灵活调整激活专家数量)。
关键数据:文心5.1将模型总参数压缩至文心5.0的约1/3,激活参数压缩至约1/2,预训练算力成本仅为业界同规模模型的6%。在LM Arena搜索榜中,文心5.1以1223分斩获全球第四、国内第一。在智能体能力方面,文心5.1在τ³-bench与SpreadsheetBench-Verified Agent评测中超越DeepSeek-V4-Pro;在数学竞赛评测AIME26中得分99.6,仅次于Gemini 3.1 Pro。
2. 阿里巴巴:通义千问Qwen 3.8-Max——2.4万亿参数的“全能旗舰”
2026年8月3日,阿里巴巴正式发布Qwen 3.8-Max,这是千问系列迄今为止最强大的模型。
架构创新:基于Qwen 3.5架构迭代升级,采用第三代稀疏MoE(混合专家)架构,总参数量达2.4万亿,但推理时仅激活950亿参数。这种“轻量架构、旗舰性能”的设计,在保持超大模型能力上限的同时大幅降低了算力消耗与推理成本。模型支持100万Token的超长上下文窗口,最大输出长度可达131072 Tokens。
能力亮点:Qwen 3.8-Max在Text Arena排名第五,Vision Arena排名第二。在编程方面,Frontend Code Arena排名第四。内部测试中,该模型自主完成了一个为期16天的真实软件工程项目开发,从零开始建立自进化智能体框架,形成了工程闭环。在多模态能力上,它能无缝处理过百页文件、整部电视剧集或长达100小时的直播内容。
3. 腾讯:混元Hy4 preview——开源模型第一梯队的“生产力担当”
2026年8月28日,腾讯混元发布并开源新一代大语言模型Hy4 preview。
核心参数:总参数770B(7700亿),激活参数49B,上下文长度突破1M(100万Token)。相比前一代Hy3的295B,总参数实现了大幅提升。
场景化能力:Hy4 preview定位“为生产力而生”。在软件工程场景下,增强了长程开发任务的理解、规划、调试与验证能力;在办公分析场景下,显著提升了复杂办公环境理解和金融分析能力;在游戏开发场景中,增强了一句话生成可玩原型的能力;在科学研究场景下,在AI研发、分子动力学模拟、凝聚态物理等领域均有长足进步。
自我进化:Hy4 preview首次参与自身训练方法、数据策略、评估体系和底层算子的自动优化,形成初步的递归自我改进闭环。通过自主分析推理系统瓶颈,端到端吞吐量相较基线提升31.8%。定价方面,输入6元/百万tokens,输出18元/百万tokens,缓存命中最低0.3元。
4. 字节跳动:豆包Seed 2.1系列——面向Agent时代的“数字员工”
2026年6月23日,字节跳动正式发布Seed2.1系列模型。
系列构成:包括Doubao-Seed-2.1-Pro和Doubao-Seed-2.1-Turbo两个版本,API服务已全量上线火山引擎。
三大核心能力:Seed2.1从三个维度进行了升级——更可靠的通用Agent能力(进一步强化跨工具、跨环境的任务交付能力);更稳定的代码工程交付能力(可在真实企业级开发任务中完成需求理解、功能实现、bug修复、运行环境搭建和结果验证);更强劲的多模态等基础能力(对复杂视觉信息和视频内容处理更准确)。
评测表现:Seed2.1 Pro在GDPval基准上获得最高分,在Agents’ Last Exam(ALE)基准评测中处于参评模型的第一梯队。模型已在豆包产品和TRAE上线。
5. 华为:盘古openPangu 2.0——与昇腾算力深度绑定的开源模型
2026年6月,华为在开发者大会上正式发布开源盘古openPangu 2.0。
版本与参数:包括Pro和Flash两个版本。2.0 Pro总参数量505B(5050亿),激活参数量18B;2.0 Flash总参数量92B(920亿),激活参数量6B。模型支持512K超长上下文,训练数据总量约34T tokens。采用稀疏MoE架构——5050亿参数但每次推理只激活约180亿参数。
生态优势:openPangu 2.0基于昇腾NPU训练,单卡吞吐率可达其他业界主流开源模型的2倍,更适配鸿蒙生态。华为计划从6月30日起陆续开源7大组件。
6. 小米:MiMo系列——万亿参数的“智能体”先锋
小米在AI领域的投入可谓大手笔——未来三年投入超600亿元。其MiMo系列已成为行业不可忽视的力量。
旗舰型号:MiMo-V2.5-Pro采用SWA(Sliding Window Attention)架构,支持1M上下文窗口,采用万亿参数MoE架构,总参数1.02T(1.02万亿),激活42B。该模型在Artificial Analysis全球大模型综合智能排行榜中位列全球第八、国内第二。
推理速度:基于SWA架构叠加FP4 Experts、DFlash解码等全链路优化,UltraSpeed模式在通用GPU上的推理速度达到1000 tokens/s。2026年4月28日,小米MiMo-V2.5系列模型以MIT License协议全球开源。
7. 美团:LongCat(龙猫)——全国产算力的万亿参数模型
美团LongCat 2.0总参数达1.6万亿,是业内首个在全国产算力集群上完成训练与推理全流程的万亿参数模型。在代码编写及Agent调用场景中表现突出,主要用于服务美团的本地生活主营业务。
8. 科大讯飞:星火X2.5系列——端侧AI的先行者
科大讯飞主打端侧模型(如4B、1.7B版本),是端侧模型首个原生支持100万Token的厂商。基于全国产算力平台训练,应用于个人办公、代码开发、智能硬件、机器人等本地化场景。
9. 360:360智脑与安全大模型——通用+垂直双轮驱动
360自研千亿参数通用大模型360智脑,具备多模态理解、逻辑推理、代码生成等能力。同时推出专注于威胁检测、漏洞挖掘等垂直场景的360安全大模型,实现通用AI能力与安全业务的深度协同。
10. 商汤科技:日日新SenseNova系列——交付级原生多模态智能体
2026年5月8日,商汤推出日日新SenseNova 6.7 Flash-Lite轻量化多模态智能体模型。采用原生多模态架构,Token消耗下降60%。7月,商汤在WAIC 2026发布了日日新SenseNova U1 Pro,这款面向长程任务的交付级原生多模态智能体基座模型,将理解、生成和行动纳入统一的能力框架。
11. 网易:子曰大模型4.0——深耕教育场景
网易子曰大模型4.0是面向教育场景的多模态模型(27B参数),推出LobsterAI等Agent应用矩阵,支持14种语言的语音合成,应用于智能办公、学习、跨语言沟通、AI硬件等场景。
二、AI大模型“独角兽”:技术创新引领者
1. 深度求索(DeepSeek):DeepSeek-V4系列——开源黑马的效率革命
DeepSeek V4于2026年4月发布,是DeepSeek系列中改动最大的一版。
参数规模:V4-Pro总参数1.6万亿(激活49B),V4-Flash总参数284B(激活13B),两者均原生支持100万Token超长上下文。1M场景下,V4-Pro的单token FLOPs只有V3.2的27%,KV cache只有10%。
架构创新:引入mHC(流形约束超连接)强化残差连接;设计hybrid attention架构(CSA和HCA交替叠加)解决长文效率问题;采用Muon作为主优化器。值得一提的是,DeepSeek V4已支持华为算力适配。
2. 智谱AI:GLM-5系列——从“写代码”到“写工程”
2026年2月,智谱AI发布并开源新一代旗舰大模型GLM-5。
参数升级:参数量从355B(激活32B)扩展至744B(激活40B),预训练数据从23T提升至28.5T。采用异步强化学习和稀疏注意力机制(DSA)来提升Agent能力。
能力跃升:GLM-5实现了从“写代码”到“写工程”的能力演进,在Coding与Agent能力上取得开源SOTA表现。在多项国际评测中位列全球第四、开源第一,编程体感已逼近顶尖闭源模型Claude。
3. 月之暗面(Moonshot AI):Kimi K3——全球最大的开源模型
2026年7月17日,月之暗面发布Kimi K3大模型。
规模之最:总参数规模达到2.8万亿,是目前全球参数最大的开源AI模型。原生支持视觉理解,拥有100万词元超长上下文窗口。
性能表现:Kimi K3一举拿下Frontend Code Arena编程榜单榜首,实现开源模型首次超越头部闭源模型登顶。依托自研KDA混合线性注意力、注意力残差等底层架构创新,在编程、智能体、长文本推理等场景性能跻身全球第一梯队。
4. MiniMax:MiniMax M3——三项全能的开源旗舰
2026年6月1日,MiniMax正式发布新一代旗舰大模型MiniMax M3。
核心能力:M3是国内首个同时具备“前沿Coding能力、1M超长上下文、原生多模态”三项核心能力的大模型,也是目前全球唯一具备完整能力组合的开源选项。总参数428B MoE架构,采用自研稀疏注意力架构MiniMax Sparse Attention(MSA)。
开源与可用性:M3于2026年6月12日开源,API最高支持1M tokens上下文窗口。
5. 阶跃星辰(StepFun):Step系列——从模型到操作系统的全栈生态
阶跃星辰发布了全球首个大模型原生AI终端品牌STEPX和智能体原生操作系统Step AOS。
模型矩阵:Step 3.7 Flash采用稀疏MoE架构,总参数196B+1.8B(ViT)、激活参数11B,最高生成速度可达400Tokens/s。Step Edge端侧基础大模型在29项权威基准评测中位列同类端侧模型第一。
6. 面壁智能(ModelBest):MiniCPM系列——端侧AI的“密度之王”
面壁智能专注于端侧AI,是小参数、高性能的“高密度”模型代表。
最新成果:2026年7月发布MiniCPM5-2B端侧文本大模型,仅20亿参数,却在综合知识、数学推理、代码、指令遵循和智能体能力上均做到同尺寸领先。同时发布首个具身智能系列MiniCPM-Robot。截至2026年6月30日,MiniCPM开源模型系列累计下载量突破3800万次。
7. 百川智能(Baichuan AI):Baichuan-M4——医疗领域的垂直冠军
百川智能深耕医疗垂直领域。Baichuan-M4由百川智能与清华大学研究团队联合打造。
医疗能力:在HealthBench及其Hard、Professional三个榜单上同时位列世界第一,全面超越GPT-5.5、Claude Opus 4.7、DeepSeek-V4-Pro。幻觉率低至3.3%。引入“证据锚定”技术,医学结论能精确对应权威医学论文或临床指南的具体段落,循证引用精度高达90.0。
8. 零一万物(01.AI):Yi-Lightning系列——国际化视野的效率模型
由李开复博士创立的零一万物,其Yi-Lightning在Chatbot Arena上保持全球总排名第六的成绩,Arena得分1287分,与GPT-4o-0513持平。定价仅$0.14/百万tokens,主打高性价比。提供Yi-Lightning、Yi-Lightning-Lite、Yi-Large、Yi-Vision等多款模型API。
三、五大行业趋势总结
纵观2026年国内大模型的发展,以下五大趋势清晰可见:
趋势一:从“参数堆砌”到“效率优先” 。百度文心5.1以6%成本实现领先效果、DeepSeek V4将KV cache压缩至10%——各大厂商不再盲目追求参数规模,而是更加注重单位算力的产出效率。
趋势二:MoE架构成为主流选择。无论是阿里的Qwen 3.8-Max、腾讯的Hy4 preview、华为的openPangu,还是DeepSeek V4、小米MiMo,几乎全部头部模型都采用了MoE架构,实现了“大容量、低激活”的高效推理。
趋势三:百万Token上下文成为标配。从Qwen 3.8-Max的100万、Hy4 preview的100万、DeepSeek V4的100万、MiMo的100万到Kimi K3的100万——超长上下文已成为头部模型的标配能力。
趋势四:Agent能力成为核心竞争力。字节Seed2.1专为Agent与Coding时代打造、小米MiMo聚焦复杂智能体任务、智谱GLM-5强调“从写代码到写工程”——模型正在从“聊天工具”进化为“行动主体”。
趋势五:开源生态与国产算力加速融合。腾讯Hy4 preview、DeepSeek V4、智谱GLM-5、小米MiMo纷纷开源;华为openPangu基于昇腾NPU训练、美团LongCat在全国产算力集群完成训练——开源与算力自主正成为中国大模型产业的双轮驱动。
总结
2026年的中国大模型产业,已从“百花齐放”的初级阶段迈向“精耕细作”的成熟阶段。从互联网巨头的全栈生态到独角兽公司的技术创新,从万亿参数的规模突破到百万上下文的标配普及,从单纯的文本对话到多模态智能体的全面进化——每一个维度都在快速迭代。
对于开发者而言,选择模型的维度已不再单一:是需要极致性价比(百度文心5.1、DeepSeek V4-Flash),还是追求编程能力天花板(阿里Qwen 3.8-Max、月之暗面Kimi K3);是需要超长上下文处理(腾讯Hy4 preview、小米MiMo),还是聚焦端侧轻量化部署(科大讯飞星火、面壁MiniCPM)——答案取决于具体的应用场景。
可以预见,随着算力成本的持续下降和模型效率的不断提升,AI大模型将真正从“奢侈品”变为“基础设施”,赋能千行百业的智能化转型。