TABLESPACE 表空间:PostgreSQL 索引与表分离存储的性能优化
-
- 一、前言
- 二、核心开发规范
- 三、底层原理通俗讲解
- 四、实战错误案例&优化方案
-
- 场景1:创建表空间并让索引独立存放(正确姿势)
- 场景2:经典优化——表在默认空间,索引单独放 SSD
- 场景3:已有索引迁移到新表空间
- 场景4:备份恢复踩坑——目标库没有该表空间
- 五、绝对禁止的写法汇总
- 六、最终评审口诀(记住不踩坑)
- 七、总结
- 参考来源
标签:#PostgreSQL #索引 #表空间 #性能优化
一、前言
给大表加索引时,你有没有在 DDL 里见过这样的写法?
CREATE INDEX idx_orders_user_id ON orders (user_id) TABLESPACE ts_index_ssd;
TABLESPACE 子句可以把索引存到单独的表空间,与表数据分离。这是 PostgreSQL 官方文档明确认可的性能优化手段:高频索引放 SSD、冷数据表放 HDD。但它不是无脑"分开就更快"——前提是物理介质有差异,而且表空间的备份恢复是个隐藏的坑。
二、核心开发规范
三、底层原理通俗讲解
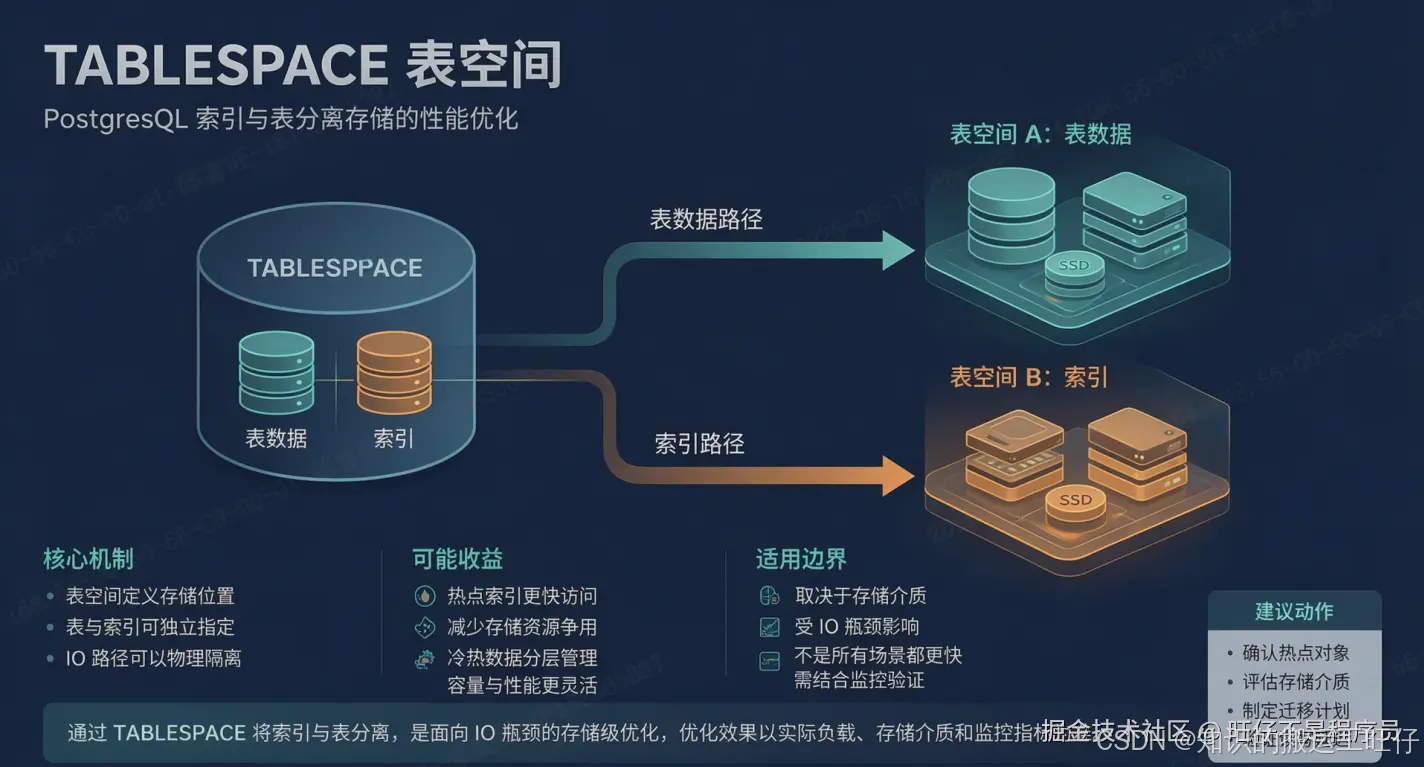
- 表空间是什么:一个"逻辑标签 → 文件系统目录"的映射。CREATE TABLESPACE ts_name LOCATION '/路径' 之后,放到该表空间的对象,数据文件就物理落在那个目录下(实现上是符号链接,不是 Oracle 那种容器);
- 官方文档的典型用途:把一个高频使用的索引放到非常快、高可用的磁盘(如昂贵的固态设备 SSD)上;同时把很少访问、不追求性能的归档数据表放到更便宜、更慢的磁盘上;
- 索引与表分离的意义:B-tree 索引的随机读非常频繁,放在独立快速盘上 = IO 路径隔离,避免和数据页的读写互相挤占带宽;同时不同表空间可以独立规划备份、迁移和容量;
- 表空间级成本参数(加分项):CREATE TABLESPACE 支持设置 random_page_cost / seq_page_cost / effective_io_concurrency 等参数,覆盖优化器对该表空间读写成本的估计——SSD 表空间配更低的 random_page_cost,优化器会更愿意走上面的索引;
- 警告(官方原文):表空间是数据库集群的不可分割部分,不能单独备份、不能附加到其他集群;一旦表空间丢失(磁盘故障、文件被删),整个集群可能无法读取或无法启动——千万别把表空间放到临时或易失设备上。
四、实战错误案例&优化方案
场景1:创建表空间并让索引独立存放(正确姿势)
❌ 错误写法(目录不存在就建表空间,或全部对象挤在默认表空间)
CREATE TABLESPACE ts_index_ssd LOCATION '/ssd1/pg_index';
— ERROR: directory "/ssd1/pg_index" does not exist
— (LOCATION 目录必须预先存在,且属主是运行 PostgreSQL 的系统用户)
✅ 正确写法(先建目录 → 建表空间 → 建索引时指定)
# 1. 在系统层面创建目录(属主设为 postgres)
mkdir -p /ssd1/pg_index && chown postgres:postgres /ssd1/pg_index
— 2. 创建表空间(需超级用户权限)
CREATE TABLESPACE ts_index_ssd LOCATION '/ssd1/pg_index';
— 3. 建索引时用 TABLESPACE 子句指定独立表空间
CREATE INDEX idx_orders_user_id ON orders (user_id) TABLESPACE ts_index_ssd;
验证:
SELECT schemaname, tablename, indexname, tablespace
FROM pg_indexes
WHERE indexname = 'idx_orders_user_id';
— psql 里也可以直接 \\db 查看所有表空间
关键结论:表空间 = 逻辑标签映射到物理目录;建索引加 TABLESPACE 子句即可让索引物理落盘到独立位置。
场景2:经典优化——表在默认空间,索引单独放 SSD
表设计:orders 表 5000 万行,user_id 索引被高频查询
✅ 正确做法(按对象使用模式分介质)
— 表、普通数据仍在默认表空间 pg_default
CREATE TABLE orders (...);
— 高频索引放到 SSD 表空间(可与表数据物理隔离)
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id)
TABLESPACE ts_index_ssd;
— 归档表放慢速大容量盘(数据不追求性能)
CREATE TABLE orders_archive (LIKE orders INCLUDING ALL)
TABLESPACE ts_archive_hdd;
关键结论:官方文档推荐的就是这种"按使用模式分介质"——高频索引放快盘、冷数据放慢盘;同一块盘上拆分没有意义。
场景3:已有索引迁移到新表空间
❌ 错误做法(删了重建,期间索引不可用)
✅ 正确做法(ALTER INDEX 直接迁移数据文件)
— 单索引迁移(需拥有索引 + 新表空间 CREATE 权限)
ALTER INDEX idx_orders_user_id SET TABLESPACE ts_index_ssd;
— 批量:把当前数据库 pg_default 里的所有索引迁走(会加锁,慎用于生产)
ALTER INDEX ALL IN TABLESPACE pg_default SET TABLESPACE ts_index_ssd;
关键结论:ALTER INDEX … SET TABLESPACE 会把索引的数据文件物理移动到新表空间,不需要删建;批量迁移注意锁表窗口。
场景4:备份恢复踩坑——目标库没有该表空间
❌ 常见翻车现场
pg_dump -Fc mydb > mydb.dump
# 换一台机器恢复:
pg_restore -d mydb mydb.dump
# ERROR: tablespace "ts_index_ssd" does not exist
✅ 正确做法(三选一)
# 方案A:先转储并恢复表空间定义(表空间是集群级对象,用 pg_dumpall)
pg_dumpall –tablespaces-only -f tablespaces.sql
# 恢复端先执行 tablespaces.sql,再 pg_restore
# 方案B:恢复时忽略表空间,全部落到默认表空间
pg_restore –no-tablespaces -d mydb mydb.dump
# 方案C:恢复后再把索引迁移回目标表空间
ALTER INDEX idx_orders_user_id SET TABLESPACE ts_index_ssd;
关键结论:表空间不在单库备份里——pg_dump 只备份对象,不备份集群级表空间;恢复备份前先确认目标集群有对应表空间,否则直接报错。
五、绝对禁止的写法汇总
- 同一块物理磁盘上拆分表空间(无性能收益,纯增加管理负担);
- LOCATION 指向不存在的目录 / 相对路径 / 数据目录内部(创建直接失败);
- 把表空间放到临时盘、易失设备(官方明确警告:丢失会导致整个集群无法启动);
- 备份恢复不考虑表空间(pg_restore 报 tablespace does not exist);
- 给所有索引无脑各建一个表空间(表空间数量失控,运维成本爆炸)。
六、最终评审口诀(记住不踩坑)
建索引指定 TABLESPACE,快盘分离性能佳;
同盘拆分白折腾,备份恢复别忘它。
七、总结
- 何时用:高频索引与数据表存在物理介质差异(SSD / HDD)或需要 IO 路径隔离时,用 TABLESPACE 分离存储才有意义;
- 怎么用:CREATE TABLESPACE 建空间 → 建索引加 TABLESPACE 子句 → 已有索引用 ALTER INDEX … SET TABLESPACE 迁移;
- 高级玩法:表空间级 random_page_cost 等参数可引导优化器更倾向使用快盘上的索引;
- 别忘了:表空间是集群级对象,备份恢复要单独处理(pg_dumpall –tablespaces-only / pg_restore –no-tablespaces),且绝不能放在易失设备上。
标签:PostgreSQL 数据库 性能优化
参考来源
- PostgreSQL 官方文档 22.6 Tablespaces(性能用途与警告)—— https://www.postgresql.org/docs/17/manage-ag-tablespaces.html
- PostgreSQL 官方文档 CREATE TABLESPACE(LOCATION 与成本参数)—— https://www.postgresql.org/docs/17/sql-createtablespace.html
- PostgreSQL 官方文档 ALTER INDEX(SET TABLESPACE 与批量迁移)—— https://www.postgresql.org/docs/current/sql-alterindex.html
- PostgreSQL 官方文档 pg_dump(–no-tablespaces)—— https://www.postgresql.org/docs/17/app-pgdump.html