LLM 和 Jev 到底有什么区别?为什么这个"不说话的AI"突然爆火?
2026年9月,一个"不会写句子"的AI突然刷屏开发者社区。它不聊天、不写代码、不写诗,只干一件事:给你一个判断。TypeSafe AI 给它起名叫 Jev,定位是"System One Model"。本文从原理、演进、企业代码、竞品对比到面试题,一次性把 LLM 和 Jev 讲透。
文章目录
- LLM 和 Jev 到底有什么区别?为什么这个"不说话的AI"突然爆火?
-
- 一、痛点场景:你是不是也在为这些事头疼?
-
- 痛点1:客服系统用 GPT 做分类,每月账单十几万
- 痛点2:Agent 每走一步都要调一次大模型,成本爆炸
- 痛点3:内容审核批量处理,GPU 成本扛不住
- 痛点4:面试被问"Jev 是什么",一句话答不上来
- 二、是什么:LLM 和 Jev 到底是什么?
-
- 2.1 专业定义
- 2.2 Jev 的三个核心原语
- 2.3 大白话解释
- 2.4 生活案例
- 三、为什么用:为什么需要 Jev?LLM 不够吗?
-
- 3.1 LLM 做决策的三个"原罪"
- 3.2 那为什么不直接用 BERT 小分类器?
- 3.3 解决方案:快慢分工
- 四、怎么演进过来的:从 Prompt 到 System One
-
- 4.1 2022年:万物皆可 Prompt
- 4.2 2023年:Function Calling 与结构化输出
- 4.3 2024年:小模型路由架构流行
- 4.4 2025年:Agent 爆发,决策成本飙升
- 4.5 2026年9月:Jev 横空出世
- 4.6 2026年9月中下旬:开源复现涌现
- 4.7 演进逻辑一句话
- 五、怎么用:企业项目实战代码
-
- 5.1 环境准备
- 5.2 示例1:客服意图分类(Noul + Choice)
- 5.3 示例2:内容审核批量评分(Score)
- 5.4 示例3:Jev + LLM 混合路由(企业级 Agent)
- 5.5 示例4:Cloudflare Workers 上用 Jev(低代码)
- 5.6 企业落地最佳实践
- 六、竞品对比:BERT / LLM / 结构化输出 LLM / Jev
-
- 选型一句话
- 七、常用场景:Jev 和 LLM 分别用在哪里?
-
- 7.1 Jev 最适合干的活
- 7.2 LLM 仍然不可替代的活
- 7.3 什么时候必须用 Jev?
- 八、面试官高频面试题:这些问题必须能答
-
- Q1:Jev 到底是不是一个 LLM?
- Q2:Jev 为什么比 LLM 快这么多?
- Q3:Jev 和 Function Calling / 结构化输出有什么区别?
- Q4:什么是 System 1 / System 2?为什么借用这个概念?
- Q5:Jev 的 Noul 是什么?和普通分类有什么区别?
- Q6:Jev 会取代 LLM 吗?
- Q7:你们项目里怎么落地 Jev?踩过什么坑?
- 九、总结:一张图记住 LLM 和 Jev
- 转载声明
一、痛点场景:你是不是也在为这些事头疼?
先聊几个企业里真实发生的场景,看看你有没有中招。
痛点1:客服系统用 GPT 做分类,每月账单十几万
某电商公司客服系统,每条用户消息都扔给 GPT-4 做意图分类。10万条/天的工单,分类一次平均消耗 800 token,每月 API 费用超过 12 万。更离谱的是,分类任务明明只需要一个"是/否"或者"选A还是B",GPT 却要输出一大段解释,还时不时格式跑偏,程序解析失败率 5% 以上。
痛点2:Agent 每走一步都要调一次大模型,成本爆炸
某创业公司做 AI Agent,每执行一步都要问 LLM:"下一步该做什么?"一个用户任务平均要调 15 次 LLM。Token 费用加起来,单次任务成本 3 块钱,根本不敢规模化。团队想把简单判断交给小模型,但小模型理解力不够,经常判断错。
痛点3:内容审核批量处理,GPU 成本扛不住
某内容平台要审核每天 500 万条 UGC。用大模型审核,延迟 2 秒,成本高到无法接受;用传统 BERT 分类器,理解不了"这条投诉是不是真的"这种需要语义推理的判断。两头为难。
痛点4:面试被问"Jev 是什么",一句话答不上来
2026年下半年,越来越多 AI 公司面试开始问:“你了解 Jev 吗?”"你们 Agent 里的决策层用什么模型?“如果你还只会说"就是个分类模型”,那就落后了。
这些痛点背后,其实是同一个问题:我们一直在用"会说话的模型"去干"只需要做判断"的活,大材小用,又贵又慢。
二、是什么:LLM 和 Jev 到底是什么?
2.1 专业定义
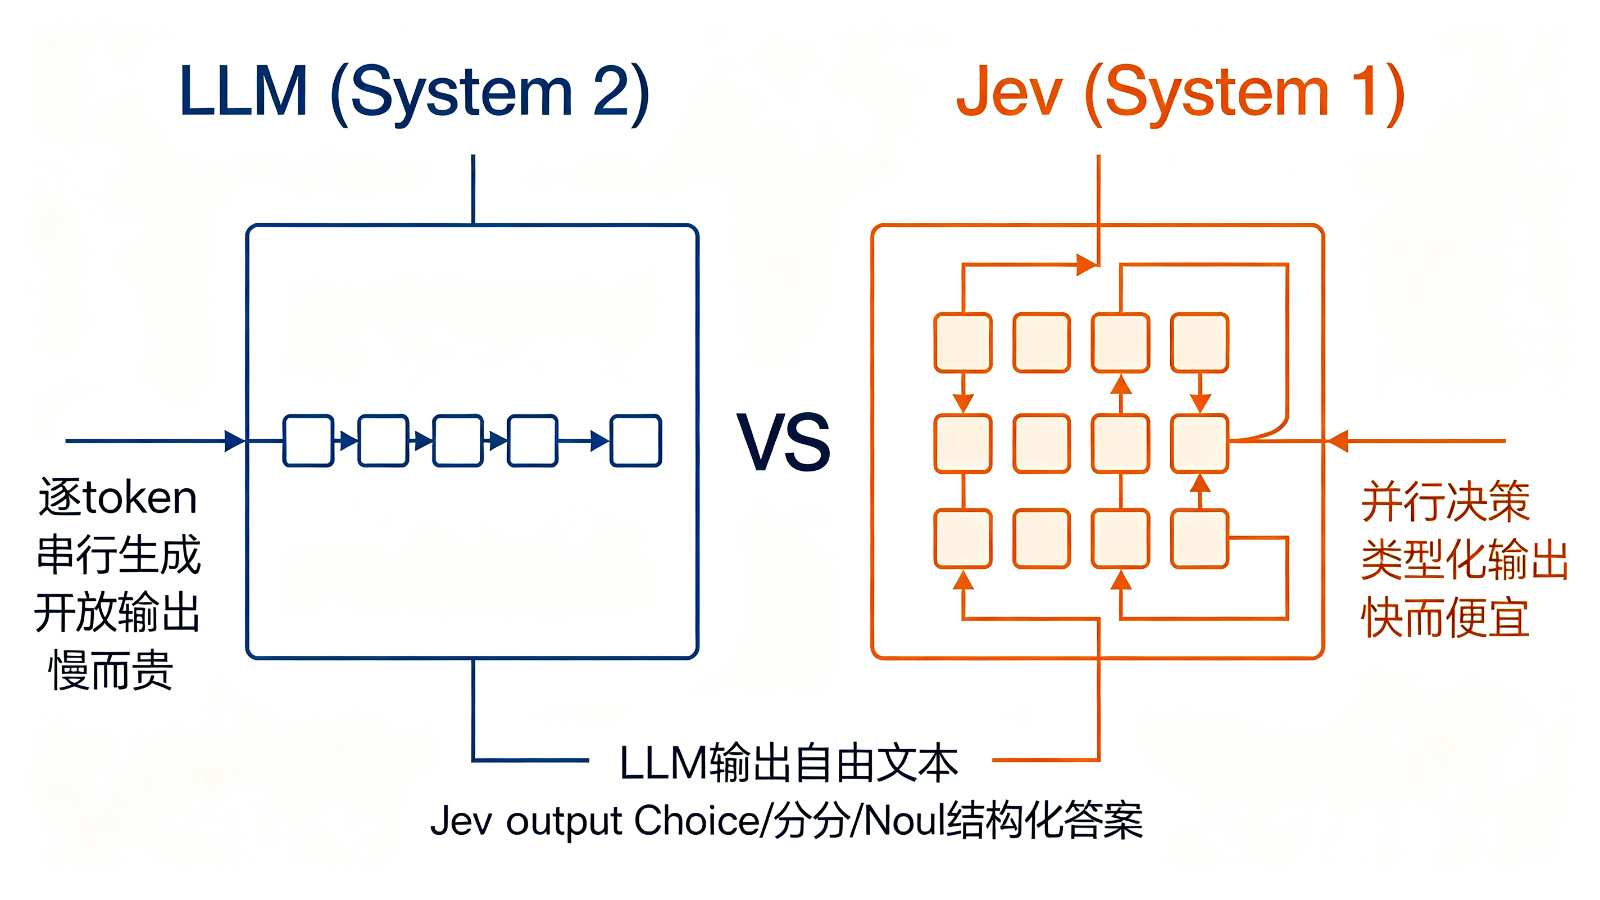
LLM(Large Language Model,大语言模型):以 Transformer Decoder 为架构,通过自回归方式逐 token 生成文本的通用语言模型,如 GPT、Claude、DeepSeek、Qwen。它擅长理解、生成、推理、对话,是当前 AI 应用的主力。
Jev:TypeSafe AI 于 2026 年 9 月发布的"System One Model"(系统一模型)。它不生成任何自由文本,接收一段状态(state)和一组结构化问题后,直接返回带概率的类型化答案。官方口号是 “Decisions, not strings”——要决策,不要文本。[“https://36kr.com/p/3988164509711361”,“https://www.langchain.com/blog/building-a-harness-with-jev”]
2.2 Jev 的三个核心原语
Jev 只支持三种操作,没有别的花活:[“https://36kr.com/p/3991444838857731”,“https://docs.typesafe.ai/primitives/noul”]
| Choice | 选择 | 从候选项里选一个 | 选中的选项 + 每个选项的概率分布 |
| Score | 评分 | 按标准打分 | 分数 + 置信区间 |
| Noul | 二元判断 | 是/否类问题 | 0 到 1 之间的概率(名字来源于 No+Boolean,隐喻伯努利分布) |
2.3 大白话解释
打个比方:
- LLM 像一个博学的教授。你问他任何问题,他都会滔滔不绝地写一篇小论文。优点是什么都能聊,缺点是慢、贵,而且有时候会一本正经地胡说八道(幻觉)。
- Jev 像一个反应极快的裁判。你不用让他写报告,直接问:"这个球出界了吗?"他一秒钟举手:"出界,95%概率。"没有废话,只有判断。
2.4 生活案例
再换个更通俗的例子:
你去餐厅吃饭,服务员问你:“要辣吗?”
- 用 LLM:它会给你写一段——"考虑到您上次点了微辣,今天天气较热,建议您选择微辣以保持口感平衡,理由有以下三点……“说了 300 字,你只想知道"要"还是"不要”。
- 用 Jev:它直接回:"要辣,概率 0.85。"你根据这个概率决定要不要提醒后厨。
LLM 是那个写点评的美食家,Jev 是那个一秒钟判断"这菜能不能吃"的质检员。
三、为什么用:为什么需要 Jev?LLM 不够吗?
3.1 LLM 做决策的三个"原罪"
第一,串行生成太慢。
LLM 是自回归模型,必须一个 token 一个 token 地生成。你问一个是/否问题,它也要先想"嗯……“、然后"这个问题……”、最后才说"是"。生成 50 个 token 才给你答案,延迟和成本都浪费在这些废话上。
Jev 用的是并行采样(Parallel Sampler):把多个问题同时丢进去,一次前向传播全部出结果。TypeSafe 官方数据是比同类 LLM 快 20-200 倍。[“https://www.woshipm.com/ai/6466421.html”,“https://www.langchain.com/blog/building-a-harness-with-jev”]
第二,自由输出容易翻车。
你让 LLM 输出 JSON,它可能多写一句"好的,这是结果";你让它输出 1 到 5 的评分,它可能输出"我觉得大概是 3 分左右"。程序没法稳定解析。实测中,某些模型的结构化输出格式错误率高达 45.5%。[“https://horadecodar.com.br/jev-vs-llm/”]
Jev 的输出空间是你在请求里定义死的,返回的就是类型化结果,程序直接用,格式错误率为 0。
第三,太贵。
一次分类任务,LLM 要消耗几百 token,成本约 $0.03-$0.18;Jev 输入 token 定价 $42/十亿,输出 token 永久免费,单次任务成本约 $0.0004,差了两个数量级。[“https://horadecodar.com.br/jev-vs-llm/”,“https://www.mindstudio.ai/blog/jev-pricing-cost-per-token”]
3.2 那为什么不直接用 BERT 小分类器?
有人会说:“BERT 分类不更快更便宜吗?”
问题在于:
Jev 用 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习)训练,输出的概率是校准过的——它说 90%,长期来看 90% 的时候确实是对的。这对工程系统至关重要,因为你需要根据概率设阈值:“概率超过 0.8 就自动处理,低于 0.5 就转人工。”[“https://www.langchain.com/blog/building-a-harness-with-jev”]
3.3 解决方案:快慢分工
Jev 的核心思想来自卡尼曼《思考,快与慢》:
- System 1(系统一):快速、直觉、自动判断。Jev 干这个。
- System 2(系统二):缓慢、深思熟虑、复杂推理。LLM 干这个。
一个完整的 AI 系统应该是:Jev 在前面做高频、原子化的判断(路由、分类、评分、风险筛查),只有当 Jev 不确定或者遇到复杂任务时,才把请求交给 LLM。这样 80% 的请求用便宜快速的 Jev 处理,20% 复杂请求才动用 LLM,整体成本降一个数量级。[“http://tech.cnr.cn/techph/20260920/t20260920_527819594.shtml”,“https://blog.nimendra.xyz/blog/jev-decision-layer-for-production-ai/”]
四、怎么演进过来的:从 Prompt 到 System One
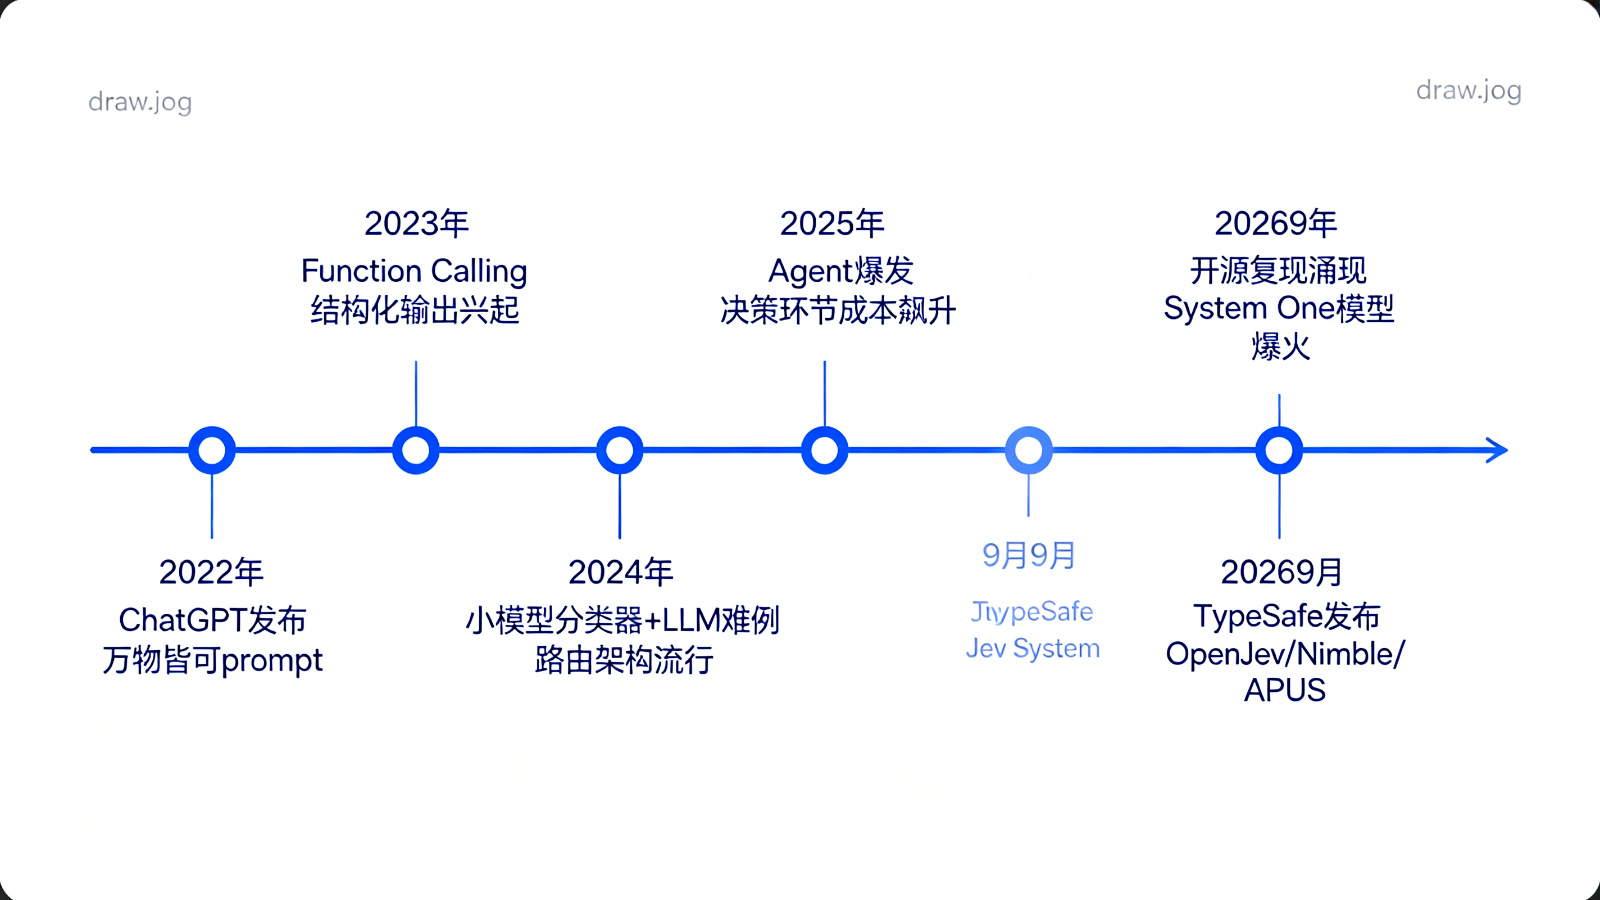
4.1 2022年:万物皆可 Prompt
ChatGPT 刚出来时,什么任务都用 prompt 解决。分类就是:"请判断这条评论是正面还是负面,只回答正面或负面。"能用,但慢、贵、格式不稳定。
4.2 2023年:Function Calling 与结构化输出
OpenAI 推出 Function Calling,各家 LLM 跟进,模型可以按 schema 输出 JSON。这解决了一部分格式问题,但本质还是自回归生成,速度和成本没有质变。你还是要为"好的,结果是……"这些废话付费。
4.3 2024年:小模型路由架构流行
工程团队开始实践"大小模型路由":简单问题用小模型(如 DistilBERT、Phi-2),难问题才上 GPT-4。但小模型理解力不够,路由准确率上不去,而且每个分类任务都要单独训练和部署,维护成了噩梦。
4.4 2025年:Agent 爆发,决策成本飙升
Agent 应用井喷。一个 Agent 任务要执行十几步,每步都要做决策:“该不该调用工具?”“这个结果满意吗?”"用户是不是不满意?“每步都调 LLM,token 费用爆炸,延迟也不可接受。行业开始呼唤专门的"决策层”。
4.5 2026年9月:Jev 横空出世
前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 发布 Jev,首次把"只做决策、不生成文本"做成一个独立模型品类。它用新架构 + 并行采样 + RLCD 训练,发布几天内 X 上原帖浏览量破 3700 万,14 万开发者关注。[“https://36kr.com/p/3991213552368393”]
4.6 2026年9月中下旬:开源复现涌现
Jev 发布后仅 4 天,开源社区就出现多个复现:
- OpenJev:基于 Qwen3.5-4B,通过提取 prompt logits 实现决策,与 Jev 一致率 84.5%。[“https://apidog.com/blog/openjev-open-source-jev-alternatives/”]
- Nimble:Bespoke Labs 推出的开源版,可本地部署。[“https://36kr.com/p/3991444838857731”]
- NanoJev / Kev-0.5B:轻量复现版本。
- APUS fast-browser-use:中国 APUS 公司推出全球首批跨平台开源复现,支持 macOS/Linux/Windows,MIT 协议。[“http://tech.cnr.cn/techph/20260920/t20260920_527819594.shtml”]
4.7 演进逻辑一句话
从"让 LLM 什么都干",到"让 LLM 只干它擅长的事,判断交给专门的快模型"——这是 AI 工程化从玩具走向生产的必然一步。
五、怎么用:企业项目实战代码
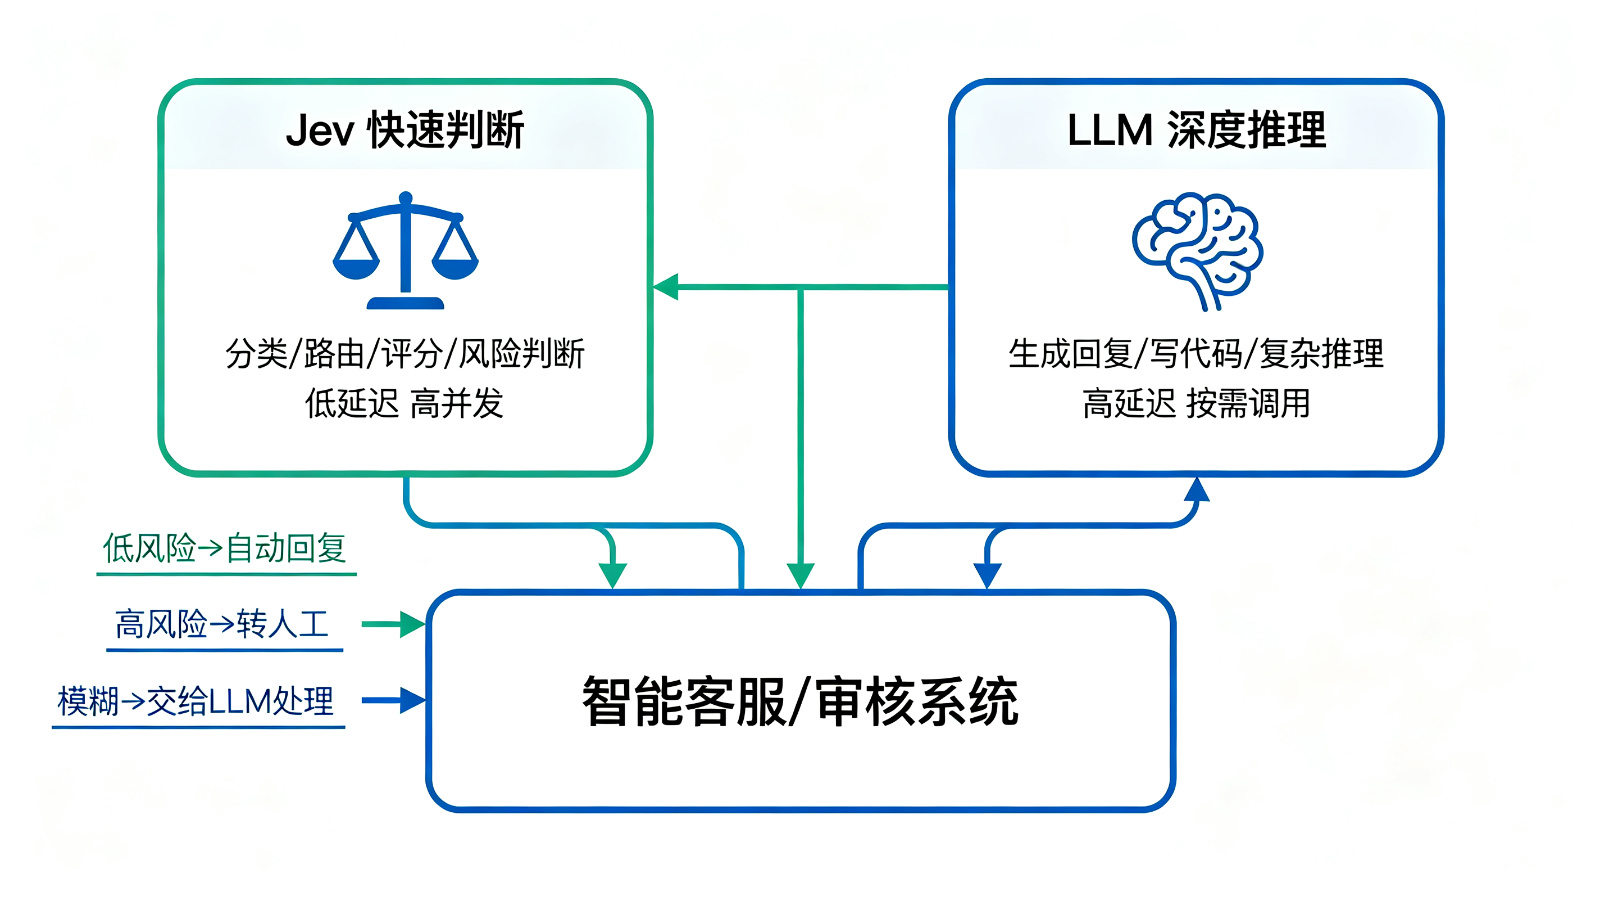
光说不练假把式。下面给你三个真实企业场景的代码示例,覆盖 Jev 官方 SDK 调用、Cloudflare Workers AI 调用、以及 Jev + LLM 混合路由。
5.1 环境准备
# 安装 TypeSafe 官方 Python SDK
pip install typesafe-sdk
# 设置 API Key(从 https://typesafe.ai 申请)
export TYPESAFE_API_KEY="ts-xxxxxxxxxxxx"
# 同时需要一个 LLM SDK 用于处理复杂任务
pip install openai
5.2 示例1:客服意图分类(Noul + Choice)
这是最典型的用法——用户进线后,先用 Jev 判断意图,决定路由到哪个队列。[“https://docs.typesafe.ai/introduction/quickstart”]
from typesafe_sdk import TypesafeClient, Choice, Noul
# 初始化客户端,自动读取 TYPESAFE_API_KEY 环境变量
client = TypesafeClient()
def classify_ticket(user_message: str):
"""
用 Jev 对客服工单做意图分类和紧急程度判断
一次调用同时问两个问题,并行返回
"""
# 状态:用户的工单内容
state = {
"message": user_message,
"channel": "web_form",
"user_tier": "premium"
}
# 一次调用里同时问两个问题,Jev 并行回答
decisions = client.ask(
state=state,
questions=[
# 问题1:Choice —— 意图分类
Choice(
question="用户的主要意图是什么?",
options=[
"refund", # 退款
"technical_issue", # 技术问题
"billing", # 账单问题
"general_inquiry" # 一般咨询
]
),
# 问题2:Noul —— 是否紧急
Noul(
question="这条工单是否需要在1小时内人工处理?"
)
]
)
# 解析结果,直接是类型化数据,不需要 parse JSON
intent = decisions[0].selected # "refund" / "technical_issue" …
intent_probs = decisions[0].probabilities # 每个选项的概率分布
is_urgent = decisions[1].answer # True / False
urgency_prob = decisions[1].probability # 0.0 ~ 1.0
return {
"intent": intent,
"intent_confidence": intent_probs[intent],
"is_urgent": is_urgent,
"urgency_probability": urgency_prob
}
# 测试
result = classify_ticket(
"我付了钱但APP一直闪退,数据全没了,必须马上解决!"
)
print(result)
# 输出示例:
# {
# 'intent': 'technical_issue',
# 'intent_confidence': 0.92,
# 'is_urgent': True,
# 'urgency_probability': 0.88
# }
5.3 示例2:内容审核批量评分(Score)
某内容平台每天要审核海量 UGC,用 Jev 做批量风险评分,高分才转 LLM 详查。
from typesafe_sdk import TypesafeClient, Score
client = TypesafeClient()
def batch_moderate(comments: list[str]) –> list[dict]:
"""
批量内容审核:给每条评论打风险分(0-10)
Jev 单次调用可以并行处理多个问题,比逐条调 LLM 快几十倍
"""
results = []
# 每批处理 20 条,并行评估
batch_size = 20
for i in range(0, len(comments), batch_size):
batch = comments[i:i+batch_size]
# 构造一批 Score 问题,一次调用全部回答
questions = [
Score(
question=f"以下评论的风险程度(0=完全安全,10=严重违规):{comment}"
)
for comment in batch
]
decisions = client.ask(
state={"source": "user_generated_content"},
questions=questions
)
for comment, decision in zip(batch, decisions):
results.append({
"comment": comment,
"risk_score": decision.score, # 0 ~ 10
"confidence": decision.confidence # 置信度
})
return results
# 使用
comments = [
"这个产品真好用,推荐!",
"加我微信xxxx领红包",
"你们公司就是骗子,我要投诉到消协",
# … 几万条
]
moderated = batch_moderate(comments)
# 根据分数分流:>=8 直接拦截,5-8 转人工,<5 放行
for item in moderated:
if item["risk_score"] >= 8:
print(f"[拦截] {item['comment']} (score={item['risk_score']})")
elif item["risk_score"] >= 5:
print(f"[人工复审] {item['comment']}")
else:
print(f"[放行] {item['comment']}")
5.4 示例3:Jev + LLM 混合路由(企业级 Agent)
这是最有工程价值的模式:Jev 做快速门控,不确定时才上 LLM。
import os
from openai import OpenAI
from typesafe_sdk import TypesafeClient, Noul, Choice
jev = TypesafeClient()
llm = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
def handle_user_query(user_query: str) –> str:
"""
混合路由:Jev 先判断要不要用 LLM
简单问题 Jev 直接决策,复杂问题才调 LLM
"""
# 第一步:Jev 快速判断
decisions = jev.ask(
state={"query": user_query},
questions=[
# 判断1:这是不是一个需要生成长文本的复杂问题?
Noul(question="这个问题需要详细解释或生成大段文本吗?"),
# 判断2:这是不是有明确选项的分类问题?
Choice(
question="如果这是分类问题,属于哪类?",
options=["greeting", "pricing", "technical", "complaint", "other"]
)
]
)
need_llm = decisions[0].answer
category = decisions[1].selected
# 第二步:根据 Jev 的判断分流
if not need_llm and category != "other":
# Jev 直接路由,不调 LLM,成本几乎为零
auto_replies = {
"greeting": "您好!请问有什么可以帮您?",
"pricing": "我们的基础版99元/月,专业版299元/月,详情见官网定价页。",
"technical": "技术问题请提供报错截图,我们会在24小时内回复。",
"complaint": "非常抱歉给您带来不便,已为您转接人工客服。"
}
return f"[Jev自动回复] {auto_replies[category]}"
else:
# 复杂问题才动用 LLM,省 token
response = llm.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "system", "content": "你是一个专业的客服助理。"},
{"role": "user", "content": user_query}
],
max_tokens=500
)
return f"[LLM生成回复] {response.choices[0].message.content}"
# 测试
print(handle_user_query("你好"))
print(handle_user_query("我的订单还没到,帮我看看物流"))
print(handle_user_query("帮我写一份Python代码来分析CSV文件里的销售数据并生成图表"))
5.5 示例4:Cloudflare Workers 上用 Jev(低代码)
如果不想自己维护后端,Cloudflare AI 已经直接集成了 Jev,可以用 REST 调用:[“https://developers.cloudflare.com/ai/models/typesafe/jev/”]
curl "https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/typesafe/jev" \\
–header "Authorization: Bearer $CLOUDFLARE_API_TOKEN" \\
–header "Content-Type: application/json" \\
–data '{
"state": {"message": "这个订单3天了还没发货,什么垃圾服务!"},
"questions": [
{
"type": "noul",
"question": "客户是否在表达强烈不满?"
},
{
"type": "choice",
"question": "客户诉求是什么?",
"options": ["查询物流", "退款", "投诉", "换货"]
}
]
}'
5.6 企业落地最佳实践
六、竞品对比:BERT / LLM / 结构化输出 LLM / Jev
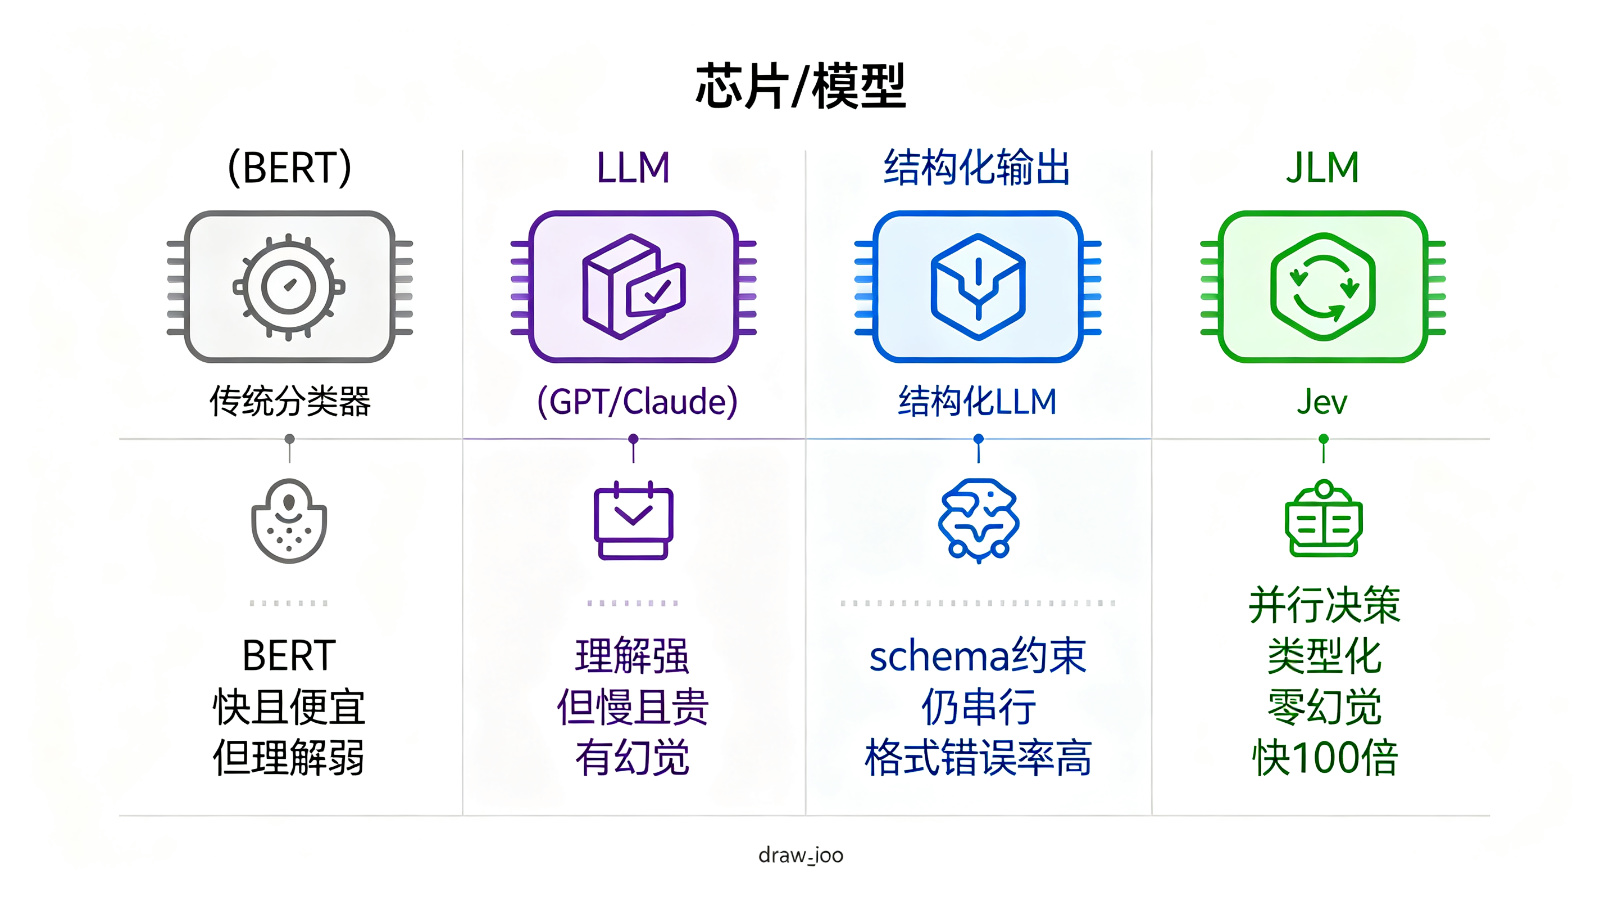
| 输出形式 | 固定类别概率 | 自由文本 | schema 约束的 JSON | 类型化决策+概率 |
| 生成方式 | 单次前向 | 逐token自回归 | 逐token自回归 | 并行采样,一次前向 |
| 理解能力 | 弱(需微调) | 强 | 强 | 较强(LLM级语义理解) |
| 速度 | 极快(ms级) | 慢(秒级) | 慢(秒级) | 快(<500ms) |
| 成本 | 几乎为零(自部署) | 高 | 中高 | 极低(比LLM便宜40-400倍) |
| 格式稳定性 | 稳定 | 差(幻觉、跑偏) | 中等(仍有格式错误) | 100%类型化,零格式错误 |
| 概率校准 | 未校准 | 不提供/不可信 | 不提供 | RLCD训练,校准过 |
| 多任务并行 | 不支持(单任务) | 不支持(串行) | 不支持(串行) | 一次调用多问题并行 |
| 部署方式 | 自部署 | API/自部署 | API/自部署 | API为主,开源版刚起步 |
| 灵活性 | 低(一个模型一个任务) | 极高 | 高 | 中(问题定义在请求里) |
| 幻觉风险 | 无 | 高 | 中 | 无(不生成自由文本) |
| 适用场景 | 简单固定分类 | 对话、写作、推理 | 需要生成结构化结果的复杂任务 | 高频决策、路由、评分、门控 |
[“https://dev.to/miruky/jev-does-not-replace-the-llm-it-changes-who-owns-the-decision-3n6”,“https://horadecodar.com.br/jev-vs-llm/”]
选型一句话
- 任务简单固定、量极大:BERT 微调仍然最便宜。
- 需要理解+生成:用 LLM,别犹豫。
- 需要理解但只要结构化结果:试 Jev,它就是为这个生的。
- 数据绝对不能出内网:等 OpenJev/NanoJev 成熟,或用小模型 logits 自实现。
七、常用场景:Jev 和 LLM 分别用在哪里?
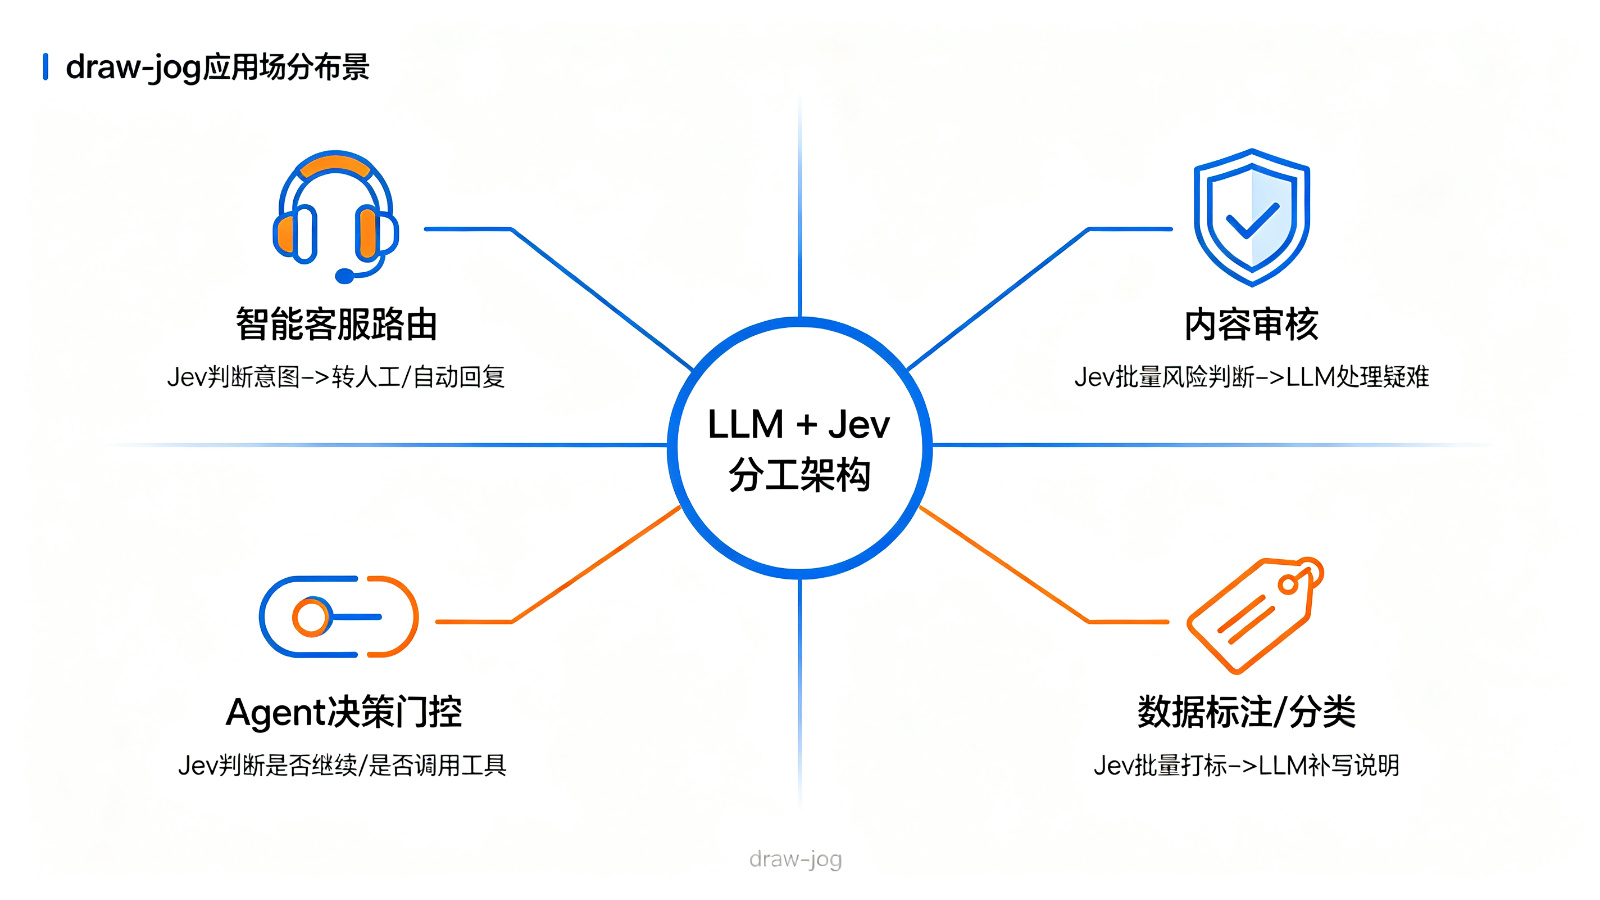
7.1 Jev 最适合干的活
7.2 LLM 仍然不可替代的活
7.3 什么时候必须用 Jev?
满足以下任意一条,就该认真考虑:
- 单次决策量大(日调用十万次以上),LLM 成本扛不住。
- 延迟敏感(要求 <500ms),LLM 太慢。
- 输出必须 100% 结构化,不能容忍格式错误。
- 需要概率做门控(“超过 0.8 自动通过”)。
八、面试官高频面试题:这些问题必须能答
Q1:Jev 到底是不是一个 LLM?
答题要点:
- 严格说不是。Jev 不是自回归生成模型,不输出 token 序列。
- 它是一个"System One Model",输入状态+结构化问题,直接返回类型化决策和概率。
- TypeSafe 官方原话:“Jev is neither small nor an LLM”。
- 它有 LLM 的语义理解能力,但砍掉了文本生成,专做判断。
Q2:Jev 为什么比 LLM 快这么多?
答题要点:
- 两个原因:一是不做自回归逐 token 生成,二是用并行采样一次前向传播回答多个问题。
- LLM 生成 100 个 token 要 100 次前向;Jev 一次前向出所有答案。
- 架构层面的优势,不是靠量化或蒸馏省出来的。
Q3:Jev 和 Function Calling / 结构化输出有什么区别?
答题要点:
- 结构化输出的 LLM 仍然是自回归生成,只是被 schema 约束了,速度和成本没有本质变化。
- Jev 根本不生成文本,直接输出决策概率,速度快 20-200 倍,成本低 40-400 倍。
- Jev 的概率是校准过的(RLCD),可以直接用于自动化阈值;LLM 的 self-reported confidence 不可信。
Q4:什么是 System 1 / System 2?为什么借用这个概念?
答题要点:
- 来自卡尼曼《思考,快与慢》:System 1 是快速直觉反应,System 2 是缓慢深度思考。
- AI 系统也应该这样分工:Jev 做 System 1 快速判断,LLM 做 System 2 深度推理。
- 80% 的请求是简单判断,用 Jev 快速处理;20% 复杂请求才上 LLM。
Q5:Jev 的 Noul 是什么?和普通分类有什么区别?
答题要点:
- Noul 是二元判断原语,返回 0 到 1 的概率。
- 关键在于概率是校准过的:0.9 意味着长期来看 90% 为真。
- 普通分类器输出的分数没有校准,你不知道 0.8 到底意味着什么。
- 工程上可以根据概率设阈值做自动决策。
Q6:Jev 会取代 LLM 吗?
答题要点:
- 不会。它们是互补关系,不是替代。
- Jev 不生成文本、不做复杂推理,这些活还是 LLM 干。
- 未来趋势是"LLM + System One 模型"的混合架构,Jev 做决策层,LLM 做推理层。
Q7:你们项目里怎么落地 Jev?踩过什么坑?
答题模板(加分项):
- 场景:客服意图路由,原来全量调 GPT-4,每月 12 万。
- 做法:Jev 做一级路由,80% 工单自动分类,20% 模糊工单转 LLM。
- 效果:成本降到每月 2 万,延迟从 1.5 秒降到 200ms。
- 坑:早期问题定义太模糊(“客户是不是生气了”),Jev 概率不稳定。改成明确定义(“客户是否使用了辱骂性词汇或要求退款”)后准确率大幅提升。
- 教训:Jev 的问题描述必须精确,模糊的问题得到模糊的概率。
九、总结:一张图记住 LLM 和 Jev
| 定位 | 会说话的通用大脑 | 只做判断的快速裁判 |
| 架构 | 自回归 Transformer | 并行采样 + RLCD |
| 输出 | 自由文本 | Choice/Score/Noul 类型化决策 |
| 速度 | 慢(秒级) | 快(<500ms) |
| 成本 | 高 | 低 40-400 倍 |
| 幻觉 | 有 | 无 |
| 擅长 | 生成、推理、对话 | 分类、路由、评分、门控 |
| 类比 | 写文章的教授 | 秒判出界的裁判 |
记住这句话:LLM 负责"想",Jev 负责"判"。 在 AI Agent 时代,决策频率远高于生成频率,专门的决策层模型不是噱头,而是生产系统降本增效的必经之路。
Jev 会不会是终局?不一定。但它指明了一个方向:AI 模型正在从"一个模型干所有事"走向"多种模型分工协作"。看懂这个趋势,比记住 Jev 这个名字更重要。
转载声明
本文为原创文章,如需转载,请联系作者获得授权,并注明出处。