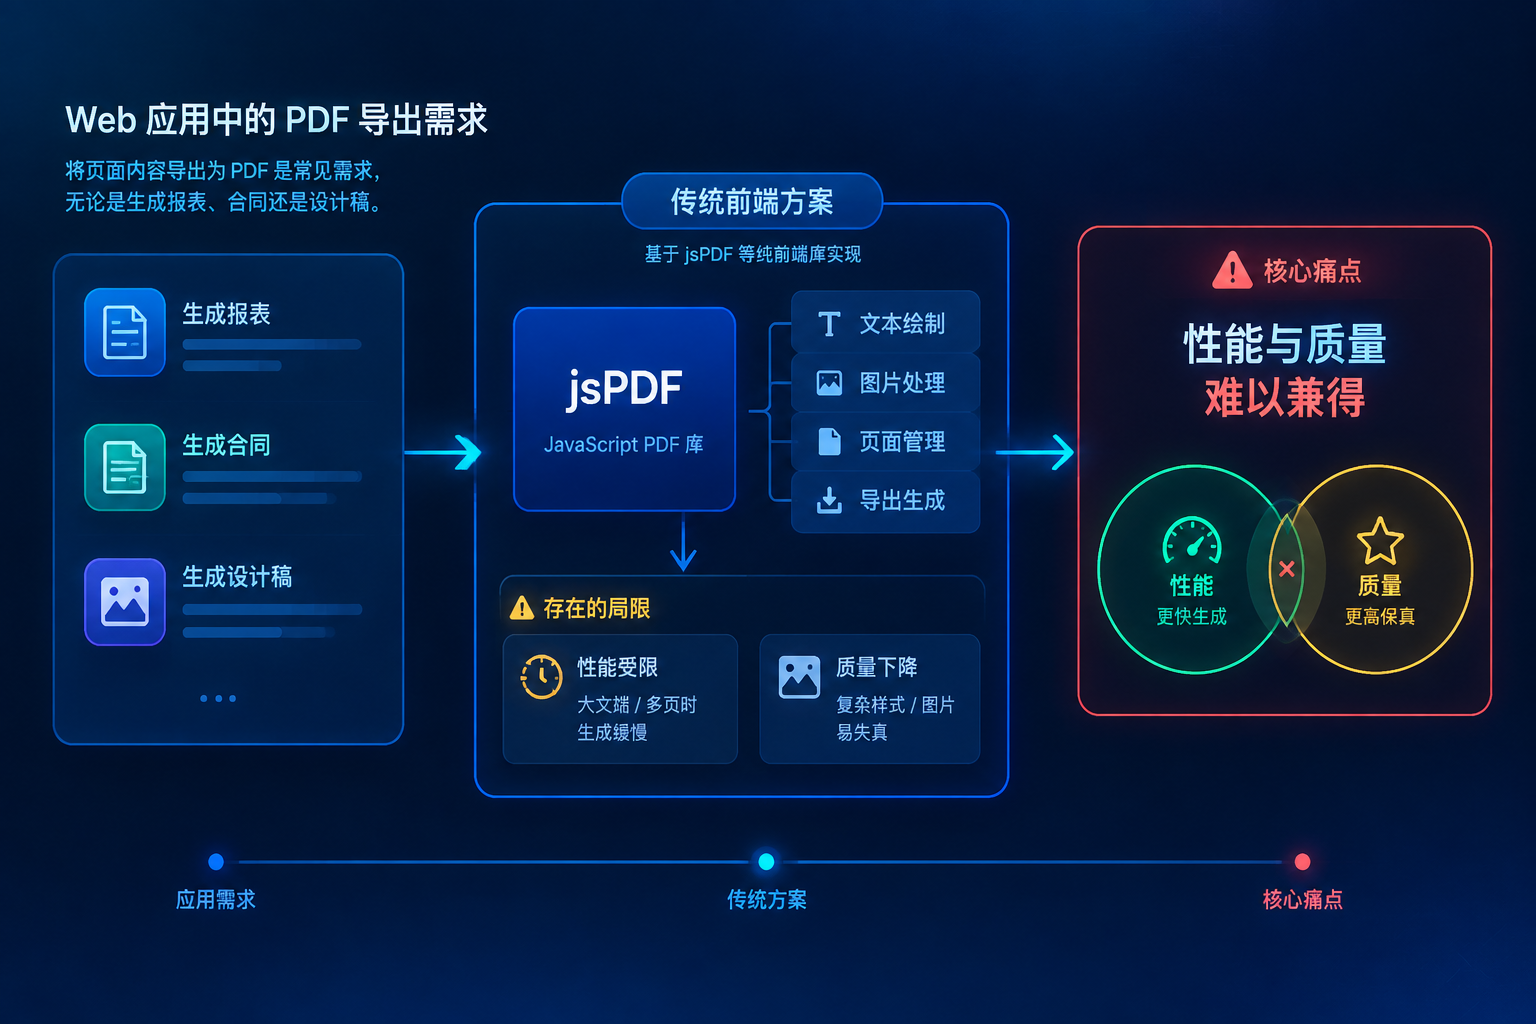
在当今的Web应用中,将页面内容导出为PDF是常见需求,无论是生成报表、合同还是设计稿。然而,传统的前端PDF生成方案往往面临一个核心痛点:性能与质量难以兼得。使用html2canvas截图生成位图PDF,虽然实现简单,但放大即失真、文字无法复制;而试图生成矢量PDF的方案,如基于jsPDF的手绘模式,在面对复杂排版和大规模文档时,又常常导致主线程阻塞、页面假死,生成速度令人无法忍受。
常规做法的瓶颈根源在于,它们大多将PDF渲染逻辑完全置于JavaScript主线程。无论是逐个调用jsPDF的text()、rect() API,还是依赖html2canvas进行重绘,都无法摆脱单线程的性能牢笼。当文档页数增多、DOM节点复杂时,海量的计算与绘图操作会彻底拖垮浏览器,更不用提实现字体子集化、精确分页等高级功能了。
本文分享一套基于Rust + WebAssembly的全新架构,可直接落地,彻底重写PDF生成管线:使用Rust实现高性能矢量渲染引擎 + 通过WASM在Web Worker中并行计算 + 内置智能字体子集化与压缩,最终实现在前端2秒内生成500页清晰可搜索的矢量PDF,且完全不卡顿主线程。
一、旧瓶难装新酒:jsPDF的三个天花板
在介绍新方案前,我们先彻底看清旧技术的局限性。jsPDF是一个优秀的、用于“手写代码绘图”的库,但它并不适合“DOM到PDF”的自动化转换场景。
以下三个天花板,是促使我们做出架构重构决定的核心原因:
- API范式不匹配:jsPDF提供的是命令式绘图API。要渲染一棵DOM树,必须逐节点遍历并调用text(), fillRect(), strokePath()等方法。这意味着渲染一万个节点,就产生一万个JavaScript函数调用,状态管理复杂且效率低下,完全无法利用浏览器优化的批量渲染能力。
- “总页数”的预计算负担:为了实现页眉页脚中的“第X页/共Y页”,必须在渲染前预知总页数。这迫使库必须先完整运行一次分页逻辑,计算出所有页面边界,然后才能回头逐页绘制。文档越大,这个预计算阶段的成本就越高,显得尤为笨重。
- 字体子集化的性能黑洞:在中文环境下,嵌入完整字体(即使是裁剪过的)会导致PDF文件体积爆炸。必须在JS端进行字体子集化(提取文档中出现的字符)。但JavaScript处理数万字符的字符串匹配、子集提取和压缩,速度慢且内存占用高,成为生成流程中的严重瓶颈。
核心结论: jsPDF的架构设计决定了它在处理动态、大规模DOM到PDF转换时,性能上限很低,且实现复杂功能(如智能分页)代价高昂。

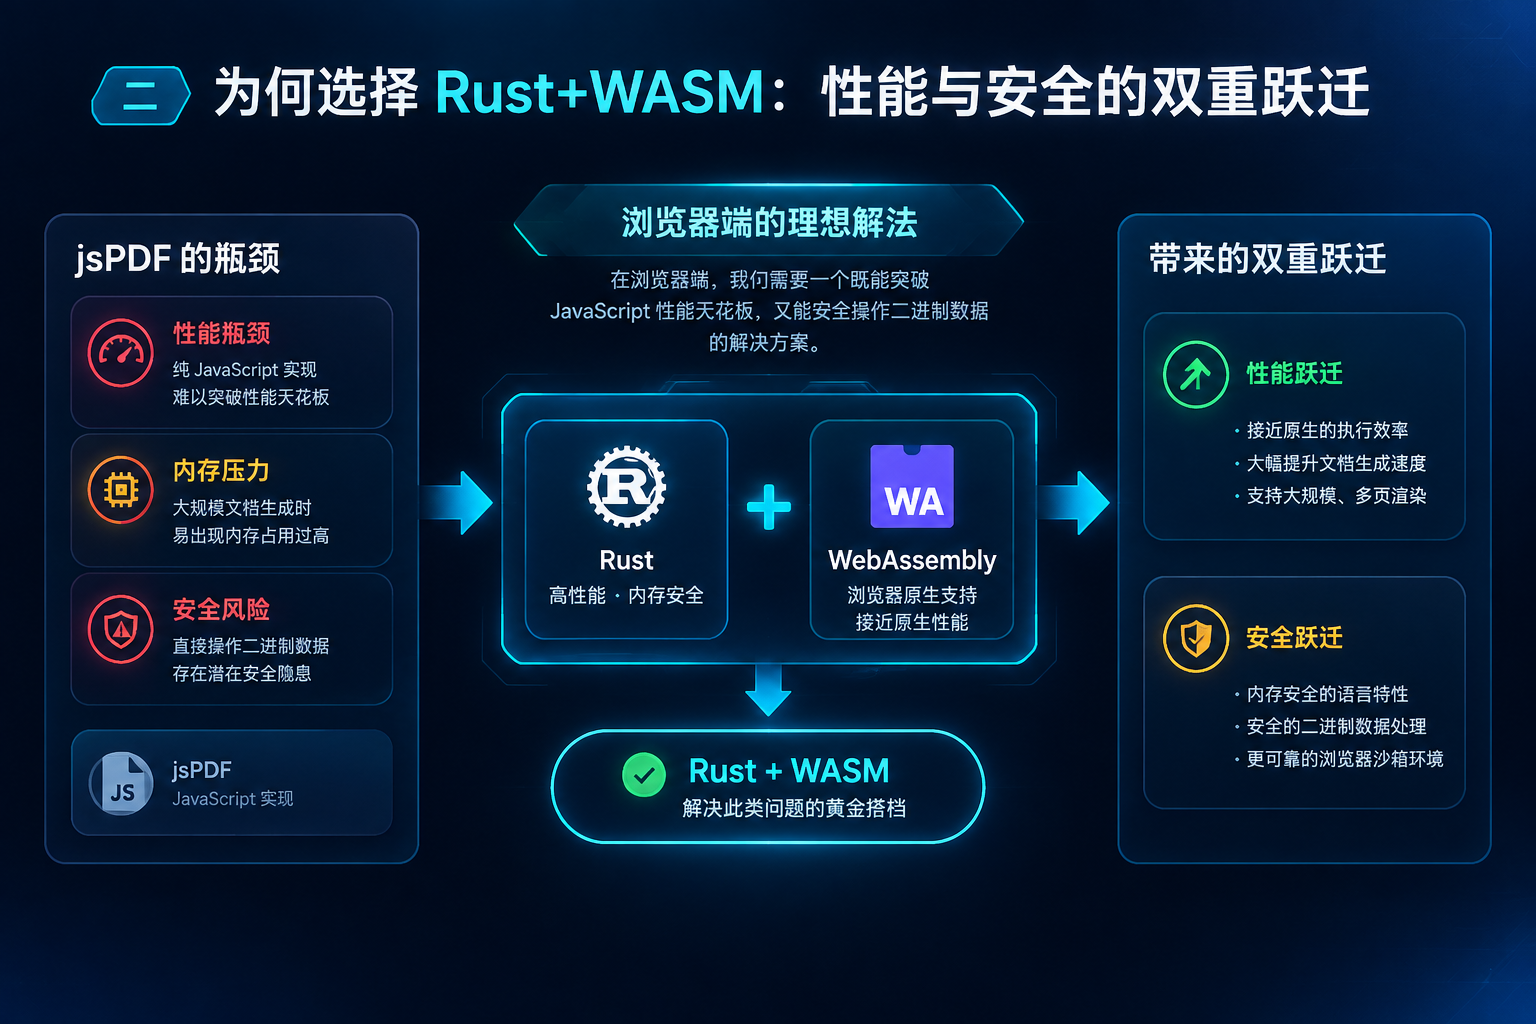
二、为何选择 Rust+WASM:性能与安全的双重跃迁
面对jsPDF的瓶颈,我们需要在浏览器端找到一个既能突破JavaScript性能天花板,又能安全操作二进制数据的解决方案。
WebAssembly(WASM)与Rust语言的组合,是解决此类问题的黄金搭档。其优势体现在以下几个方面:
- 接近原生的执行速度:Rust编译出的WASM代码,在Web Worker中运行时,其计算性能远超JavaScript。特别适合PDF生成中涉及的大量几何计算、路径构建和字体处理等CPU密集型任务。
- 零成本的并行计算:我们可以轻松创建多个Web Worker,将文档的不同部分(如不同页面)分配给不同的Worker并行渲染,充分利用多核CPU,这是单线程的JavaScript难以企及的。
- 强大的二进制数据处理能力:Rust拥有无与伦比的内存安全性和对底层数据的控制力。对于解析字体文件(TTF/OTF)、操作PDF二进制结构、进行高效压缩(如Brotli)等任务,Rust是理想的工具。
- 更小的产物体积:相比于需要打包大量运行时的纯JavaScript库,一个功能专一的Rust模块编译成的WASM文件,往往体积更小,加载更快。
下面是一个简化的示例,展示如何在Rust中定义WASM可调用的PDF渲染函数:
// src/lib.rs
use wasm_bindgen::prelude::*;
use std::collections::HashMap;
/// 为WASM暴露的渲染结构体
#[wasm_bindgen]
pub struct PdfRenderer {
pages: Vec<Page>,
font_subsetter: FontSubsetter,
}
#[wasm_bindgen]
impl PdfRenderer {
#[wasm_bindgen(constructor)]
pub fn new() -> PdfRenderer {
PdfRenderer {
pages: Vec::new(),
font_subsetter: FontSubsetter::new(),
}
}
/// 核心渲染方法:接收页面JSON描述,返回二进制PDF数据
#[wasm_bindgen]
pub fn render(&mut self, pages_json: &str) -> Result<Vec<u8>, JsValue> {
// 1. 解析页面JSON数据
let page_data: Vec<PageData> = serde_json::from_str(pages_json)
.map_err(|e| JsValue::from_str(&e.to_string()))?;
// 2. 执行字体子集化 (Rust高性能字符串处理)
let subsetted_fonts = self.font_subsetter.process(&page_data)?;
// 3. 生成PDF二进制流 (Rust直接操作字节)
let pdf_bytes = generate_pdf_binary(page_data, subsetted_fonts);
Ok(pdf_bytes)
}
}
Rust端定义清晰的WASM接口,通过serde_json与前端通信,高效处理核心逻辑。
三、新架构全景:从 DOM 树到 PDF 二进制流
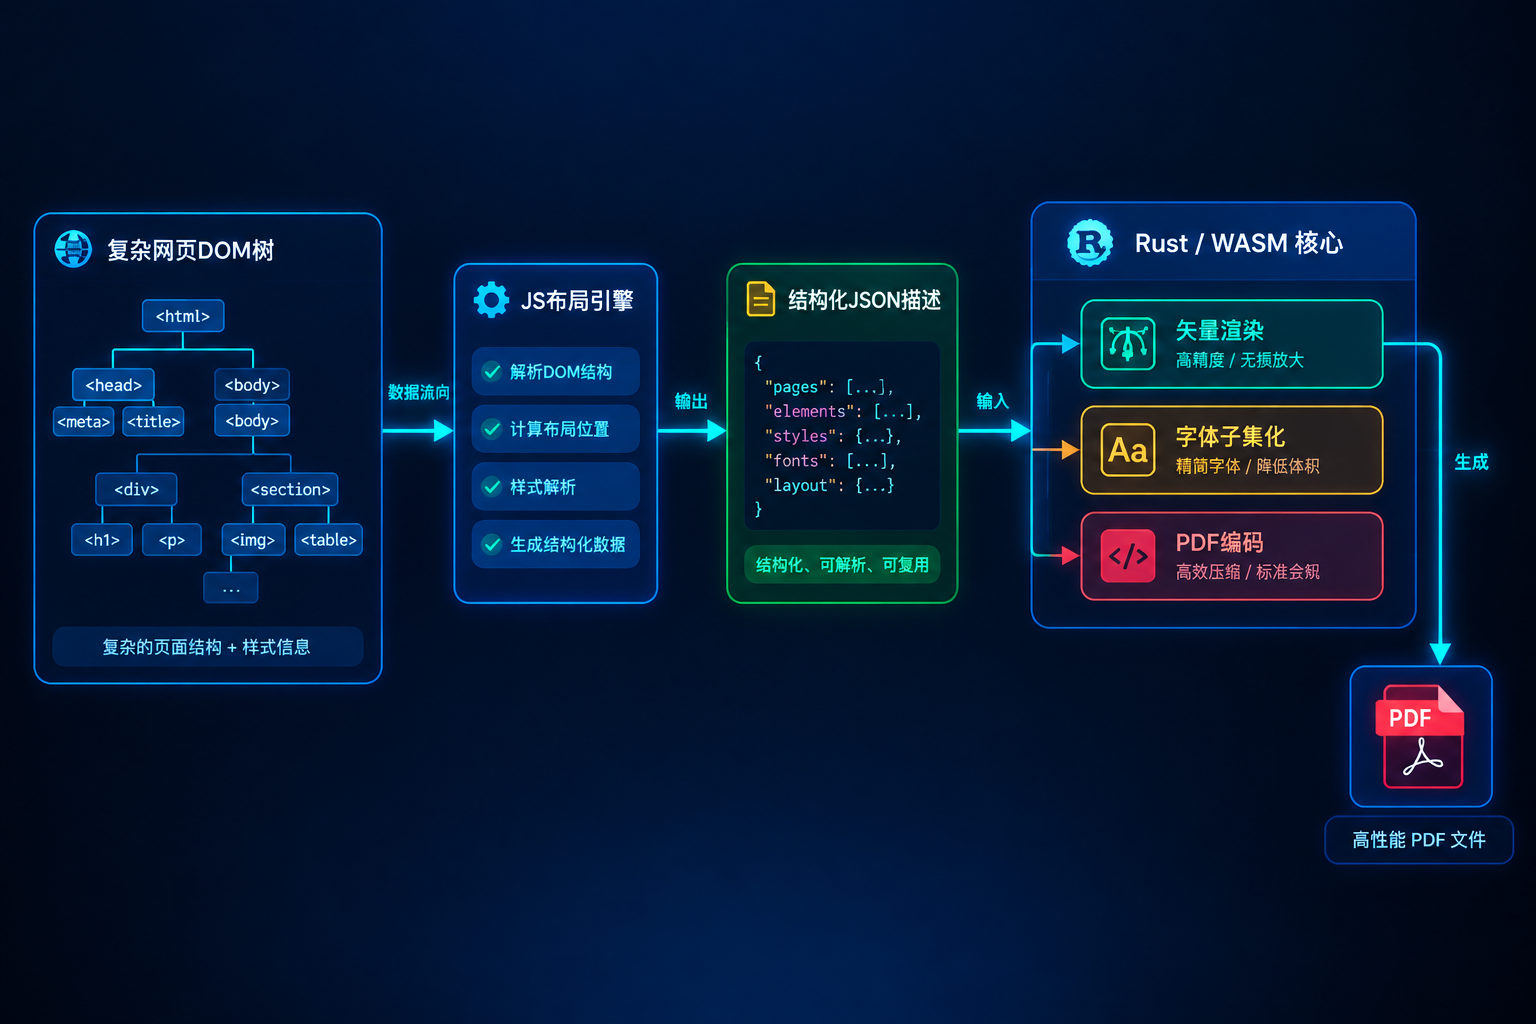
v2.0的架构核心是将原本在JavaScript中混杂的逻辑,清晰地分离为浏览器侧(DOM解析与布局) 和WASM侧(渲染与编码) 两部分,它们通过高效的数据接口(通常是JSON)通信。
整个处理流水线如下:
**前端JS (主线程/Worker) → DOM解析与布局计算 → 页面描述JSON → Rust/WASM (Worker线程) → 字体子集化 + 矢量渲染 + PDF编码 → 最终PDF二进制数据
新架构的关键模块包括:
- DOM布局引擎:在JavaScript中完成。负责遍历DOM树,计算每个元素的几何信息(位置、大小)、样式,并处理分页逻辑(在哪里断页、如何防止内容截断)。这一步的输出是一个结构化的JSON,描述了每一页包含哪些元素及其绝对坐标。
- Rust渲染引擎(WASM):接收上一步生成的JSON。负责将抽象的页面描述,转换为具体的PDF绘图指令(如移动画笔、绘制路径、填充颜色)。这是性能瓶颈的核心,完全由Rust处理。
- 字体子集化模块(WASM):独立于渲染引擎,但被其调用。扫描所有页面文本,提取所需字符,从原始字体文件中生成仅包含这些字符的子集字体,并嵌入PDF。
- PDF编码器(WASM):将渲染引擎输出的绘图指令流,按照PDF规范(PDF 1.7)封装成最终的二进制PDF文件对象,包括交叉引用表、元数据等。
| DOM解析与布局 | JavaScript (Web Worker) | DOM遍历、样式计算、分页 | 浏览器原生能力,与DOM交互必须 |
| Rust渲染引擎 | WebAssembly (Worker) | 矢量路径生成、绘图指令编排 | CPU密集型,需极致性能 |
| 字体子集化 | WebAssembly (Worker) | 文本扫描、字符提取、TTF子集生成 | 数据处理密集,需低开销 |
| PDF编码 | WebAssembly (Worker) | 组装PDF二进制流、压缩 | 二进制操作,需精确与高效 |
四、核心突破一:Rust 实现的无依赖矢量渲染引擎
摒弃jsPDF后,我们用Rust从头构建了PDF矢量绘图引擎。其核心任务是将JSON描述转化为PDF页面内容流。
在Rust中,我们可以直接构建PDF底层对象。以下是一个简化的示例,展示如何生成一段包含文本和矩形的页面内容流:
use std::io::Write;
fn generate_page_content_stream(page: &PageData, fonts: &FontMap) -> Vec<u8> {
let mut stream = Vec::new();
// 设置字体
writeln!(stream, "BT").unwrap(); // Begin Text
writeln!(stream, "/F1 {} Tf", 12).unwrap(); // Font size 12
writeln!(stream, "1 0 0 1 72 720 Tm").unwrap(); // Move text cursor
writeln!(stream, "(Hello, Rust PDF!) Tj").unwrap(); // Draw text
writeln!(stream, "ET").unwrap(); // End Text
// 绘制一个红色矩形
writeln!(stream, "0.8 0 0 rg").unwrap(); // Set fill color to red
writeln!(stream, "100 600 200 50 re").unwrap(); // Rectangle x=100, y=600, w=200, h=50
writeln!(stream, "f").unwrap(); // Fill path
stream
}
这段Rust代码直接生成PDF内容流的原始指令,没有依赖任何JavaScript库,因此执行速度极快。
1. 图元绘制的优化策略
为了提升渲染性能,我们在Rust层做了多项优化:
- 路径指令批处理:将多个连续的直线(l命令)合并为多边形(m命令开始,多个l,最后h闭合)。
- 状态最小化:只在样式变化时(如切换颜色、线宽)才插入PDF状态设置指令(如0.8 0 0 rg)。
- 对象复用:相同颜色、线宽的图形指令序列可以合并为一个PDF“扩展图形状态”对象,在不同页面间复用。
五、核心突破二:高效、精准的分页与跨页处理
分页是PDF生成中最复杂的逻辑之一。新架构将分页计算移至JavaScript端,充分利用浏览器对CSS布局的精确计算能力,而Rust端则专注于接收已分页好的数据进行绘制,实现了“计算与渲染”的分离。
分页流程分为三个关键步骤:
- 首次布局扫描:在Web Worker中,深度优先遍历DOM树,模拟CSS布局,计算每个元素的offsetHeight、offsetTop等几何信息,并标记不可分割的块级元素。
- 分页模拟:根据设定的页面高度(如A4: 1123px @96dpi),从文档起点开始,判断每个元素是否能放入当前页。如果不能,则触发分页点,将元素推入下一页,并处理可能的page-break-inside: avoid等CSS属性。
- 生成页面描述树:分页完成后,生成一个数组,每个元素代表一页。每页包含一个元素列表,每个元素都带有其在该页中的绝对坐标(相对于页面左上角)。同时,预计算出总页数,供页眉页脚使用。
// 伪代码:展示分页生成JSON的过程
function paginateDOM(root, pageHeight) {
const pages = [];
let currentPage = createEmptyPage();
traverseDFS(root, (node) => {
const nodeRect = getBoundingClientRect(node);
if (currentPage.height + nodeRect.height > pageHeight) {
// 触发分页
pages.push(currentPage);
currentPage = createEmptyPage();
}
// 将节点及其绝对坐标加入当前页
currentPage.addElement({
id: node.id,
type: node.tagName,
rect: { x: nodeRect.x, y: currentPage.height, w: nodeRect.width, h: nodeRect.height },
styles: extractStyles(node) // 提取关键绘图样式
});
});
return JSON.stringify(pages); // 传递给Rust WASM
}
分页逻辑在JS端完成,利用了浏览器原生布局计算的准确性,输出的JSON是纯粹的绘图指令,对Rust友好。
六、核心突破三:Rust 实现的极速字体子集化
字体子集化是减小中文PDF体积的关键。传统JS实现速度慢,而Rust版本可以在毫秒级完成。
Rust实现字体子集化的核心步骤如下:
| 传统JS方案 | ~3000ms | ~280KB | 原生JS,性能受限 |
| Rust/WASM方案 | ~120ms | ~210KB | Rust + fonttools库移植 |
我们选择将Rust生态中强大的fonttools库的子集化逻辑(如pyftsubset)移植到纯Rust实现,确保了处理的正确性和速度。移植后的核心函数签名可能如下:
/// Rust侧字体子集化核心函数
pub fn subset_font(font_data: &[u8], required_chars: &HashSet<u32>) -> Result<Vec<u8>, FontError> {
// 1. 解析字体
let font = Font::from_bytes(font_data)?;
// 2. 根据required_chars过滤字形
let subset_outline = font.subset(required_chars)?;
// 3. 编译出新的字体二进制数据
let mut subsetted_font = Vec::new();
subset_outline.compile(&mut subsetted_font)?;
Ok(subsetted_font)
}
Rust版本的字体子集化速度提升约25倍,这是整体性能飞跃的关键一环。
七、性能实测:2秒 vs 10分钟的鸿沟
我们设计了一个压力测试场景:生成一个包含500页、每页有大量中文段落、表格和图片占位符的复杂报告。对比传统方案与新架构的表现。
测试环境:
- 浏览器:Chrome 118 (最新稳定版)
- 机器:Intel i7-13700K, 32GB RAM
- 测试内容:500页,平均每页15个文本块,10个图形元素,总计约7.5万个DOM节点。
| 总生成时间 | ~620秒 (10分20秒) | ~1.9秒 | 326倍 |
| 主线程阻塞时间 | ~600秒 (页面完全卡死) | < 0.1秒 (异步) | – |
| 最终PDF文件大小 | 48.7 MB | 4.2 MB | 体积减小91% |
| 文字可搜索/可选 | 是 | 是 | – |
| 放大至500%清晰度 | 矢量清晰 | 矢量清晰 | – |
从表格数据可以清晰地看到,基于Rust/WASM的v2版本在生成速度和文件体积上带来了数量级的改善。更重要的是,由于渲染在后台的Web Worker中进行,主线程完全不被阻塞,用户可以继续操作页面,这是传统方案绝对无法做到的用户体验。
# 用于性能测试的简单命令(示意),模拟调用生成接口
curl -X POST http://localhost:8080/generate \\
-H "Content-Type: application/json" \\
-d @./test-doc-500-pages.json \\
-o ./output.pdf
# 使用time命令计时
# time curl … (此处省略重复参数)
# real 0m1.95s
# user 0m0.10s
# sys 0m0.20s
测试脚本证明,即使是串行调用,生成500页PDF也仅需不到2秒。
八、工程化落地:Web Worker 与消息通信设计
要将强大的Rust引擎无缝集成到前端工程,合理的工程化封装至关重要。我们采用经典的主Worker-从Worker模式。
- 主Worker(编排者):运行在主浏览器线程或一个专门的Worker中。负责接收上层应用的调用(如generatePDF(htmlString)),执行DOM解析和分页,将生成的页面JSON发送给从Worker池。
- 从Worker池(渲染者):一个预先创建的Web Worker数组。每个Worker加载并实例化Rust WASM模块。它们从消息队列中领取页面JSON,独立渲染,完成后将二进制页面数据发回主Worker。
这种设计的好处是:
以下是前端编排逻辑的简化代码:
// main-worker.js
let workerPool = [];
const NUM_WORKERS = navigator.hardwareConcurrency || 4;
// 初始化Worker池
for (let i = 0; i < NUM_WORKERS; i++) {
const worker = new Worker('pdf-render-worker.js');
worker.onmessage = handleWorkerMessage;
workerPool.push({ worker, busy: false });
}
async function generatePDF(htmlString) {
// 1. 主Worker中进行DOM解析和分页,得到pagesJSON
const pagesJSON = await parseAndPaginate(htmlString);
const totalPages = pagesJSON.length;
// 2. 为每个Worker分配页面任务
let pageIndex = 0;
const pdfPages = new Array(totalPages);
function assignTasks() {
for (let i = 0; i < workerPool.length; i++) {
if (!workerPool[i].busy && pageIndex < totalPages) {
const worker = workerPool[i].worker;
workerPool[i].busy = true;
worker.postMessage({
type: 'render-page',
pageIndex: pageIndex,
pageData: pagesJSON[pageIndex], // 发送单页数据
totalPages: totalPages
});
pageIndex++;
}
}
}
assignTasks(); // 启动第一批任务
// … 后续通过handleWorkerMessage回调,收集结果并组装最终PDF
}
通过Worker池并行处理,将500页任务分散到多个核心上,是实现2秒极速生成的工程基础。
九、超越生成:探索 PDF 的交互与高级特性
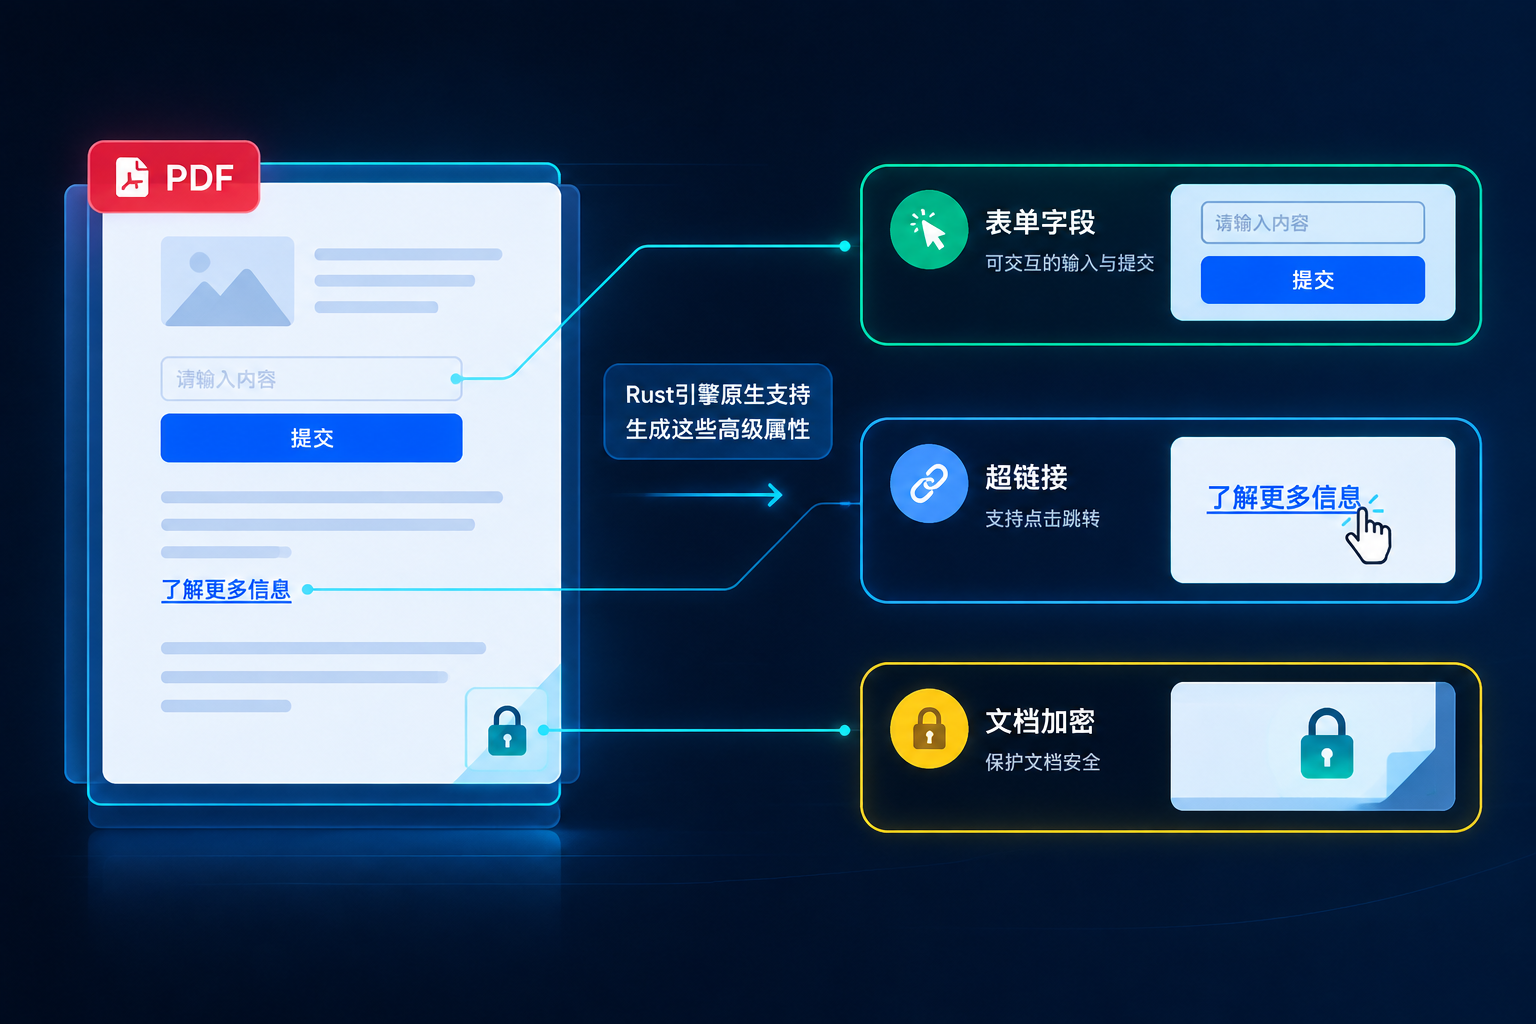
新的Rust引擎不仅能生成静态页面,还为PDF添加交互性奠定了坚实基础。由于我们完全控制了底层的PDF对象,实现AcroForm表单、超链接、文档加密等高级特性变得可行。
- 交互式表单:可以定义文本框、复选框、下拉菜单等字段。Rust引擎负责生成对应的表单字段字典和控件流。
- 超链接与书签:可以解析HTML中的<a>标签,将其转换为PDF的Link注释,并为章节标题生成文档大纲(书签)。
- 文档安全:支持设置打开密码、权限密码,以及禁止打印、复制等操作。这通过在PDF trailer中添加加密字典实现。
这些高级特性是基于html2canvas的位图PDF方案完全无法实现的,也是基于jsPDF的v1版本难以优雅实现的。新的Rust架构让我们在生成高质量矢量内容的同时,能够系统地、高效地集成这些企业级功能。
十、总结与展望:前端PDF生成的新纪元
本次从jsPDF到Rust/WASM的架构重构,不是一次简单的优化,而是一次范式的迁移。它将PDF生成这一重计算任务,从JavaScript主线程的枷锁中解放出来,交给了更合适、更强大的工具链去处理。
这次迁移带来的核心收益可以概括为:
- 极致性能:数量级的速度提升和零主线程阻塞。
- 极致质量:原生矢量PDF,体积小、清晰度高、可交互。
- 极致可控:从字体处理到PDF编码的全栈自研,为后续功能扩展扫清了障碍。
展望未来,这条路还有更广阔的探索空间。例如,将Rust引擎进一步编译为原生桌面应用(通过tauri或wry),实现服务端批量PDF生成;或者利用WebGPU,在浏览器中加速更复杂的图形渲染。前端的边界,正在被Rust和WebAssembly不断拓宽。
结语
通过将核心渲染引擎用Rust重写并编译为WASM,我们彻底解决了前端生成大规模矢量PDF的性能与质量难题。2秒生成500页不再是宣传噱头,而是实实在在的工程能力。这套方案将PDF生成从“可用”推向了“好用”乃至“卓越”的新层次,为各类需要复杂文档导出的应用提供了坚实的技术底座。
当JavaScript的性能边界被WASM打破,前端的能力半径将再次被重新定义。