前言
Prometheus 能发现问题,并不等于告警就真的“送到了人手里”。我更容易遇到的反而是后半段:规则已经触发,Alertmanager 也在运行,但钉钉群没有消息;或者告警能发,恢复通知却没回来;再往后把 Prometheus 和 Alertmanager 拆到不同网络,原本在局域网里正常的链路又突然中断。对我来说,这类问题最怕把所有组件混在一起看,因为 Prometheus、Alertmanager、prometheus-webhook-dingtalk、钉钉机器人和公网连接其实各自只负责一段。更麻烦的是,通知链一旦配置得太复杂,真正故障时很容易出现“监控明明报警了,但没人知道卡在哪一跳”的情况,所以我更习惯先把单群、恢复通知和网络连通逐层跑通,再去扩展多群和固定地址。
这次我按一条完整链路重新走了一遍:先让 Prometheus 指向 Alertmanager,再创建钉钉自定义机器人并保存 Webhook;随后用 Docker 部署 prometheus-webhook-dingtalk,把 Alertmanager 的 receiver 指向 8060 服务,并开启 send_resolved: true。单群告警确认成功以后,再继续做双群广播示例。最后把 Prometheus 与 Alertmanager 放到不同网络,通过 cpolar 把 Alertmanager 的 9093 端口映射为 TCP 公网地址,再切换到固定 TCP。我更看重的是每一跳有没有真正验证,而不是看到钉钉弹出一条消息就直接宣布整套告警体系已经“生产可用”。
1. 先把告警链路拆开看
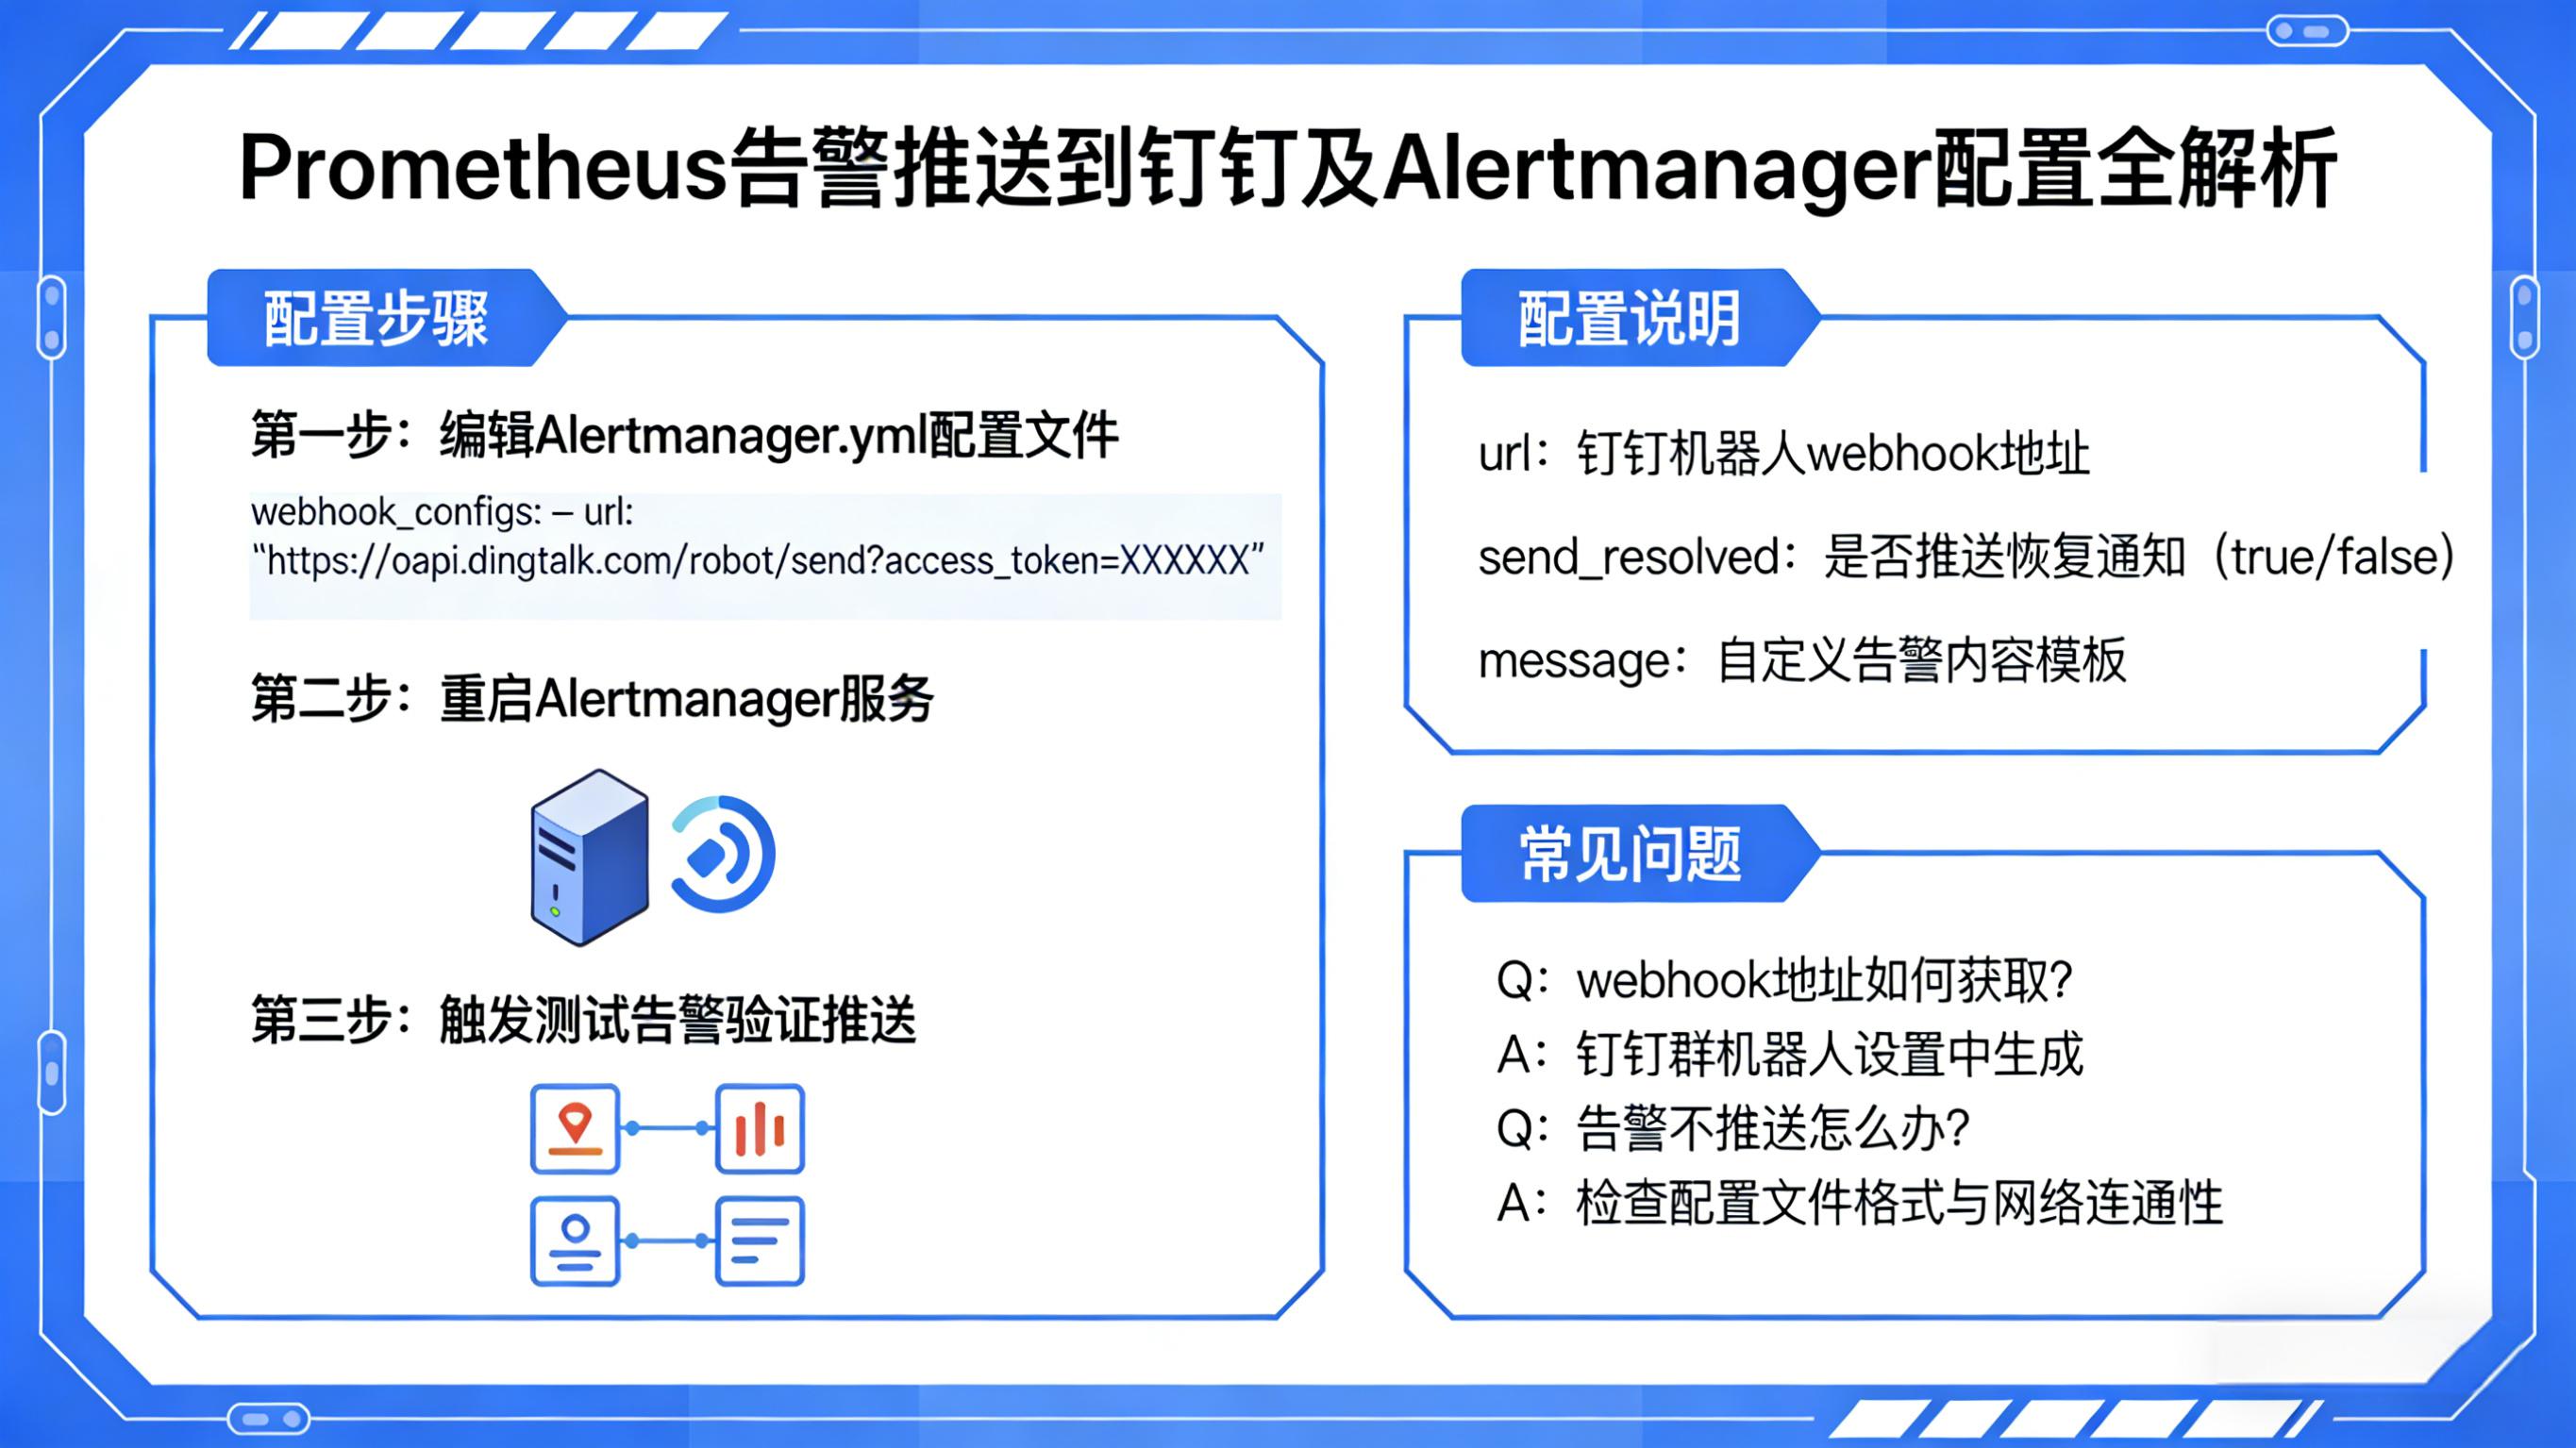
这一套配置里有四个核心角色:
- Prometheus:采集指标,并根据规则触发告警;
- Alertmanager:接收告警,负责分组、路由和通知;
- prometheus-webhook-dingtalk:把 Alertmanager 的 Webhook 请求转换成钉钉机器人能接收的消息;
- 钉钉机器人:最终把消息送到群里。
所以最基础的链路其实是:
Prometheus → Alertmanager → prometheus-webhook-dingtalk → 钉钉机器人。
如果后面 Prometheus 和 Alertmanager 不在同一个网络,再在它们之间增加 cpolar:
Prometheus → cpolar TCP 公网入口 → Alertmanager 9093 → webhook-dingtalk → 钉钉。
把这几层分开以后,哪一段断了就查哪一段,不需要一上来把所有配置都推倒重来。
2. 前提条件先确认
当前环境要求已经具备:
如果 Alertmanager 和 webhook 服务部署在同一台主机,还要注意 Docker 网络隔离问题。
先检查 Docker:
docker –version
3. 先让 Prometheus 指向 Alertmanager
进入 Prometheus 配置文件,按当前环境配置 Alertmanager。
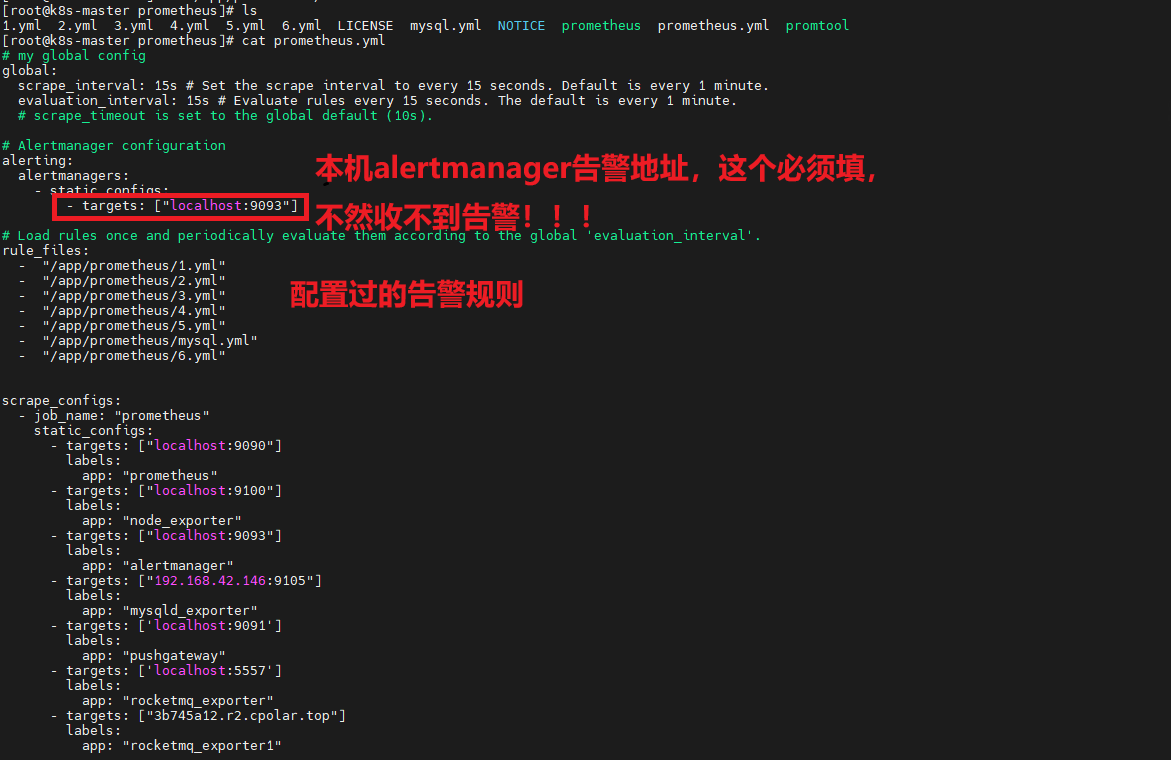
修改以后重启 Prometheus:
systemctl restart prometheus
这一层的目标很简单:
Prometheus 触发的告警,要先能够送到 Alertmanager。
后面的钉钉通知都建立在这一步正常的基础上。
4. 创建钉钉自定义机器人
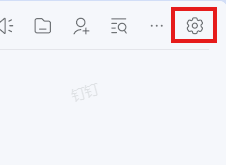
打开钉钉群,进入右上角设置。
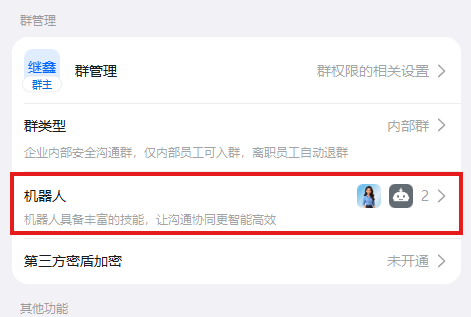
找到【智能群助手】,开始添加机器人。
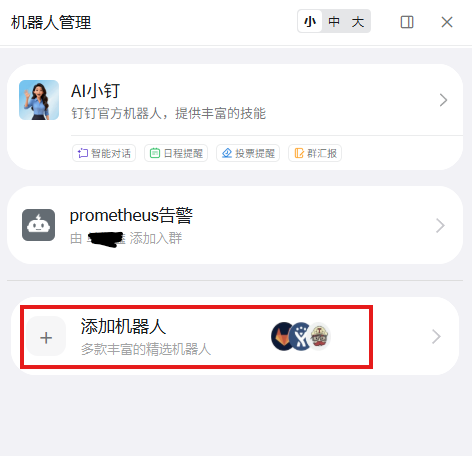
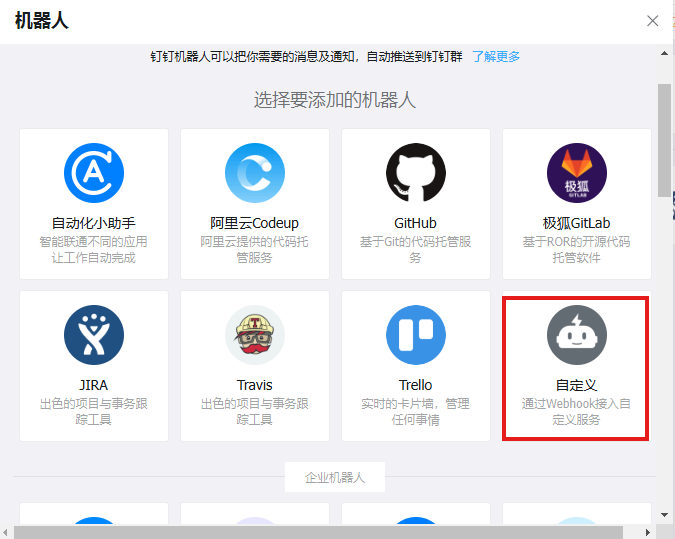
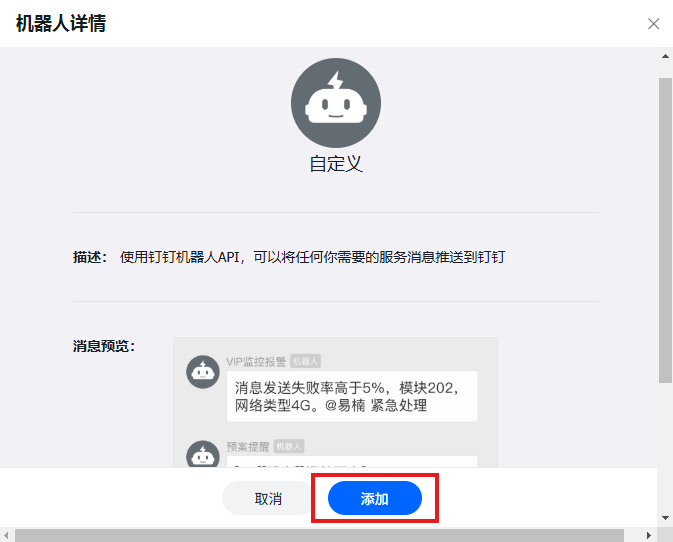
选择自定义机器人。
继续点击添加。
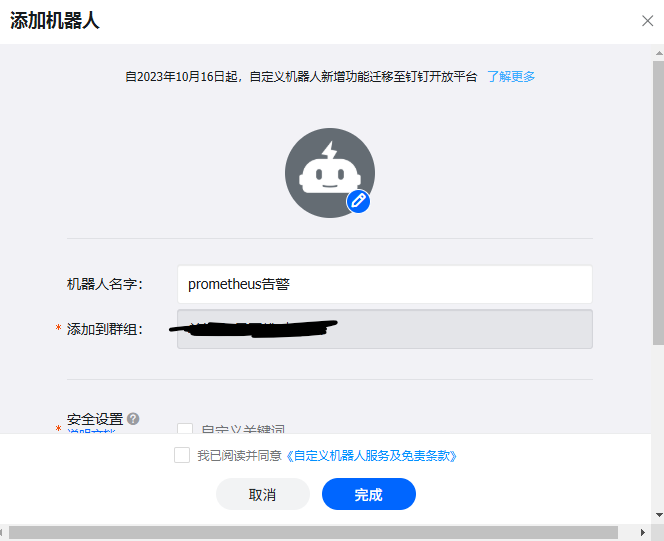
给机器人设置名称,当前示例使用:
prometheus告警
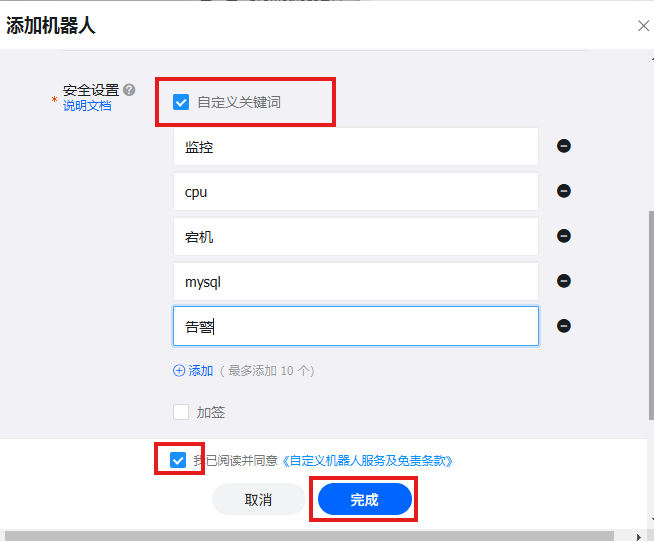
接着配置机器人安全限制。
当前流程使用关键词方式,同时也提到可以设置:
- 加签;
- IP 地址。
完成以后复制生成的 Webhook,后面要写进 dingtalk.yaml。
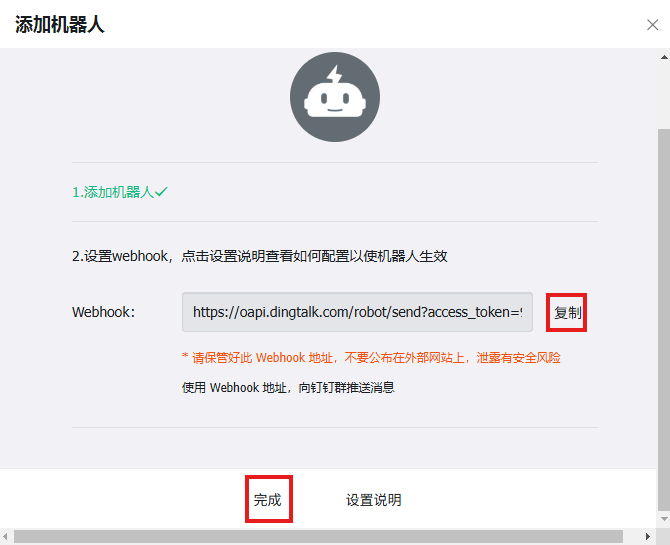
这里的 Webhook 本质上就是机器人通知入口,拿到以后不要随意公开。
5. 部署 prometheus-webhook-dingtalk
先创建:
dingtalk.yaml
内容如下:
cat > dingtalk.yaml <<EOF
targets:
webhook1:
url: https://oapi.dingtalk.com/robot/send?access_token=你的_access_token
EOF
这里定义了一个:
webhook1
目标,URL 使用刚才钉钉机器人生成的 Webhook。
然后启动容器:
docker run -d \\
–name dingtalk-webhook \\
-p 8060:8060 \\
-v $(pwd)/dingtalk.yaml:/etc/prometheus-webhook-dingtalk/config.yml \\
–restart always \\
timonwong/prometheus-webhook-dingtalk:latest
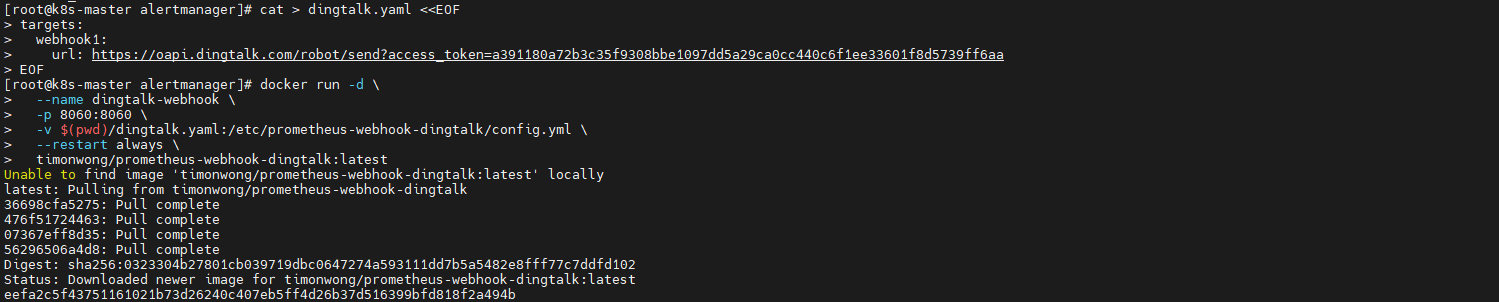
当前几个关键参数是:
- 容器名:dingtalk-webhook
- 对外端口:8060
- 配置文件:dingtalk.yaml
- 容器配置路径:/etc/prometheus-webhook-dingtalk/config.yml
- 镜像:timonwong/prometheus-webhook-dingtalk:latest
到这里,钉钉机器人和中间转换服务已经准备好。
6. 配置 Alertmanager 把告警送到钉钉
打开 Alertmanager 配置文件:
vi alertmanager.yml
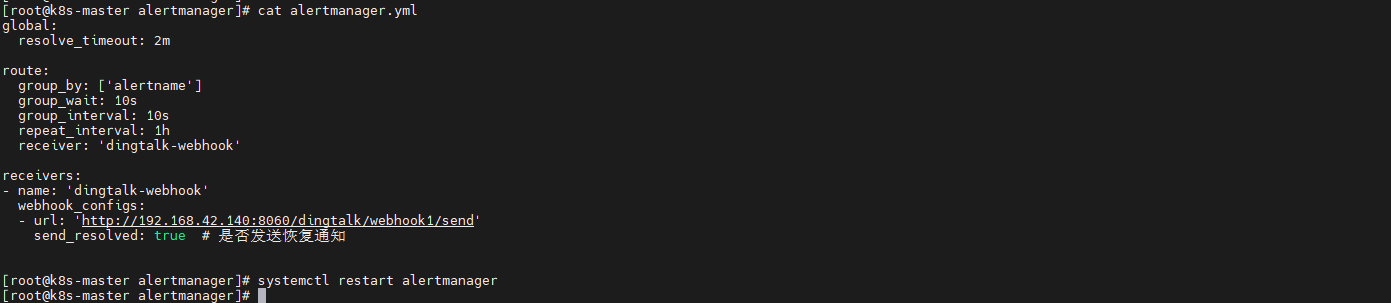
当前配置如下:
global:
resolve_timeout: 2m
route:
group_by: ['alertname']
group_wait: 10s
group_interval: 10s
repeat_interval: 1h
receiver: 'dingtalk-webhook'
receivers:
– name: 'dingtalk-webhook'
webhook_configs:
– url: 'http://<你的服务器IP> :8060/dingtalk/webhook1/send'
send_resolved: true
这段配置里,我最关注三个地方。
第一,receiver 是:
dingtalk-webhook
第二,Webhook 地址指向:
http://<你的服务器IP> :8060/dingtalk/webhook1/send
第三:
send_resolved: true
表示恢复状态也会继续发送。
修改以后重启 Alertmanager:
systemctl restart alertmanager
这里 <你的服务器IP> 要换成运行 prometheus-webhook-dingtalk 的主机 IP。
如果 Alertmanager 和 webhook 服务在同一台机器,当前说明提到可以使用 127.0.0.1,但同时也提醒要注意 Docker 网络问题。
当前告警已经能够送出。
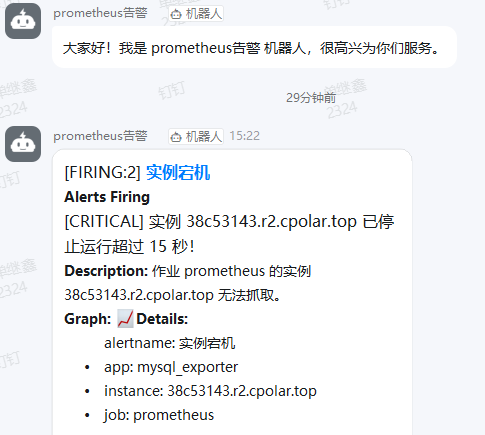
这一步真正验证的是:
Prometheus → Alertmanager → 8060 webhook-dingtalk → 钉钉群。
7. 多个钉钉群怎么发?
如果需要把同一组告警同时送到多个群,可以继续增加 target。
先编辑:
vi dingtalk.yaml
当前示例配置两个群:
targets:
ops-team:
url: https://oapi.dingtalk.com/robot/send?access_token=a391180a72b3c35f9308bbe1097dd5a29ca0cc440c6f1ee33601f8d5739ff6aa
secret: secret1
dev-team:
url: https://oapi.dingtalk.com/robot/send?access_token=3e373b6623264d1c71098acde924328d0e16753820a17475aa95bd6655111e04
secret: secret2
这里分别定义:
- ops-team
- dev-team
然后重新启动 webhook 容器:
docker run -d \\
–name dingtalk-webhook \\
-p 8060:8060 \\
-v $(pwd)/dingtalk.yaml:/etc/prometheus-webhook-dingtalk/config.yml \\
–restart always \\
timonwong/prometheus-webhook-dingtalk:latest
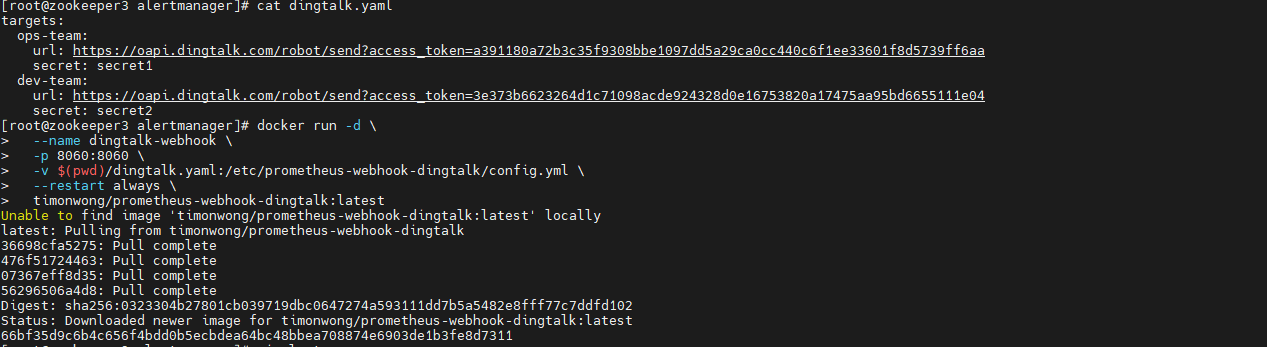
接下来编辑 Alertmanager:
vi alertmanager.yml
当前配置为:
global:
resolve_timeout: 2m
# 主路由:所有告警走这个路径
route:
group_by: ['alertname']
group_wait: 10s
group_interval: 10s
repeat_interval: 1h
receiver: 'broadcast' # ← 指向一个组合 receiver
# 定义 receivers
receivers:
– name: 'broadcast'
webhook_configs:
# 发给 ops 钉钉群
– url: 'http://<你的服务器IP>/dingtalk/ops-team/send'
send_resolved: true
# 发给 dev 钉钉群
– url: 'http://<你的服务器IP>/dingtalk/dev-team/send'
send_resolved: true
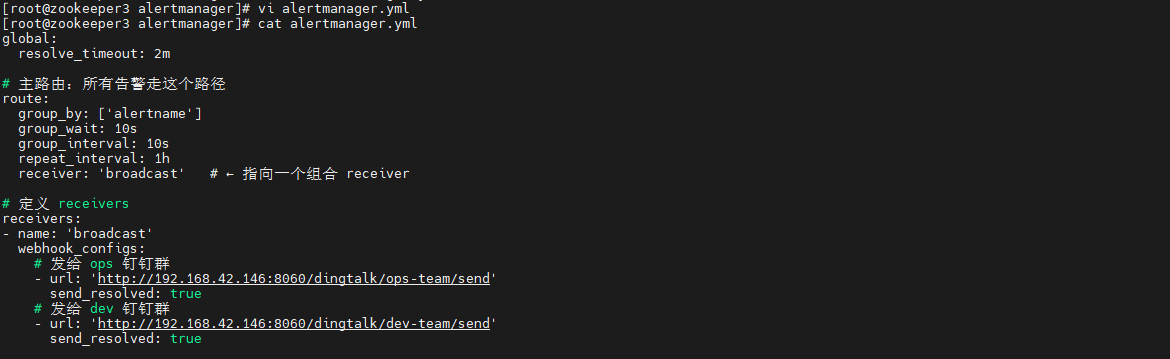
这里使用的是一个名为:
broadcast
的 receiver,并在同一个 receiver 里配置两个 webhook_configs。
所以这个示例真正展示的是:
同一批告警同时广播到 ops 和 dev 两个群。
它还没有进一步展示“按告警标签把不同类型分发给不同团队”的 route 分支,所以我不会把这一段扩大成已经完成了精细化职责路由。
配置完成以后重启 Alertmanager:
systemctl restart alertmanager
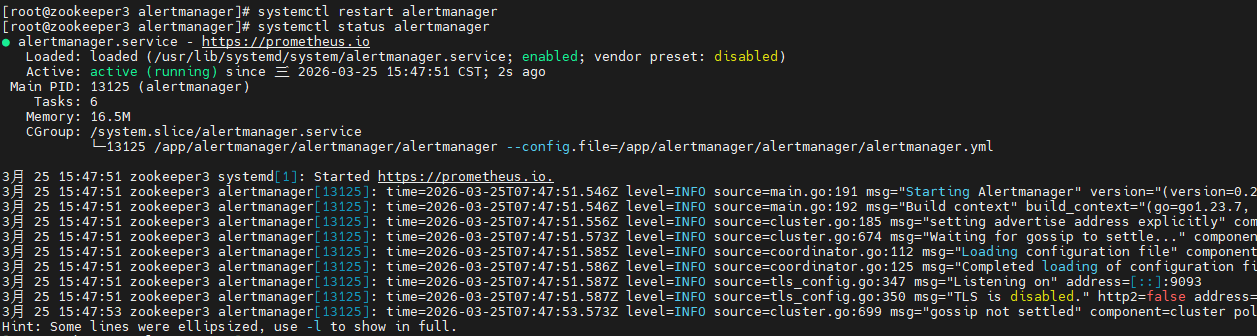
稍等以后,两个群里都能看到告警。
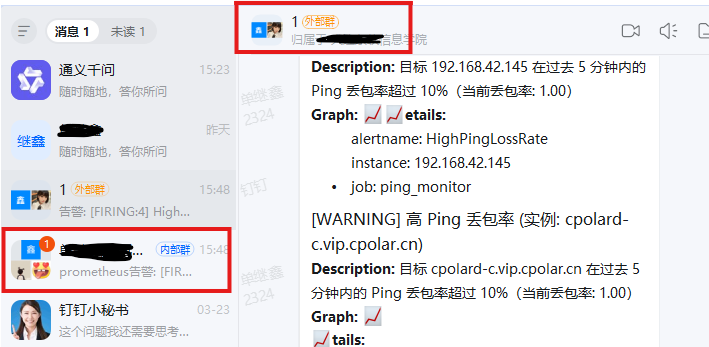
这里还有一个需要特别核对的技术细节:前面的单群示例 URL 明确写了 :8060,而这一组双群 receiver URL 没有写 8060。两段配置本身并不完全一致,真正复现时要按自己的 webhook 服务监听地址确认。
8. Prometheus 和 Alertmanager 不在同一个网络怎么办?
如果 Prometheus 和 Alertmanager 位于同一个局域网,Prometheus 可以直接把告警送到 Alertmanager 的 9093。
但拆到不同网络以后,Prometheus 就无法再直接访问内网 Alertmanager。
这时候我会把问题限定成一句话:
让 Prometheus 能访问 Alertmanager 的 9093。
cpolar 在这里负责的就是这段网络入口。
它不参与告警规则、分组、钉钉消息转换,也不替 Alertmanager 处理告警。
9. 安装 cpolar
执行:
sudo curl https://get.cpolar.sh | sh
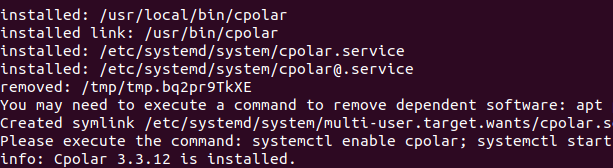
安装完成以后检查服务状态:
sudo systemctl status cpolar
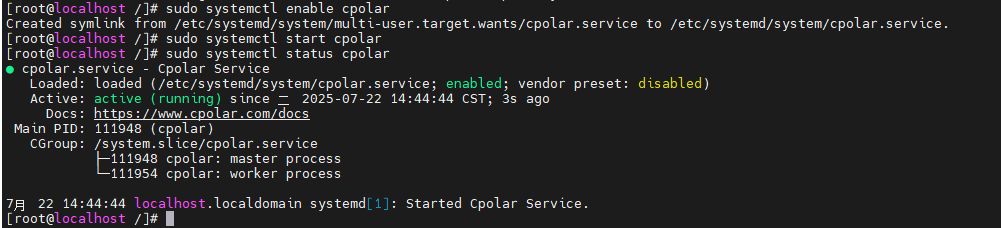
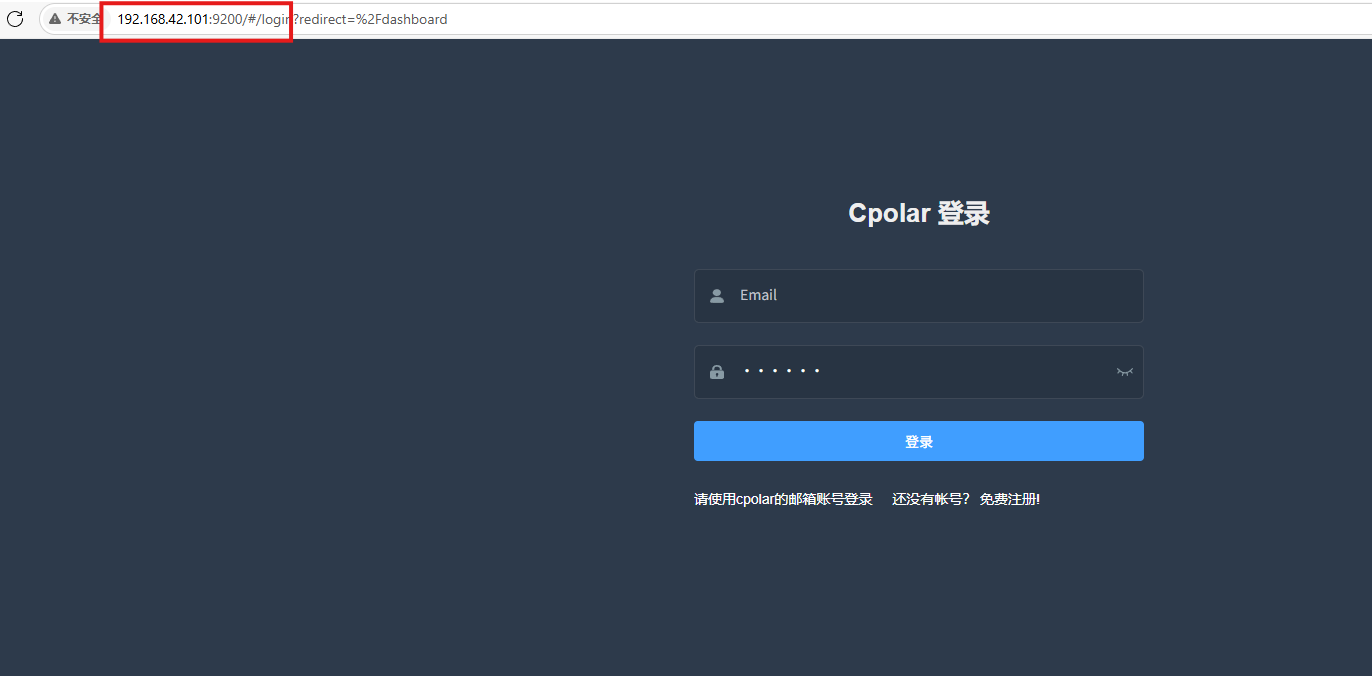
服务正常后,通过主机 IP + 9200 打开 cpolar Web 管理页面。
页面里同时出现:
http://ip:9200
以及链接目标:
http://localhost:9200/
实际访问时,以当前主机真正能够打开的地址为准。
10. 给 Alertmanager 的 9093 创建 TCP 公网入口
进入【隧道管理 → 创建隧道】。
当前配置为:
- 隧道名称:alertmanager
- 协议:tcp
- 本地地址:9093
- 端口类型:随机临时 TCP 端口
- 地区:China Top

创建成功以后,到在线隧道列表查看公网地址。
当前示例得到:
- 域名:2.tcp.cpolar.top
- 公网端口:10409

这时候,Prometheus 就可以把不同网络里的 Alertmanager 当作:
2.tcp.cpolar.top:10409
来访问。
11. 修改 Prometheus 的 Alertmanager 地址
打开:
vi prometheus.yml
写入:
alerting:
alertmanagers:
– static_configs:
– targets: ["2.tcp.cpolar.top:10409"]

这样 Prometheus 的 Alertmanager target 就从局域网地址切换到了 cpolar TCP 公网地址。
后面的重启命令当前写的是:
systemctl restart alertmanager
这一点需要特别注意:这里修改的是 prometheus.yml,但紧接着执行的却是 systemctl restart alertmanager。两处操作并不对应,我保留这条现有命令,不在正文里替换;真正操作时要确认自己需要重载的是哪一个服务。
重启以后,钉钉仍然能够收到告警。

这一步说明跨网络链路在当前测试中仍然能够继续工作:
Prometheus → 2.tcp.cpolar.top:10409 → Alertmanager 9093 → webhook-dingtalk → 钉钉。
12. 随机 TCP 能用以后,再换固定地址
随机 TCP 地址适合先确认跨网络告警链路。
如果 Prometheus 要长期使用这个 Alertmanager,地址固定下来更容易维护。
当前步骤进入 TCP 地址预留。

区域选择页面当前显示:
China VIP
后面的保留结果又记录为:
-
地区:China Top
-
地址:3.tcp.cpolar.top:11755

这两处地区文字按当前步骤分别保留。
接着回到 cpolar Web UI,进入隧道列表。
到这一步,说明文字写的是找到:
ssh
隧道。

但前面真正创建的隧道名称是:
alertmanager
所以实际操作时,应确认自己编辑的是指向本地 9093 的那条 Alertmanager TCP 隧道。
把端口类型修改为:
固定TCP端口
再填写保留成功的 TCP 地址。

更新以后,到在线隧道列表查看。

当前公网地址已经切换成固定 TCP 形式。
13. 这条告警链我会怎么判断是否真的跑通
我不会只看“钉钉出现一条消息”就结束。
至少会把整条链分成三段确认:
第一段:Prometheus → Alertmanager
确认 Prometheus 的 alertmanager target 指向正确。
第二段:Alertmanager → webhook-dingtalk → 钉钉
确认 receiver、8060、机器人 Webhook 和 send_resolved: true 对应。
第三段:跨网络 Prometheus → cpolar → Alertmanager 9093
确认随机 TCP 能工作,再切换固定 TCP。
这样以后无论是钉钉不响、恢复通知缺失,还是 Prometheus 和 Alertmanager 分网后突然断链,都能先判断是哪一段出了问题。
总结
这次最有价值的不是“终于把告警发进钉钉”,而是把一条容易混在一起的通知链拆开了。
从单群到双群,再到跨网络 Alertmanager,核心关系始终没变:
Prometheus 负责触发 → Alertmanager 负责路由 → prometheus-webhook-dingtalk 负责格式转换 → 钉钉机器人负责送达;如果 Prometheus 和 Alertmanager 不在同一网络,cpolar 只补上 9093 这一段连接。
这样配置以后,我更愿意先关注告警是不是准确、恢复通知有没有回来、谁真正需要收到这条消息,而不是一味增加通知渠道。监控的价值不在于群里更热闹,而在于真正出问题时,正确的人能看到一条足够清楚、可以继续行动的告警。