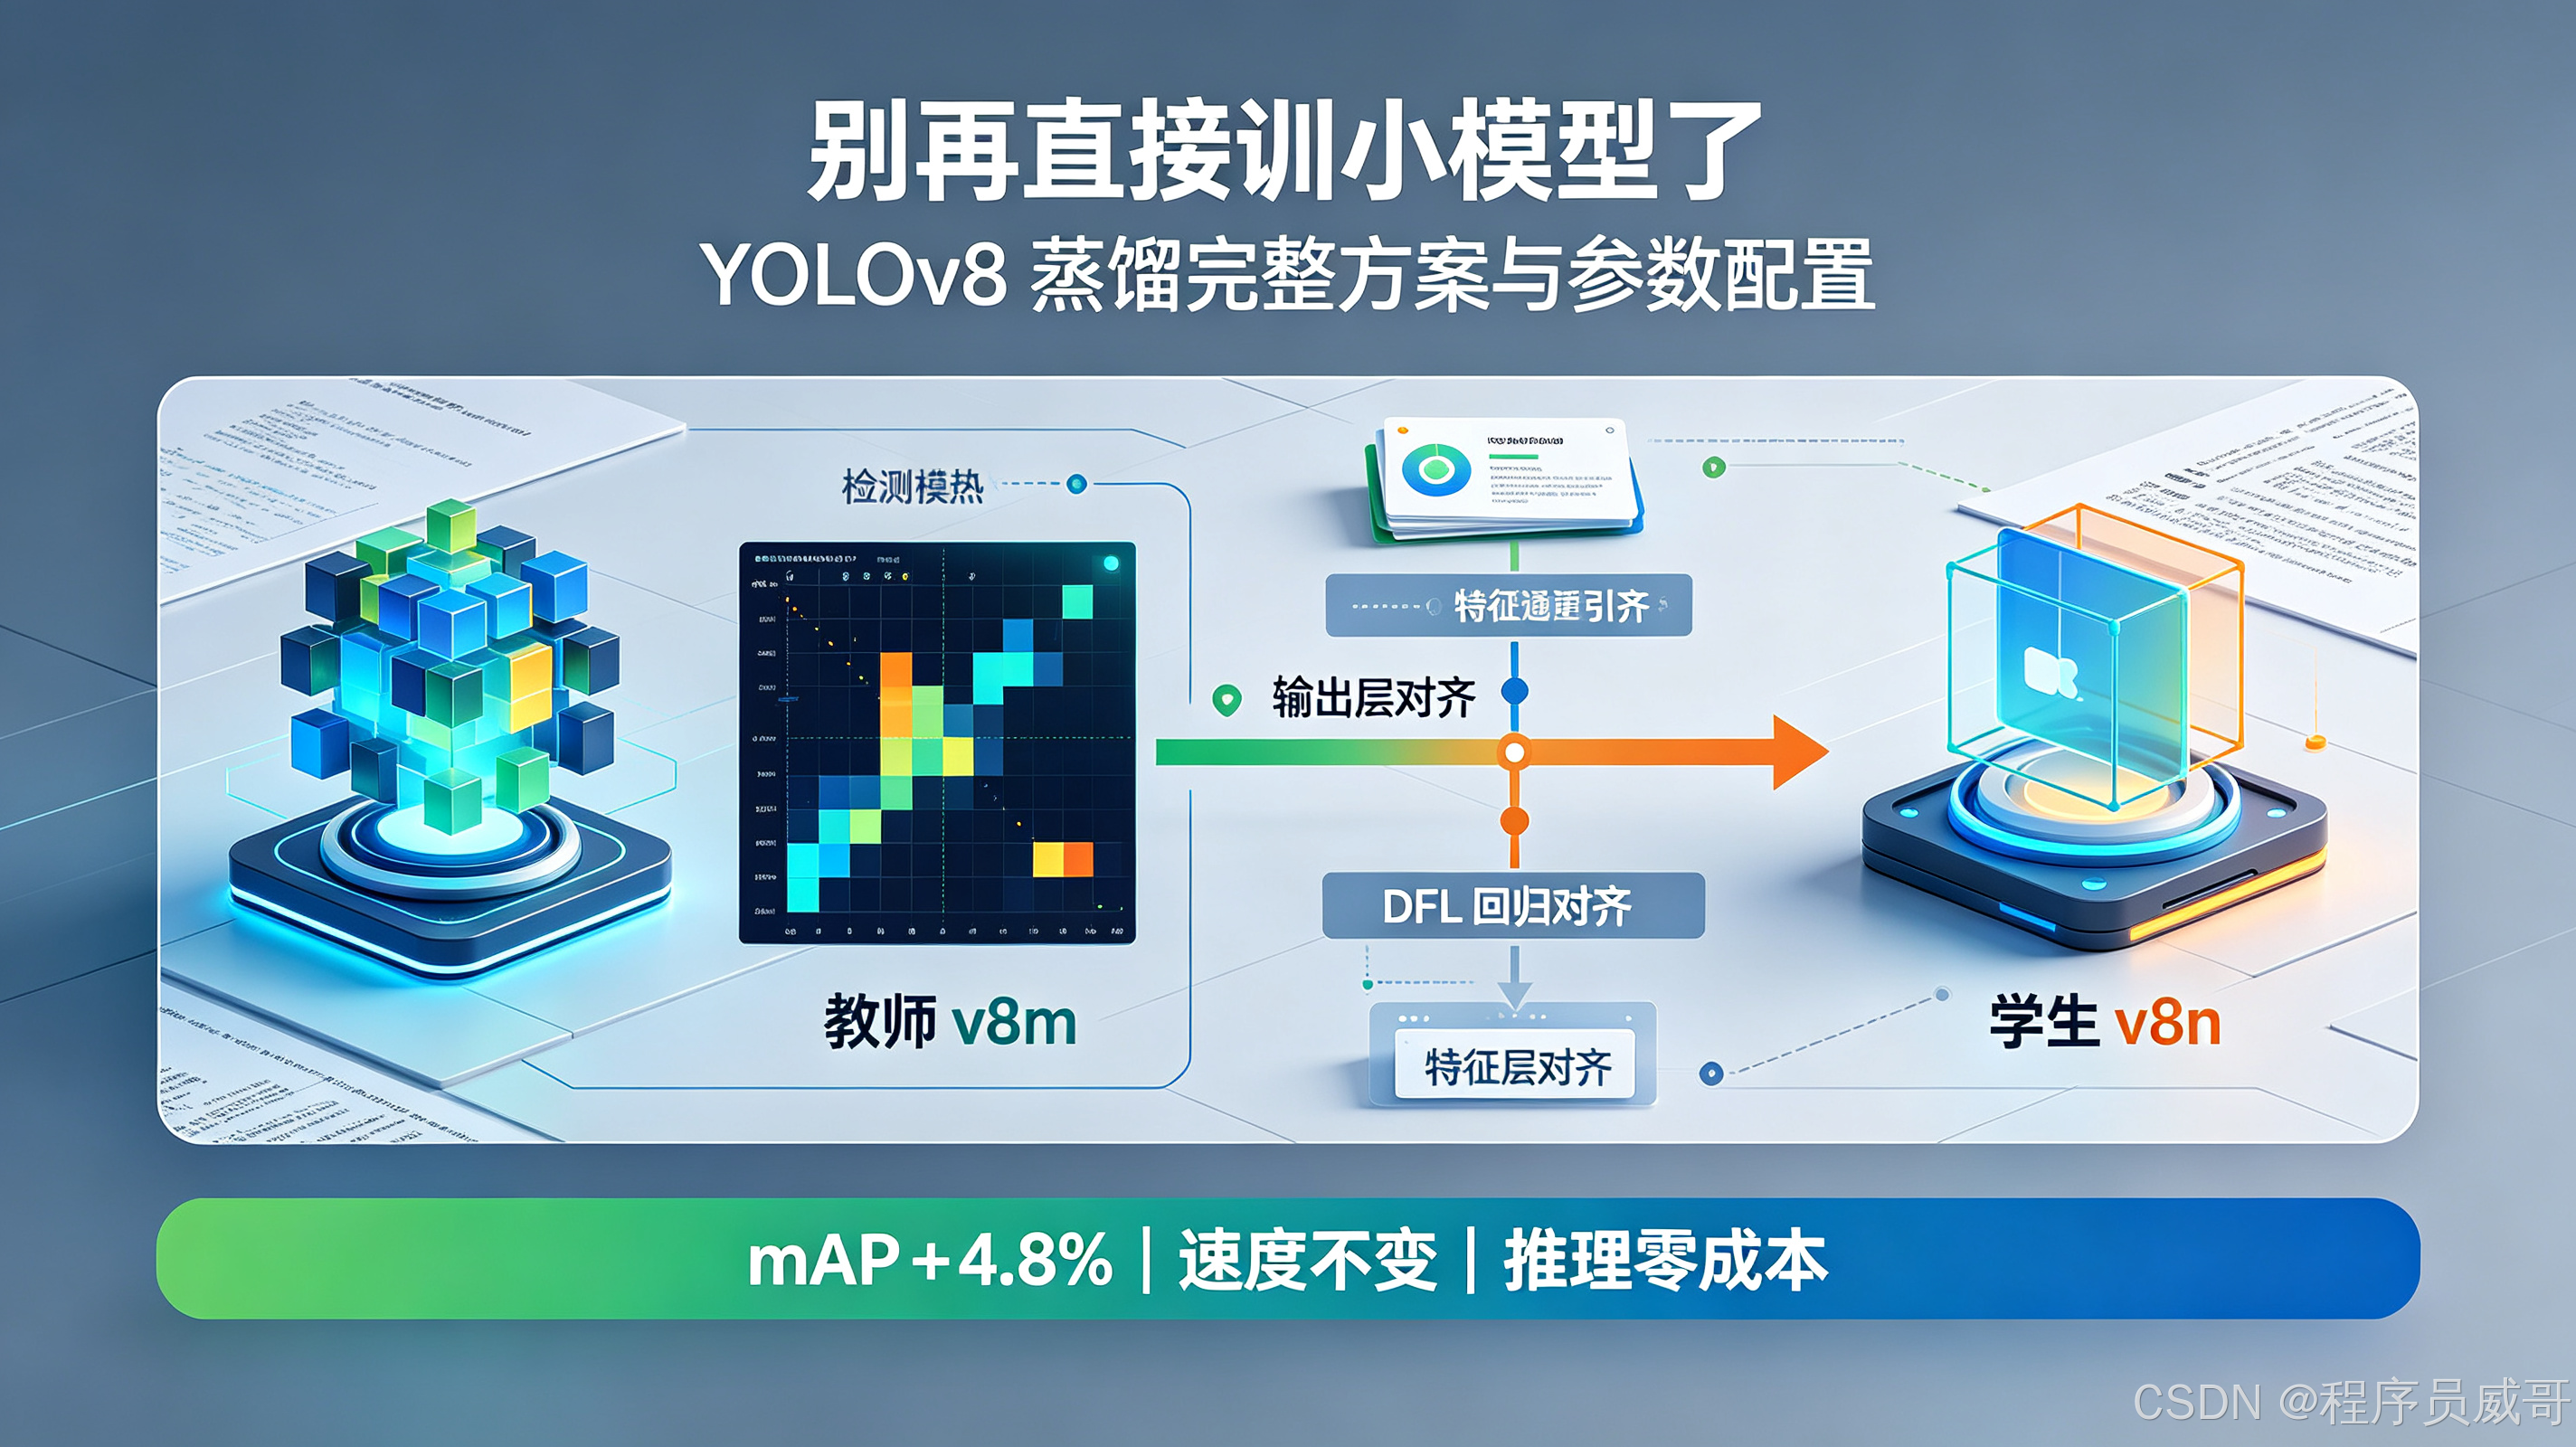
最近在做工业缺陷检测的边缘端部署,目标是在嵌入式平台上做到30FPS以上的实时检测。最开始直接用YOLOv8n,速度确实达标,但实测mAP比v8m差了近12个点,小缺陷漏检很严重;换成v8s精度是够了,但帧率直接砍半,端侧算力扛不住。
试过结构化剪枝、INT8量化,要么精度掉得没法看,要么优化后的收益抵不上调参的成本。最后转向知识蒸馏,用YOLOv8m当教师模型去蒸馏v8n,最终在参数量、推理速度完全不变的前提下,mAP@0.5提升了4.8个百分点,基本摸到了v8s的精度门槛,部署成本却没加一分钱。
网上关于YOLOv8蒸馏的文章不少,但很多都是直接套用YOLOv5的旧方案,实际跑起来要么不涨点,反而掉点。踩了一圈坑才发现,YOLOv8的C2f结构、DFL回归损失、TaskAligned分配策略,和v5的差异非常大,蒸馏方案必须针对性适配才行。这篇文章就把我们验证有效的完整蒸馏方案、参数配置和踩坑总结全部分享出来。
一、为什么很多人做YOLOv8蒸馏没效果
知识蒸馏的核心逻辑很简单:用训练好的大模型(教师)输出的软标签、中间特征来指导小模型(学生)训练,让小模型学到大模型的“暗知识”,而不只是硬标签的对错。理论上,学生模型可以在不增加参数量的前提下,获得更接近教师的精度。
但很多人实际做下来,发现YOLOv8蒸馏要么涨点不到1%,要么直接掉点,核心原因就是直接照搬YOLOv5的蒸馏方案,没有适配v8的结构变化:
很多人拿v5时代的蒸馏代码改个模型名就用,本质上是只做了半吊子的分类蒸馏,回归分支和特征层完全没对齐,效果自然好不了。
二、整体蒸馏方案设计
我们的方案是“输出层蒸馏+中间特征蒸馏”双路结合,教师模型用YOLOv8m,学生用YOLOv8n,全程冻结教师权重,只更新学生参数。
#mermaid-svg-01tFVkNy6oXMyZhg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-01tFVkNy6oXMyZhg .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-01tFVkNy6oXMyZhg .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-01tFVkNy6oXMyZhg .error-icon{fill:#552222;}#mermaid-svg-01tFVkNy6oXMyZhg .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-01tFVkNy6oXMyZhg .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-01tFVkNy6oXMyZhg .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-01tFVkNy6oXMyZhg .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-01tFVkNy6oXMyZhg .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-01tFVkNy6oXMyZhg .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-01tFVkNy6oXMyZhg .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-01tFVkNy6oXMyZhg .marker{fill:#333333;stroke:#333333;}#mermaid-svg-01tFVkNy6oXMyZhg .marker.cross{stroke:#333333;}#mermaid-svg-01tFVkNy6oXMyZhg svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-01tFVkNy6oXMyZhg p{margin:0;}#mermaid-svg-01tFVkNy6oXMyZhg .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-01tFVkNy6oXMyZhg .cluster-label text{fill:#333;}#mermaid-svg-01tFVkNy6oXMyZhg .cluster-label span{color:#333;}#mermaid-svg-01tFVkNy6oXMyZhg .cluster-label span p{background-color:transparent;}#mermaid-svg-01tFVkNy6oXMyZhg .label text,#mermaid-svg-01tFVkNy6oXMyZhg span{fill:#333;color:#333;}#mermaid-svg-01tFVkNy6oXMyZhg .node rect,#mermaid-svg-01tFVkNy6oXMyZhg .node circle,#mermaid-svg-01tFVkNy6oXMyZhg .node ellipse,#mermaid-svg-01tFVkNy6oXMyZhg .node polygon,#mermaid-svg-01tFVkNy6oXMyZhg .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-01tFVkNy6oXMyZhg .rough-node .label text,#mermaid-svg-01tFVkNy6oXMyZhg .node .label text,#mermaid-svg-01tFVkNy6oXMyZhg .image-shape .label,#mermaid-svg-01tFVkNy6oXMyZhg .icon-shape .label{text-anchor:middle;}#mermaid-svg-01tFVkNy6oXMyZhg .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-01tFVkNy6oXMyZhg .rough-node .label,#mermaid-svg-01tFVkNy6oXMyZhg .node .label,#mermaid-svg-01tFVkNy6oXMyZhg .image-shape .label,#mermaid-svg-01tFVkNy6oXMyZhg .icon-shape .label{text-align:center;}#mermaid-svg-01tFVkNy6oXMyZhg .node.clickable{cursor:pointer;}#mermaid-svg-01tFVkNy6oXMyZhg .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-01tFVkNy6oXMyZhg .arrowheadPath{fill:#333333;}#mermaid-svg-01tFVkNy6oXMyZhg .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-01tFVkNy6oXMyZhg .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-01tFVkNy6oXMyZhg .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-01tFVkNy6oXMyZhg .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-01tFVkNy6oXMyZhg .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-01tFVkNy6oXMyZhg .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-01tFVkNy6oXMyZhg .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-01tFVkNy6oXMyZhg .cluster text{fill:#333;}#mermaid-svg-01tFVkNy6oXMyZhg .cluster span{color:#333;}#mermaid-svg-01tFVkNy6oXMyZhg div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-01tFVkNy6oXMyZhg .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-01tFVkNy6oXMyZhg rect.text{fill:none;stroke-width:0;}#mermaid-svg-01tFVkNy6oXMyZhg .icon-shape,#mermaid-svg-01tFVkNy6oXMyZhg .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-01tFVkNy6oXMyZhg .icon-shape p,#mermaid-svg-01tFVkNy6oXMyZhg .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-01tFVkNy6oXMyZhg .icon-shape .label rect,#mermaid-svg-01tFVkNy6oXMyZhg .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-01tFVkNy6oXMyZhg .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-01tFVkNy6oXMyZhg .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-01tFVkNy6oXMyZhg :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
输入图像
教师模型 YOLOv8m 冻结权重
学生模型 YOLOv8n 可训练
骨干最终特征层
检测头输出 分类+DFL回归
骨干最终特征层
检测头输出 分类+DFL回归
特征蒸馏损失 L2
分类蒸馏损失 KL散度
回归蒸馏损失 KL散度
硬标签损失 分类+回归
真实标签
总损失
更新学生模型参数
整体损失由三部分加权组成:
- 硬标签损失:学生模型输出和真实标签的损失,和正常训练一致,作为主导损失。
- 输出层蒸馏损失:分为分类和回归两部分,都是用KL散度对齐教师和学生的输出分布。
- 特征层蒸馏损失:对齐骨干网络最后一层的特征图,让学生学习教师的特征提取能力。
这里特别说一下,很多蒸馏方案只做输出层,对于v8n这种参数量很小的模型来说,学习能力有限,只学最终输出很难摸到教师的深层逻辑。加上中间特征层的引导,涨点效果会非常明显。
三、核心细节与参数配置
这部分是整个方案的关键,参数调不对,结构再对也没用。
1. 教师模型的选择
很多人觉得教师模型越大越好,直接上v8l甚至v8x,其实未必。教师和学生的模型容量差距越大,特征空间的差异就越大,学生越难对齐。
我们对比过v8s、v8m、v8l三个教师蒸馏v8n的效果:
- v8s教v8n:mAP涨2.1%,提升有限,因为教师本身精度不高。
- v8m教v8n:mAP涨4.8%,收益最高,性价比最好。
- v8l教v8n:mAP涨4.5%,反而不如v8m,而且训练速度慢很多。
所以对于v8n来说,v8m是最优的教师选择,两者结构层级一致,特征维度差异可控,学生能有效吸收教师的暗知识。
2. 输出层蒸馏:分类+回归双对齐
分类蒸馏
分类分支用KL散度计算软标签损失,和常规做法一致,但要注意两个点:
- YOLOv8的分类输出是sigmoid后的概率,计算KL前要先做温度缩放再计算分布距离。
- 温度系数T设为4,太高会让软标签太平滑,失去区分度;太低会接近硬标签,失去蒸馏意义。
回归蒸馏
这是绝大多数人做错的地方。YOLOv8的回归分支输出的是DFL分布,一共16个概率值,对应边界框的坐标分布,而不是4个坐标值。
很多人直接用MSE损失去对齐4个预测坐标,这完全忽略了DFL的分布信息,蒸馏效果微乎其微。正确的做法是对DFL的输出分布做KL散度,让学生学习教师的坐标分布置信度。回归蒸馏的温度系数T设为2,因为回归分布的粒度更细,温度太高会模糊位置信息。
3. 特征层蒸馏:通道对齐是前提
骨干最后一层C2f的输出,教师v8m的通道数是576,学生v8n是256,维度不一样,不能直接算损失。
我们用一个1×1的卷积层做通道对齐,把学生的256通道映射到576通道,再和教师的特征图做L2损失。这个1×1卷积只在训练时用,推理的时候直接去掉,完全不影响速度和参数量。
特征蒸馏的权重不要太高,设为0.05就够了,太高会让学生过度拟合教师的特征,反而泛化能力下降。
4. 损失权重配比
总损失 = 硬标签损失 + 0.2 × 分类蒸馏损失 + 0.15 × 回归蒸馏损失 + 0.05 × 特征蒸馏损失
核心原则:硬标签损失永远是主导,蒸馏损失只是辅助。
很多人把蒸馏损失权重设到0.5甚至更高,相当于让学生优先模仿教师,而不是学习真实标签,结果就是学生学歪了,在验证集上掉点。我们试过很多组配比,0.2左右的总蒸馏权重是收益最高的。
四、落地实现与训练策略
1. 核心代码实现
基于ultralytics框架修改,核心是在损失计算部分加入蒸馏损失。这里放最关键的损失函数修改片段:
import torch
import torch.nn as nn
import torch.nn.functional as F
class DistillLoss(nn.Module):
def __init__(self, cls_temp=4.0, reg_temp=2.0, cls_weight=0.2, reg_weight=0.15, feat_weight=0.05):
super().__init__()
self.cls_temp = cls_temp
self.reg_temp = reg_temp
self.cls_weight = cls_weight
self.reg_weight = reg_weight
self.feat_weight = feat_weight
# 特征对齐卷积层:学生通道256 -> 教师通道576
self.feat_adapt = nn.Conv2d(256, 576, kernel_size=1, bias=False)
def kl_loss(self, student_logits, teacher_logits, temperature):
# 计算KL散度蒸馏损失
student_prob = F.log_softmax(student_logits / temperature, dim=–1)
teacher_prob = F.softmax(teacher_logits / temperature, dim=–1)
loss = F.kl_div(student_prob, teacher_prob, reduction='batchmean') * (temperature ** 2)
return loss
def forward(self, student_outputs, teacher_outputs, student_feat, teacher_feat, targets):
# 1. 原始硬标签损失
hard_loss = student_outputs.loss(targets)
# 2. 分类蒸馏损失
cls_student = student_outputs['cls']
cls_teacher = teacher_outputs['cls']
cls_distill_loss = self.kl_loss(cls_student, cls_teacher, self.cls_temp)
# 3. 回归DFL蒸馏损失
reg_student = student_outputs['dfl']
reg_teacher = teacher_outputs['dfl']
reg_distill_loss = self.kl_loss(reg_student, reg_teacher, self.reg_temp)
# 4. 特征蒸馏损失
feat_student = self.feat_adapt(student_feat)
feat_distill_loss = F.mse_loss(feat_student, teacher_feat)
# 总损失加权求和
total_loss = hard_loss + \\
self.cls_weight * cls_distill_loss + \\
self.reg_weight * reg_distill_loss + \\
self.feat_weight * feat_distill_loss
return total_loss
注意:训练前要把教师模型加载并设为eval模式,全程冻结参数,不要参与梯度更新。特征层需要用hook来获取,不要直接修改模型的forward返回值,避免后续推理出问题。
2. 训练策略
蒸馏训练不能完全照搬正常训练的参数,需要针对性调整:
- 训练轮次:比正常训练多30%-50%。比如正常训100epoch,蒸馏建议训150epoch。学生需要更多时间来消化教师的暗知识,轮次不够会导致蒸馏不充分。
- 学习率:初始学习率设为正常训练的0.7倍。有教师引导,不需要太大的学习率,太大容易震荡。
- 预热策略:前10个epoch关闭蒸馏损失,只用硬标签训练,让学生先学到基础的特征,再加入蒸馏引导,效果会更好。
- 数据增强:保持和正常训练一致的增强强度,不要因为蒸馏就减弱Mosaic、Mixup。强增强下的蒸馏效果更稳定,泛化能力更好。
五、实验结果与消融验证
我们在COCO val2017数据集上做了完整的对比实验,训练设备为3090Ti,batch=32,训练150epoch。
| YOLOv8n 原生 | 45.2% | 3.2M | 11.8ms |
| YOLOv8n 蒸馏(仅分类) | 46.7% | 3.2M | 11.8ms |
| YOLOv8n 蒸馏(分类+回归) | 48.9% | 3.2M | 11.8ms |
| YOLOv8n 蒸馏(全方案) | 50.0% | 3.2M | 11.9ms |
| YOLOv8s 原生 | 51.4% | 11.2M | 28.3ms |
| YOLOv8m 原生 | 57.2% | 25.9M | 47.6ms |
从结果可以看到:
- 仅加分类蒸馏,只有1.5个点的提升,效果有限。
- 加上回归DFL蒸馏后,提升到3.7个点,收益非常明显,也印证了回归蒸馏的重要性。
- 再加上特征层蒸馏,最终提升4.8个点,参数量和推理速度几乎没有变化,推理时间只多了0.1ms,完全可以忽略。
- 蒸馏后的v8n,精度已经非常接近原生v8s,但参数量只有v8s的28%,推理速度是v8s的2.4倍,边缘部署的性价比极高。
我们也在自己的工业缺陷检测数据集上做了测试,mAP提升了5.2个点,比COCO上的收益还要高一点,因为工业场景的样本分布更集中,教师的暗知识更有效。
六、常见踩坑总结
这是我们踩了无数坑总结出来的经验,也是绝大多数人蒸馏效果不好的原因。
坑1:回归分支用MSE做蒸馏
这是最常见的错误。YOLOv8用DFL输出坐标分布,不是直接的四个坐标值,MSE只能对齐最终的坐标均值,完全学不到分布的置信度信息,蒸馏效果大打折扣。一定要用KL散度对齐DFL的完整分布。
坑2:蒸馏损失权重过高
很多人觉得蒸馏损失加得越多,学生学得越好。实际上权重超过0.3之后,涨点就会停滞,再高就会开始掉点。硬标签才是学生学习的根本,蒸馏只是锦上添花,不是雪中送炭。
坑3:教师模型选得太大
不要盲目用最大的模型当教师。教师和学生的容量差距要在合理范围内,差太大反而会出现“教不动”的情况。对于v8n来说,v8m是最优解;如果是蒸馏v8s,可以考虑用v8l。
坑4:训练轮次和正常训练一样
蒸馏需要更长的收敛时间。学生既要学硬标签,又要模仿教师的分布,收敛速度会比正常训练慢。轮次不够的话,还没学到位就结束了,看起来像是蒸馏没用,其实是没训完。
坑5:教师模型没冻结或者没设eval
低级但常见的错误。教师模型一定要设为eval模式,并且冻结所有参数,不然训练的时候教师的权重会跟着变,就不是“教师教学生”,变成“俩学生一起瞎学”了。
坑6:特征层直接算损失,不做通道对齐
教师和学生的特征通道数不一样,直接算损失维度都对不上,要么报错,要么强行广播导致完全无效。必须用1×1卷积做通道映射,而且这个卷积只在训练时存在,推理完全不影响。
写在最后
总的来说,知识蒸馏是YOLO小模型提升性价比极高的方案,不需要改模型结构,不需要增加任何推理成本,就能获得可观的精度提升,非常适合边缘部署、端侧检测这类对速度和算力有严格要求的场景。
当然,没有一套参数能通吃所有场景。不同的数据集、不同的学生模型,对应的最优权重、温度、训练轮次都会有差异,但整体的方案思路和避坑原则是通用的。建议大家在自己的数据集上先做小范围的消融实验,找到最合适的参数配比。