9 月 22 日凌晨,小米正式发布并开源了 Xiaomi MiMo-V2.6 系列,包含 Pro 与 Flash 两个原生全模态模型。
如果把时间线拉长一点看,这次发布更像是一份"交付回执"。此前小米在公开直播里把强化学习的训练看板摊开给外界看——几条 RL 训练线、烧了多少钱、跑到第几步——当时很多人将信将疑:账本敢公开是一回事,模型真能打是另一回事。现在权重上线了,榜单也出来了,可以逐条对账。
对开发者来说,这次最值得关心的其实不是"开源第一"这个标题,而是三个更具体的问题:分数是怎么来的?开源的东西除了权重还有什么?以及,我自己跑得动吗?
一、先把分数放到台面上
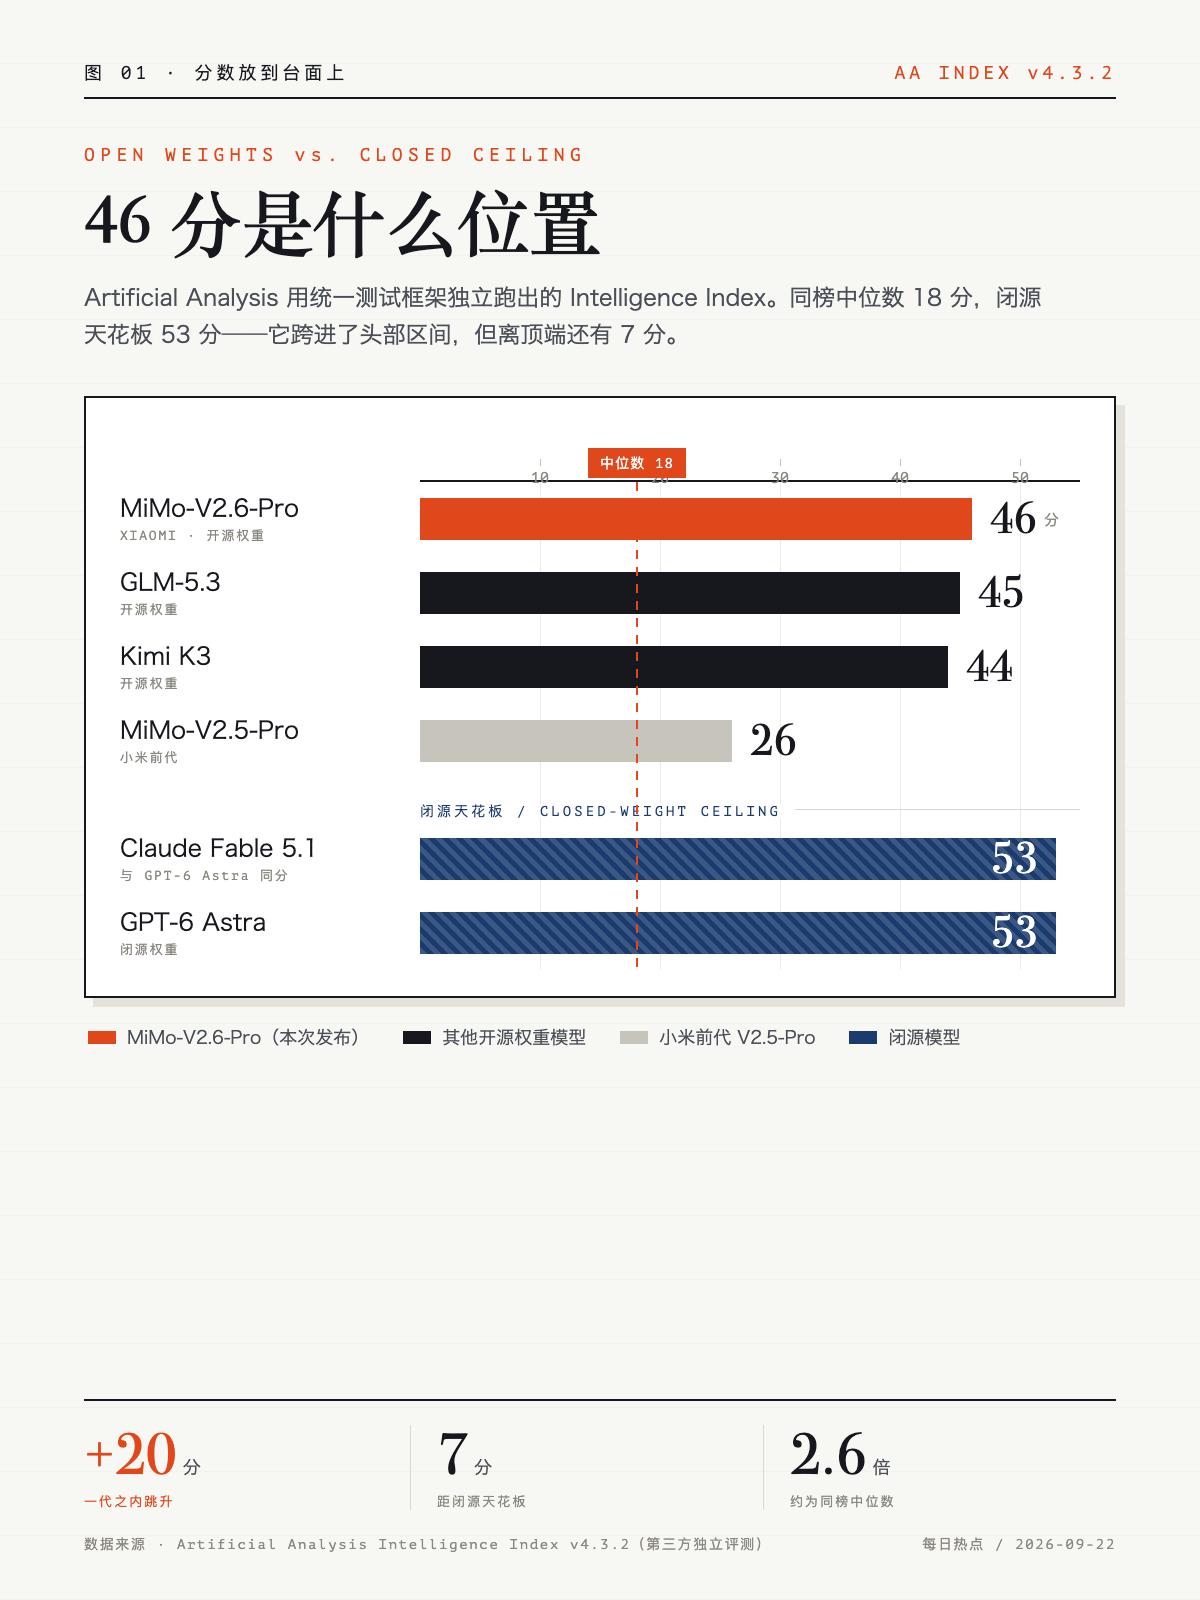
MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index v4.3.2 上拿到 46 分(部分来源精确到 46.3 或 46.32)。这个分数的参照系是这样的:
- 同榜的 Kimi K3 为 44 分,GLM-5.3 为 45 分,MiMo-V2.6-Pro 超过两者,成为当前该榜上排名最高的开源权重模型;
- 小米前代 MiMo-V2.5-Pro 只有 26 分,一代之内跳升 20 分;
- 同榜可比模型的中位数是 18 分;
- 榜单天花板仍然是闭源模型:Claude Fable 5.1 与 GPT-6 Astra 均为 53 分。
这三个数字放在一起才有信息量。从 18 分的中位数到 46 分,说明它确实跨进了头部区间;但离 53 分的天花板还有 7 分,而且这 7 分是小米官方口径自己承认的。
需要强调的是,这个分数由 Artificial Analysis 用统一的测试框架独立跑出来,不是厂商自测。这一点在当前基准分数普遍通胀的环境下,含金量比分数本身更重要。
除了综合分,AA 还公布了一组可横向对比的运行数据:输出速度 134.3 tokens/秒(另有来源记为 124.7),首 token 延迟 2.15 秒,每个 Intelligence Index 任务的平均成本为 0.13 美元,整套评估跑完总成本 206.66 美元,过程中模型共生成约 1.4 亿 token。按 AA 的标价折算,大约相当于每百万输入 0.435 美元、每百万输出 0.87 美元,在 7:2:1(缓存:输入:输出)的混合比例下等效混合价约 0.18 美元。
这组数字比官方那句"同等智能水平下价格仅为海外模型的 1/20~1/60"更有说服力,因为它可以被任何人在同一个框架里复算。
二、架构拆解:1.02T 稀疏 MoE 与原生四模态
技术报告把 Pro 的骨架写得很细,这里挑关键的看。
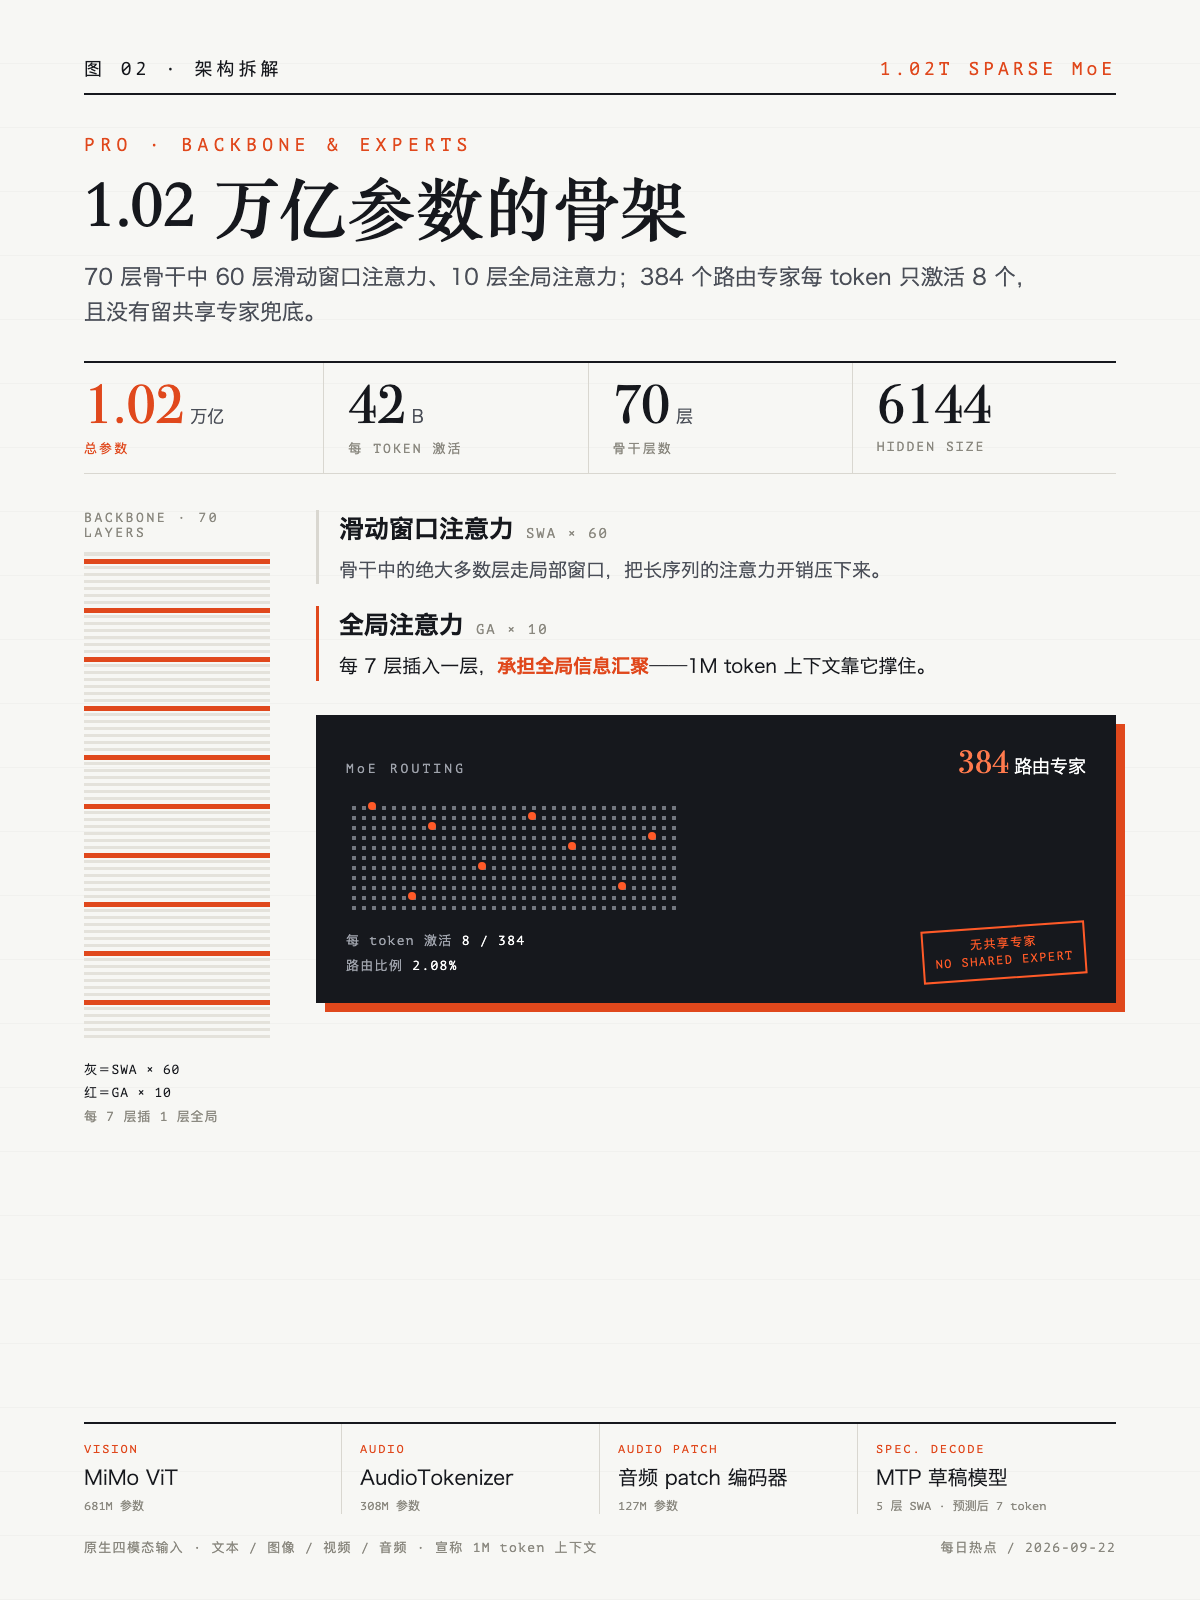
Pro 是稀疏 MoE 架构,总参数 1.02 万亿,每 token 激活 42B。骨干共 70 层,其中 60 层是滑动窗口注意力(SWA),10 层是全局注意力(GA);hidden size 为 6144;384 个路由专家中每 token 激活 8 个,且没有共享专家。Flash 则是 309B 总参、15B 激活。
"没有共享专家"这个选择值得留意。主流 MoE 设计里通常会留一两个始终激活的共享专家来兜住通用能力,MiMo-V2.6-Pro 把它去掉了,说明路由训练的稳定性问题被其他手段(后文会提到冻结 Router)解决了,或者至少被判断为可控。
模态方面,模型原生支持文本、图像、视频、音频四类输入,配套的组件包括 681M 参数的 MiMo ViT 视觉编码器、308M 的 AudioTokenizer 与 127M 的音频 patch 编码器,宣称支持 1M token 上下文。
推理加速上,模型配了一个 5 层 SWA 的 MTP(Multi-Token Prediction)草稿模型,走 DFlash 风格的推测解码路线,每次前向预测后续 7 个 token。
这里有一个容易被忽略的工程含义:1M 上下文 + 原生多模态 + 稀疏激活三者叠在一起,意味着 KV Cache 与专家并行的通信开销会成为部署时的主要瓶颈,而不是单纯的显存占用。后面讲部署时会再回到这一点。
三、训练账本:6 天、30 步、75 万条轨迹、347 万美元
这是本次发布里最"反常识"的一段,也是上一场直播承诺的兑现部分。
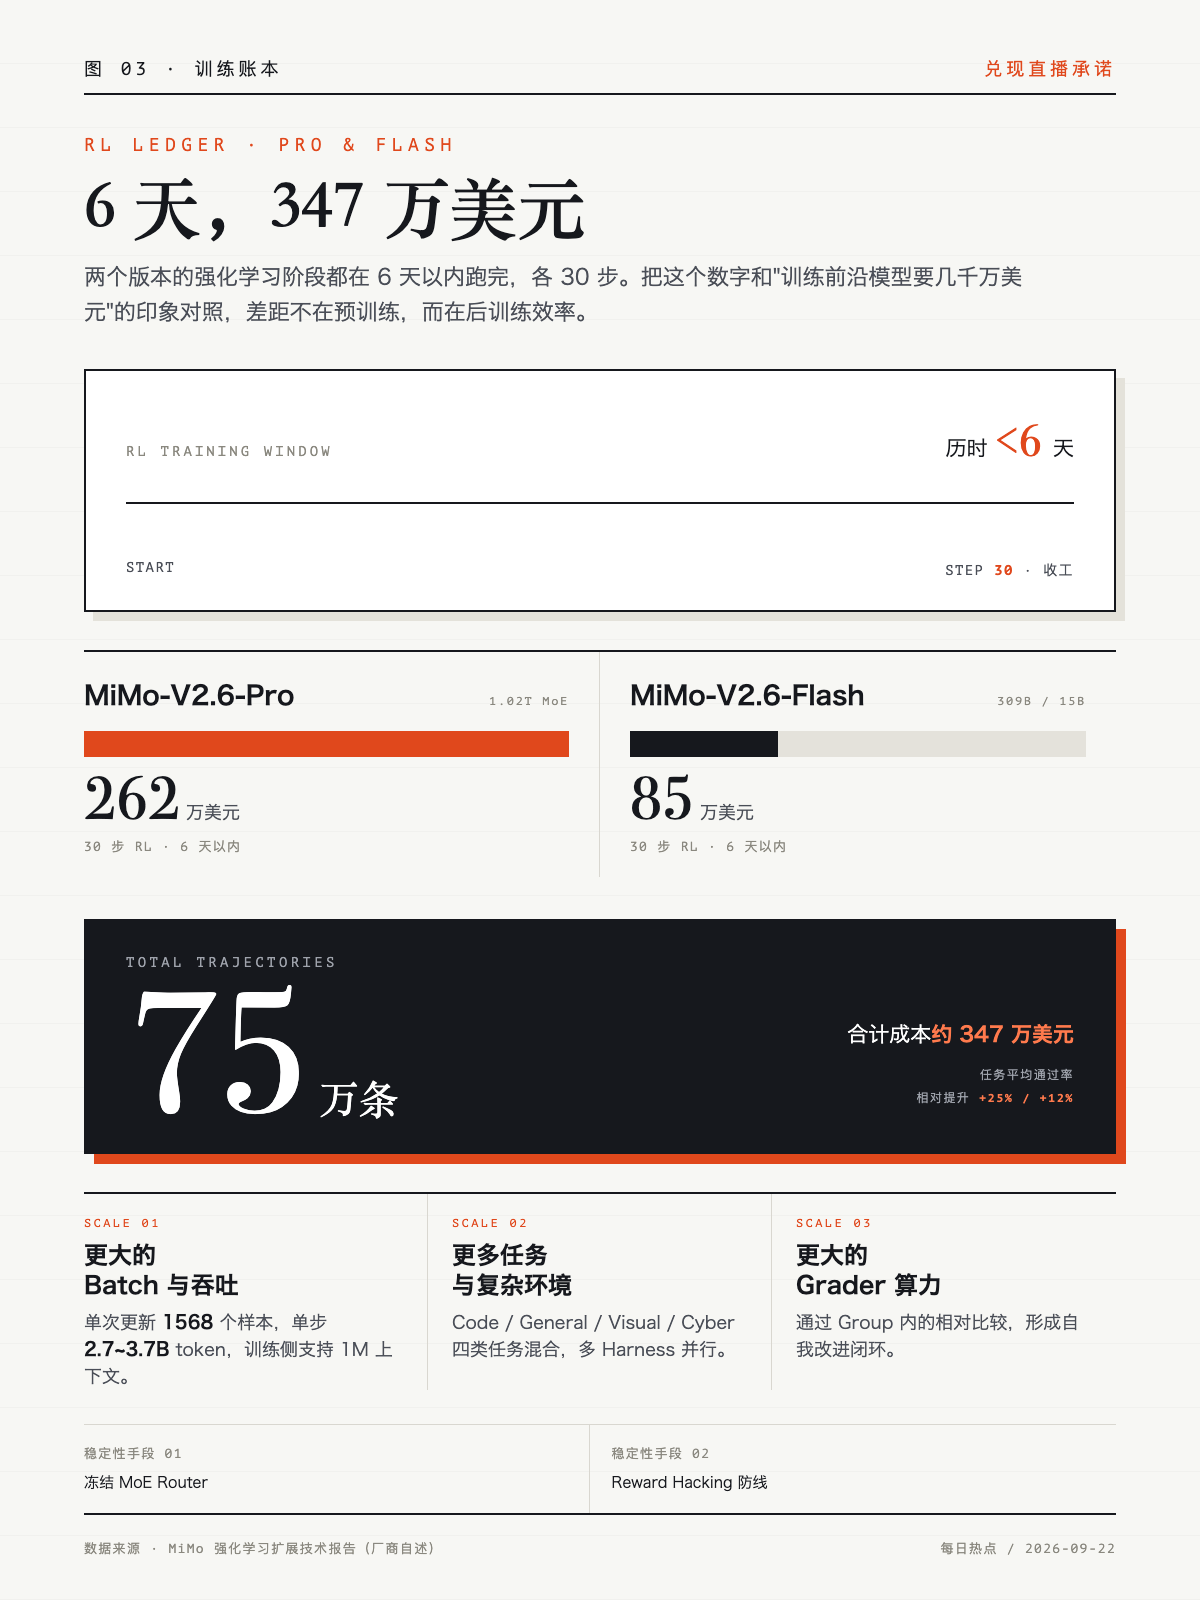
Pro 与 Flash 的训练历时均不到 6 天,各自完成 30 步 RL,累计约 75 万条轨迹。成本分别约 262 万美元与 85 万美元,合计约 347 万美元。
也就是说,一个 1.02T 总参的模型的强化学习阶段,账单是 262 万美元、时间是 6 天以内。把这个数字和"训练一个前沿模型要几千万到几亿美元"的行业印象对照,差距不在预训练,而在后训练阶段的效率被压缩到了一个新的量级。
报告把算力扩展归纳为三个维度:
稳定性方面,训练中冻结了 MoE Router,并建立了针对 Reward Hacking 的防线。最终任务平均通过率相对提升 25% 与 12%(两个版本各一)。
四、上手:从 Hugging Face 到 SGLang 部署
先说许可,这是最干脆的一条:两个模型权重均为 MIT 许可,无访问门控,允许商业部署、修改、微调与再分发,没有营收门槛,也没有研究条款限制。
权重于 2026 年 9 月 21 日相继上线 Hugging Face,仓库为 XiaomiMiMo/MiMo-V2.6-Pro-RL 与 XiaomiMiMo/MiMo-V2.6-Flash-RL(ModelScope 有镜像)。注意仓库名里的 -RL 后缀指的是训练后谱系,本身就是完整模型,不是 LoRA 适配器——这一点在社区里被误解过。
规格上,Flash 放出的是 172.9 GB 的 FP8(e4m3)权重,分成 65 个分片;Pro 参数量约为其 3 倍,下载量在半 TB 量级。
拉取很直接:
# 需要 huggingface_hub 提供的新版命令行
pip install -U "huggingface_hub[cli]"
# Flash:172.9GB FP8,65 个分片,适合单机多卡起步
hf download XiaomiMiMo/MiMo-V2.6-Flash-RL \\
–local-dir ./mimo-v26-flash
# Pro:约 3 倍体量,建议先确认磁盘与带宽再拉
hf download XiaomiMiMo/MiMo-V2.6-Pro-RL \\
–local-dir ./mimo-v26-pro
然后是部署。这里必须把一件事说清楚:小米没有提供可直接调用的模型端点,权重可下载自托管,但推理基础设施要自备。 官方建议 Pro 跨多节点、多 GPU 做分布式推理,并给出了 SGLang 的部署配方——Docker 镜像 lmsysorg/sglang:latest,示例命令是 –tp 16 –dp 2 –ep 16:
docker run –gpus all –ipc=host –shm-size 32g \\
-v ./mimo-v26-pro:/models/mimo-pro \\
-p 30000:30000 \\
lmsysorg/sglang:latest \\
python3 -m sglang.launch_server \\
–model-path /models/mimo-pro \\
–tp 16 –dp 2 –ep 16 \\
–context-length 1048576 \\
–trust-remote-code
–tp 16 是张量并行度,–ep 16 是专家并行度,–dp 2 是数据并行度。三者组合起来的一套配置,硬件门槛就摆在那里了。
社区方向的讨论是:FP8 量化配合 MXFP4 存储格式,可以在 16 卡 A100 或 Pro6000 上跑起来。也就是说,"开源第一"和"个人开发者跑得动"之间隔着一整个机房。真要在本地折腾,更现实的选择是 Flash,或者干脆用官方同步上线的托管服务 MiMo-V2.6-Pro-UltraSpeed——标称输出速度最高为标准 Pro 的 20 倍。
五、那 7 分差在哪:分项对比
综合分只说明了"差 7 分",但差的这 7 分落在哪些能力上,才是选型时真正要看的东西。把 Pro 与 Claude Opus 5、GPT-5.6 Sol、Fable 5 的分项摆在一起:
落后的部分,集中在长链自主编程与安全攻防:
| ProgramBench | 26.5 | Opus 5:37.0 |
| Terminal Bench 4.0 | 34.9 | Opus 5:49.0 |
| ExploitBench | 47.9 | Opus 5:70.0 / GPT-5.6 Sol:78.5 |
追平甚至反超的部分,集中在工具编排与自动化:
| GDPval-AA 2.1 | 1673 | Opus 5:1708(反超 GPT-5.6 Sol 1588、Fable 5 1595) |
| AutomationBench v1.0.6 | 53.1 | Opus 5:50.3 |
| Toolathlon-Verified | 76.9 | GPT-5.6 Sol:74.9 |
| Agents’ Last Exam | 31.6 | 与 Opus 5 持平 |
作为参照,前代 V2.5 Pro 在 GDPval-AA 2.1 上只有 1107 分——这个分项的提升幅度其实比综合分的 20 分更惊人。
结论很清晰:**MiMo-V2.6-Pro 的能力画像是"会调度、会编排、会自动化,但自己从头写长代码和挖漏洞还不稳"。**如果你的场景是 Agent 工作流、工具调用、自动化编排,它现在的性价比非常高;如果你的场景是长时间自主的软件工程或安全研究,那 7 分差距正好就落在这些位置上。
六、生态与争议:开源清单与第三方口碑
这次开源里最有工程价值、也最少见的部分,其实不是权重。
同步放出的还有:
- 完整技术报告(有来源称 44 页)与模型卡;
- 7k+ 高质量 RL 任务环境,覆盖软件工程、漏洞复现、知识型工作、网页设计开发四类智能体任务;
- 基于 verl、uni-agent 和 mini-swe-agent 的端到端 RL 训练框架,涵盖环境交互、轨迹采集、奖励评估到策略优化的全流程;
- 极简 mini-harnesses,把系统提示、工具与上下文管理解耦,支持 Multi-Harness Training,用来提升模型在未见框架上的泛化能力。
多数开源只给权重,给训练环境与 RL 框架的很少——这意味着这次放出的不只是一个模型,而是一套可以复现方法论的工具链。
其中最接地气的一条验证路径是 MiMo-V2.6-Distill-Qwen-9B:以蒸馏模型为起点做 RL,11 项评测均较 SFT 基线提升。
| SWE-bench Verified | 61.1 | 66.2 |
| Terminal Bench 2.1 | 37.1 | 52.8 |
| MiMo Cyber Bench | 31.3 | 47.0 |
| MiMo Visual Coding | 64.0 | 72.4 |
9B 量级是个人开发者能真正从零复现的规模。如果你想验证"RL 才是这波涨分的主因"这个论断,这是成本最低的实验路径,比拿万亿 MoE 来举例有说服力得多。
不过,热度之外也有几个需要打折扣的地方,写在这里以免选型时踩坑:
- 部分基准(例如 DeepSWE 的 48.8→65.7 提升)来自小米自测或自家 Live RL 仪表盘,尚待独立复现。厂商自测分数与公开榜单数据不可直接比较,这是分析人士明确指出的一点;
- 当时 MiMo-V2.6-Pro 的可用 API 供应商数量有限,这会直接影响实际接入的可行性;
- 有一个方向相反的第三方数据点:据 AgentBreaking 报道,在代码竞技场(Code Arena)的开源权重排名中,MiMo-V2.6 位列第三,并非第一。AA 综合指数登顶与单项竞技场表现并不一致,只看 AA 一榜容易得出过于乐观的结论。
七、总结
回到开头那个问题:这两周前的直播账本,兑现了吗?从公开信息看,兑现得比较完整——训练天数、步数、轨迹数、成本都公开了,模型也确实交付了,AA 指数开源第一是第三方框架跑出来的结果。
但落到"要不要用"这个问题上,我的判断是:
最值得记住的一点,可能不是 46 分,而是 347 万美元和 6 天。当后训练成本被压到这个量级,"开源阵营追平闭源"就不再是一句口号,而是一道可以估算的工程题——差的 7 分,按这个迭代速度,大概只是时间问题。
参考链接
- IT之家:小米正式发布并开源 Xiaomi MiMo-V2.6 系列 Pro 与 Flash 双版本 https://m.ithome.com/html/1005496.htm
- OrcaRouter 博客:MiMo-V2.6-Pro 发布解析——AA 指数 46 分与评测运行数据 https://www.orcarouter.ai/blog/xiaomi-mimo-v2-6-pro-release
- OpenLM:MiMo-V2.6 技术报告要点,架构与训练账本 https://openlm.ai/mimo-v2.6/
- RuntimeWire:小米开源 MiMo-V2.6-RL,权重规格与 MIT 许可 https://runtimewire.com/article/xiaomi-open-sources-mimo-v2-6-rl-cost-3-47m
- alphaXiv:MiMo 强化学习扩展技术报告,7k+ RL 任务环境与训练框架 https://www.alphaxiv.org/abs/2609.mimo-scaling-reinforcement-learning
- 博客园:MiMo-V2.6-Distill-Qwen-9B 的 RL 提升实测 https://www.cnblogs.com/liferecords/articles/23072518
- OrcaRouter 博客:MiMo-V2.6-RL 与 DeepSWE 已知信息,分项基准对比 https://www.orcarouter.ai/blog/xiaomi-mimo-v2-6-rl-deepswe-what-we-know
- OrcaRouter 博客:MiMo-V2.6-Flash 发布,自部署与 SGLang 配方 https://www.orcarouter.ai/blog/xiaomi-mimo-v2-6-flash-release
- AgentBreaking:MiMo-V2.6 系列评测复盘,基准可信度与 Code Arena 排名 https://agentbreaking.com/blog/xiaomi-mimo-v2-6-series-evaluation/