本文通过实际案例,介绍了使用LangChain框架实现文档导入、向量存储和多轮检索问答的RAG(Retrieval-Augmented Generation)实践。文章详细讲解了文档加载、文本切分、向量化存储、对话检索链构建、LLM接入等关键步骤,并推荐使用Langfuse实现LLMOps监控,自动捕获链中每一步的输入输出。通过本文,读者可以学习如何搭建一个基于LangChain的智能问答Agent,提升信息检索和生成的准确性。
整体框架
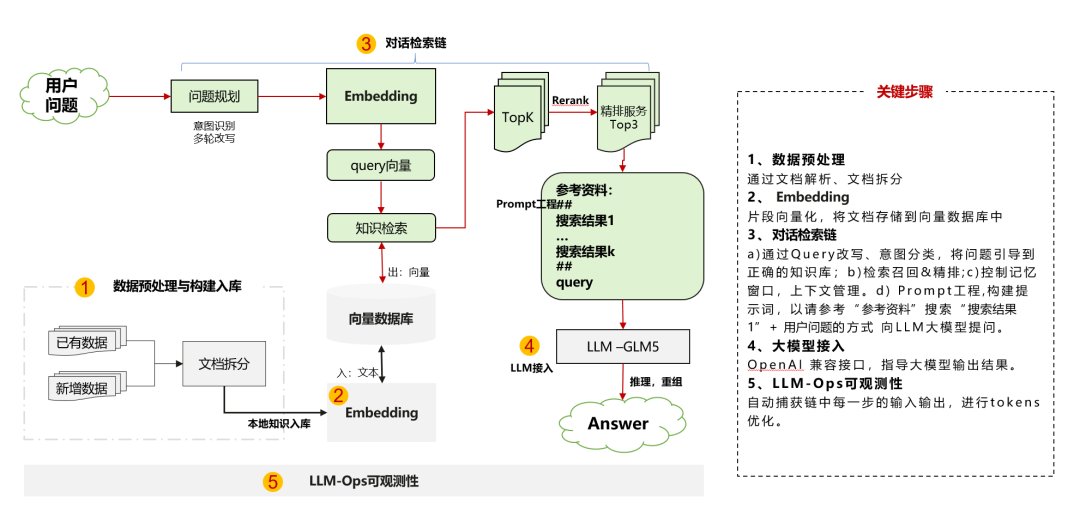
应用程序
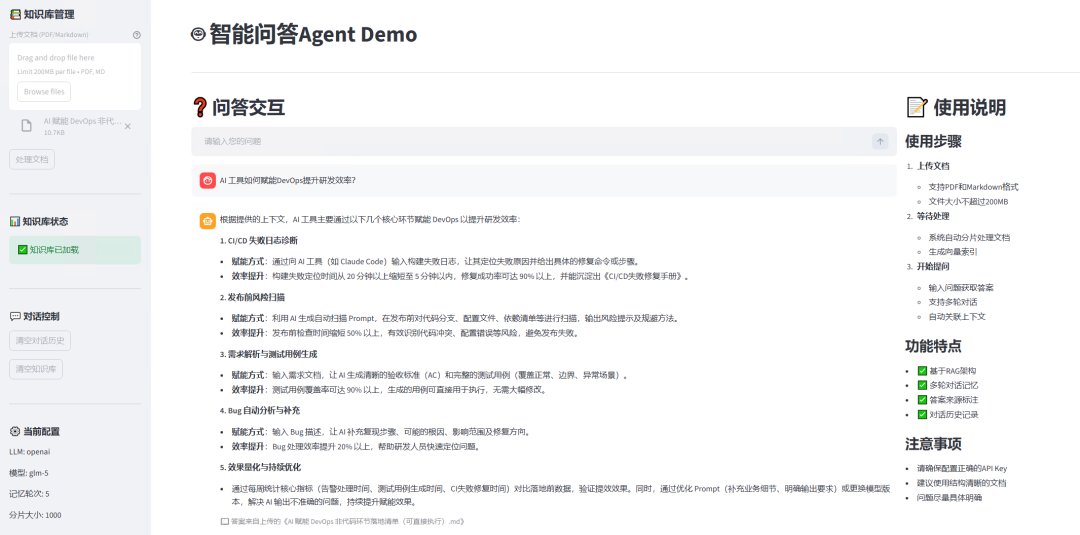
程序跑起来的样子:
一、文档加载与切分
1.1 多格式加载
针对不同文档格式使用对应的 Loader,保留原始结构与元数据(如页码、来源路径):
# document_processor.pyfrom langchain_community.document_loaders import PyPDFLoader, UnstructuredMarkdownLoaderdef load_document(file_path: str):ext = os.path.splitext(file_path)[1].lower()if ext == ".pdf":loader = PyPDFLoader(file_path) # 逐页加载,自动提取页码到 metadataelif ext == ".md":loader = UnstructuredMarkdownLoader(file_path) # 保留 Markdown 结构else:raise ValueError(f"不支持的文件格式: {ext}")return loader.load()
说明:
- PDF 使用 PyPDFLoader,每页生成一个 Document,metadata["page"] 自动记录页码
- Markdown使用UnstructuredMarkdownLoader,可保留标题层级语义
- 始终验证返回列表非空,避免空文档流入后续流程
文本切分是影响检索质量的关键环节。使用 RecursiveCharacterTextSplitter 按语义边界(段落→句子→词)逐级尝试切分:
from langchain_text_splitters import RecursiveCharacterTextSplittersplitter = RecursiveCharacterTextSplitter(chunk_size=1000, # 每块最大字符数chunk_overlap=100, # 相邻块重叠字符数,保留上下文连续性)chunks = splitter.split_documents(docs)# 过滤纯空白块,避免噪声进入向量库chunks = [c for c in chunks if c.page_content.strip()]
关键参数权衡:
| 参数 | 偏小 | 偏大 |
| chunk_size | 语义不完整,上下文丢失 | 噪声增多,检索精度下降 |
| chunk_overlap | 块边界处信息断裂 冗余数据增加 | 向量库膨胀 |
说明:
- 中文技术文档推荐 chunk_size=800~1200,chunk_overlap=80~150
- 对结构化文档(表格、列表为主)可适当降低 chunk_size
- 切分后务必过滤空白块,否则会引入无意义的零向量污染检索结果
二、向量化与存储
本项目使用 text-embedding-v3 模型:
# config.pyfrom langchain_community.embeddings import DashScopeEmbeddingsdef get_embeddings():return DashScopeEmbeddings(model="text-embedding-v3",dashscope_api_key=DASHSCOPE_API_KEY,)
说明:
- Embeddings 模型与 LLM 的语言偏好应保持一致(中文文档 → 中文 Embeddings)
- 不同 Embeddings 模型生成的向量不可混用;更换模型后必须重建整个向量库
# vector_store.pyfrom langchain_community.vectorstores import FAISSdef create_vector_store(documents):embeddings = get_embeddings()vector_store = FAISS.from_documents(documents, embeddings)return vector_storedef get_retriever(vector_store, k=3):return vector_store.as_retriever(search_kwargs={"k": k})
FAISS 在内存中构建索引,适合中小规模知识库(万级以内文本块)。as_retriever(search_kwargs={"k": 3}) 表示每次检索返回相似度最高的 3 个文档块。
最佳实践:
- k值推荐 3~5;过小会漏掉关键片段,过大则引入噪声,稀释 LLM 的注意力
- 生产环境中需要将向量库持久化到磁盘,避免重启后重新构建:
vector_store.save_local("faiss_index") # 保存FAISS.load_local("faiss_index", embeddings) # 加载
- 文档更新时,用 vector_store.add_documents(new_chunks)增量追加,而非全量重建
三、对话检索链
ConversationalRetrievalChain 将多轮对话与向量检索结合,分两步执行:
用户提问 + 对话历史│▼ Step 1: 问题改写[Condense Question LLM]将追问改写为独立的完整问题│▼ Step 2: 检索 + 生成[Retriever] → 相关文档块│[QA LLM] → 最终回答
问题改写 Prompt:
_CONDENSE_QUESTION_PROMPT = PromptTemplate.from_template("""根据以下对话历史和后续问题,将后续问题改写为一个独立的问题。对话历史:{chat_history}后续问题: {question}独立问题:""")
QA 回答 Prompt:
说明:
- QA Prompt 中明确禁止编造是防止幻觉的关键约束
- 要求 LLM 注明来源,使结果可追溯、可验证
- 提供明确的兜底回复(“未查询到相关信息”),避免 LLM 在无关文档中强行拼凑答案
# qa_chain.pydef create_qa_chain(retriever):llm = get_llm()memory = ConversationBufferWindowMemory(k=5, # 保留最近 5 轮对话memory_key="chat_history",return_messages=True, # 以消息对象格式返回,兼容 Chat 模型output_key="answer", # 只将 answer 字段写入记忆,排除 source_documents)chain = ConversationalRetrievalChain.from_llm(llm=llm,retriever=retriever,memory=memory,condense_question_prompt=_CONDENSE_QUESTION_PROMPT,combine_docs_chain_kwargs={"prompt": _QA_PROMPT},return_source_documents=True, # 返回检索到的原始文档,用于来源标注)return chain
说明:
- output_key="answer"配合return_source_documents=True时是必填项,否则记忆模块无法识别应写入哪个输出字段
- return_messages=True使记忆以 ChatMessage对象列表返回,与 Chat 类型 LLM(如 ChatOpenAI)原生兼容;若使用文本补全模型则应设为 False
- k=5控制记忆窗口;过大会使 Prompt 超过 LLM 上下文长度限制,推荐 3~8
检索完成后,从 source_documents 中提取文件名附加在回答末尾:
def ask(chain, question: str) -> str:result = chain({"question": question}, callbacks=callbacks)answer = result["answer"]source_docs = result.get("source_documents", [])sources = set()for doc in source_docs:source = doc.metadata.get("source", "未知来源")sources.add(source)if sources:source_text = "、".join(sources)if source_text not in answer:answer += f"/n/n📄 来源: {source_text}"return answer
说明:
- 使用 set() 对来源去重,避免同一文件被多个 chunk 命中时重复显示
- 在追加来源前检查 LLM 是否已自行引用,避免重复(if source_text not in answer)
四、LLM 接入
使用 ChatOpenAI + 自定义 base_url,可无缝接入任何兼容 OpenAI 协议的大模型(如华为云 GLM-5等):
# config.pyfrom langchain_openai import ChatOpenAIdef get_llm():return ChatOpenAI(model=LLM_MODEL_NAME, # 如 "glm-5"api_key=LLM_API_KEY,base_url=LLM_API_BASE, # 如 "https://api.modelarts-maas.com/openai/v1")
说明:
- 优先使用 ChatOpenAI(Chat 模型)而非 LLM(文本补全模型),因为前者原生支持消息格式,与 ConversationalRetrievalChain 的多轮记忆机制兼容性更好
- 通过环境变量管理凭证,永远不要将 API Key 硬编码进源码
- 若需要切换模型,只需修改 .env 中的三个变量,无需改代码
五、可观测性:Langfuse 集成
RAG 系统的质量问题往往难以定位,常见问题包括:
- 检索阶段返回了不相关文档
- 改写后的独立问题语义发生偏移
- LLM 忽略检索结果、产生幻觉
Langfuse 通过 LangChain CallbackHandler 自动捕获链中每一步的输入输出,在 Dashboard 中可视化展示完整的 Span 树。
Langfuse 3.x 通过环境变量自动配置,只需传入 CallbackHandler:
# config.py — 环境变量自动读取 LANGFUSE_PUBLIC_KEY / SECRET_KEY / HOSTfrom langfuse.langchain import CallbackHandlerdef get_langfuse_handler():if not LANGFUSE_ENABLED:return Nonereturn CallbackHandler(update_trace=True)# qa_chain.py — 将 handler 注入 chain 调用handler = get_langfuse_handler()callbacks = [handler] if handler else Noneresult = chain({"question": question}, callbacks=callbacks)
必须在 .env 中配置:
LANGFUSE_PUBLIC_KEY=pk-lf-xxxLANGFUSE_SECRET_KEY=sk-lf-xxxLANGFUSE_HOST=http://your-langfuse-host:3000
最佳实践:
- 通过 LANGFUSE_ENABLED 标志(当 key 缺失时自动为 False)实现零侵入降级,不影响无 Langfuse 的部署环境
- Langfuse 3.x 基于 OpenTelemetry,不需要手动调用 flush(),trace 由后台线程异步上报
- update_trace=True会将链的输入/输出自动写入 trace 根节点,方便在 Dashboard 直接查看 Q&A 对
六、配置管理最佳实践
所有运行参数通过环境变量集中管理,代码中无任何硬编码值:
# config.pyload_dotenv() # 从 .env 文件加载CHUNK_SIZE = int(os.getenv("CHUNK_SIZE", "1000")) # 带默认值CHUNK_OVERLAP = int(os.getenv("CHUNK_OVERLAP", "100"))TOP_K = int(os.getenv("TOP_K", "3"))MEMORY_ROUNDS = int(os.getenv("MEMORY_ROUNDS", "5"))
完整 .env 配置示例:
# LLM(必填)LLM_API_KEY=your_api_keyLLM_API_BASE=https://api.modelarts-maas.com/openai/v1LLM_MODEL_NAME=glm-5# 嵌入向量配置# 使用 'modelarts' 表示华为云 ModelArts bge-m3 嵌入向量EMBEDDINGS_PROVIDER=modelarts# 嵌入向量 API 配置EMBEDDINGS_API_BASE=https://api.modelarts-maas.com/v1EMBEDDINGS_MODEL=bge-m3# 文档处理(可选,有默认值)CHUNK_SIZE=1000CHUNK_OVERLAP=100TOP_K=3MEMORY_ROUNDS=5# Langfuse 可观测性(可选)LANGFUSE_PUBLIC_KEY=pk-lf-xxxLANGFUSE_SECRET_KEY=sk-lf-xxxLANGFUSE_HOST=http://localhost:3000
最后
2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!
金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。
现在企业疯狂紧缺一类人才:懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。
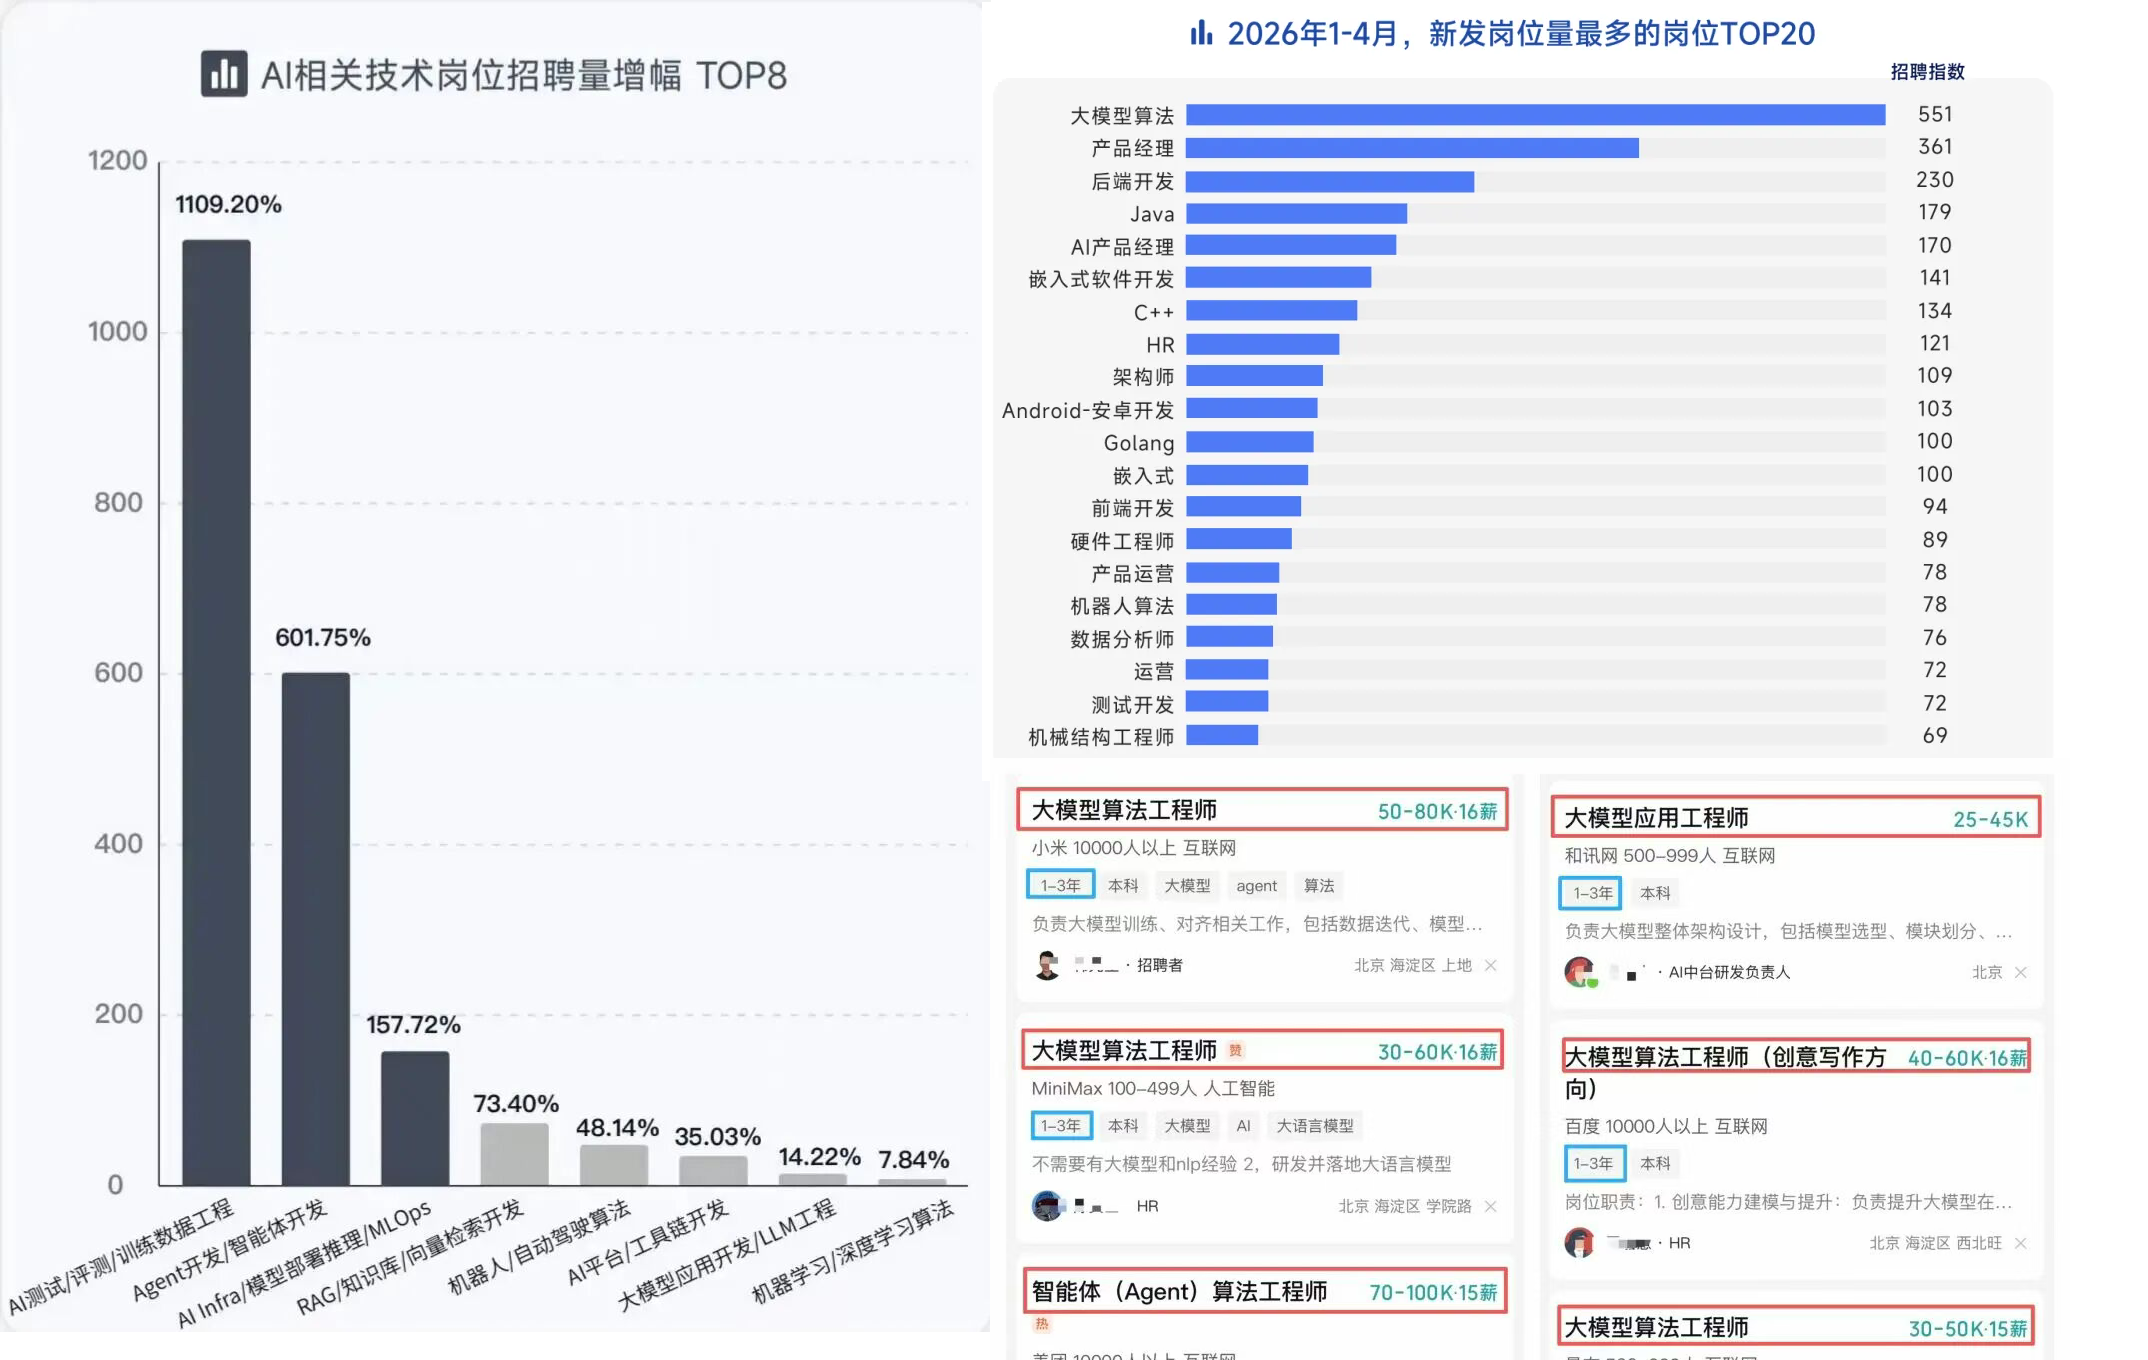
风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员该怎样从零入门大模型,抓住这波机会?
今天整理好【2026 最新版】AI 大模型全套免费学习资源,覆盖零基础入门、项目实战、理论知识、大厂面试,从基础一路进阶。所有资料分类归档,没有多余杂料,无套路免费分享给想要入局 AI 赛道的程序员与零基础小白!
👇👇扫码免费领取全部内容👇👇
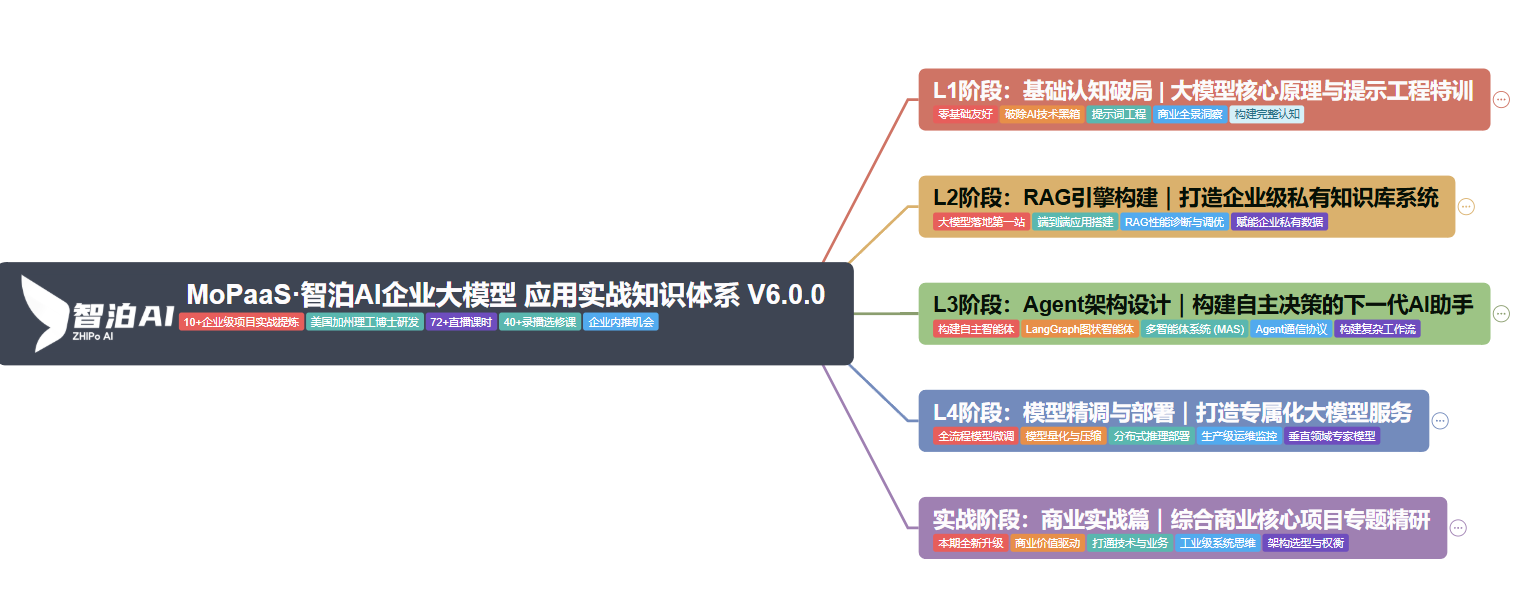
1、大模型系统化完整学习路线
2、大模型经典书籍&文档
3、AI 大模型最新行业研究报告
4、企业级实战项目 + 完整配套源码
5、大厂大模型面试真题汇总
6、这些资料真的有用吗?
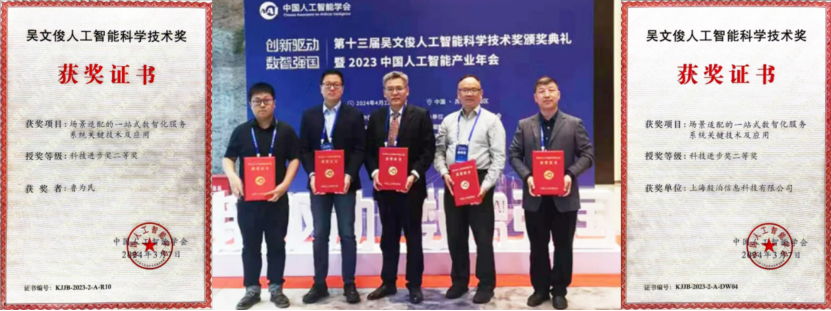
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】