Linux perf 进阶:PMU 硬件计数器与 TopDown 微架构分析法
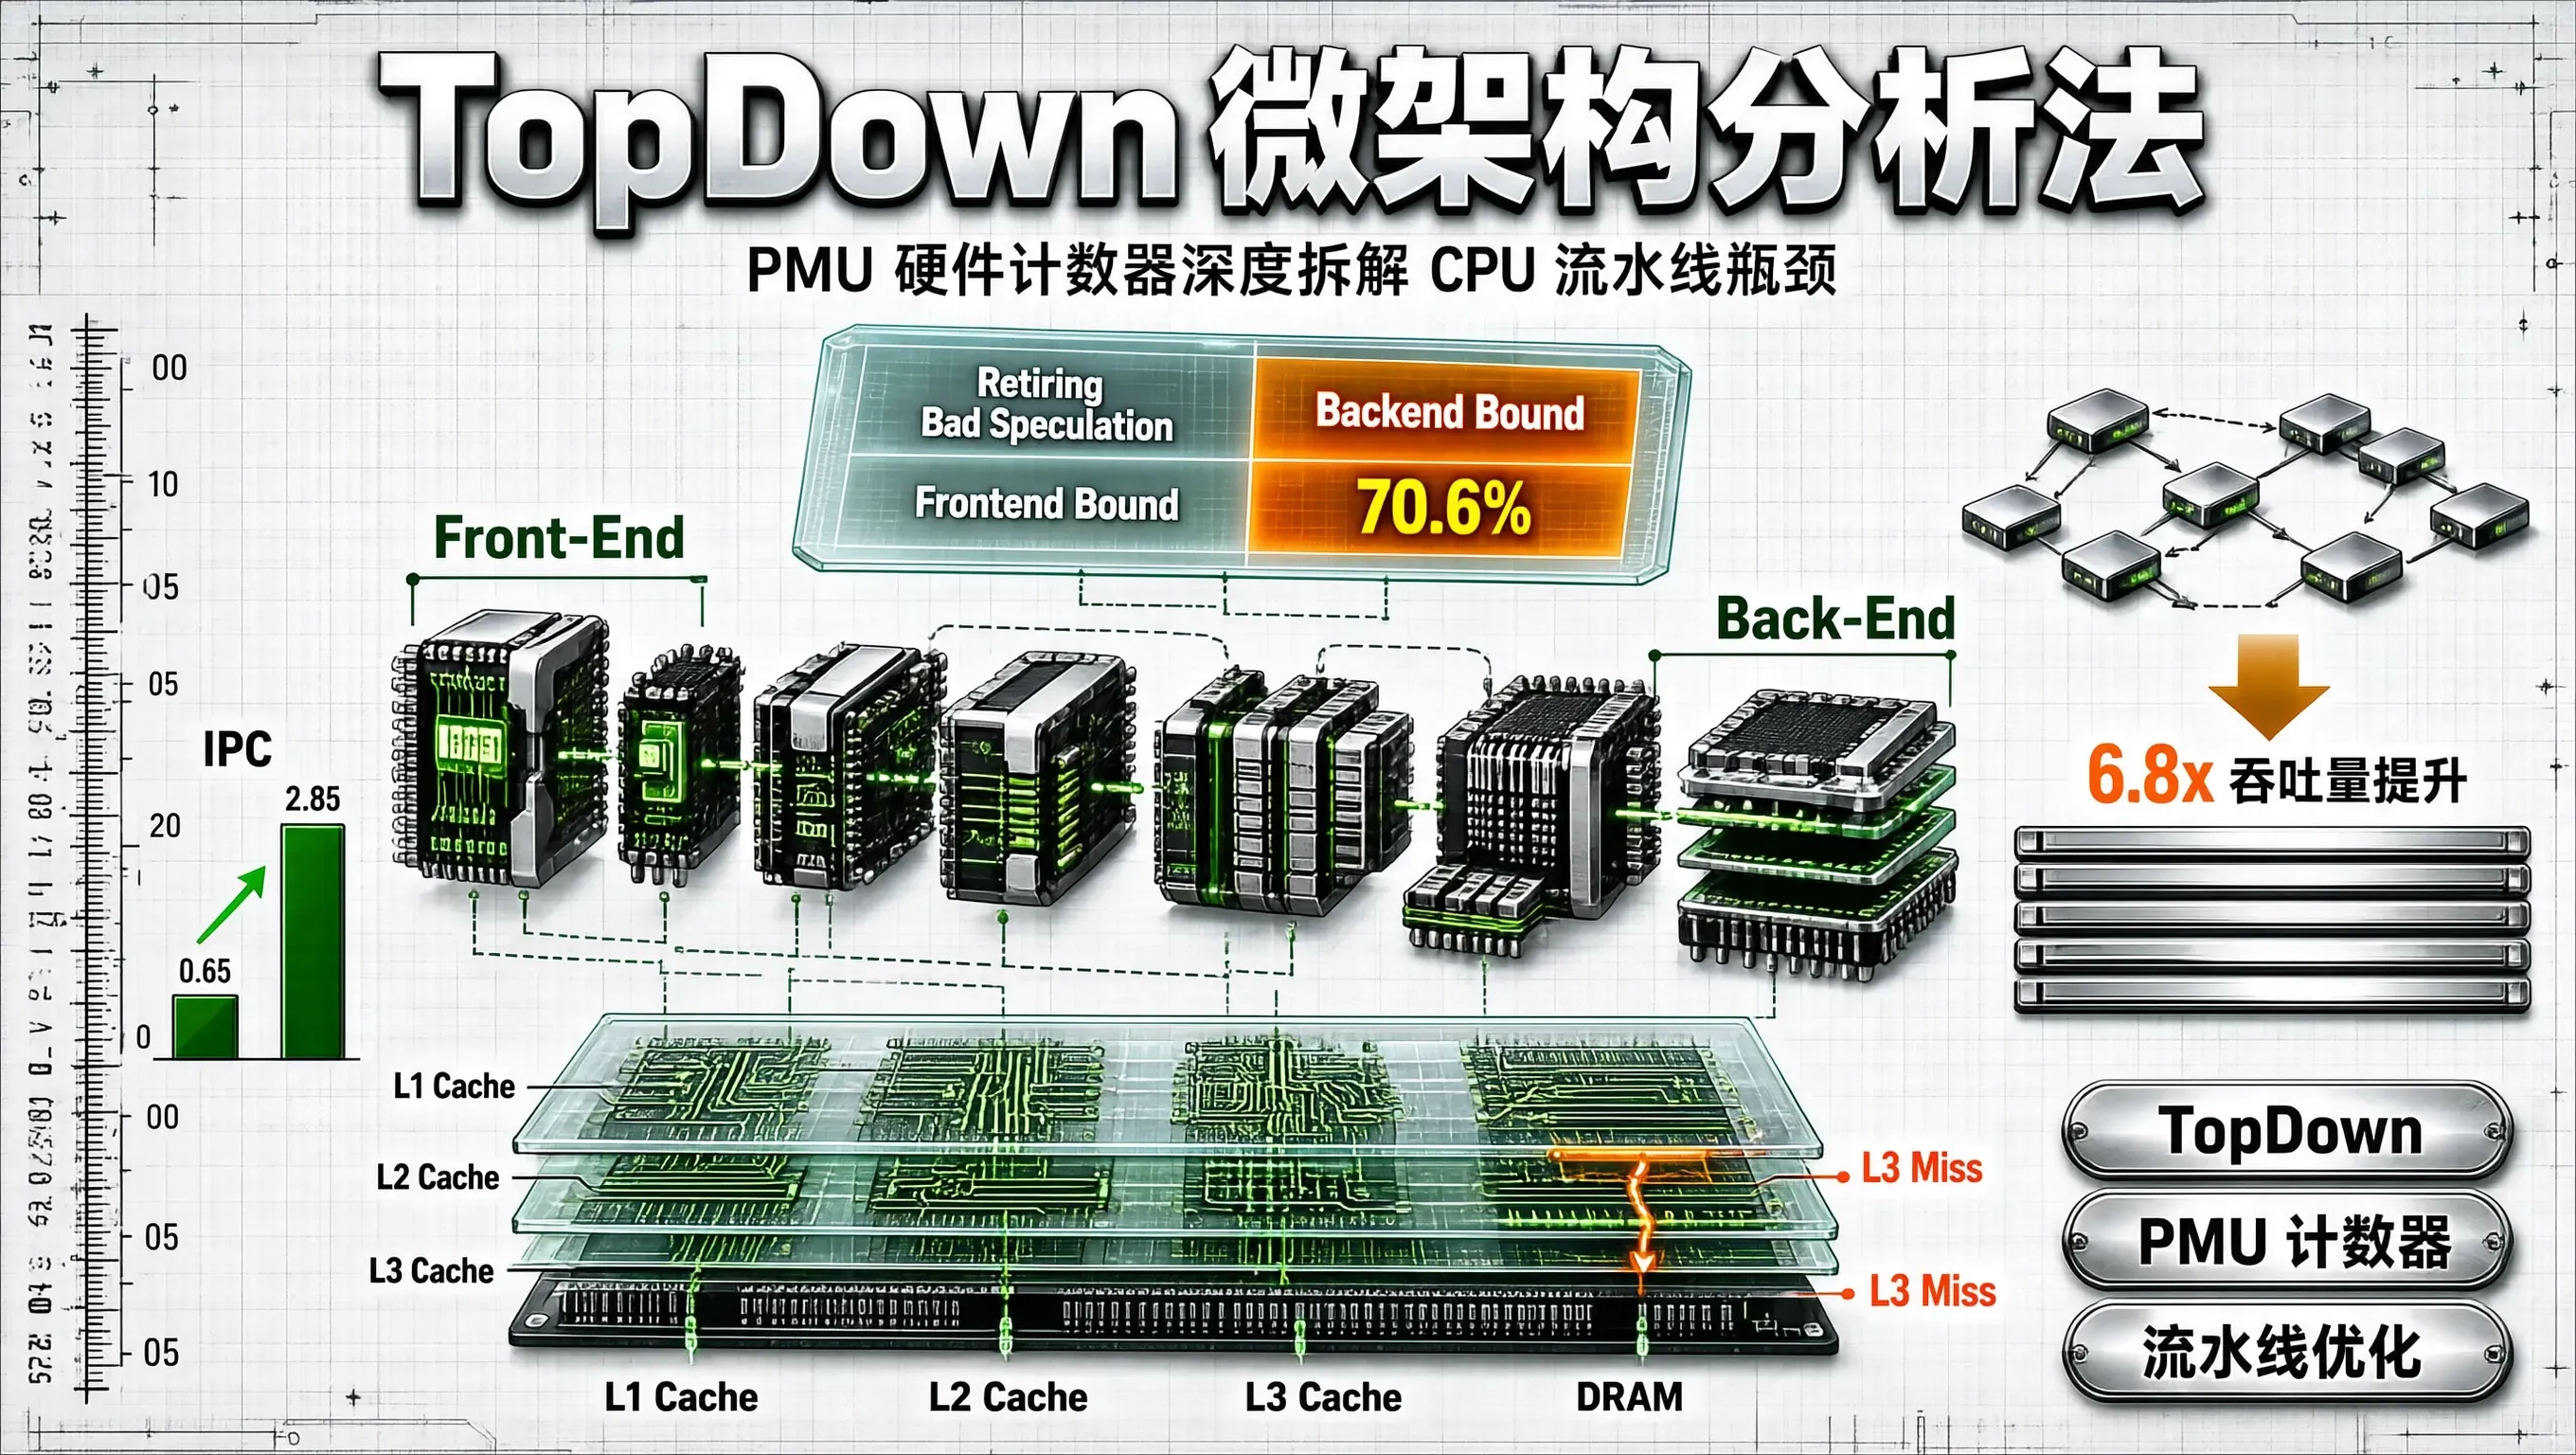
在现代高性能计算、超低延迟系统与大模型推理算子深度优化中,当工程师完成了算法时间复杂度优化、移除了显式锁竞争并减少了系统调用开销后,常常会遭遇一道坚固的物理性能高墙:
- 代码逻辑非常简洁,但程序的单核吞吐量依然无法提升;
- CPU 的每时钟周期指令数(IPC,Instructions Per Cycle)长期徘徊在 0.6 ~ 0.9 的低位,远未达到现代超标量架构理论的 4.0 以上上限。
此时,传统的函数调用栈级 Profiler(如基础 pprof 或 gprof)已经无法定位瓶颈所在。因为性能瓶颈早已不再是“哪行代码执行时间最长”,而是深埋于现代 CPU 芯片内部的微架构流水线停顿(Microarchitectural Pipeline Stalls)。
为了系统性量化处理器核心内部各个流水线阶段的物理阻塞,由 Intel 性能架构师 Ahmad Yasin 提出的 TopDown 微架构分析方法(TopDown Microarchitecture Analysis Method,TMAM) 成为了现代底层性能工程的标准方法论。本文结合 Linux perf 工具与硬件性能监控单元(PMU),深度拆解 TopDown 体系的实战分析。
处理器流水线与 TopDown 四分类体系
现代超标量乱序执行(Out-of-Order)CPU 流水线由两大部分构成:
TopDown 方法将 CPU 核心在每个时钟周期所能处理的所有理论流水线槽位(Pipeline Slots),划分为四大互斥的 Level 1 指标:
TopDown Level 1 槽位消耗四分类图谱:
┌────────────────────────────────────────────────────────────────────────┐
│ 全部 Pipeline 槽位 (100%) │
├───────────────────────────────────┬────────────────────────────────────┤
│ 1. Retiring (有效退役槽位 – 目标!): │ 2. Bad Speculation (分支预测失败): │
│ 微操作成功执行并按序提交退役! │ 由于分支预测错误或微码异常导致 │
│ (高性能系统的黄金目标: > 50%!) │ 流水线被强行清空所浪费的槽位! │
├───────────────────────────────────┼────────────────────────────────────┤
│ 3. Frontend Bound (前端瓶颈): │ 4. Backend Bound (后端瓶颈): │
│ 前端取指、译码或 iCache 缺失, │ 后端由于等待慢速内存或计算单元 │
│ 未能及时向后端输送足够的微操作! │ 结构性拥堵, 导致流水线发生停顿! │
└───────────────────────────────────┴────────────────────────────────────┘
PMU 硬件计数器工作机制
现代 CPU 内部集成了硬件性能监控单元(Performance Monitoring Unit,PMU)。PMU 包含多组可编程的模型特定寄存器(MSR):
- 固定功能计数器(Fixed Counters):硬件硬编码记录 CPU_CLK_UNHALTED.THREAD(实际核心时钟周期)、INST_RETIRED.ANY(退役指令数)等;
- 可编程通用计数器(General Purpose Counters):可通过内核驱动动态配置,监听数百种特定的微架构物理事件(如 MEM_LOAD_RETIRED.L3_MISS、BR_MISP_RETIRED.ALL_BRANCHES);
- PEBS(Processor Event-Based Sampling):在硬件事件溢出时,CPU 硬件通过专用 DMA 机制直接捕获当前触发事件时的精确寄存器状态(IP 指针、访存物理地址、延迟时钟数),彻底杜绝软件中断采样的指令偏移偏差(Skid)。
实战:使用 perf stat –topdown 快速定位系统瓶颈
对运行中的高吞吐低延迟关键进程(PID=9527)执行系统级微架构诊断:
# 采样 10 秒微架构 Level 1 分类
sudo perf stat –topdown -p 9527 — sleep 10
Performance counter stats for process id '9527':
Retiring Bad Speculation Frontend Bound Backend Bound
16.4% 3.2% 9.8% 70.6% <– 锁定核心瓶颈!
诊断下钻逻辑
上述采样清晰指出:整台服务高达 70.6% 的时钟周期槽位被 Backend Bound 阻塞,而真正的有效退役(Retiring)仅占 16.4%!
为了进一步锁定是访存瓶颈(Memory Bound)还是执行单元瓶颈(Core Bound),使用 perf 下钻采集 Level 2 事件:
sudo perf stat -p 9527 -e \\
cycles,\\
instructions,\\
cycle_activity.stalls_mem_any,\\
cycle_activity.stalls_l3_miss,\\
cycle_activity.stalls_total,\\
uops_retired.stall_cycles \\
— sleep 10
Level 2 细分诊断树:
Backend Bound (70.6%)
├── Memory Bound (59.4%): 绝大多数停顿发生在等待 L3 Cache Miss 与 DRAM 内存访问!
│ └── 物理病灶: 数据结构散落在堆内存各处, 存在大量指针跳转与 Cacheline 颠簸
│
└── Core Bound (11.2%): 部分密集浮点计算与除法器端口占用
优化案例对决:离散指针链表 vs Cache 友好平坦连续内存
针对上述典型的 Memory Bound 场景,我们将原有的离散指针链表结构重构为平坦连续的紧凑数组(Data-Oriented Design / SoA):
// 优化前:离散指针对象链表 (极其严重的 Memory Bound)
struct Node {
uint64_t id;
double weight;
Node* next; // 频繁跨 Cacheline 随机指针跳转
};
// 优化后:连续平坦紧凑内存结构 (CPU L1/L2 硬件预取极佳)
struct FlatNodePool {
std::vector<uint64_t> ids;
std::vector<double> weights; // 内存完全物理连续,单 Cacheline 一次载入 8 个 double
};
实测对账矩阵(优化前后微架构指标全面对比)
| 单核有效吞吐量 | 4.2 M ops/s | 28.6 M ops/s | 吞吐量飙升 6.8 倍 |
| 每周期指令数 (IPC) | 0.65 (流水线严重饥饿) | 2.85 (高度饱和运算) | IPC 提升 4.38 倍 |
| TopDown: Retiring 比例 | 16.4% | 68.2% | 有效算力占空比大幅提升 |
| TopDown: Backend Bound | 70.6% (严重阻塞) | 14.5% (显著释放) | 消除大部分流水线停顿 |
| L3 Cache Miss 率 | 14.8% | 0.3% | 内存带宽开销降低 98% |
| 单操作平均时钟周期 | 68 cycles | 8.2 cycles | 延迟缩短 88% |