面试官真正在考察的,是你面对非结构化数据时,有没有自底向上的工程拆解能力,和从“能跑”到“可靠”的架构意识。
你去面字节二面,面试官问:Agent 做 RAG,遇到 PDF 文件该怎么处理?
你几乎脱口而出——把 PDF 里的文本抽出来,切分一下,灌进向量库,完事。
面试官脸上还挂着微笑,但心里已经把你归进了“只跑过 demo”的那一档。
倒不是说这个思路错。PDF 只有纯文字、排版规整的时候,它确实能跑通。但真实业务里的 PDF,是这个理想世界的反面:目录、页眉页脚、多栏排版、嵌入的表格、流程图、合同条款扫描件,甚至一页里同时塞了文字、图片和手写签名。
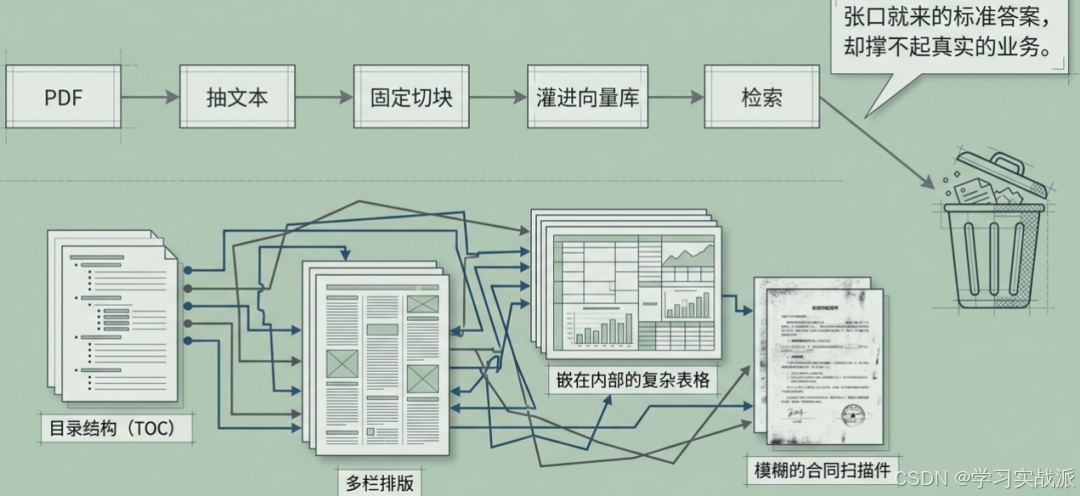
你把这样一份文件当纯文本流来处理,最后 RAG 搜出来的,是一堆缺头少尾、数据错乱、混着页眉广告词的碎片。灌进去的是垃圾,吐出来的答案自然没人敢信。
一句话:把 PDF 处理看作一条生产级文档理解流水线——识别类型、还原结构、智能分块、上下文注入。
下面这四关,就是面试官真正想听的。
第一关:识别文件类型——90% 的人倒在这里
处理 PDF 的第一步,不是急着抽文本,而是先认清楚你面前的文件究竟是哪种“物种”。
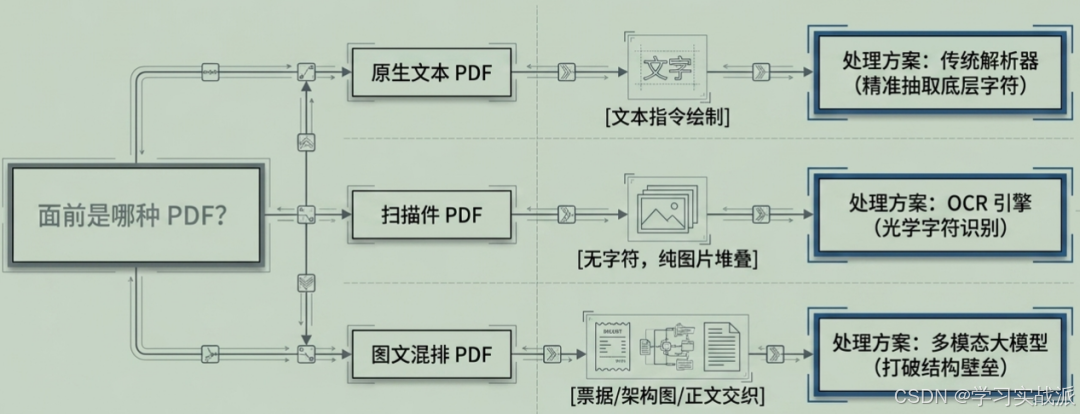
原生文本 PDF:是用文本指令直接画的,文字就藏在里面,解析器可以精准提取,并保留位置信息。
扫描件 PDF:说白了就是一张张图片的容器,里面一个字符都没有,必须走 OCR 这条路,把像素变成文字。
图文混排 PDF:更麻烦,正文里可能嵌着一张票据照片、一个架构图、一个签章。对图表、流程图这类复杂元素,光抓文字不够,得调用视觉理解能力,让多模态模型直接看图,生成一段描述。
|
文件类型 |
本质 |
处理手段 |
|
原生文本 PDF |
文本指令绘制 |
解析器精准提取,保留坐标 |
|
扫描件 PDF |
图片容器,无字符 |
OCR 识别 |
|
图文混排 PDF |
文字 + 图片 / 图表 |
文字抽取 + 多模态视觉理解 |
Anthropic 的 Claude PDF 支持就是这个思路——它不去解析 PDF 的结构,而是像人眼一样,直接阅读每一页的视觉呈现,同时理解上面的文字、图表和表格,把图像和文本当成一个整体来认知。
这一步如果用“抽文本 + 单纯 OCR”来拼凑,信息很容易割裂;端到端的视觉理解,反而更能捕捉表格线和数据之间的关联。
第二关:还原文档结构(骨架)
类型识别完,接下来要把文档的骨架立起来。PDF 不只是文字的堆砌,它有标题层级、章节边界、段落关系,有表格和图片的穿插,有脚注和页眉页脚的附属信息。
你需要把这些结构还原成计算机能理解的数据模型:通过文字坐标和字体大小,推断哪里是一级标题、哪里是正文;通过线条和空白区,还原表格的行列;页眉页脚要么被识别剔除,要么被标记为特殊的 metadata 保留下来。
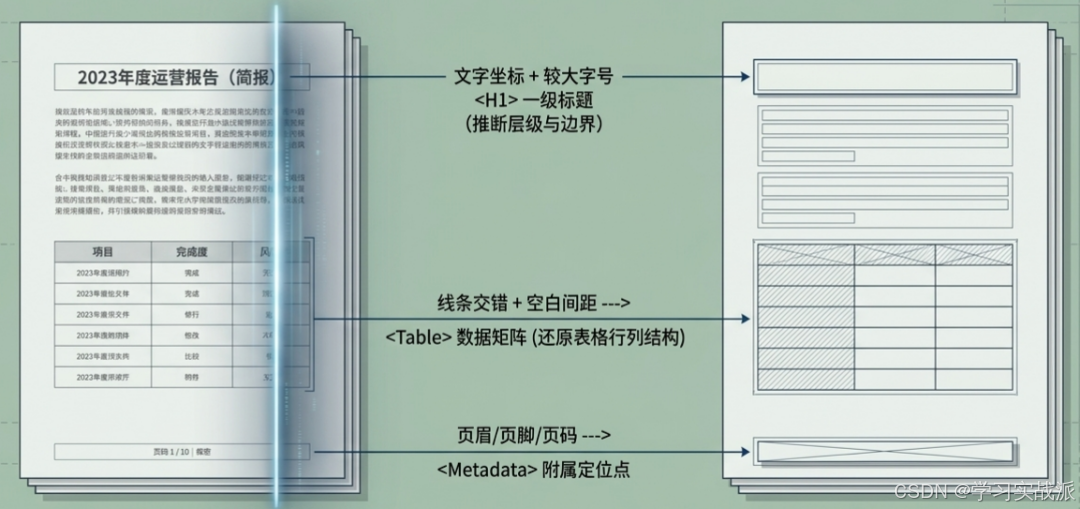
这一步的价值,不是让内容更好看,而是让每一个信息点都带上可追溯的定位信息。处理合同 PDF,你必须知道某个条款出自第几条第几页;分析财报,要清楚“净利润 32 亿”这个数字来自哪张表、对应哪个财年哪个指标。
缺了这层结构,Agent 回答起来可以很自信,但你根本没办法回溯它到底看了哪里——这对风控、合规和法律场景是致命的。
第三关:智能分块与上下文注入(切片与索引)
骨架立起来,就进入整条流水线里最精巧的一环:切片与索引。这里要彻底和固定长度分块说再见,正确的姿势是按语义单元来切:
- 同一标题统领的几个段落,作为一个块;
- 一张完整的表格,单独结构化;
- 一张图片与其下方的说明文字,绑在一起;
- 长表格,转成按行列字段组织的结构化文本。
每个块不能裸奔,必须携带丰富的 metadata:文档 ID、页码、章节标题、表格编号、图片描述、时间戳、版本号——凡能帮助定位和筛选的信息都要带上。
chunk_id: 3-12
doc: 2024年报.pdf
page: 37
section: 第三章 风险因素
table_id: T7
context: 该片段讨论汇率波动对海外营收的影响
但仅仅这样还不够——块离开原始语境,模型可能依然无法准确理解它在全局中的角色。这时候可以借鉴 Anthropic 提出的 Contextual Retrieval 思路:索引每个块的时候,不是只存它自己的文本,而是主动给它补一小段上下文说明,比如“该片段出自第三章 风险因素,具体讨论了汇率波动对海外营收的影响”,或者“以下是一张 2023 年 Q3 各地区营收对比表”。
这段说明会跟 chunk 一起被向量化。检索阶段一旦命中,模型看到的就不再是一节孤立的字块,而是一个带着位置感、背景感的信息单元,有效避免“只见树木不见森林”的检索盲区。
最终,文本部分走向量索引;结构化的表格、日期、编号等,则建立关键词或混合索引,为后续的精确过滤和对比查询打好基础。
第四关:Agent 工具化 + 可追溯引用 + 评测闭环
结构完整、索引就绪,才轮到 Agent 出场。很多人的做法是检索出相关块后,一股脑全塞进 Prompt,指望模型硬扛——这仍然是一种暴力阅读。
更好的设计,是把 PDF 的能力封装成一组清晰的工具,让 Agent 像带着工具包进档案馆的调研员一样工作:
search_pdf(query) # 语义检索相关片段
read_page(page) # 读取指定页面全文
extract_table(table) # 抽取表格,转 CSV / Markdown
analyze_chart(image) # 调用视觉模型看图说话
source(chunk) # 返回带页码和片段的引用
用户只是问一个事实,Agent 调一次 search_pdf 就能搞定;若要对比 2022 年和 2023 年的毛利率变化,Agent 就会规划一个多步流程:先搜索包含毛利率的不同章节,再用 extract_table 把相关年份的报表抽出来,最后综合比较;遇到图表问题,则调用视觉工具直接解析。
这样一来,处理过程是动态的、按需的,而不是每次把整座文档山搬进上下文窗口。
到这还差最后一道保险:生产级系统不能没有可追溯引用和评测闭环。Agent 给出的最终回答里,必须明确标注每个论断来自第几页、第几段,原文片段是什么——Anthropic 的 Citations 机制已经提供了很好的范例,PDF 中可以按提取出的文本标注引用,并返回页码范围。
评测体系同样要跟上,不是只看最终答案对不对,而是把中间每个环节拉出来量化:
|
环节 |
考察指标 |
|
检索 |
检索到的 chunk 是否来自正确页码 |
|
表格解析 |
行列值是否准确 |
|
OCR |
有没有漏字错字 |
|
图表理解 |
图表信息有没有被正确理解 |
只有把这些指标搭起来,你才有能力持续迭代 PDF RAG 系统,而不会让它在生产环境里慢慢腐化。
跳出这道题本身,面试官真正在考察的,是你面对非结构化数据时,有没有自底向上的工程拆解能力,和从“能跑”到“可靠”的架构意识。
做 AI 应用,越靠近数据入口的基础处理,越考验一个人对整个系统脆弱性的理解。你能把 PDF 这道脏活累活拆得明白、讲得通透,就意味着你有底气接住真正落地的项目,而不是只会把问题交给下一个环节。
最后
我们整理出这套 AI 大模型 突围资料包:
✅ 从零到一的 AI 学习路径图
✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
✅ 百度/阿里专家闭门录播课
✅ 大模型当下最新行业报告
✅ 真实大厂面试真题
✅ 2025 最新岗位需求图谱
所有资料 ⚡️ ,朋友们如果有需要 《 AI大模型 入门+进阶学习资源包》,下方扫码获取~
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。