🔥承渊政道:个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨
🎬 博主简介:
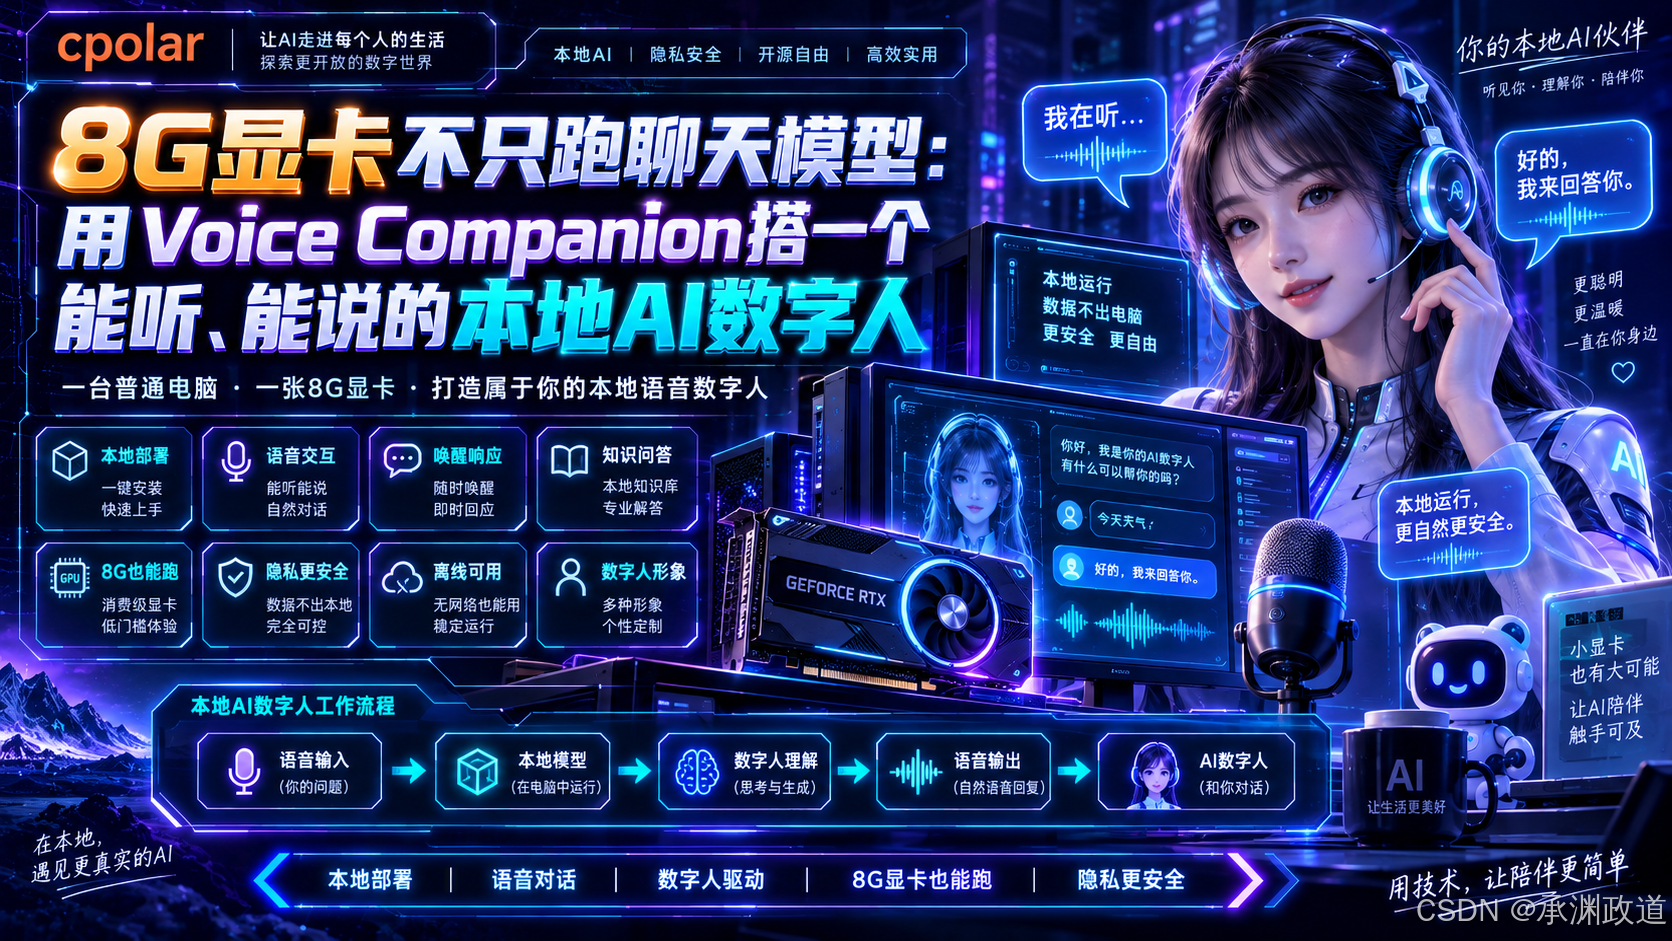
手里只有一张8G显卡时,我以前第一反应也是“能跑多大的模型”.但真折腾一阵以后,我反而更想试点不一样的:同样的显存,能不能把语音识别、大模型回复、TTS、音色和数字人口型串成一套完整交互,而不是一直盯着参数量和跑分.Voice Companion Bundle 吸引我的地方就在这里,它不是单独塞一个聊天模型进网页,而是把“我说话—系统听懂—模型回答—合成声音—人物开口”这条链真正接起来.对我来说,这种项目好不好玩,关键不在“赛博女友”这个名字,而在每一环有没有真的协同起来.这也更符合我折腾本地 AI 的习惯.这次我按 Windows + WSL2 的整合包流程部署 Voice Companion,先用 DeepSeek 在线 API 把基础语音对话跑通,再通过 LM Studio 加载本地模型并开放 12345 API 服务,把数字人的 LLM 切换成本机推理.原测试里本地模型输出约 34 token/s,生成回答时 GPU 占用也会明显上升.最后我再用 cpolar 把 Voice Companion 的 Web 页面提供到公网,固定二级子域名 voice01,并补上 HTTP Auth.整篇我会把“8G 显卡能跑”“当前模型能完整进显存”“本地链路已经验证”分别说清楚,不把一次成功测试扩大成所有 8G 显卡、所有模型都能得到同样体验.
目录
- 1.这套项目真正有意思的,不只是一个“AI 女友”界面
- 2.下载 Voice Companion Bundle整合包
- 3.先用DeepSeek在线API把整条对话链跑通
- 4.先选麦克风,再开始第一次语音对话
- 5.人设、声音和人物形象分别怎么改?
-
- 5.1助手人设
- 5.2参考音色
- 5.3人物形象
- 5.4LLM服务
- 6.用 LM Studio 在 Windows上加载本地大模型
- 7.加载模型并先单独跑一次
- 8.打开 LM Studio API 服务
- 9.把数字人的 LLM 切到本地模型
- 10.本地已经能说话,接下来才考虑远程访问
- 11.Windows安装cpolar
- 12.注册并登录cpolar Web UI
- 13.给Voice Companion 创建随机公网入口
- 14.随机地址跑通以后,再配置固定二级子域名
- 15.公网入口再加一层 HTTP Auth
- 16.总结
1.这套项目真正有意思的,不只是一个“AI 女友”界面
Voice Companion Bundle 面向的是 Windows + WSL2 环境.
它把几条原本分开的能力接到了一起:
- Faster-Whisper:语音识别;
- OpenAI 兼容接口:大模型对话;
- Qwen3-TTS:语音合成和参考音色克隆;
- LiveTalking + Wav2Lip:数字人口型同步;
- 助手人设、参考音色、人物形象:个性化配置.
所以真正的工作链是:
麦克风 → 语音识别 → LLM → TTS → 数字人口型 → 浏览器交互。
这也是我最想验证的地方.
如果只是让大模型回一句文字,8G 显卡能玩的东西其实已经很多;但把声音、模型和数字人拼成一条实时链,体验完全不一样.
项目文件、人物、音色、API Key 和运行日志按这套方案保存在本机;不过如果使用 DeepSeek 这类在线 API,模型回复这一段仍然依赖在线服务.后面换到 LM Studio,才把负责回答的 LLM 继续往本地收.
2.下载 Voice Companion Bundle整合包
先进入项目的 GitHub Release 页面,下载最新版本的 Voice Companion Bundle.
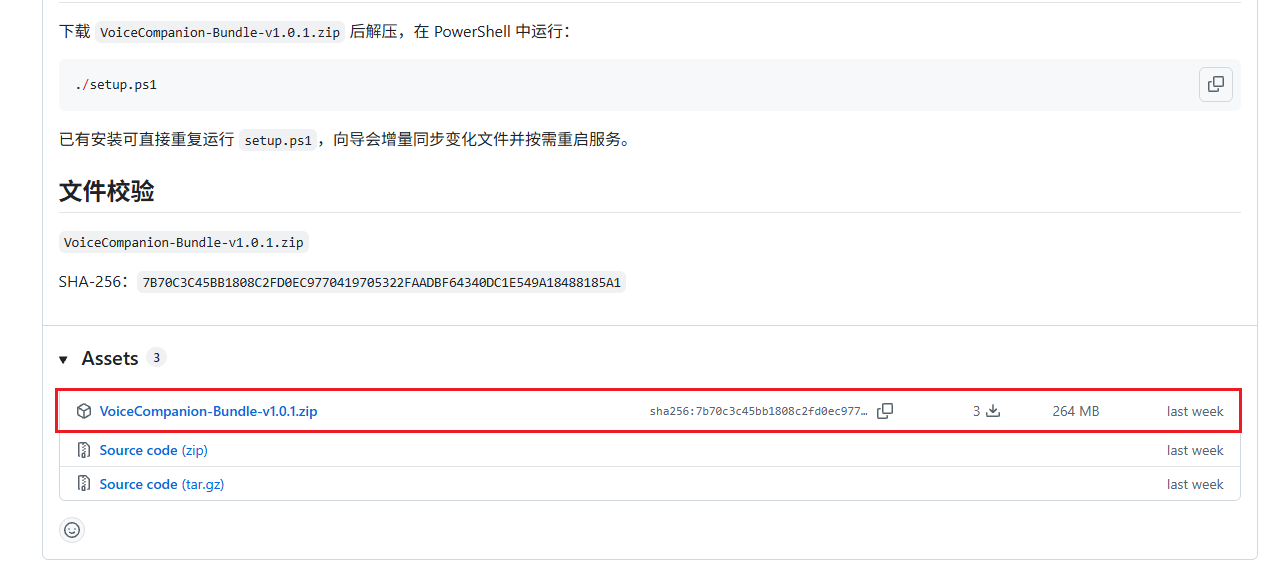
下载以后解压.
目录里可以看到:
setup.ps1
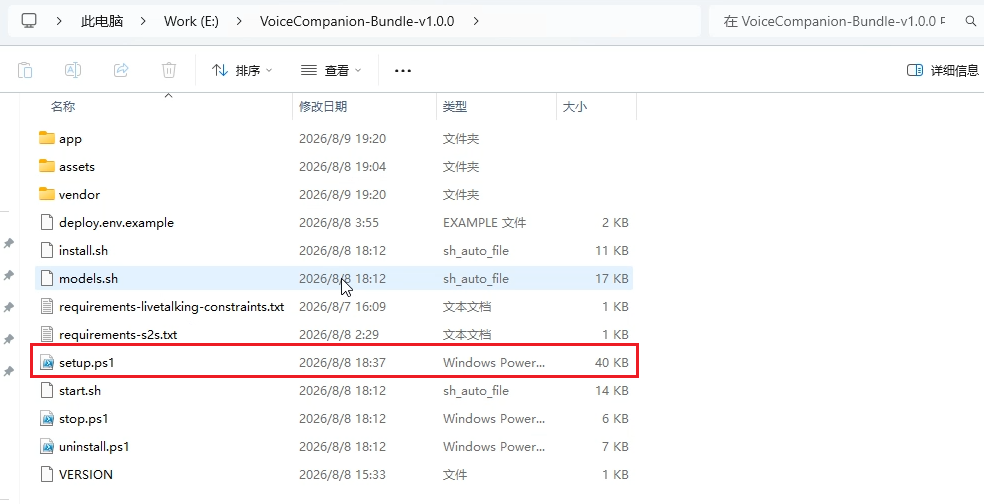
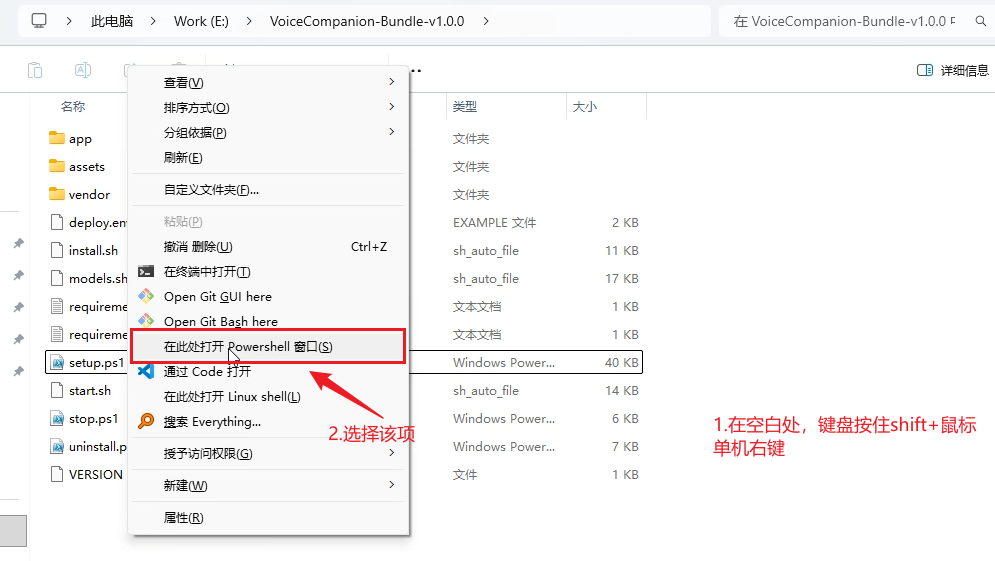
在当前目录空白处按住 Shift,点击鼠标右键,选择:
在此处打开 PowerShell 窗口
然后执行:
./setup.ps1
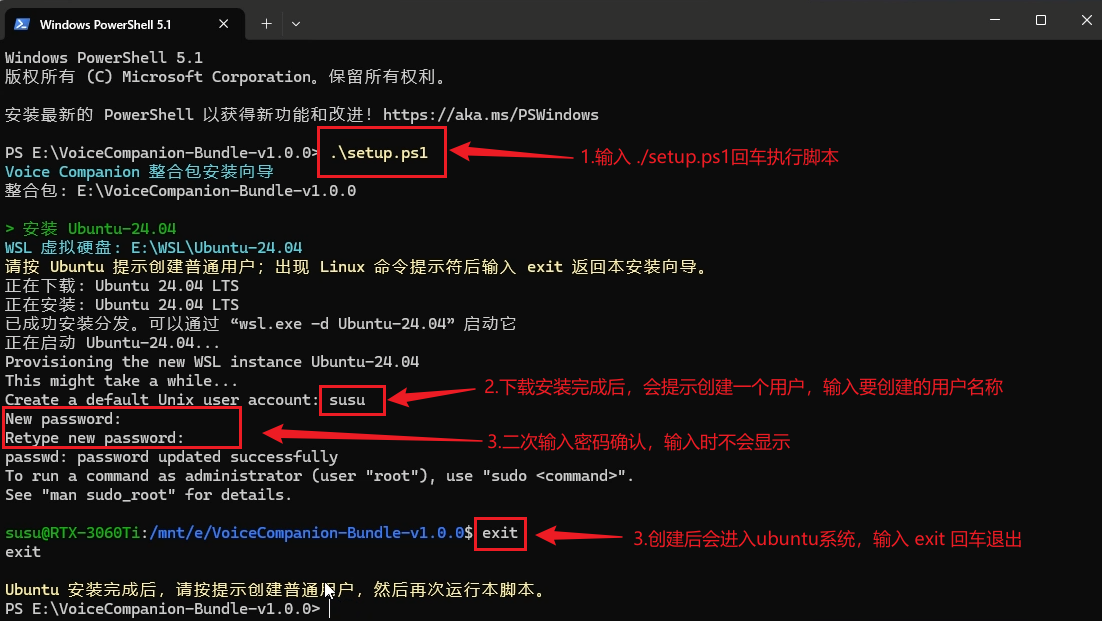
第一次执行时,会下载安装 Ubuntu 并创建用户.
完成以后,再执行一次:
./setup.ps1
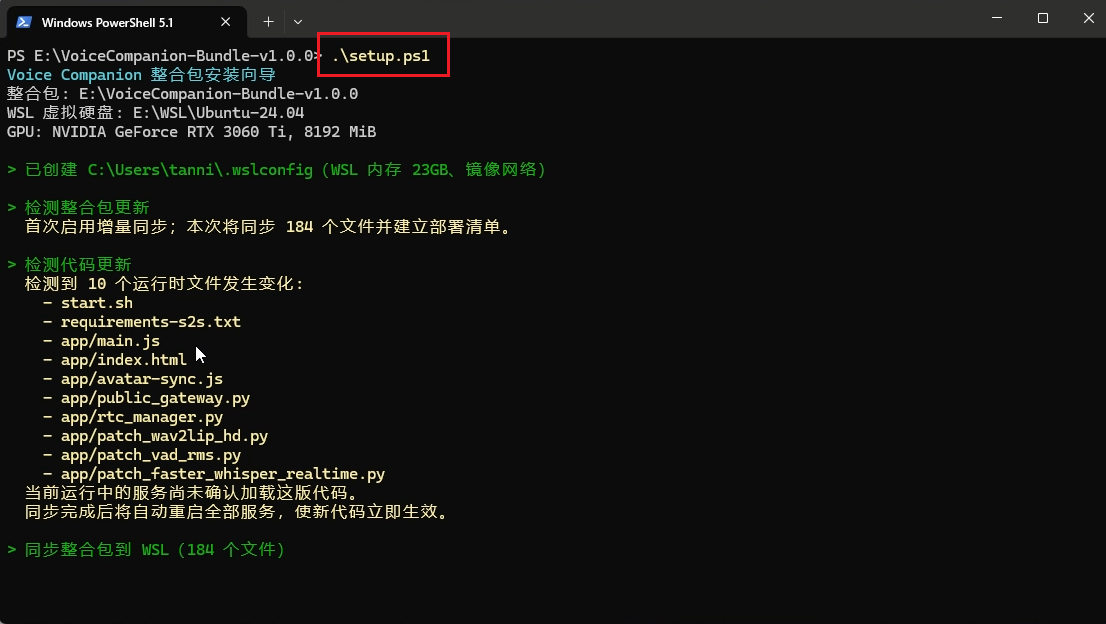
脚本接下来会根据显卡给出推荐档位,并测试下载源.
默认直接回车即可.
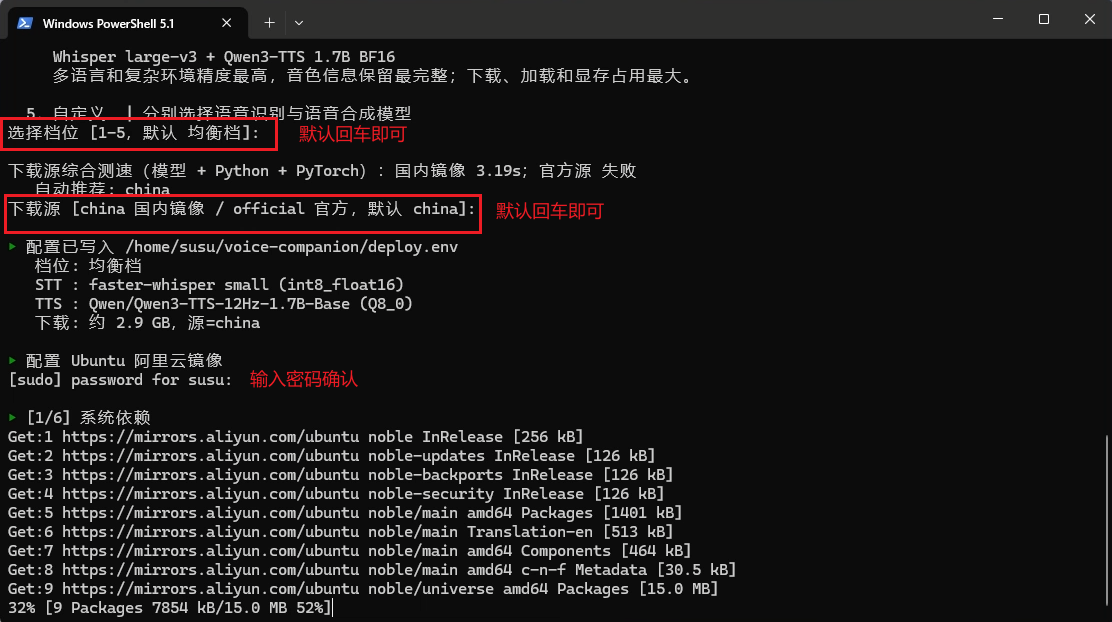
后续会继续下载系统依赖、Python 包管理环境、项目资源、数字人资源以及 Qwen TTS 相关资源.
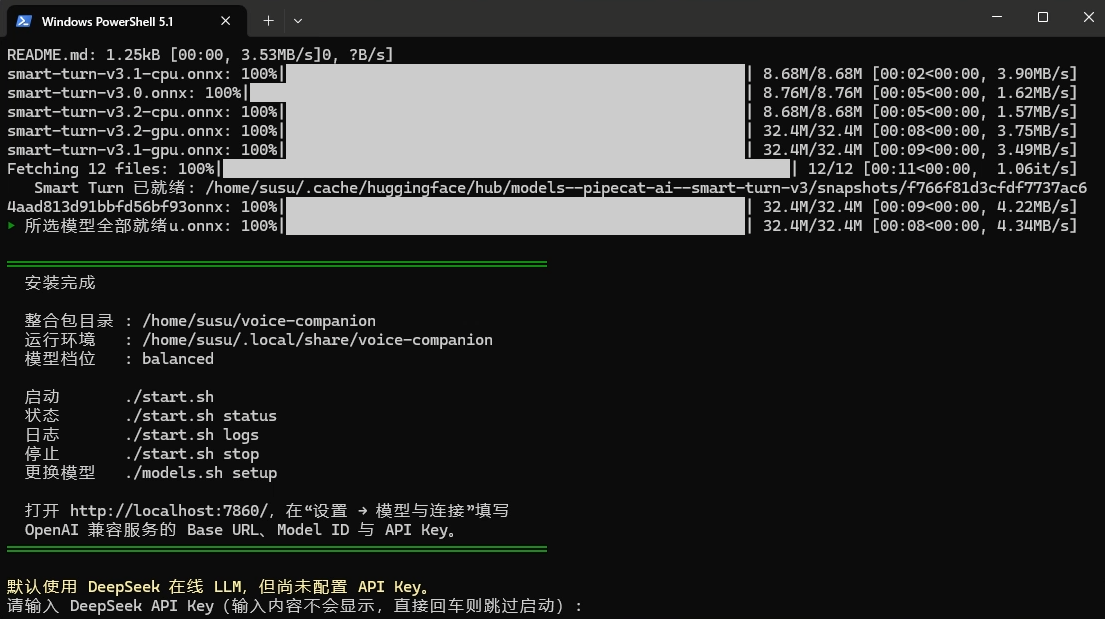
对我来说,这种整合包最大的价值不是“完全不用懂环境”,而是先把最容易互相冲突的一堆组件装到能启动的状态.
真出了问题,还是要知道语音、模型、TTS 和数字人分别是哪一层.
3.先用DeepSeek在线API把整条对话链跑通
安装过程中会要求填写 DeepSeek API Key.
创建地址按原步骤保留:
https://platform.deepseek.com/api_keys
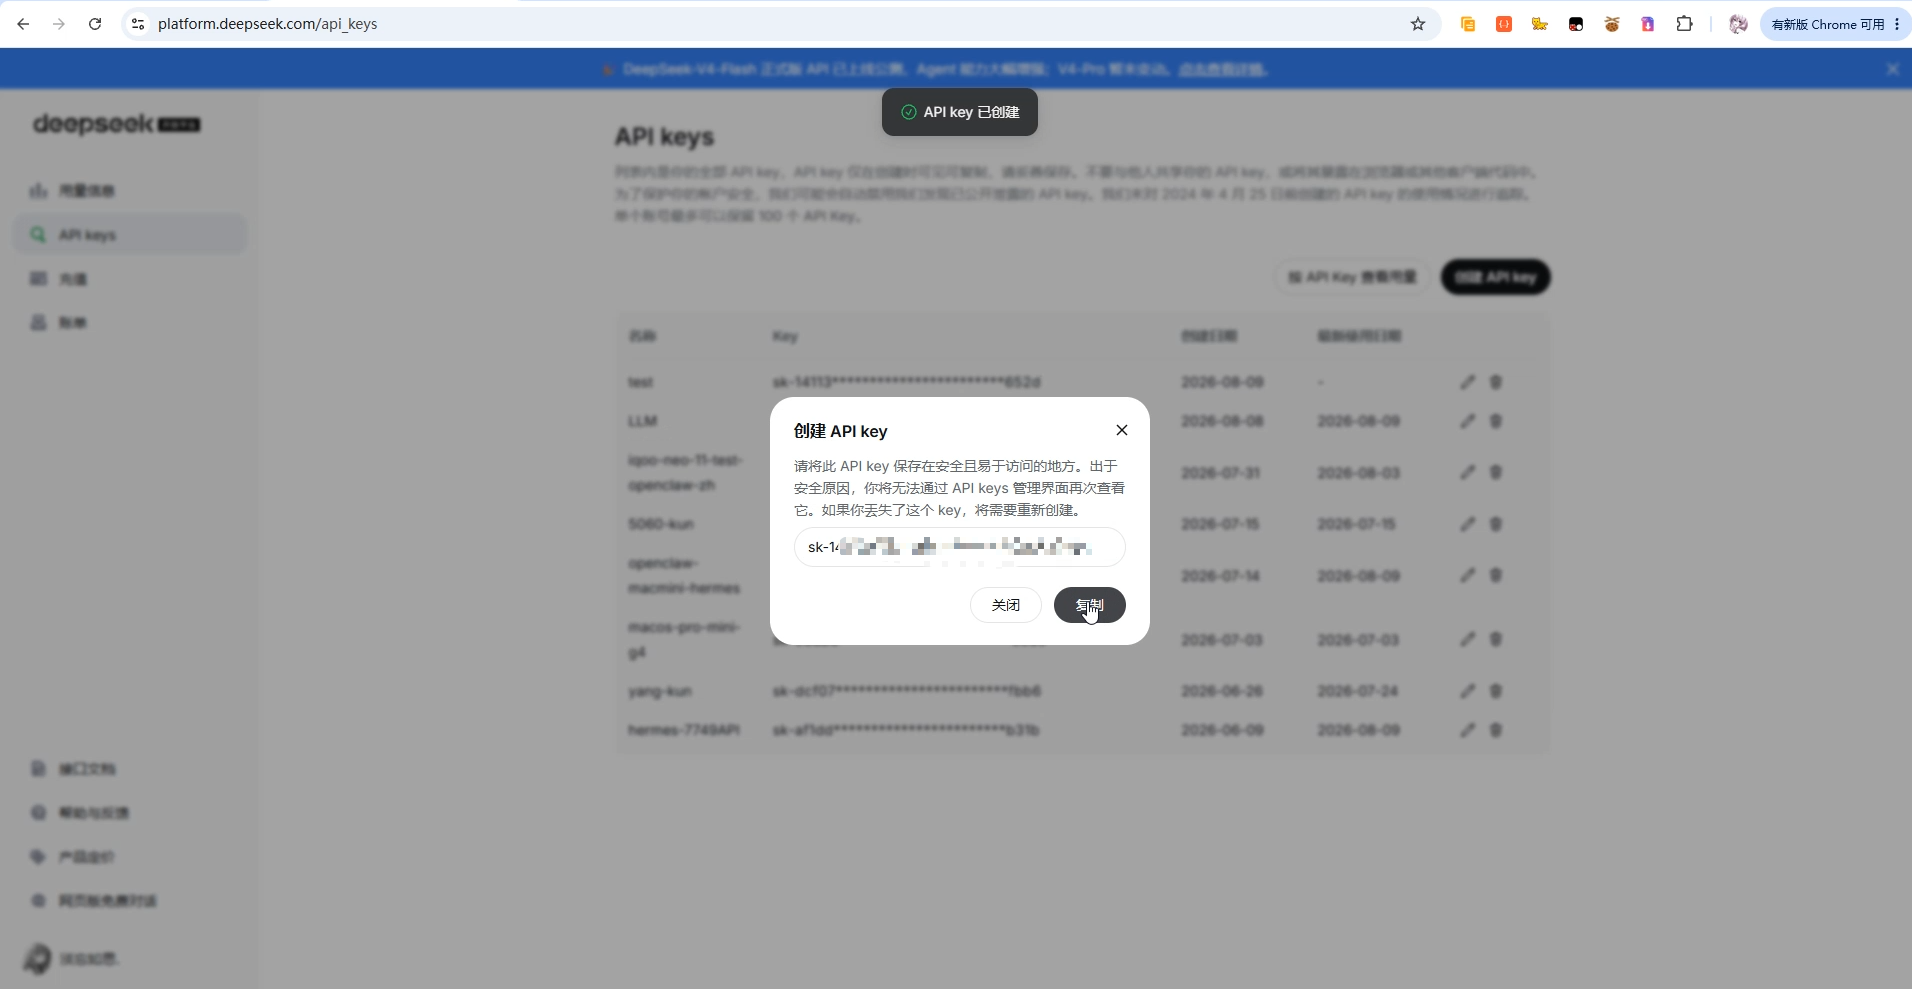
创建以后,把 Key 回填到终端.
当前流程默认先使用在线 LLM,这样可以减少本地显卡在大模型推理这一段的压力.
填完以后会继续启动数字人服务.
服务启动成功后,浏览器自动打开页面.
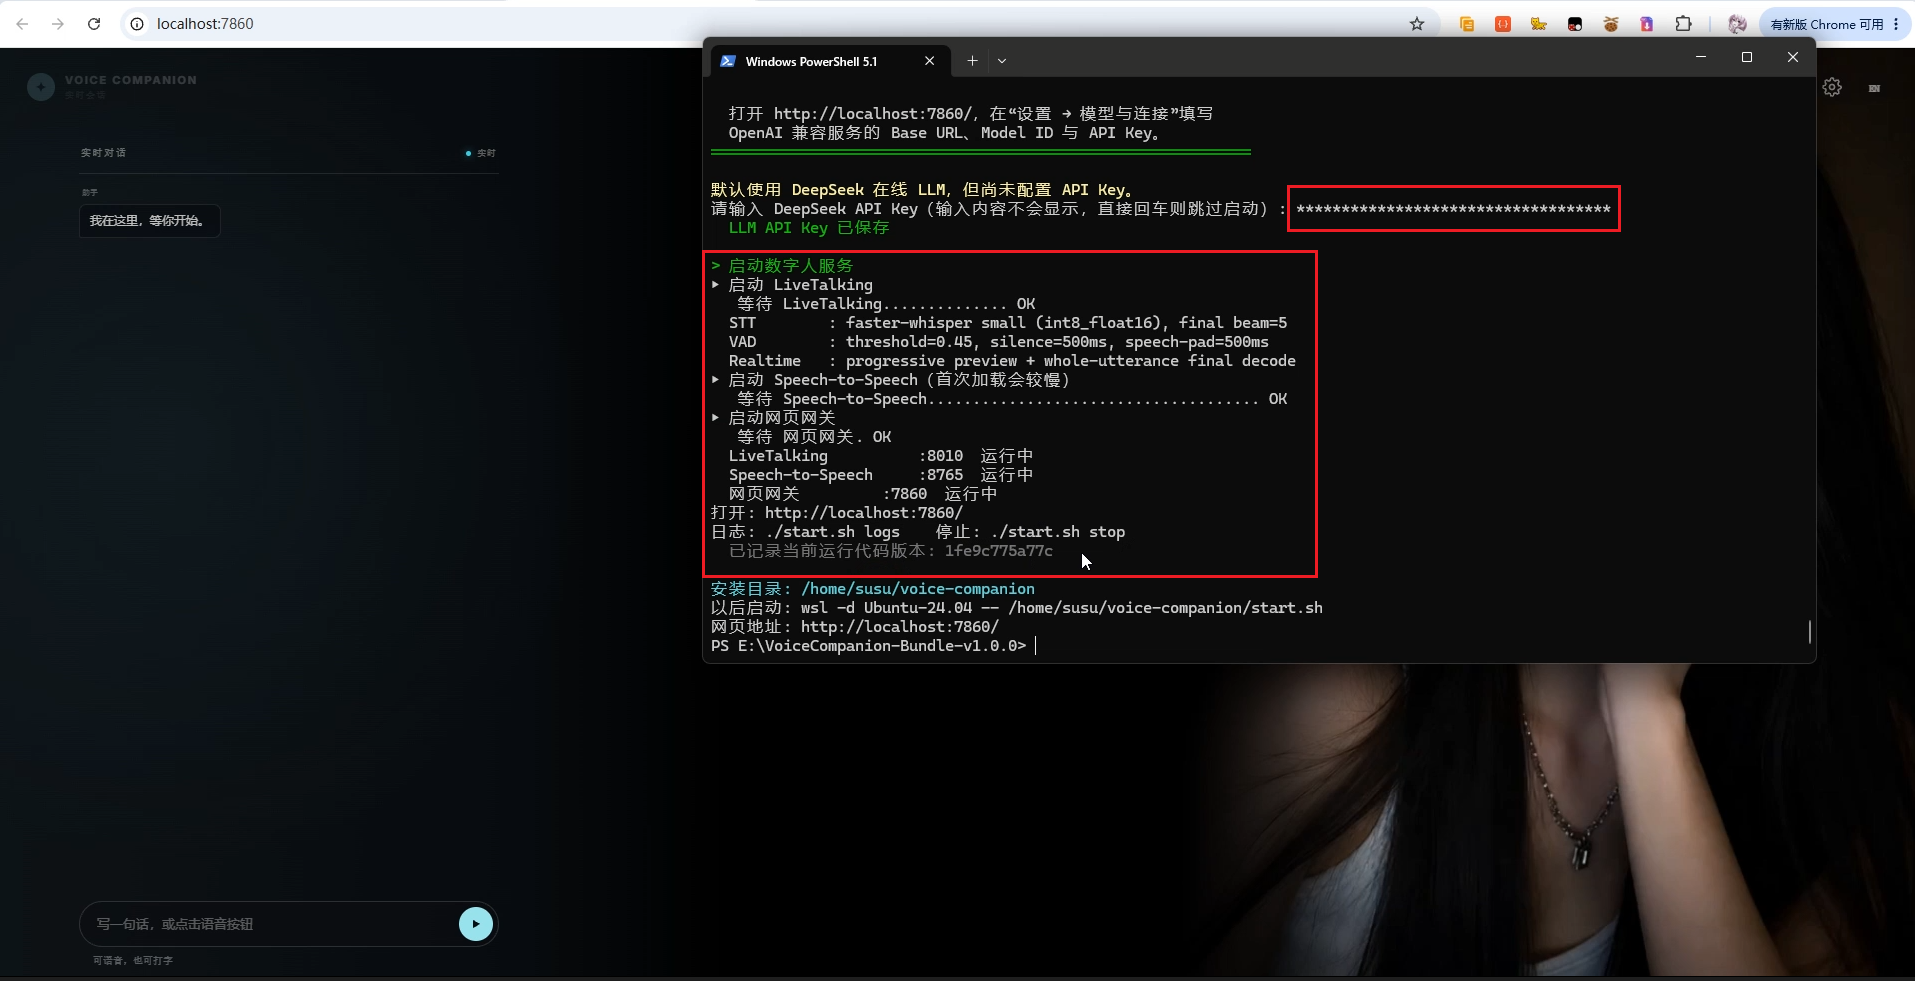
到这里并不是所有功能都验证完成了,只能说明整合包已经安装并成功启动.
真正好不好用,还是要开口说话.
4.先选麦克风,再开始第一次语音对话
进入页面后,先点击左上角设置,选择当前使用的麦克风设备.
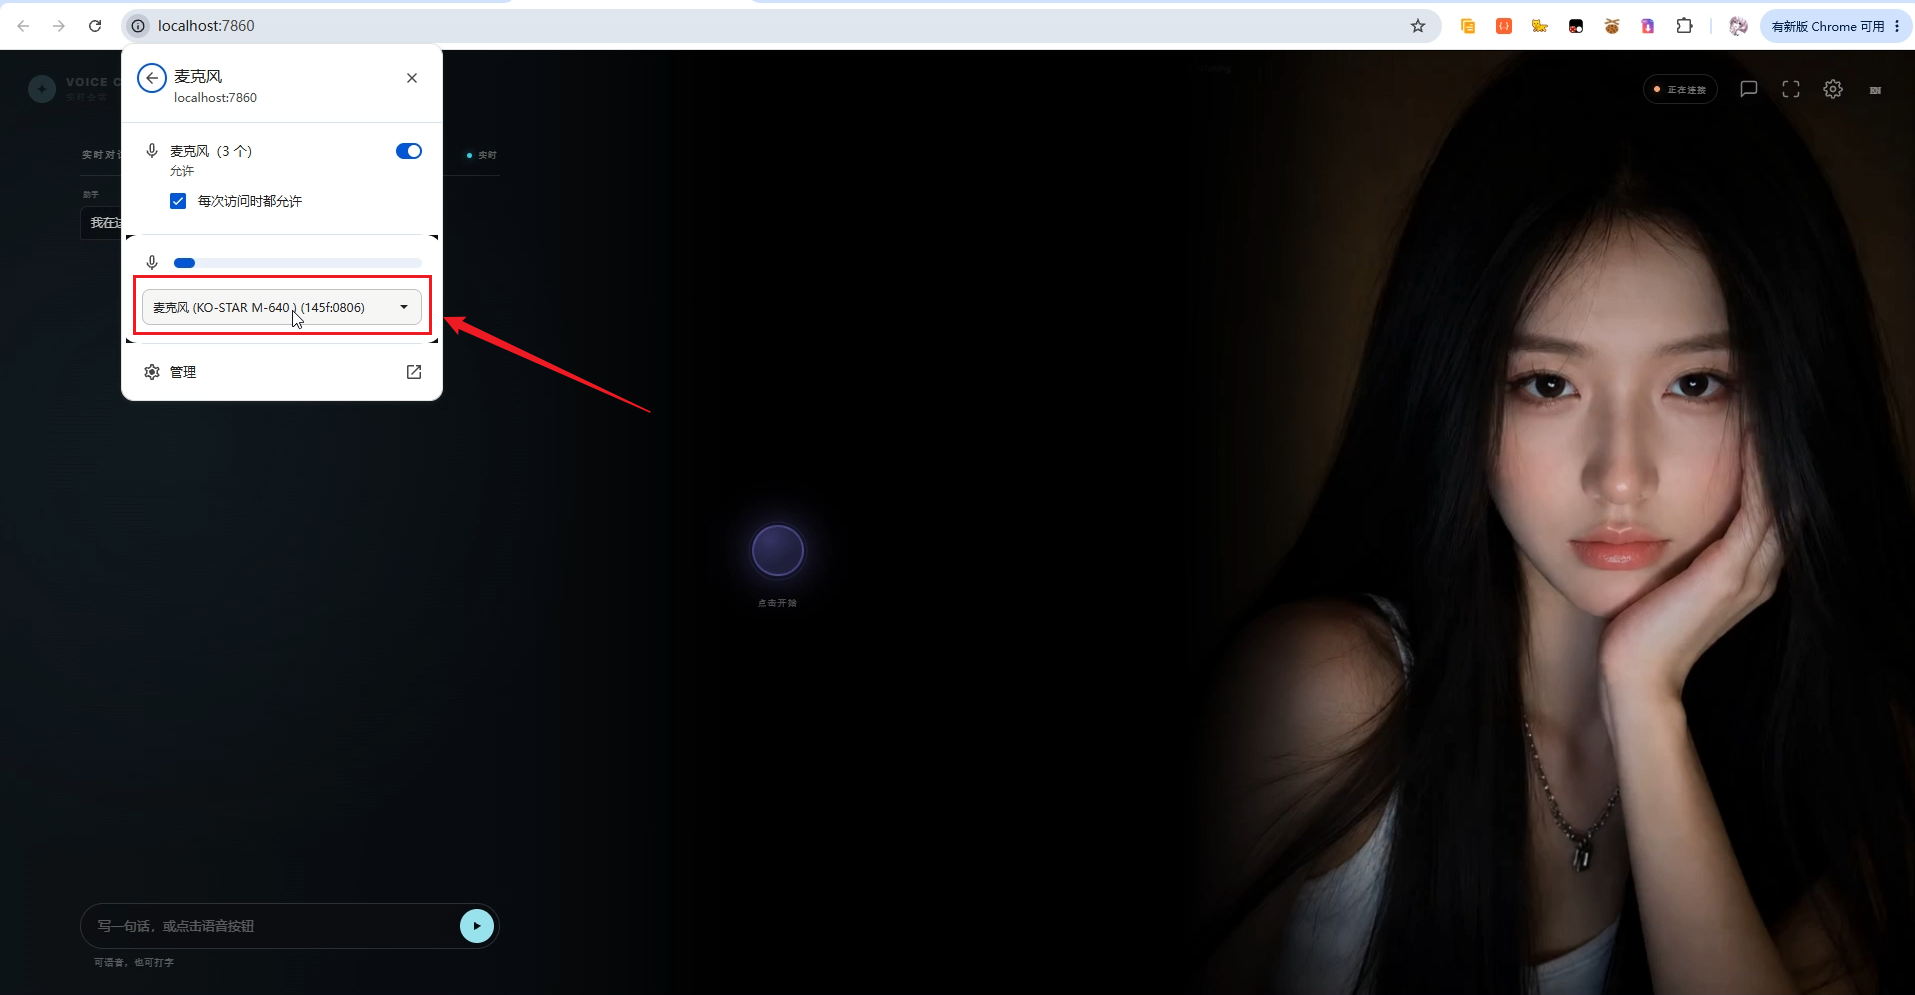
然后点击:
开始
稍等以后,数字人会先进行一次语音回应,同时人物口型跟随声音变化.
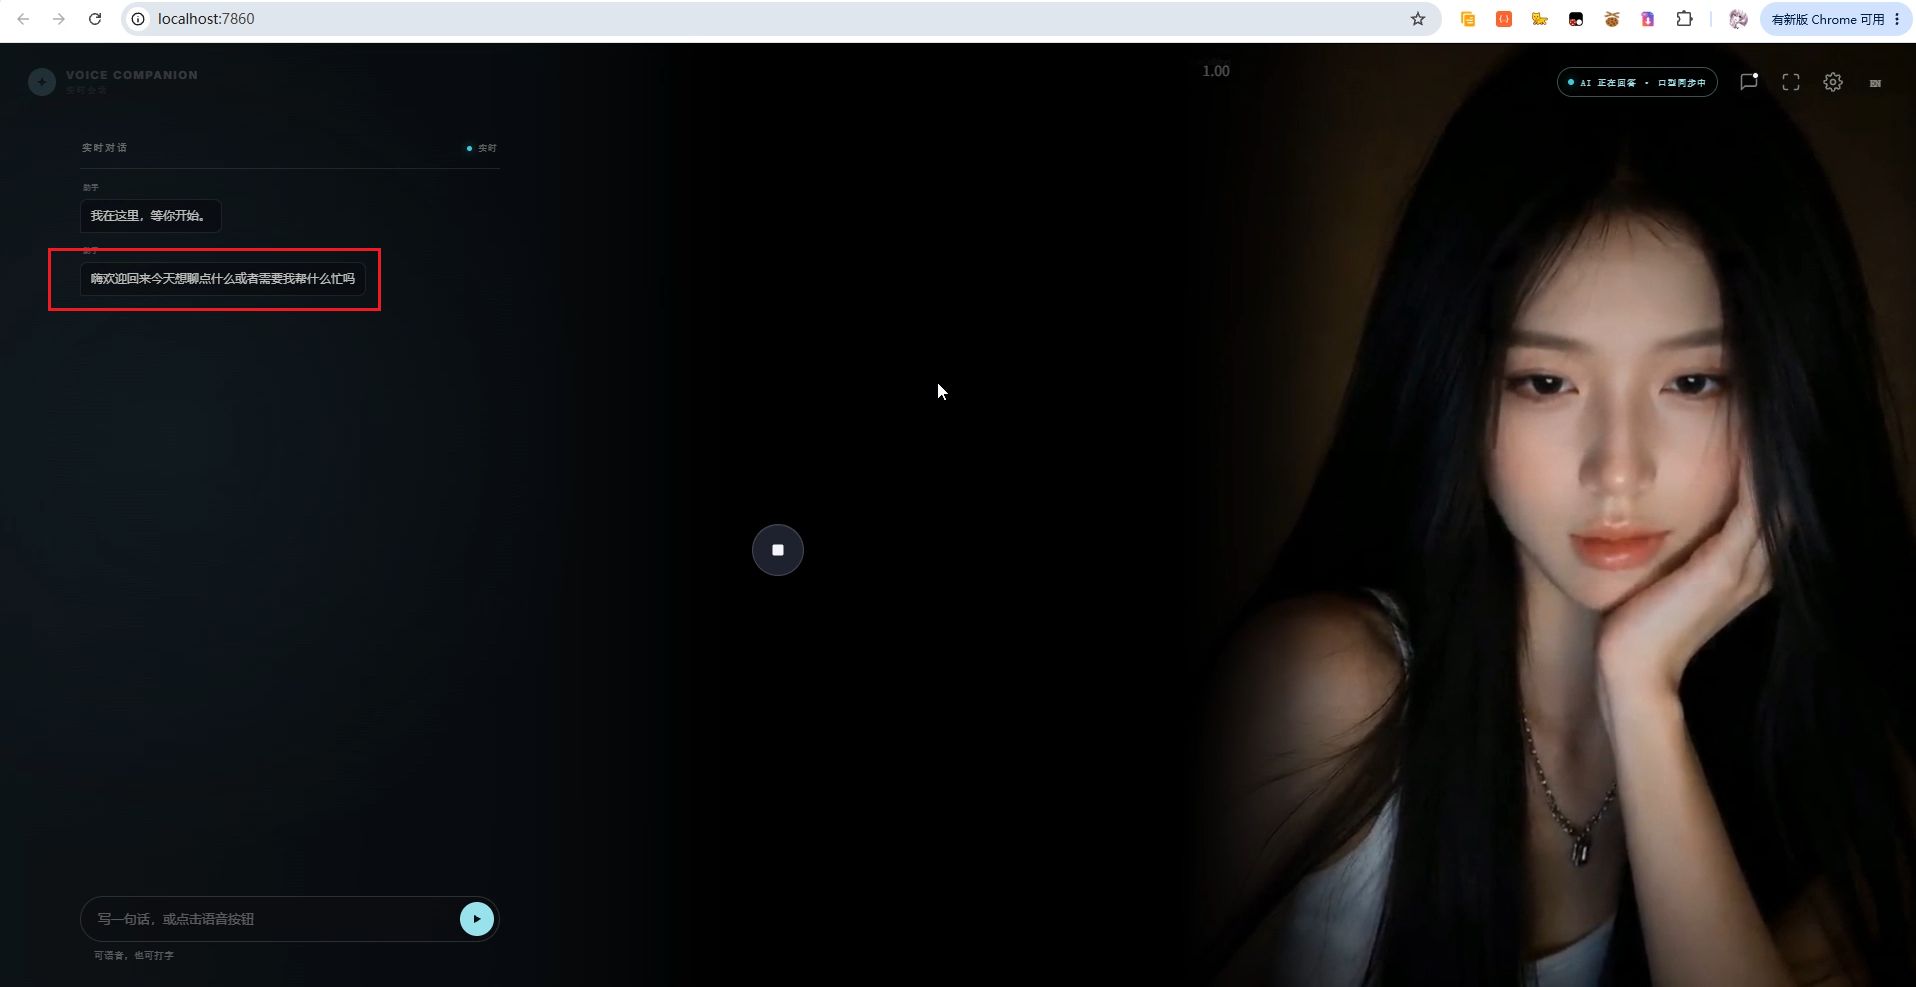
回答结束后出现麦克风,就可以直接说话.
如果环境噪声比较大,还可以调整麦克风噪声门限.
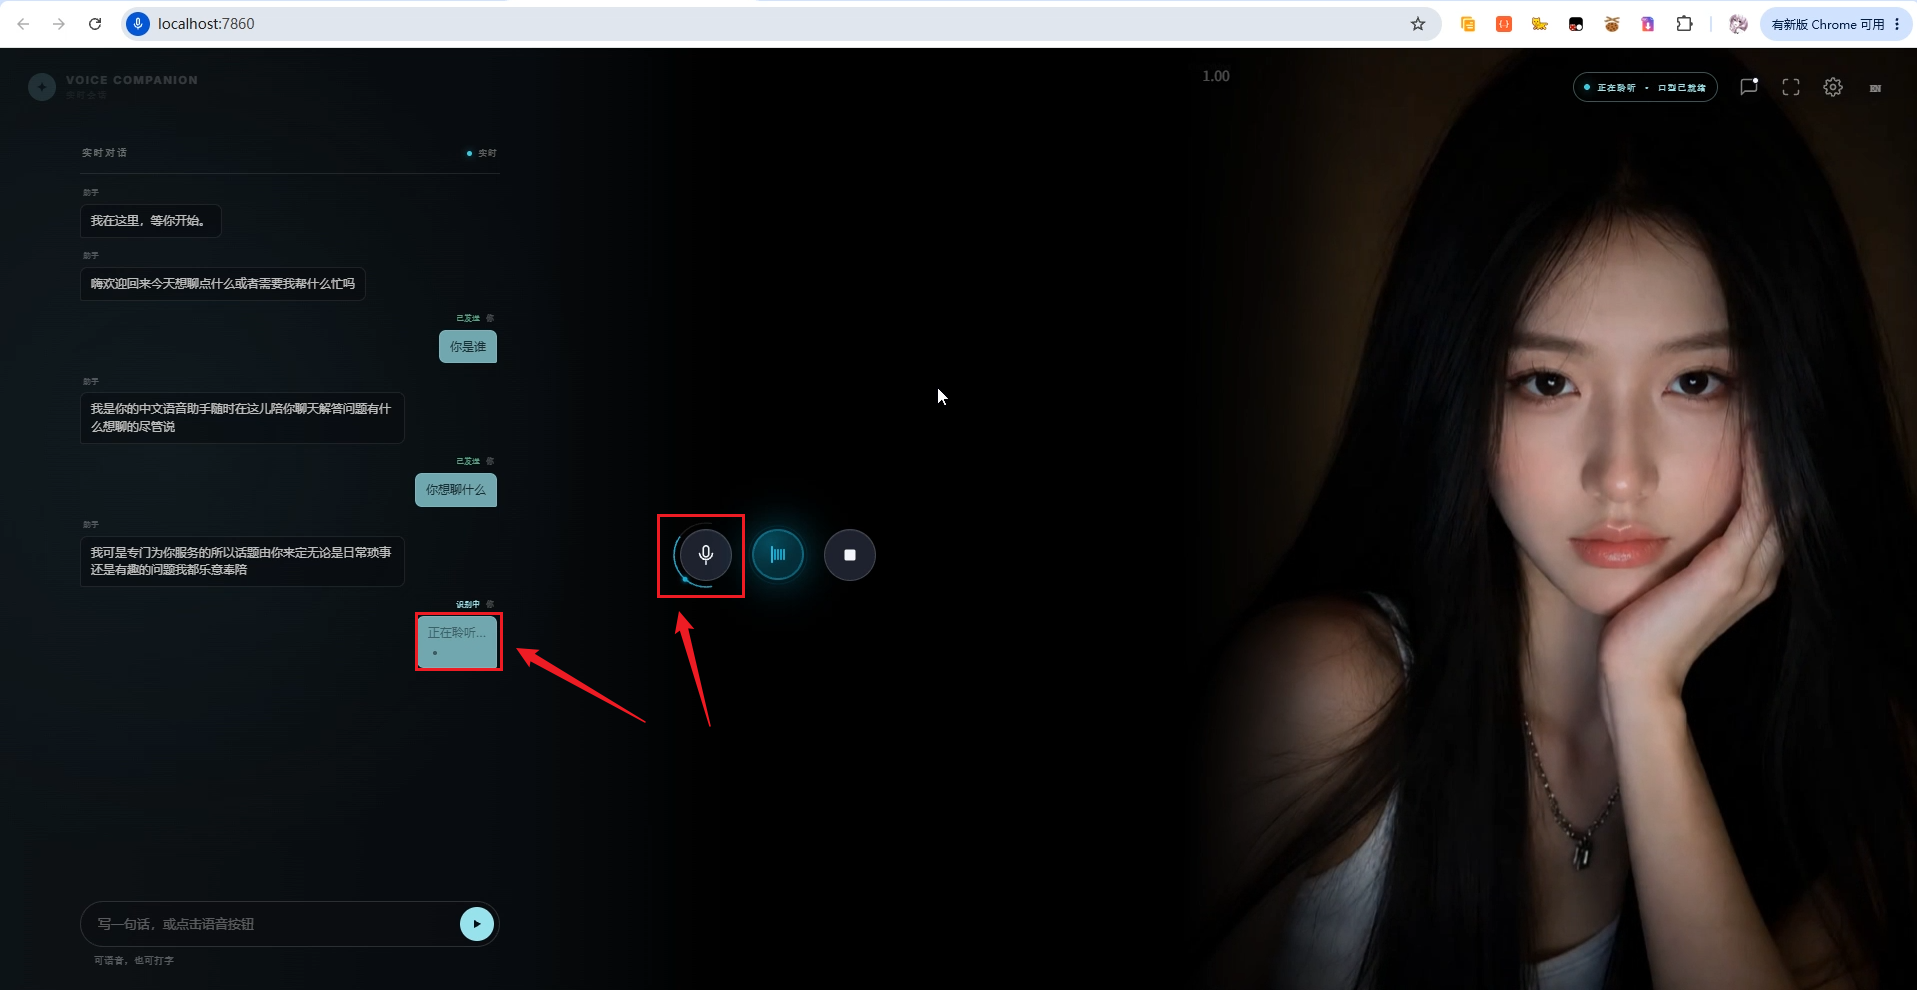
这一层实际验证的是:
麦克风输入 → 语音识别 → 在线 LLM 回复 → TTS → 数字人口型。
我会先确认这条基础链稳定,再去改人设、换声音、换模型.
5.人设、声音和人物形象分别怎么改?
右上角的设置里,几块内容是分开的.
5.1助手人设
助手页面可以修改人物设定.
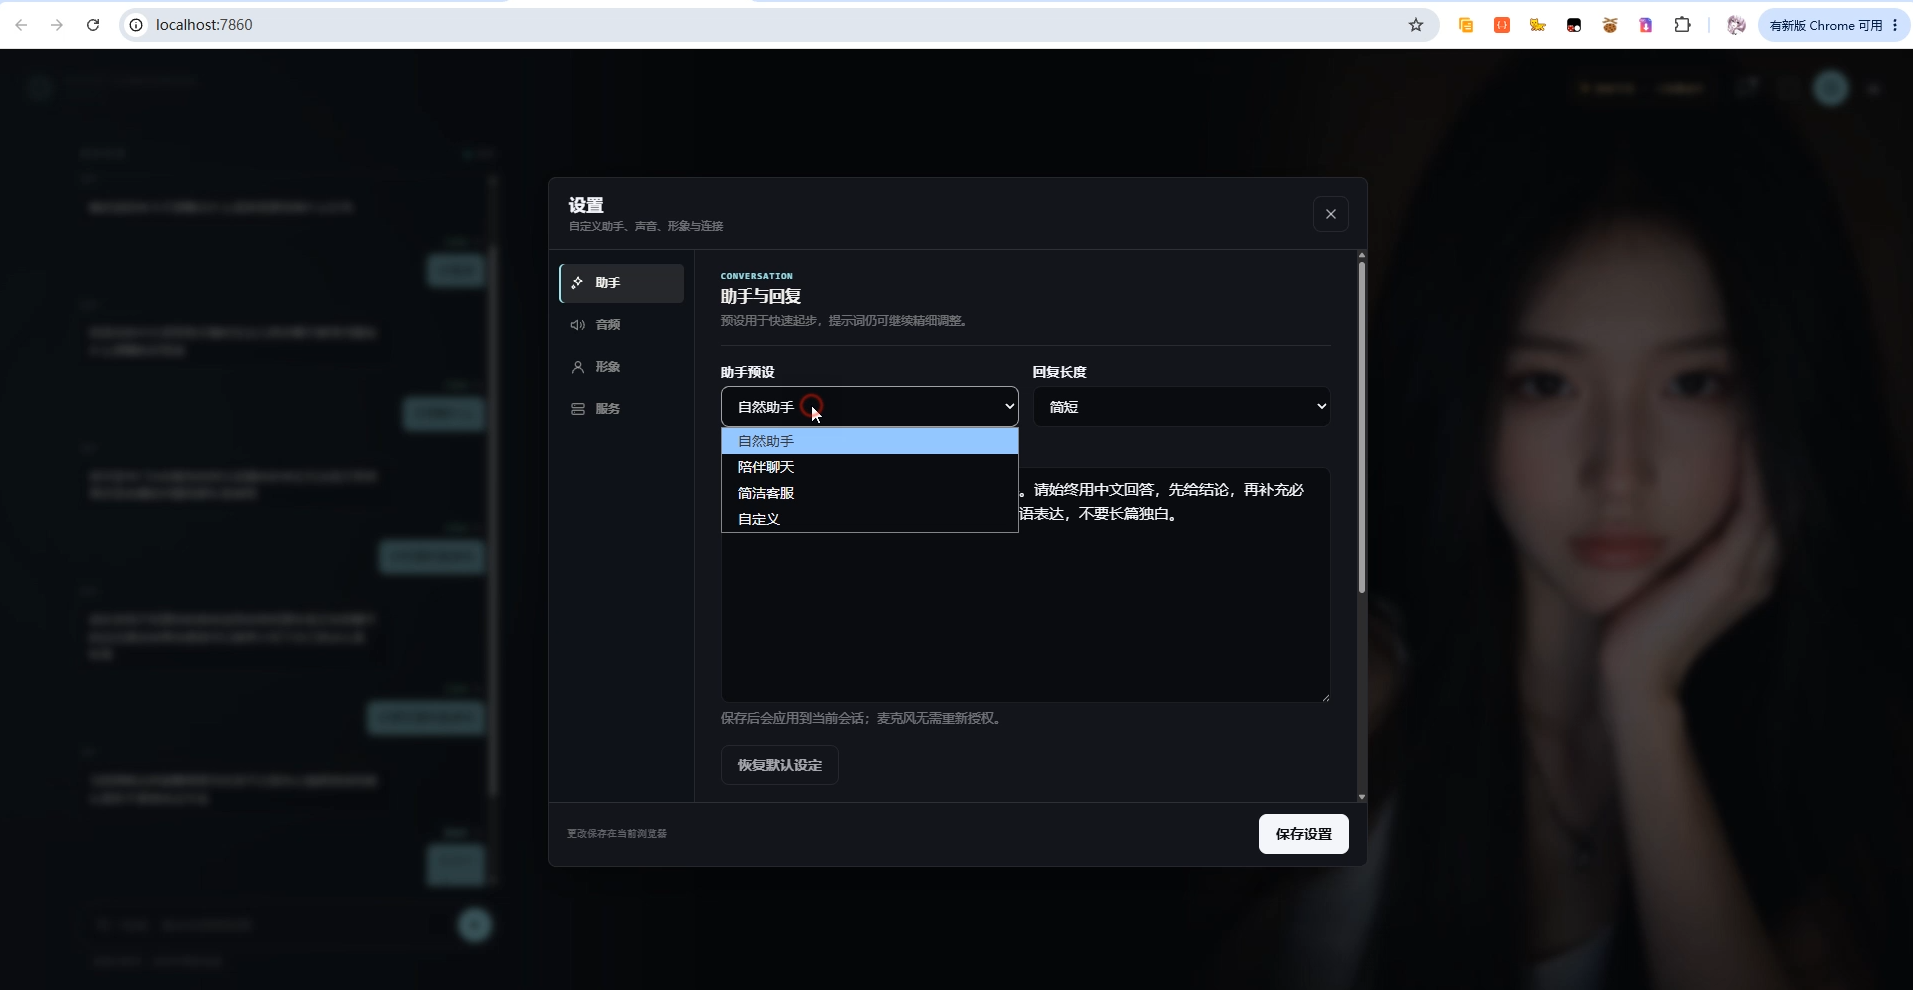
这里影响的是 AI 回答时的人设和表达方向,不是人物视频本身.
5.2参考音色
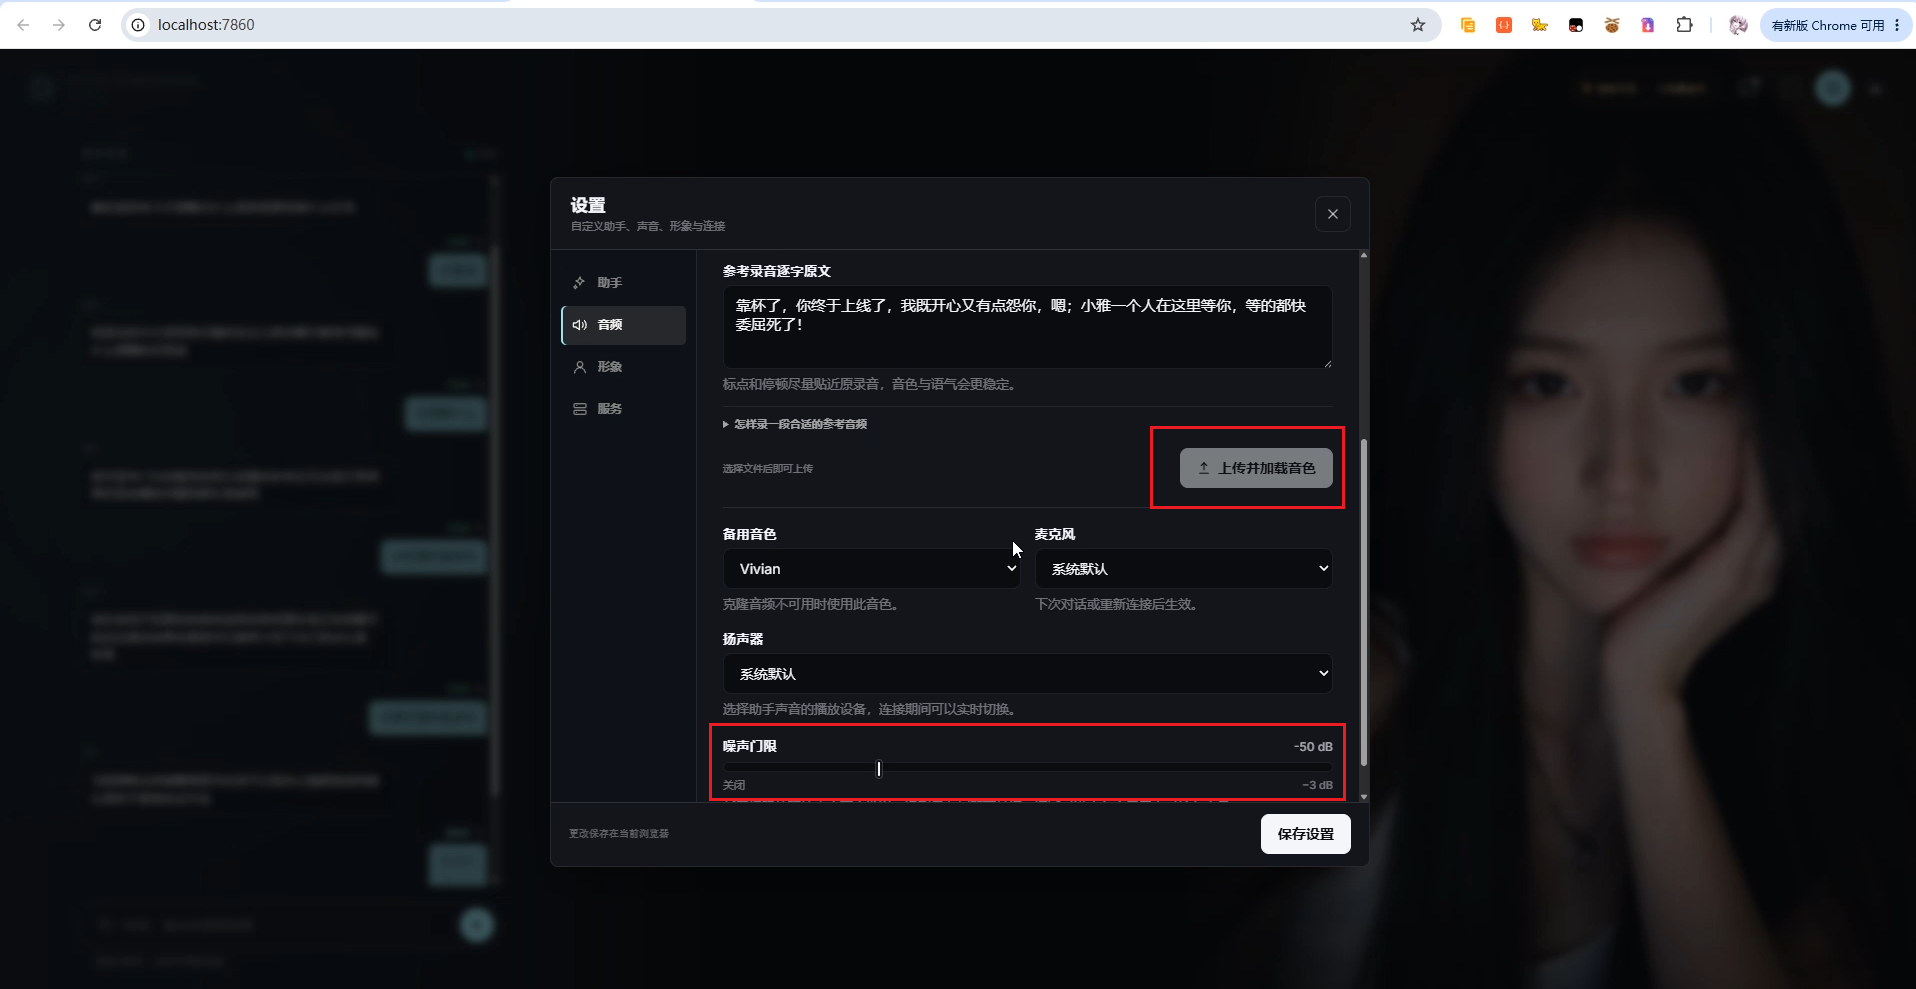
音频页面可以上传参考音频,用于音色克隆.
噪声门限也在这里调整.
5.3人物形象
形象页面可以上传人物视频,生成新的数字人形象.
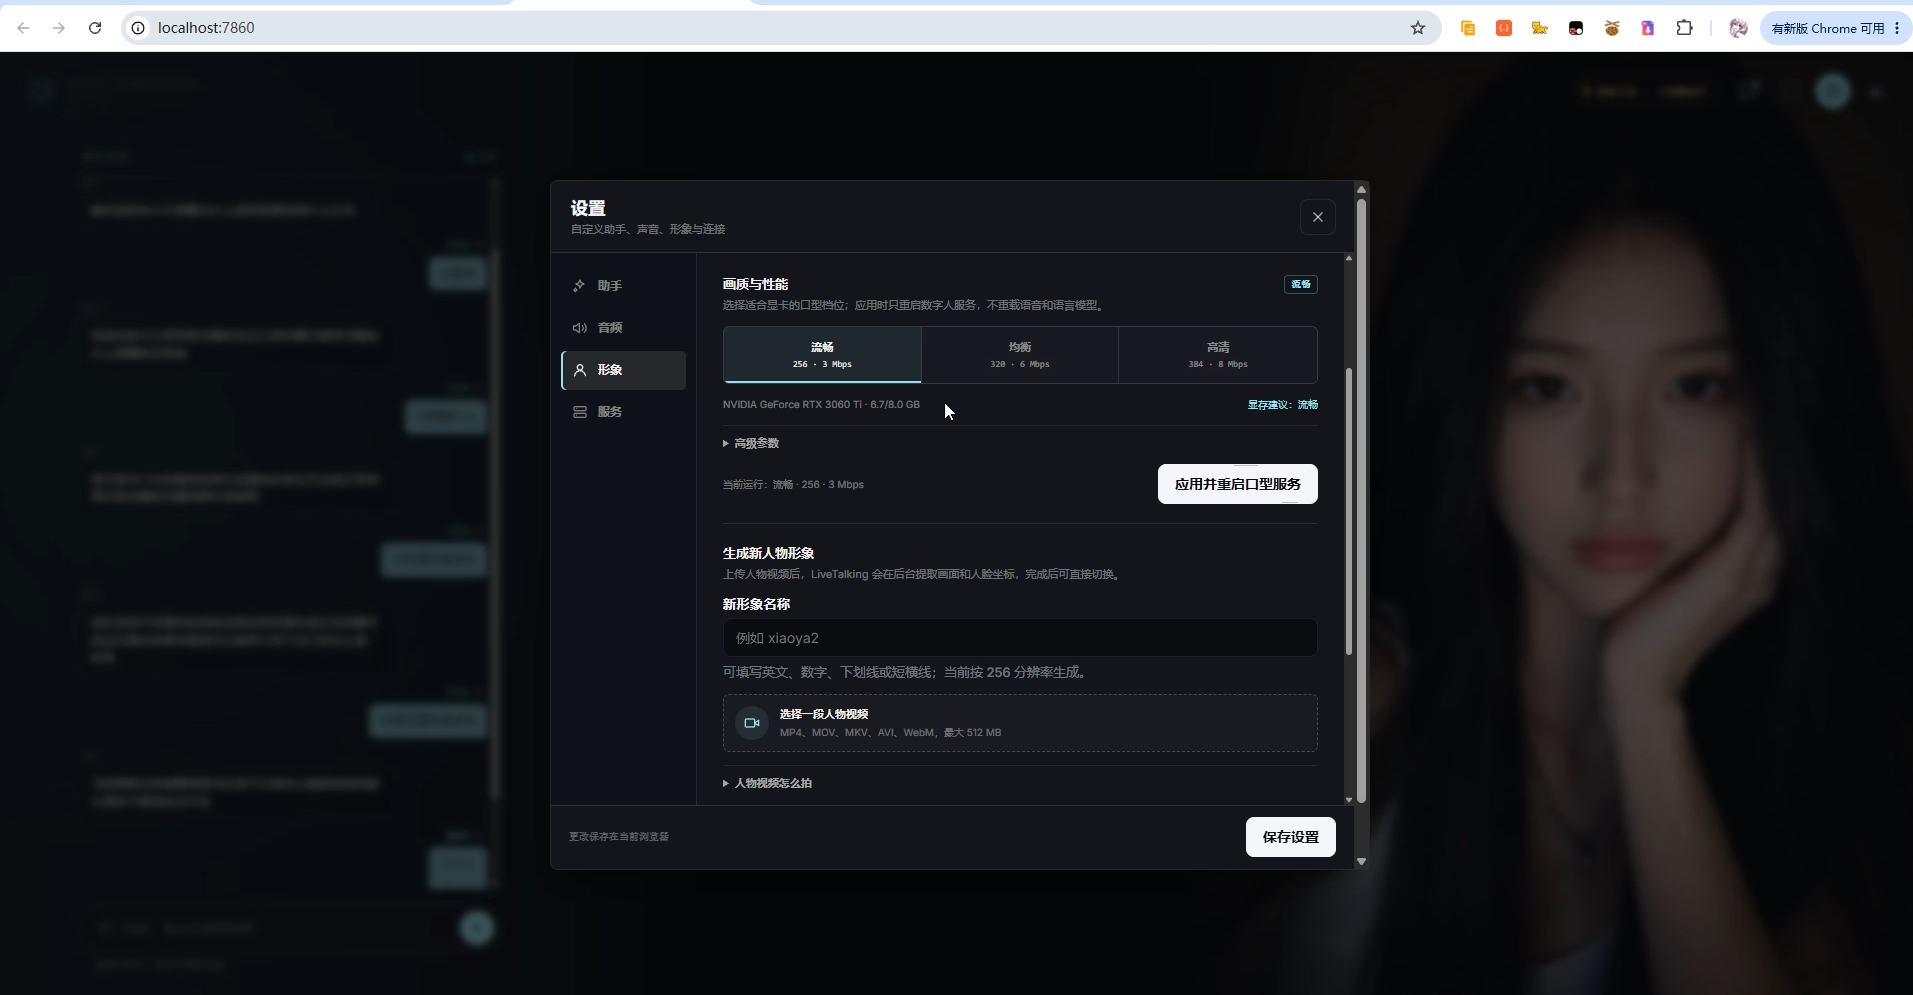
原步骤里也明确提到,数字人形象会占用一定显存,可以根据需要调整画质.
这一点对 8G 显卡尤其重要:显存不只给 LLM 用,数字人和语音链里的其他组件也会一起争资源.
5.4LLM服务
服务页面负责配置对话模型.
默认已经使用 DeepSeek 在线 API,也支持增加其他 OpenAI 兼容服务.
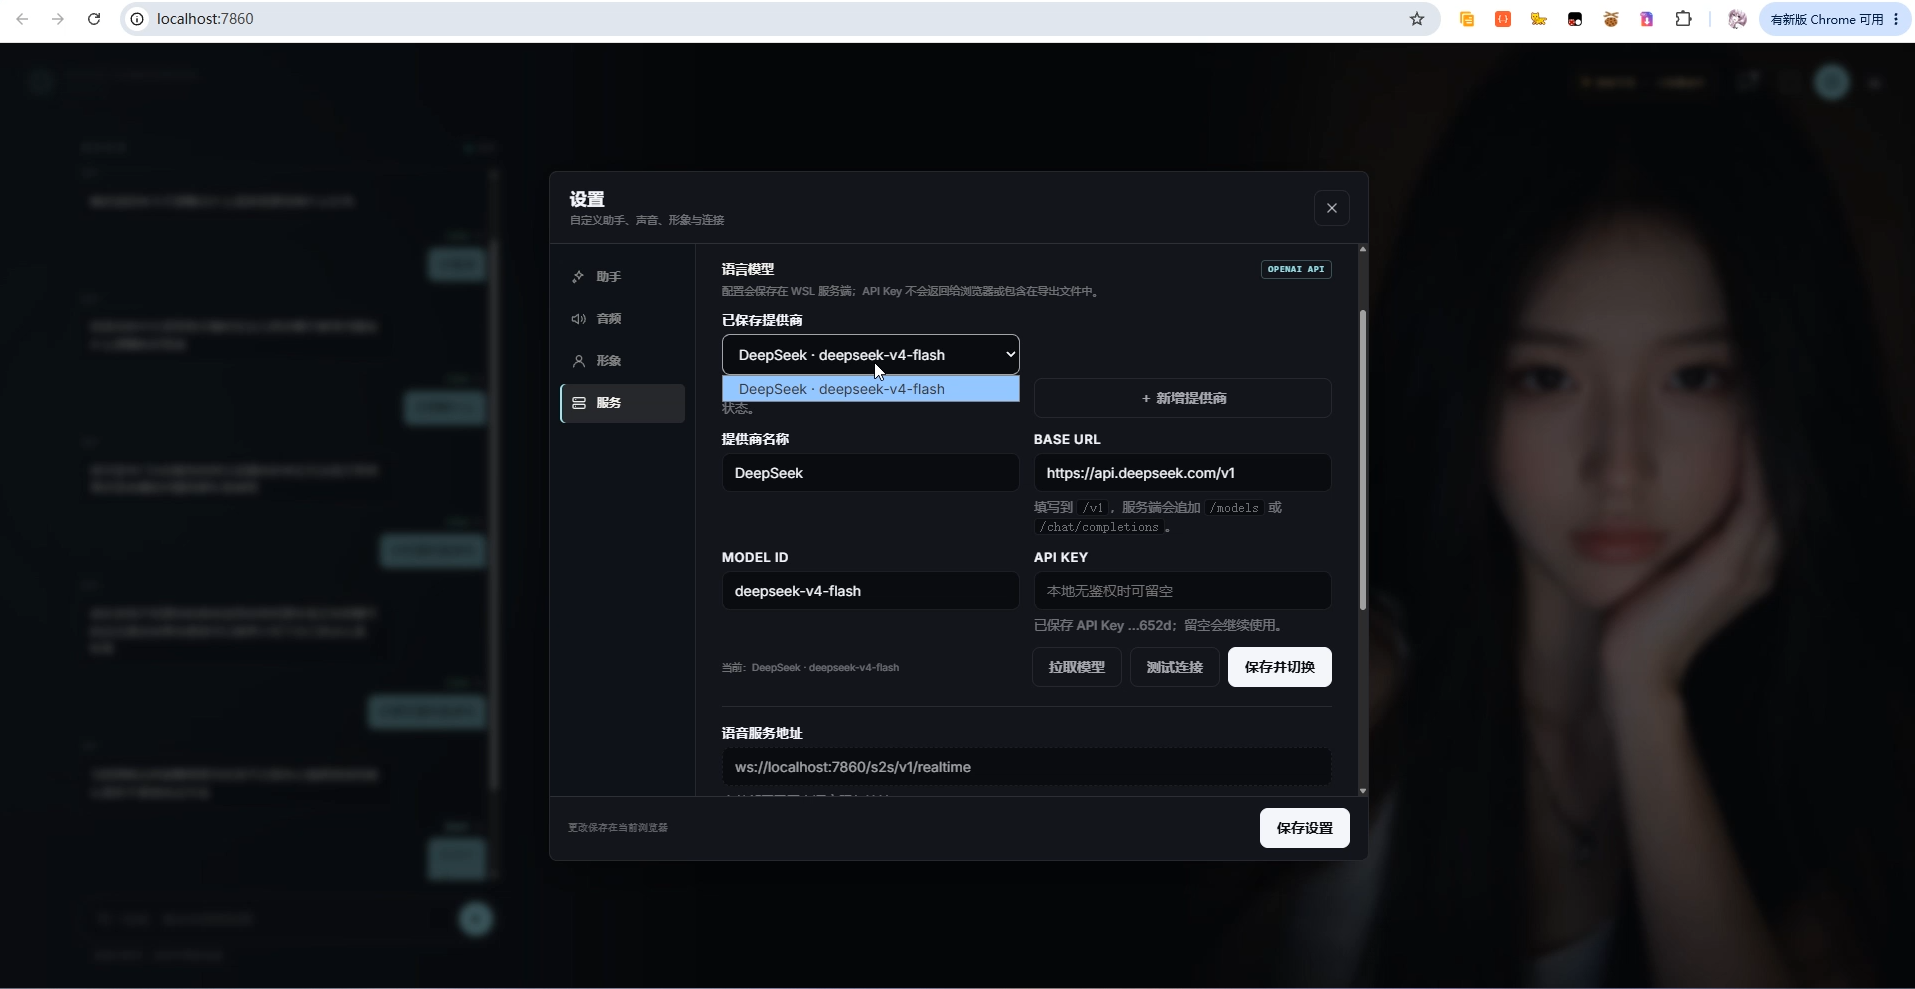
下一步我就把这一层切成本地模型.
6.用 LM Studio 在 Windows上加载本地大模型
打开 LM Studio 官网,下载安装 Windows 版本.
原文给出的下载地址是:
https://lmstudio.ai/download
安装完成进入界面后,可以先从左下角设置里切换中文.

接着进入模型页面.
这次示例使用的是 gemma 4,并选择了一个点赞较多的无审查版本.

页面出现:
可能能够完全加载进 GPU 显存
以后,再下载当前模型.

这里我不会把这句话直接改写成“所有 8G 显卡都能完整加载 gemma 4”.
它只是当前模型、当前量化和当前机器下 LM Studio 给出的判断.
7.加载模型并先单独跑一次
下载完成后,在顶部选择模型并加载.

加载成功后先在 LM Studio 内部测试.
这次输入:
你好

当前测试输出速度约为:
34 token/s
到这里确认的是:
本地模型在这台机器上已经能够独立推理。
这个数值属于当前实测,不代表换一张 8G 显卡、另一个模型或不同上下文以后还会保持相同速度.
8.打开 LM Studio API 服务
接下来进入 LM Studio 左侧第二个页面.
在 Server Settings 中,把端口设置为:
12345
然后启动服务.

日志里可以看到服务已经启动.

当前 Base URL 是:
http://localhost:12345
这一步把 LM Studio 从“本机聊天软件”变成了 Voice Companion 可以调用的本地 OpenAI 兼容服务.
9.把数字人的 LLM 切到本地模型
回到 Voice Companion.
进入:
设置 → 服务
点击新增提供商.
提供商名称可以自定义.
BaseURL 填:
http://localhost:12345
模型 ID 先输入任意字符,再点击拉取模型;拉取成功后删除刚才的任意字符,从下拉框中选择前面加载的本地模型.
测试成功以后保存并切换.

回到主页,再点击:
开始
重新进行语音对话.

当前测试里,在数字人生成回答时 GPU 占用会明显上升.
这说明这一次对话的 LLM 回复已经切换到本机推理.
所以到这里,实际验证到的链路是:
语音识别 → 本地 LLM → TTS → 数字人口型。
我更愿意把“进一步本地化”这样理解,而不是简单说成“完全离线”.
因为页面、模型文件和交互链可以在本机协同运行,但具体有没有其他依赖,还要看你实际启用的组件和配置.
10.本地已经能说话,接下来才考虑远程访问
前面的 Voice Companion 主要还是运行在本地电脑上.
人在外面以后,本地地址自然就访问不到.
这里再加入 cpolar.

cpolar 在这套方案里只负责:
把 Voice Companion 的 Web 页面提供到公网。
它不负责语音识别,不负责大模型回复,也不参与 TTS 或数字人口型.
所以这一段只解决:
远程浏览器怎么进入本地 Voice Companion 页面。
11.Windows安装cpolar
进入下载页面,下载 64-bit 安装包.

安装完成后,在 CMD 中检查版本:
cpolar version

出现版本信息以后,说明安装完成.
12.注册并登录cpolar Web UI
进入 cpolar 官网注册账号.

完成注册.

浏览器访问:
http://127.0.0.1:9200

登录以后进入 Web UI.

13.给Voice Companion 创建随机公网入口
进入:
隧道管理 → 创建隧道
本地地址填写 Voice Companion 项目的访问端口,然后创建.

创建以后进入在线隧道列表,可以看到同一隧道对应的两条不同协议公网地址.

这里使用 HTTPS 地址测试.

当前测试里,通过公网地址访问后:
- 语音对话可以继续使用;
- 数字人口型正常;
- 模型回复正常.
也就是说,这一次不仅仅是“页面能打开”,还继续验证了公网环境下的实际交互.
不过这里仍然不能自动推出所有网络环境下的实时性都会一样,外网体验还会受实际网络质量影响.
14.随机地址跑通以后,再配置固定二级子域名
如果只是临时测试,随机地址已经够用.
准备长期使用,就继续配置固定二级子域名.
进入预留页面:
https://dashboard.cpolar.com/reserved
选择与当前隧道相同的地区.
原步骤给出的示例是:
- 地区:China Top
- 名称:voice01
- 描述:任意方便辨识的备注
 填写完成后,点击【保留】按钮.保留成功后,会得到一个固定的二级子域名.
保留成功以后,回到:
隧道管理 → 隧道列表
这里后续把需要编辑的隧道写成:
7860

然后把域名类型改成:
二级子域名
填写刚才保留成功的名称.

更新以后查看在线隧道列表.

当前 7860 隧道已经切换成固定公网地址.
继续从浏览器访问.

Voice Companion 可以正常打开并使用.
固定二级子域名解决的是:
远程入口不再随着随机地址变化。
它不会改变本地模型速度,也不会增加显存.
15.公网入口再加一层 HTTP Auth
把数字人页面开放到公网以后,我会额外关心一个问题:
只要知道地址,是不是谁都能打开?
所以继续给 cpolar 隧道增加 HTTP Auth.
进入隧道列表,找到前面的 7860 隧道并编辑.

展开:
高级 → HTTP Auth
按照下面的格式填写:
用户名:密码
这里要分清:
HTTP Auth 是 cpolar 公网隧道的访问保护,不是 Voice Companion 自己的账号系统。
账号密码最好单独设置,并优先使用 HTTPS 地址.
配置完成以后更新.

重新打开 Voice Companion 的 HTTPS 公网地址时,浏览器会先弹出身份验证窗口.

通过验证后,才继续进入数字人页面.
到这里,公网使用至少多了一层基础访问保护.
16.总结
这次让我觉得 8G 显卡“还能玩点别的”的地方,不是终于挤进了一个更大的模型,而是把一整条语音数字人链跑了起来.
实际流程是:
Windows + WSL2 → Voice Companion Bundle → Faster-Whisper → DeepSeek 在线 API → Qwen3-TTS → LiveTalking / Wav2Lip → 麦克风语音测试 → 人设 / 音色 / 形象设置 → LM Studio → 本地 gemma 4 模型 → 34 token/s 测试 → localhost:12345 API → Voice Companion 切本地 LLM → cpolar → 随机公网 → 固定二级子域名 voice01 → HTTP Auth。
几个边界也值得一直记住:
- 原文给出的硬件体验起点是 8G 显卡,但这不是“所有 8G 显卡 + 所有模型都能获得相同结果”的保证;
- LM Studio 显示“可能能够完全加载进 GPU 显存”,对应的是当前模型和当前配置;
- 34 token/s 是这次本地模型的实际测试结果,不代表其他硬件和模型;
- 默认 DeepSeek 在线 API 能减轻本地 LLM 推理压力,但它仍然是在线模型调用;
- 切换到 LM Studio 后,已经实际看到 GPU 占用上升并完成本地 LLM 对话测试;
- cpolar 只负责 Voice Companion Web 页面的公网入口,不参与语音、模型、TTS 和数字人逻辑;
- 固定域名阶段后续步骤把隧道称为 7860,按现有流程保留;
- HTTP Auth 属于公网隧道访问保护,不是 Voice Companion 自身用户系统.
如果只是为了聊天,一张 8G 显卡跑一个本地模型当然已经够折腾;但我更喜欢这类把多个能力拼起来的玩法.声音、模型、人物、口型和远程入口真正协同以后,显卡不再只是“跑多少 B 参数”的数字,而开始变成一套可以直接说话、直接回应的本地 AI 交互系统.

🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 真正的成熟,是理解而不评判!
一个人的认知越来越成熟的时候,会很容易理解身边的每一个人.没有好坏,没有对错,只是处在不同的位置,表现出的一些行为和话语.你明白了这一点,就会有真正的爱和慈悲,你就会接纳、包容、善待和允许一切的发生.我认为我没有资格评判任何人,因为每个人的成长环境不同,三观自然不同,做出的选择也会不同.我没有理由用我的眼界去评判别人,也许我处在他的人生剧本中,我会过得更糟糕.严以律己,宽以待人,人非圣贤,孰能无过.其实,学会接受别人的不完美,也就接纳了真正的自己.