从 Jev 说起:快慢模型如何协同调度,以及这背后需要解决什么问题
摘要
近期 TypeSafe AI 的 Jev 模型引起了不少关注。它不做自回归文本生成,而是给定状态与一组预定义问题,一次前向输出 Choice / Score / Null 的概率分布与置信度,端到端 70–500 ms。这个变化看似只是「更快更便宜」,实际上改变的是输出的形状——概率可以直接参与计算,而文本必须经过解析才能变成数字。本文从这一处差异出发,记录一条由浅入深的推导路径。
先回答 Jev 能做什么、不能做什么:Null 只保证不输出选项之外的内容,不保证判断正确,因此「零幻觉」是格式性质而非判断性质。再回答它该如何被接入:与其在「Jev 或 LLM」之间二选一,不如建一条 L0–L4 的过滤器链,让每一层成为上一层的门。
此时第一个工程问题出现了——门控阈值该设多少。这是选择性分类与 Chow 规则的原型,也是校准漂移、选项集不穷尽等失效模式的入口。但仅有门控不够:推理模型的质量随计算量呈现阶段性跃迁,预算必须在多个环节之间分配,这引出 anytime 算法、performance profile 与停时边界。更进一步,升级本身是一项有成本的行动,需要按代价敏感的方式决策,于是出现 Learning to Defer、基率陷阱与误差相关性。
三条线索最终汇入同一个 Wald 决策论骨架:状态空间、动作空间与损失函数。结论是,这类系统的核心资产并非某个模型,而是校准曲线、performance profile 与慢路径条件准确率这三张表,以及让它们持续更新的日志管道。
1. 从一个具体模型说起
1.1 Jev 为什么值得注意
近期 Jev(TypeSafe AI,2026 年 9 月发布)在 LLM 应用圈里讨论度不低。它的卖点通常被概括为「快」——给定状态与一组预定义问题,一次前向直接输出 Choice / Score / Null 的概率分布与校准置信度,端到端 70–500 ms。
「快」确实成立,但只说「快」会错过真正的变化。要理解它,得先看三个事实:
三条合起来,改变的不是推理速度,而是输出的形状。文本必须经过解析、抽取、再打分才能变成数字;概率可以直接进入计算——作为门控的阈值比较项、作为停时规则的统计量、作为 verifier 的打分依据。这个区别决定了它在系统里的位置,也决定了后面所有讨论的起点。
1.2 「零幻觉」说对了一半
Null 这一项的存在,意味着它不会输出选项之外的内容。这一点被概括为「零幻觉」,也是它常被拿来与大模型对比的原因。
但这个表述需要精确化。不妨把它的性质拆开看:
| 输出属于预定义选项集 | 是 | 无需做格式校验、无需解析容错 |
| 输出可被程序直接消费 | 是 | 可进入阈值比较、可作为 DAG 节点输入 |
| 输出概率与频率大致匹配 | 训练目标追求,但需实测验证 | 必须在线校准、分桶检验 |
| 判断正确 | 否 | 不能把高置信度当作可信的替身 |
| 分布外时仍可靠 | 否 | 必须配 L0 结构性守卫与 OOD 信号 |
前三条都是格式性质。第四条是关键——一个分类器可以完全不产生幻觉,同时把样本分错一半。它保证不输出选项之外的内容,不保证选对。
这一处区分很重要。格式无幻觉只意味着输出可被解析、可被审计,它不能推导出判断可信。如果忽略这一步,「高置信度」就会被当成一种人格担保,而后面所有门控都会建立在错误的假设上。
1.3 一个自然的想法,以及一个自然的错误
看到「快而便宜」,最自然的反应是把它当成一个「便宜版 LLM」,在「用 Jev 还是用推理模型」之间做二选一。这个想法很符合直觉,但它隐含了一个前提:每个输入只属于一类任务。
现实并非如此。任务天然分层——格式校验是确定性规则的事,路由是封闭选项的事,规划是开放生成的事,争议仲裁是专家的事。把这些任务塞进同一个模型、用同一个标准判断,既浪费了确定性代码几乎为零的成本,也把高风险决策和日常路由绑在了同一条预算曲线上。
那么换一个方向:能不能让每一层只处理自己擅长的事,把剩下的交给下一层?这就是「阶梯」的雏形——不是选 A 或选 B,而是让每一层成为上一层的过滤器。这个想法看起来简单,但它立刻带来一个自己无法回答的问题。
1.4 阶梯带来的第一个问题:阈值该设多少
假设现在有两层。快层便宜,慢层贵。快层给出一个置信度,什么时候该相信它,什么时候该升级?
「设成 0.8」是最常见的答案,也是最容易出问题的答案。置信度的价值取决于错误代价:选错一个路由的成本,和选错一个医疗判断的成本不是同一个量级;快层本身的成本,和慢层的开销差了多少,也直接改变了这个门槛的位置。
于是阈值不是一个可以拍脑袋定下来的常数。它必须来自一个计算:升级的收益,是否超过了升级的成本。 这句话本身就是代价敏感决策的雏形。而要回答它,至少需要知道三件事:快层在不同置信度下的错误率、慢层在快层错的那部分样本上的准确率、以及两边的成本差。
到这里,讨论已经从「这个模型能做什么」进入了「决策该如何做」的领域。前者可以靠产品文档回答,后者需要一套理论。
1.5 更深一层:预算如何在整条链路上分配
但慢层的准确率也不是免费的。它多花一点计算,结果通常会更好一些;花到某个程度,再多的计算也换不来提升。这条曲线不是平滑的——推理模型的实测表现经常长时间不动,然后在某一步突然跃迁。
这意味着「给慢层更多预算」不是一句可以无脑执行的话。预算要在规划、执行、验证多个环节之间分配,而分配的标准应当是边际收益:哪一步多花一点计算带来的质量提升最大,预算就给哪一步。
问题随之扩大为:如何在预算有限的前提下,决定每一步该投入多少。这就是自适应计算与停时问题的原型。
1.6 再深一层:误差相关性
还有一个问题无法从单个环节的设计中看出来。
快慢两层模型共享大量预训练语料、tokenizer 与指令格式。它们的错误不是独立的。慢层整体的准确率,不能代表它在快层错的那些样本上的准确率。 如果按全局 99% 的准确率去设计阈值,实际 regret 可能会高一个数量级。
于是门槛设得再精细,也挡不住共因失效。要缓解这一点,需要刻意引入异质性:不同架构、不同训练范式、logits 决策与文本生成之间的搭配。这个约束反过来说明,阶梯的层级划分不是随意的,它直接决定了系统抗相关性的能力。
1.7 问题的全貌:这其实是一个顺序决策问题
把前面的线索串起来,问题就不再是「如何路由一个请求」,而是一个结构清晰得多的问题:
- 可选动作不止两个,而是一组有不同成本与不同准确率的层级;
- 每个动作都有成本,也有做错事的代价;
- 决策不是一次性的,可以在不同阶段重做、升级、回滚;
- 每个动作的效果无法精确预知,只能用统计估计。
这正是带成本约束的顺序决策问题。它同时包含三个子问题:何时放弃作答(选择性分类)、何时继续投入计算(anytime)、以及何时花钱叫更强的能力来复核(代价敏感决策)。
三个问题在教科书里分属不同章节,但共享同一副骨架:Wald 的决策论三件套——状态空间、动作空间与损失函数。本文的其余部分,就是沿着这副骨架把三条线索重新整理一遍,给出可以落地的规则、代码与护栏。
1.8 顺带一提:这与「快思考、慢思考」有什么关系
卡尼曼在《思考,快与慢》里的表述,常被概括为「系统一与系统二相辅相成」。但这个概括比原意温和。
更尖锐的原话是:系统一不仅提供直觉,还给系统二提供默认答案;而系统二通常是懒惰的,倾向于直接采纳。
翻译成工程语言,这就是本文所有护栏存在的理由:慢层的「复核」功能是一个高成本动作,系统会在长期使用中把它当成可省略的步骤。快层不会累,慢层会;于是系统会越来越依赖快层的默认值,直到某天快层在一个分布外样本上给出高置信度的错误,整条链路在没有预警的情况下偏离轨道。
所以真正需要设计的不是「什么时候该升级」,而是如何防止团队在不该省略的时候省略。这一点会贯穿后文的所有具体规则——它们本质上都是同一个防御意图的不同写法。
2. 统一骨架:三张表与一个动作空间
2.1 Wald 的三件套
选择性分类、anytime 算法、带验证的代价敏感决策在教材里分属不同章节,但它们共享同一决策论骨架。Wald 把统计推断写成三件套:状态空间 Θ、动作空间 A、损失函数 L(θ, a)。任一调度问题都可写成
a∗(x)=argmina∈A[c(a)+E[L(θ,a)∣x]]a^*(x)=\\arg\\min_{a\\in A}\\Big[c(a)+\\mathbb E[L(\\theta,a)\\mid x]\\Big]a∗(x)=arga∈Amin[c(a)+E[L(θ,a)∣x]]
c(a)c(a)c(a) 是动作本身的资源代价:一次快路径调用几分钱,一次推理模型调用几块钱,一次人工复核等几分钟。第二项则是做错事的代价。所谓调度,就是给 Harness 规定动作空间 A={L0,L1,L2,L3,人}A=\\{\\text{L0},\\text{L1},\\text{L2},\\text{L3},\\text{人}\\}A={L0,L1,L2,L3,人},再近似求解上式。
这个式子同时指出了工程的全部难点:代价项 E[L∣x]\\mathbb E[L\\mid x]E[L∣x] 永远估不准,成本项 c(a)c(a)c(a) 以为知道、其实不知道。前者需要校准与分层统计,后者需要真实账本——推理模型的 token 单价会变化,超时重试与降级是否计入,人工复核是均摊成本还是事故成本,都会改变最优阈值。调度器若只读取模型的「价格参数」而不读取财务与运维口径,得到的只是数学上正确、业务上错位的策略。
2.2 三种理论只是对「信息」和「次数」做了不同假设
| 选择性 classification | 买「不答的权利」 | 一次 | 置信度水平集 |
| Anytime / 自适应计算 | 买更多计算 | 多次(停时) | performance profile + 停止边界 |
| 带验证的 cost-sensitive | 买更准的后验 | 两次(买不买信息) | 阈值或阈值曲面 |
这套分类的用处在于定位,而不是炫技。当需求是「无法可靠回答就别回答」,对应的是第一张表;当需求是「预算固定、质量要尽量高」,对应的是第二张表;当需求是「该不该花钱叫一个更贵的能力来复核」,对应的是第三张表。一个真实系统往往三者并存,那就必须显式裁决——第 6 章会给出统一目标函数的显式写法。
3. 第一层:Chow 规则与选择性分类
3.1 三分钟推导
设误分类损失归一化为 1,拒绝(abstain)损失为 λ。给定 x,判定为类别 i 的条件风险是 1−P(y=i∣x)1-P(y=i\\mid x)1−P(y=i∣x),拒绝的条件风险是 λ。于是
拒绝 ⟺ λ<1−maxiP(i∣x) ⟺ maxiP(i∣x)<1−λ\\text{拒绝}\\iff \\lambda<1-\\max_i P(i\\mid x)\\iff \\max_i P(i\\mid x)<1-\\lambda拒绝⟺λ<1−imaxP(i∣x)⟺imaxP(i∣x)<1−λ
记 t=1−λt=1-\\lambdat=1−λ,结论极其朴素:最优拒绝域是后验最大值的一个水平集。阈值 t 的经济含义就是「拒绝一笔的损失占一次误判损失的比例」。
两个推论直接约束工程预期。
其一,被拒绝的不是随机样本,而是决策边界附近的一层壳。对「有效二值」问题——绝大多数输入其实只在正确答案与一个主要干扰项之间犹豫——被拒样本里最多约一半原本会分错。这意味着拒绝率永远大于错误率的下降量。拒绝的经济意义是「用覆盖率换可控的错误密度」,不是「把错误压到零」。如果业务汇报里写「开启拒绝后错误率下降 20%」却不写覆盖率从 95% 掉到 70%,那 20% 没有任何可比性。
其二,λ 有上界。若 λ≥1−1/K\\lambda\\ge 1-1/Kλ≥1−1/K,K 为类别数,则永不拒绝——因为拒绝比在 K 个类别上随机猜还贵。这是极好的 sanity check:若算出的阈值让系统几乎全部拒绝,要么把 EwrongE_{\\text{wrong}}Ewrong 标高了,要么 K 标错了。排查这个边界比反复微调模型便宜得多。
3.2 对偶形式:约束版本更适合跨团队对齐
Chow 原结论存在两种等价表述。拉格朗日形式是「给拒绝一个成本,最小化期望损失」;约束形式是「在拒绝率不超过 ρ 的前提下最小化错误率」,二者通过乘子一一对应。
这个对偶在工程上极有用:产品经理给不出 λ,但能给得出「最多 5% 的请求走慢路径」。因此实操不该从 λ 出发,而应从风险–覆盖曲线出发——横轴覆盖率,纵轴被接受部分的错误率,沿曲线选工作点。评估则看 AURC 与 E-AURC,而不是单点准确率。Traub 等人的工作指出传统选择性分类评估存在系统性缺陷,画曲线之前值得先读;否则很容易在错误的口径上比较出错误的赢家。
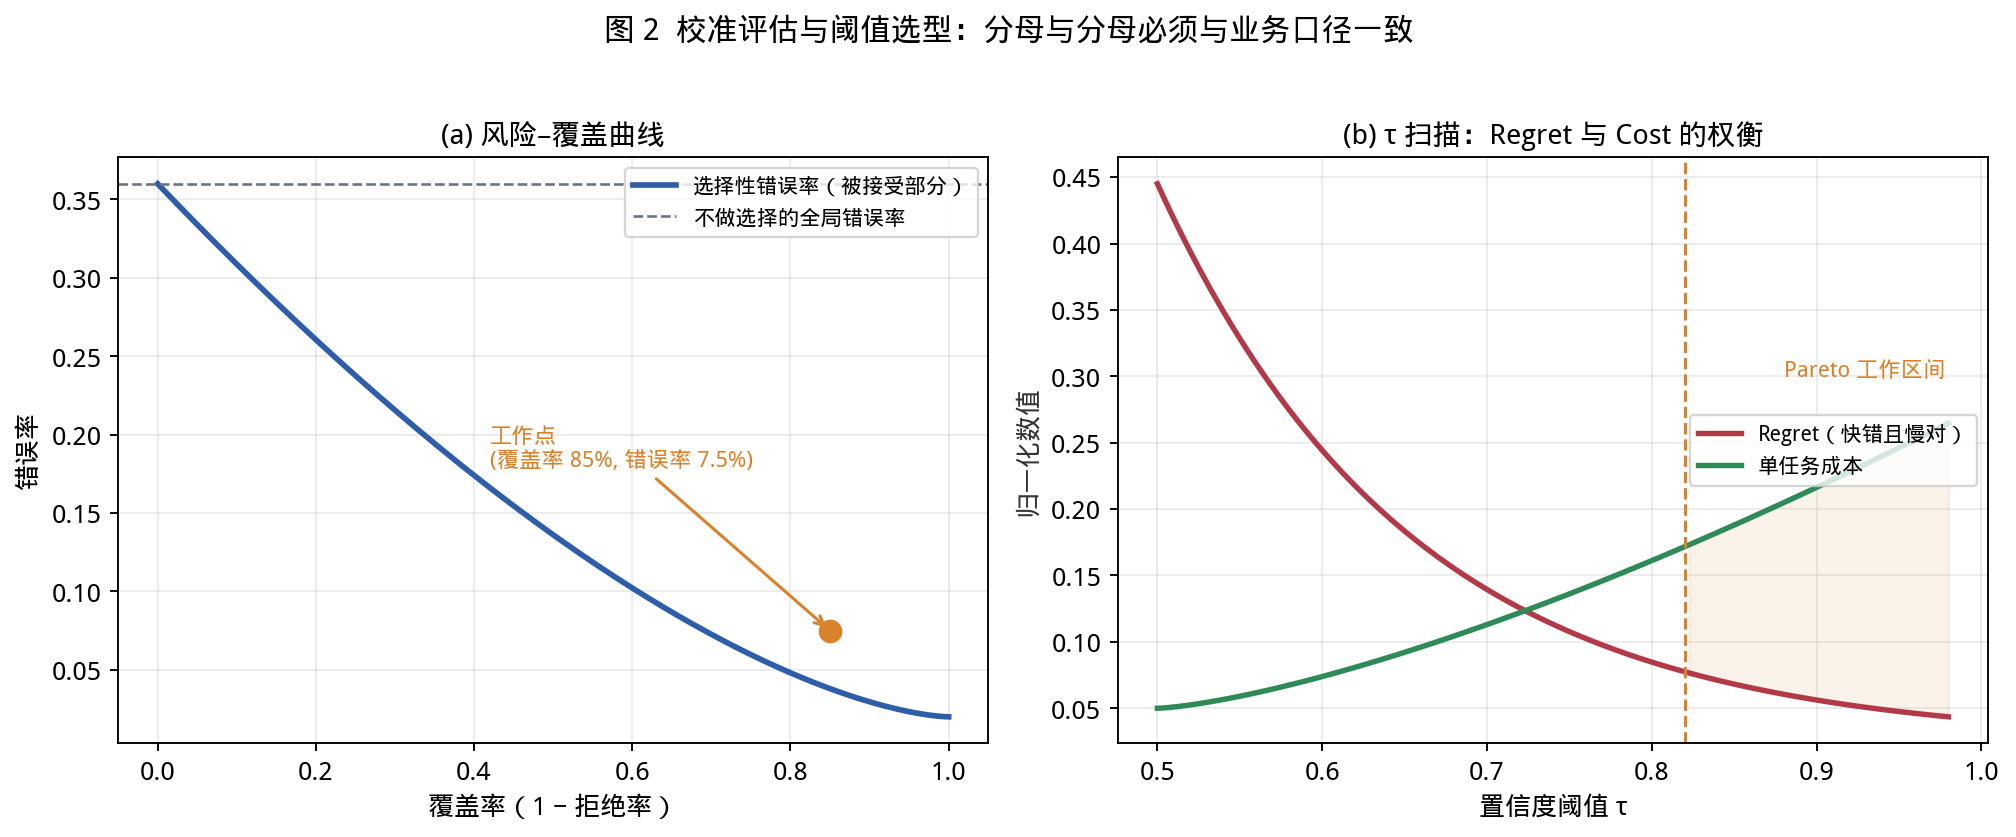
图 :风险–覆盖曲线,右为 τ 扫描下的 Regret–Cost 权衡。工作点是 Pareto 前沿,不是某个「看起来够高」的阈值。
3.3 三个会让系统带病上线的坑
校准漂移。 Chow 最优性的前提之一是「P(y|x) 是真的后验」。校准只在训练分布上成立,covariate shift 一来,0.9 就不再是 90%。更麻烦的是,shift 下的最优拒绝规则未必是 confidence thresholding,似然比检验往往更合适。这条结论的现实含义是:在线校准不能只做全局温度缩放,应按问题类别与难度分桶,各自拟合等渗回归或 Platt 缩放,并定期用回流的重标注样本重拟合;同时把 OOD 信号(logit 能量、embedding 到训练集最近邻距离)并入门控特征,其收益通常大于单纯调阈值。
选项集不穷尽是架构错误,不是噪声。 拒绝项的存在理由,正是承认真值可能不在动作空间内。若把选项集做成「是/否」而真实世界存在第三种可能,无论阈值如何调整都得不到一致性,只会得到一批高置信度的错误。设计上应永远保留 Other / Uncertain,并把它的命中率作为监控指标:命中率持续升高,说明业务语义正在漂移,需要扩选项集而不是调阈值。
口径错位。 若只优化「被接受部分」的错误率而业务看「总体错误率」,两者差一个覆盖率因子。汇报时必须写清分母,否则指标的改善可能全部来自少答。
4. 第二层:Anytime 与自适应计算预算
4.1 performance profile 是核心资产
Dean、Boddy、Zilberstein 与 Russell 的核心定义很朴素:一个 anytime 算法由 performance profile Q(t)Q(t)Q(t) 刻画——投入 t 计算量所能得到的期望质量。加上可中断性与收益递减(Q′′(t)<0Q''(t)<0Q′′(t)<0),最优停止问题就有了解。
两个概念尤其值得落到代码里。
- contract 与 interruptible 的差别,就是「事先承诺」与「随时交卷」的差别。 前者须先声明预算,后者可随时中断;二者可互相转换,但转换有明确性能损失界。工程上「预算桶」是 contract,「verifier 不通过就回滚重规划」则是在做 interruptible 转换。转换有代价,别指望免费。
- 模块组合的预算分配。 多个 anytime 模块串联时,整体 profile 不是简单叠加,最优分配要用动态规划求解,原则是让各模块对预算的边际质量增益相等。这正是「好钢用在刀刃上」的数学表述,也是 DAG 上每个节点该分多少预算的依据。
4.2 推理模型的 Q(t) 不漂亮
经典理论假设 Q(t) 平滑凹。推理模型的 test-time compute profile 却常呈现阶段性跃迁:多跑几步思维链,质量可能长时间不动,然后在某一步突然跳升。这条形态差异带来两个后果。
第一,基于「最近几步质量增量」的贪心停止规则方差极大,极易早停。第二,这也解释了为什么必须设置 checkpoint 重同步——纯快路径的 cascade error 本质上是 Q(t) 非凸导致的错觉:系统以为自己已经收敛,其实只是卡在 plateau 上。
因此停止规则不宜做成连续判定,而应分阶段、带确认:只在「规划完成」「工具返回」「最终生成」等离散事件上做判定;「继续」的决定要求连续两次低置信度才触发。这个滞回(hysteresis)结构既能防临界样本来回抖动,也能避免把预算烧在阈值附近的反复横跳上。
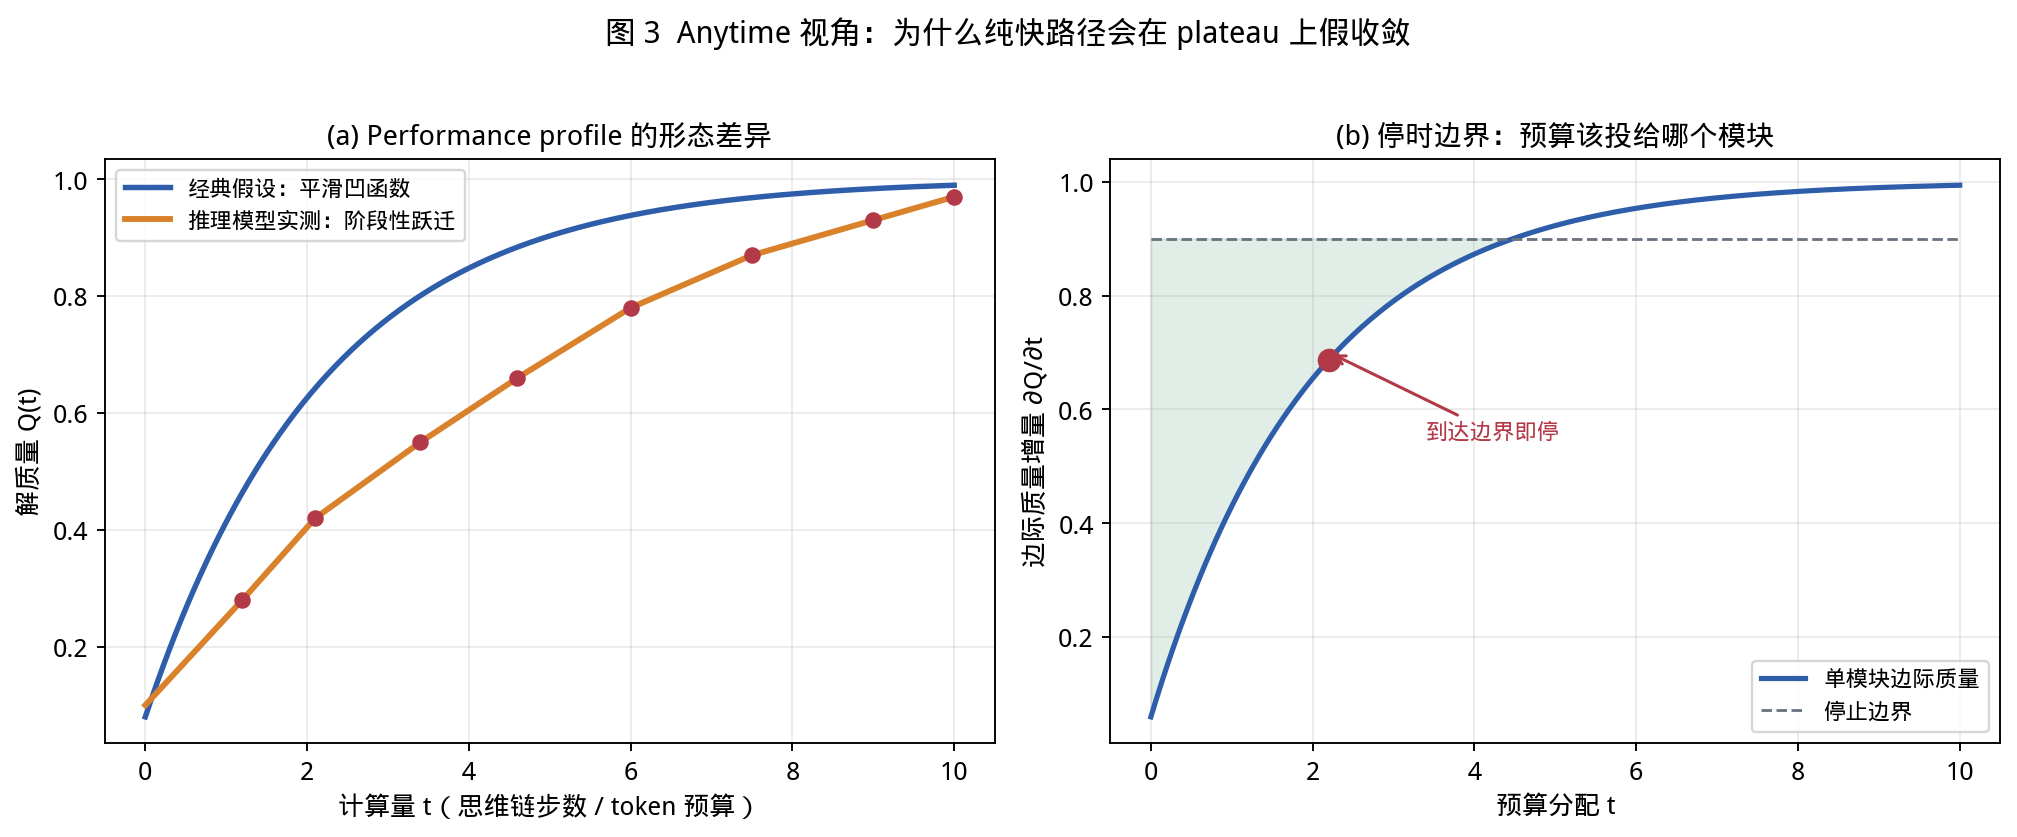
图 :Anytime 视角:经典平滑 profile 与推理模型实测的阶段性跃迁,右为停时边界——预算应按边际质量分配。
4.3 SPRT:Chow 的序贯版本
Wald 的 SPRT:每次观察后更新信念,似然比穿上界则接受、穿下界则拒绝、否则继续采样;Wald–Wolfowitz 证明其在给定两类错误下期望样本数最优。
Chow 是「单发快照」,SPRT 是「信念鞅的首达时」。前者适合一次前向就给分布的模型,后者适合「可以反复问、每次花一点钱」的场景,例如反复抽样投票、多 verifier 交叉检查。
落地时有两条技术细节决定成败:
4.4 三层停时不能混着用
| token 级 | 这段生成要不要打断重做 | logits 熵、verifier 增量打分 | speculative decoding、draft-and-verify |
| 步级 | 工具调用/子任务要不要升级 | 概率输出器守卫、schema 校验 | Chow 阈值 + 滞回 |
| 任务级 | 会话还要不要继续花钱 | 完成度、预算余额、意图是否满足 | 预算桶 + 终态 verifier |
token 级已有成熟方案:投机解码的本质就是「快模型生成、慢模型验证」,与本文的 sandwich 结构同构。步级是大多数 Agent 系统的主战场。任务级几乎不存在通用解,主要靠预算桶硬约束——这既是限制,也是研究空白。
5. 第三层:代价敏感升级与 Learning to Defer
5.1 阈值公式的严格推导与适用条件
设动作空间 A={accept,escalate}A=\\{\\text{accept},\\text{escalate}\\}A={accept,escalate},记 p=maxiP(i∣x)p=\\max_i P(i\\mid x)p=maxiP(i∣x),快路径出错损失归一化为 1,Δc=cslow−cfast\\Delta c=c_{\\text{slow}}-c_{\\text{fast}}Δc=cslow−cfast,慢路径的条件错误损失为 ℓs(x)\\ell_s(x)ℓs(x)。则
升级 ⟺ (1−p)>Δc+ℓs(x)⟹τ=1−Δc−ℓs(x)\\text{升级}\\iff (1-p)>\\Delta c+\\ell_s(x)\\quad\\Longrightarrow\\quad \\tau=1-\\Delta c-\\ell_s(x)升级⟺(1−p)>Δc+ℓs(x)⟹τ=1−Δc−ℓs(x)
现在适用条件被写清楚了:
第三条是绝大多数工程实现都会踩的位置。慢路径全局 99% 准确,不代表它在「快路径自信地错了的那一小撮样本」上也有 99% 准确——而调度真正关心的正是这一小撮。
5.2 用 VOI 重写,能解释很多直觉说不清的现象
升级的期望价值可以写成
升级 ⟺ E[L∣x,fast]−E[L∣x,after slow]⏟信息的期望价值 EVI>Δc\\text{升级}\\iff \\underbrace{\\mathbb E[L\\mid x,\\text{fast}]-\\mathbb E[L\\mid x,\\text{after slow}]}_{\\text{信息的期望价值 EVI}}>\\Delta c升级⟺信息的期望价值 EVIE[L∣x,fast]−E[L∣x,after slow]>Δc
这个视角有三层含义。
- verifier 很烂时升级是亏的。 EVI 的上界由 verifier 的信息量决定,噪声大的 verifier 带来的后验收缩很小,EVI 天然小于 Δc\\Delta cΔc。此时最优策略不是硬升,而是先修 verifier。
- 有些任务不值得做门控。 若某类请求后验本来就很尖(p≈1),EVI≈0,花在门控上的钱收不回来。门控本身有成本:概率输出器便宜到可忽略,但用中等模型做 router 时,这笔账必须单独算。
- 一次前向塞多个判断是结构性优势。 多个问题并行时,Δc\\Delta cΔc 几乎不变而 EVI 累加,单位成本的信息价值显著上升。这是输出形状带来的优势,不是小优化;Harness 必须做请求合并(request coalescing),否则等于主动放弃一半收益。
5.3 Learning to Defer:把升级做成可学习对象
Madras 等人、Mozannar 与 Sontag 的 learning to defer(L2D)让模型同时输出「预测类别」与「交给专家」,损失写为
L=1{不弃权且错}+ce(x)⋅1{弃权}L=\\mathbf 1\\{\\text{不弃权且错}\\}+c_e(x)\\cdot\\mathbf 1\\{\\text{弃权}\\}L=1{不弃权且错}+ce(x)⋅1{弃权}
关键贡献是一致代理损失:经验风险最小化仍收敛到贝叶斯最优的预测与弃权联合策略。后续工作扩展到多专家、任意成本函数与 H-consistency bound。
它对这套架构的意义有三层:
- 「什么时候叫慢模型」从手写阈值变成端到端可训练;训练信号只需「输入、快路径输出、慢路径输出、谁对了」这类极易从日志获取的字段。
- 它天然处理「专家也不是全知」。 学的是 P(expert 会对∣x)P(\\text{expert 会对}\\mid x)P(expert 会对∣x),正好补上 ℓs(x)\\ell_s(x)ℓs(x) 估不准的问题。
- 多专家版本学到的就是数据驱动的阶梯,而不是手工配置的 C/R/F 映射表。
冷启动路线建议是:先用 Chow 阈值跑足够长时间攒日志 → 再用 L2D 在日志上做离线策略学习 → 上线时保留规则兜底与一键回滚。跳过第一步,L2D 学到的就是选择偏差的产物——它只会优化被旧策略送到的那批样本。
5.4 两个概率陷阱
基率陷阱。 假设快路径准确率 96%(错误率 4%),升级判定器召回 80%、误报率 5%,则被升级请求中真正该升级的比例为
0.04×0.800.04×0.80+0.96×0.05=0.0320.080=40%\\frac{0.04\\times 0.80}{0.04\\times 0.80+0.96\\times 0.05}=\\frac{0.032}{0.080}=40\\%0.04×0.80+0.96×0.050.04×0.80=0.0800.032=40%
六成升级是白花的钱。这不是判定器太差,而是基率太低。解法只有两条:把快路径做得更准(提高 prevalence),或接受「升级主要是保险而非纠错」,并把 KPI 从「升级命中率」改为「总 regret + 总成本」。绝不要用 escalation precision 考核团队——它会逼着团队把阈值调松,最终成本爆炸。
误差相关性。 几乎所有 cascade 分析都隐含「快慢模型错误近似独立」的假设。现实中它们共享预训练语料、tokenizer 与指令格式,错误高度共因。若慢路径边际准确率 99%,但在「快路径自信地错了」的子群体上只有 70%,按 99% 算出的 τ 会过于激进,实际 regret 可能高一个数量级;堆更多 verifier 的边际收益衰减得比预期更快,因为它们错在同一批样本上。
→ Regret 必须成为第一指标,因为它是唯一能暴露误差相关性的指标。 缓解手段不是换更多模型,而是刻意引入异质性:不同架构、不同训练范式、logits 决策与文本生成并存。异质性是这类系统唯一的抗相关武器。
5.5 当「平均成本最小」不够时
期望优化给不了尾部保证。若业务需要「保证不出事」,应走 conformal prediction / selective conformal risk control:用校准集构造预测集,获得有限样本、分布无关的覆盖率保证,并可与选择性分类组合成两阶段流程。代价是保守、覆盖率不可控、强 shift 下集合会膨胀到无信息量。
要保证就走 conformal,要效率就走 Chow / L2D,别指望兼得。 若二者都要,唯一诚实的做法是把冲突显式化:
min E[L]+λ1⋅Cost+λ2⋅Latency+λ3⋅CVaRα(L)\\min\\ \\mathbb E[L]+\\lambda_1\\cdot\\text{Cost}+\\lambda_2\\cdot\\text{Latency}+\\lambda_3\\cdot\\text{CVaR}_\\alpha(L)min E[L]+λ1⋅Cost+λ2⋅Latency+λ3⋅CVaRα(L)
最后一项把合规部门的要求量化进调度器:用 CVaR 而非期望,会把阈值推向保守方向,幅度由 α 控制。
6. 三种视角的冲突:必须显式裁决,不能各管一段
| 优化目标 | 覆盖率约束下的错误率 | 时间约束下的解质量 | 成本约束下的期望损失 |
| 花钱买什么 | 买「不答的权利」 | 买更多计算 | 买更准的后验 |
| 决策次数 | 一次 | 多次 | 两次 |
| 需要的资产 | 校准的置信度 | performance profile | 升级者的条件准确率 |
| 最优规则形状 | 置信度水平集 | 停时边界 | 阈值或阈值曲面 |
| 主要失效 | 校准漂移、选项集不穷尽 | Q(t) 非凸导致早停 | 误差相关性、基率陷阱 |
| 在系统中的职责 | L1 出口门控 | 步级/任务级预算 | L1→L2→L3 路由 |
三者存在内在冲突:选择性分类追求「少答」,anytime 追求「晚一点答但答得好」,cost-sensitive 追求「花最少的钱答」。在一个有 deadline 的系统里,它们竞争同一笔预算。裁决方式只能是给目标函数一个统一的拉格朗日乘子,并把乘子暴露成可调参数——这也是第 10 章要讲的「最重要的接口」。
7. 架构设计:阶梯、四个机制与带标签的 DAG
7.1 四个机制
前置路由。 让概率输出器自己做路由决策。路由恰好是「封闭选项 + 高频 + 低风险」的典型形状。特征四五个就够用:选项空间是否封闭可枚举、是否需要生成新文本或解释理由、错误是否可逆可补救、是否需要跨步记忆或检索、输入是否超窗口。实现上做成可配置的声明式规则 + 一个 meta-question,别写死在代码里——规则写在配置中,变更才有审计记录。
置信度门控。 阈值必须是代价敏感的,不能拍脑袋定 0.8;且必须在线校准、分桶拟合、定期重拟合。注意校准与规则都只是入场券,真正决定上线质量的是它们在分布漂移下的表现。
快模型当压缩器。 L1/L2 把大量原始状态压缩成结构化摘要再喂 L3,ROI 通常高于单纯优化路由。快系统负责「看清」,慢系统负责「想通」——这两个动作的成本差异,是调度能省钱的全部来源。
Sandwich 结构。 完整链路是:LLM 规划 → 概率输出器守卫 → LLM 执行 → 概率输出器完成性判定与一致性检查 → 不通过则回滚重规划。验证通常比生成容易得多,这是整条链路成立的理由。
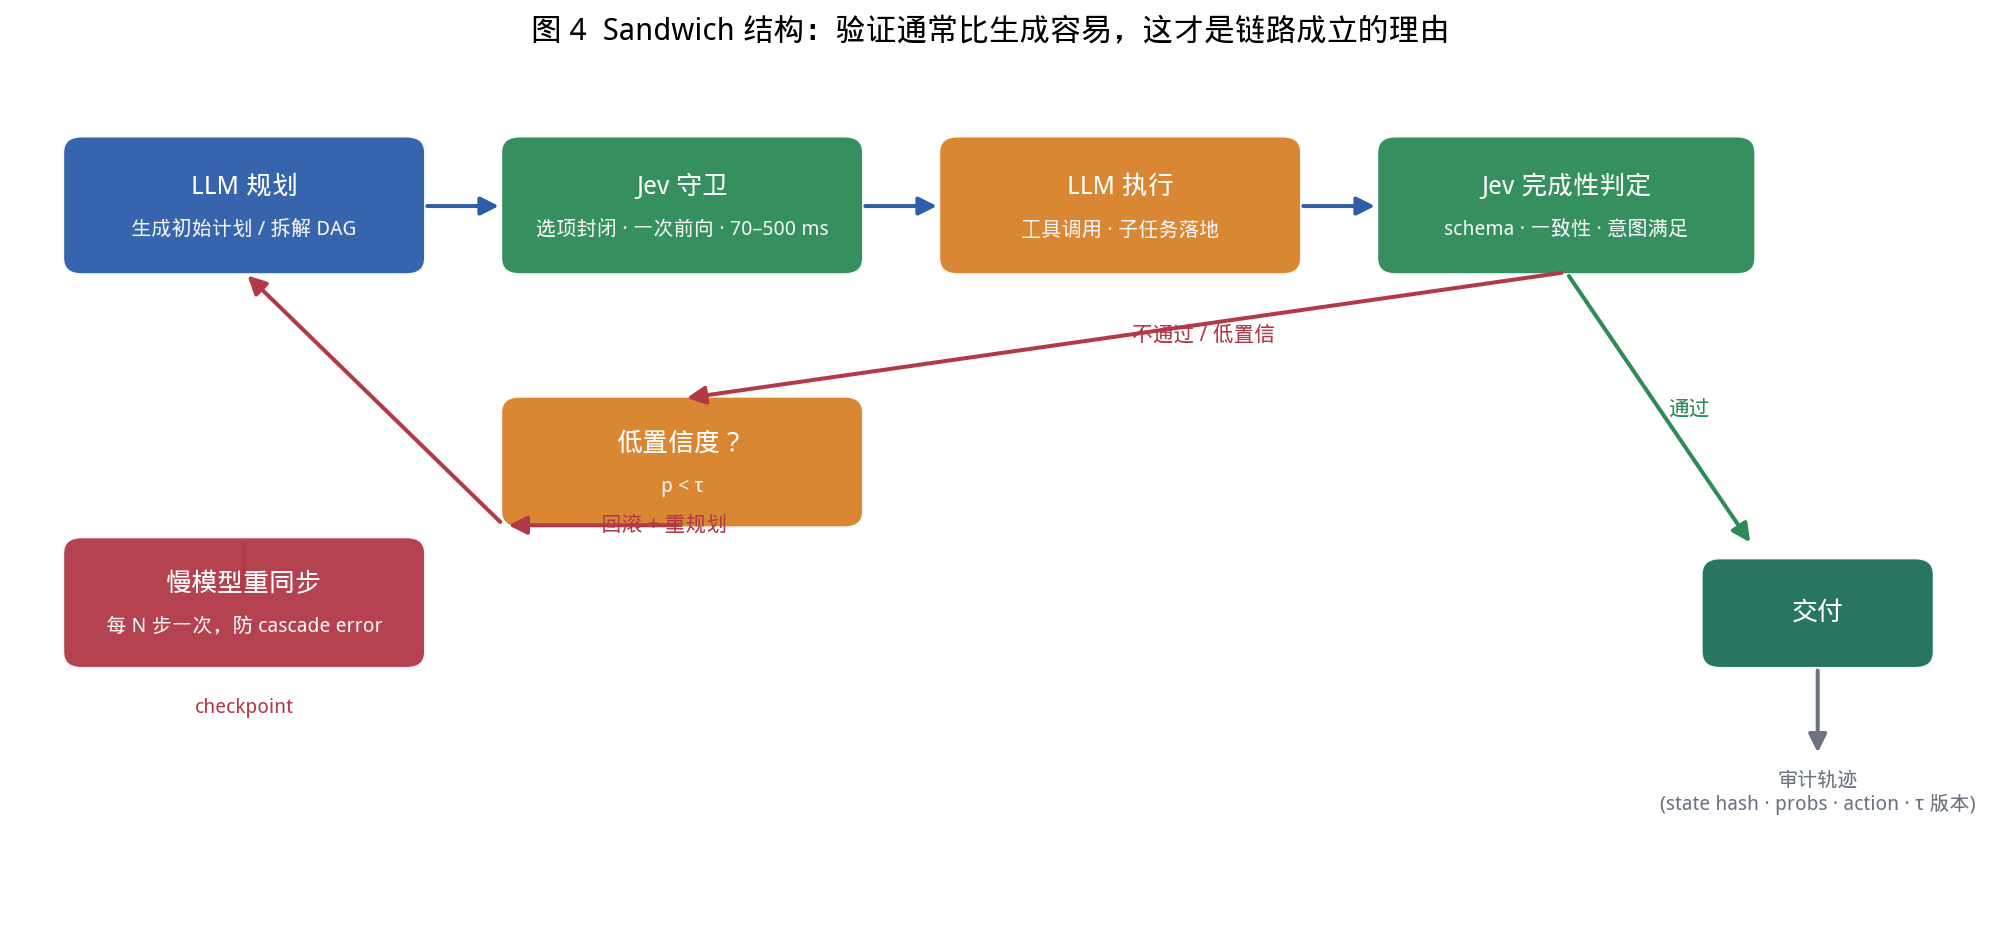
图 :Sandwich 结构:快系统夹住慢系统。回滚路径与 checkpoint 重同步是可靠性的一部分,不是附加功能。
7.2 把任务拆成带标签的 DAG
节点按 C(Closedness,选项是否封闭)、R(Risk,错误是否可逆)、F(Frequency,调用频率)三个属性标注:
- C 高、R 低、F 高 → 纯 L1
- C 低(需开放生成)→ L3
- R 高 → L3 + L1 verifier,与 C 无关
- F 高但 C 中 → L2
再加两个全局约束:预算桶(每任务/每会话成本上限,耗尽强制降级)与 checkpoint 重同步(快路径连续执行 N 步后强制慢模型做一次状态重整,防 cascade error)。
还有一个极易遗漏的工程细节:多个问题并行一次调用时延迟几乎不变。Harness 必须做 request coalescing——把同一时刻的多个判断合并成一个请求,而不是串行十次。不做这一步,等于主动放弃一半收益。
8. 可落地的代码骨架
# ===== 离线标定(周期性重算)=====
# 1. Q_n(t) : performance profile,历史日志回归
# 2. e_fast,n(p) : 快路径在置信度 p 下的条件错误率,分桶等渗校准
# 3. e_slow,n : 慢路径在"快路径错"子群体上的条件错误率(必须单独估计!)
def calibrate(records):
fast_bins = group_by_confidence(records, bins=20)
e_fast = {b: isotonic_fit(b) for b in fast_bins}
# 关键:e_slow 不能按全局准确率算,要按 fast_was_wrong 分层
e_slow = error_rate(filter(records, lambda r: r.fast_wrong))
return e_fast, e_slow
# ===== 在线调度 =====
class Harness:
def __init__(self, node_cfg, budget, tau_hysteresis=0.03):
self.cfg = node_cfg # per-node: Δc, e_slow, τ
self.budget = budget
self.tau_up = {k: v – tau_hysteresis for k, v in node_cfg["tau"].items()}
self.tau_down = {k: v + tau_hysteresis for k, v in node_cfg["tau"].items()}
self.last_action = "accept"
def decide(self, node, state, questions):
# request coalescing:多个判断攒成一次前向,延迟几乎不变
probs = jev.classify(state, questions) # -> {choice, prob, conf}
p = max(probs.prob)
tau = self.tau_down[node] if self.last_action == "escalate" else self.tau_up[node]
if p >= tau:
self.last_action = "accept"
return "accept", probs
if self.budget.remaining() < self.cfg[node].delta_c:
return "degrade_to_L2", None # 预算耗尽强制降级
self.last_action = "escalate"
return "escalate", probs
def run(self, dag):
trace = []
for step_count, n in enumerate(topological(dag), start=1):
action, meta = self.decide(n, state(n), questions(n))
out = execute(n, action, state(n))
state = apply(out)
trace.append(audit_record(n, action, meta, out)) # 审计轨迹
if step_count % CHECKPOINT_EVERY == 0:
state = slow_model_resync(state) # 防 cascade error
return finalize(trace)
四个细节决定这个骨架能不能长期运行。
- e_slow 必须按「快路径错的子群体」估计。 样本不足就分层 pooling,绝不能用全局准确率替代。
- 阈值带滞回。 τup≠τdown\\tau_{\\text{up}}\\ne\\tau_{\\text{down}}τup=τdown,避免临界样本来回震荡。滞回区间的宽度本身是一个可调参数,应与阈值一起参与版本管理。
- 每个判定留审计轨迹。 至少记录 state hash、options、probs、chosen action、τ 版本。没有它,事后归因与合规审查都无法完成。
- 总量配额放在 Harness 外层,不在节点层。 Jevons 悖论发生在系统层面:局部最优加起来是全局失控。节点只知自己的代价,Harness 才知会话总量。
9. 指标体系:没有度量就没有调度
| Fast-path hit rate | 多少比例没惊动慢模型 | 诊断 |
| Escalation rate | 升级率 | 诊断 |
| Fast-slow agreement | 快慢一致率 | 诊断 |
| Regret | 快路径错而慢路径对的占比 | 考核 |
| Cost per completed task | 单任务成本 | 考核 |
| P95/P99 latency | 尾部延迟 | 考核 |
横轴 τ、纵轴 Regret 与 Cost 画出的是 Pareto 前沿,工作区间就在前沿上。均值会骗人,尾部延迟决定用户体验的下界。
Router 的可学习化建议分三步走:初期规则 + 静态阈值,跑够日志后切 bandit 或 RL(以任务完成率与成本构造奖励),切换时保留规则兜底与一键回滚。Learned router 漂移起来比静态阈值难看十倍——它会在数据分布轻微变化后悄悄把流量全推到某个路径上,而静态阈值只会变得保守。
10. 两周 MVP:只做两处改动
选一条已经在跑的 Agent 链路,做两处改动:
这两处都是「封闭选项 + 高频 + 可事后补救」的完美靶子,改造风险最低、收益最直接。跑通之后再谈自适应路由与在线学习。过早引入 L2D,只会把日志不足的问题伪装成模型能力不足。
11. 四个边界:理论会在哪里骗你
非平稳性。 所有结论假设分布稳定,而业务分布每天都在变,校准与阈值都是滞后估计。门控必须是「估计 + 保守余量 + 快速回滚」的组合。把 τ 故意往保守侧偏 10–20%,这个 slack 不是浪费,而是为非平稳性买的保险。
对抗性输入。 Chow、SPRT、L2D 都假设测试样本来自同一生成过程。越狱、prompt injection、对抗样本会让置信度不再是可靠信号。这一层只能靠 L0 确定性规则和独立训练的越狱检测这类结构性守卫,模型自己给出的「我很确定」不在此列。
Goodhart。 把「快路径覆盖率」或「单任务成本」设成 KPI,团队会朝指标优化而非朝任务完成优化。六个指标里只有 Regret 与 Cost per completed task 抗 Goodhart,其余只能用于诊断。
理论给不了你 EwrongE_{\\text{wrong}}Ewrong。 整套骨架里最关键的参数——「做错这件事到底值多少钱」——不在数学里,而在业务里。数学能给的是给定 λ 下的最优策略,给不了 λ。因此 harness 最重要的接口不是 classify(),而是一个能让产品、法务、财务一起调 λ,并立刻看到 regret/cost 曲线的控制台。把政治问题变成可调参数,是这类系统能活过第一次事故的唯一方式。
12. 一个比「相辅相成」更尖锐的判断
系统一不仅提供直觉,还给系统二提供默认答案;而系统二通常是懒惰的,倾向于直接采纳。这句话几乎原封不动地预言了当前 Harness 的最大风险——慢模型太贵,团队会越来越依赖快路径的默认值,直到快路径在一个分布外样本上自信地错了。
所以优雅的调度最终要解决的是一个监控问题:如何让系统知道自己什么时候不知道。校准概率只是入场券,答案在那几张表与那几条曲线里:校准曲线、performance profile、慢路径条件准确率、风险–覆盖曲线、Regret–Cost Pareto 前沿。系统不一定要变得更聪明,但必须变得更可观测。
延伸阅读
必读。 Chow (1970) On optimum error and reject tradeoff;El-Yaniv 与 Wiener 关于选择性分类的两篇;Madras 等人 (2018) Predict Responsibly;Mozannar 与 Sontag (2020) Consistent Estimators for Learning to Defer;Wald (1945) 与 Wald–Wolfowitz (1948)。
直接可用。 Chen 等人 (2023) FrugalGPT,LLM cascade 原型,粗糙但是对的直觉;Snell 等人 (2024) Scaling LLM Test-Time Compute Optimally;Fischer 与 Ramdas (2024) 关于 SPRT overshoot 的修正;Heng 与 Soh (2025) Know When to Abstain,shift 下的似然比拒绝规则。
评估。 Traub 等人 (NeurIPS 2024) Overcoming Common Flaws in the Evaluation of Selective Classification Systems——画风险–覆盖曲线之前先读,能省掉不少无效实验。