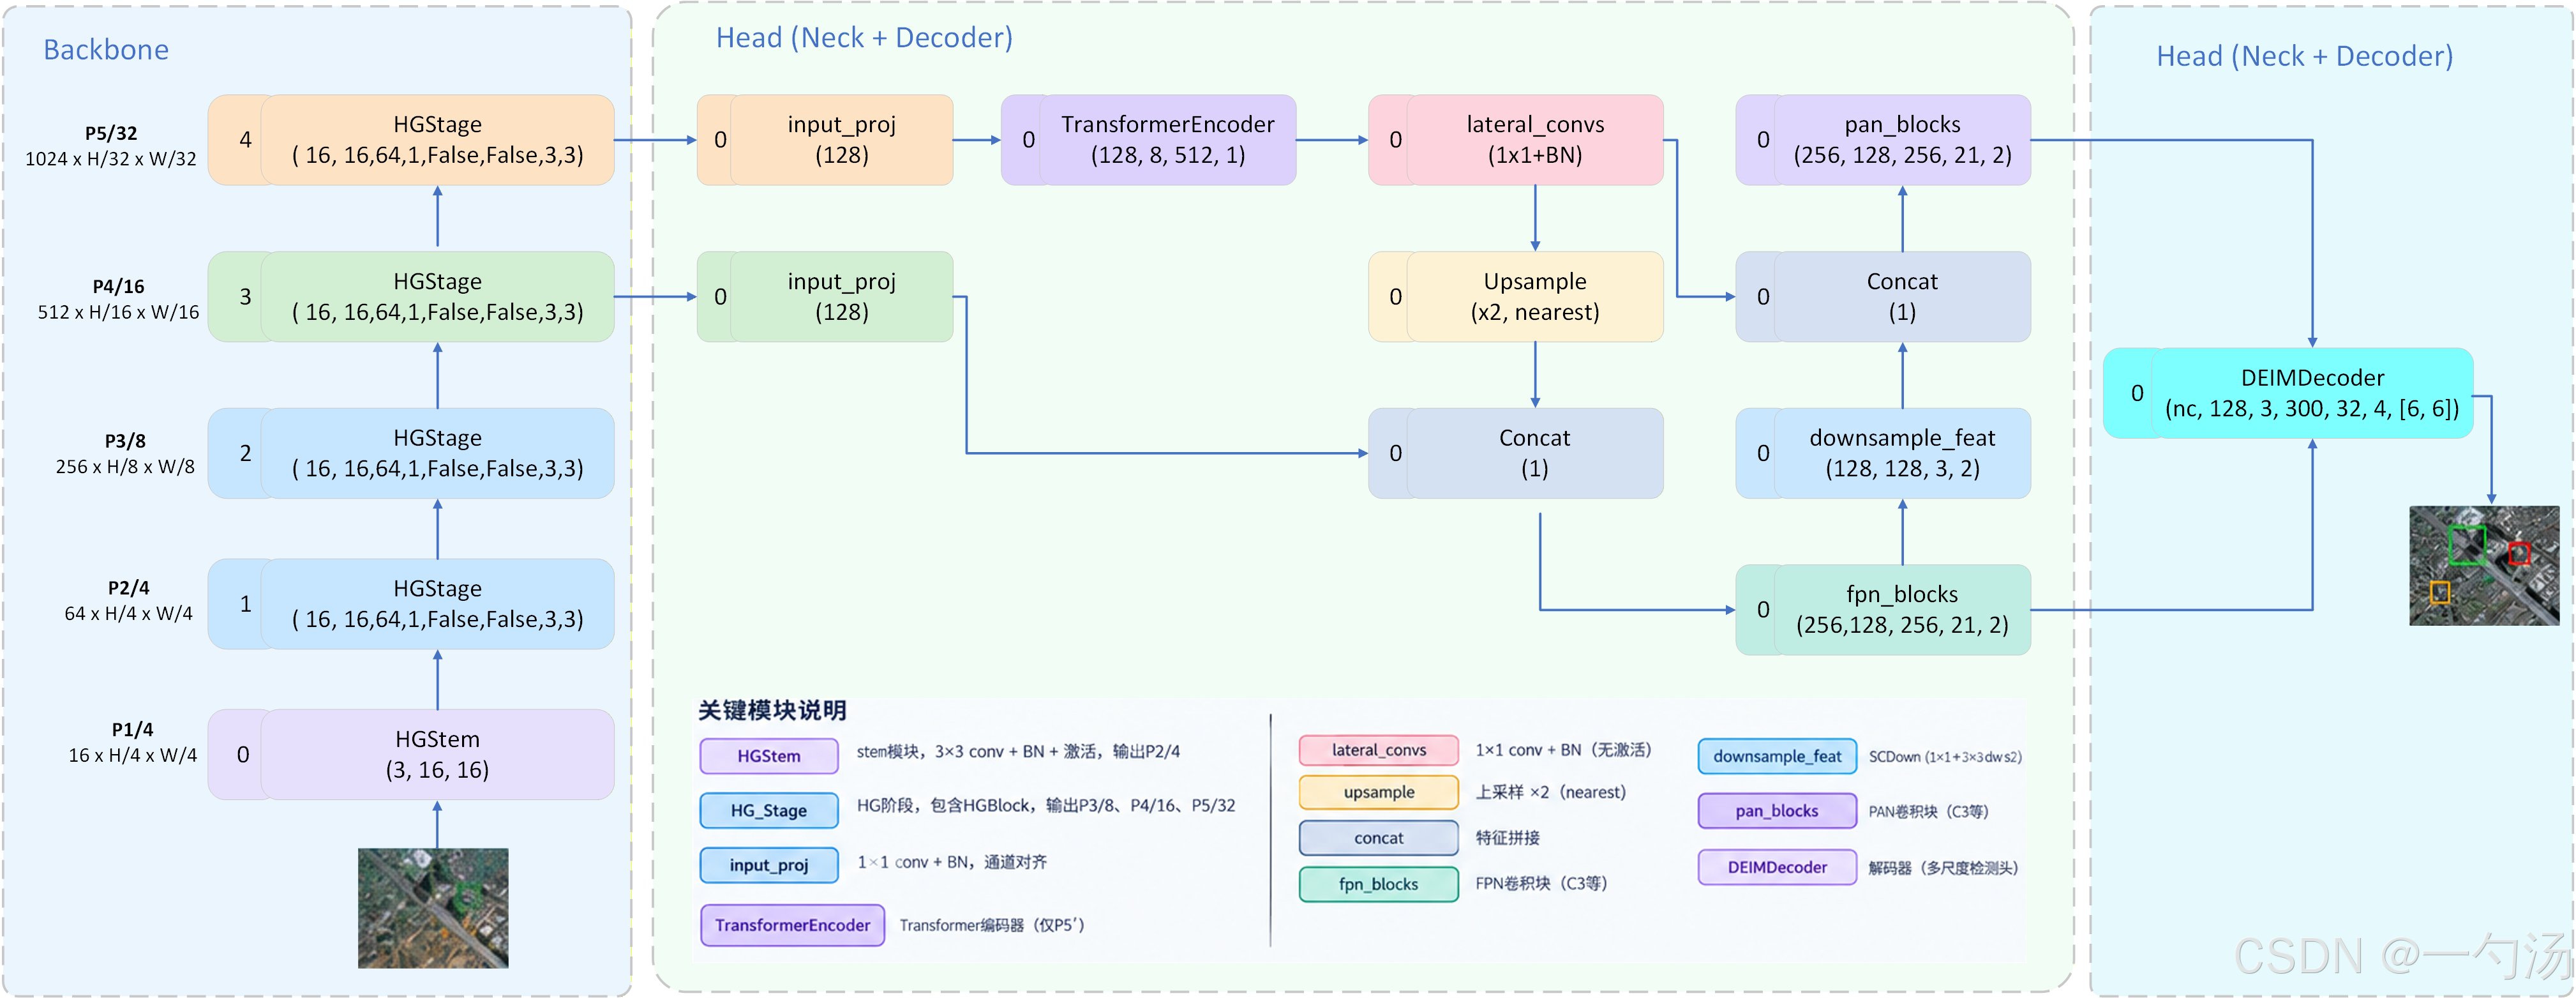
DEIM 的 neck lateral 通路(融合前投影)原始实现是 1×1 卷积——逐像素独立处理,没有序列上下文;而 Mamba 这类状态空间模型用线性复杂度的序列扫描,天然具备长程上下文建模能力。针对这条"只看单点、不看邻居"的通路,我们做了一批 Mamba 替换变体(MambaLayer、mxt_mamba_layer、mamba_vision、CCSM、CCViM、CSI、EVSSM、FAMamba_CSI、MMB、SAVSS_layer、UVMB 等),主落点 lateral_convs_<X>(neck 同维增强,c→c),backbone 侧同样可换 HG_Stage_<X>,全部保持原落点参数格式不变、一行切换。本文给出完整变体清单与分组逻辑,重点拆解 MambaLayer(Mamba-2 状态空间核心)。
1. 现有的卷积和 Transformer 有什么不好
在讨论 Mamba 之前,先看看图像建模的两个主流范式各自卡在哪里:
| 卷积 | 局部滑窗,感受野受限 | 看局部:长程依赖要靠堆层,且分辨率越大、层数越深 |
| Transformer / 注意力 | 全 token 两两交互 | 看全局:O(N²) 复杂度,高分辨率特征图直接吃不消 |
| 两者共同 | 卷积只有局部、注意力是平方复杂度 | 没有人提供"线性复杂度的全局建模" |
落到 DEIM 的具体场景:lateral 通路处理的是高分辨率特征图(P5 融合前),此时——
-
用卷积(1×1 / 3×3):只有局部视野,跨位置信息为 0,上下文得靠后续融合块一层层补;
-
用注意力:全局视野有了,但 O(N²) 在 P5 分辨率下计算量直接爆炸。
一句话总结:卷积看不全,注意力看得全但太贵——Mamba 用状态空间扫描提供了第三条路:线性复杂度的长程建模,恰好适合 lateral 这种"高分辨率、又需要上下文"的位置。
2. HG 的卷积注意力可以往哪些方向改进
"把 Mamba 接进 DEIM"有四个方向,也是我们最终落地的四个分组:
| 原生 Mamba 核心 | 直接用 Mamba-1/2 扫描块 | MambaLayer、mxt_mamba_layer、mamba_vision | 最正宗、已验证 | 依赖 CUDA 扫描算子 |
| 视觉 Mamba 变体 | 为图像设计的扫描/卷积混合 | CCViM、CSI、FAMamba_CSI、EVSSM、SAVSS_layer | 适配 2D 特征图 | 结构复杂 |
| 通道-状态混合 | Mamba 与通道注意力结合 | CCSM、MMB、UVMB | 补上通道维度 | 参数增加 |
| 多向扫描 | 多方向序列扫描 | CSI、EVSSM、mamba_vision | 上下文覆盖全 | 扫描次数×计算 |
四路共同点:neck 落点保持 c→c 同维不变(lateral_convs_),backbone 落点保持 HG_Stage 外壳不变。变体全做,让实验挑最优。
3. HG 的卷积注意力是如何改进的
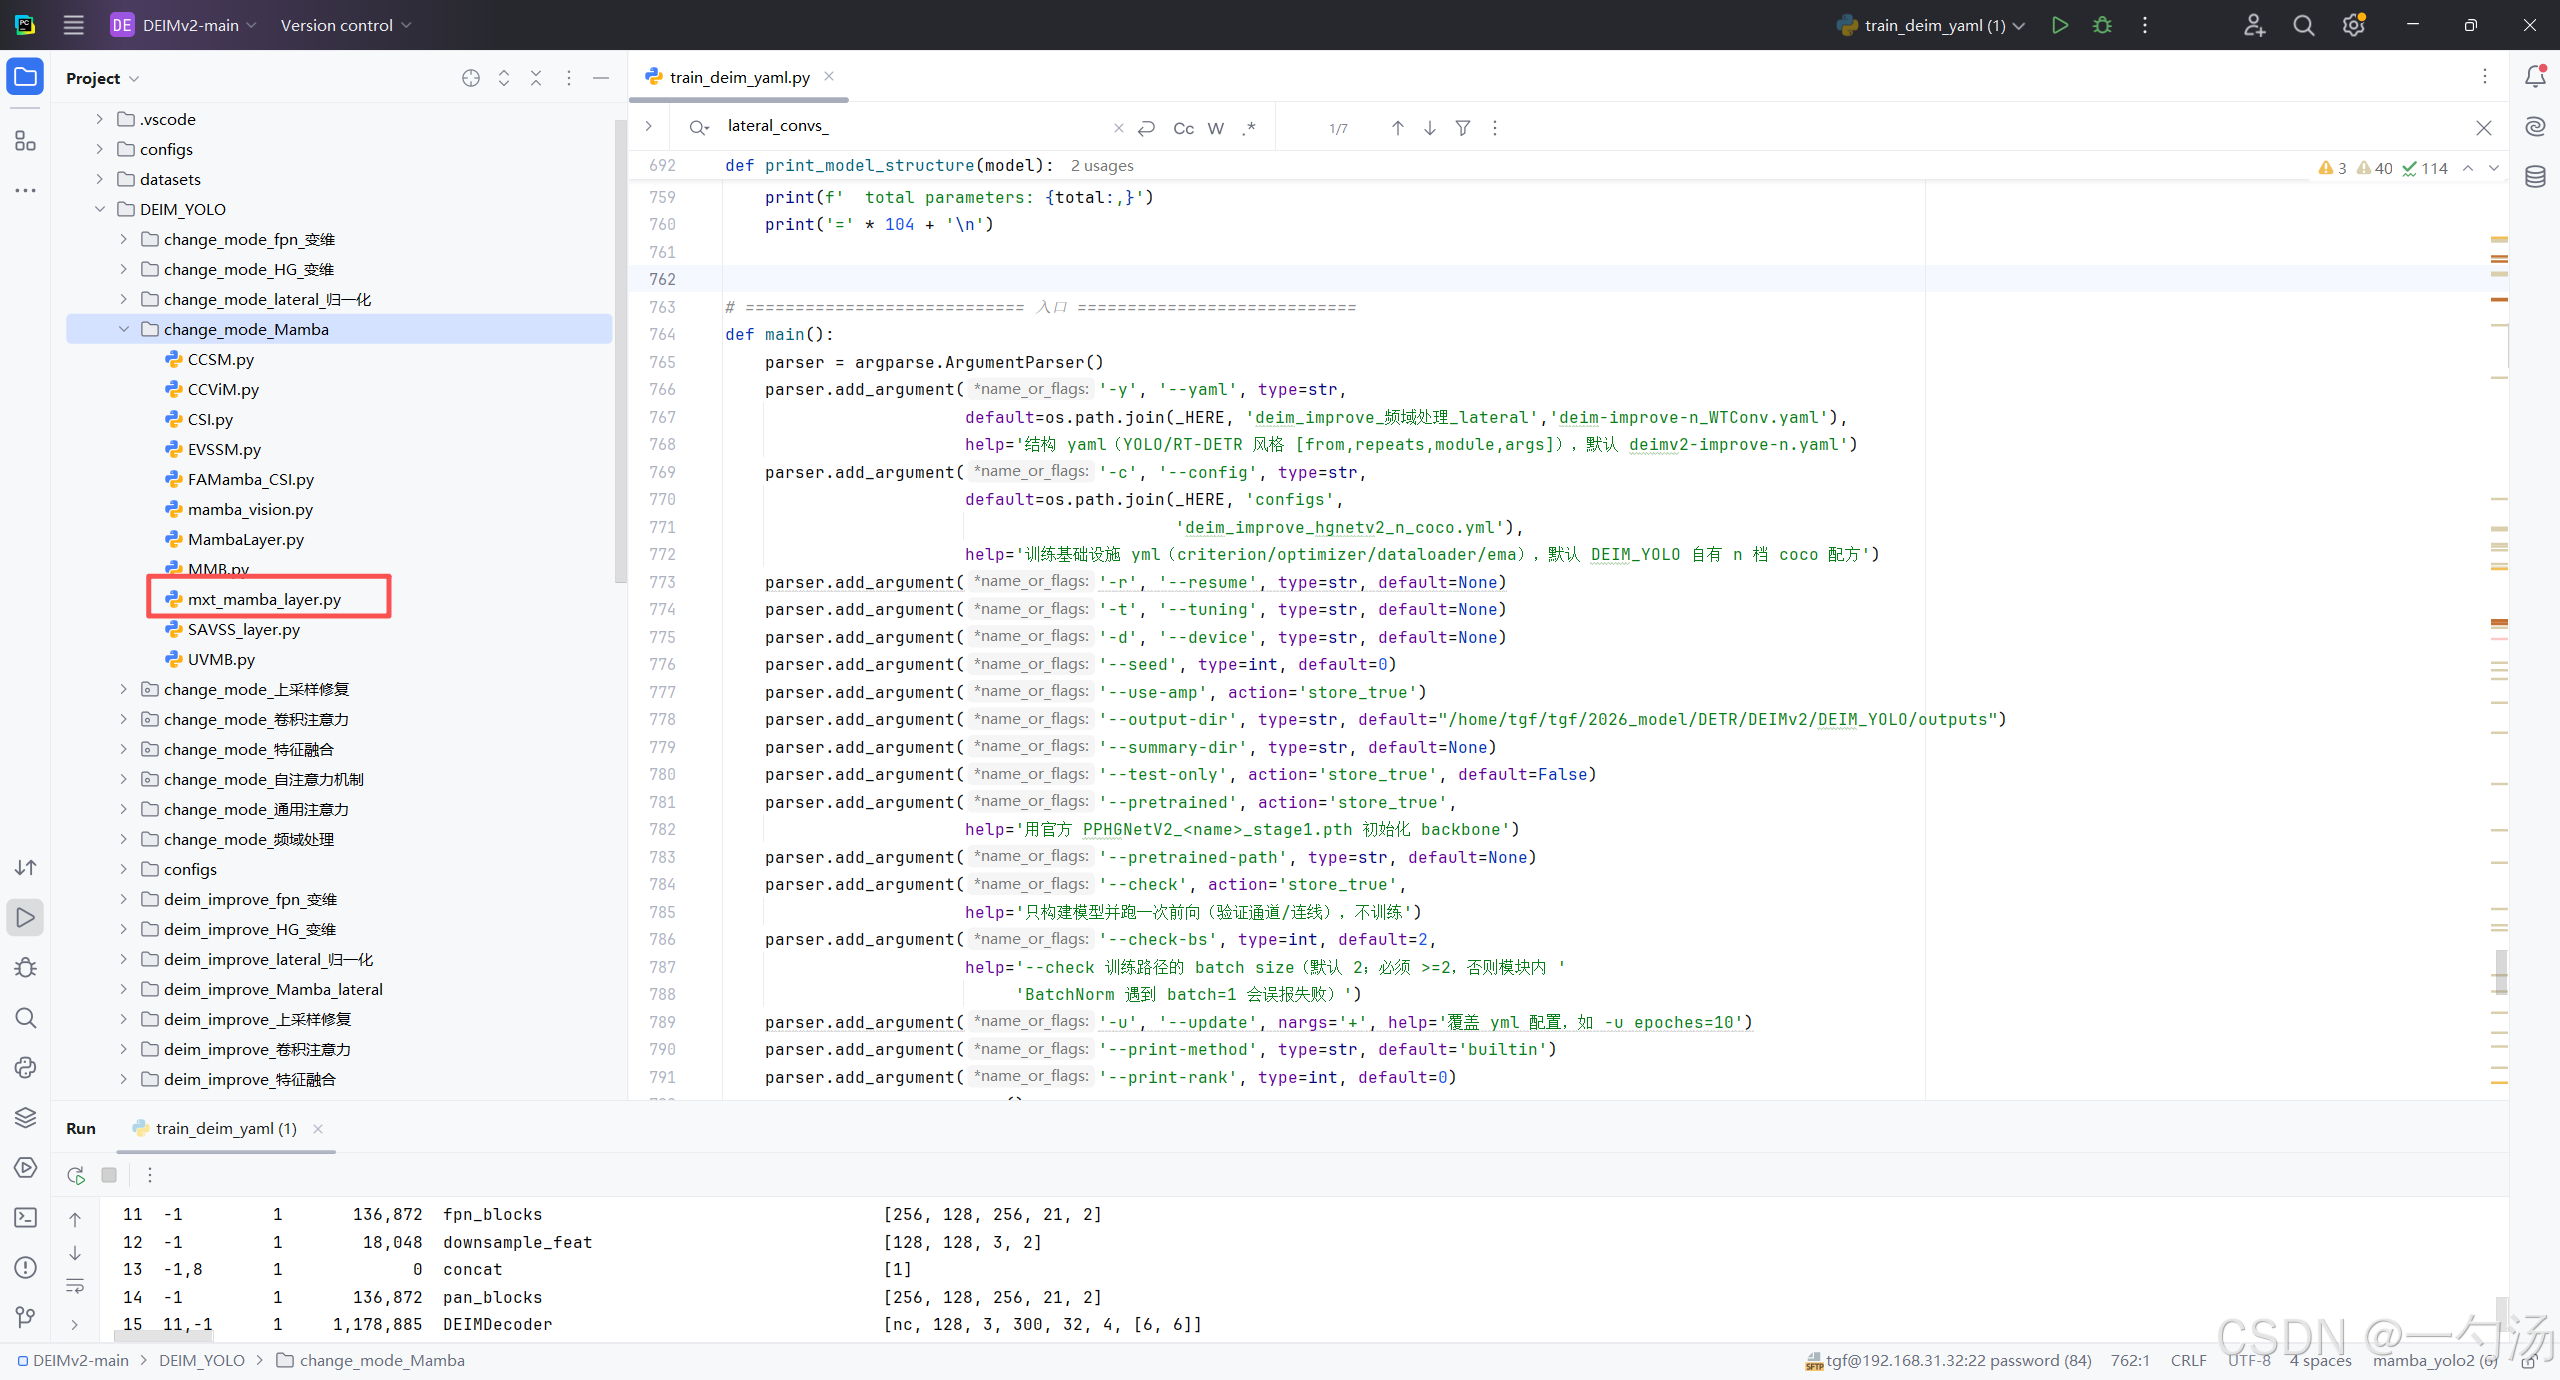
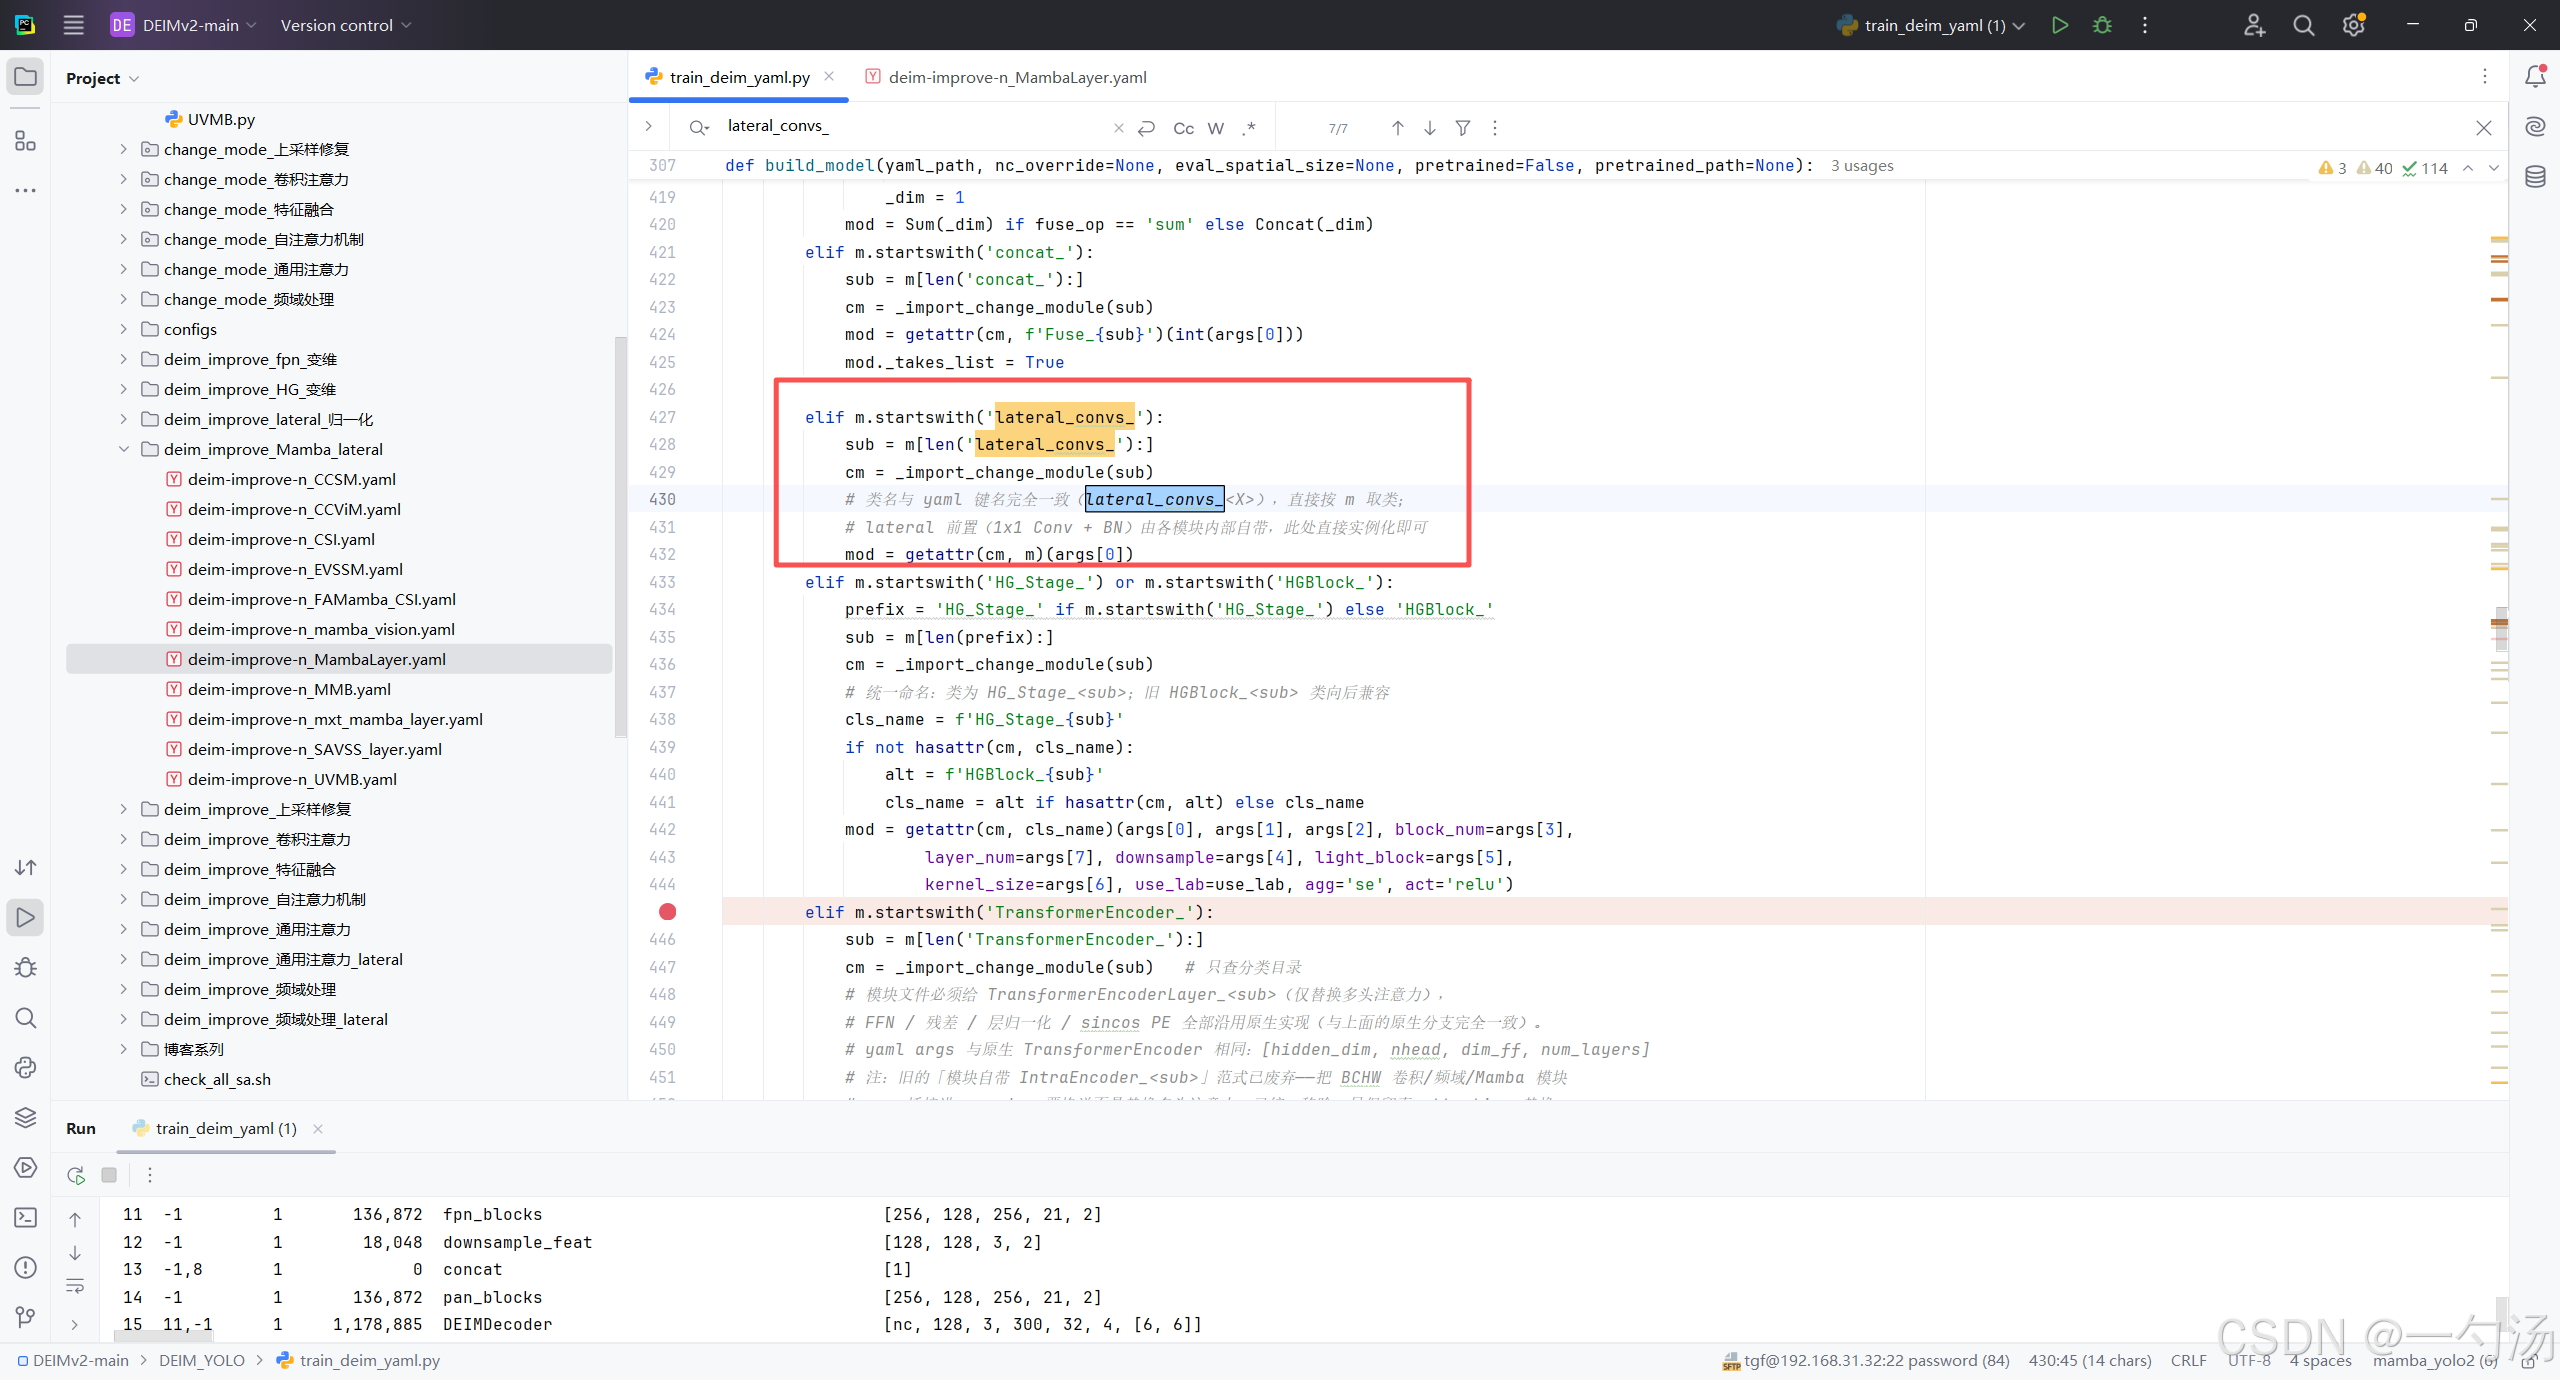
Mamba 的替换变体主落点 lateral_convs_<X>在train_deim_yaml.py的 m.startswith('lateral_convs_') 分支自动导入,不需要自己修改,轻松魔改改进DEIM:
3.1 原生 Mamba 核心组——最正宗的状态空间
| MambaLayer | Mamba-2 核心:LayerNorm + 状态空间扫描(d_state=16, d_conv=4, expand=2)(详见第 4 节) |
| mxt_mamba_layer | 多分支混合 Mamba 层 |
| mamba_vision | 视觉 Mamba(多向扫描) |
3.2 视觉 Mamba 变体组——为图像设计
| CCViM | 卷积+视觉 Mamba 混合 |
| CSI / FAMamba_CSI | 通道空间交互 Mamba / 频率注意力 Mamba |
| EVSSM / SAVSS_layer | 增强视觉状态空间 / 空间注意力视觉状态空间 |
3.3 通道-状态混合组——补上通道维度
| CCSM | 通道-状态协同调制 |
| MMB | Mamba 多分支块 |
| UVMB | 均匀视觉 Mamba 块 |
设计逻辑:三个分组对应"Mamba 进检测器"的三个本质问题——原生核心回答"状态空间范式本身在 neck 上有没有用",视觉变体回答"如何为 2D 特征图定制扫描",通道混合回答"扫描之外还需不需要通道调制"。变体不是堆数量,而是把'换一个计算范式'这个动作的每个可设计维度都覆盖了一遍;MambaLayer 则是其中最正统、最适合验证范式价值的代表。
4.代码和视频讲解
视频讲解:
DEIM:超越 YOLO,快准双绝!DEIM:让 DETR 告别慢收敛,开启实时检测新纪元_哔哩哔哩_bilibili
DEIM:超越 YOLO,快准双绝!一个视频告诉你DEIM如何搭建backbone_哔哩哔哩_bilibili
代码获取:
YOLOv8_improve/DEIM.md at master · tgf123/YOLOv8_improve · GitHub
5.以MambaLayer为例
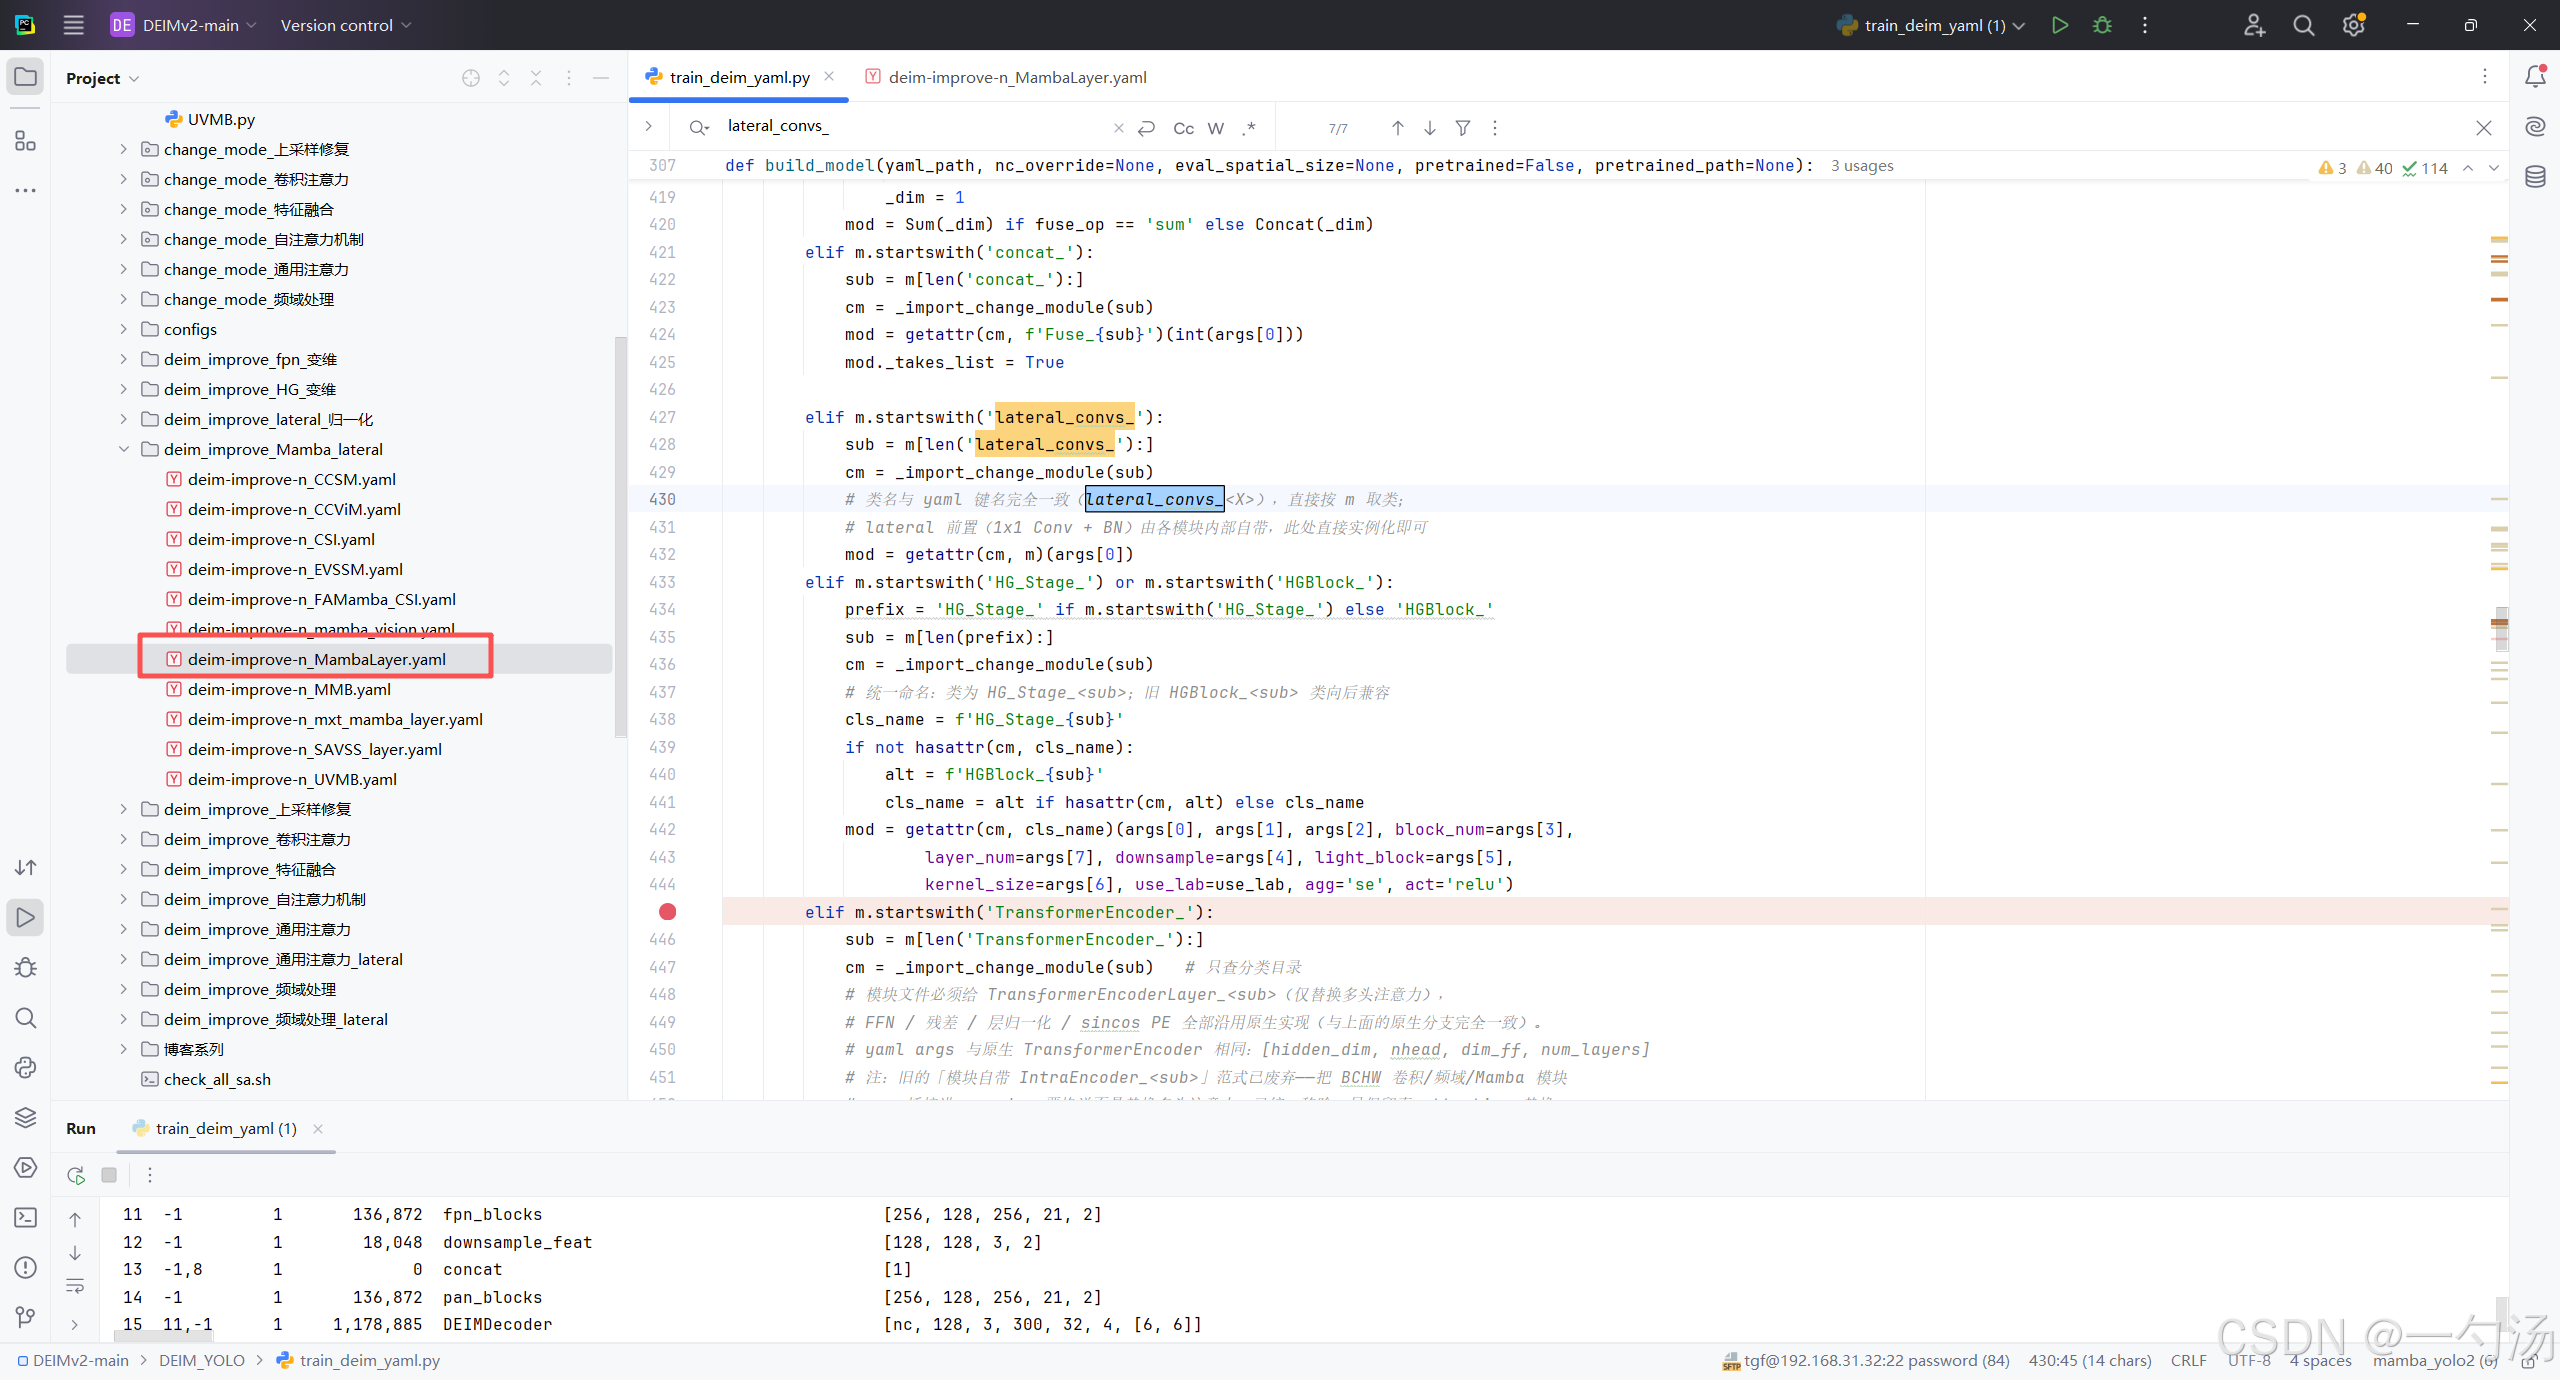
第一: 将下面的核心代码复制到DEIMv2-main\\DEIM_YOLO\\change_mode_Mamba
路径下,如下图所示。
第二:自适应导包与模型搭建
第三:将模型配置文件复制到DEIM.YAMY文件中
第四:yaml改进配置文件
backbone:
# [from, repeats, module, args] (原生 HG_Stage,仅 neck 的 lateral_convs 被改进)
– [-1, 1, HGStem, [3, 16, 16]] # 0 stem(stem_channels) -> P2/4
– [-1, 1, HG_Stage, [16, 16, 64, 1, False, False, 3, 3]] # 1 stage1 -> P2/4
– [-1, 1, HG_Stage, [64, 32, 256, 1, True, False, 3, 3]] # 2 stage2 -> P3/8(n 档不用)
– [-1, 1, HG_Stage, [256, 64, 512, 2, True, True, 5, 3]] # 3 stage3 -> P4/16, 512ch
– [-1, 1, HG_Stage, [512, 128, 1024, 1, True, True, 5, 3]] # 4 stage4 -> P5/32, 1024ch
head:
# —- 1) input_proj(官方 forward 的 proj_feats 循环,n 档 num_levels=2 故循环 2 次)—-
– [-1, 1, input_proj, [128]] # 5 proj_feats[1] = P5': layer4(1024) -> 128
– [3, 1, input_proj, [128]] # 6 proj_feats[0] = P4': layer3( 512) -> 128
# —- 2) intra-scale encoder(DEIM 的 HybridEncoder.encoder,作用于 use_encoder_idx=[1] 即 P5')—-
– [5, 1, TransformerEncoder, [128, 8, 512, 1]] # 7 P5''
# —- 3) 自顶向下 FPN —-
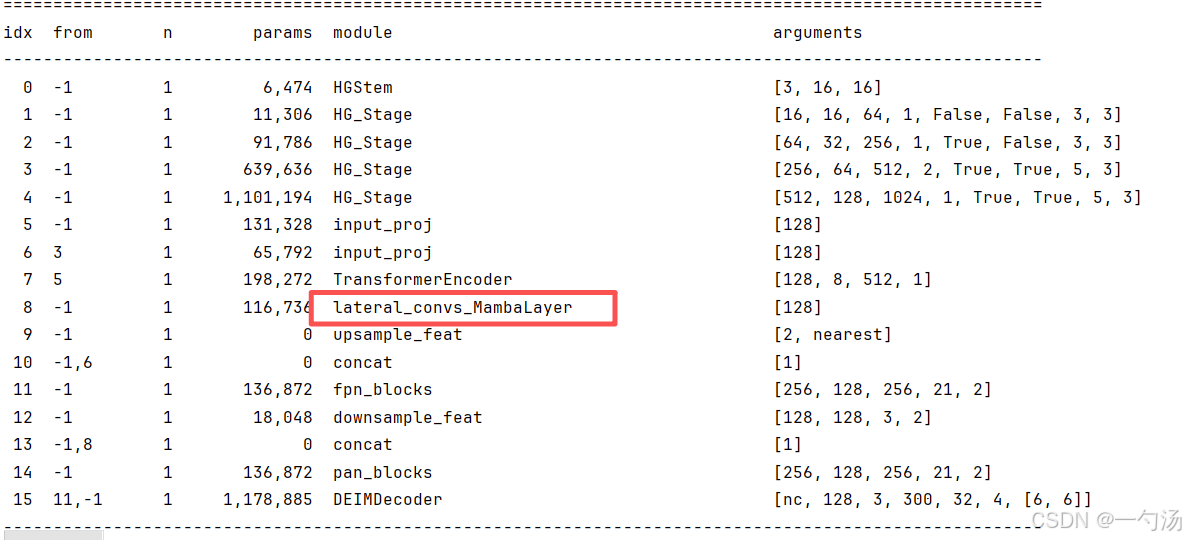
– [-1, 1, lateral_convs_MambaLayer, [128]] # 8 Y5 = lateral_convs.0(P5'')(1×1 conv + BN,无激活)
– [-1, 1, upsample_feat, [2, "nearest"]] # 9 上采样 2 倍:Y5 -> P4 分辨率
– [[-1, 6], 1, concat, [1]] # 10 concat(↑Y5, P4') -> 256ch
– [-1, 1, fpn_blocks, [256, 128, 256, 21, 2]] # 11 F4 = fpn_blocks.0 (c1,c2,c3,c4,n)
# —- 4) 自底向上 PAN —-
– [-1, 1, downsample_feat, [128, 128, 3, 2]] # 12 ↓F4(SCDown: 1×1 + 3×3 dw s2)
– [[-1, 8], 1, concat, [1]] # 13 concat(↓F4, Y5) -> 256ch
– [-1, 1, pan_blocks, [256, 128, 256, 21, 2]] # 14 F5 = pan_blocks.0 -> P5/32
– [[11, -1], 1, DEIMDecoder, [nc, 128, 3, 300, 32, 4, [6, 6]]] # 15 Detect(F4, F5)
第五:模型跑出的结果