版权与内容来源声明
本文为原创整理。文中涉及官方文档、开源仓库、论文与公开报道的内容,均在附表 A 中标注来源;引用官方原文保持原样,不作改写。文中命令、版本号与界面截图以本文成文时的实测/核验结果为准,标注「待验证」的部分请以你本地环境实际输出为判断依据。本文不推荐任何破解、盗版软件,也不推荐任何规避地区限制的访问方式,亦不对任何收益结果作承诺。转载请注明出处。
第 1 章 先说结论:Python 不是入场券,跑通推理才是
很多 C++ / 嵌入式工程师想转 AI 大模型,第一反应是「先去把 Python 学一遍」。这个顺序我建议反过来。
原因很直接:你真正稀缺的存量能力,是「能读懂并驱动别人的推理引擎」——这比会写 Python 语法难得多。一个模型在你的机器上怎么被加载、怎么被量化、走哪块硬件算、显存(或内存)不够时怎么妥协,这些才是真实岗位里「环境部署与推理优化」要处理的东西。它们和语言无关,和工程判断有关。
所以第一课不该是 Python,而是在自己的机器上把一个模型推理跑通:门槛最低、能立刻验证、且直接对应岗位内容。Python 当然要补,但补它的目的是用生态(调 SDK、看社区示例、跑别人的脚本),不是把它当入场券。
本文只做一件事:带你把「本地推理跑通」这件事的边界搞清楚,哪些是官方事实、哪些是我自己的判断,一一标出来。顺带给你一个更稳的心法:转型不是把过去清零,而是换一套问题来用你已有的工程判断力。 部署、量化、后端选择,这些问题的形状,和你当年在嵌入式/服务端排查「资源不够、怎么妥协」几乎一样,只是对象从内存和线程换成了显存和张量。
第 2 章 llama.cpp 是什么
先认识一个工具,叫 llama.cpp(人话解释:一个用 C/C++ 写的、能在你自己电脑上跑大语言模型的推理引擎)。
它的仓库自我描述是:LLM inference in C/C++,许可为 MIT。
官方对它的目标写得很清楚(原文照抄):
The main goal of llama.cpp is to enable LLM (and VLM) inference with minimal setup and state-of-the-art performance on a wide range of hardware – locally and in the cloud.
翻译一下这句话的意思:用最小的配置,在从你笔记本到云服务器的各种硬件上,把大模型(含视觉语言模型)跑起来,并且性能要够好。
几个和「C++ 工程师」相关的点:
- 零依赖。官方特性条目原文:Plain C/C++ implementation without any dependencies。(人话:纯 C/C++ 实现,不依赖一堆第三方运行库。)这对你意味着:编译它用的就是你熟悉的那套工具链,没有一堆 Python 虚拟环境要配。
- 它建在 ggml 库之上。官方原话写作 “is build on top of the ggml library”(原文有此拼写,我保持原样)。(人话:它本身不是从零写的张量库,而是架在一个叫 ggml 的底层张量计算库上。)
- Apple 芯片是一等公民:官方原文 “Apple silicon is a first-class citizen – optimized via ARM NEON, Accelerate and Metal frameworks”。
- x86 也有针对性优化:“AVX, AVX2, AVX512 and AMX support for x86 architectures”;甚至 RISC-V 也有 “RVV, ZVFH, ZFH, ZICBOP and ZIHINTPAUSE support for RISC-V architectures”。
对 C++ 工程师来说,这一点尤其重要:这玩意儿的源码、它的依赖,都是你读得懂的世界。一个用 Python 入门的人,往往停在「装好库、调好 API」就满足了;而你天然会往下多看一层——编译怎么过的、链接了什么、哪段是热点。后面第 7 章会具体说这种「多看一层」能变成什么。
第 3 章 量化位宽为什么和你有关
你大概率听过「量化」这个词,但可能没意识到它和你能不能在本地跑起来直接挂钩。
官方特性条目原文:
1.5-bit, 2-bit, 3-bit, 4-bit, 5-bit, 6-bit, and 8-bit integer quantization for faster inference and reduced memory use
(人话:模型权重原本常用更高的精度存储,量化就是把它压成更低位宽的整数——用精度换内存和速度。位宽越低,文件越小、吃的内存越少,但信息丢失越多。)
这解释了为什么「本地跑得起来」:一个几十 GB 全精度的模型,普通电脑根本装不下;压到 4-bit 甚至更低之后,内存占用大幅下降,笔记本也能跑。代价是输出质量会有取舍——这正是你需要能讲清楚的工程权衡,而不是一个「越低越好」的结论。
| 1.5 / 2 / 3 bit | 最小、最快 | 取舍最明显 | 先验证「能不能跑通」时用 |
| 4 / 5 / 6 bit | 适中 | 多数场景够用 | 本地日常把玩的主力区间 |
| 8 bit | 较大、较慢 | 更接近原始精度 | 想看「量化前长什么样」时对比用 |
说明:上表前两项为官方原文列出的位宽范围,右两列是本文观点,不是官方结论。具体哪个位宽在你的机器上「够用」,请以你本地实测为准。
第 4 章 跑起来有四条路
官方 Quick start 给了四条获取途径(照抄其表述):
本文观点:哪条路适合你,看你的背景。
| llama.app | 只想最快看到效果 | 点几下就行,先建立「它能跑」的信心 |
| 预编译二进制 | 不想碰构建环境 | 下载即用,适合先验证 |
| Docker | 环境干净、怕污染本机 | 一条命令起服务,适合后面接 API |
| 源码构建 | C++ 工程师、想读代码 | 你本就该走这条——能编译、能断点、能改 |
下面两条是官方 README 给的示例命令。你我没有实测过,务必注意:
⚠️ 代码待验证
# Download and run a model directly from Hugging Face
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
# Launch OpenAI-compatible API server
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
这是官方 README 的写法:第一条是直接拉起一个模型对话,第二条是起一个兼容 OpenAI 接口的本地服务。命令能否在你机器上一次跑通,取决于你的系统、编译选项和模型文件,请以其本地实际输出为判断依据。
本文观点:C++ 工程师别停在「敲了命令」,要顺着这两条命令往里看——它从哪个仓库拉模型、用什么后端加载、量化在哪一步生效。这一步才是你的增量。
第 5 章 后端怎么选
「后端」人话解释:模型到底交给哪块硬件去算——CPU、苹果芯片、N 卡、还是通用 GPU API。
官方有一张 Supported backends 表(后端 / 目标设备,逐条照抄):
| BLAS | All |
| BLIS | All |
| CANN | Ascend NPU |
| CUDA | Nvidia GPU |
| HIP | AMD GPU |
| Hexagon | Snapdragon |
| IBM zDNN | IBM Z & LinuxONE |
| MUSA | Moore Threads GPU |
| Metal | Apple Silicon |
| OpenCL | Adreno GPU |
| OpenVINO [In Progress] | Intel CPUs, GPUs, and NPUs |
| RPC | All |
| SYCL | Intel GPU |
| VirtGPU | VirtGPU APIR |
| Vulkan | GPU |
| WebGPU | All |
| ZenDNN | AMD CPU |
常用的几类,本文观点这样理解(注意:下表右列是判断,不是官方描述):
| CPU(BLAS/BLIS) | 没有独显也能跑,慢但稳 | 笔记本验证、小模型 |
| Metal | 苹果芯片专属加速 | Mac 本地首选 |
| CUDA | N 卡加速 | 有 N 卡的工作站 |
| Vulkan / WebGPU | 跨 GPU、甚至浏览器 | 不想绑死厂商时 |
| CPU+GPU 混合 | 官方原文:CPU+GPU hybrid inference to partially accelerate models larger than the total VRAM capacity | 模型比显存还大时 |
最后一行是官方原文:CPU+GPU hybrid inference to partially accelerate models larger than the total VRAM capacity。(人话:当模型比显存还大,就把一部分放 GPU、一部分放 CPU 一起算,让它「勉强跑起来」。)
这份资料是什么:后端和量化怎么取舍,最好对着能跑的环境边试边记。我把官方文档索引(build / docker / models 等)和一套从私有化部署讲起的视频课入口整理在资料包里了,照着目录挑章节最省时间。放在资料包里,扫码即可获取:
第 6 章 三个容易走偏的地方
下面是本文观点,不是官方结论,但都是踩过坑后的判断:
第一,把「敲命令跑起来」当成「懂推理」。
能跑 llama cli 不等于理解推理。真正值钱的是:你能说清量化位宽怎么影响输出、不同后端差在哪、显存不够时系统怎么妥协。只点了命令,等于只验证了「键盘能用」。
第二,一上来补 Python 语法而绕开部署。
Python 要学,但别把它当门槛。先让推理在本机跑通,缺什么生态再补什么——这样你补的是「用得上」的部分,不是「看起来在学 AI」的部分。
第三,只看模型多大,不看硬件约束。
很多人执着于「装下最大的模型」,却说不清自己机器为什么装不下、量化之后差在哪。部署的本质是在硬件约束下做取舍,结论必须能追到量化位宽和后端选择这两件事上。
第 7 章 从「跑起来」到「说得清」
本篇重点不是教你写简历,而是:这段经历怎么变成可追问的工程经验。
你做过的事,要能回答几个问题才算「说得清」:
- 我为什么选这个量化位宽,而不是更低/更高的?(回到第 3 章的取舍)
- 我为什么用这个后端,而不是别的?(回到第 5 章的适用面)
- 模型比显存大时,我知不知道有 CPU+GPU 混合这条路?
能答上来,这段经历就是「我亲手把推理在本地部署并做过权衡」,而不是「我跑过一条命令」。
对 C++ 工程师还有一个额外红利:llama.cpp 的源码和依赖,是你熟悉的世界。官方致谢里列了一批单头文件库(single-header libraries),被它复用——比如 yhirose/cpp-httplib(被 llama-server 使用)、nothings/stb、nlohmann/json、mackron/miniaudio、sheredom/subprocess.h。(人话:它用的就是 C++ 圈子里常见的那批轻量库。)
这意味着什么?意味着你不止「会用工具」,还能顺着源码读下去:服务怎么起的、请求怎么走的、依赖是不是你见过的库。这恰恰是 C++ 工程师转大模型时,比「会写 Python」更难被替代的那块——你读得懂推理引擎本身。当别人只能描述「我调了某个接口」,你能描述「请求从哪进、在哪被量化、交给哪块硬件、为什么这一步慢」,这中间的认知落差,就是岗位加分项。
官方文档索引可以继续深挖:docs/build.md、docs/docker.md、docs/android.md、docs/multi-gpu.md、docs/development/token_generation_performance_tips.md、docs/models.md。
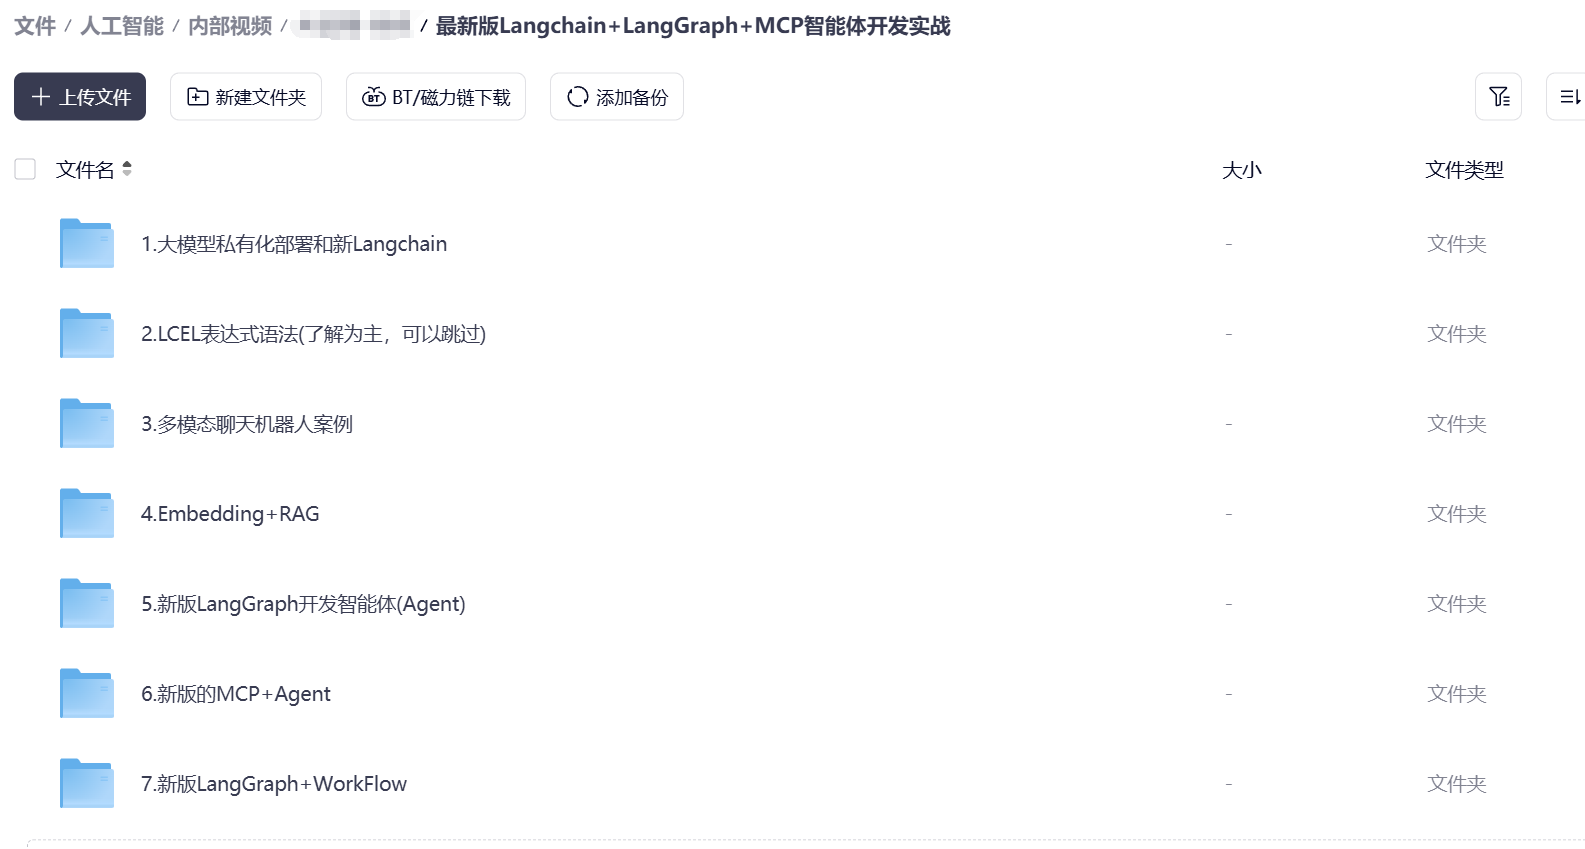
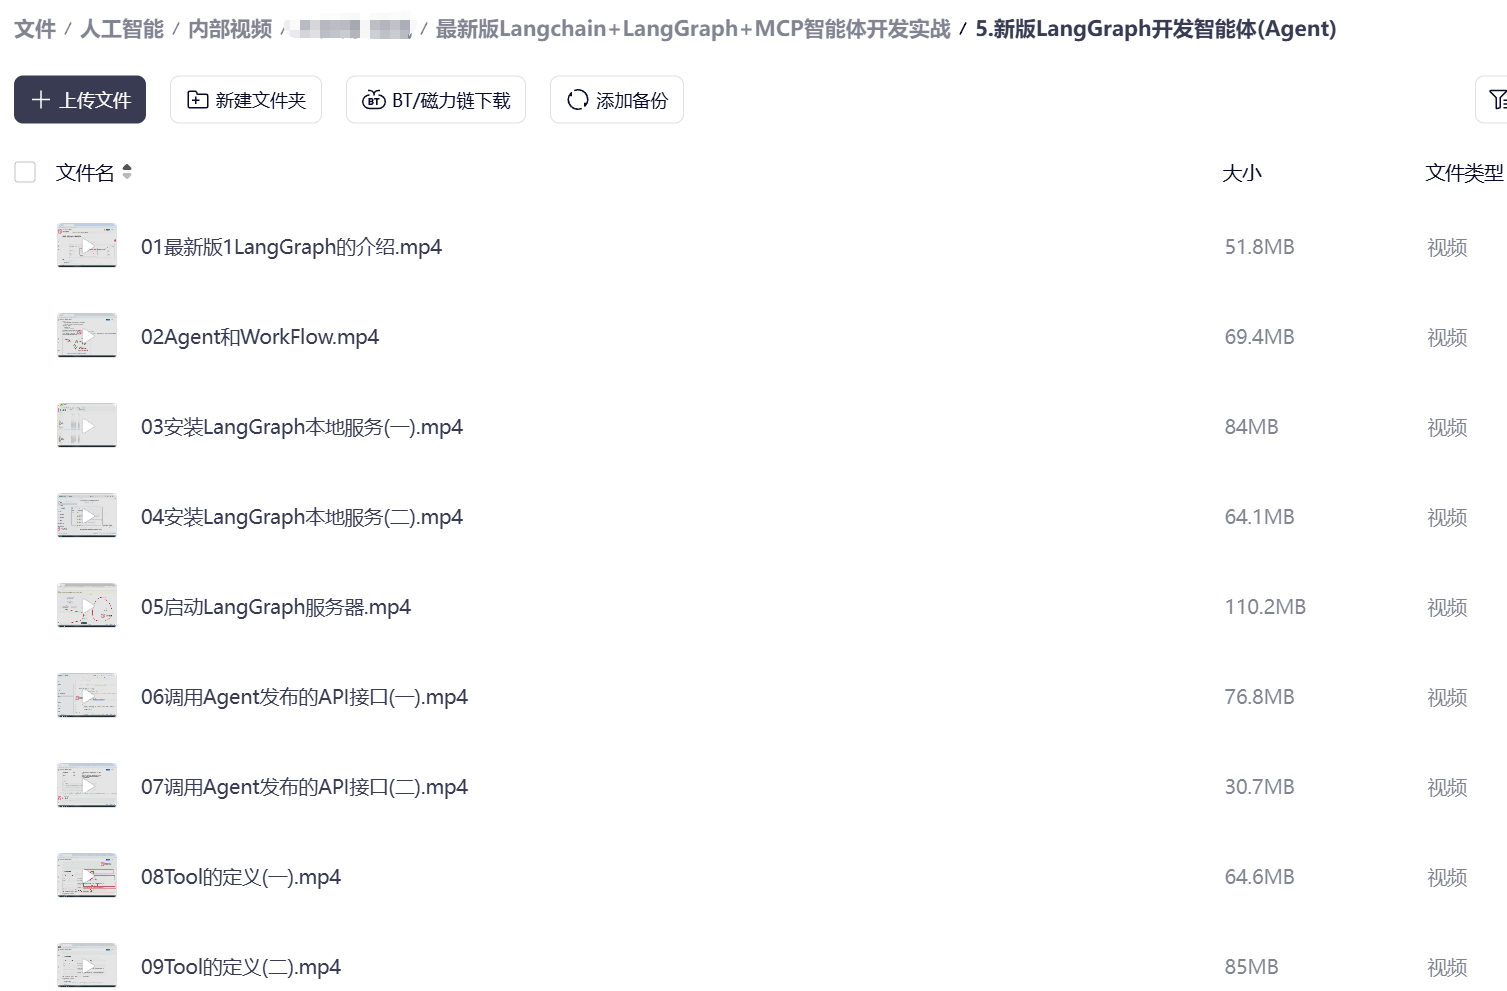
这份资料是什么:从「能跑」到「说得清」,最好有一份能对照的路线和能跟着敲的视频。我在资料包里放了 AI 大模型学习路线图和《LangChain + LangGraph + MCP 智能体开发实战》视频课,目录里就有私有化部署那一章。放在资料包里,扫码即可获取:
附表 A:本文引用事实与出处对照表
| 1 | 仓库自我描述 “LLM inference in C/C++”,许可 MIT | llama.cpp 官方仓库 https://github.com/ggml-org/llama.cpp (2026-09-21 访问) | 第 2 章 |
| 2 | 官方目标原文(LLM/VLM inference with minimal setup…) | 同上 README | 第 2 章 |
| 3 | “is build on top of the ggml library”(原文拼写) | 同上 README | 第 2 章 |
| 4 | “Plain C/C++ implementation without any dependencies” | 同上 README | 第 2 章 |
| 5 | Apple silicon / x86 / RISC-V 优化条目原文 | 同上 README | 第 2 章 |
| 6 | 1.5/2/3/4/5/6/8-bit 量化原文 | 同上 README | 第 3 章 |
| 7 | Quick start 四条获取途径(llama.app / Docker / releases / 源码) | 同上 README | 第 4 章 |
| 8 | 两条示例命令及注释(Download and run… / Launch OpenAI-compatible API server) | 同上 README | 第 4 章 |
| 9 | Supported backends 全表(BLAS~ZenDNN 共 17 项) | 同上 README | 第 5 章 |
| 10 | “CPU+GPU hybrid inference to partially accelerate models larger than the total VRAM capacity” | 同上 README | 第 5 章 |
| 11 | 致谢单头文件库:cpp-httplib / stb / nlohmann-json / miniaudio / subprocess.h | 同上 README 致谢 | 第 7 章 |
| 12 | 文档索引:build / docker / android / multi-gpu / token_generation_performance_tips / models | 同上 README | 第 7 章 |
| 13 | 「Python 不是入场券,先跑通推理」及全文取舍判断 | 本文观点(非外部事实,请辩证看待) | 第 1、4、6、7 章 |
附表 B:术语速查表
| 推理(Inference) | 把训练好的模型拿来用——给它输入、拿回输出,区别于训练 |
| 量化(Quantization) | 把模型权重压成更低精度的数,用精度换内存和速度 |
| 后端(Backend) | 模型交给哪块硬件算:CPU、Metal、CUDA、Vulkan、WebGPU 等 |
| ggml | llama.cpp 底下那层 C 写的张量计算库 |
| GGUF | llama.cpp 使用的模型文件格式(本文示例模型后缀) |
| 混合推理 | 模型比显存大时,CPU 和 GPU 一起分担计算 |
| MIT 许可 | 一种宽松开源许可,允许较自由地使用与再分发 |
写在最后:这篇用到的资料
写这篇文章时,把相关的官方文档和源码又翻了一遍,顺手也整理了几份配套的东西:
- 大模型学习路线图:从零基础到能自己动手做 Agent,按阶段说明每一步该学什么、哪些可以先跳过
- 《LangChain + LangGraph + MCP 智能体开发实战》视频课:7 个模块,从私有化部署、Embedding+RAG 到 MCP+Agent 全流程
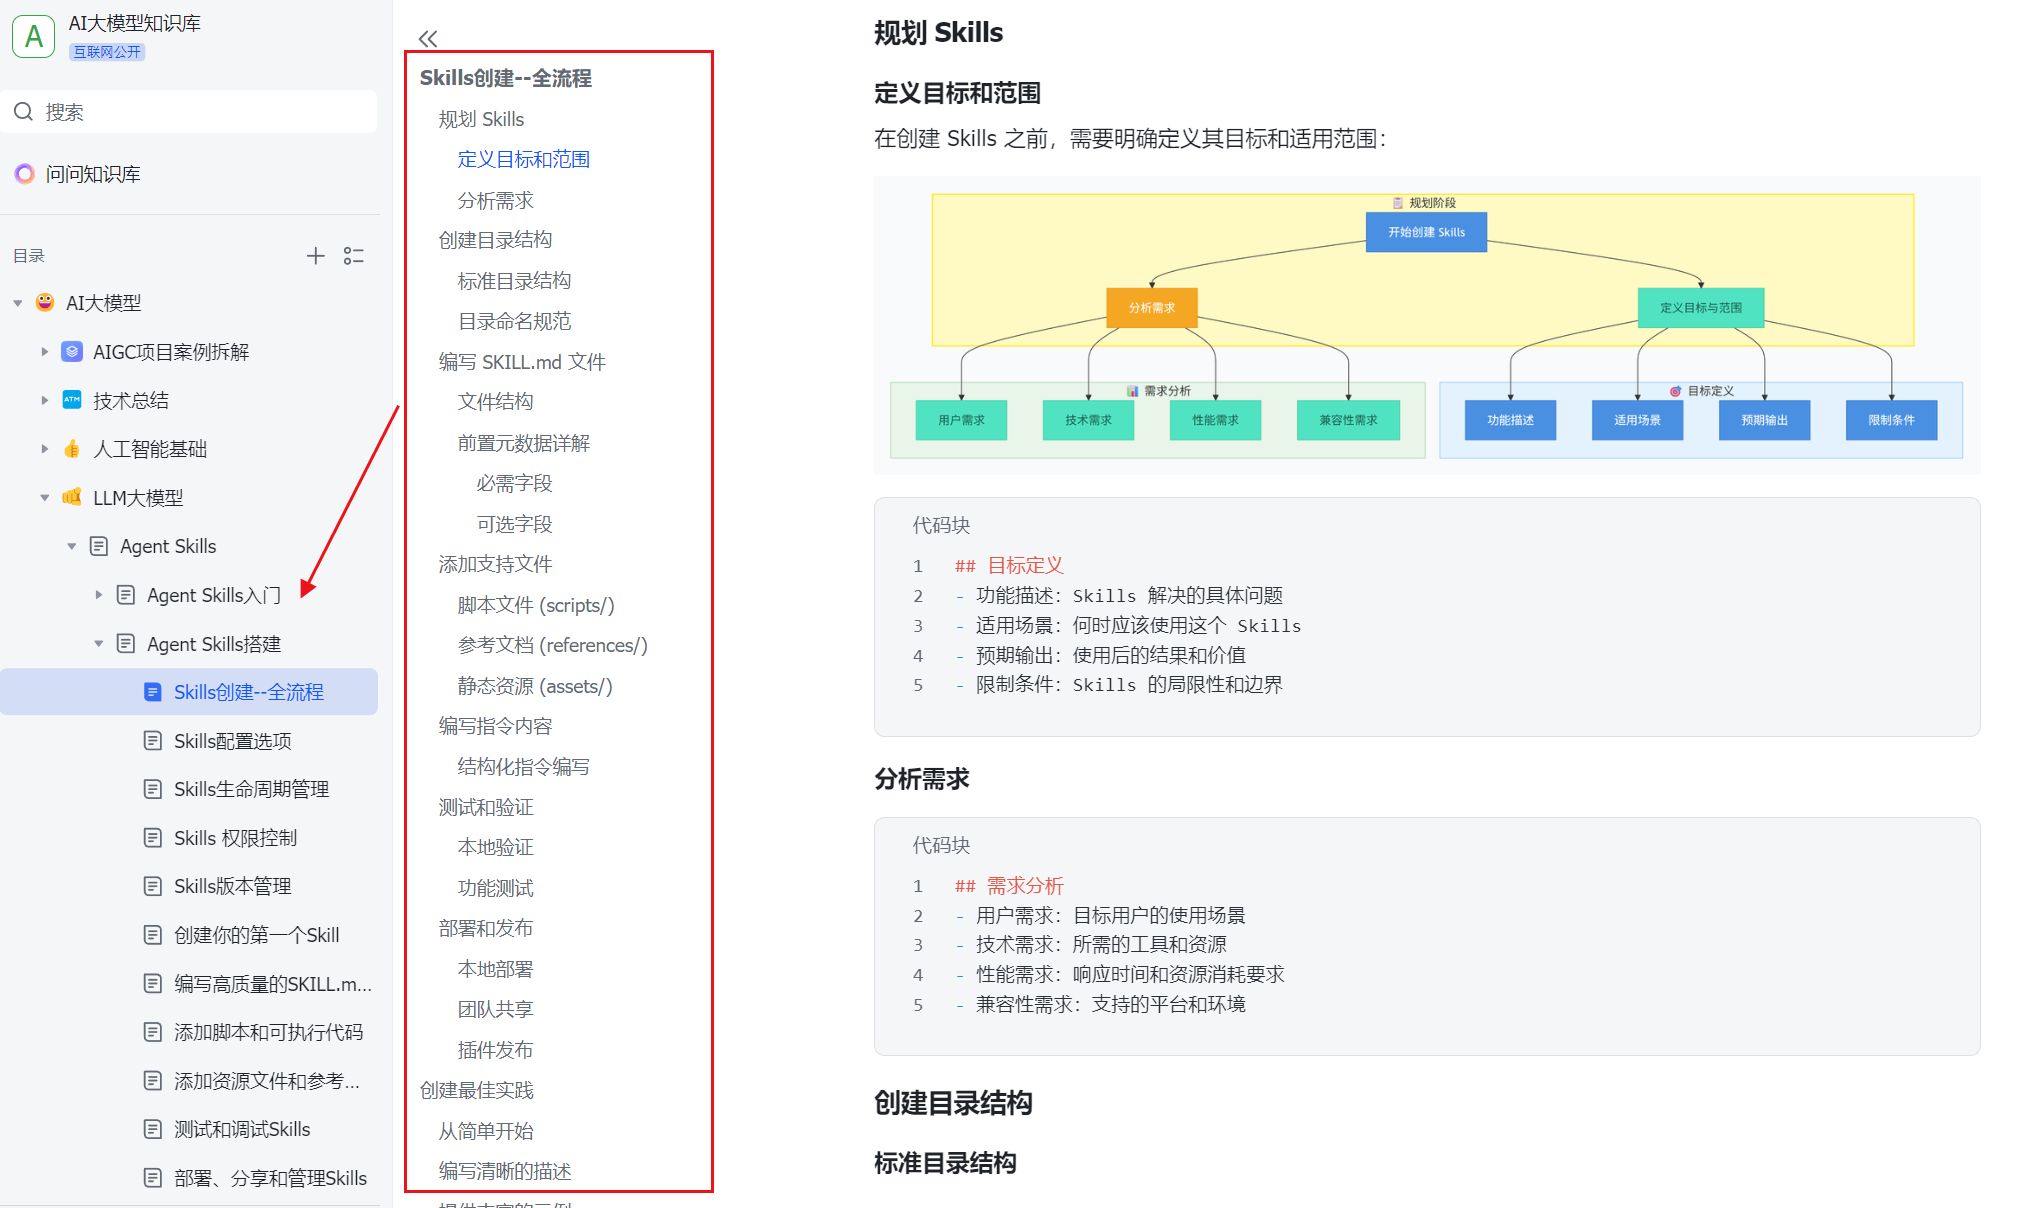
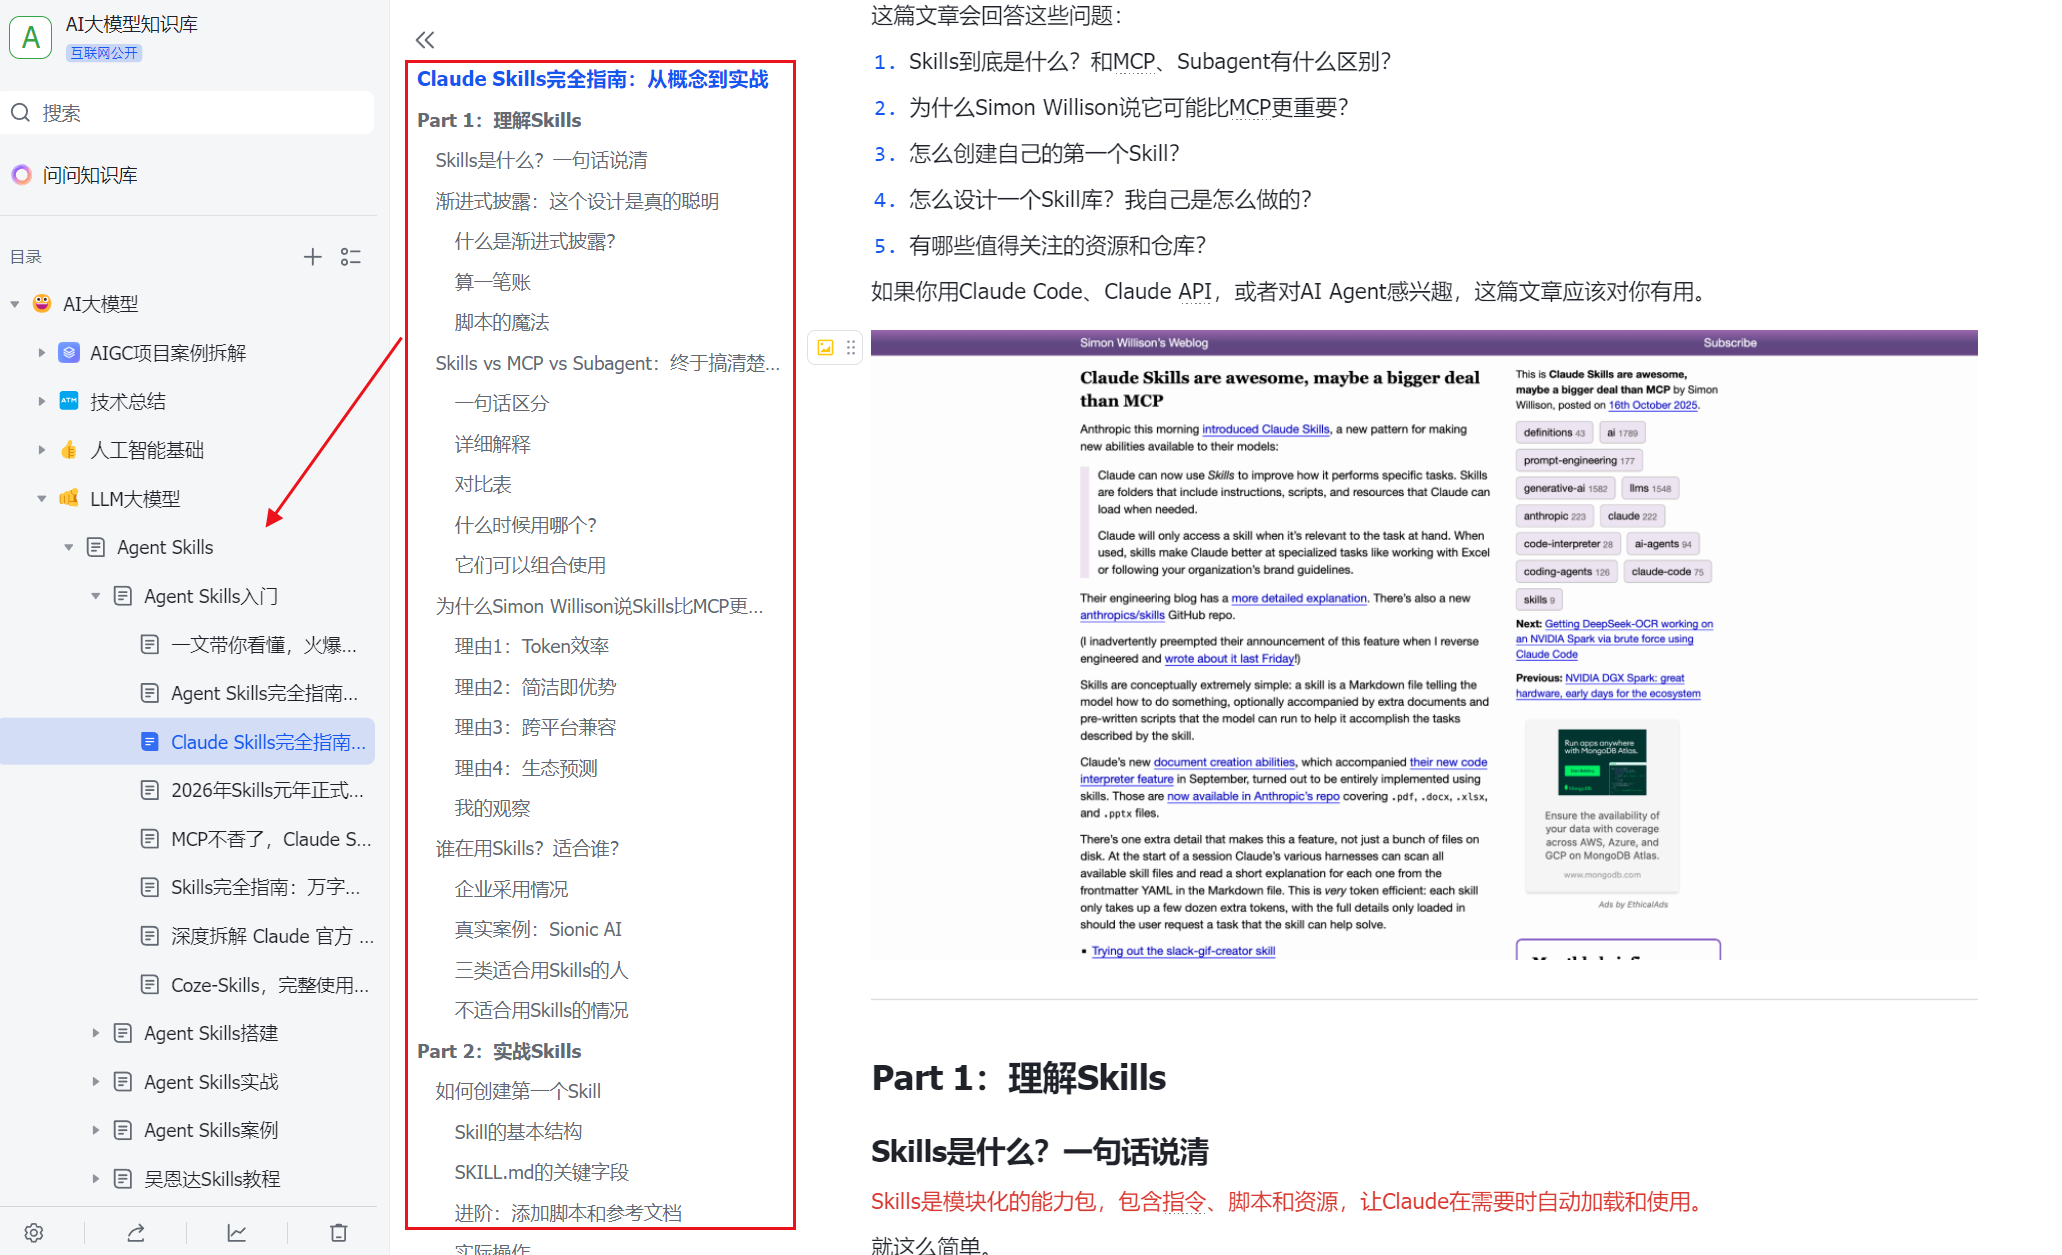
- AI 大模型知识库(在线可查):Agent Skills 从入门到落地、Claude Skills 完全指南等专题,按目录浏览即可
- 640 套 AI 大模型行业报告 + 经典 PDF 书籍:看行业落地案例和别人怎么做的时候用得上
- 大模型零基础到精通教学视频:跟着敲一遍,比只读文档快得多
资料是我自己整理的,放在下面这个码上,扫码即可获取:
添加时备注「AI」,优先通过。
资料按「先路线、再动手、最后查漏」的顺序整理好了,建议先看学习路线那一份,照着它挑一条适合自己当前基础的路径再往下看。