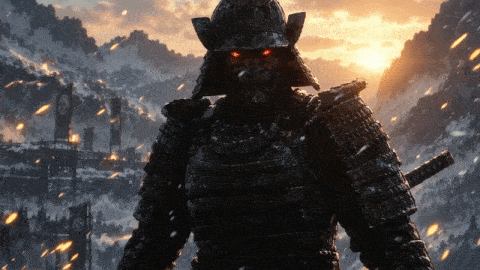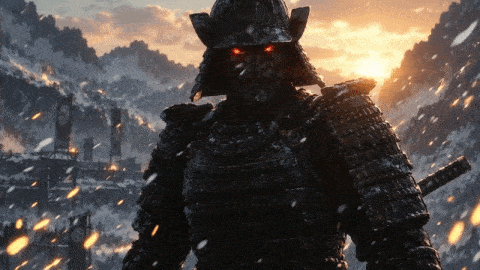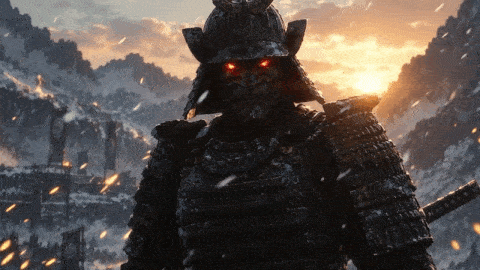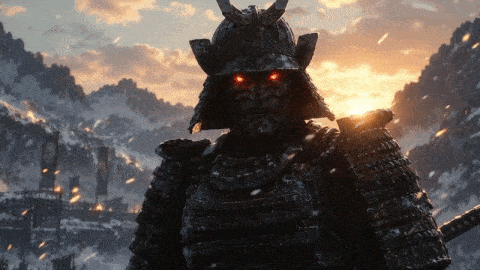
 (使用 Gemini Omni Flash 生成的视频)
几年前第一次尝试 Deforum 的时候,它几乎算是开源 AI 动画生成领域最常用的工具之一。它基于 Stable Diffusion 模型,通过逐帧生成的方式来制作 AI 视频。
当时,我想做的是把一段输入视频的视觉风格从电影感的奇幻风格转换成动漫风格。整个方案使用了 Stable Diffusion 1.5、一个 Anime LoRA,以及 ControlNet 来尽可能保持不同帧之间的一致性。
从理论上看,这套组合似乎没什么问题。但实际效果只能说相当不理想。
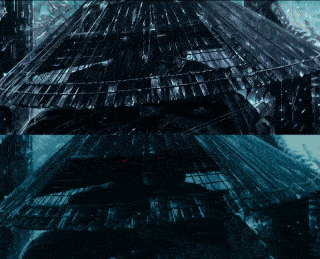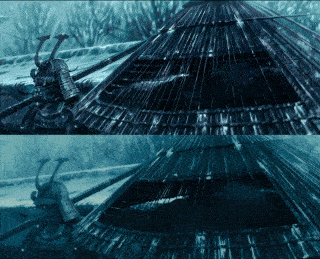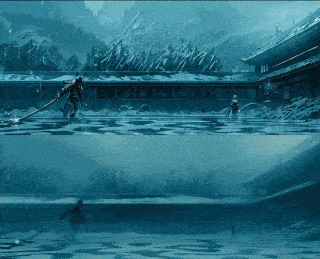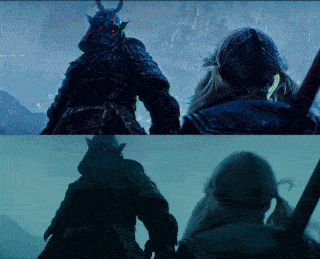 (《美少女特攻队》原版场景(下)— Deforum 视频重制版(上),GIF 分辨率和质量有所降低 )
除了生成画面本身存在大量问题——比如背景细节融化、对提示词理解不到位、局部结构变形等——那个时期 AI 视频生成最典型、也最难解决的问题,其实是时间一致性(temporal consistency)。
如果你经历过那个阶段,可能还记得那些在网上疯狂传播的“跳舞希腊雕像”视频。
在当时的 AI 视频工具中,这已经算是相当惊艳的成果了,但画面闪烁的问题依然非常明显。
所谓视频闪烁,本质上是因为生成模型在逐帧生成时,会不断重新决定一些细节、纹理甚至光照。即使主体看起来没有变化,这些局部信息也可能在相邻帧之间发生变化,从而破坏整个视频的连续性。
而时间来到三年之后,我们已经有了 MiniMax、可灵、Sora、万象 等模型。
它们不仅能够生成细节清晰、观感自然的单帧画面,同时还能够在连续的视频中保持相当高程度的时间一致性。
 (* 2026 年生成的 AI 视频(左图,由Maurice Bourdon使用 MiniMax H3 生成)与 2023 年生成的 AI 视频(右图)对比。GIF 分辨率和质量有所降低*)
下面就和你一起梳理一下:过去几年里,AI 视频生成到底经历了哪些关键的技术演进,才让画面质量和时间一致性实现了如此惊人的提升。
当每一帧都是一个独立任务
视频生成的故事其实并不是从 Deforum 或 Stable Diffusion 开始的。
前面提到的很多问题,在生成式 AI 视频发展的早期阶段就已经存在。早期研究者尝试过很多不同的方法。例如,VGAN 使用 GAN 和 3D 卷积来生成视频;MoCoGAN 则尝试显式地将“内容(content)”与“运动(motion)”分离,让两者可以被独立控制。
后来,Attention 机制开始进入这一领域。比如 VideoGPT 就把视频表示成一系列离散 token,再使用 Transformer 对这些 token 进行预测,本质上借鉴了 Transformer 在文本生成领域已经取得成功的思路。
这些早期方法都没有真正成为主流,因为它们最终生成的视频,最多只能算“很有潜力”,距离真正实用还有很大距离。
真正进入大众视野的是 2022 年发布的 Stable Diffusion。随后出现的 Deforum,则进一步展示了如何把一个原本用于图像生成的模型“改造成”视频生成工具。
那么,Deforum 搭配 ControlNet 到底是怎么工作的?
首先,我们获取原始视频中的一帧,并从这一帧中提取结构信息,例如深度图或边缘图,然后将这些信息输入 ControlNet,让生成结果大致保持原始画面的构图。
接着,把上一帧生成的结果作为下一帧 Stable Diffusion 1.5 img2img 的初始图像。生成完成后,这一帧又会成为下一次生成的输入。
如此循环往复,一帧接一帧地生成整个视频。
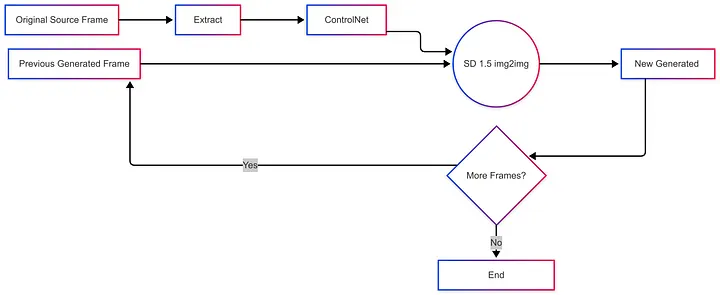 (Deforum + ControlNet 生成循环示意图)
正如前面提到的,当时使用的是 SD 1.5、Anime LoRA,以及用于保持结构的 ControlNet 深度图。
从理论上来看,这套方案似乎相当合理,但实际效果并不理想。
其中最关键的问题在于:整个流程只是通过数据传递,把多个独立的推理步骤串联了起来,而不是让模型本身真正建立起持续的视频上下文。
SD 1.5 根本不知道“上一帧”是什么,也不知道自己正在处理一个视频。
对于它来说,输入的只是一张 init image,然后像处理普通 img2img 任务一样对这张图进行去噪。它并没有记住自己上一帧生成了什么。
所以,我们能够获得的时间连续性,其实只来自外部流程:把上一帧生成的结果重新喂给模型,作为下一帧的初始图像,而不是模型自身具备了真正的视频记忆能力。
除此之外,ControlNet 的结构图也是针对每一帧独立提取的。这同样可能导致相邻帧之间出现细微的不一致。
如果我们提高上一帧对当前帧的影响,可以让画面更加稳定,但同时也可能削弱新的动漫风格。
反过来,如果降低上一帧的影响,让模型更充分地发挥风格化能力,那么每一帧的细节和纹理就可能被重新生成。
换句话说,当时所谓的“一致性”,其实是在用像素一点一点地换来的,而且每一次取舍都非常脆弱。
让图像模型真正理解运动
下一代方法并没有完全抛弃 Diffusion 模型,而是在原有架构上继续增加视频相关能力。
例如 AnimateDiff 和 Video LDM,都保留了经过预训练的 2D 图像 UNet,并在原有空间层之间加入新的时间注意力(temporal attention)模块。
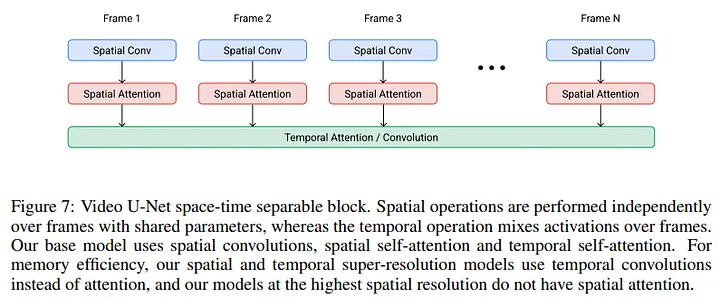 (LDM视频 架构的时间注意力)
原有的空间层依然负责逐帧处理画面——时间维度甚至可以简单地折叠进 batch 中。
而新增的时间模块,则开始沿着帧的维度观察整个视频。
由于这个模块是在大量视频数据上训练出来的,它开始真正学习不同帧之间的运动模式,而不再只是依赖像素层面的“前后帧混合”。
这是一个真正意义上的进步:模型开始学习帧与帧之间的关联。
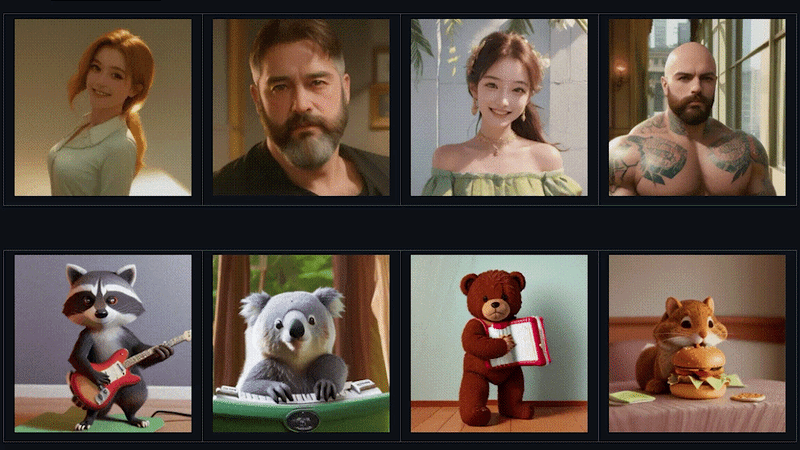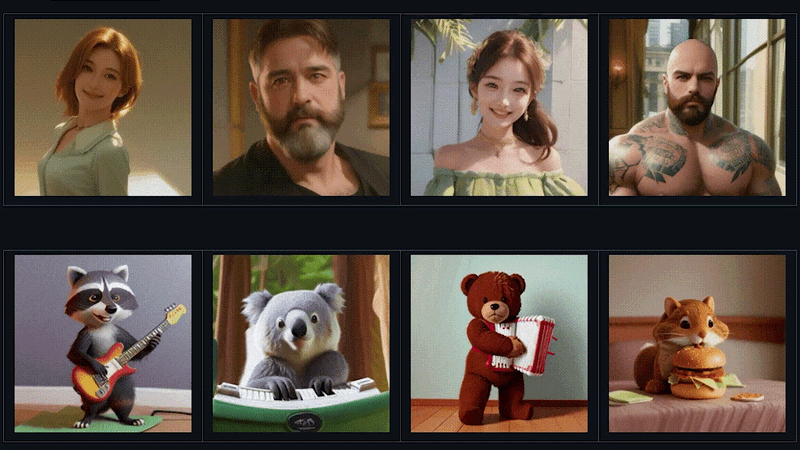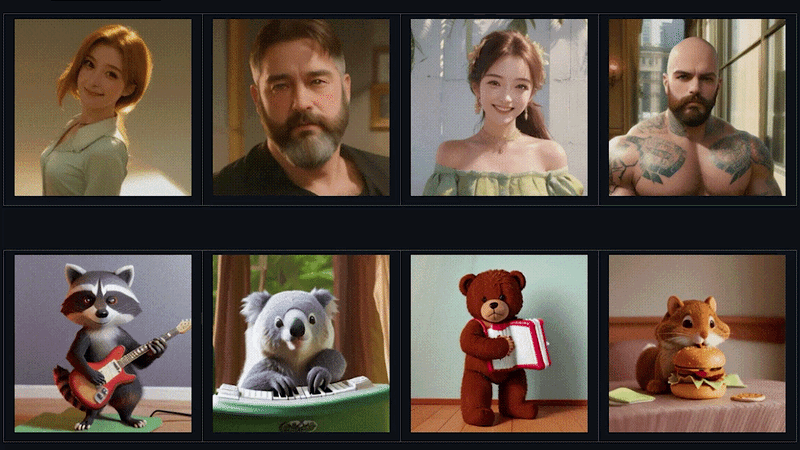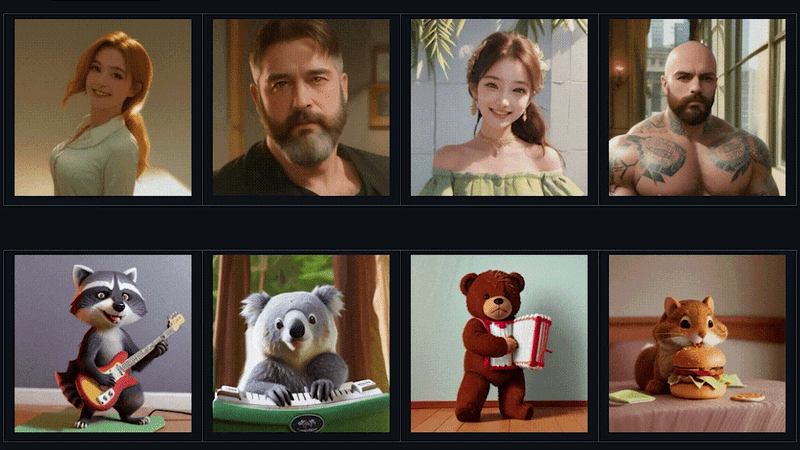 (LDM视频 示例)
这时,模型已经具备了时间一致性能力。
但问题在于,时间推理仍然只是附加在一个本质上以图像生成为核心的模型之上的模块,因此它的能力依然存在上限。
为了更直观地理解这一点,可以想象模型正在生成一个人走路的画面。
空间层非常擅长回答:
“这一帧画面应该长什么样?”
而时间模块负责回答:
“这一帧应该和前后帧形成怎样的关系?”
但底层的图像生成模型,本质上还是围绕“生成一张合理的图片”进行优化的。
时间模块需要在此基础上,额外为画面施加连贯的运动。
在很多情况下,这已经能够取得不错的效果。但当任务变得更加复杂时,问题就会开始暴露,例如:
- 更复杂、持续时间更长的运动;
- 物体被遮挡之后再次出现;
- 持续数秒甚至更长时间的运动变化。
与此同时,还有另一条路线尝试解决视频风格迁移的问题,而且不需要专门训练一个全新的视频模型。
Rerender-A-Video 使用光流(optical flow)以及跨帧约束,让不同帧之间的信息能够相互传播;TokenFlow 则采用了另一种思路,根据不同帧之间的对应关系传播扩散模型的特征。
这两种方法都利用了原始视频中的信息来避免每一帧被完全独立地重新生成,同时也不需要额外训练或微调模型。
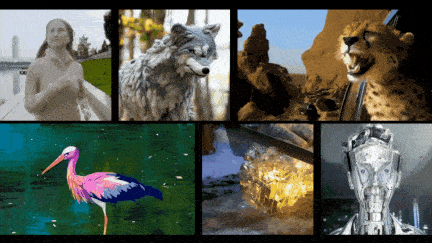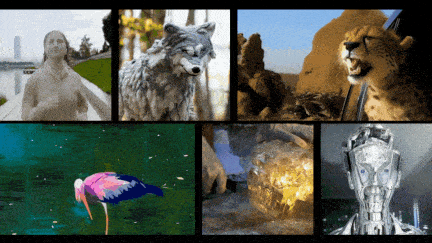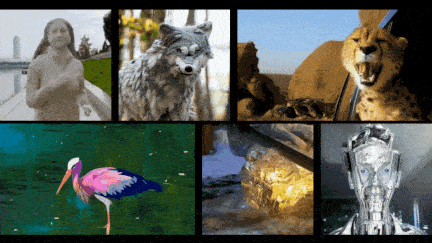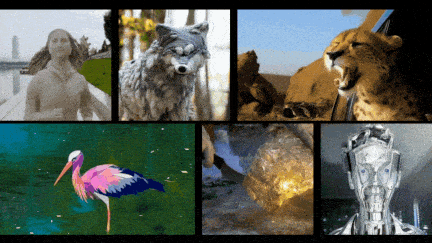 ( LDM视频示例,GIF 分辨率和质量有所降低 )
与简单地逐帧运行图像扩散模型相比,这些方法可以显著提升视频重绘过程中的时间一致性。
但它们仍然依赖一个关键前提:必须在不同帧之间建立可靠的对应关系。
而现实中的视频并不总是这么简单。
当出现遮挡、快速运动、新区域逐渐进入画面,或者两个区域本身就很难判断是否对应时,这种帧间对应关系就可能失效,并进一步产生各种视觉伪影。
现代 AI 视频生成的一致性是怎么实现的?
真正的转折点来自一个非常重要的变化:
不再把视频看成一连串独立的图片,而是直接把视频作为一个时空(spatiotemporal)对象进行建模。
这一思路带来了视频生成质量上的巨大飞跃。
Sora 的出现就是其中一个重要代表。它将视频表示为统一的时空潜空间(spatiotemporal latent),然后对整个视频进行统一的去噪,而不是把每一帧单独生成。
这一类新一代模型大致遵循类似的流程。
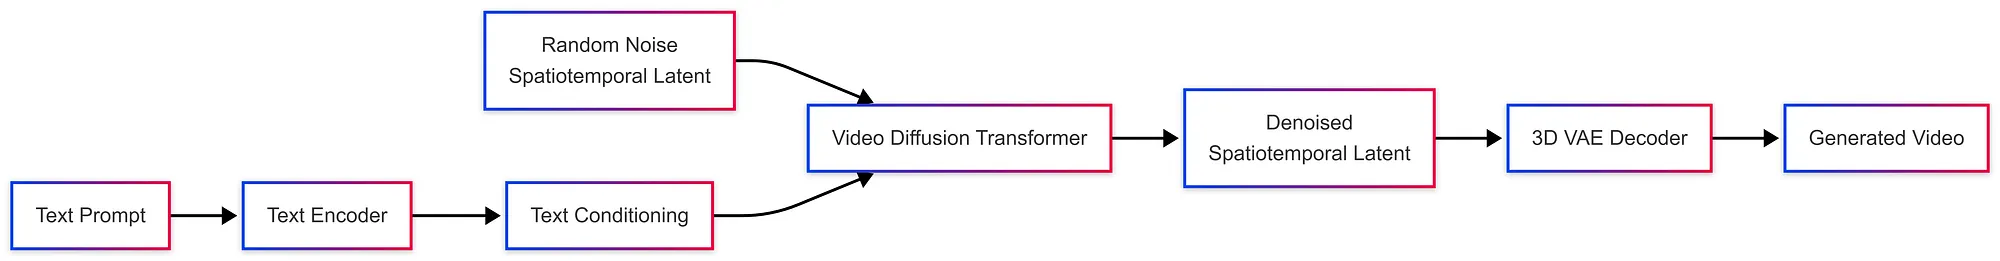 (SOTA 模型中典型的原生视频到视频生成流程)
在这些更新的架构中,一个具有因果性的 3D VAE 会同时在空间和时间两个维度上对视频进行压缩与解码,从而得到一个时空潜表示。
这样一来,时间信息就能够直接保存在 latent representation 中,而不再只是依赖像素层面的跨帧处理。
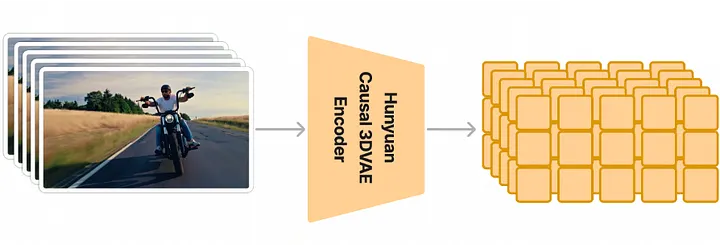 (混源视频模型中的时空补丁)
接下来,这些 latent 会被进一步切分成所谓的“时空块(spacetime patches)”。
可以把它理解成视频版本的 Vision Transformer:Vision Transformer 会把一张图片切分成许多 image patches,而这里的 token 则同时覆盖一小块空间区域和一小段时间。
这些 token 随后会被送入 Diffusion Transformer,也就是 DiT。
DiT 会对整个 token 序列执行全局 self-attention,这意味着视频中的任意一个 token 都可以关注到片段中其他位置的 token,而不只是几帧之外、相同空间位置上的内容。
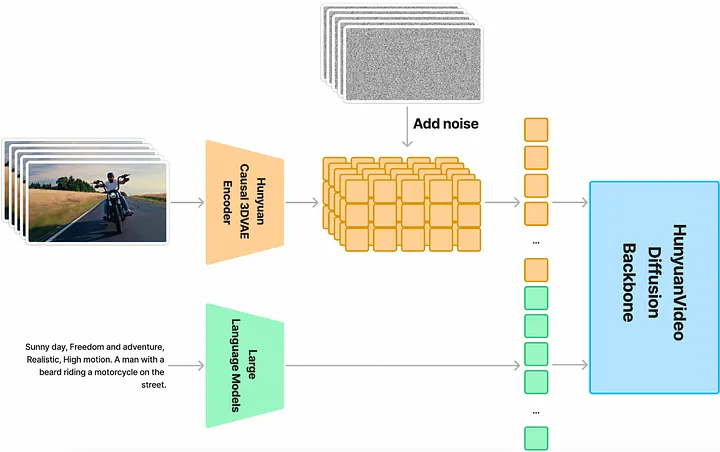 (DiT在视频模型中的应用)
使用这种 Diffusion Transformer 架构之后,一个非常重要的变化是:
模型在生成第 40 帧人物的手时,可以在同一次 attention 操作中,直接关注第 5 帧和第 90 帧中对应的手部信息。
换句话说,模型不再只是“记得上一帧长什么样”,而是在同一个统一的时空表示中理解整个视频。
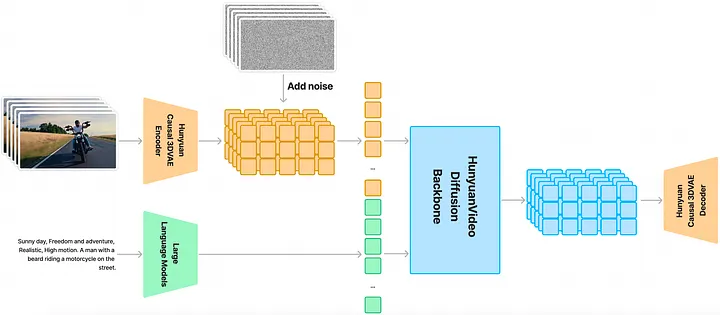 (混源视频模型完整架构)
最后,Diffusion Transformer 输出的结果会经过解码,还原成最终视频。
此时,时间一致性已经不再是生成完成之后额外施加的一层约束,而是直接成为模型生成过程的一部分。
为了进一步理解这种新一代 AI 视频生成范式,我们可以来看一个非常典型的案例:阿里云的 万象 模型家族。
案例:Wan 2.1 与 Wan 2.2
 ( 万象生成的视频示例 )
如果你想深入理解新一代视频生成模型是如何工作的,Wan 模型家族是一个非常合适的研究对象。
阿里云不仅公开了完整模型权重,还发布了详细的技术报告。
下面就是 Wan 2.1 的整体架构。
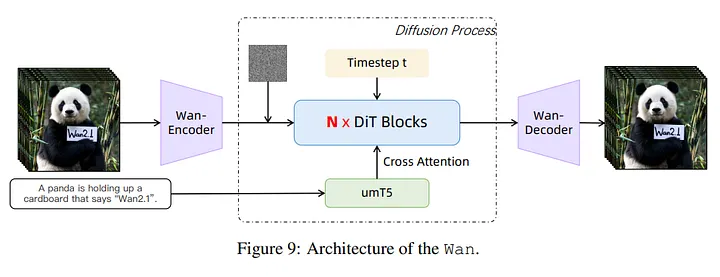 (万象视频生成架构图)
VAE
架构中第一个值得关注的组件,是 Wan 的编码器/解码器,也就是一个时空变分自编码器(Spatio-Temporal Variational Autoencoder)。
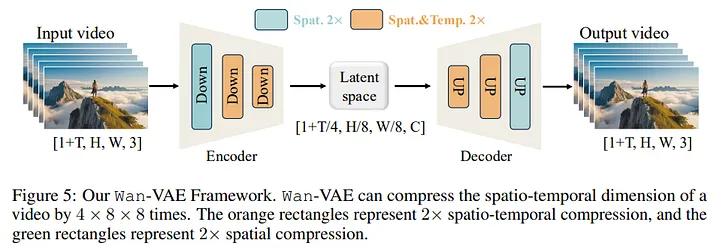 (万象论文中的 VAE 架构)
Wan-VAE 是一个相对较小的因果 3D VAE,大约拥有 1.27 亿参数。
和其他 VAE 一样,它的主要作用是把输入数据压缩成更低维的 latent representation。
具体来说,它会在时间维度上进行 4 倍压缩,在空间维度上进行 64 倍压缩,也就是将视频的高度和宽度分别压缩 8 倍。
Wan-VAE 被设计成 causal,也就是因果式的。
这意味着,时空表示中的每一个 latent slice,只依赖当前帧和之前的帧,而不会依赖未来帧。
这样设计的一个重要好处是,模型可以缓存最近的特征,从而对任意长度的视频进行流式编码和解码,而不需要每次都从头重新处理整个视频。
为了保证这一因果特性,Wan-VAE 使用 RMSNorm 替代了 GroupNorm,因为 GroupNorm 所依赖的跨 batch 统计信息可能破坏这种因果关系。
Transformer
经过 Wan-VAE 编码之后,接下来就是 Diffusion Transformer。
这一部分主要由三个组件组成:
- Patchifying 模块
- Transformer Blocks
- Unpatchifying 模块
首先,latent 会通过一个尺寸为 (1,2,2) 的 kernel 进行 patchify,将其转换成一系列 token。
随后,这些 token 会进入 Transformer Blocks。
在这里,模型会执行时空 self-attention,同时通过 cross-attention 与文本 embedding 建立联系。
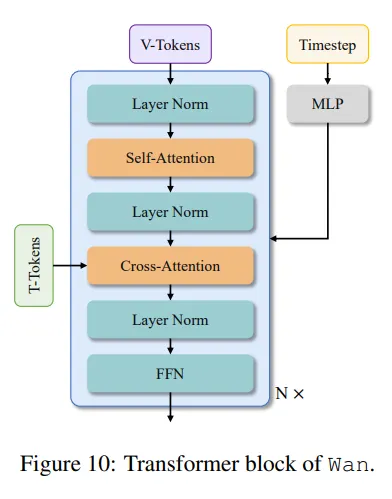
这里还有一个值得注意的细节:Wan 所使用的文本编码模型。
Wan 使用的是 uMT5 来进行文本编码。
uMT5 属于 T5 系列模型,因此它是双向(bidirectional)的,这一点与如今大家更熟悉的因果式 decoder-only LLM 有明显区别。
为什么这很重要?
因为这里的文本编码器并不是负责“生成文本”。
它真正的任务是理解完整的提示词,并将其转换成一个丰富的语义表示,再提供给扩散模型作为生成条件。
之后,模型采用 **Flow Matching(流匹配)**进行训练。
与传统 Diffusion 模型学习如何预测并去除添加到视频中的噪声不同,Flow Matching 学习的是:如何让一个带噪的表示逐渐向原始视频靠拢。
模型在每一个步骤中预测这个移动的方向和速度,从而逐步将噪声表示转换成目标视频。
Wan 2.2 中的 MoE
Wan 2.2 进一步对去噪过程进行了拆分。
它并不是根据输入内容来动态选择专家模型,而是直接根据整个去噪轨迹,将过程交给两个不同的专家模型:
高噪声专家负责早期步骤,此时模型主要确定整体布局和粗粒度运动。
低噪声专家负责后期步骤,此时模型主要对纹理、细节等内容进行精细化处理。
两者之间通过一个信噪比(Signal-to-Noise Ratio,SNR)阈值决定何时进行切换。
每个专家大约拥有 14B 参数,总参数量约为 27B。
但由于每个步骤只激活其中一个专家,因此实际推理成本仍然接近一个 14B 的 dense 模型,同时整体模型容量却可以接近翻倍。
使用 VACE 真正进行视频风格重绘
现在的新一代视频生成模型,例如 Wan,主要还是用于 Text-to-Video 和 Image-to-Video。
但如果回到我最初的需求——视频风格重绘(video restyling)——那么只讨论 Text-to-Video 或 Image-to-Video 显然还不够。
虽然不同模型在具体实现方式上有所差异,但整体思路已经比较接近。
继续以 Wan 模型家族为例。
阿里团队在 2025 年推出了 VACE,全称是 Video tasks within an All-in-one framework for Creation and Editing。
它构建在 Wan 之上,是一个面向视频创作与编辑的一体化框架,可以支持视频风格重绘、视频修复(inpainting)、姿态或深度引导编辑,以及基于参考内容的风格迁移等任务。
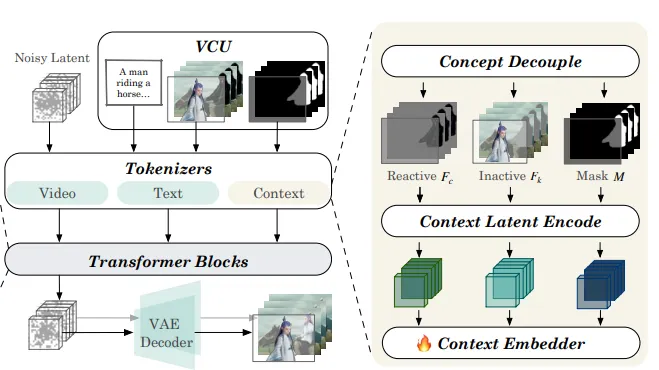
VACE 会把输入文本、源视频以及 mask 统一组织成一个 Video Condition Unit。
在进入 VAE 之前,也就是 Tokenization 阶段,模型会利用 mask 执行一个叫作 concept decoupling 的步骤,将源视频拆分成两组不同的序列:
**Reactive frames:**包含需要重新生成的区域。
**Inactive frames:**包含需要保留的区域。
随后,这两部分都会通过 Wan-VAE 被编码到与 noisy generation tokens 相同的 latent 空间中。
换句话说,模型能够根据 mask 明确知道哪些区域需要重新生成、哪些区域需要尽可能保留,而不是像 Deforum 那样,仅仅依赖一个 denoising strength 滑杆去不断寻找一个合适的平衡点。
如果你还记得前面的内容,这恰恰是 Deforum 当年最难解决的问题之一。
从这里开始,VACE 提供了两种训练方式:
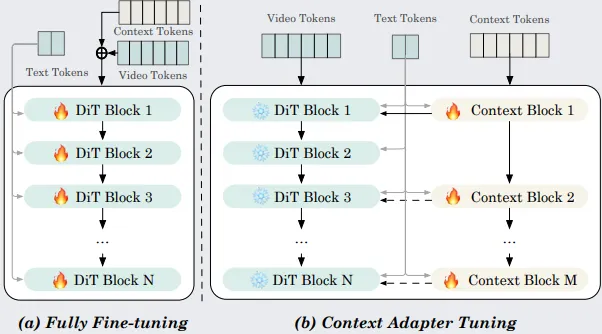
**Full Fine-tuning:**将 context tokens 直接与 noisy tokens 拼接起来,然后对整个模型进行重新训练。
**Context Adapter Tuning:**一种更加轻量的方式。它使用一组并行的 Context Blocks 来处理条件信息,再将处理后的结果重新注入一个基本保持冻结的基础 DiT 模型中。
Context Adapter Tuning 的思路与图像领域的 ControlNet 有一定相似之处,但这里针对的是原生视频 Transformer 架构。
最后
短短三年左右,**AI 视频生成**已经取得了巨大的进步。
本文只是以其中一种架构为例进行介绍,而实际上,还有许多其他模型也取得了类似、甚至更进一步的成果。
如今,Seedance 2.0、MiniMax H3、Luma Ray3.2 等模型都已经展现出了非常强的能力,而且它们解决的问题早已不只是时间一致性。
它们正在逐渐做到:
- 在不同镜头之间保持角色身份一致;
- 理解并执行更加复杂的指令;
- 保留参考图片和参考视频的结构;
- 处理多个主体以及主体之间的互动;
- 在更长的视频序列中生成越来越连贯的运动。
AI 视频生成最初要解决的问题,只是如何让连续帧看起来不像是被完全独立地生成出来的。
而今天,我们正在进入一个完全不同的阶段:
模型不再只是生成一帧又一帧的画面,而是在学习理解一个完整的视觉场景,以及这个场景如何随着时间展开和变化。