接口对不上还硬改?适配器模式当翻译层
关键词:设计模式、结构型模式、适配器模式、Python、大模型工程
目录
- 一、新组件说另一种方言,你的代码怎么办?
- 二、适配器模式:在中间加一层「翻译」
- 三、Python 的鸭子类型,让适配器还能更轻?
- 四、对象适配器还是类适配器?组合优先
- 五、大模型工程里,适配器为什么到处都是?
- 六、三条记住就行
一、新组件说另一种方言,你的代码怎么办?
你辛辛苦苦把一套系统搭在干净接口之上:业务代码只管调用 analyze(text),拿回一个情感分析结果。某天需求来了——团队想试一家新厂商的模型,或者要接入三年前写的那个遗留打分模块。麻烦在于,新来的这位说的是另一种方言:一个返回 {"choices":[{"message":{"content":…}}]},另一个只认 infer(prompt),回的是 {"completion":…}。两边都不能改:一个是第三方 SDK,一个是没人敢动的旧代码。
最直接的反应,是在业务里散一堆分支:if vendor == 'A' … elif vendor == 'B' …。两家勉强撑得住,到第五家就崩了,而且每接一个新后端,核心代码都得再改一遍。更隐蔽的代价在测试上:因为核心逻辑里直接揉了厂商调用,你想给核心写单测,要么真联网打厂商接口,要么把那一坨分支整个 mock 掉——结果测的不是业务逻辑,是分支本身。
这种「让核心去学新方言」的写法,问题不在当下能跑,而在它把「具体厂商」和「业务决策」焊死在了一起。供应商从两家变五家时,每一次新增都是一次对核心的侵入式修改,而侵入式修改又是 bug 最喜欢的温床。更干净的做法是反过来:别让核心去学新方言,而是在中间塞一个翻译。这个翻译,就是适配器模式(Adapter)。
适配器属于 GoF 的结构型模式,定义很朴素:把一个类的接口,转换成客户期望的另一个接口,让本来因为接口对不上而没法合作的类,能一起干活。注意关键词是「转换接口」而不是「改接口」——被适配的那一方原样不动,动的是中间这层。把这句记牢,后面所有判断都不会偏:适配器是保护双方、只改中间层的模式,不是去动任何一方的内部实现。
一个很实用的判断标准:当你想「改一改被适配者让它适配我」时,先问它能不能改。第三方 SDK 改了下次升级就被覆盖,遗留模块改了没人敢签字发布——这两类从源头就排除了「改源码」这条路,适配器几乎是唯一干净的选项。反过来,如果那个不兼容的接口是你自己两周前写的,与其在外面套适配器,不如直接把接口改顺,适配器反而成了多余的间接层。所以适配器不是「接口不对就无脑套」,而是「不能改、又必须接」时的那条缝。
还有个容易忽略的视角:分支式接入让核心同时背负「业务规则」和「厂商差异」两件事,开发者每次读核心代码都得在脑子里切换上下文。适配器把「厂商差异」单独抽走之后,核心终于只剩业务规则,可读性和可测性一起回来。界面名义上接上了,心智模型却更乱了——这正是该用适配器而不是硬改的信号。
举个最小化的反例:核心里写 if model == 'gpt': client = OpenAI(…) elif model == 'claude': client = Anthropic(…) elif model == 'local': client = Ollama(…),然后后面每一处调用都带同样的判断。三家看着还行,加到第八家时,这段判断已经散在十几个函数里,改一家要翻遍全仓库。适配器把这段「判断 + 转换」收进一个类,核心永远只写 provider.generate_completion(…),换厂商只是换掉那个类,核心里一个 if 都不用留。
二、适配器模式:在中间加一层「翻译」
适配器模式把职责拆成四个角色,各管一摊:
- Target(目标接口):客户端期望的契约,比如「要会 quack 和 fly」。它是客户说出来的「我想要的样子」,由适配器去实现。
- Adaptee(被适配者):已有但接口不兼容的类,比如一只只会 gobble 和短途飞的火鸡。它是被保护的对象,原则上不该为别人改自己。
- Adapter(适配器):实现 Target,内部持有 Adaptee 的引用,把 Target 的调用翻译成 Adaptee 能懂的调用。它是一层纯粹的「翻译」,不新增业务语义。
- Client(客户端):只认 Target 接口,从头到尾不认识 Adaptee。
(图一:适配器的四个角色——客户端只认接口,适配器专职翻译,被适配者保持原样不被污染)
最经典的例子是「让火鸡伪装成鸭子」。鸭子接口要求 quack() 和 fly(),火鸡只有 gobble(n) 和 fly_to()(而且飞不远)。适配器把 quack() 转成火鸡的 gobble(3),把 fly() 转成连飞五次来凑鸭子一趟的距离:
class Duck:
def quack(self):
return "Quack!"
def fly(self):
return "I'm flying!"
class Turkey:
def gobble(self, n):
return "gobble " * n
def fly_to(self):
return "I'm flying a short distance"
class TurkeyAdapter:
# 实现 Duck 接口,但内部把调用翻译给 Turkey
def __init__(self, turkey):
self.turkey = turkey
def quack(self):
return self.turkey.gobble(3).strip() + " (适配器把咯咯叫翻译成了呱呱叫)"
def fly(self):
trips = [self.turkey.fly_to() for _ in range(5)]
return " / ".join(trips) + " (火鸡飞不远,适配器连飞5次凑够鸭子一趟的距离)"
def client_use(duck):
# 客户端只认 Duck 接口,不关心背后是鸭还是火鸡
print("quack ->", duck.quack())
print("fly ->", duck.fly())
client_use(Duck()) # 真鸭子
client_use(TurkeyAdapter(Turkey())) # 火鸡套上适配器
跑出来的输出,两端走的是同一个 client_use,但行为被翻译到位了:
真鸭子:
quack -> Quack!
fly -> I'm flying!
火鸡套上适配器后:
quack -> gobble gobble gobble (适配器把咯咯叫翻译成了呱呱叫)
fly -> I'm flying a short distance / … (连飞5次凑够鸭子一趟的距离)
适配器真正的价值在这里显形:被适配的 Turkey 一行没改,客户端的 client_use 一行没改,唯一的改动点是新增了一个「翻译层」。将来再要接入一只企鹅、一只蝙蝠,都只是再写一个适配器,核心代码永远不动。
容易和它搞混的两个模式顺带分清:装饰器(Decorator)是给同一个接口「加职责」,接口本身不变,比如给一个 Quack 套上「带回声的 Quack」;门面(Facade)是给一堆复杂子系统一个「简化入口」,接口不一定是被迫转换,而是主动收敛复杂度。适配器不一样——它是被迫的,因为两边接口已经对不上、又都不能改,才需要在中间翻译。分辨它们只看一点:有没有「把 A 的接口翻译成 B 期望的接口」这层被迫的转换,有才是适配器。
顺带把「翻译」这件事拆开看,它通常包含三件小事:方法名映射(把 gobble 当 quack 用)、参数重整(火鸡一次飞不远,适配器就循环五次凑距离)、返回值重整(把 {"completion": …} 抽成纯文本)。适配器里最容易被忽略的是第三件——被适配者返回的结构往往比你要的「胖」,翻译不仅是换名字,还要把多余字段剥掉、把缺的字段补上。拿火鸡那例说,客户端要的是「叫一声 + 飞一趟」两个干净动作,适配器负责把火鸡「咯咯叫 N 次 + 短途飞五次」这种原始动作,翻译成客户端无感的统一行为。写适配器时最值得花心思的,就是这层返回值的归一化,它直接决定上游能不能真的「无感」。
还有一层更深的判断:适配器擅长翻译「形状」(方法名、参数个数、返回结构),不擅长翻译「语义」。如果两边的接口不只是长得不一样,而是根本表达不同的事——比如一边要「同步阻塞调用」,另一边只有「异步流式返回」——硬套适配器会把语义强行抹平,调用方迟早踩坑。这种时候该谈的是协议升级或接口重新设计,而不是加一层翻译。适配器解决的是「说同一种事但方言不同」,不是「根本不是一回事」。
顺带澄清一个常见误用:有人把「为了测试而抽的接口」也当成适配器,其实那叫「依赖倒置」,适配器是依赖倒置之后、用来填两边接口落差的那个具体实现。先有「核心只依赖抽象」的设计,才有「用适配器接具体实现」的落点;反过来一上来就堆适配器、核心却直接依赖具体类,适配器几乎从不需要。
当然,适配器也不是多多益善。一个常见反模式是给「自己完全掌控、且只有一个调用点」的类也套一层适配器,理由是「万一以后要换呢」。这种「防御性间接层」在没发生之前只是噪音:它没解决任何当前的不兼容,还多了一次跳转让人读代码多绕一道。判断该不该写,回到最朴素的准绳——现在就有「不能改又对不上」的双方吗?有才写,没有就先直连。
三、Python 的鸭子类型,让适配器还能更轻?
到了 Python 这儿,适配器有了一个别的语言给不了的小特权:鸭子类型。所谓鸭子类型,就是「只要走路像鸭子、叫起来像鸭子,那就当它是鸭子」——解释器不在乎一个对象是不是真的继承了某个 Target 基类,只在乎它有没有那个方法。
这意味着,很多时候你根本不需要先定义一个正式的 Target 接口,适配器只要「长得像」客户端期望的样子就行。下面两个类没有任何共同父类,但因为都有 get_products(),客户端就能一视同仁地遍历它们:
class SupermarketOne:
def get_products(self):
return {"apples": 0.2, "oranges": 0.3}
class SupermarketTwo:
def get_fruit(self):
return [("apples", 0.19)]
def get_meat(self):
return [("lamb", 6.17)]
class SupermarketTwoAdapter:
# 没有继承任何 Target,只是凑齐了 get_products 这个方法
def __init__(self, s2):
self.s2 = s2
def get_products(self):
return dict(self.s2.get_fruit() + self.s2.get_meat())
def shop(source):
return "%s -> %s" % (type(source).__name__, source.get_products())
for s in [SupermarketOne(), SupermarketTwoAdapter(SupermarketTwo())]:
print(shop(s))
输出很直白:
SupermarketOne -> {'apples': 0.2, 'oranges': 0.3}
SupermarketTwoAdapter -> {'apples': 0.19, 'lamb': 6.17}
两个类没有共同父类,但因都有 get_products(),客户端一视同仁。这就是鸭子类型给适配器减的「重量」:你省掉了先声明接口、再让人去 implements 的那套仪式。写个内部脚本接两个数据源,这种写法又快又省心。
不过轻归轻,别走极端,鸭子类型也有暗坑。两个八竿子打不着的类,可能恰好都叫 save(),但一个把数据落盘、一个把 ORM 改动刷进数据库——名字一样,副作用天差地别。如果你只靠鸭子类型把它们塞进同一个列表循环调用 save(),文件确实写了、事务却悄悄提交了,这种 bug 不报错、只在生产环境偶发。举个具体的:FileStore.save() 是序列化落盘,Session.save() 是提交事务,调用方若只看方法名就当成同类,埋下的就是静默故障。所以「方法名凑齐就当成同类」在边界处要格外小心,这正是 ABC / Protocol 存在的意义:把「长得像」升级成「契约上确实是一类」。
更现代一点,Python 的 typing.Protocol 给了第三条路:结构化子类型。你用 Protocol 描述「要有 get_products 这个方法」,既保留了鸭子类型「不用显式继承」的轻,又能在静态检查阶段就发现「某个类其实没凑齐方法」。它的好处是「结构性子类型」——只要类长这样就算实现,不用改类的继承树去强行认祖归宗。结论很实用:快速原型、内部脚本,鸭子类型让适配器零负担;要进长期维护的库或团队代码,用 ABC 或 Protocol 把接口钉住,既保留适配器的灵活,又给后来人一张地图。
用法长这样:你声明 class ProductSource(Protocol): def get_products(self) -> dict: …,然后 SupermarketOne 即便不继承它,只要方法有同样的签名,静态检查器就认它是 ProductSource。比起硬继承 ABC,Protocol 不污染类的继承树,特别适合给第三方类「补一张契约」——你改不了人家的类,又想给它贴个接口标签,Protocol 正好补上这块。
四、对象适配器还是类适配器?组合优先
GoF 其实给了适配器两种写法,差别只在「适配器怎么够到被适配者」:
- 对象适配器:靠组合,适配器内部持有一个 Adaptee 实例,委托它干活。
- 类适配器:靠多继承,适配器同时继承 Target 和 Adaptee,直接调用父类方法。
下面这段把两种都写出来了,Python 的多继承让类适配器也能成立:
class Target:
def request(self):
raise NotImplementedError
class Adaptee:
def specific_request(self):
return "Adaptee 的特定能力"
class ObjectAdapter(Target):
# 对象适配器:组合
def __init__(self, adaptee):
self.adaptee = adaptee
def request(self):
return "组合转发 -> " + self.adaptee.specific_request()
class ClassAdapter(Target, Adaptee):
# 类适配器:多继承
def request(self):
return "继承直调 -> " + self.specific_request()
print(ObjectAdapter(Adaptee()).request()) # 组合转发 -> Adaptee 的特定能力
print(ClassAdapter().request()) # 继承直调 -> Adaptee 的特定能力
两者都能跑出结果,但取舍很清楚:
(图二:对象适配器靠组合、类适配器靠多继承,选型的天平明显倾向组合)
对象适配器胜在灵活:一个适配器能同时适配 Adaptee 及其所有子类,测试时把 Adaptee 换成 mock 也毫无压力。类适配器在编译期就绑死在某个具体 Adaptee 上,换子类就废了——假如后来 Adaptee 出了个 SpecialAdaptee 子类,你得再写一个 SpecialClassAdapter,而对象适配器只要把 SpecialAdaptee 实例传进去就完了。
补充一个工程视角:对象适配器还顺带解决了「适配 Adaptee 全家」的问题。因为组合持有的是 Adaptee 类型的引用,传进去一个子类实例也能正常工作,适配器本身一行不用改;而类适配器因为继承关系在类定义时就焊死,遇到子类只能新写一份。项目里被适配的对象一旦有继承体系,组合的优势会被进一步放大。
还有个跨语言的事实:在 Java、C# 这类没有多继承的语言里,类适配器压根不是可选项,组合是唯一路径。这也解释了为什么 GoF 虽列出两种,工业界却几乎一边倒地用对象适配器——不是因为类适配器「错」,而是它的收益(能覆写 Adaptee)在大多数场景里抵不过它的代价(绑死具体类、无法覆盖子类、不可测)。所以默认答案永远是对象适配器;只有当你确实需要覆写 Adaptee 内部行为、又确定不会换子类时,才值得为多继承那份耦合买单。把这条当成肌肉记忆,选型时基本不会错。
五、大模型工程里,适配器为什么到处都是?
讲到这,你大概已经发现:适配器在大模型工程里根本不是「偶尔用用」的偏门技巧,而是把一堆接口各异的模型和服务接进统一业务的家常手段。它在大模型开发里的位置很明确——你是写应用的人,真正要对接的模型、向量库、检索源天天在换,适配器就是那层让你「换底层不换上层」的缓冲。它和「门面」「代理」这些结构型模式常被一起提起,但在大模型工程里它的出场频率最高,原因很直白:这一行技术迭代太快,模型、向量库、检索后端半年一换,而你的业务需求没那么爱变。凡是「变的比不变的多」的接缝,都该用适配器护住不变的那一侧。
场景一:统一多家模型 Provider 接口。 这是最典型的一处。OpenAI、Anthropic、本地 Ollama、各家兼容网关,调用方式和返回结构全不一样:有的用 choices[0].message.content,有的用 completion,入参一个叫 messages 一个叫 prompt,连抛错类型都不同。正确做法是抽一个 BaseAIProvider 接口,每个厂商写一个适配器把各自 SDK 归一化。下面的代码能直接跑,背后是两套不同形状的假客户端:
from abc import ABC, abstractmethod
class BaseAIProvider(ABC):
@abstractmethod
def generate_completion(self, messages): ...
@abstractmethod
def get_model_info(self): ...
class _MockOpenAIClient:
def create(self, messages):
return {"choices": [{"message": {"content": "OpenAI 兼容接口的回复"}}]}
class OpenAICompatibleAdapter(BaseAIProvider):
def __init__(self, client): self.client = client
def generate_completion(self, messages):
# 内部是 choices[].message.content 形状,对外只给纯文本
return self.client.create(messages)["choices"][0]["message"]["content"]
def get_model_info(self): return {"provider": "openai-compatible"}
class _MockLocalClient:
def infer(self, prompt):
return {"completion": "本地模型接口的回复", "meta": {"tok": 12}}
class LocalModelAdapter(BaseAIProvider):
def __init__(self, client): self.client = client
def generate_completion(self, messages):
# 内部是 completion 形状,入参也叫 prompt
return self.client.infer(messages[–1]["content"])["completion"]
def get_model_info(self): return {"provider": "local"}
def app_call(provider, msg):
# 业务核心只认 BaseAIProvider,不关心背后是谁
return provider.generate_completion(msg)
msg = [{"role": "user", "content": "hi"}]
print(app_call(OpenAICompatibleAdapter(_MockOpenAIClient()), msg))
print(app_call(LocalModelAdapter(_MockLocalClient()), msg))
输出证实:两次业务调用接口完全一致,背后却是两套不同形状的 SDK。统一的红利不止「换模型不动核心」这一条——路由和兜底也能建在同一层上:便宜模型打头阵,出错再 fallback 到更稳的模型,这套逻辑只跟 BaseAIProvider 打交道,跟具体厂商无关;各家 SDK 抛的不同异常,也在适配器里归一化成同一个错误类型,业务侧一把 try 兜住,而不是在每个调用点写不同的异常分支。举个具体的:OpenAI 的 SDK 抛 openai.APIError,本地模型框架可能抛自己的 RuntimeError,业务侧若直接 except 这两类,等于又把厂商差异吸回核心。在适配器里统一成 ProviderError,核心只 except ProviderError 一处兜底,厂商再怎么换异常类型都不用动上层。值得记一笔的是:现在国内外大量厂商都提供 OpenAI 兼容协议,很多时候你改个 Base URL 和 Key 就行,连适配器都不用写。
这套思路不是凭空来的。主流的 Code Agent 在做多模型接入时,普遍把「OpenAI 兼容协议」当成默认接口:只要厂商提供兼容网关,改个 Base URL 和 Key 就能接,根本不必写适配器;只有那些形态特殊的自研后端,才需要单独写一个适配器。换句话说,行业的事实标准是「尽量让被适配者说同一种方言,实在不行再写翻译」——适配器是兜底,不是第一选择。认清这一点,你才不会因为「听说适配器好」就到处套,而是只在异构兜底处下手。
场景二:把 LLM 当作可替换的「基础设施」。 在六边形架构里,领域层定义端口(接口),具体实现是适配器。比如把「文本情感分析」定义成一个 port,OpenAI 的实现是一个适配器,某天想换成传统机器学习模型甚至写死规则,领域层完全无感:
from abc import ABC, abstractmethod
class TextAnalyzer(ABC): # 领域端口:业务只认这个
@abstractmethod
def analyze(self, text: str) –> str: ...
class OpenAISentimentAnalyzer(TextAnalyzer): # LLM 适配器
def __init__(self, client): self.client = client
def analyze(self, text: str) –> str:
resp = self.client.chat.completions.create(
model="gpt-4o-mini",
messages=[{"role": "user", "content": f"分析情感:{text}"}])
return resp.choices[0].message.content
class RuleBasedAnalyzer(TextAnalyzer): # 换掉 LLM 也行,领域层无感
def analyze(self, text: str) –> str:
return "正面" if "好" in text else "负面"
把 LLM 当基础设施,意味着你的代码始终掌控流程:拼好提示词、发请求、解析结果,模型只是个被调用的黑盒,没有记忆、没有自主权。一旦哪天发现 LLM 太贵或不稳,用 RuleBasedAnalyzer 这样的非 LLM 适配器顶上,调用方完全无感。反过来,如果你要的是「模型自己决定调哪个工具、走哪条路」,那就超出了适配器的范畴,该上 Agent 编排了——适配器管的是「接口翻译」,不管「行为自治」。这也给选型提了个醒:当你纠结「要不要把这段逻辑抽成适配器」时,先确认被封装的是不是「无自主权的被调用方」。是,适配器正解;如果封装对象要反过来驱动你的流程、自己做决策,那它更像协作者甚至主控方,适配器的边界就不合适了。
场景三:统一向量库接口。 Chroma、Milvus、pgvector 的建库、写入、查询 API 各不相同。在 RAG 链路里,你通常不希望检索逻辑跟具体向量库绑死。用一个 VectorStore 适配器把各家 similarity_search 抹平成统一签名,哪天从本地 Chroma 迁到云端 Milvus,只换适配器,上层检索代码原封不动:
class VectorStore(ABC):
@abstractmethod
def similarity_search(self, query: str, k: int) –> list: ...
class ChromaAdapter(VectorStore):
def __init__(self, client): self.client = client
def similarity_search(self, query, k):
return self.client.query(query, n_results=k)["documents"][0]
class MilvusAdapter(VectorStore):
def __init__(self, client): self.client = client
def similarity_search(self, query, k):
return [hit.entity.get("text") for hit in self.client.search(query, limit=k)]
这一层适配器的回报在迁移时最明显。很多团队早期用本地 Chroma 跑通原型,业务起来后迁到云端 Milvus 扛并发——如果没有 VectorStore 这层适配,所有 client.query(…) 的调用点都得改;有了它,只换一个适配器实例,检索逻辑纹丝不动。把「换底层不换上层」落到代码上,就是这个感觉。更进一步,如果某段时间内要双写两个向量库做灰度,适配器也能让上层无感地同时写两家、只读一家。
场景四:把不同检索源接进同一个 RAG 链。 真实 RAG 往往混合向量检索、BM25 关键词检索、甚至实时网页抓取。每一种都是一套自己的接口。给它们各自包一层 Retriever 适配器,统一成 retrieve(query) -> List[Document],上游的「重排 + 拼提示词」逻辑就能用同一套代码消费所有来源,再做融合排序:
class Retriever(ABC):
@abstractmethod
def retrieve(self, query: str) –> list: ...
class VectorRetriever(Retriever):
def __init__(self, store): self.store = store
def retrieve(self, query): return self.store.similarity_search(query, k=3)
class WebRetriever(Retriever):
def __init__(self, api): self.api = api
def retrieve(self, query): return self.api.search(query)
# 上游融合排序逻辑只认 Retriever 接口,不关心背后是向量还是网页
融合检索(hybrid search)之所以能成立,前提就是所有来源被归一化成了同一个 retrieve 契约。向量负责语义召回、BM25 负责关键词精确命中、网页负责时效性——三者返回格式天差地别,但进了 Retriever 适配器后,上游的重排模块只看到一摞统一的 Document。没有这层翻译,融合排序代码会被三种返回结构撕得支离破碎。
实际项目里,适配器通常不是在调用点随手 new 出来的,而是交给一个工厂或依赖注入容器按配置挑选。比如配置里写 provider: local,启动时工厂就 LocalModelAdapter 一个实例注入给业务;要切到云端,改配置即可,连代码都不用碰。适配器解决「接口翻译」,工厂/注入解决「哪个适配器被装上」,两者配合才是生产里这套模式的完整形态。只写适配器不接管装配,调用点还是会散落 if/elif——那就白忙了。
把这四个场景连起来看,你会发现它们说的是同一件事:在大模型应用里,「会变的那一侧」(模型、向量库、检索源)永远在被适配,「不变的那一侧」(你的业务核心)靠接口稳坐钓鱼台。适配器就是那条让两侧解耦的缝。一个统一适配层的样子长这样:
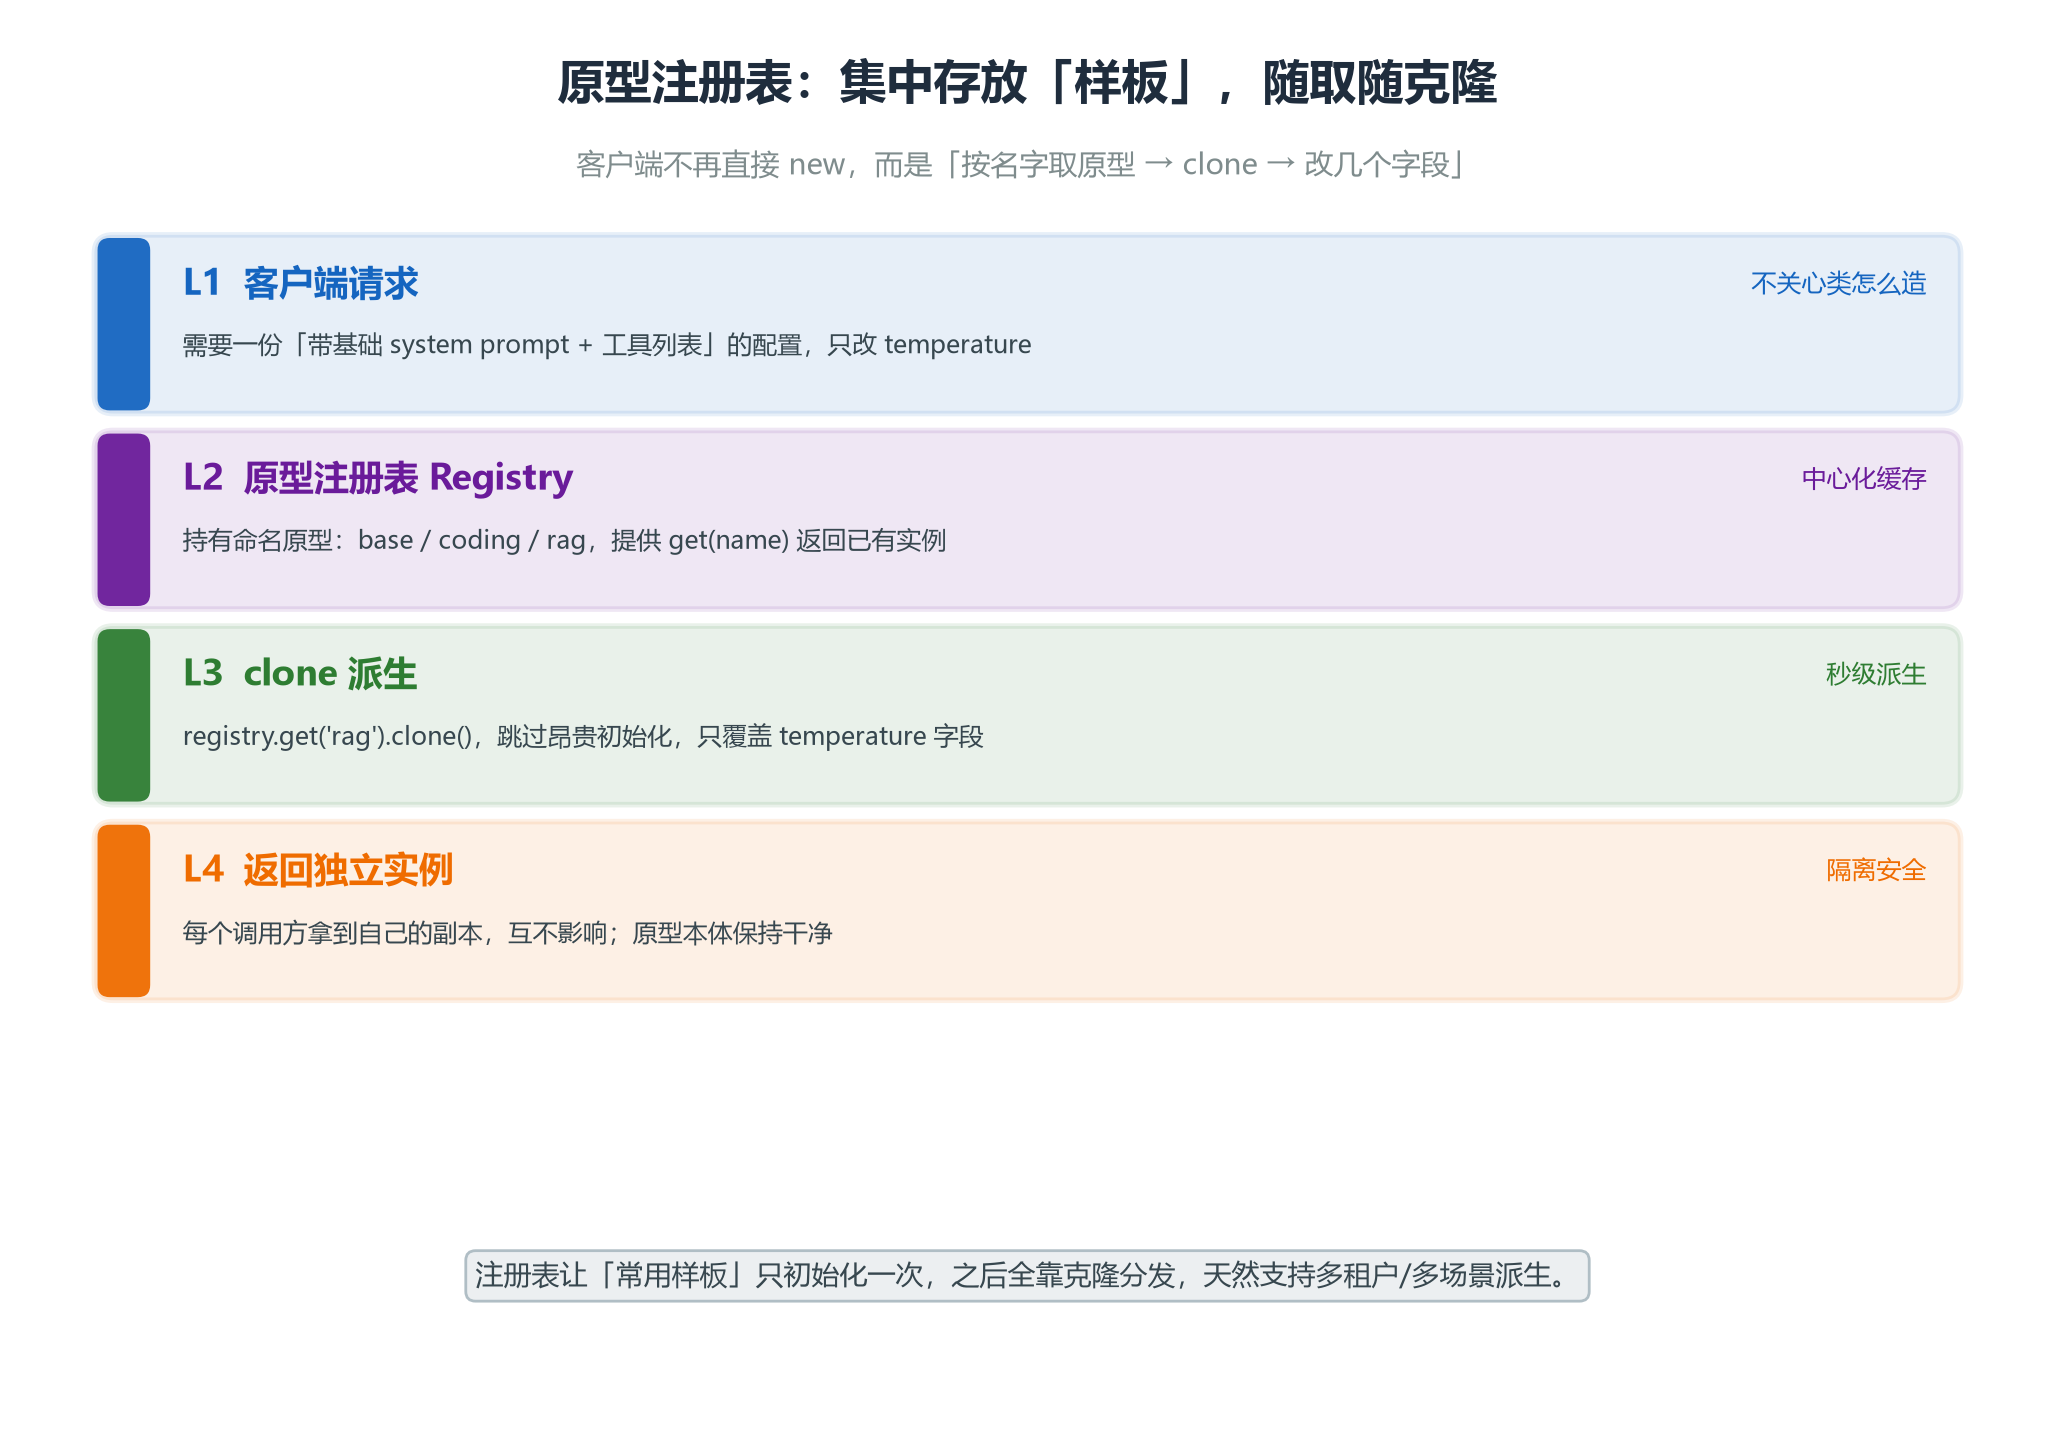
(图三:业务核心只认统一接口,换模型只是换一个适配器实例,核心代码一行不动)
判断到底要不要为某个后端写适配器,看下面这张矩阵比凭感觉靠谱:
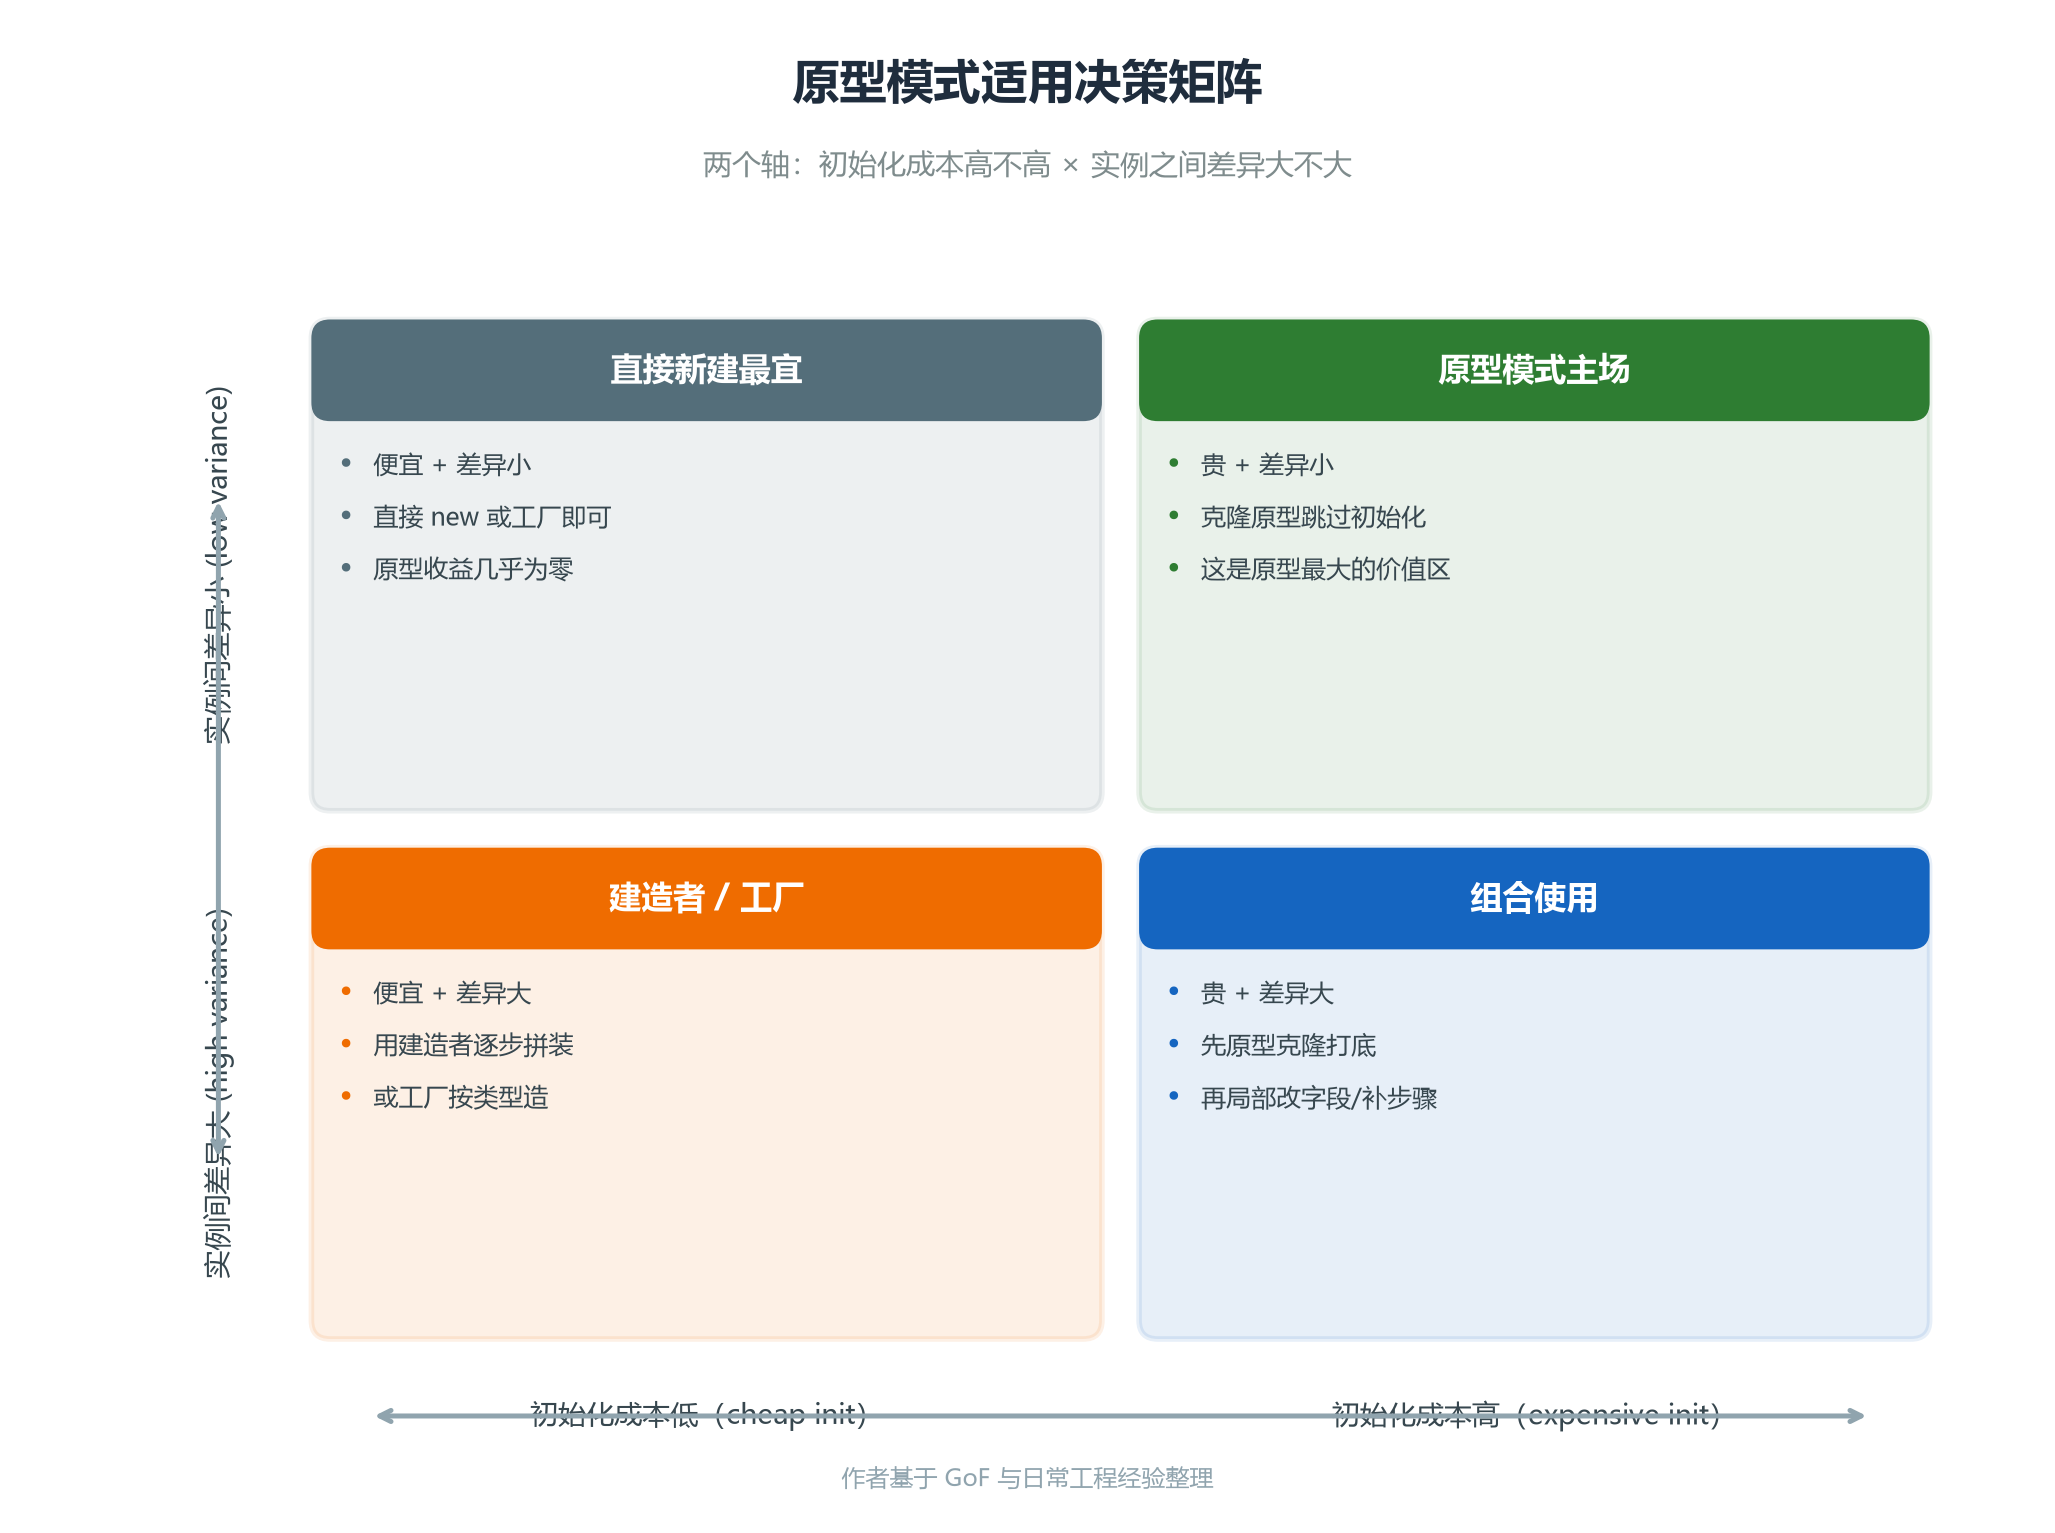
(图四:决策口径——能否改源码 × 是否要对接多个异构实现,两条都偏左上方时适配器收益最大)
一句话收束这四个场景:凡是「接口对不上、又不能改、还可能要接好几个」的地方,就先抽接口、再写适配器;凡是「接口能改、只有一处用到」的地方,直接重构更省事,不必硬套。
最后补一句代价,免得用过头:适配器本身是一层间接,意味着底层 SDK 一旦改接口,你得同步改对应的适配器,翻译层不会自动跟着变——它把「厂商差异」收拢到一个文件,也把「维护点」收拢到同一个文件,这是好事,但别误以为它零成本。更忌讳的是「适配器的适配器」:为了接 A 写了适配器,为了接 B 又在 A 的适配器外再包一层,链路一长,出问题时你根本分不清错在哪一层。一条原则够用:每个被适配的后端只对应一个适配器,翻译只发生一次,上游永远只看到统一接口。
六、三条记住就行
- 适配器转的是接口,不是被适配者的实现。 第三方 SDK 和遗留模块原样保留,所有「翻译」都发生在中间那一层,核心业务和旧代码两边都不用为对方改自己。记住它和装饰器、门面的区别:只有「被迫把 A 接口翻译成 B 期望的接口」才是适配器,加职责是装饰器,收复杂度是门面。也别指望适配器翻译语义差异——只翻译形状,不翻译「根本不是一回事」。
- Python 里优先对象适配器,能用鸭子类型就别先立接口。 快速场景靠「方法凑齐」就能即插即用;要进长期维护的库,再用 ABC 或 typing.Protocol 把契约钉死。类适配器靠多继承,只在必须覆写 Adaptee 行为时才考虑,而且在没有多继承的语言里它根本不存在。对象适配器还能顺带覆盖 Adaptee 的整个子类家族,组合优势在继承体系里会被放大。
- 大模型工程里,适配器是换底层不换上层的缓冲。 统一多模型 Provider、向量库、RAG 检索源时,先抽接口、再写适配器;凡是不兼容又必须接的异构后端,都是它的主场。路由、兜底、错误归一化也都能建在这层之上,而不是散进业务核心。这层缓冲越厚,你切换底层、接入新厂商的成本就越低,业务核心也越经得起模型圈的快速迭代。