秋叶aaakiComfyUI整合包ComfyUI 2026年8月整合包 v3.2
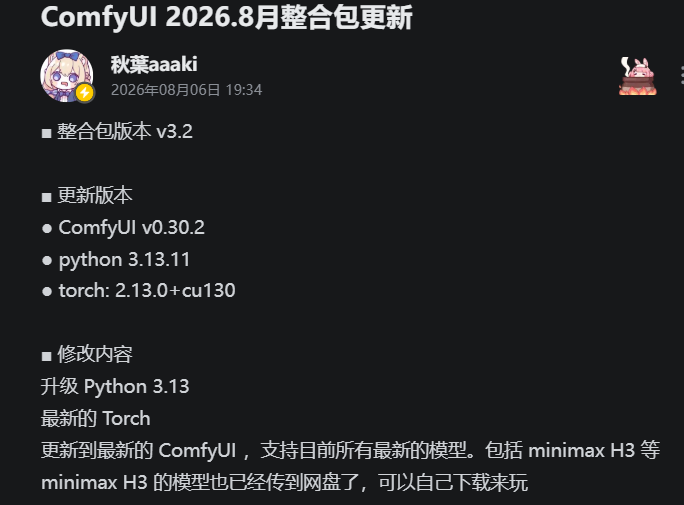
秋叶 ComfyUI 2026 整合包 v3.2 完整部署教程:Python 3.13 + Torch 2.13 全栈升级
引言
秋叶大佬 2026 年 8 月发布了 ComfyUI 整合包 v3.2,这是目前国内适配性最优、稳定性最强的商用/学习级版本。这次升级不是简单的版本号跳动,而是底层依赖栈的全面重构——Python 升到 3.13.11,Torch 升到 2.13.0+cu130,ComfyUI 同步到 v0.30.2,原生支持 2026 年所有主流新模型,包括 MiniMax H3、Wan 2.2、Qwen-Image-2.1 等。
一句话总结:解压即用,无需配置环境,新模型开箱就能跑。
一、v3.2 核心更新内容
|
组件 |
旧版本(3.0) |
v3.2 版本 |
升级意义 |
|
ComfyUI |
v0.29.x |
v0.30.2 |
原生支持所有 2026 年新模型架构 |
|
Python |
3.12.x |
3.13.11 |
性能提升,部分节点兼容性更强 |
|
PyTorch |
2.0+cu126 |
2.13.0+cu130 |
CUDA 13.0 支持,新显卡性能释放更充分 |
节点调整:精简了停止更新、老旧冗余的节点,增补了视频生成类专用节点,扩展了图像和视频创作能力。
二、下载与安装
下载地址
网盘(永久有效):秋叶 ComfyUI 2026 整合包 分享
安装步骤
- ✅ 正确示例:D:\\AI_Tools\\ComfyUI-AKI
- ❌ 错误示例:D:\\AI工具\\ComfyUI新版、C:\\Program Files\\ComfyUI-AKI
三、模型配置(必做)
秋叶整合包默认不内置任何 AI 绘画大模型,首次使用前必须手动配置。
方法一:手动安装(推荐新手)
进入 ComfyUI 根目录的 models 文件夹,按类型存放:
|
文件夹 |
存放内容 |
|
checkpoints |
Stable Diffusion 基础大模型 |
|
loras |
LoRA 微调模型 |
|
vae |
VAE 解码模型 |
|
controlnet |
ControlNet 控制模型 |
模型可从 Civitai、LiblibAI 等平台下载。
方法二:共享 WebUI 模型(省空间)
如果你已安装 Stable Diffusion WebUI 且下载了大量模型,可以直接共享,无需重复下载:
注意:WebUI 的配置段是
a111:,不是
comfyui:。路径后
保留一个空格,否则无法识别。
四、核心目录结构
ComfyUI/
├── custom_nodes/ # 自定义插件、第三方节点
├── models/
│ ├── checkpoints/ # 基础大模型
│ ├── loras/ # LoRA 模型
│ ├── vae/ # VAE 解码模型
│ ├── controlnet/ # ControlNet 模型
│ ├── clip/ # 文本编码器
│ ├── clip_vision/ # 视觉识别模型
│ ├── diffusion_models/ # 扩散模型
│ ├── upscale_models/ # 超分辨率放大模型
│ └── …
├── input/ # 待处理输入图像
├── output/ # 生成成品默认输出
└── extra_model_paths.yaml # 模型共享配置
五、插件管理器 ComfyUI-Manager
插件是 ComfyUI 扩展功能的核心。优先安装 ComfyUI-Manager,可实现:
- 一键安装缺失节点:工作流打开后自动检测并提示安装缺失的自定义节点
- 批量更新插件:一键更新全部已安装插件
- 通过 Git 链接安装:支持第三方节点在线安装
- 快照管理:保存/恢复插件安装状态
安装方式
进入 custom_nodes 文件夹,通过 Git 拉取:
git clone https://github.com/ltdrdata/ComfyUI-Manager.git
安装完成后重启 ComfyUI,管理器会集成到主界面菜单中。
六、基础使用流程(标准工作流)
加载大模型
在 Load Checkpoint 节点中,下拉选择已放入 checkpoints 文件夹的模型。
配置提示词
在 CLIP Text Encode 节点中:
- 正向提示词:描述期望生成的画面
- 反向提示词:屏蔽瑕疵、水印、畸形等无效元素
设置图像尺寸
在 Empty Latent Image 节点中设置宽度、高度、批次数量。
配置采样参数
在 KSampler 节点中设置:
- 迭代步数(Steps)
- CFG 引导参数
- 采样算法、调度器类型
生成并保存
点击右侧 Queue Prompt 执行,运算完成后自动通过 VAE Decode 解码、Save Image 保存至 output 目录。
七、v3.2 新增模型支持(重点)
ComfyUI v0.30.2 是一个以新模型引入为核心的版本:
视频生成
- MiniMax H3:全模态视频+音频生成,8GB+ 显存可跑,v3.2 原生支持,开箱即用
- Flux 3 视频模型:Flux 系列正式进入视频生成领域
- Wan 2.2 全系列:万象视频模型生态更新
- SeeDance 2.5:字节舞蹈/动作生成模型新版本
- LTX Video:音视频同步生成,10GB+ 显存需求
图像生成与编辑
- Qwen-Image-2.1:原生支持,文生图+图片编辑+多图参考,6GB 显存可玩
- FLUX.1 dev/pro/schnell:全系列支持
- Stable Diffusion 3.5 / SDXL:原生支持
性能优化
- LTX 和 Wan 模型加速:推理速度提升
- res_multistep 采样器优化:减少不必要计算开销
- int8_convrot VAE 支持:降低显存占用
八、常见问题与避坑指南
坑1:解压密码输错,以为文件损坏
秋叶整合包有解压密码(通常为 bilibili-秋葉aaaki),输错会提示文件损坏。仔细核对大小写后重试。
坑2:模型文件放错目录,加载不出来
确认模型类型对应正确的文件夹。FLUX 模型需要放在 diffusion_models 或 unet 目录,不能用传统的 checkpoints 加载方式。
坑3:显存不够,生成时报错
在绘世启动器中开启低显存模式,或手动添加启动参数:
- –lowvram:8G 以下显存优化
- –vram-mode minimal:4G 及以下极致节省
坑4:共享 WebUI 模型不生效
检查 extra_model_paths.yaml 中的 base_path 路径是否正确,路径后保留空格,重启 ComfyUI 生效。
九、总结
秋叶 v3.2 整合包的核心价值在于:把 Python 3.13 + Torch 2.13 + ComfyUI v0.30.2 的完整环境封装好了,解压即用。你不用再折腾 Python 版本冲突、CUDA 适配、依赖缺失这些让人头疼的问题。MiniMax H3 的原生支持、Qwen-Image-2.1 的开箱即用,以及 Wan、LTX 等视频模型的全面覆盖,让它成为 2026 年入门 ComfyUI 的最佳选择。
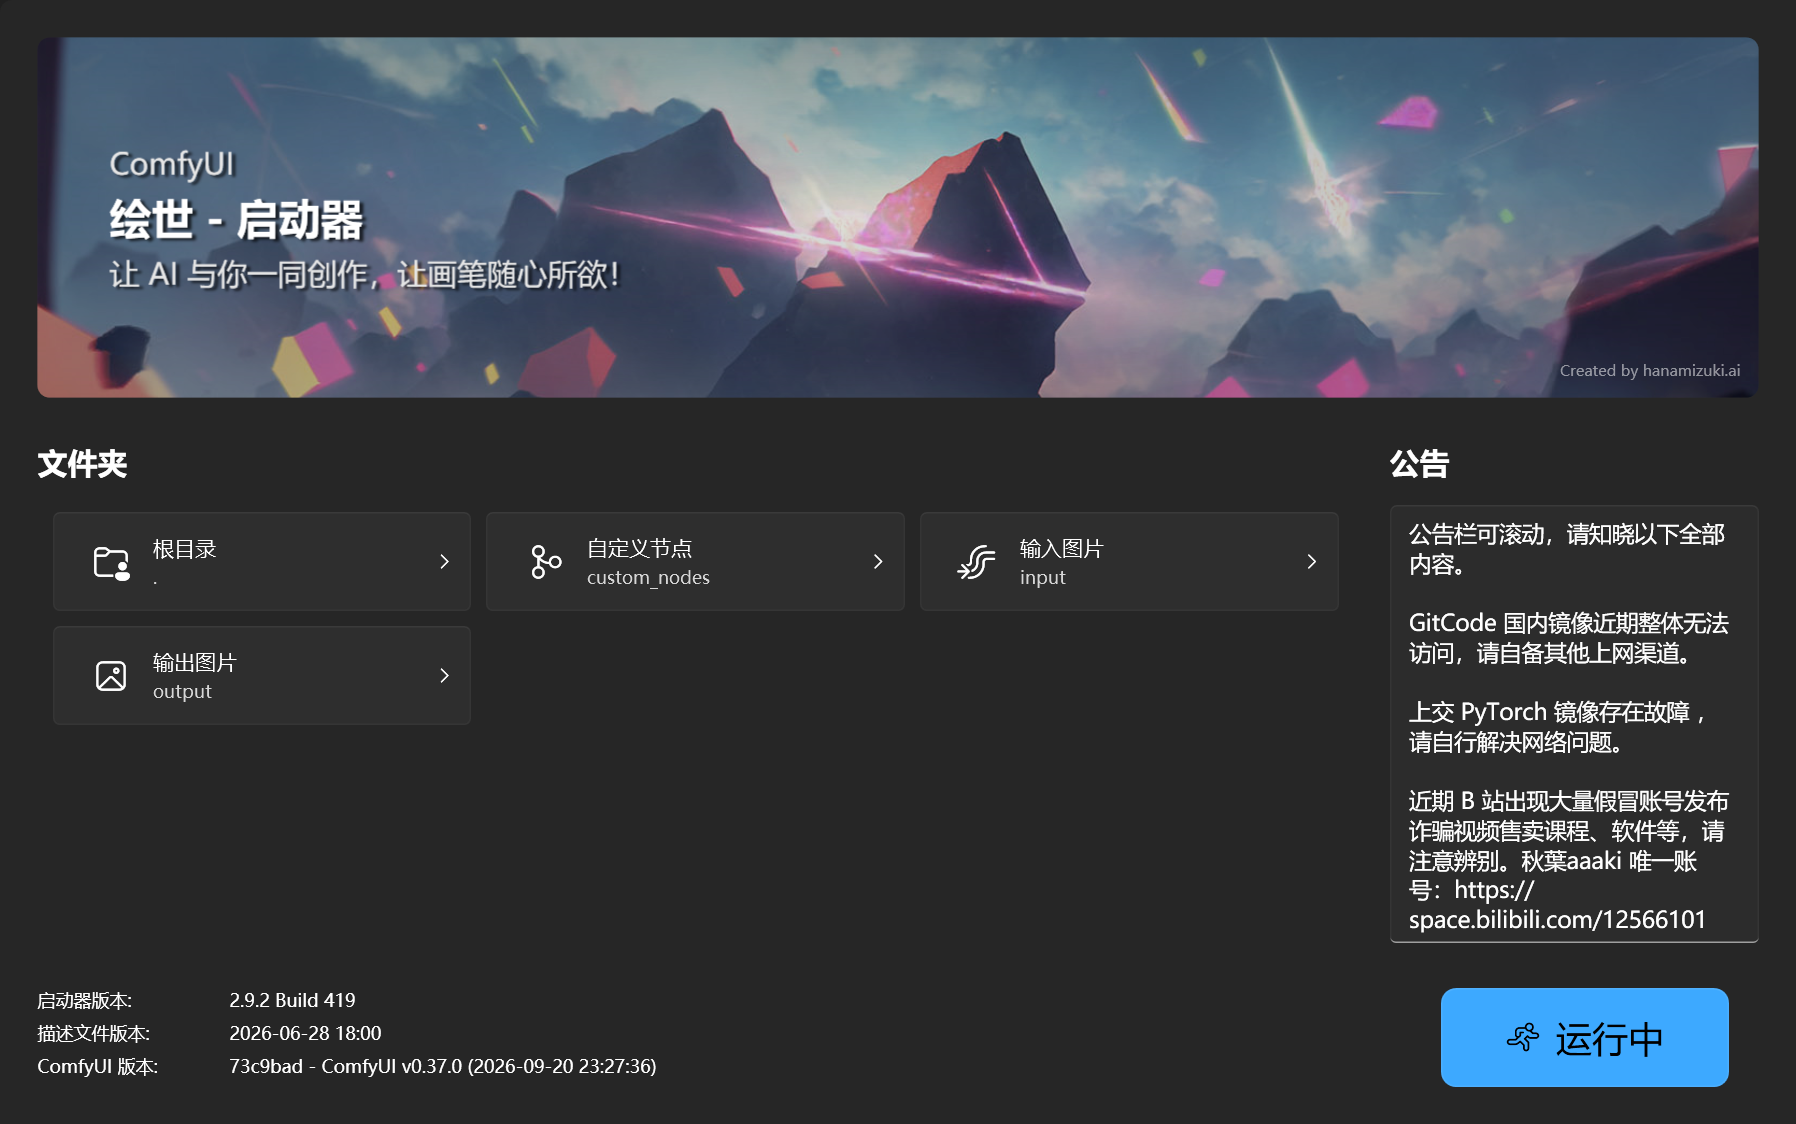
ComfyUI 2026年8月整合包 v3.2 更新公告
整合包版本
v3.2
核心更新内容
|
组件 |
更新版本 |
说明 |
|
ComfyUI |
v0.30.2 |
支持目前所有最新模型,包括 MiniMax H3 等 |
|
Python |
3.13.11 |
官方推荐版本,兼容性良好 |
|
PyTorch |
2.13.0+cu130 |
最新 Torch,配合 CUDA 13.0 |
修改内容
- 升级 Python 3.13:ComfyUI 官方文档明确推荐 Python 3.13,支持良好
- 更新最新 Torch:PyTorch 2.13.0 + CUDA 13.0,充分利用新硬件性能
- 更新到最新 ComfyUI v0.30.2:支持目前所有最新模型
新增模型支持(v0.30.2 亮点)
ComfyUI v0.30.2 是一个以新模型引入为核心的版本:
视频生成模型
- Flux 3 视频模型(来自 Black Forest Labs):Flux 系列正式进入视频生成领域,支持文生视频、图生视频和视频续写
- SeeDance 2.5(字节跳动):舞蹈/动作生成模型新版本
- Wan-Animate2:万象系列动画生成模型
- MiniMax H3:开源权重、原生音频、2K 视频输出的全能视频模型
图像与增强模型
- TopazAI Bloom 2 & Wonder 3.5:新增对 TopazAI 旗下模型的支持
- LTX-2.5:LTX 开源视频模型更新,原生多镜头生成,针对消费级硬件优化
性能优化
- LTX 和 Wan 模型加速:推理速度提升,视频生成效率改善
- res_multistep 采样器优化:跳过无用噪声创建,减少计算开销
量化与硬件适配
- 非对称 w4a8_int 量化支持:扩展低精度推理选择
- int8_convrot VAE 支持:降低显存占用,提升推理速度
MiniMax 音频生态修复
- 修复音频 VAE 完全卸载问题
- 修复 H3 潜空间噪声遮罩采样问题
- 修复 H3 VAE 设备转换问题
下载信息
夸克网盘:秋叶 ComfyUI 2026 整合包 分享